首页 文章 精选 留言 我的

精选列表

搜索[文件分享],共10000篇文章
优秀的个人博客,低调大师

Lucene dvd dvm文件便是docvalues文件——就是针对field value的列存储

public final class Lucene54DocValuesFormat extends DocValuesFormat Lucene 5.4 DocValues format. Encodes the five per-document value types (Numeric,Binary,Sorted,SortedSet,SortedNumeric) with these strategies: NUMERIC: Delta-compressed: per-document integers written as deltas from the minimum value, compressed with bitpacking. For more information, seeDirectWriter. Table-compressed: when the number of unique values is very small (< 256), and when there are unused "gaps" in the range of values used (such asSmallFloat), a lookup table is written instead. Each per-document entry is instead the ordinal to this table, and those ordinals are compressed with bitpacking (DirectWriter). GCD-compressed: when all numbers share a common divisor, such as dates, the greatest common denominator (GCD) is computed, and quotients are stored using Delta-compressed Numerics. Monotonic-compressed: when all numbers are monotonically increasing offsets, they are written as blocks of bitpacked integers, encoding the deviation from the expected delta. Const-compressed: when there is only one possible non-missing value, only the missing bitset is encoded. Sparse-compressed: only documents with a value are stored, and lookups are performed using binary search. BINARY: Fixed-width Binary: one large concatenated byte[] is written, along with the fixed length. Each document's value can be addressed directly with multiplication (docID * length). Variable-width Binary: one large concatenated byte[] is written, along with end addresses for each document. The addresses are written as Monotonic-compressed numerics. Prefix-compressed Binary: values are written in chunks of 16, with the first value written completely and other values sharing prefixes. chunk addresses are written as Monotonic-compressed numerics. A reverse lookup index is written from a portion of every 1024th term. SORTED: Sorted: a mapping of ordinals to deduplicated terms is written as Binary, along with the per-document ordinals written using one of the numeric strategies above. SORTED_SET: Single: if all documents have 0 or 1 value, then data are written like SORTED. SortedSet table: when there are few unique sets of values (< 256) then each set is assigned an id, a lookup table is written and the mapping from document to set id is written using the numeric strategies above. SortedSet: a mapping of ordinals to deduplicated terms is written as Binary, an ordinal list and per-document index into this list are written using the numeric strategies above. SORTED_NUMERIC: Single: if all documents have 0 or 1 value, then data are written like NUMERIC. SortedSet table: when there are few unique sets of values (< 256) then each set is assigned an id, a lookup table is written and the mapping from document to set id is written using the numeric strategies above. SortedNumeric: a value list and per-document index into this list are written using the numeric strategies above. Files: .dvd: DocValues data .dvm: DocValues metadata 转自:http://lucene.apache.org/core/6_4_2/core/org/apache/lucene/codecs/lucene54/Lucene54DocValuesFormat.html 可以看到占用空间非常小!!! du -sm elasticsearch/nodes/0/indices/hec_test2/0/index/* 299 elasticsearch/nodes/0/indices/hec_test2/0/index/_e.fdt 1 elasticsearch/nodes/0/indices/hec_test2/0/index/_e.fdx 1 elasticsearch/nodes/0/indices/hec_test2/0/index/_e.fnm 148 elasticsearch/nodes/0/indices/hec_test2/0/index/_e_Lucene50_0.doc 130 elasticsearch/nodes/0/indices/hec_test2/0/index/_e_Lucene50_0.tim 5 elasticsearch/nodes/0/indices/hec_test2/0/index/_e_Lucene50_0.tip 1 elasticsearch/nodes/0/indices/hec_test2/0/index/_e_Lucene54_0.dvd 1 elasticsearch/nodes/0/indices/hec_test2/0/index/_e_Lucene54_0.dvm 1 elasticsearch/nodes/0/indices/hec_test2/0/index/_e.si 1 elasticsearch/nodes/0/indices/hec_test2/0/index/segments_7 0 elasticsearch/nodes/0/indices/hec_test2/0/index/write.lock 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6669414.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

得物新商品审核链路建设分享

一、 前言 得物近年来发展迅猛,平台商品类目覆盖越来越广,商品量级越来越大。而以往得物的上新动作更多依赖于传统方式,效率较低,无法满足现有的上新诉求。那么如何能实现更加快速的上新、更加高效的上新,就成为了一个至关重要的命题。 近两年AI大模型技术的发展,使得发布和审核逐渐向AI驱动的方式转变成为可能。因此,我们可以探索利用算法能力和大模型能力,结合业务自身规则,构建更加全面和精准的规则审核点,以实现更高效的工作流程,最终达到我们的目标。 本文围绕AI审核,介绍机审链路建设思想、规则审核点实现快速接入等核心逻辑。 二、如何实现高效审核 对于高效审核的理解,主要可以拆解成“高质量”、“高效率”。目前对于“高质量”的动作包括,基于不同的类目建设对应的机审规则、机审能力,再通过人工抽查、问题Case分析的方式,优化算法能力,逐步推进“高质量”的效果。 而“高效率”,核心又可以分成业务高效与技术高效。 业务高效 逐步通过机器审核能力优化审核流程,以解决资源不足导致上新审核时出现进展阻碍的问题。 通过建设机审配置业务,产品、业务可以直观的维护类目-机审规则-白名单配置,从而高效的调整机审策略。 技术高效 通过建设动态配置能力,实现快速接入新的机审规则、调整机审规则等,无需代码发布,即配即生效。 Q2在搭建了动态配置能力之后,算法相关的机审规则接入效率提升了70%左右。 三、动态配置实现思路 建设新版机审链路前的调研中,我们对于老机审链路的规则以及新机审规则进行了分析,发现算法类机审规则占比超过70%以上,而算法类的机审规则接入的流程比较固化,核心分成三步: 与算法同学沟通定义好接口协议 基于商品信息构建请求参数,通过HTTP请求算法提供的URL,从而获取到算法结果。 解析算法返回的结果,与自身商品信息结合,输出最终的机审结果。 而算法协议所需要的信息通常都可以从商品中获取到,因此通过引入“反射机制”、“HTTP泛化调用”、“规则引擎”等能力,实现算法规则通过JSON配置即可实现算法接入。 四、商品审核方式演进介绍 商品审核方式的演进 人审 依赖商管、运营,对商品上架各字段是否符合得物上新标准进行人工核查。 机审 对于部分明确的业务规则,比如白底图、图片清晰度、是否重复品、是否同质品等,机审做前置校验并输出机审结果,辅助人工审核,降低审核成本,提升审核效率。 AI审核 通过丰富算法能力、强化AI大模型能力、雷达技术等,建设越来越多的商品审核点,并推动召回率、准确率的提升,达标的审核点可通过自动驳回、自动修改等action接管商品审核,降低人工审核的占比,降低人工成本。 五、现状问题分析 产品层面 机审能力不足,部分字段没覆盖,部分规则不合理: 机审字段覆盖度待提升 机审规则采纳率不足 部分机审规则不合理 缺少产品配置化能力,配置黑盒化,需求迭代费力度较高: 规则配置黑盒 规则执行结果缺乏trace和透传 调整规则依赖开发和发布 缺少规则执行数据埋点 技术层面 系统可扩展性不足,研发效率低: 业务链路(AI发品、审核、预检等)不支持配置化和复用 规则节点不支持配置化和复用 六、流程介绍 搭建机审配置后台,可以通过配置应用场景+业务身份+商品维度配置来确定所需执行的全量规则,规则可复用。 其中应用场景代表业务场景,如商品上新审核、商家发品预检、AI发品预检等;业务身份则表示不同业务场景下不同方式,如常规渠道商品上新的业务场景下,AI发布、常规商品上新(商家后台、交易后台等)、FSPU同款发布品等。 当商品变更,通过Binlog日志触发机审,根据当前的应用场景+业务身份+商品信息,构建对应的机审执行链(ProcessChain)完成机审执行,不同的机审规则不通过支持不同的action,如自动修正、自动驳回、自动通过等。 链路执行流程图如下: 七、详细设计 整体架构图 业务实体 ER图 含义解释 ※ 业务场景 触发机审的应用场景,如新品发布、商家新品预检等。 ※ 业务身份 对于某个应用场景,进一步区分业务场景,如新品发布的场景下,又有AI发品、常规发品、FSPU同款发品等。 ※ 业务规则 各行业线对于商品的审核规则,如校验图片是否是白底图、结构化标题中的类目需与商品类目一致、发售日期不能超过60天等。同一个业务规则可以因为业务线不同,配置不同的机审规则。 ※ 规则组 对规则的分类,通常是商品字段模块的名称,一个规则组下可以有多个业务规则,如商品轮播图作为规则组,可以有校验图片是否白底图、校验图片是否清晰、校验模特姿势是否合规等。 ※ 机审规则 对商品某个商品字段模块的识别并给出审核结果,数据依赖机审能力以及spu本身。 ※ 机审能力 商品信息(一个或多个商品字段模块)的审核数据获取,通常需要调用外部接口,用于机审规则审核识别。 ※ 业务&机审规则关联关系 描述业务规则和机审规则的关联关系,同一个业务规则可以根据不同业务线,给予不同的机审规则,如轮播图校验正背面,部分业务线要求校验全量轮播图,部分业务线只需要校验轮播图首图/规格首图。 机审执行流程框架 流程框架 通过责任链、策略模式等设计模式实现流程框架。 触发机审后会根据当前的业务场景、业务身份、商品信息等,获取到对应的业务身份执行链(不同业务身份绑定不同的执行节点,最终构建出来一个执行链)并启动机审流程执行。 由于机审规则中存在数据获取rt较长的情况,如部分依赖大模型的算法能力、雷达获取三方数据等,我们通过异步回调的方式解决这种场景,也因此衍生出了“异步结果更新机审触发”。 ※ 完整机审触发 完整机审触发是指商品变更后,通过Binlog日志校验当前商品是否满足触发机审,命中的机审规则中如果依赖异步回调的能力,则会生成pendingId,并记录对应的机审结果为“pending”(其他规则不受该pending结果的影响),并监听对应的topic。 ※ 异步结果更新机审触发 部分pending规则产出结果后发送消息到机审场景,通过pendingId以及对应的商品信息确认业务身份,获取异步结果更新责任链(与完整机审的责任链不同)再次执行机审执行责任链。 动态配置能力建设 调研 新机审链路建设不仅要支持机审规则复用,支持不同业务身份配置接入,还要支持新机审规则快速接入,降低开发投入的同时,还能快速响应业务的诉求。 经过分析,机审规则绝大部分下游为算法链路,并且算法的接入方式较为固化,即“构建请求参数” -> “发起请求” -> “结果解析”,并且数据模型通常较为简单。因此技术调研之后,通过HTTP泛化调用实现构建请求参数、发起请求,利用**规则引擎(规则表达式)**实现结果解析。 规则引擎技术选型 调研市面上的几种常用规则引擎,基于历史使用经验、上手难度、文档阅读难度、性能等方面综合考虑,最终决定选用QLExpress。 **HTTP泛化调用能力建设** ※ 实现逻辑 定义MachineAuditAbilityEnum统一的动态配置枚举,并基于MachineAuditAbilityProcess实现其实现类。 统一入参为Map结构,通过反射机制、动态Function等方式,实现商品信息映射成算法请求参数;另外为了提升反射的效率,利用预编译缓存的方式,将字段转成MethodHandle,后续对同一个字段做反射时,可直接获取对应的MethodHandle,提升效率。 /** * 缓存类字段的MethodHandle(Key: Class+FieldName, Value: MethodHandle) */ privatestaticfinalMap<String,MethodHandle>FIELD_HANDLE_CACHE=newConcurrentHashMap<>(); /** * 根据配置从对象中提取字段值到Map *@return提取后的Map */ publicMap<String,Object>fieldValueMapping(AutoMachineAlgoRequestConfig requestConfig,ObjectspuResDTO) { AutoMachineAlgoRequestConfig.RequestMappingConfigrequestMappingConfig = requestConfig.getRequestMappingConfig(); Map<String,Object> targetMap =Maps.newHashMap(); //1.简单映射关系,直接将obj里的信息映射到resultMap当中 //2.遍历复杂映射关系,value是基础类型 //3.遍历复杂映射关系,value是对象 returntargetMap; } /** * 预编译FieldMapping */ privateList<AutoMachineAlgoRequestConfig.FieldMapping>compileConfig(List<AutoMachineAlgoRequestConfig.FieldMapping> fieldMappingList,Objectobj) { List<AutoMachineAlgoRequestConfig.FieldMapping> mappings =newArrayList<>(fieldMappingList.size()); //缓存反射mapping returnmappings; } privateObjectgetFieldValue(Objectrequest,StringfieldName) throwsThrowable{ StringcacheKey = request.getClass().getName() +"#"+ fieldName; MethodHandlehandle =FIELD_HANDLE_CACHE.get(cacheKey); returnhandle !=null? handle.invoke(request) :null; } 基于实现@FeignClient注解,实现HTTP调用的执行器,其中@FeignClient中的URL表示域名,autoMachineAuditAlgo方法中的path表示具体的URL,requestBody是请求体,另外还包含headers,不同算法需要不同headers也可动态配置。 返回结果均为String,而后解析成Map<String,Object>用于规则解析。 @FeignClient( name ="xxx", url ="${}" ) publicinterfaceGenericAlgoFeignClient{ @PostMapping(value ="/{path}") StringautoMachineAuditAlgo( @PathVariable("path")Stringpath, @RequestBodyObjectrequestBody, @RequestHeaderMap<String,String> headers ); @GetMapping("/{path}") StringautoMachineAuditAlgoGet( @PathVariable("path")Stringpath, @RequestParamMap<String,Object> queryParams, @RequestHeaderMap<String,String> headers ); } 动态配置JSON。 { "url":"/ai-check/demo1", "requestMappingConfig":{ "fieldMappingList":[ { "sourceFieldName":"categoryId", "targetKey":"categoryId" }, { "sourceFieldName":"brandId", "targetKey":"brandId" } ], "perItemMapping":{ "mappingFunctionCode":"firstAndFirstGroundPic", "fieldMappingList":[ { "sourceFieldName":"imgId", "targetKey":"imgId" }, { "sourceFieldName":"imgUrl", "targetKey":"imgUrl" } ] } } } 机审规则动态解析建设 ※ 实现逻辑 定义MachineAuditRuleEnum统一的动态配置枚举,并基于MachineAuditRuleProcess实现其统一实现类。 搭建QLExpress规则引擎,为了提升QLExpress规则引擎的效率,同样引入了缓存机制,在机审规则配置表达式时,则触发loadRuleFromJson,将表达式转换成规则引擎并注入到缓存当中,真正机审流程执行时会直接从缓存里获取规则引擎并执行,效率上有很大提升。 // 规则引擎实例缓存 privatestaticfinalMap<String,ExpressRunner> runnerCache =newConcurrentHashMap<>(); // 规则配置缓存 privatestaticfinalMap<String,GenericEngineRule> ruleConfigCache =newConcurrentHashMap<>(); // 规则版本信息 privatestaticfinalMap<String,Integer> ruleVersionCache =newConcurrentHashMap<>(); /** * 加载JSON规则配置 *@paramjsonConfig 规则JSON配置 */ publicGenericEngineRuleloadRuleFromJson(StringruleCode,StringjsonConfig) { //如果缓存里已经有并且是最新版本,则直接返回 if(machineAuditCache.isSameRuleConfigVersion(ruleCode) && machineAuditCache.getRuleConfigCache(ruleCode) !=null) { returnmachineAuditCache.getRuleConfigCache(ruleCode); } // 如果是可缓存的规则,预加载 returnrule; } 机审规则执行时,通过配置中的规则名称,获取对应的规则引擎进行执行。 /** * 根据规则名称执行规则 *@paramruleCode 规则名称 *@paramcontext 上下文数据 *@return规则执行结果 */ publicMachineAuditRuleResultexecuteRuleByCode(StringruleCode,Map<String,Object> context, MachineAuditRuleProcessData ruleProcessData) { if(StringUtils.isBlank(ruleCode)) { thrownewIllegalArgumentException("机审-通用协议-规则-规则名称不能为空"); } //从缓存中获取规则引擎 //基于规则引擎执行condition //统一日志 } ※ 配置demo 动态配置JSON。 { "ruleCode":"demo1", "name":"规则demo1", "ruleType":1, "priority":100, "functions":[ ], "conditions":[ { "expression":"result.code == null || result.code != 0", "action":{ "type":"NO_RESULT", "messageExpression":"'无结果'" } }, { "expression":"result.data == 0", "action":{ "type":"PASS", "messageExpression":"'机审通过" } }, { "expression":"result.data == 1", "action":{ "type":"REJECT", "messageExpression":"'异常结果1'", "suggestType":2, "suggestKey":"imgId", "preAuditSuggestKey":"imgUrl" } }, { "expression":"result.data == 2", "action":{ "type":"REJECT", "messageExpression":"'异常结果2'", "suggestType":2, "suggestKey":"imgId", "preAuditSuggestKey":"imgUrl" } } ], "defaultAction":{ "type":"PASS" } } 八、关于数据分析&指标提升 在经历了2-3个版本搭建完新机审链路 + 数据埋点之后,指标一直没有得到很好的提升,曾经一度只是维持在20%以内,甚至有部分时间降低到了10%以下;经过大量的数据分析之后,识别出了部分规则产品逻辑存在漏洞、算法存在误识别等情况,并较为有效的通过数据推动了产品优化逻辑、部分类目规则调整、算法迭代优化等,在一系列的动作做完之后,指标提升了50%+。 在持续了比较长的一段时间的50%+覆盖率之后,对数据进行了进一步的剖析,发现这50%+在那个时间点应该是到了瓶颈,原因是像“标题描述包含颜色相关字样”、“标题存在重复文案”以及部分轮播图规则,实际就是会存在不符合预期的情况,因此紧急与产品沟通,后续的非紧急需求停止,先考虑将这部分天然不符合预期的情况进行处理。 之后指标提升的动作主要围绕: 算法侧产出各算法能力的召回率、准确率,达标的算法由产品与业务拉齐,是否配置自动驳回的能力。 部分缺乏自动修改能力的机审规则,补充临时需求建设对应的能力。 经过产研业务各方的配合,以最快速度将这些动作进行落地,指标也得到了较大的提升。 往期回顾 1.营销会场预览直通车实践|得物技术 2.基于TinyMce富文本编辑器的客服自研知识库的技术探索和实践|得物技术 3.AI质量专项报告自动分析生成|得物技术 4.社区搜索离线回溯系统设计:架构、挑战与性能优化|得物技术 5.eBPF 助力 NAS 分钟级别 Pod 实例溯源|得物技术 文 / 沃克 关注得物技术,每周更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~ 未经得物技术许可严禁转载,否则依法追究法律责任。

优秀的个人博客,低调大师

每日一博 | 分享 8 个 CSS 小技巧

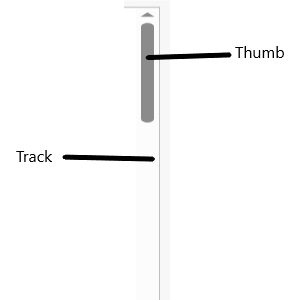
前言 在网页设计和前端开发中,CSS属性是非常重要的一部分。掌握常用的CSS属性不仅可以使你的网页看起来更美观,还能提升用户体验,今天小编为大家介绍8个常见的CSS小技巧: 1.修改滚动条样式 下图是我们常见的滚动条,现在需要改变滚动条的宽度和颜色了,并把它画的圆一点。 (常见的滚动条) 可以用::-webkit-scrollbar来实现: /*设置滚动条的宽度*/ ::-webkit-scrollbar{ width: 10px; } /*将轨道改为蓝色,并设置圆形边框*/ ::-webkit-scrollbar-track{ background-color: blue; border-radius: 10px; } /* 将滚动条设置为灰色并将其设置为圆形*/ ::-webkit-scrollbar-thumb{ background: gray; border-radius: 10px } /*悬停时呈深灰色*/ ::-webkit-scrollbar-thumb:hover{ background: darkgray; } ​ (改变之后的滚动条) 2.修改光标停留在页面上的样式 一般情况下鼠标的样式是一个箭头,改变鼠标光标的样式为其他类型: /*类为first的元素,设置鼠标为不可用状态 。 */ .first{ cursor: not-allowed; } /* 类为second的元素,将鼠标指针设置为放大镜效果 */ .second{ cursor: zoom-in; } /* 类为third的元素,将鼠标指针设置为十字准星形状*/ .third{ cursor: crosshair; } ​ (改变之后的光标) 3.保持组件的纵横比大小 在构建响应式组件的时候,组件的高度与宽度的不协调经常会导致视频和图像会出现拉伸的情况,影响读者的观感,因此我们需要设置组件的纵横比属性: .example{ /* 设置纵横比 */ aspect-ratio: 1 / .25; /* 设置宽度后,高度自动设置 */ width: 200px; /*设置边框.*/ border: solid black 1px; } 设置了宽度之后,我们将自动得到等于125像素的高度,以保持长宽比。 ​ (显示效果) 4.页面平滑的滚动 通过代码实现平滑地从一个页面跳转到另一个页面: <!DOCTYPE html\> <html\> <head\> <style\> /*设置页面平滑地滚动*/ html { scroll-behavior: smooth; } #section1 { height: 600px; background-color: pink; } #section2 { height: 600px; background-color: yellow; } <style\> <head\> <body> <h1\>Smooth Scroll</h1\> <div class="main" id="section1"\> <h2>Section 1</h2> <p>Click on the link to see the "smooth" scrolling effect.</p> <a href="\#section2">Click Me to Smooth Scroll to Section 2 Below</a> <p>Note: Remove the scroll-behavior property to remove smooth scrolling.</p> </div> <div class="main" id="section2"> <h2>Section 2</h2> <a href="#section1">Click Me to Smooth Scroll to Section 1 Above</a> </div> <p><strong>Note:</strong> The scroll-behavior property is not supported in Internet Explorer.</p> </body> </html> 点击这里查看效果: 5.筛选 使用 CSS 向图像添加滤镜: img{ filter: /*YOUR VALUE */; } 有许多可用的过滤器。您可以模糊、增亮和饱和滤镜。您可以将图像设为灰度、更改其不透明度、反转颜色等等。 ​ 正常图像(左)、模糊图像(中)和高对比度图像(右) ​ 增亮图像(左)、灰度图像(中)和色调旋转图像(右) 点击此页面了解更多关于筛选的详细信息。 6.背景效果 使用backdrop-filter在图片中添加背景。 <div class="image"\> <div class="effect"> backdrop-filter: blur(5px); </div> </div> <style> .image{ background-image: url(YOUR URL); background-size: cover; width: 400px; height: 400px; display: flex; align-items: center; justify-content: center; } .effect{ font-size: x-large; color: white; font-weight: 800; background-color: rgba(255, 255, 255, .3); backdrop-filter: blur(5px); padding: 20px; } </style> ​ (实现的效果) 7.组件反射 在 SVG 下方创建反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below; } ​ (方框反射) 抵消反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below 20px; } ​ (带有偏移的反射) 渐变反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below 0px linear-gradient(to bottom, rgba(0,0,0,0), rgba(0,0,0,.5)); } ​ (渐变反射) 8. 检查浏览器是否支持某个属性 使用@Supports检查 CSS 是否支持特定属性。 /* 检查浏览器是否支持显示 */ @supports (display: flex){ /* 如果支持,则显示为flex。*/ div{ display: flex } } 以上就是关于CSS的8个小技巧,希望可以帮助到大家。 本文为翻译,原文地址: https://medium.com/@anirudh.munipalli/10-powerful-css-properties-that-every-web-developer-must-know-e5d7f8f04e10 扩展链接: 高级SQL分析函数-如何用窗口函数进行排名计算 3D模型+BI分析,打造全新的交互式3D可视化大屏开发方案 React + Springboot + Quartz,从0实现Excel报表自动化

优秀的个人博客,低调大师

数据库模型设计案例分享(GaussDB版)

目录 一、前言 二、应用系统数据库设计的基本流程 三、数据库模型设计 1、概念结构设计阶段 2、逻辑结构设计阶段 3、物理结构设计阶段 四、小结 一、前言 GaussDB数据库是一款企业级分布式数据库,支持集中式和分布式两种部署形态。它面向金融互联网交易和政企OA/办公等场景,具有安全可靠、超高性能、简单易用等优势。 在GaussDB中,数据建模是非常重要的一部分。数据建模是指根据业务需求和数据特点,将现实世界中的实体、属性、关系等概念抽象出来,并用一定的方式表示成计算机可以理解的形式。数据库模型设计的目的是为了建立一个能够满足业务需求的数据存储结构,使得数据的存储、查询、更新等操作更加高效、可靠、安全。 在GaussDB中,可以使用E-R图来进行数据建模,E-R图也称实体-联系图(Entity Relationship Diagram),提供了表示实体类型、属性和联系的方法,用来描述现实世界的概念模型,它可以帮助您更好地理解您的业务逻辑并将其转换为关系模型。 二、应用系统数据库设计的基本流程 应用系统数据库设计基本流程简图: 第一步:需求分析:主要包括数据、功能、性能等 第二步:数据库设计:主要包括概念结构设计、逻辑结构设计、物理结构设计等 第三步:数据库实施:选择数据库软件,并进行落地。 第四步:数据库系统运行、维护和优化。 其中数据库设计(Database Design)是E-R设计模型中的主要环节。 三、数据库模型设计 本节结合GaussDB数据库的相关知识点,以简单的订单模型举例来演示数据库模型的设计过程。 数据库模型设计主要分以下3个阶段: 1、概念结构设计阶段 概念数据模型(CDM)是按用户的观点来对数据和信息建模,其目标是统一业务概念,作为业务人员和技术人员之间沟通的桥梁,确定不同实体之间的最高层次的关系。其特征包括: 面向用户,反映用户的业务需求 抽象性强,不涉及具体实现细节 层次结构清晰,各层之间有一定的关系 可扩展性好,可以方便地添加新的实体和关系等。 所以这个阶段,我们主要完成从需求中抽象出示实体集和关系集。 示例系统:订单系统,实体(订单、客户、供应商、商品、地址)。 实体集之间关系集梳理: 1)客户与订单是一对多 2)客户与地址是一对一 3)供应商与地址是一对一 4)供应商与商品是一对多 5)订单与商品是一对多 如图, 确定不同实体之间的最高层次的关系: 2、逻辑结构设计阶段 逻辑数据模型(LDM)尽可能详细地描述数据, 逻辑数据模型的特征包括: 包括所有实体和它们之间的关系 指定了每个实体的所有属性 指定外键(标识不同实体之间关系的键) 关系表规范化等。 如图, 完善每个实体的属性:​​​​​​ 3、物理结构设计阶段 物理数据模型(PDM)表示如何在数据库中构建模型。 物理数据库模型显示所有表结构,包括列名,列数据类型,列约束,主键,外键以及表之间的关系。物理数据模型的功能包括: 规范所有表和列 外键用于标识表之间的关系。 物理上的考虑可能导致物理数据模型与逻辑数据模型有差异 不同的RDBMS的物理数据模型将有所不同,例如MySQL和GaussDB之间列的数据类型可能有所不同。 目标是指定如何用数据库模式来实现逻辑数据模型,以及真正的保存数据。 如图,完成所有实体转换为表,转换所有关系集为相关表的外键,转换所有属性为列。 针对上面的物理数据模型设计时,GaussDB数据库有如下字段设置规范建议: 合理选用字符串数据类型。优先使用变长字符类VARCHAR。只有该字段输入确定为固定字符则使用定长字符类型,或需要自动补充空格,才使用CHAR(n)。 字符类型字段不应存储数字类型的数据。如果对存储在字符类型字段中的数据进行数值计算,或者与数值进行比较操作(如置于过滤条件中),会带来不必要的数据类型转换的开销,同时该字段上的索引可能失效,影响查询性能。 字符类型字段不应存储时间或日期类数据。如果对存储在字符类型字段中的数据与日期类数据进行计算或比较操作(如置于过滤条件中),会带来不必要的数据类型转换的开销,同时该字段上的索引可能失效,影响查询性能。 对于明确不存在NULL值的字段加上NOT NULL约束。对于NOT NULL字段,优化器在某些场景下会进行特殊优化,可较大提升查询性能。 相关联字段的数据类型应保持一致。在进行关联操作时,如果字段类型不一致,会带来数据类型转换开销。 大字段(例如varchar(1000)、varchar(4000))不建议超过8个。 字段定义时建议同时创建COMMENT注释信息,以便于未来维护。 不建议对表预留字段。大部分场景下可支持快速新增、删除表字段,或者修改字段的DEFAULT值。 尽量使用高效的数值类数据类型。在满足业务精度的情况下,选择的优先级从高到低依次为整数、浮点数、NUMERIC。 合理设置数值字段的数据类型,根据取值范围选择合适的数值类型,尽量少用NUMERIC/DECIMAL类型。NUMERIC和DECIMAL等价,NUMERIC(或DECIMAL)数据类型操作对CPU消耗较高。 数据库模型设计的三个主要阶段汇总如下: 概念数据模型设计阶段:实体、关系集 逻辑数据模型设计阶段:实体、关系集、属性、主键、外键 物理数据模型设计阶段:表、列名、列数据类型、主键、外键 四、小结 通常,数据建模是为了让查询更简单、更高效。在现实场景中,如果要想高效的使用好数据库,那么一个优秀的数据建模是必不可少的。数据模型是应用系统数据库设计的基础,而数据库则是数据模型实现的工具。本文建模后是在GaussDB数据库平台上进行落地实验的,其逻辑与思路与大多少关系型数据库基本通用。 ——结束

优秀的个人博客,低调大师

共建基础软件基石,OpenCloudOS 社区开源实践分享

近日,红帽宣布了限制源代码访问性的政策,称RHEL相关源码仅通过CentOS Stream公开,付费客户和合作伙伴可通过Red Hat Customer Portal访问到源代码。也就是说,公开渠道不再提供RHEL的源码,只能获取CentOS Stream的源码,非客户获取源码就没有以前便利了。 这是继CentOS停服之后,红帽的又一大动作。消息一出,引发了许多人的担忧。事实上,有关红帽对CentOS相关代码发行方式的变更可以追溯到更早之前。CentOS是红帽发行的社区版Linux,其上游原本是红帽的企业发行版Linux系统RHEL (Red Hat Enterprise Linux),因此对使用者来说更加稳定。 在服务器生产环境中,CentOS占有率达到了90%,2021年国内存量400万台。 2020年12月份,CentOS官网正式宣布,将停止维护CentOS Linux,并将更多资金和人力投入到CentOS Stream中。而CentOS Stream则是在RHEL的上游,其稳定性自然不如CentOS。 CentOS停服带来了一系列的问题,如安全性风险,随着更新和补丁的停止,系统将不再收到安全补丁;软件和依赖性问题,部分软件包和应用程序可能会面临过期和兼容性问题;技术支持缺失;迁移成本问题;遗留系统兼容性问题。 在CentOS宣布停服之后,许多人开始寻找更稳定的替代方案,OpenCloudOS社区便应运而生。在过去一年多的时间,已经有600多家公司加入OpenCloudOS社区,实现了产业链类型全覆盖(12大行业),主流芯片、数据库、整机全覆盖,覆盖10000+用户群体…… 7月1日,在OSCHINA主办的93期源创会上,腾讯操作系统TencentOS研发团队产品负责人,OpenCloudOS社区贡献者汪礼超为到场观众详细讲解了OpenCloudOS社区发展与建设思路,以及技术特性。 汪礼超介绍,最初OpenCloudOS社区希望能在短期解决CentOS断供替代问题,长期解决国产操作系统上游供应问题,保障行业应用的基础软件安全供应及可持续健康发展。社区定位是从源社区(L1)、商业版(L2)、到社区稳定版(L3)的全链路覆盖,输出经海量业务验证的企业级稳定操作系统版本。避免断供风险,为行业提供可控的操作系统的上下游供应,做中国操作系统全链路供应标杆。 OpenCloudOS社区作为核心底座,全面保障国产操作系统软件供应链,同源支撑服务器、桌面、嵌入式、边缘全场景。目前,OpenCloudOS社区及衍生版本装机量累计超1000万台,覆盖银行、保险、证券等12大行业。 技术能力方面,OpenCloudOS依托TencentOS 10年+专业技术打磨、系统整体可用性99.999%、宕机自动分析成功率95%,享有多级质量保障,提供高级别的安全防护服务,健全的运营支撑服务。 汪礼超带来了多个OpenCloudOS版本的介绍。 如OpenCloudOS Stream23系列版本,是OpenCloudOS社区Stream SIG成员联合研发独立演进的首个L1源社区项目,此系列紧跟上游,保障供应安全。目前已发布3个版本,产品能力持续完善,软件包自主选型达到3000,实现不依赖其他发行版的自编译。 OpenCloudOS v9系列版本,这是OpenCloudOS社区成员联合研发的基于OpenCloudOS Stream23的首个L3全自研版本,高效经济,独立开放。OpenCloudOS桌面系列版本,兼具实用和自主性,桌面支持是OC社区的重点工作之一,目前OC8已完成NDE桌面的支持,OC9完成了Gnome桌面的适配工作。 未来,OpenCloudOS开源社区将持续优化用户体验,继续提升操作系统易用性、安全性、稳定性;提升资源利用率,降本增效;持续打造绿色经济基础软件;紧跟新技术发展;协同开发者、伙伴、客户、行业共同打造基础软件基石、确保应用环境稳定、基础服务设施供应安全。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册