首页 文章 精选 留言 我的

精选列表

搜索[Emacs化],共10000篇文章
优秀的个人博客,低调大师

(二)Java工程化--Maven实践

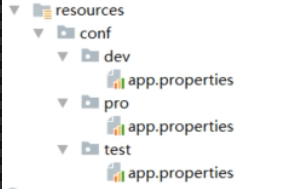
Maven项目版本号 默认版本号: 1.0-SNAPSHOT 最佳实践是约定该版本为不稳定版本,如果发布一定要删除; 建议的版本规则: 主版本号.次版本号.增量版本号-<里程碑版本> 如:1.0.0-RELEASE 10.2.5-FINAL 等. 最佳实践是结合自身情况制定大家都认可的版本号规则. 常见命令 内置的maven插件提供了常见的命令, 可以在以下位置找到对应的包: .m2\repository\org\apache\maven\plugins compile clean 删除/target,将已编译的二进制文件等删除 test test case junit/testNG package 打包 install 把项目install到本地仓库 deploy 发布jar到remote服务器 mvn help:system 查看环境变量 插件 插件仓库 https://maven.apache.org/plugins/ http://www.mojohaus.org/plugins.html 常见插件 findbugs 静态代码检查 versions 统一升级版本号 统一升级版本 http://www.mojohaus.org/versions-maven-plugin/ 可以查看使用示例, 常用的设置版本的命令为mvn versions: set –DnewVersion=1.1.0-final mvn versions:set -DnewVersion=1.1 source 打包源代码,当jar提供给外部的时候斟酌使用 assembly 打包zip、war tomcat7 <plugins> <!--静态代码bug扫描--> <plugin> <groupId>org.codehaus.mojo</groupId> <artifactId>findbugs-maven-plugin</artifactId> <version>3.0.0</version> <configuration> <threshold>High</threshold> <effort>Default</effort> <findbugsXmlOutput>true</findbugsXmlOutput> <findbugsXmlOutputDirectory>target/site</findbugsXmlOutputDirectory> </configuration> </plugin> <!--版本号管理--> <plugin> <groupId>org.codehaus.mojo</groupId> <artifactId>versions-maven-plugin</artifactId> <version>2.3</version> </plugin> <!--打包源代码--> <plugin> <artifactId>maven-source-plugin</artifactId> <version>2.3</version> <executions> <execution> <id>attach-sources</id> <phase>install</phase> <goals> <goal>jar-no-fork</goal> </goals> </execution> </executions> </plugin> <!--这个有点晕,生成可执行jar包什么的--> <plugin> <artifactId>maven-assembly-plugin</artifactId> <version>3.0.0</version> <configuration> <archieve> <manifest> <mainClass>com.xlx.Test</mainClass> </manifest> </archieve> <descriptorRefs> <descriptorRef>jar-with-dependencies</descriptorRef> </descriptorRefs> </configuration> </plugin> <!--tomcat插件--> <plugin> <groupId>org.apache.tomcat.maven</groupId> <artifactId>tomcat7-maven-plugin</artifactId> <version>2.2</version> <configuration> <port>8080</port> <path>/</path> </configuration> </plugin> </plugins> 自定义插件 学习地址https://maven.apache.org/guides/plugin/guide-java-plugin-development.html 创建项目 修改pom的<packaging>maven-plugin</packaging> 添加依赖 <dependencies> <dependency> <groupId>org.apache.maven</groupId> <artifactId>maven-plugin-api</artifactId> <version>LATEST</version> </dependency> <dependency> <groupId>org.apache.maven.plugin-tools</groupId> <artifactId>maven-plugin-annotations</artifactId> <version>LATEST</version> <scope>provided</scope> </dependency> </dependencies> 写代码实现AbstractMojo @Mojo(name="xlxTest",defaultPhase = LifecyclePhase.PACKAGE) public class Test extends AbstractMojo { /** * 接收的参数 */ @Parameter private String message; /** * 接收多个值的参数 */ @Parameter private List<String> options; /** * 命令行中接收,注意必须有property mvn:package -Dargs=this is from cmd */ @Parameter(property = "args") private String args; public void execute() throws MojoExecutionException, MojoFailureException { System.out.println("my first maven plugin message is : " + message); System.out.println("my first maven plugin options is : " + options); System.out.println("my first maven plugin args from evm is : " + args); } } mvn install 使用, maven可以接收参数, 也可以使用环境变量取,如${settings.localRepository},${project.baseUri}等 <!--项目pom修改--> <build> <plugins> <plugin> <groupId>com.xlx</groupId> <artifactId>engineering</artifactId> <version>1.0-SNAPSHOT</version> <executions> <execution> <phase>package</phase> <goals> <goal>xlxTest</goal> </goals> </execution> </executions> <configuration> <message>message</message> <options> <option>one</option> <option>two</option> </options> </configuration> </plugin> </plugins> </build> Profile 不同运行环境 dev/prod/test等 mvn clean package –P dev settings.xml 可以指定不同服务器仓储配置<profile.active>私服或者官方</profile.active> 多环境配置的配置文件路径 <profiles> <profile> <id>dev</id> <properties> <profile.active>dev</profile.active> </properties> <activation> <activeByDefault>true</activeByDefault> </activation> </profile> <profile> <id>test</id> <properties> <profile.active>test</profile.active> </properties> </profile> </profiles> <build> <resources> <resource> <directory>${baseDir}/src/main/resources</directory> <excludes> <exclude>conf/**</exclude> </excludes> </resource> <resource> <directory>src/main/resources/conf/${profile.active}</directory> </resource> </resources> </build> 私服 下载: https://www.sonatype.com/download-oss-sonatype?hsCtaTracking=920dd7b5-7ef3-47fe-9600-10fecad8aa32%7Cf59d5f10-099f-4c66-a622-0254373f4a92 安装, 解压即可, 如果需要修改端口号等信息, 可以修改文件\nexus-3.13.0-01\etc\nexus-default.properties 启动命令 转到\nexus-3.13.0-01\bin下, nexus /run 可查看启动日志 使用: http://books.sonatype.com/nexus-book/reference3/index.html pom中增加发布节点 <distributionManagement> <repository> <id>nexus-release</id> <name>nexus-release</name> <url>http://localhost:8099/repository/maven-releases/</url> </repository> <snapshotRepository> <id>nexus-snapshot</id> <name>nexus-snapshot</name> <url>http://localhost:8099/repository/maven-snapshots/</url> </snapshotRepository> </distributionManagement> 修改settings.xml 增加服务器账号密码信息 <server> <id>nexus-release</id> <username>admin</username> <password>admin123</password> </server> <server> <id>nexus-snapshot</id> <username>admin</username> <password>admin123</password> </server> 生成脚手架 mvn archetype: create-from-project 从项目生成脚手架 cd /target/generated-soource/archetype 转到此目录 mvn install 发布到仓库 可以添加到ide的脚手架列表 mvn archetype:generate –DarchetypeCatagory=local 命令行方式创建项目 local参数指定走本地仓库

优秀的个人博客,低调大师

Jenkins 2.32.3参数化构建ant项目

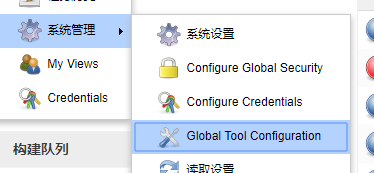
Jenkins端 项目端 重要部分说明 Jenkins端 1.基本配置同maven配置即可,注意事项:参数不需要增加双引号 构建:使用ant进行构建,此处的ant需在系统设置中先配置好 项目端 使用ant调用java代码来获取svn提交记录,并产生小包和日志 新增build.xml 重要部分说明 申明执行环境 执行java代码: 2.1. 使用java 标签来执行指定路径java类的main方法,java标签中classpath为java类编译后所在路径 2.2. java标签中classpath 为class文件执行所需的运行环境 2.3. java标签中arg 为传递给main函数的参数,使用${}来获取Jenkins传递的参数 来自为知笔记(Wiz)

优秀的个人博客,低调大师

Jenkins 2.32.3参数化构建maven项目

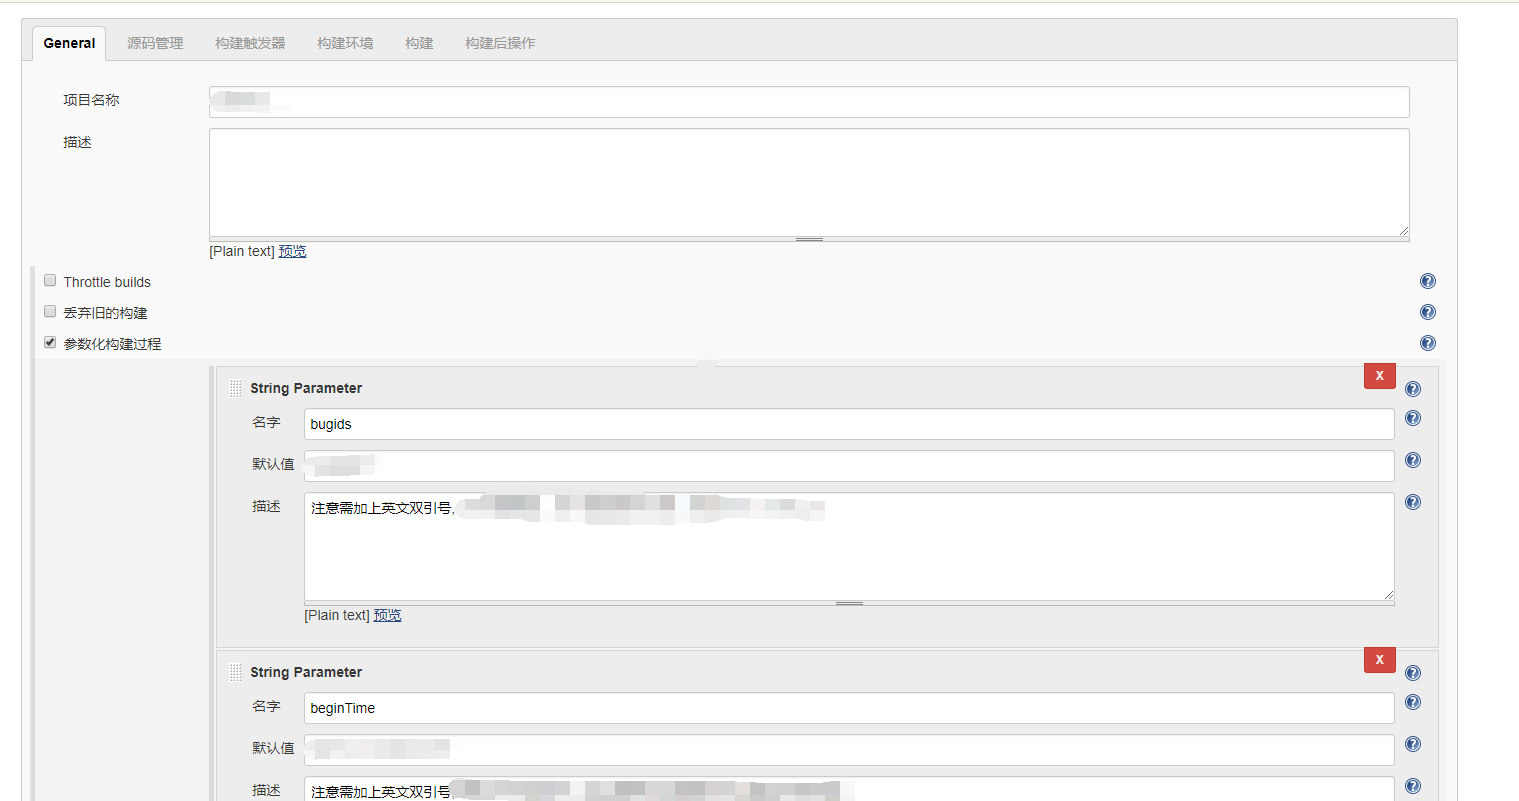
场景描述 使测试人员可依据开发提交的问题编号更精确的提取升级包 Jenkins项目配置 基础配置:注意事项输入的参数需增加双引号 源码管理: 构建:注意事项:-Dbugids=%bugids% -DbeginTime=%beginTime% -DendTime=%endTime%,这一段为传递到maven中的参数需和参数配置中名字保持一致, maven命令中需增加test命令 JAVA项目端配置 简介:使用org.testng来接收Jenkins传递的参数,在测试方法中执行java类来进行捞取提交日志,并复制提交文件到升级包的操作. pom.xml 在properties中增加提包所需的参数,需与Jenkins中参数名一致 使用maven-surefire-plugin来传递Jenkins中参数到java测试类中: java代码 在测试包中增加提包相关代码,并使用@Parameters注解来接收maven传递过来的参数 来自为知笔记(Wiz)

优秀的个人博客,低调大师

(一)Java工程化--Maven基础

Maven 读作['mevən] 翻译成中文是"内行,专家" Maven是什么 包依赖的前世今生: 原始的jar包引用--> ant --> maven. 是一种项目管理工具 Maven优势: convertion over configuration 约定优于配置: 这个原则不仅适用于maven, 更是目前大多数框架遵循的原则,如mvc 简单 易于测试 构建简单 CI(持续集成) 插件丰富 下载和安装 下载: http://maven.apache.org/download.cgi 安装: 解压安装即可 环境变量配置: windows: 配置path MAVEN_HOME linux: 在 .bash_profile 文件中 运行参数: 定义环境变量MAVEN_OPS 配置settings.xml: settings.xml文件是个空模板,我们可以在这个文件进行一些自定义配置. 常用的配置如:repo存储目录 创建maven项目 项目结构: 遵循约定优于配置原则, 项目包的组织结构如下 pom.xml groupId 公司组织id artifactId 功能命名 version 版本号 packageing 打包方式,默认jar,可修改为maven-project,war dependancyManagement 最好之出现在父pom中,用于统一版本号,只做声明依赖,子模块pom中还需要引用,但不需要制定version. dependancy type 默认jar scope 指定哪个阶段适用,各阶段如下: compile 编译,打包,默认 如spring-core test 测试 如spring-test provided 编译 如servlet runtime 运行时 如JDBC驱动实现包 system 本地一些jar 依赖传递 依赖仲裁:(1)最短路径原则,根据依赖树就近取最接近的版本;(2)加载顺序原则;(3)exclusions 排除包 命令: mvn dependancy:tree Maven生命周期(三个过程) 区分术语:lifecycle/phase/goal 生命周期: clean 包含的phase: pre-clean --> clean --> post-clean default compile package install deploy ... site pre-site --> site -->post-site --> site-deploy A Build Lifecycle is Made Up of Phases 一个构建生命周期是有多个phase组成 A Build Phase is Made Up of Plugin Goals 一个构建phase是由多个插件目标goal构成

优秀的个人博客,低调大师

Python数据持久化-csv、excel篇

2018年7月4日笔记 学习目标: 1.会使用Python第三方模块操作CSV文件 2.会使用Python第三方模块操作EXCEL文件 本章内容: Python操作CSV:什么是CSV、Python如何操作CSV文件、Python如何写入CSV文件 Python操作EXCEL:利用xlrd模块操作Excel、利用xlwt模块写入EXCEL、xlutils结合xlrd操作EXCEL Python操作CSV 1.什么是CSV CSV是一种通用的,相对简单的文件格式,被用户、商业和科学广泛应用。最广泛的应用是在程序之间转移表格数据,而这些程序本身是不兼容的格式上进行操作的。因为大量程序都支持CSV变体,至少是作为一个可选择的输入/输出格式。 例如,一个用户可以需要交换信息,从一个私有格式存储数据的数据库程序,得到一个数据格式完全不同的电子表格。最有可能的情况是,该数据库程序被导出数据为“CSV”,然后被导出的CSV文件可以被电子表格程序导入。 “CSV”并不是一种单一的、定义明确的格式。因此在实践中,术语“CSV”泛指具有以下特征的任何文件: 纯文本,使用某个字符,比如ASCII、Unicode、EBCDIC或GB2312,由记录组成; 每条记录被分隔符分隔为字段(典型分隔符有逗号、分号或制表符); 有时分隔符可以包括可选的空格; 每条记录都有同样的字段序列。 2.读取csv文件 运行代码的py文件所在的文件夹需要有销售相关企业信息.csv这个文件, 此文件下载链接: https://pan.baidu.com/s/1j8_kSiEFoB_lrLPNSJAiSw 密码: 8248 文件下载后要和被执行的py文件放到同一级目录下 import csv if __name__ == "__main__": with open("销售相关企业信息.csv") as csvFile: reader = csv.reader(csvFile) print(type(reader)) for i in reader: print(i,type(i)) 上面一段代码的运行结果如下: <class '_csv.reader'> ['类别编号', '类别名称', '说明'] <class 'list'> ['1', '饮料', '软性饮料,咖啡,啤酒,及麦酒'] <class 'list'> ['2', '调味品', '甜酸酱,配料,涂料,及香料'] <class 'list'> ['3', '点心', '甜点心,糖果,甜面包'] <class 'list'> ['4', '日用品', '寿司'] <class 'list'> ['5', '谷类/麦片', '面包,饼干,面团,麦片'] <class 'list'> ['6', '肉/家禽', '肉品'] <class 'list'> ['7', '特制品', '水果干及豆腐'] <class 'list'> ['8', '海鲜', '海带及鱼类'] <class 'list'> 3.写入csv文件 import csv if __name__ == "__main__": with open("./csvTest.csv","w") as csvfile: writer = csv.writer(csvfile) writer.writerow(['id','url','keywords']) data = [ ['1','http://www.baidu.com','百度'], ['2','http://www.tmall.com','天猫'], ['3','http://www.jd.com','京东'] ] writer.writerows(data) 上面一段代码运行产生的csv文件如下图所示: 图片.png-7.6kB 让产生的csv文件不空行,只需要在open函数内添加参数newline='' import csv if __name__ == "__main__": with open("./csvTest.csv",\ "w",newline='') as csvfile: writer = csv.writer(csvfile) writer.writerow(['id','url','keywords']) data = [ ['1','http://www.baidu.com','百度'], ['2','http://www.tmall.com','天猫'], ['3','http://www.jd.com','京东'] ] writer.writerows(data) 上面一段代码运行产生的csv文件如下图所示: 图片.png-4.4kB 4.小结 简述Python如何读写csv open()函数产生的文件赋值给file变量. 用csv.reader(file)产生一个reader用来读文件,reader是一个可迭代对象,数据类型为csv.reader 用csv.writer(file)产生一个writer用来写文件,reader是一个可迭代对象,数据类型为csv.writer Python操作Excel 1.利用xlrd模块读取Excel 运行代码的py文件所在的文件夹需要有某公司贸易数据.xlsx这个文件, 此文件下载链接: https://pan.baidu.com/s/1shU7evZJ8KFEmNAqoMwlBw 密码: wr7q 文件下载后要和被执行的py文件放到同一级目录下 1.1 读取excel文件工作表中第1个工作薄的第1行。 import xlrd if __name__ == "__main__": excel = xlrd.open_workbook('某公司贸易数据.xlsx') sheet = excel.sheets()[1] row = sheet.row_values(0) print(row) 上面一段代码的运行结果如下: ['产品编号', '产品', '供应商编号', '类别编号', '单位数量', '单价', '库存量', '已订购量', '安全存量', '不再销售'] 1.2 读取excel文件工作表中第2个工作簿的第4行第3列的数据 import xlrd if __name__ == "__main__": excel = xlrd.open_workbook('某公司贸易数据.xlsx') sheet = excel.sheets()[1] cell = sheet.cell(3,2) print(cell,type(cell)) cellValue = sheet.cell(3,2).value print(cellValue,type(cellValue)) 上面一段代码的运行结果如下: text:'1' <class 'xlrd.sheet.Cell'> 1 <class 'str'> 1.3 对excel文件的每一行进行循环遍历 import xlrd if __name__ == '__main__': excel = xlrd.open_workbook("某公司贸易数据.xlsx") sheet = excel.sheet_by_index(0) for i in range(sheet.nrows): print(sheet.row_values(i)) 上面一段代码的运行结果如下: ['类别编号', '类别名称', '说明'] ['1', '饮料', '软性饮料,咖啡,啤酒,及麦酒'] ['2', '调味品', '甜酸酱,配料,涂料,及香料'] ['3', '点心', '甜点心,糖果,甜面包'] ['4', '日用品', '寿司'] ['5', '谷类/麦片', '面包,饼干,面团,麦片'] ['6', '肉/家禽', '肉品'] ['7', '特制品', '水果干及豆腐'] ['8', '海鲜', '海带及鱼类'] 1.4 对excel文件的每一列进行循环遍历 import xlrd if __name__ == '__main__': excel = xlrd.open_workbook("某公司贸易数据.xlsx") sheet = excel.sheet_by_index(0) for i in range(sheet.ncols): print(sheet.col_values(i)) 上面一段代码的运行结果如下: ['类别编号', '1', '2', '3', '4', '5', '6', '7', '8'] ['类别名称', '饮料', '调味品', '点心', '日用品', '谷类/麦片', '肉/家禽', '特制品', '海鲜'] ['说明', '软性饮料,咖啡,啤酒,及麦酒', '甜酸酱,配料,涂料,及香料', '甜点心,糖果,甜面包', '寿司', '面包,饼干,面团,麦片', '肉品', '水果干及豆腐', '海带及鱼类'] 2.利用xlwt模块写入Excel 新建一个excel,第1行第2列写入内容excel test,保存文件,命名为excelTest.xls import xlwt if __name__ == "__main__": excel = xlwt.Workbook() sheet = excel.add_sheet("表01") sheet.write(0,1,'excel test') excel.save("excelTest.xls") 上面一段代码运行截图如下: image_1chqns1mi15pnr4l1564qrdovg9.png-26.7kB 3.利用xlutils结合xlrd操作Excel 修改excel文件中的第2行第3列的值为酒,之前该格子的内容为"软性饮料,咖啡,啤酒,及麦酒" import xlrd from xlutils.copy import copy if __name__ == "__main__": excel = xlrd.open_workbook("某公司贸易数据.xlsx") excelNew = copy(excel) sheet = excelNew.get_sheet(0) sheet.write(1,2,"酒") excelNew.save("某公司贸易数据(修改1).xls") image_1chqof3tk4v4frq1dla4501fntm.png-23kB 4.利用openpyxl操作Excel 利用get_sheet_names获取所有工作簿的名字,openpyxl库访问第1行第3列是sheet.value(1,3) from openpyxl import load_workbook if __name__ == '__main__': excel = load_workbook("某公司贸易数据.xlsx") sheetNames = excel.get_sheet_names() print(sheetNames) sheet = excel.get_sheet_by_name("客户") for i in range(1,5): print(sheet.cell(row=i,column=3).value) sheet['C3'] = "张先生" print("修改excel文件后,再次打印:") for i in range(1,5): print(sheet.cell(row=i,column=3).value) 上面一段代码运行结果如下: ['产品类别', '产品资料', '订货明细', '订货主档', '员工', '商品供应', '客户', '货运公司'] 联系人 陈小姐 黄小姐 胡先生 修改excel文件后,再次打印: 联系人 陈小姐 张先生 胡先生 作业 image_1chqq144d12icgobgtm107hj7t13.png-65.4kB import xlwt if __name__ == '__main__': excel = xlwt.Workbook() sheet = excel.add_sheet("sheet1") table = [['姓名','分数'],['小明','80'],['小王','90'],['小刚','100']] for i in range(len(table)): for j in range(len(table[i])): sheet.write(i,j,table[i][j]) excel.save("excelTest.xls")
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册