首页 文章 精选 留言 我的

精选列表

搜索[诊断自动化],共10000篇文章
优秀的个人博客,低调大师

连载|想用Python做自动化测试?递归函数

“递归函数就是函数内部调用自身,可以使代码逻辑更加易懂。但是递归也有坑,需要避免。” 13.1 概念 在函数内部,可以调用其他函数。如果一个函数在内部调用自身,这个函数就是递归函数。 理论上,所有的递归函数都可以写成循环的方式,但循环的逻辑不如递归清晰。 计算阶乘n! = 1 x 2 x 3 x ... x n,用函数fact(n)表示: def fact(n): if n==1: return 1 return n * fact(n - 1) 13.2 写递归代码的套路 写递归代码的关键就是找到如何将大问题分解为小问题的规律,然后按照下面套路即可实现: 第一步,写出递推公式 以计算阶乘为例,递归公式是:fact(n)=n!=n×(n−1)×⋅⋅⋅3×2×1=n×(n−1)!=n×fact(n−1) 第二步,推敲终止条件 以计算阶乘为例,终止条件是n=1时,fact(1)=1。 13.2.1 斐波那契数列 再来看一个斐波那契数列的例子,斐波那契数列中后一个元素是前两个相邻元素的和。比如: 0,1,1,2,3,5,8,13,21,34,55,…。 那么我们如何得到第n个数是多少?分两步走: 第一步,写出递推公式。求第n个元素,可以先求出n-1和n-2个元素的值,然后再将这两个求和,所以公式是: fibonacci(n) = fibonacci(n - 1) + fibonacci(n - 2) 第二步,推敲最终终止条件。终止条件包含三个:n=0时,f(n)=0;n=1时,f(n)=1;n=2时,f(n)=1。 if n < 1: # 递归终止条件 return 0if n in [1, 2]: # 递归终止条件 return 1 转换成完整代码就是: def fibonacci(n): if n < 1: # 递归终止条件 return 0 if n in [1, 2]: # 递归终止条件 return 1 return fibonacci(n - 1) + fibonacci(n - 2) # 递归公式 不管是编写递归还是阅读递归代码,只要遇到递归,我们就把它抽象成一个递推公式,不用想一层层的调用关系,不要试图用人脑搞清楚计算机每一步都是怎么执行的。 13.2.2 n 个台阶有多少种走法 再来看看一个例子,假如有 n 个台阶,每次可以跨 1 个台阶或者 2 个台阶,请问走这 n 个台阶有多少种走法? 我们从第一步开始想,如果第一步跨1个台阶,问题就变成了n-1个台架有多少种走法。如果第一步跨2个台阶,问题就变成n-2个台阶有多少种走法。我们把n-1个台阶的走法和n-2个台阶的走法求和,就是n个台阶的走法。用公式表示就是f(n)=f(n-1)+f(n-2)。这就是递归公式了。 再来看看终止条件,最后1个台阶就不需要再继续递归了,只有一种走法,就是f(1)=1。我们把这个放到递归公式里面看下,通过这个终止条件能否求出f(2),发现f(2)=f(1)+f(0),也就是仅知道f(1)是不能求出f(2)的,因此要么知道f(0)的值,或者直接将f(2)作为一个递归终止条件。f(0)表示0个台阶有几种走法,f(2)表示2个台阶有几种走法。明显,f(2)更容易理解一些。所以定为f(2)=2也是一个终止条件,表示最后2个台阶有两种走法,即一次跨1个台阶和一次跨2个台阶。有了f(1)和f(2),就能求出f(3),进而求出f(n)了。 转化成代码即是: def walk(n): if n == 1: # 递归终止条件 return 1 if n == 2: # 递归终止条件 return 2 return walk(n - 1) + walk(n - 2) # 递归公式 13.3 递归可解决哪类问题 原始问题的解可以分解为几个子问题的解 原始问题和子问题,只有数据规模的不同,求解思路完全一样 存在递归终止条件 13.4 递归存在的问题 堆栈溢出 重复计算 编写递归代码时,我们会遇到很多问题,比较常见的一个就是堆栈溢出,而堆栈溢出会造成系统性崩溃,后果会非常严重。什么是堆栈溢出呢? 函数调用会使用栈来保存临时变量。每调用一个函数,都会将临时变量封装为栈帧压入内存栈,等函数执行完成返回时,再出栈。系统栈或者虚拟机栈空间一般都不大。如果递归求解的数据规模很大,调用层次很深,一直压入栈,就会有堆栈溢出的风险。 可以通过Pycharm工具查看调用栈的情况。在递归公式那行代码上添加断点,不断执行Step Over,可以看到Frames窗口中的栈信息会不断增加和减少,当调用一次函数会增加一帧,当调用返回后会减少一帧。最后返回第一层栈func.py。前面说的堆栈溢出的风险,体现在Frames窗口中的栈帧太多了。 那么,如何避免出现堆栈溢出呢? 通常可以在代码中限制递归调用的最大深度的方式来解决这个问题。比如Python语言,限制了递归深度,当递归深度过高,则会抛出:RecursionError: maximum recursion depth exceeded in comparison异常,防止系统性崩溃。 我们在代码中也可以自己设置递归的深度,比如限制n最大不能超过100,代码如下: def walk(n): if n == 1: return 1 if n == 2: return 2 if n > 100: raise RecursionError("recursion depth exceede 100") return walk(n - 1) + walk(n - 2) 除此之外,使用递归时还会出现重复计算的问题。什么意思?拿走台阶那个例子来说明。比如计算6个台阶的走法f(6),过程如下图: 从图中,我们可以直观地看到,想要计算 f(5),需要先计算 f(4) 和 f(3),而计算 f(4) 还需要计算 f(3),因此,f(3) 就被计算了很多次,这就是重复计算问题。 那么怎么解决这个问题?为了避免重复计算,我们可以通过字典保存已经求解过的 f(k)。当递归调用到 f(k) 时,先看下是否已经求解过了。如果是,则直接从字典中取值,不需要重复计算,这样就能避免刚讲的问题了。 修改下计算台阶走法的代码,解决重复计算的问题: data = dict() # 保存中间结果def walk(n): if n == 1: return 1 if n == 2: return 2 if n > 100: raise RecursionError("recursion depth exceed 100") if n in data: # 如果在中间结果中,则直接返回,不用进入递推公式再次计算 return data[n] result = walk(n - 1) + walk(n - 2) # 在递归公式前面增加个查找步骤 data[n] = result # 将计算结果保存在中间结果data字典中 return resultprint(walk(6)) 本文分享自微信公众号 - 明说软件测试(liuchunmingnet)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

GitLab+Docker搭建CI/CD自动化部署

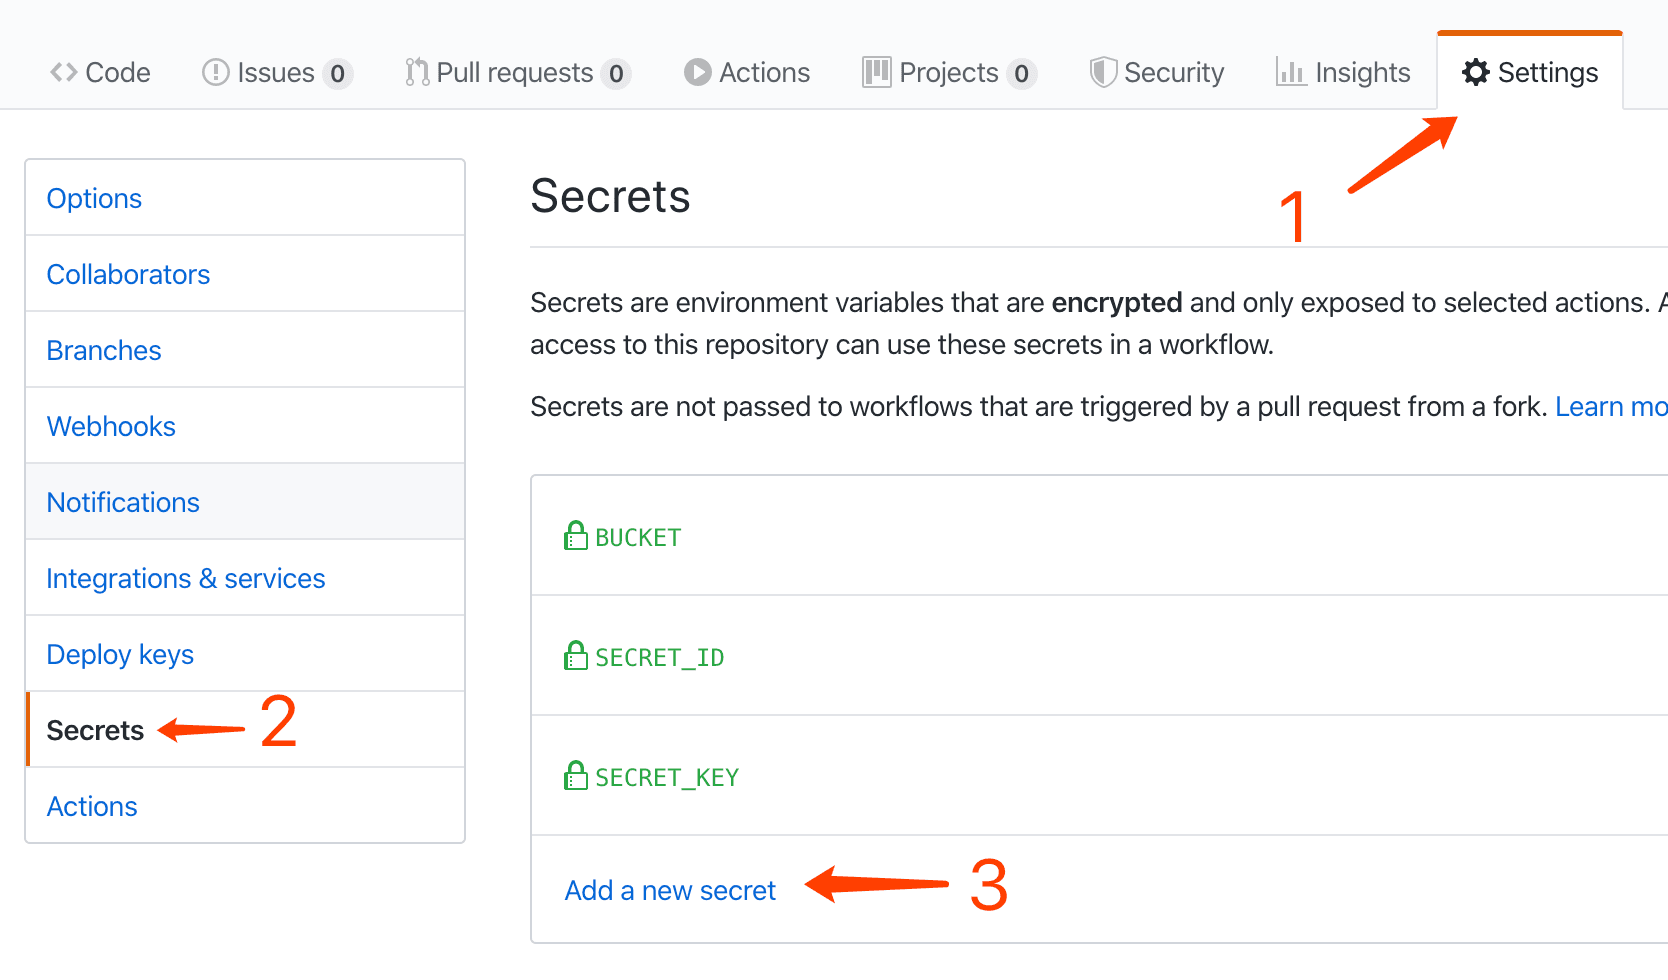
1.使用场景CICD,顾名思义就是持续集成(Continuous Integration)和持续部署(Continuous Deployment)简称,指在开发过程中自动执行一系列脚本来减低开发引入 bug 的概率,在新代码从开发到部署的过程中,尽量减少人工的介入。以前的老技术,比如git/svn+jenkins这种,jenkins的配置多数还是依赖于负责维护CI的人,很多人不熟悉jenkins怎么配置,每一个步骤应该怎么编译和测试,一般都由CI的人来定义。而CICD,其实可以使用jenkinsfile,就象gitlab的 .gitlab-ci.yaml文件,把CICD的流程控制和步骤也作为开发的一部分,由开发去维护。并且可以很快的部署到多个环境。持续集成持续集成指在和向远程仓库 push 代码后,在这次提交合并入主分支前进行一系列测试,构建等流程。假设现在有个应用的代码存储在 gitlab 上,每天开发者都 push 很多次提交,针对每次 push,你可以创建一系列脚本进行自动测试,降低往应用里引入错误的概率。这就是持续集成,它可应用在包括开发分支在内的多个分支上。持续部署持续部署在持续集成的基础上更进一步,指将推送指仓库默认分支的部署至产品环境。如果这部分需要手动触发,这就是一个持续交付(Continuous Delivery)环节。 安装环境Gitlab 内置了 CICD 工具,不需要使用第三方工具。使用gitlab的CICD流程,使用物联管理平台项目为例子。搭建一个pipe。一旦提交代码,自动将物联管理平台部署到docker(k8s集群)中。 使用到的技术有: docker,gitlab-runner,linux shell,(k8s,helm)环境:IP 安装软件172.26.67.109 docker、gitlab172.26.67.108 docker、gitlab-runner 2.1 安装docker和docker-compose在两台服务器上安装docker,百度或参考以前写的《Centos7下安装Docker.docx》、《通过 docker-compose 快速构建部署.docx》2.2 安装gitlab在172.26.67.109上使用docker安装gitlab在172.26.67.109上编写一个docker-compose.yml文件version: '3'services: gitlab: image: twang2218/gitlab-ce-zh restart: always container_name: "gitlab" privileged: true hostname: "172.26.67.109" environment: GITLAB_OMNIBUS_CONFIG: | external_url 'http://172.26.67.109' gitlab_rails["time_zone"] = "Asia/Shanghai" gitlab_rails["gitlab_shell_ssh_port"] = 1222 nginx["listen_port"] = 80 ports: - "80:80" - "8443:443" - "1222:22" volumes: - ./gitlab/config:/etc/gitlab - ./gitlab/data:/var/opt/gitlab - ./gitlab/logs:/var/log/gitlab - "/etc/localtime:/etc/localtime:ro" 然后docker-compose up -d运行𧘖安装gitlab,𧘖安装后浏览器打开http://172.26.67.109 创建组、用户、项目等2.3 安装gitlab-runner在172.26.67.108上使用docker安装gitlab-runner在172.26.67.108上编写一个docker-compose.yml文件version: '3'services: gitlab-runner: container_name: gitlab-runner restart: always privileged: true image: gitlab/gitlab-runner volumes: - "/var/run/docker.sock:/var/run/docker.sock" - "./gitlab-runner/config:/etc/gitlab-runner" - "/etc/localtime:/etc/localtime:ro" 然后docker-compose up -d运行𧘖安装gitlab-runner,然后注册gitlab-runner到gitlab上1、从gitlab上获取注册令牌 2、注册gitlab-runnerdocker exec -it gitlab-runner gitlab-ci-multi-runner register -n \ --url http://172.26.67.109/ \ --registration-token XXXXXXXXXXXS5UDqw \ --tag-list=dev,uat,prod \ --description "project_build_runner" \ --docker-privileged=false \ --docker-pull-policy="if-not-present" \ --docker-image "livingobjects/jre8" \ --docker-volumes /var/run/docker.sock:/var/run/docker.sock \ --docker-volumes /opt/data/gitlab-runner/.m2:/root/.m2 \ --executor docker 在gitab上可以看到己注册的gitlab-runner 持续集成、部署使用 Gitlab 的 CICD ,只需要在 Gitlab 的仓库的根目录中添加 .gitlab-ci.yml 文件。 这个文件中,可以定义CICD 的各个环节,配置每个环节执行的命令,触发方式等。这个配置文件其实就是按照 YAML 规定了一些结构的 shell 脚本,里面的命令会在符合条件时逐一执行。一旦在仓库中添加这个文件,Gitlab 会检测到它并用名为 Gitlab Runner 工具执行它。每次触发的 CICD 会把配置中的脚划分为不同的 job,多个 job 组成一个 pipeline。最简单的 .gitlab-ci.yml 文件可以包含:before_script: apt-get install rubygems ruby-dev -yrun-test: script: - ruby --version 其中 before_scripts 属性会在执行任一脚本前预装一些需要的依赖(类似 unittest 的 setUp 方法),此后名为 run-test 的脚本会显示当前系统的 ruby 版本。这两个步骤组成了一个 pipeline 会在这个仓库的每次push后执行。这行任务的执行情况也可以在 Gitlab 的对应页面上查看,就像在 Terminal 中看日志一样。 而每个 pipeline 的 job 的执行情况也可以在页面上查看 如果中途报错了,可以一键回滚 CICD 工作流假设你在本地修改了一些代码以增加一些特性,当你把这些改动 push 到远程仓库的特性分支后,项目里设定的 CICD pipeline 就被触发了,一般流程如下:运行自动脚本(串行或并行): 构建并测试应用 在合并前 review 改动上述流程如果没有问题就可以把改动合并入主分支,CD 会自动把它部署到产品中,如果发现了任何问题,还能一键回滚。工作流程图如下: 该图简要显示了基本的工作流,想要了解 Gitlab CICD 的更多特请,请参阅CICD 索引表.gitlab-ci.yml 文件结构.gitlab-ci.yml 是指定了 CICD 相关配置的 YAML 文件。(YAML 是专门用来写配置文件的语言,简洁强大,和 python 一样用缩进代表层级,表达能力和 JSON 基本一致,但格式更方便。一般而言,CICD 过程会包含如下最外层的 key:stages: 定义整个 CICD pipeline 的 job 数量和名称variables: 定义 CICD 流程中的一些环境变量before_scripts: 在每个 job 的 scripts 执行前进行的命令集,一般是创建目录,打印 context 目录等操作,可类比 unittest 的 setUp 方法stage: 定义了一个 job 的具体流程,可以在前面加上名称下面通过一个例子进行一些讲解stages: test build deployvariables: GIT_STRATEGY: none PROJECT_REPO_NAMESPACE: test PROJECT_REPO_NAME: cicd_learn DEPLOYMENT_REPO_NAMESPACE: test DEPLOYMENT_REPO_NAME: deploy_testbefore_script: export ROOT_PATH=$(pwd) echo 'root path:' $ROOT_PATH mkdir $PROJECT_REPO_NAME cd $PROJECT_REPO_NAME echo 'date:' $DATEtest_stage: stage: test script: - <test related command here> artifacts: paths: - xxxx.html when: always allow_failure: falsebuild_stage: stage: build script: - <build related command here> when: manual allow_failure: false only: - master deploy: stage: deploy script: - <deploy related command here> allow_failure: false only: - master stages例子中 stages 值为一个数组(p.s. 用 - 代表数组和 markdown 类似)。包含了三个 job,test, build, deploy分别实现自动测试,打包项目和部署。下方的 stage 必须在全局定义的 stages 内。variables值为键值对象,为了后续的流程,此处定义了开发项目和部署项目的 namespace 和 repo_name。同 shell 类似,后续使用其值需要加上 $ 符号。定义的变量也有对应的作用域,定义在顶层就可以作为全局变量供所有 job 使用,如果是一些 job 特有的变量,就定义在 job 内部。before_script值为数组,每一个元素其实就是一个 linux 命令,写的时候装作自己在写 shell 就好。该部分主要生成了后续构建需要的镜像标签,切换当前目录等。为了 debug 方便,这些变量最好打印。类似的,如果在 job 完成后有一些时候操作,可以定义 after_script。需要注意的是如果定义在顶层,内部的命令会在每个 job 运行之前执行,如果某些 job 需要特别的预操作,可以在 job 内部再配置一个 before_script 对象,它会复写外部的全局预操作。test_stage名为 test 的 job 的具体配置,一般是个复合对象。stagejob 对应的 stage,如果有多个 job 对应同一个 stage,在执行时会并行执行这些 job。script这个 job 执行的命令,此处是进入的项目仓库目录,并且执行了一个 shell 脚本,这个脚本定义了执行项目的所有单元测试。一般建议如果要执行的命令过多,就把这些命令写成脚本放在项目内。CICD 流程直接执行这个脚本。artifacts这个对象用来定义 job 的产出,比如我们让 test_stage 产出一个 html 格式的报告,显示每个单元测试的执行情况(报告生成相关代码写在项目内)。 数组内 paths 和 when 分别定义报告的路径和产出场景。此处表示报告放置于根目录下,任何时候都要提供报告。设定正确后,就可以 Gitlab 的 pipline 页面上可以下载相关文件。allow_failure见名知意,如果值为 true,那么即使没通过测试,也可以执行后续的 job.build_stage该步骤在测试通过的基础上,把项目编译打包,方便后续部署。when此处的 when 定义在 job 内的顶层,值为 manual 表示其需要在 Gitlab 上手动触发(页面上点击按钮即可)。onlyonly 指明了 job 的执行场景,可以是分支名,表明只有 master 分支可以执行 build,如果要用排除法反向指定,可以用 except。deploy_stage所有的 key 现在你应该都了解了,这里不再赘述。这一步骤主要是将部署产品的服务器上的内容更新。

优秀的个人博客,低调大师

Gradle 6.1 发布,项目自动化构建工具

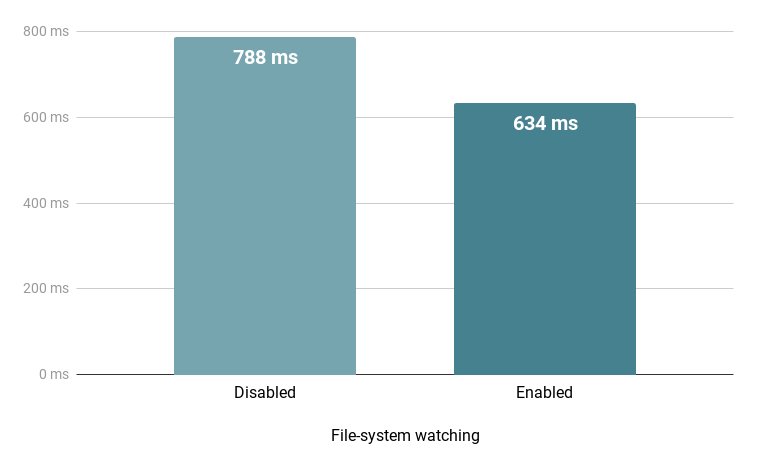
Gradle 6.1已发布,此版本支持可重定位的依赖项缓存,可配置 Java,Groovy 和 Scala 类之间的编译顺序,并启动了一组新的可下载示例。同时还修复了一些错误,为Gradle 插件作者提供了方便等等。 具体更新内容如下: Gradle 的依赖项缓存可以重定位 $GRADLE_HOME/caches/modules-2现在可以将 Gradle 6.1 和更高版本缓存的依赖项重新定位到 Gradle Dependency 缓存下。如果已经下载了依赖项,则将其移至新位置或植入主机映像后,使用依赖项缓存的构建将不需要访问网络即可下载工件或元数据。 请注意,应使用相同的Gradle版本对缓存进行初始化和使用,以达到最佳效果。有关更多详细信息,请参见文档。 Gradle 团队表示,这只是帮助使用临时 CI 代理的组织减少构建过程中下载依赖项的开销的第一步。 在Groovy,Scala和Java之间定义编译顺序 以前,Java,Groovy 和 Scala 编译之间的关系是在同一项目中使用显式任务依赖性进行硬编码的。Gradle 假定 Groovy 和 Scala 编译将始终依赖 Java 编译。也就是说,compileGroovy并且compileScala将直接取决于的输出compileJava。 这些任务依赖项已使用目录属性进行了重塑。编译任务之间的关系在任务的类路径中表示。从类路径中删除目录属性也会删除相应的任务依赖项。这可用于更改 Java,Groovy 和 Scala 编译任务之间的关系。 例如,在以前,当在同一项目中组合 Groovy 和 Kotlin 时,就很难使 Kotlin 类依赖于 Groovy 类。 tasks.named('compileGroovy') { // Groovy only needs the declared dependencies // and not the output of compileJava classpath = sourceSets.main.compileClasspath } tasks.named('compileKotlin') { // Kotlin also depends on the result of Groovy compilation // which automatically makes it depend of compileGroovy classpath += files(sourceSets.main.groovy.classesDirectory) } 可下载的 Gradle 示例 除了教程和指南以及广泛的用户手册,Gradle 现在还提供了样本索引,以演示可以使用 Gradle 构建的各种项目,例如Kotlin或Spring boot。这些样本还展示了可以使用 Groovy 或 Kotlin DSL 解决的常见问题,例如向 Java 项目添加集成测试。每个样本都捆绑了一个Gradle 包装器,因此用户甚至无需尝试就可以安装 Gradle。 这些示例使用与文档相同的 Gradle 版本进行测试。随着时间的推移将添加更多样本。如果您对问题或用例有任何建议,认为可以作为一个很好的例子,请打开一个新的问题。 使用 JDK8 + 对方法参数名称进行 Groovy 编译支持 Gradle 6.1 支持编译 Groovy 代码并包括方法参数名称。 插件作者的改进 仅在查询值时确定属性值 在以前的 Gradle 版本中,某些 Gradle 类型(例如Property或ConfigurableFileCollection)提供了一种finalizeValue()方法,可以急切地计算属性的最终值并防止进一步的更改。 当任务开始运行时,Gradle 会自动完成这些类型的任务属性,以便任务操作和 Gradle 的构建缓存/最新检查可以看到相同的值。这也避免了多次计算属性值,这有时可能很昂贵。插件还可以finalizeValue()在查询值之前用于完成其他属性,例如项目扩展的属性。 在此版本中,这些类型获得了一种新finalizeValueOnRead()方法。此方法与相似finalizeValue(),不同之处在于最终值是在查询值而不是立即查询时计算的。如果属性值的计算成本可能很高,或者尚未配置该值以确保该属性的所有使用方从此点开始都能看到相同的最终值,则插件可以使用此方法。 请参阅用户手册以了解更多详细信息。 New managed property types Gradle 5.5 引入了任务和其他类型的托管属性的概念,其中 Gradle 为在任务,项目扩展或其他自定义类型上定义的抽象属性提供了getter和setter的实现。通过删除一堆样板,这简化了插件的实现。 在此版本中,任务或其他自定义类型可能具有type的抽象只读属性DomainObjectSet<T>。 请参阅用户手册以了解更多详细信息。 New factory methods 该ObjectFactory类型(插件和其他自定义类型用于创建各种有用类型的实例)具有多种新的工厂方法来创建某些 Gradle 类型,这些类型只能使用以前的版本中的内部API来创建: polymorphicDomainObjectContainer()创建ExtensiblePolymorphicDomainObjectContainer<T>实例的方法。 namedDomainObjectSet()创建NamedDomainObjectSet<T>实例的方法。 namedDomainObjectList()创建NamedDomainObjectList<T>实例的方法。 请参阅用户手册以了解更多详细信息。 对 Gradle 工具提供商的改进 工具 API:TestLauncher可以运行特定的Test任务测试 TestLauncher通过指定测试类或方法的名称,Tooling API 中的接口已经可以启动测试。但是,如果有多个Test任务,则将Test执行所有任务。 对于 IDE,开发人员通常只希望一次只执行一个任务。Gradle 6.1 引入了新的 API,以Test使用withTaskAndTestClasses()和withTaskAndTestMethods()方法对特定任务执行测试。 发布说明 下载地址

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册