首页 文章 精选 留言 我的

精选列表

搜索[视频解析],共10000篇文章
优秀的个人博客,低调大师

LinkedIn架构演化历史解析

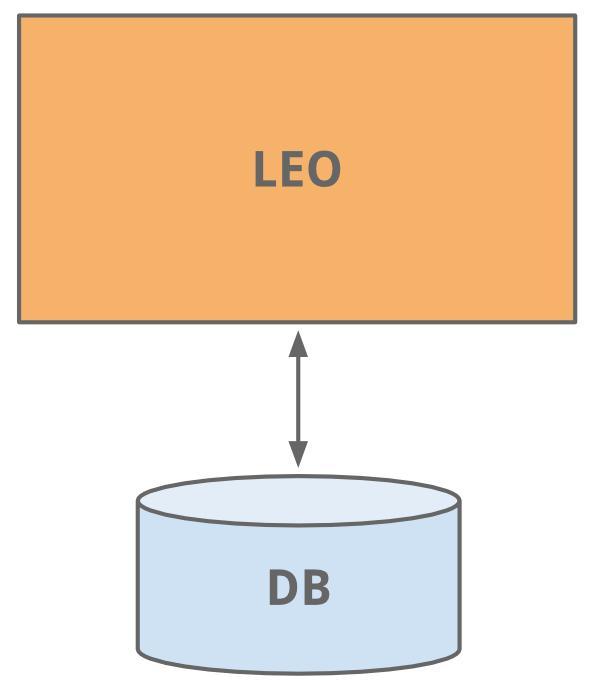
LinkedIn 创建于 2003 年,主要目标是连接你的个人人脉以得到更好的的工作机会。上线第一周只有 2700 个会员,之后几年,LinkedIn 的产品、会员、服务器负载都增长非常快。 今天,LinkedIn 全球用户已经超过 3.5 亿。我们每天每秒有上万个页面被访问,移动端流量已占到 50% 以上。所有这些接口请求都从后台获取,达到每秒上百万级。 那么,我们是怎么做到的呢? 早些年 – Leo LinedIn 开始跟很多网站一样,只有一台应用服务做了全部工作。这个应用我们给它取名叫“Leo”。它包含了所有的网站页面(JAVA Servlets),还包含了业务逻辑,同时连接了一个轻量的 LinkedIn 数据库。 哈!早年网站的形态-简单实用 会员图表 第一件要做的是管理会员与会员间的社交网络。我们需要一个系统来图形化遍历用户之间连接的数据,同时又驻留内存以达到有效和高性能。从这个不同的需 求来看,很明显我们需要可以独立可扩展的 Leo。一个独立的会员图示化系统,叫“云”的服务诞生了 – LinkedIn 的第一个服务。为了让图表服务独立于 Leo,我们使用了 Java RPC 用来通讯。 也大概在这期间我们也有搜索服务的需求了,同时会员图表服务也在给搜索引擎-Lucene 提供数据。 复制只读数据库 当站点继续增长,Leo 也在增长,增加了角色和职责,同时自然也增加了复杂度。负载均衡的多实例 Leo 运转起来了。但新增的负载也影响了 LinkedIn 的其它关键系统,如会员信息数据库。 一个通常的解决方案是做垂直扩展 – 即增加更多的 CPU 和内存!虽然换取了时间,但我们以后还要扩展。会员信息数据库受理了读和写请求,为了扩展,一个复制的从数据库出现了,这个复制从库, 是会员主库的一个拷贝,用早期的 databus 来保证数据的同步(现在开源了)。从库接管了所有的读请求,同时添加了保证从库与主库一致的逻辑。 当主-从架构工作了一段时间后,我们转向了数据库分区 当网站开始看起来越来越多流量,我们的应用服务 Leo 在生产环境经常宕机,排查和恢复都很困难,发布新代码也很困难,高可用性对 LinkedIn 至关重要,很明显我们要“干掉”Leo,然后把它拆分成多个小功能块和无状态服务。 面向服务的架构 – SOA 工程师从分解负担 API 接口和业务逻辑的微服务开始,如搜索、个人信息、通讯及群组平台,然后是展示层分解,如招募功能和公共介绍页。新产品和新服务都放在 Leo 之外了,不久,每个功能区的垂直服务栈完成了。 我们构建了从不同域抓取数据模型的前端服务器,用于表现层展示,如生成 HTML(通过 JSPs)。我们还构建了中间层服务提供 API 接口访问数据模型及提供数据库一致性访问的后端数据服务。到 2010 年,我们已经有超过 150 个单独的服务,今天,我们已经有超过 750 个服务。 因为无状态,可以直接堆叠新服务实例及用硬件负载均衡实现扩展。我们给每个服务都画了警戒红线,以便知道它的负载,从而制定早期对策和性能监控。 缓存 LinkedIn 可预见的增长,所以还需要进一步扩展。我们知道通过添加更多缓存可以减少集中压力的访问。很多应用开始使用如 memcached/couchbase 的中间层缓存,同时在数据层也加了缓存,某些场景开始使用 useVoldemort 提供预结果生成。 又过一了段时间,我们实际上去掉了很多中间层缓存,中间层缓存数据往往来自多个域,但缓存只是开始时对减少负载有用,但更新缓存的复杂度和生成图表变得更难于把控。保持缓存最接近数据层将降低潜在的不可控影响,同时还允许水平扩展,降低分析的负载。 Kafka 为了收集不断增长的数据,LinkedIn 开始了很多自定义的数据管道来流化和队列化数据,例如,我们需要把数据保存到数据仓库、我们需要发送批量数据到 Hadoop 工作流以分析、我们从每个服务聚合了大量日志、我们跟踪了很多用户行为,如页面点击、我们需要队例化 InMail 消息服务、我们要保障当用户更新个人资料后搜索的数据是最新的等等。 当站点还在增长,更多定制化管道服务出现了,因网站需要可扩展,单独的管道也要可扩展,有些时候很难取舍。解决方案是使用 kafka,我们的分布式发布-订阅消息平台。Kafka 成为一个统一的管道服务,根据提交的日志生成摘要,同时一开始就很快速和具有可扩展性。它可以接近于实时的访问所有数据源,驱动了 Hadoop 任务,允许我们构建实时的分析,广泛的提升了我们站点监控和告警的能力,同时支持将调用可视化。今天,Kafka 每天处理超过 5 亿个事件。 反转 扩展可从多个维度来衡量,包括组织结构。2011 年晚些时候,LinkedIn 内部开始一个创新,叫”反转”(Inversion)。我们暂停了新功能开发,允许所有的开发部门集中注意力提升工具和布署、基础架构及实用性开发。这对 于今天敏捷开发新的可扩展性产品很有帮助。 近几年 – Rest.li 当我们从 Leao 转向面向服务的架构后,之前基于 JAVA 的 RPC 接口,在团队中已经开始分裂了,并且跟表现层绑得太死,这,只会变得更坏。为了搞定这个问题,我们开发了一套新的 API 模型,叫 Rest.li,它是一套以数据为中心的架构,同时保证在整个公司业务的数据一致性且无状态的 Restful API。 基于 HTTP 的 JSON 数据传递,我们新的 API 最终很容易支持到非 java 编写的客户端,LinkedIn 今天依然主要用 Java,但同时根据已有的技术分布也利用了 Python、Ruby、Node.js 和C++。脱离了 RPC,同时也让我们从前端表现层及后端兼容问题解耦,另外, 使用了基于动态发现技术(D2)的 Rest.li,我们每个服务层 API 获得了自动负载均衡、发现和扩展的能力。 今天,LinkedIn 所有数据中心每天已经有超过 975 个 Rest.li 资源和超过千亿级 Rest.li 调用。 Rest.li R2/D2 技术栈 超级块 面向服务的架构对于域解耦和服务独立扩展性很有帮助,但弊端是,大都我们的应用都需要很多不同类型的数据,按序会产品数百个延伸的调用。这就是通常 说的“调用线路图”,或伴随着这么多延伸调用的“扇出”(fan-out)。例如,任何个人信息页都包含了远不止于相册、连接、群组、订阅、关注、博客、 人脉维度、推荐这些。调用图表可能会很难管理,而且只会把事件搞得越来越不规则。 我们使用了”超级块”的概念 – 一个只有单一 API 接口的群组化后台服务。这样可以允许一个小组去优化一个“块”,同时保证每个客户端的调用情况可控。 多数据中心 作为一个会员快速增长的全球化公司,我们需要将数据中心进行扩展,我们努力了几年来解决这个问题,首先,从两个数据中心(洛杉矶和芝加哥)提供了公 共个人信息,这表明,我们已经可以提供增强的服务用来数据复制、不同源的远程调用、单独数据复制事件、将用户分配到地理位置更近的数据中心。 我们大多的数据库运行在 Espresso(一个新的内部多用户数据仓库)。Espresso 支持多个数据中心,提供了主-主的支持,及支持复杂的数据复制。 多个数据中心对于高可用性具有不可思议的重要性,你要避免因单点故障不仅只导致某个服务失效,更要担心整个站点失效。今天,LinkedIn 运行了 3 个主数据中心,同时还有全球化的 PoPs 服务。 我们还做了哪些工作? 当然,我们的扩展故事永远不止这么简单。我们的工程师和运维团队这些年做了不计其数的工作,主要包括这些大的初创性的: 这些年大多关键系统都有自己的丰富的扩展演化历史,包括会员图表服务(Leo 之外的第一个服务),搜索(第二个服务),新闻种子,通讯平台及会员资料后台。 我们还构建了数据基础平台支持很长一段时间的增长,这是 Databus 和 Kafka 的第一次实战,后来用 Samza 做数据流服务,Espresso 和 Voldemort 作存储解决方案,Pinot 用来分析系统,以及其它自定义解决方案。另外,我们的工具也进步了,如工程师可自动化布署这些基础架构。 我们还使用 Hadoop 和 Voldemort 数据开发了大量的离线工作流,用以智能分析,如“你可能认识的人”,“相似经历”,“感觉兴趣的校友”及“个人简历浏览地图”。 我们重新考虑了前端的方法,加了客户端模板到混合页面(个人中心、我的大学页面),这样应用可以更加可交互,只要请求 JSON 或部分 JSON 数据。还有,模板页面通过 CDN 和浏览器缓存。我们也开始使用了 BigPipe 和 Play 框架,把我们的模型从线程化的服务器变成非阻塞异步的。 在代码之外,我们使用了 Apache 的多层代理和用 HAProxy 做负载均衡,数据中心,安全,智能路由,服务端渲染,等等。 最后,我们继续提升服务器的性能,包含优化硬件,内存和系统的高级优化,利用新的 JRE。 下一步是什么 LinkedIn 今天仍在快速增长,仍然有大量值得提升的工作要做,我们正在解决一些问题,看起来只解决了一部分 – 快来加入我们吧! 来源:51CTO

优秀的个人博客,低调大师

android studio lint基本解析

可访问性(accessibility) 1、Image without contentDescription图像没有内容描述 这个是需要对图片进行一个描述,不然会有警告,一般情况下进行统一的标识加入 android:c ontentDescription="@string/abc 正确性(correctness) 2、Attribute unused on older versions 旧版本中未使用的属性 3、Class is not registered in the manifest 类没有在清单中注册 没有注册的activity 4、Duplicate ids across layouts combined with include tags布局中重复的ids与包含标签相结合 引用的布局和父布局包含相同的id 5、Implied locale in date format 使用日期格式的默示语言环境 http://blog.csdn.net/revival_liang/article/details/51812723 时间声明问题 SimpleDateFormat format = new SimpleDateFormat("MM月dd日HH时mm分ss秒");//有报警问题 SimpleDateFormat format = new SimpleDateFormat("MM月dd日HH时mm分ss秒", Locale.getDefault()); 6、Incorrect order of elements in manifest 清单中元素的顺序不正确 有些权限需要写道application之前,示例极光的一个权限 <uses-permission android:name="packagename.permission.JPUSH_MESSAGE" /> 7、Layout Inflation without a Parent 父布局没有膨胀 示例 使用nullView view = inflater.inflate(R.layout.progressbar, null); 正确的使用 第三个参数设置为了true,表示将第一个参数所指定的布局添加到第二个参数的View中 LinearLayout ll = (LinearLayout) findViewById(R.id.ll); LayoutInflater inflater = LayoutInflater.from(this); inflater.inflate(R.layout.linearlayout, ll,true); 8、Missing commit() calls 失踪的commit()调用 一般报错 After creating a FragmentTransaction, you typically need to commit it as well fragmentTransaction = fragmentManager.beginTransaction(); fragmentTransaction.replace(R.id.xxxx, new xxxxFragment().newInstance(xxxx),"xxxx"); fragmentTransaction.commit(); 改为(暂未测试效果) fragmentManager.beginTransaction().replace(R.id.xxxx, new xxxxFragment().newInstance(xxxx),"xxxx").commit(); 9、Missing commit() on SharedPreference editor ` SharedPreferences.Editor edit = sp.edit(); edit.putString("isFirstLogin", "0"); edit.commit(); 改为 apply() ` 这两个方法的区别在于: apply没有返回值而commit返回boolean表明修改是否提交成功 apply是将修改数据原子提交到内存, 而后异步真正提交到硬件磁盘, 而commit是同步的提交到硬件磁盘,因此,在多个并发的提交commit的时候,他们会等待正在处理的commit保存到磁盘后在操作,从而降低了效率。而apply只是原子的提交到内容,后面有调用apply的函数的将会直接覆盖前面的内存数据,这样从一定程度上提高了很多效率。 apply方法不会提示任何失败的提示。 由于在一个进程中,sharedPreference是单实例,一般不会出现并发冲突,如果对提交的结果不关心的话,建议使用apply,当然需要确保提交成功且有后续操作的话,还是需要用commit的。 10、Nested scrolling widgets 嵌套滚动窗口小部件 scrollview中嵌套了listview 11、Obsolete Gradle Dependency 过时Gradle依赖 提示android 升级高版本 12、RecyclerView Problems recycleerview的问题 在onBindviewholder方法中不能使用position 应该使用holer.getAdapterPosition()来获取position 有时候在做item换位置时直接使用postiion会发生位置错误 无法获取到变换后的位置 13、ScrollView size validation scrollview大小的验证 ScrollView里的LinearLayout的高度应该使用wrap_content 14、Reference to an id that is not in the current layout 引用不在当前布局内的id 15、Target SDK attribute is not targeting latest version 目标SDK属性不是针对最新版本的 15、Unreachable state in a <selector> In a selector, only the last child in the state list should omit a state qualifier. If not, all subsequent items in the list will be ignored since the given item will match all 在选择器中,只有状态列表中的最后一个子应该省略一个状态限定符。如果没有,则列表中的所有后续项都将被忽略,因为给定的项将匹配所有项 16、Using deprecated resources 过时的方法 17、Using inlined constants on older versions quanxu Internationalization 国际化 18、Hardcoded text 硬编码 https://toutiao.io/posts/572671/app_preview 19、TextView Internationalization java 代码中使用的汉字应使用常量来代替(个人建议) 20、 Bidirectional Text 双向设置 如 :android:paddingLeft="15dp" 需要设置两侧对应android:paddingLeft="15dp" android:paddingRight="15dp" Performance 性能 21、FrameLayout can be replaced with <merge> tag FrameLayout可以替换为<merge>标签 MergeRootFrame 如果FrameLayout是根布局,并且不提供背景或填充等,它通常可以替换为稍微更有效的<merge>标签。请注意,这取决于上下文,因此请确保在继续之前了解<merge>标记的工作原理。 22、Handler reference leaks handle引起程序泄露参考 因为同一个线程下的handler共享一个looper对象,消息中保留了对handler的引用,由于Java在生成内部类的时候,原本没有构造器的内部类会被生成一个带外部类参数的构造器,这个内部类就会持有外部类的隐式引用。Handler其实隐式的持有了Activity的引用,只要有消息在队列中,那么handler便无法被回收,如果handler不是static那么使用Handler的Service和Activity就也无法被回收。这就可能导致内存泄露 http://blog.csdn.net/liangchengfeng/article/details/51999882 23、HashMap can be replaced with SparseArray HashMap可以用SparseArray替换 ` HashMap<Integer, HashMap<String, String>> rightPopCommonList = new HashMap<Integer, HashMap<String, String>>(); 改为 HashMap<Integer, HashMap<String, String>> rightPopCommonList = new new HashMap<>(); ` 24、Inefficient layout weight 低效的权重布局 在 设置权重属性的时候相应的宽高属性应设为0dp 25、Layout hierarchy is too deep 布局层次结构太深 嵌套过多的布局不利于性能。考虑使用更平的布局(比如相对布局或GridLayout)。默认的最大深度为10,但可以使用环境变量androidlintmaxdepth配置 26、Memory allocations within drawing code 绘制代码内的内存分配 Avoid object allocations during draw/layout operations (preallocate and reuse instead) You should avoid allocating objects during a drawing or layout operation. These are called frequently, so a smooth UI can be interrupted by garbage collection pauses caused by the object allocations. The way this is generally handled is to allocate the needed objects up front and to reuse them for each drawing operation. Some methods allocate memory on your behalf (such as Bitmap.create), and these should be handled in the same way. 27、Missing baselineAligned attribute 消失的baselineAligned属性 baselineAligned属性默认为true 这是基准线设置,设置为fale时它的子控件不对齐 当linearlayout为水平时设置为fale 获取更好的性能http://blog.csdn.net/bdmh/article/details/48495583 28、Nested layout weights 嵌套布局权重 避免权重套权重,当一个非零权重的线性布局被嵌套在另一个带有非零权重的线性布局中,那么度量的数量就会呈指数增长。 29、Node can be replaced by a TextView with compound drawables 节点可以用一个带有复合绘图的TextView来替换 让只有图片和文字的一个小布局合并为一个textview 这个视情况。 30、Obsolete layout params 布局中无用的参数 31、Overdraw: Painting regions more than once 过度绘制 一般布局根背景不需要在设置bg了 子布局的背景挡住的父布局造成了过度绘制 32、Static Field Leaks 静态变量泄露 主要是上下文对象不要设置为static 33、Unused resources 无用的资源 34、Useless leaf layout 无用的布局 35、Useless parent layout无用的父布局 36、View Holder Candidates adapter没有重用子布局

优秀的个人博客,低调大师

经典的 Fork 炸弹解析

Jaromil在2002年设计了最为精简的一个Linux Fork炸弹,整个代码只有13个字符,在shell中运行后几秒后系统就会宕机: :(){:|:&};: 这样看起来不是很好理解,我们可以更改下格式: :() { :|:& }; : 更好理解一点的话就是这样: bomb() { bomb|bomb& }; bomb 因为shell中函数可以省略function关键字,所以上面的十三个字符是功能是定义一个函数与调用这个函数,函数的名称为:,主要的核心代码是:|:&,可以看出这是一个函数本身的递归调用,通过&实现在后台开启新进程运行,通过管道实现进程呈几何形式增长,最后再通过:来调用函数引爆炸弹.因此,几秒钟系统就会因为处理不过来太多的进程而死机,解决的唯一办法就是重启。 Bomb一下 秉着不作不死的心态,我们也来运行一下,于是我将矛头指向云主机,,我使用了国内的一个2G内存的云主机,首先在本地开启两个终端,在一个终端连接云主机后运行炸弹,几秒后再尝试用另外一个终端登录,效果可以看下面Gif图: 看,运行一段时间后直接报出了-bash: fork: Cannot allocate memory,说明内存不足了。并且我在二号终端上尝试连接也没有任何反应。因为是虚拟的云主机,所以我只能通过主机服务商的后台来给主机断电重启。然后才能重新登录: 炸弹危害 Fork炸弹带来的后果就是耗尽服务器资源,使服务器不能正常的对外提供服务,也就是常说的DoS(Denial of Service)。与传统1v1、通过不断向服务器发送请求造成服务器崩溃不同,Fork炸弹有种坐山观虎斗,不费一兵一卒斩敌人于马下的感觉。更吓人的是这个函数是不需要root权限就可以运行的。看到网上有帖子说某些人将个性签名改为Fork炸弹,结果果真有好奇之人中枪,试想如果中枪的人是在公司服务器上运行的话,oh,! 预防方式 当然,Fork炸弹没有那么可怕,用其它语言也可以分分钟写出来一个,例如,python版: import os while True: os.fork() Fork炸弹的本质无非就是靠创建进程来抢占系统资源,在Linux中,我们可以通过ulimit命令来限制用户的某些行为,运行ulimit -a可以查看我们能做哪些限制: ubuntu@10-10-57-151:~$ ulimit -a core file size (blocks, -c) 0 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 7782 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) unlimited open files (-n) 1024 pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 8192 cpu time (seconds, -t) unlimited max user processes (-u) 7782 virtual memory (kbytes, -v) unlimited file locks (-x) unlimited 可以看到,-u参数可以限制用户创建进程数,因此,我们可以使用ulimit -u 20来允许用户最多创建20个进程。这样就可以预防bomb炸弹。但这样是不彻底的,关闭终端后这个命令就失效了。我们可以通过修改/etc/security/limits.conf文件来进行更深层次的预防,在文件里添加如下一行(ubuntu需更换为你的用户名): ubuntu - nproc 20 这样,退出后重新登录,就会发现最大进程数已经更改为20了, 这个时候我们再次运行炸弹就不会报内存不足了,而是提示-bash: fork: retry: No child processes,说明Linux限制了炸弹创建进程。 原文发布时间为:2015-06-24 本文来自云栖社区合作伙伴“Linux中国”

优秀的个人博客,低调大师

weex高性能list解析

weex是alibaba出品的用于移动端跨平台开发界面的框架,类似react-native。而ListView在移动端界面的开发中是非常重要的组件,无论是H5还是react-native都因为ListView的低性能而饱受非议。那么到底是什么样的实现让weex能拥有与众不同的ListView性能呢? List示例 首先,让我们一起来看看weex下如何使用list。 <template> <div> <list class="list"> <refresh class = "refresh-view" display="{{refresh_display}}" onrefresh="onrefresh"> <text if="{{(refresh

优秀的个人博客,低调大师

Macaca基础原理解析

导语 前面几篇文章介绍了在Macaca实践中的一些实用技巧与解决方案,今天简单分析一下Macaca的基础原理。这篇文章将以前面所分享的UI自动化Macaca-Java版实践心得中的demo为基础,进行一下实例讲解。 Macaca的基本组成 通过对源码各个模块的分析,可以帮助我们对Macaca的整体构成有一个基础的认识。Macaca已经开源,相关的源码在对应的github上都可以下载: https://github.com/macacajs。 大家会在alibaba集团的开源github上找到macaca的另一个仓库https://github.com/alibaba/macaca/,关于这两个仓库的关系这里简单讲一下,由于主仓库https://github.com/macacajs模块众多,所以在alibaba集团下的github上采用了a

优秀的个人博客,低调大师

解析阿里云容器服务

容器服务(Container Service)是一种高性能可伸缩的容器管理服务,支持在一组阿里云云服务器上通过 Docker 容器来运行或编排应用。容器服务免去了您对容器管理集群的搭建,整合了负载均衡、专有网络 (VPC) 等云产品,让咱们可以通过控制台或简单的 API(兼容 Docker API)进行容器生命周期管理。主要功能:集群管理,灵活的地域和网络环境选择;多种服务器托管方式;一站式容器生命周期管理;兼容标准 Docker API;阿里云环境特有的增值能力;高可用调度策略,打通上下游交付流程。 容器服务常用的应用场景: 1)Web 应用镜像化部署,在容器集群中加入两台云服务器和一个负载均衡,并通过云数据库 RDS 版提供数据存储,最后选择 WordPress 等容器镜像。 2)持续集成系统构建,在阿里云容器 Hub 创建一个自动构建类型的镜像仓库,选择关联代码源到 GitHub 或云 Code。镜像构建完毕后,通过调用容器服务的 OpenAPI 完成容器的部署。 3)微服务架构,将用户现有的复杂系统拆分成多个微服务,每个微服务的内容用一个镜像管理。通过 Docker Compose 模板描述服务之间的依赖关系和配置。通过容器服务选择之前创建的编排模板创建应用。 2016云栖大会上,阿里云资深专家易立从中国容器市场分析、阿里云容器服务路线图、云市场与解决方案层层深入,为我们讲解了阿里云容器服务是如何加速企业创新的。预知详情,且看下文PDF:

优秀的个人博客,低调大师

hadoop源码解析---INodeReference机制

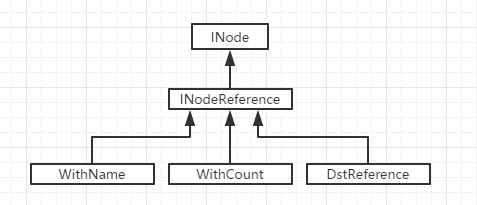
本文主要介绍了hadoop源码中hdfs的INodeReference机制。 在hdfs2.6版本中,引入了许多新的功能,一些原有的源代码设计也有一定的改造。一个重要的更新就是引入了快照功能。但是当HDFS文件或者目录处于某个快照中,并且这个文件或者目录被重命名或者移动到其他路径时,该文件或者目录就会存在多条访问路径。INodeReference就是为了解决这个问题产生的。 问题描述 /a是hdfs中的一个普通目录,s0为/a的一个快照,在/a目录下有一个文件test。根据快照的定义,我们可以通过/a/test以及/a/snapshot/s0/test访问test文件。 但是当用户将/a/test文件重命名成/x/test1时,通过快照路径/a/snapshot/s0/test将无法访问test文件,这种情况是不符合快照规范的。 引入INodeReference 为了解决上述问题,hdfs引入了INodeReference类。图1-1给出了INodeReference的继承关系图。这里的WithName,WithCoount,DstReference都是INodeReference的子类,同时也是INodeReference的内部类。WithName对象用于替代重命名操作前源路径中的INode对象,DstReference对象则用于替代重命名操作后目标路径中的INode对象,WithName和DstReference共同指向了一个WithCount对象,WithCount对象则指向了文件系统目录树中真正的INode对象。 图1 INodeReference代码实现 INodeReference是一个抽象类,它拓展自INode类,所以INodeReference及其子类是可以添加到文件系统目录树中以替代原有的INodeFile节点的。INodeReference定义了referred字段,这个字段用于保存当前INodeReference类指向的INode节点,所以WithName和RstReference,referred字段就指向了WithCount对象,对于WithCount,referred指向了真正的INode对象。INodeReference还定义了getReferredINode()方法,在文件系统目录树的操作中,如果判断当前节点是一个引用节点,则会调用getReferredINode()方法获取INodeReference指向的INode对象。 publicabstractclassINodeReferenceextendsINode{ privateINodereferred;//指向的INode节点 publicINodeReference(INodeparent,INodereferred){ super(parent); this.referred=referred; } publicfinalINodegetReferredINode(){//获取指向的INode节点 returnreferred; } publicfinalvoidsetReferredINode(INodereferred){ this.referred=referred; } //... } 然后,我们在来看看WithCount类的实现。 WithCount类定义了一个集合字段withNameList用于保存所有指向这个WithCount对象的WithName对象集合。WithCount类还定义了addReference()方法,任何指向WithCount对象的WithName对象以及DstReference对象都需要调用这个方法来添加指向关系。对于指向这个WithCount对象的DstReference对象,addReference()方法会将这个对象设置为自己的父INode节点;而对于WithName对象,addReference()方法则将这个对象放入withNameList集合中保存。 publicstaticclassWithCountextendsINodeReference{ //保存所有指向这个WithCount对象的WithName对象的集合 privatefinalList<WithName>withNameList=newArrayList<WithName>(); publicWithCount(INodeReferenceparent,INodereferred){ super(parent,referred);//调用父类的构造方法,指向文件系统目录树中的INode Preconditions.checkArgument(!referred.isReference()); refferred.setParentReferenct(this);//设置真实INode的父节点为当前WithCount对象 } publicvoidaddReferenct(INodeReferenceref){ if(refinstanceofWithName){//如果是WithName对象,则加入withNameList WithNamerefWithName=(WithName)ref; inti=Collections.binarySearch(withNameList,refWithName,WITHNAME_COMPARATOR); Preconditions.checkState(i<0); withNameList.add(-i-1,refWithName); }elseif(refinstanceofDstReference){//如果是DstReference对象,则设置为父节点 setParentReference(ref); } } //... } 看完WithCount后,在看看WithName和DstReference。WithName类定义了name字段用于保存重命名前文件的名称,同事定义了lastSnapshotId字段用于保存WithName对象构造时源路径的快照版本号。DstReference类的实现就更简单了,只定义了一个dstSnapshotId字段用于保存重命名操作前目标路径的最新快照的版本号。WithName和DstReference在构造时都会调用父类的构造方法指向WithCount对象,同时还会调用WithCount.addReference()方法配置WithCount对象。 publicstaticclassWithNameextendINodeReference{ privatefinalbyte[]name;//重命名前的文件名 privatefinalintlastSnapshotId; publicWithName(INodeDirectoryparent,WithCountreferred,bytep[]name,intlastSnapshotId){ super(parent,referred);//调用父类构造方法,指向WithCount节点 this.name=name; this.lastSnapshotId=lastSnapshotId; referred.addReferenct(this);//调用WithCount.addReferenct() } //... } publicstaticclassDstReferenceextendsINodeReference{ privatefinalintdstSnapshotId; publicDstReference(INodeDirectoryparent,WithCountreferred,finalintdstSnapshotId){ super(parent,referred); this.lastSnapshotId=lastSnapshotId; referred.addReferenct(this);//调用WithCount.addReferenct() } //.. }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册