首页 文章 精选 留言 我的

精选列表

搜索[本地部署],共10000篇文章
优秀的个人博客,低调大师

cloudera 部署Hadoop 更方便

注意:以下操作对应 rhel5/centos5 1 获取cdh3 yum 源 wget-chttp://archive.cloudera.com/redhat/cdh/cdh3-repository-1.0-1.noarch.rpm 2 安装下载的rpm 包 yum--nogpgchecklocalinstallcdh3-repository-1.0-1.noarch.rpm //安装后将得到cloudera-cdh3.repo 文件 [root@namenode~]#ll/etc/yum.repos.d/ total40 -rw-r--r--1rootroot1926Aug292011CentOS-Base.repo -rw-r--r--1rootroot631Aug292011CentOS-Debuginfo.repo -rw-r--r--1rootroot626Aug292011CentOS-Media.repo -rw-r--r--1rootroot5390Aug292011CentOS-Vault.repo -rw-r--r--1rootroot201Jul142011cloudera-cdh3.repo 3 导入 rpm key rpm--importhttp://archive.cloudera.com/redhat/cdh/RPM-GPG-KEY-cloudera 4 安装 hadoop 主程序 yuminstallhadoop-0.20 5 hadoop <daemon type> namenode datanode secondarynamenode jobtracker tasktracker //比如安装 namenode 为: yum install hadoop-0.20-datanode,不同角色安装不同服务 6 安装后 hadoop 目录 //hadoop配置文件目录 [root@namenode~]#ll/etc/hadoop/ total8 lrwxrwxrwx1rootroot34Feb1702:56conf->/etc/alternatives/hadoop-0.20-conf drwxr-xr-x2rootroot4096Feb2810:13conf.empty drwxr-xr-x2rootroot4096Feb2810:15conf.pseudo //hadoop日志目录 [root@namenode~]#ll/var/log/hadoop lrwxrwxrwx1rootroot28Feb1702:56/var/log/hadoop->/etc/alternatives/hadoop-log //hadoop进程脚本 [root@namenode~]#ll/etc/init.d/|grephadoop -rwxr-xr-x1rootroot3041Feb1702:26hadoop-0.20-datanode -rwxr-xr-x1rootroot3067Feb1702:26hadoop-0.20-jobtracker -rwxr-xr-x1rootroot3041Feb1702:26hadoop-0.20-namenode -rwxr-xr-x1rootroot3158Feb1702:26hadoop-0.20-secondarynamenode -rwxr-xr-x1rootroot3080Feb1702:26hadoop-0.20-tasktracker 7 修改配置文档 (hdfs 方面) //slaves配置文件namenode上配置即可 cat/etc/hadoop/conf/slaves datanode1 datanode2 //hdfs-site.xml配置文件 cat/etc/hadoop/conf/hdfs-site.xml <?xmlversion="1.0"?> <?xml-stylesheettype="text/xsl"href="configuration.xsl"?> <!--Putsite-specificpropertyoverridesinthisfile.--> <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.permissions</name> <value>false</value> </property> <!--ImmediatelyexitsafemodeassoonasoneDataNodechecksin. Onamulti-nodecluster,theseconfigurationsmustberemoved.--> <property> <name>dfs.safemode.extension</name> <value>0</value> </property> <property> <name>dfs.safemode.min.datanodes</name> <value>1</value> </property> <!-- <property> specifythissothatrunning'hadoopnamenode-format'formatstherightdir <name>dfs.name.dir</name> <value>/var/lib/hadoop-0.20/cache/hadoop/dfs/name</value> </property> --> <!--addbydongnan--> <property> <name>dfs.data.dir</name> <value>/data/dfs/data</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/data/dfs/tmp</value> </property> <property> <name>dfs.datanode.max.xcievers</name> <value>200000</value> </property> </configuration> //core-site.xml配置文件 cat/etc/hadoop/conf/core-site.xml <?xmlversion="1.0"?> <?xml-stylesheettype="text/xsl"href="configuration.xsl"?> <!--Putsite-specificpropertyoverridesinthisfile.--> <configuration> <property> <name>fs.default.name</name> <value>hdfs://namenode:8020</value> </property> </configuration> 8 java 环境 //下载安装jdk chmod+xjdk-6u26-linux-x64-rpm.bin ./jdk-6u26-linux-x64-rpm.bin //编辑profile vim/etc/profile exportJAVA_HOME=/usr/java/jdk1.6.0_26 exportPATH=$JAVA_HOME/bin:$PATH //载入环境变量 souce /etc/profile 9 启动hadoop 相应进程 [root@namenode~]#/etc/init.d/hadoop-0.20-namenodestart [root@namenode~]#jps 5599NameNode 12889Jps 本文转自 dongnan 51CTO博客,原文链接: http://blog.51cto.com/dngood/791719

优秀的个人博客,低调大师

MySQL5.6 部署MHA

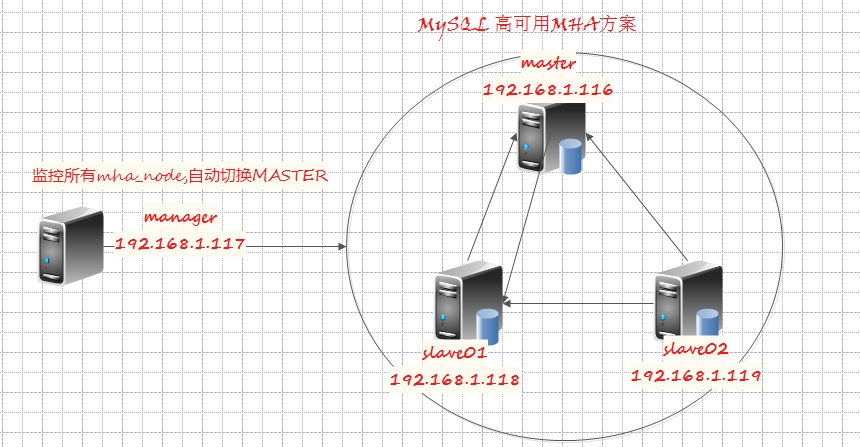
趁着最近几天休息,就把之前没有补全的博客也来补补。 今天就和大家聊聊MySQL高可用方案中的MHA 在中小型架构中,针对MySQL做高可用 用的最多的可能就是keepalived/heartbeat+MySQL Replication。 这种方案配置简单、维护方便,并且也能实现MySQL的故障转移,因此更多的倾向于此架构 MHA是什么? MHA是由日本Mysql专家用Perl写的一套Mysql故障切换方案,来保障数据库的高可用性,它的功能是能在0-30s之内实现主Mysql故障转移(failover),MHA故障转移可以很好的帮我们解决从库数据的一致性问题,同时最大化挽回故障发生后数据的一致性。 MHA里有两个角色一个是node节点一个是manager节点,要实现这个MHA,必须最少要三台数据库服务器,一主多备,即一台充当master,一台充当master的备份机,另外一台是从属机,这里实验为了实现更好的效果使用四台机器,需要说明的是一旦主服务器宕机,备份机即开始充当master提供服务,如果主服务器上线也不会再成为master了,因为如果这样数据库的一致性就被改变了 这里有一个mha的网络拓扑图,我们先来简单的介绍下 先来聊聊这个拓扑图,文章开篇也有过介绍,MHA有两个重要的角色,一个是manager,另外一个是node; 从这个拓扑图中,或许大家不难分辨出如下信息 1 2 3 4 192.168.1.117manager管理节点 192.168.1.116master主库 192.168.1.118slave01从库+备库 192.168.1.119slave02从库 一、环境初始化 1、修改主机名 1 2 3 4 5 6 7 8 主机:manager执行命令 #sed-i's/HOSTNAME=.*/HOSTNAME=manager/g'/etc/sysconfig/network&&hostnamemanager 主机:master执行命令 #sed-i's/HOSTNAME=.*/HOSTNAME=master/g'/etc/sysconfig/network&&hostnamemaster 主机:slave01执行命令 #sed-i's/HOSTNAME=.*/HOSTNAME=slave01/g'/etc/sysconfig/network&&hostnameslave01 主机:slave02执行命令 #sed-i's/HOSTNAME=.*/HOSTNAME=slave02/g'/etc/sysconfig/network&&hostnameslave02 2、主机名解析 1 2 3 4 5 本文转自zys467754239 51CTO博客,原文链接:http://blog.51cto.com/467754239/1695175,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册