首页 文章 精选 留言 我的

精选列表

搜索[多云部署],共10000篇文章
优秀的个人博客,低调大师

CentOS7.3 部署Haproxy 1.7.2

原文发表于cu:2017-03-16 参考文档: haproxy:http://www.haproxy.org/ 本文涉及haproxy的安装,并做简单配置。 一.环境准备 1.操作系统 CentOS-7-x86_64-Everything-1511 2. Haproxy版本 截至2017-02-23,haproxy稳定版本是1.7.2:http://www.haproxy.org/download/1.7/src/haproxy-1.7.2.tar.gz 3.拓扑图 haproxy服务器采用VMware ESXi虚拟出的1台服务器,前端访问地址10.11.4.152,后端地址192.168.4.152;1 Web1服务器为采用docker技术生成的1台服务器,已安装并启动nginx服务,ip地址192.168.4.171; Web2同Web1服务器,ip地址192.168.4.172; 设置web1/2测试页面(路径参考nginx安装步骤),以方便后续查看验证结果。 二.Haproxy安装 1. 下载 [root@elk-node2 ~]# cd /usr/local/src/ [root@elk-node2 src]# wget http://www.haproxy.org/download/1.7/src/haproxy-1.7.2.tar.gz 2. 编译安装 #”TARGET”指定编译对应的os对应的内核版本,通过”uname -r”查询内核版本呢,README文件可查询对应关系 [root@elk-node2 src]# tar -zxvf haproxy-1.7.2.tar.gz [root@elk-node2 src]# cd haproxy-1.7.2 [root@elk-node2 haproxy-1.7.2]# make TARGET=linux2628 PREFIX=/usr/local/haproxy [root@elk-node2 haproxy-1.7.2]# make install PREFIX=/usr/local/haproxy 三.Haproxy配置 1.配置用户 [root@elk-node2 ~]# groupadd haproxy [root@elk-node2 ~]# useradd -g haproxy haproxy -s /sbin/nologin 2. 配置文件 1)配置文件详解 #默认安装目录下没有配置文件,只有”doc”,“sbin”,“share”三个目录,可手工创建目录及配置文件; #haproxy的配置文件主要是以下5部分:global全局配置、defaults默认配置、监控页面配置、frontend配置、backend配置 [root@elk-node2 ~]# mkdir -p /usr/local/haproxy/etc [root@elk-node2 ~]# cd /usr/local/haproxy/etc/ [root@elk-node2 etc]# vim haproxy.cfg #全局配置, 用于设定义全局参数, 属于进程级的配置, 通常与操作系统配置有关. global #定义全局日志, 配置在本地, 通过local0 输出, 默认是info级别,可配置两条 log 127.0.0.1 local0 warning #定义日志级别【error warning info debug】 #log 127.0.0.1 local1 info #运行路径 chroot /usr/local/haproxy #PID 文件存放路径 pidfile /var/run/haproxy.pid #设置每haproxy进程的最大并发连接数, 其等同于命令行选项“-n”; “ulimit -n”自动计算的结果参照此参数设定. maxconn 4096 #运行haproxy 用户, 或者使用关键字uid user haproxy #运行haproxy 用户组, 或者使用关键字gid group haproxy #后台运行haproxy daemon #设置启动的haproxy进程数量, 只能用于守护进程模式的haproxy; #默认只启动一个进程, 鉴于调试困难等多方面的原因, 一般只在单进程仅能打开少数文件描述符的场景中才使用多进程模式. nbproc 1 #设置每进程所能够打开的最大文件描述符数目, 默认情况其会自动进行计算, 因此不推荐修改此选项. #ulimit-n 819200 #调试级别, 一般只在开启单进程时调试, 且生产环境禁用. #debug #haproxy启动后不会显示任何相关信息, 这与在命令行启动haproxy时加上参数“-q”相同 #quiet #定义统计信息保存位置 stats socket /usr/local/haproxy/stats #默认配置 defaults #默认的模式【tcp:4层; http:7层; health:只返回OK】 mode http #继承全局的日志定义输出 log global #日志类别, httplog #option httplog #如果后端服务器需要记录客户端真实ip, 需要在HTTP请求中添加”X-Forwarded-For”字段; #但haproxy自身的健康检测机制访问后端服务器时, 不应将记录访问日志,可用except来排除127.0.0.0,即haproxy本身. #option forwardfor except 127.0.0.0/8 option forwardfor #开启http协议中服务器端关闭功能, 每个请求完毕后主动关闭http通道, 使得支持长连接,使得会话可以被重用,使得每一个日志记录都会被记录. option httpclose #如果产生了一个空连接,那这个空连接的日志将不会记录. option dontlognull #当与后端服务器的会话失败(服务器故障或其他原因)时, 把会话重新分发到其他健康的服务器上; 当故障服务器恢复时, 会话又被定向到已恢复的服务器上; #还可以用”retries”关键字来设定在判定会话失败时的尝试连接的次数 option redispatch retries 3 #当haproxy负载很高时, 自动结束掉当前队列处理比较久的链接. option abortonclose #默认http请求超时时间 timeout http-request 10s #默认队列超时时间, 后端服务器在高负载时, 会将haproxy发来的请求放进一个队列中. timeout queue 1m #haproxy与后端服务器连接超时时间. timeout connect 5s #客户端与haproxy连接后, 数据传输完毕, 不再有数据传输, 即非活动连接的超时时间. timeout client 1m #haproxy与后端服务器非活动连接的超时时间. timeout server 1m #默认新的http请求连接建立的超时时间,时间较短时可以尽快释放出资源,节约资源. timeout http-keep-alive 10s #心跳检测超时时间 timeout check 10s #最大并发连接数 maxconn 2000 #设置默认的负载均衡方式 #balance source #balnace leastconn #统计页面配置, frontend和backend的组合体, 监控组的名称可按需自定义 listen admin_status #配置监控运行模式 mode http #配置统计页面访问端口 bind 0.0.0.0:1080 #统计页面默认最大连接数 maxconn 10 #http日志格式 option httplog #开启统计 stats enable #隐藏统计页面上的haproxy版本信息 stats hide-version #监控页面自动刷新时间 stats refresh 30s #统计页面访问url stats uri /stats #统计页面密码框提示文本 stats realm mCloud\ Haproxy #监控页面的用户和密码:admin, 可设置多个用户名 stats auth admin:admin #手工启动/禁用后端服务器, 可通过web管理节点 stats admin if TRUE #设置haproxy错误页面 errorfile 400 /usr/local/haproxy/errorfiles/400.http errorfile 403 /usr/local/haproxy/errorfiles/403.http errorfile 408 /usr/local/haproxy/errorfiles/408.http errorfile 500 /usr/local/haproxy/errorfiles/500.http errorfile 502 /usr/local/haproxy/errorfiles/502.http errorfile 503 /usr/local/haproxy/errorfiles/503.http errorfile 504 /usr/local/haproxy/errorfiles/504.http #监控haproxy后端服务器的监控状态 listen site_status bind 0.0.0.0:1081 #监听端口 mode http #http的7层模式 log 127.0.0.1 local2 err #[err warning info debug] monitor-uri /site_status #网站健康检测URL,用来检测HAProxy管理的网站是否可以用,正常返回200,不正常返回503 acl site_dead nbsrv(php_server) lt 1 #定义网站down时的策略当挂在负载均衡上的指定backend的中有效机器数小于1台时返回true acl site_dead nbsrv(html_server) lt 1 acl site_dead nbsrv(backend_default) lt 1 monitor fail if site_dead #当满足策略的时候返回503,网上文档说的是500,实际测试为503 monitor-net 192.168.4.171/32 #来自192.168.4.152的日志信息不会被记录和转发 monitor-net 192.168.4.172/32 #frontend, 名字自定义 frontend HAproxy_Cluster #定义前端监听端口, 建议采用bind *:80的形式,否则做集群高可用的时候有问题,vip切换到其余机器就不能访问. bind 0.0.0.0:80 #acl后面是规则名称,当请求的url末尾是以.php结尾时,匹配触发php_web规则,以下两种写法均可. acl php_web url_reg /*.php #当请求的url末尾是以.css、.jpg、.png、.jpeg、.js、.gif结尾时,匹配并触发static_web规则. #acl static_web path_end .gif .png .jpg .css .js .jpeg #acl static_web url_reg /*.(css|jpg|png|jpeg|js|gif)$ #-i为忽略大小写,当被请求的是以www.test.com开头的主机时,匹配并触发dns_name规则. acl html_web hdr_beg(host) -i www.haproxytest.com #acl html_web hdr_beg(host) 10.11.4.152 #当客户端的IP是x.x.x.x时,匹配并触发src_ip规则. #acl src_ip src x.x.x.x #如果匹配acl规则php_web,将请求转交到php_server组处理;如果匹配acl规则html_web,将请求转交到html_server组处理. use_backend php_server if php_web use_backend html_server if html_web #如果以上规则都不匹配时,将请求转交到default_backend组处理. default_backend backend_default #backend后端配置, 配置php_server组与html_server组 backend php_server #定义负载均衡方式为roundrobin方式, 即基于权重进行轮询调度的算法, 在服务器性能分布较均匀情况下推荐. #另有如下几种负载均衡方式: #-- static-rr: 也是基于权重进行轮转调度, 但属于静态方法, 运行时调整后端机组权重不会使用新的权重; #-- source: 基于请求源IP进行hash运算匹配后端服务器组; #-- leastconn: 不适合会话较短的环境, 如基于http的应用; #-- uri: 对整个URI进行hash运算; #-- uri_param: 对URI中的参数进行转发; #-- hdr(<name>):根据http头进行转发, 无该头部则转为使用roundrobin. balance roundrobin mode http #允许插入serverid到cookie中,serverid后面可定义 cookie SERVERID #心跳检测方式为检测后端服务器index.html文件,还有其他方式 option httpchk GET /index.html #后端服务器定义, maxconn 1024表示该服务器的最大连接数, cookie 1表示serverid为1, weight代表权重(默认1,最大为265,0则表示不参与负载均衡), #check inter 1500是检测心跳频率, rise 2是2次正确认为服务器可用, fall 3是3次失败认为服务器不可用. server php1 192.168.4.171:80 maxconn 1024 cookie 1 weight 3 check inter 1500 rise 2 fall 3 backend html_server balance source mode http server html1 192.168.4.172:80 maxconn 1024 cookie 1 weight 3 check inter 1500 rise 2 fall 3 backend backend_default balance source mode http server default1 192.168.4.171:80 maxconn 1024 cookie 1 weight 3 check inter 1500 rise 2 fall 3 2)error文件 #配置文件中统计监控页面部分定义了error文件,将安装包中的文件复制到安装目录使用 [root@elk-node2 ~]# cp -r /usr/local/src/haproxy-1.7.2/examples/errorfiles/ /usr/local/haproxy/ 3)日志文件 创建文件 [root@elk-node2 ~]# mkdir -p /usr/local/haproxy/log [root@elk-node2 ~]# touch /usr/local/haproxy/log/haproxy.log [root@elk-node2 ~]# ln -s /usr/local/haproxy/log/haproxy.log /var/log/ [root@elk-node2 ~]# chown haproxy:haproxy /var/log/haproxy.log rsyslog主配置文件 #修改”SYSLOGD_OPTIONS”参数,-c 2 使用兼容模式,默认是 -c 5;-r 开启远程日志;-m 0 标记时间戳,单位是分钟,0表示禁用该功能 [root@elk-node2 ~]# vim /etc/sysconfig/rsyslog SYSLOGD_OPTIONS="-c 2 -r -m 0" rsyslog文件 #haproxy默认没有日志,依靠rsyslog收集日志; #文件最末尾的“&~”,如果没有此配置,日志除写入指定文件外,会同步写入messages文件 [root@elk-node2 ~]# cd /etc/rsyslog.d/ [root@elk-node2 rsyslog.d]# touch haproxy.conf [root@elk-node2 rsyslog.d]# chown haproxy:haproxy haproxy.conf [root@elk-node2 rsyslog.d]# vim haproxy.conf # Provides UDP syslog reception $ModLoad imudp $UDPServerRun 514 # haproxy.log # local0.* /usr/local/haproxy/log/haproxy.log #local1.* /usr/local/haproxy/log/haproxy.log local2.* /usr/local/haproxy/log/haproxy.log &~ [root@elk-node2 rsyslog.d]# systemctl restart rsyslog.service #关闭selinux,本文因没有关闭selinux导致排查问题用了比较长的时间 [root@elk-node2 rsyslog.d]# setenforce 0 4)配置文件权限及软链接 [root@elk-node2 ~]# chown -R haproxy:haproxy /usr/local/haproxy/ [root@elk-node2 ~]# mkdir -p /etc/haproxy [root@elk-node2 ~]# ln -s /usr/local/haproxy/etc/haproxy.cfg /etc/haproxy/ [root@elk-node2 ~]# chown -R haproxy:haproxy /etc/haproxy 3. 配置开机启动 [root@elk-node2 ~]# cp /usr/local/src/haproxy-1.7.2/examples/haproxy.init /etc/rc.d/init.d/haproxy [root@elk-node2 ~]# chown haproxy:haproxy /etc/rc.d/init.d/haproxy [root@elk-node2 ~]# chmod +x /etc/rc.d/init.d/haproxy [root@elk-node2 ~]# chkconfig --add haproxy [root@elk-node2 ~]# chkconfig --level 35 haproxy on 4.配置全局启动文件 #采用软链接方式 [root@elk-node2 ~]# ln -s /usr/local/haproxy/sbin/haproxy /usr/sbin/ [root@elk-node2 ~]# chown haproxy:haproxy /usr/sbin/haproxy 5.配置防火墙 #开放如上端口,均在配置文件中有定义,日志端口在rsyslog.d/haproxy.conf文件中定义 [root@elk-node2 ~]# vim /etc/sysconfig/iptables -A INPUT -p tcp -m state --state NEW -m tcp --dport 80 -j ACCEPT -A INPUT -p tcp -m state --state NEW -m tcp --dport 1080 -j ACCEPT -A INPUT -p tcp -m state --state NEW -m tcp --dport 1081 -j ACCEPT -A INPUT -p udp -m state --state NEW -m tcp --dport 514 -j ACCEPT [root@elk-node2 ~]# service iptables restart 6.启动并验证 [root@elk-node2 ~]# service haproxy start 1)端口验证 [root@elk-node2 ~]# netstat –tunlp 2)监控页面 监控页面展示信息与账户/密码在配置文件中已定义。 3)访问页面 触发配置文件中定义的php_server组,如下: 触发配置文件中定义的html_server组(在本地修改hosts文件),如下: 触发配置文件中定义的backend_default组,如下:

优秀的个人博客,低调大师

在docker中部署静态网页

1、新建一个80端口的web服务器,ubuntu系统 docker run -p 80 –name web -i -t ubuntu /bin/bash 2、在ubuntu上安装nginx apt-get update apt-get install -y nginx 3、在ubuntu上安装vim apt-get install -y vim 4、创建文件夹 mkdir -p /var/www/html 5、创建静态页面 cd /var/www/html vim index.html <html> <body> <h1> hi,docker! </h1> </body> </html> 6、运行nginx ps -ef 查看nginx是否正常启动 如图则nginx已经正常启动 ctrl+P && ctrl+Q 退出docker。 如图docker内ubuntu容器的80端口对应了宿主机的32769端口。 通过docker inspect web 查看容器的内网ip地址 7、访问页面 可以通过curl http://127.0.0.1:32769 访问 也可以通过 curl http://172.17.0.3 访问 当然也可以通过浏览器访问上述2个ip。 好了,大功告成。后面还要用docker实现更加复杂的应用。

优秀的个人博客,低调大师

搭建部署Hadoop 之Yarn

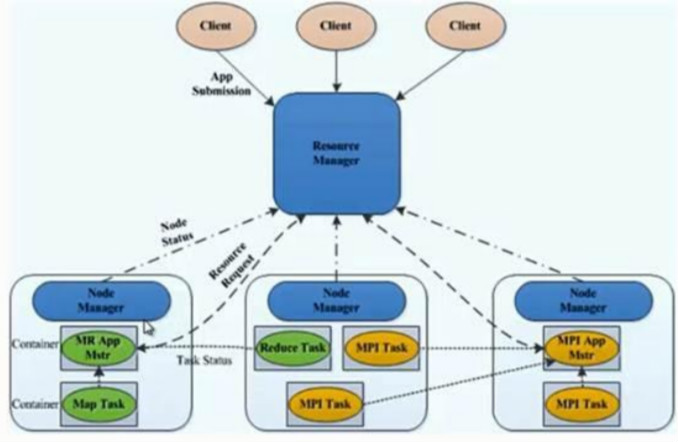
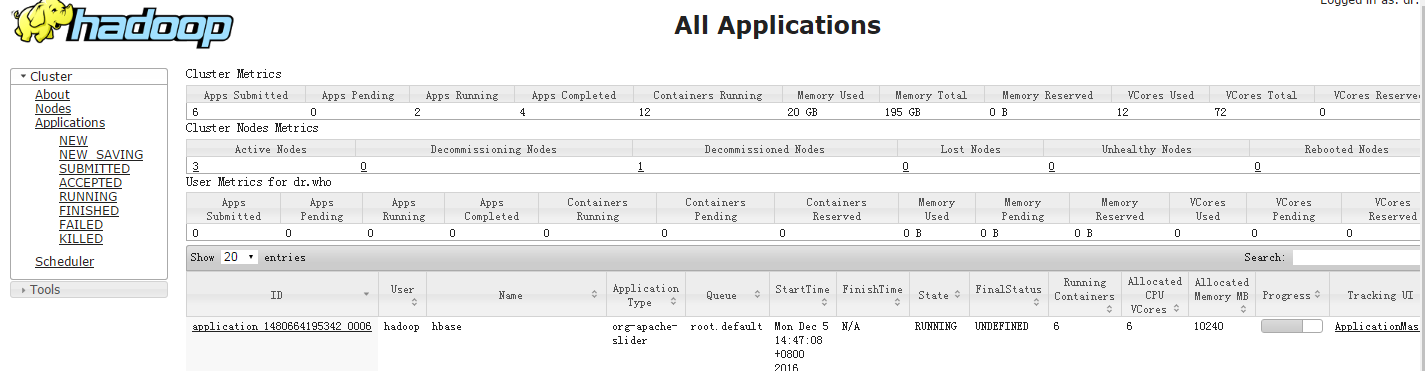
Yarn集群资源管理系统 Yarn 角色及概念 •Yarn 是 Hadoop 的一个通用的资源管理系统 • Yarn 角色 – Resourcemanager – Nodemanager – ApplicationMaster – Container – Client • ResourceManager – 处理客户端请求 – 启动 / 监控 ApplicationMaster – 监控 NodeManager – 资源分配与调度 • NodeManager – 单个节点上的资源管理 – 处理来自 ResourceManager 的命令 – 处理来自 ApplicationMaster 的命令 • Container – 对任务运行行环境的抽象,封装了 CPU 、内存等 – 多维资源以及环境变量、启动命令等任务运行相关的信息资源分配与调度 • ApplicationMaster – 数据切分 – 为应用程序申请资源,并分配给内部任务 – 任务监控与容错 • Client – 用户与 YARN 交互的客户端程序 – 提交应用程序、监控应用程序状态,杀死应用程序等 Yarn 结构 • YARN 的核心思想 • 将 JobTracker 和 TaskTacker 进行分离,它由下面几大构成组件: – ResourceManager 一个全局的资源管理器 – NodeManager 每个节点(RM)代理 – ApplicationMaster 表示每个应用 – 每一个 ApplicationMaster 有多个 Container 在NodeManager 上运行 系统规划 主机 角色 软件 192.168.4.1master Resource Manager YARN 192.168.4.2node1 Node Manager YARN 192.168.4.3node2 Node ManagerYARN 192.168.4.4node3Node ManagerYARN Yarn 安装与配置 具体实验准备 可以参考http://blog.51cto.com/13558754/2066708 # ssh 192.168.4.1 # cd /usr/local/hadoop/ # cd etc/hadoop/ # cp mapred-site.xml.template mapred-site.xml # vim mapred-site.xml <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value>// 配置使用yarn 资源管理系统 </property> </configuration> # vim yarn-site.xml <configuration> <property> <name>yarn.resourcemanager.hostname</name> <value>master</value>//配置Resource Manager 角色 </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value>// 一个 java 的类 真实环境与开发人员沟通 </property> </configuration> 配置完成以后 # for i in node{1..3}//将配置文件同步到所有主机 > do > rsync -azSH --delete /usr/local/hadoop/etc/hadoop/ ${i}:/usr/local/hadoop/etc/hadoop -e 'ssh' > done # cd /usr/local/hadoop/ 启动 yarn 服务 # ./sbin/start-yarn.sh 在所有主机上执行 jps, 查看是否启动成功 # for i in master node{1..3} > do > echo ${i} > ssh ${i} "jps" > done master 3312 Jps 3005 ResourceManager node1 3284 Jps 3162 NodeManager node2 2882 NodeManager 3004 Jps node3 2961 Jps 2831 NodeManager 显示所有可用的计算节点 # ./bin/yarn node -list 18/01/31 06:41:56 INFO client.RMProxy: Connecting to ResourceManager at master/192.168.4.1:8032 Total Nodes:3 Node-Id Node-StateNode-Http-AddressNumber-of-Running-Containers node3:46007 RUNNING node3:8042 0 node2:54895 RUNNING node2:8042 0 node1:51087 RUNNING node1:8042 resourcemanager nodemangager 验证 Yarn # bin/hadoop fs -ls /input Found 3 items -rw-r--r-- 2 root supergroup 84854 2018-01-29 21:37 /input/LICENSE.txt -rw-r--r-- 2 root supergroup 14978 2018-01-29 21:37 /input/NOTICE.txt -rw-r--r-- 2 root supergroup 1366 2018-01-29 21:37 /input/README.txt 使用yarn 统计 样本文件中单词出现频率 # ./bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount hdfs://master:9000/input hdfs://master:9000/output 查看结果 # ./bin/hadoop fs -cat hdfs://master:9000/output/* Yarn 节点管理 [root@master ~] # cat /etc/hosts 192.168.4.1master 192.168.4.2node1 192.168.4.3node2 192.168.4.4node3 192.168.4.5newnode [root@newnode ~]# rsync -azSH --delete master:/usr/local/hadoop /usr/local [root@master hadoop]# ./sbin/start-yarn.sh 添加节点 [root@master hadoop]# ./bin/yarn node -list 18/01/28 21:06:57 INFO client.RMProxy: Connecting to ResourceManager at master/192.168.4.1:8032 Total Nodes:3 Node-Id Node-State Node-Http-Address Number-of-Running-Containers node1:33596 RUNNING node1:8042 0 node2:53475 RUNNING node2:8042 0 node3:34736 RUNNING node3:8042 0 [root@newnode hadoop]# sbin/yarn-daemon.sh start nodemanager [root@master hadoop]# ./bin/yarn node -list 18/01/28 21:07:53 INFO client.RMProxy: Connecting to ResourceManager at master/192.168.4.1:8032 Total Nodes:4 Node-Id Node-State Node-Http-Address Number-of-Running-Containers newnode:39690 RUNNING newnode:8042 0 node1:33596 RUNNING node1:8042 0 node2:53475 RUNNING node2:8042 0 node3:34736 RUNNING node3:8042 0 删除节点 [root@newnode hadoop]# sbin/yarn-daemon.sh stop nodemanager //不会立即删除 [root@master hadoop]# ./bin/yarn node -list 18/01/28 21:11:31 INFO client.RMProxy: Connecting to ResourceManager at master/192.168.4.1:8032 Total Nodes:4 Node-Id Node-State Node-Http-Address Number-of-Running-Containers newnode:39690 RUNNING newnode:8042 0 node1:33596 RUNNING node1:8042 0 node2:53475 RUNNING node2:8042 0 node3:34736 RUNNING node3:8042 0 //需要重新启动服务 [root@master hadoop]# ./sbin/stop-yarn.sh [root@master hadoop]# ./sbin/start-yarn.sh [root@master hadoop]# ./bin/yarn node -list 18/01/28 21:12:46 INFO client.RMProxy: Connecting to ResourceManager at master/192.168.4.1:8032 Total Nodes:3 Node-Id Node-State Node-Http-Address Number-of-Running-Containers node1:42010 RUNNING node1:8042 0 node2:55043 RUNNING node2:8042 0 node3:38256 RUNNING node3:8042 0 本文转自 Xuenqlve 51CTO博客,原文链接:http://blog.51cto.com/13558754/2067497,如需转载请自行联系原作者

优秀的个人博客,低调大师

利用Docker快速部署Oracle环境

工作中需要频繁使用Oracle环境,但是每次搭建起来比较消耗时间,本想通过虚拟机模板的方式来快速安装oracle vm,但是每次改ip等环境也很耗时,因此想到docker中有没有已经做好的images,这样就能快速获得Oracle环境。 root@- rac1:docker search oracle INDEX NAME DESCRIPTION STARS OFFICIAL AUTOMATED docker.io docker.io/wnameless/oracle-xe-11g Oracle Express 11g R2 on Ubuntu 16.04 LTS 417 [OK] docker.io docker.io/oraclelinux Oracle Linux is an open-source operating s... 304 [OK] docker.io docker.io/alexeiled/docker-oracle-xe-11g This is a working (hopefully) Oracle XE 11... 203 [OK] docker.io docker.io/sath89/oracle-12c Oracle Standard Edition 12c Release 1 with... 112 [OK] docker.io docker.io/sath89/oracle-xe-11g Oracle xe 11g with database files mount su... 91 [OK] docker.io docker.io/isuper/java-oracle This repository contains all java releases... 52 [OK] docker.io docker.io/jaspeen/oracle-11g Docker image for Oracle 11g database 38 [OK] docker.io docker.io/oracle/oraclelinux Oracle Linux is an open-source operating s... 34 [OK] docker.io docker.io/ingensi/oracle-jdk Official Oracle JDK installed on centos. 20 [OK] docker.io docker.io/airdock/oracle-jdk Docker Image for Oracle Java SDK (8 and 7)... 16 [OK] docker.io docker.io/oracle/openjdk Docker images containing OpenJDK Oracle Linux 15 [OK] docker.io docker.io/cogniteev/oracle-java Oracle JDK 6, 7, 8, and 9 based on Ubuntu ... 12 [OK] docker.io docker.io/n3ziniuka5/ubuntu-oracle-jdk Ubuntu with Oracle JDK. Check tags for ver... 12 [OK] docker.io docker.io/andreptb/oracle-java Debian Jessie based image with Oracle JDK ... 8 [OK] docker.io docker.io/oracle/glassfish GlassFish Java EE Application Server on Or... 8 [OK] docker.io docker.io/oracle/nosql Oracle NoSQL on a Docker Image with Oracle... 7 [OK] docker.io docker.io/infogene/oracle Image for running Oracle Database 11g Stan... 6 [OK] docker.io docker.io/openweb/oracle-tomcat A fork off of Official tomcat image with O... 5 [OK] docker.io docker.io/flurdy/oracle-java7 Base image containing Oracle's Java 7 JDK 4 [OK] docker.io docker.io/jtech/oracle-jdk A Docker image based on the smallest Linux... 3 [OK] docker.io docker.io/davidcaste/debian-oracle-java Oracle Java 8 (and 7) over Debian Jessie 2 [OK] docker.io docker.io/kaluzki/oracle kaluzki/oracle 2 [OK] docker.io docker.io/clincase/oracle clincase oracle db server image 1 [OK] docker.io docker.io/jckrz/debian-oracle-jdk Vanilla Debian + Oracle JDK 1 [OK] docker.io docker.io/publicisworldwide/oracle-core This is the core image based on Oracle Lin... 1 [OK] 可以看到有很多版本,11g,12c 这里选择获取12c版本 root@- rac1:/home/# docker pull sath89/oracle-12c Using default tag: latest latest: Pulling from sath89/oracle-12c 863735b9fd15: Pull complete 4fbaa2f403df: Pull complete faadd00cf98e: Downloading [=======> ] 394.8 MB/2.768 GB 829e2e754405: Download complete root@- rac1:/home/# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/sath89/oracle-12c latest b8bf52883bc7 5 weeks ago 5.692 GB 使用刚刚下载下来的12g image创建一个container,并运行其上的oracle数据库 docker run -d -p 8080:8080 -p 1521:1521 -v /my/oracle/data:/u01/app/oracle sath89/oracle-12c [root@-rac1 ~]# docker logs -f ffbeb07058449672c640ddb4e59b8376dae2e3b4dd54142871da7adbc069ee79 ls: cannot access /u01/app/oracle/oradata: No such file or directory Database not initialized. Initializing database. Starting tnslsnr Copying database files 1% complete 37% complete Creating and starting Oracle instance 40% complete 45% complete 62% complete Completing Database Creation 66% complete 100% complete Look at the log file "/u01/app/oracle/cfgtoollogs/dbca/xe/xe.log" for further details. Configuring Apex console Database initialized. Please visit http://#containeer:8080/em http://#containeer:8080/apex for extra configuration if needed Starting web management console PL/SQL procedure successfully completed. Starting import from '/docker-entrypoint-initdb.d': found file /docker-entrypoint-initdb.d//docker-entrypoint-initdb.d/* [IMPORT] /entrypoint.sh: ignoring /docker-entrypoint-initdb.d/* Import finished Database ready to use. Enjoy! ;) 到这里Oracle实例就已经启动好了 可以看到创建的container已经在运行中 [root@-rac1 ~]~$ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 9e893d773494 sath89/oracle-12c "/entrypoint.sh " 15 minutes ago Up 15 minutes 0.0.0.0:1521->1521/tcp, 0.0.0.0:8080->8080/tcp clever_chandrasekhar 进入oracle container [root@-rac1 ~]~$ docker exec -it 9e893d773494 /bin/bash root@9e893d773494:/# su oracle oracle@9e893d773494:~$ $ORACLE_HOME/bin/sqlplus / as sysdba SQL*Plus: Release 12.1.0.2.0 Production on Fri Feb 24 03:03:00 2017 Copyright (c) 1982, 2014, Oracle. All rights reserved. SQL> Oracle 使用的实例名,用户名,密码如下 --------------------------------------------- hostname: localhost port: 1521 sid: xe username: system password: oracle --------------------------------------------- 接下来就可以快速使用Oracle12C了 本文转自 taojin1240 51CTO博客,原文链接:http://blog.51cto.com/taotao1240/1906063,如需转载请自行联系原作者

优秀的个人博客,低调大师

openstack部署中的错误总结

在安装到glance上传镜象时出错,折腾不出来,先记在这儿 1、glance index Failed to show index. Got error: You are not authenticated. 解决方法: keystone配置出错,解决keystone问题 1、删除以前MYSQL生成的KEYSTONE的表 drop table ec2_credential; drop table endpoint; drop table metadata; drop table migrate_version; drop table role; drop table service; drop table tenant; drop table token; drop table user; drop table user_tenant_membership; drop table user; drop table token; show tables; drop table tenant; 2、重启keystone服务及初始化数据库 service keystone restart keystone-manage db_sync 3、/etc/keystone/keystone.conf配置文件中(选择数据库或模板文件方式中的一种) [catalog] driver = keystone.catalog.backends.sql.Catalog #driver = keystone.catalog.backends.templated.TemplatedCatalog #template_file = /etc/keystone/default_catalog.templates 4、为了生成API,建立endpoint # Fromhttp://www.hastexo.com/resources/docs/installing-openstack-essex-20121-ubuntu-1204-precise-pangolin # Modified by Emilien Macchi # Please send me feedback atemilien.macchi@gmail.com # Thank's to Martin ! ADMIN_PASSWORD=${ADMIN_PASSWORD:-password} SERVICE_PASSWORD=${SERVICE_PASSWORD:-$ADMIN_PASSWORD} export SERVICE_TOKEN="password" export SERVICE_ENDPOINT="http://localhost:35357/v2.0" SERVICE_TENANT_NAME=${SERVICE_TENANT_NAME:-service} function get_id () { echo `$@ | awk '/ id / { print $4 }'` } # Tenants ADMIN_TENANT=$(get_id keystone tenant-create --name=admin) SERVICE_TENANT=$(get_id keystone tenant-create --name=$SERVICE_TENANT_NAME) DEMO_TENANT=$(get_id keystone tenant-create --name=demo) INVIS_TENANT=$(get_id keystone tenant-create --name=invisible_to_admin) # Users ADMIN_USER=$(get_id keystone user-create --name=admin --pass="$ADMIN_PASSWORD"--email=admin@domain.com) DEMO_USER=$(get_id keystone user-create --name=demo --pass="$ADMIN_PASSWORD"--email=demo@domain.com) # Roles ADMIN_ROLE=$(get_id keystone role-create --name=admin) KEYSTONEADMIN_ROLE=$(get_id keystone role-create --name=KeystoneAdmin) KEYSTONESERVICE_ROLE=$(get_id keystone role-create --name=KeystoneServiceAdmin) # Add Roles to Users in Tenants keystone user-role-add --user $ADMIN_USER --role $ADMIN_ROLE --tenant_id $ADMIN_TENANT keystone user-role-add --user $ADMIN_USER --role $ADMIN_ROLE --tenant_id $DEMO_TENANT keystone user-role-add --user $ADMIN_USER --role $KEYSTONEADMIN_ROLE --tenant_id $ADMIN_TENANT keystone user-role-add --user $ADMIN_USER --role $KEYSTONESERVICE_ROLE --tenant_id $ADMIN_TENANT # The Member role is used by Horizon and Swift MEMBER_ROLE=$(get_id keystone role-create --name=Member) keystone user-role-add --user $DEMO_USER --role $MEMBER_ROLE --tenant_id $DEMO_TENANT keystone user-role-add --user $DEMO_USER --role $MEMBER_ROLE --tenant_id $INVIS_TENANT # Configure service users/roles NOVA_USER=$(get_id keystone user-create --name=nova --pass="$SERVICE_PASSWORD" --tenant_id $SERVICE_TENANT--email=nova@domain.com) keystone user-role-add --tenant_id $SERVICE_TENANT --user $NOVA_USER --role $ADMIN_ROLE GLANCE_USER=$(get_id keystone user-create --name=glance --pass="$SERVICE_PASSWORD" --tenant_id $SERVICE_TENANT--email=glance@domain.com) keystone user-role-add --tenant_id $SERVICE_TENANT --user $GLANCE_USER --role $ADMIN_ROLE SWIFT_USER=$(get_id keystone user-create --name=swift --pass="$SERVICE_PASSWORD" --tenant_id $SERVICE_TENANT--email=swift@domain.com) keystone user-role-add --tenant_id $SERVICE_TENANT --user $SWIFT_USER --role $ADMIN_ROLE RESELLER_ROLE=$(get_id keystone role-create --name=ResellerAdmin) keystone user-role-add --tenant_id $SERVICE_TENANT --user $NOVA_USER --role $RESELLER_ROLE # If you want to use Quantum with Keystone (not stable in Essex) QUANTUM_USER=$(get_id keystone user-create --name=quantum --pass="$SERVICE_PASSWORD" --tenant_id $SERVICE_TENANT--email=quantum@domain.com) keystone user-role-add --tenant_id $SERVICE_TENANT --user $QUANTUM_USER --role $ADMIN_ROLE keystone service-create --name=quantum --type=network --description="Quantum Service" 5、检查服务 keystone --token password --endpointhttp://10.13.4.20:35357/v2.0user-list keystone --token password --endpointhttp://10.13.4.20:35357/v2.0role-list keystone --token password --endpointhttp://10.13.4.20:35357/v2.0tenant-list keystone --token password --endpointhttp://10.13.4.20:35357/v2.0service-list keystone --token password --endpointhttp://10.13.4.20:35357/v2.0endpoint-list 6、校验 curl -d '{"auth": {"tenantName": "admin", "passwordCredentials":{"username": "admin", "password": "password"}}}' -H "Content-type: application/json"http://localhost:35357/v2.0/tokens|python-mjson.tool 本文转自 jxwpx 51CTO博客,原文链接:http://blog.51cto.com/jxwpx/856697,如需转载请自行联系原作者

优秀的个人博客,低调大师

centos 7 部署多实例tomcat

环境需求: 需要是centos 7 环境 安装软件: tengine-2.2.1 java-1.7.0-openjdk tomcat7 安装步骤: 环境准备 yumupdate−y yum install net-tools wget -y 使用网易yum源 mv/etc/yum.repos.d/CentOS−Base.repo/etc/yum.repos.d/CentOS−Base.repo.backup cd /etc/yum.repos.d/ $ wgethttp://mirrors.163.com/.help/CentOS7-Base-163.repo 安装tomcat 和 java $ yum install tomcat java-1.7.0-openjdk java-1.7.0-openjdk-devel vim telnet gcc pcre-devel openssl-devel -y 如果安装的java版本不是7,则可以通过如下命令切换。alternatives –config java 安装 nginx、tengine $ vim /etc/yum.repos.d/nginx.repo 增加如下内容: [nginx] name=nginx repo baseurl=http://nginx.org/packages/mainline/centos/7/$basearch/ gpgcheck=0 enabled=1 安装nginx yuminstallnginx−y wgethttp://tengine.taobao.org/download/tengine-2.2.1.tar.gz tar−xvf./tengine−2.2.1.tar.gz cd ./tengine-2.2.1 ./configure make && make install mv/usr/sbin/nginx/usr/sbin/nginxbak20171104 ln -s /usr/local/nginx/sbin/nginx /usr/sbin/nginx 使用 systemctl start nginx 启动 开放80端口 firewall−cmd–zone=public–add−port=80/tcp–permanent firewall-cmd –reload 修改dns /etc/resolv.conf添加nameserver192.168.12.253到第一行 /sbin/route add -net 192.168.0.0 netmask 255.255.0.0 gw 172.16.0.254 配置多实例tomcat 使用 systemd 管理多个 tomcat 实例 现在我们新建一个实例 fulfillment,目标是可以使用 systemctl start tomcat@fulfillment 类似的命令管理实例。 设置配置文件 tomcat 已经为我们提供了配置文件的模板,就是 /etc/sysconfig/tomcat 。 复制一份 /etc/sysconfig/tomcat ,并命令为 tomcat@fulfillment 。 命令如下: $ cp /etc/sysconfig/tomcat /etc/sysconfig/tomcat@fulfillment 修改配置文件的以下几项 CATALINA_BASE=/var/lib/tomcats/fulfillment/ CONNECTOR_PORT=”8180” CATALINA_OPTS=”-server -Xms4G -Xmx4G -XX:PermSize=512m -XX:MaxPermSize=512m -XX:MaxGC _可以根据需要再修改其他项。我们示例中只修改了 CATALINA_BASE 和 CONNECTOR_PORT。 新增了 CATALINA_OPTS(不支持多个OPTS,只能拼接)_ CATALINA_BASE 目录创建 /var/lib/tomcats/fulfillment/ 目录后,复制一些文件和文件夹即可。命令行如下: mkdir/var/lib/tomcats/fulfillment/ cd /var/lib/tomcats/fulfillment/ cp−pr/etc/tomcat/Catalinaconf/Catalina cp -pr /etc/tomcat/logging.properties conf/logging.properties cp−pr/etc/tomcat/server.xmlconf/server.xml cp -pr /var/log/tomcat logs cp−pr/var/cache/tomcat/temp. cp -pr /var/cache/tomcat/work . cp−pr/var/lib/tomcat/webapps. cd conf ln−s/etc/tomcat/context.xmlcontext.xml ln -s /etc/tomcat/web.xml web.xml 设置独立的启动用户 如果我们在启动 Java 进程的时候,不想使用 tomcat 用户。我们可以通过 override 来 实现。如下: mkdir−p/etc/systemd/system/tomcat@fulfillment.service.d/ vim /etc/systemd/system/tomcat@fulfillment.service.d/override.conf 新增如下内容: [Service] User=fulfillment 这个文件可以覆盖 /usr/lib/systemd/system/tomcat@.service 文件的配置。 启动服务 现在就可以使用 systemctl start tomcat@fulfillment 命令启动了。 启动后可以使用 systemctl status tomcat@fulfillment 查看启动结果。 如果,启动失败。可以通过 journalctl 命令查看日志信息。 可以使用 systemctl cat tomcat@fulfillment 这个服务的相关配置文件。 注意:如果在启动过程中出现文件没有权限。需要注意是否开启了 selinux。 调试命令 journalctl -u tomcat@fulfillment netstat -lntp ps aux | grep java

优秀的个人博客,低调大师

windows端部署python开发环境

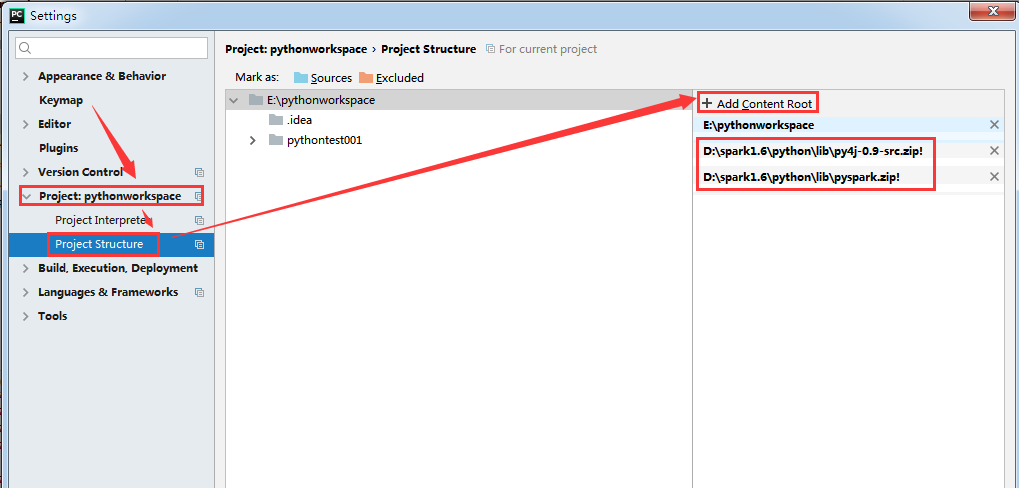
应用场景 在本地windows端,想开发python代码,或者运行python代码,需要在windows端安装python开发环境,来测试python代码,学习python。 操作步骤 1. 首先安装jdk1.8 配置环境变量等 jdk1.8下载地址 2. 安装Anaconda环境,配置环境变量 Anaconda下载地址 3. 安装spark,配置环境变量(spark1.6.1) spark1.6.1下载地址 4. 安装hadoop,配置环境变量(hadoop2.6.0) hadoop2.6.0下载地址 5. 安装pycharm python开发IDE工具下载地址 都安装完毕后,启动pycharm,选择左上角,File,Settings进行如下图设置,主要添加spark的两个依赖包:

优秀的个人博客,低调大师

Centos7单机部署ELK

一、简介 1.1介绍 ELK是三个开源工具组成,简单解释如下: Elasticsearch是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。 Logstash是一个完全开源的工具,它可以对你的日志进行收集、过滤,并将其存储供以后使用(如,搜索)。 Kibana 也是一个开源和免费的工具,它可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助您汇总、分析和搜索重要数据日志。 1.2场景分析 日志主要包括系统日志、应用程序日志和安全日志等等。运维人员和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。 通常,日志被分散的储存不同的设备上。如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志。这样是不是感觉很繁琐和效率低下。当务之急我们使用集中化的日志管理,例如:开源的syslog,将所有服务器上的日志收集汇总。 集中化管理日志后,日志的统计和检索又成为一件比较麻烦的事情,一般我们使用grep、awk和wc等Linux命令能实现检索和统计,但是对于要求更高的查询、排序和统计等要求和庞大的机器数量依然使用这样的方法难免有点力不从心。 这里采用开源实时日志分析ELK平台能够完美的解决我们上述的问题,当然也还有别的平台或者工具可以使用,这里只讨论ELK,官方网站:https://www.elastic.co 二、安装Elasticsearch 2.1安装jdk 1 2 3 4 # java -version java version "1.8.0_121" Java(TM) SE Runtime Environment (build 1.8 . 0_121 - b13) Java HotSpot(TM) 64 - Bit Server VM (build 25.121 - b13, mixed mode) 2.2安装Elasticsearch 1 2 3 4 5 # tar -zxvf elasticsearch-5.6.3.tar.gz # mv elasticsearch-5.6.3 /data/elasticsearch # cd elasticsearch/config/ # 备份配置文件 # cp elasticsearch.yml elasticsearch.yml.bak 编辑配置文件 1 2 3 4 5 6 7 8 9 # cat elasticsearch.yml | grep -v ^# cluster.name: elk - application node.name: node - 1 path.data: / data / elasticsearch / data path.logs: / data / elasticsearch / logs network.host: 172.16 . 220.248 http.port: 9200 discovery.zen.ping.unicast.hosts: [ "node-1" ] discovery.zen.minimum_master_nodes: 1 添加elasticsearch用户,不能使用root启动 1 2 3 # groupadd -g 1008 elasticsearch # useradd -g 1008 -u 1008 elasticsearch # chown -R elasticsearch:elasticsearch /data/elasticsearch/ 修改sysctl.conf文件 1 2 3 4 # vim /etc/sysctl.conf vm.max_map_count = 262144 # sysctl -p 修改/etc/security/limits.conf文件,修改打开文件句柄 1 2 3 4 * soft nofile 100000 * hard nofile 100000 * soft nproc 100000 * hard nproc 100000 添加hosts文件 1 2 # vim /etc/hosts 172.16 . 220.248 node - 1 启动 1 2 3 # su -s elasticsearch # cd /data/elasticsearch/bin # ./elasticearch & 查看是否启动 简单的curl测试 1 # curl http://172.16.220.248:9200 三、安装Logstash和filebeat filebeat用于在各个服务器上获取数据,发送到logstash上,再由logstash处理数据。 3.1安装logstash 1 2 # tar -zxvf logstash-5.6.3.tar.gz # mv logstash-5.6.3 /data/logstash 3.2安装filebeat 下载filebeat并启动,通过它来监听数据源文件的新增内容经过logstash处理后上传到es里面 1 2 3 4 # tar -zxvf filebeat-5.6.3-linux-x86_64.tar.gz # mv filebeat-5.6.3-linux-x86_64 /data/filebeat # cd /data/filebeat # cp filebeat.yml filebeat.yml.bak 编辑filebeat.yml文件 1 2 3 4 5 6 filebeat.prospectors: - input_type: log paths: - / var / log / message - log # 测试本机的一个log文件 output.logstash: hosts: [ "172.16.220.248:5044" ] 启动filebeat服务 1 2 # cd /data/filebeat # ./filebeat & 查看启动,filebeat没有监听端口,主要看日志和进程 1 2 # tialf logs/filebeat # ps -ef | grep filebeat filebeat监听的文件记录信息在/data/filebeat/data/registry 新建一个本地文件message-log,可以取几条本机系统的messages文件 3.3启动logstash 最后新建一个logstash的启动指定test.conf配置文件,内容如下: 1 2 3 4 5 6 7 8 9 10 11 input { beats { port = > "5044" } } output { elasticsearch { hosts = > "172.16.220.248:9200" } stdout { codec = > rubydebug } # 这是将输出打印在屏幕上,可以注释掉 } Logstash默认有input、filter、output三个区域,一般最少需要配置input和output即可! logstash的本身默认的logstash.yml配置文件选择不修改即可! 简单测试一下logstash不指定配置文件启动 1 2 # cd /data/filebeat/bin # ./logstash -e 'input { stdin {} } output {stdout {} }' 我们手动输入hello world,它也会输出 hello world 指定配置文件启动logstash 1 # ./logstash -f ../config/test.conf & 查看5044端口和9600端口是否开启 等待一会后应该会出现如下信息输出,这也就是test.conf里面最后一行定义输出到屏幕上 四、安装kibana 1 2 3 4 # tar -zxvf kibana-5.6.3-linux-x86_64.tar.gz # mv kibana-5.6.3-linux-x86_64 /data/kinbana # cd /data/kinbana/config/ # cp kibana.yml kibana.yml.bak 编辑kibana.yml配置文件 1 2 3 4 # vim kibana.yml server.port: 5601 server.host: "172.16.220.248" elasticsearch.url: "http://172.16.220.248:9200" 启动kinbana 1 2 # cd /data/kibana/bin # ./kibana & 查看端口 浏览器登入查看 点击create按钮后,然后点击上面的discover按钮,注意如果没数据的话,注意看看导入的时间@timestamp和现在的时间对比一下,kibana默认只显示最近15分钟的数据,如果超出15分钟请选择适当的时间,从kibana可以看到messages-log里面的15条数据都正常导入了。这就也完成我们的实现的第一个效果。但是这仅仅是把流程跑通了,接下来我们需要做的事情还有更多。注意只能先导入数据到es后才能在kibana创建索引。 五、获取Nginx access日志 Nginx日志格式在logstash的grok里面默认是没有的,需要我们手动配置,可以通过http://grokdebug.herokuapp.com/在线工具来判断配置是否正确。 5.1 在nginx服务器上安装filebeat 服务器: 172.16.200.160 1 2 3 4 # tar -zxvf filebeat-5.6.3-linux-x86_64.tar.gz # mv filebeat-5.6.3-linux-x86_64 /data/filebeat # cd /data/filebeat # cp filebeat.yml filebeat.yml.bak 修改filebeat配置文件 1 2 3 4 5 6 7 8 # cat filebeat.yml | grep -v ^$ | grep -v ^# | grep -v "#" filebeat.prospectors: - input_type: log paths: - /data/nginx/logs/160_access.log document_type: nginx_access output.logstash: hosts: ["172.16.220.248:5044"] 启动filebeat 1 # ./filebeat & 5.2 重新配置logstash启动配置文件 nginx日志格式,根据业务要求,我们这做了一些修改,比如增加cookie等,修改access.log日志时间格式等,这个会在另外的博客中写出来,会给出链接的。 nginx日志中添加cookie信息 nginx改变access.log中的时间格式 Nginx日志格式 1 2 3 4 5 6 7 8 log_format main '[$time_local] - $remote_addr:$remote_port - $upstream_addr $upstream_status $upstream_response_time - ' '"$request" $status $bytes_sent $request_time ' '"$http_referer" - "$http_user_agent" - ' '"$customerTag_cookie" - "$ym_cookie" - "$http_cookie" ' '"$http_x_forwarded_for"'; # 这里只是我们自己的格式,各位可以根据自己要求增删 grok使用表达式 可能我理解不是很到位,写的也比较复杂,我会把匹配对应项一一写出来,大家可以自己理解,然后为自己的项目配置 1 %{SYSLOG5424SD} - %{IPV4:clientip}:%{NUMBER:clientport} - %{IPV4:hostip}:%{NUMBER:itemport} %{INT:upstream_status} %{NUMBER:response_time} - \"%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}\" %{INT:status} %{INT:body_bytes_sent} %{NUMBER:request_time} %{QS:url} - %{QS:user_agent} - %{QS:customerTag} - %{QS:ym_traffic_session_id} - %{QS:all_cookies} %{IPV4:realip} grok匹配说明 1 %{SYSLOG5424SD} 时间格式 1 %{IPV4:clientip} 获取ip,clientip是自己命名的 1 %{NUMBER:clientport} NUMBER匹配数字 1 %{INT:upstream_status} INT整形 1 %{WORD:method} WORD单词 1 %{URIPATHPARAM:request} 获取请求内容request 1 %{QS:url} QS可以获取一段字符串 修改logstash启动配置文件 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 input { beats { port => "5044" } } filter { if [type] == "nginx_access" { grok { match => {"message" => "%{SYSLOG5424SD} - %{IPV4:clientip}:%{NUMBER:clientport} - %{IPV4:hostip}:%{NUMBER:itemport} %{INT:upstream_status} %{NUMBER:response_time} - \"%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}\" %{INT:status} %{INT:body_bytes_sent} %{NUMBER:request_time} %{QS:url} - %{QS:user_agent} - %{QS:customerTag} - %{QS:ym_traffic_session_id} - %{QS:all_cookies} %{IPV4:realip}"} } mutate { remove_field => "message" # 把message字段去掉,它会将上面单项获取的信息做个汇总,这样就重复了 } } } output { elasticsearch { hosts => "172.16.220.248:9200" } #stdout { codec => rubydebug } } 测试一下配置文件 1 ./logstash -t -f ../config/logstash.conf 重启logstash 不出问题elasticsearch 和kibana中就会有数据了

优秀的个人博客,低调大师

hadoop1.0安装部署(一)

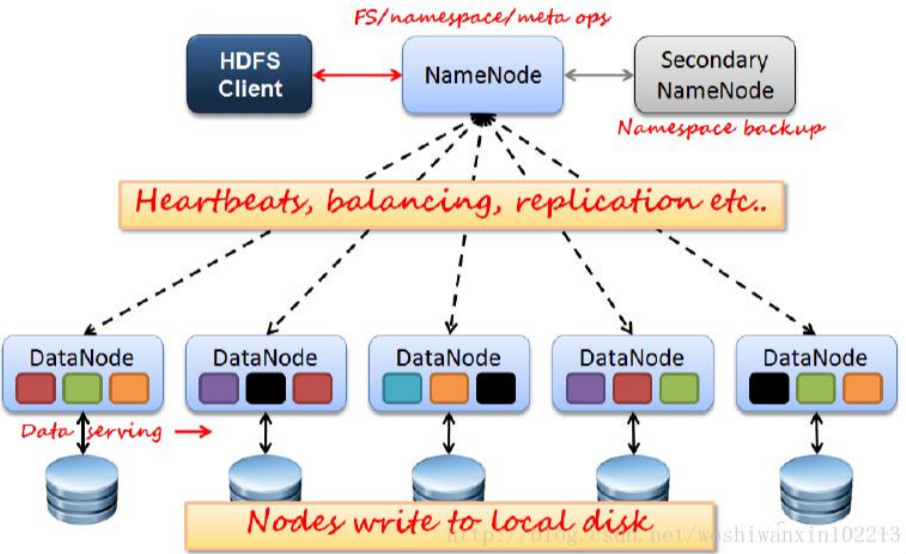
一、需求 公司线上运行有hadoop1.0和hadoop2.0,由于hadoop1.0没有处理jobtracker失败机制,它是一个单点故障,但业务还是以1.0为主,会慢慢过渡到2.0。 二、架构图 二、知识点储备 1、hadoop中NameNode、DataNode、Secondary、NameNode、JobTracker TaskTracker介绍 http://zouqingyun.blog.51cto.com/782246/1656353 2、hadoop有三种运行模式 独立(或本地)模式 无需运行任何守护进程,所有程序都在同一个JVM上执行。在独立模式下测试和调试MapReduce程序很方便,因此该模式在开发阶段比较合适 伪分布模式 Hadoop守护进程运行在本地机器上,模拟一个小规模集群 全分布模式 Hadoop守护进程运行在一个集群上。 2、Hadoop的配置文件: hadoop-env.sh: 用于定义hadoop运行环境相关的配置信息,比如配置JAVA_HOME环境变量、为hadoop的JVM指定特定的选项、指定日志文件所在的目录路径以及master和slave文件的位置等; core-site.xml: 用于定义系统级别的参数,如HDFS URL、Hadoop的临时目录以及用于rack-aware集群中的配置文件的配置等,此中的参数定义会覆盖core-default.xml文件中的默认配置; hdfs-site.xml: HDFS的相关设定,如文件副本的个数、块大小及是否使用强制权限等,此中的参数定义会覆盖hdfs-default.xml文件中的默认配置; mapred-site.xml:HDFS的相关设定,如reduce任务的默认个数、任务所能够使用内存的默认上下限等,此中的参数定义会覆盖mapred-default.xml文件中的默认配置; masters: hadoop的secondary-masters主机列表,当启动Hadoop时,其会在当前主机上启动NameNode和JobTracker,然后通过SSH连接此文件中的主机以作为备用NameNode; slaves:Hadoop集群的slave主机列表,master启动时会通过SSH连接至此列表中的所有主机并为其启动DataNode和taskTracker进程; 三、基本环境准备 1、机器 1 2 3 4 IP地址主机名扮演的角色 10.1 . 2.214 masterNameNode,JobTracker 10.1 . 2.215 slave-oneDataNode,TaskTracker 10.1 . 2.216 slave-twoSecondaryNameNode,DataNode和TaskTrakcer 2、系统版本 1 2 3 CentOSrelease 6.5 2.6 . 32 - 431 .el6.x86_64 3、关闭3台所有防火墙 service iptables stop 4、集群环境,时间同步很重要 master 启动ntpd服务 1 2 [root@master~]#servicentpdstart 正在启动ntpd:[确定] 添加定时网络时间服务器 1 2 3 4 [root@master~]#crontab-e nocrontab for root-usinganemptyone 30 ****/usr/sbin/ntpdatentp.sjtu.edu.cn>/dev/ null 2 >& 1 slave-one 1 2 [root@slave-one~]#crontab-l 10 ****/usr/sbin/ntpdate 10.1 . 2.214 >/dev/ null 2 >& 1 slave-two 1 2 [root@slave-twon~]#crontab-l 10 ****/usr/sbin/ntpdate 10.1 . 2.214 >/dev/ null 2 >& 1 5、三台主机hosts要对应 1 2 3 4 5 6 7 8 [root@master~]#vim/etc/hosts 127.0 . 0.1 localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 127.0 . 0.1 localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 :: 1 localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.1 . 2.214 master 10.1 . 2.215 slave-one 10.1 . 2.216 slave-two 6、安全起见,运行Hadoop需要以普通用户的身份进行,因此,接下来先建立运行hadoop进程的用户hadoop并给其设定密码。其他两台也一样 1 2 3 4 [root@master~]#vim/etc/hosts [root@master~]#groupaddhadoop [root@master~]#useradd-ghadoophadoop [root@master~]#echo "123456" |passwd--stdinhadoop 7、配置hadoop用户能够以基于密钥的验正方式登录本地主机,以便Hadoop可远程启动各节点上的Hadoop进程并执行监控等额外的管理工作。注意了,3台都要做相互免密钥! 1 2 3 4 [root@master~]#suhadoop [hadoop@master~]$ssh-keygen-trsa-P '' [hadoop@master~]$ssh-copy-id-i.ssh/id_rsa.pubhadoop@ 10.1 . 2.215 [hadoop@master~]$ssh-copy-id-i.ssh/id_rsa.pubhadoop@ 10.1 . 2.216 8、修改文件名柄 默认情况下,linux最大文件句柄数为1024个。服务器在大并发达到极限时,就会报出“too many open files”。这对集群来说,数量大时,会挂掉的 vim /etc/security/limits.conf 1 2 *softnofile 102400 *hardnofile 102400 重新登录,执行ulimit -a,ok ,参数生效了 四、安装配置hadoop集群 1、安装包准备 1 2 3 hadoop- 1.0 . 4 .tar.gz jdk1. 7 .0_25.tar.gz 2、安装jdk 2.1 安装JDK Hadoop依赖于1.6 update 8或更新版本的Java环境 1 [root@masterhadoop1. 0 ]#tarjdk-8u66-linux-x64.gz-C/usr/local/ 2.2Hadoop运行时需要能访问到如前安装的Java环境,这可以通过将其二进制程(/usr/local/jdk1.8.0_66)所在的目录添加至PATH环境变量的路径中实现,也可以通过设定hadoop-env.sh脚本来进行。这里采用前一种方式,编辑/etc/profile.d/java.sh,在文件中添加如下内容: 1 2 3 JAVA_HOME=/usr/usr/local/jdk1. 8 .0_66 PATH=$JAVA_HOME/bin:$PATH exportJAVA_HOMEPATH 2.3hadoop用户,并执行如下命令测试jdk环境配置是否就绪。 1 2 3 4 [hadoop@masterdata0]$java-version javaversion "1.7.0_25" Java(TM)SERuntimeEnvironment(build 1.7 .0_25-b15) JavaHotSpot(TM) 64 -BitServerVM(build 23.25 -b01,mixedmode) 3、hadoop安装配置 3.1安装 1 2 3 [root@masterhadoop1. 0 ]#tarxfhadoop- 1.0 . 4 .tar.gz-C/usr/local/ [root@masterhadoop1. 0 ]#chownhadoop:hadoop/usr/local/hadoop- 1.0 . 4 /-R 3.2 Java环境变量两种方法 3.2.1编辑/etc/profile.d/hadoop.sh,设定HADOOP_HOME环境变量的值为hadoop的解压目录,并让其永久有效。编辑/etc/profile,添加如下内容 1 2 3 HADOOP_BASE=/usr/local/hadoop- 1.0 . 4 PATH=$HADOOP_BASE/bin:$PATH exportHADOOP_BASEPATH 3.2.2 去到conf配置目录下找到环境变量文件hadoop-env.sh 确认JAVA_HOME路径是否正确 1 exportJAVA_HOME=/usr/local/jdk1. 8 .0_66 3.3 切换至hadoop用户,并执行如下命令测试hadoop是否就绪。 1 2 3 4 5 6 [hadoop@masterroot]$hadoopversion JavaHotSpot(TM) 64 -BitServerVMwarning:UsingincrementalCMS is deprecatedandwilllikelyberemoved in afuturerelease Hadoop 1.0 . 4 Subversionhttps: //svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290 CompiledbyhortonfoonWedOct 3 05 : 13 : 58 UTC 2012 Fromsource with checksumfe2baea87c4c81a2c505767f3f9b71f4 3.4 配置文件,在/usr/local/usr/local/hadoop-1.0.4/conf/目录下 3.4.1 hadoop-env.sh 记录脚本用到的环境变量,以运行hadoop namenode内存空间分配在这里为4096,在master机器上设置 1 exportHADOOP_HEAPSIZE= 4096 3.4.1core-site.xml 注意fs.default.name属性要正确配置,该属性用于配置namenode节点,我们都知道一个hadoop系统中一般只有一个namenode节点管理所有的datanode,所以设置一定要正确:hdfs://master:9000。一般默认都是9000端口 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>fs. default .name</name> <value>hdfs: //master:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/data0/hadoop/tmp</value> </property> <property> <name>io.file.buffer.size</name> <value> 65536 </value> </property> </configuration> 3.4.2hdfs-site.xml dfs.replication属性,顾名思义表示指定的hadoop文件块的备份数量,一般默认是3份,可以设为1 dfs.name.dir属性,非常重要,用来设置存放namenode数据的目录,如果这个目录访问失败,则会导致namenode启动失败 dfs.data.dir属性,用来指定datanode上本地存放数据的目录,与namenode的设置独立没有关系 dfs.name.dir属性,非常重要,namenode用来存储永久性的元数据的目录列表。namenode在列表上的各个目录中均存放相同元数据文件,如果这个目录访问失败,则会导致namenode启动失败 dfs.data.dir属性,用来指定datanode上本地存放数据块的目录列表,与namenode的设置独立没有 关系 fs.checkpoint.dir属性,辅助namenode存放检查点的目录列表。在所列的每个目录中均存放一份检查点文件副本 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>dfs.name.dir</name> <value>/data0/hadoop/dfs/name</value> </property> <property> <name>dfs.data.dir</name> </property> <property> <name>fs.checkpoint.dir</name> <value>/data0/hadoop/dfs/namesecondary</value> </property> <property> <name>fs.checkpoint.period</name> <value> 600 </value> <description>Thenumberofsecondsbetweentwoperiodiccheckpoints.</description> </property> <property> <name>dfs.namenode.handler.count</name> <value> 20 </value> <description>Thenumberofserverthreads for thenamenode.</description> </property> <property> <name>dfs.replication</name> <value> 2 </value> </property> <property> <name>dfs.datanode.du.reserved</name> <value> 32212254720 </value> <description>(30GB)Reservedspace in bytespervolume.Alwaysleave this muchspacefree for nondfs use .</description> </property> <property> <name>dfs.datanode.max.xcievers</name> <value> 4096 </value> <description>Thenumberofserverthreads for thedatanode.</description> </property> <property> <name>fs.trash.interval</name> <value> 300 </value> <description>time in minutes, 300 means 5 hours</description> </property> <property> <name>dfs.http.address</name> <!-- Thisshouldonlybe set onmaster Causeweneedtoaccesstheweb interface ofnamenode&jobtracker for WLAN <value>dcnamenode1: 50070 </value> --> <value> 0.0 . 0.0 : 50070 </value> </property> <property> <name>dfs.secondary.http.address</name> <value>slave-two: 50090 </value> </property> <property> <name>dfs.balance.bandwidthPerSec</name> <value> 5242880 </value> <description>Defaultvalue is 1048576 (1mb),that 'stooslow,setitto5242880(5mb).Wecann' t set ittoahighvalue,e.g.20mb, this willaffecttheexecutionofmap/reducetask.</description> </property> <property> <name>dfs.hosts.exclude</name> <value>/home/hadoop/hadoop- 1.0 . 4 /conf/exclude_hosts</value> <description>Namesafilethatcontainsalistofhoststhatare notpermittedtoconnecttothenamenode.Thefullpathnameofthe filemustbespecified.Ifthevalue is empty,nohostsare excluded.</description> </property> </configuration> 3.4.3mapred-site.xml mapred.jop.tracker属性用来设置JobTracker的主机、IP地址和端口,本机的话可以设置为:master:9001 maped.local.dir属性,逗号分隔的目录名称,默认值${hadoop.tmp.dir}/mapred.local。存储作业的中间数据的目录列表。作业终止时,数据被清除 maped.system.dir属性,类型为URI,默认值${hadop.tmp.dir}/mapred/system。在作业运行期间存储共享文件的目录,相对于fs.default.name maped.task tracker.map.tasks.maximum属性,类型为int,默认值为2,在任一时刻。允许在tasktracker上运行的map任务的最大数量 mapred.tasktracker.reduce.tasks.maximum属生,类型为string,默认值为-Xmx200m。JVM选项,用于启动运行map和reduce任务的tasktracker子进程。该属性可以针对每个作业进行设置。例如,可以设置JVM属性,支支技调试 mapreduce.map.java.opts属性,类型为String,默认值-Xmx200m。JVM选项,针对运行map的任务的子进程(在1.x版本中不出现) mapreduce.reduce.java.opts属性,类型为String,默认值-Xmx200m。JVM选项,针对运行reduce任务的子进程(在1.x版本中不出现) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>mapred.job.tracker</name> <value>master: 9001 </value> </property> <property> <name>mapred.job.tracker.http.address</name> <value> 0.0 . 0.0 : 50030 </value> </property> <property> <name>mapred.local.dir</name> <value>/data0/hadoop/mapred/map_loc</value> </property> <property> <name>mapred.system.dir</name> <value>/hadoop/mapred/system</value> </property> <property> <name>mapreduce.jobtracker.staging.root.dir</name> <value>/hadoop/mapred/staging</value> </property> <property> <name>mapred.job.tracker.handler.count</name> <value> 20 </value> </property> <property> <name>mapred.acls.enabled</name> <value> false </value> </property> <property> <name>mapred.tasktracker.map.tasks.maximum</name> <value> 8 </value> </property> <property> <name>mapred.tasktracker.reduce.tasks.maximum</name> <value> 4 </value> </property> <property> <name>mapred.child.java.opts</name> <value>-Xmx2048M-Xms512M</value> </property> <property> <name>io.sort.mb</name> <value> 320 </value> </property> <property> <name>io.sort.factor</name> <value> 50 </value> </property> <property> <name>mapred.reduce.slowstart.completed.maps</name> <value> 0.80 </value> </property> </configuration> 3.4.4masters 运行辅助namenode的机器列表(每行一个) 1 slave-two 3.4.5slavees 运行datanode和tasktracker的机器列表(每行一个) 1 2 slave-one slave-two 3.5 另外两台机器配置 3.5.1 把maseter下/usr/local/hadoop-1.0.4,/usr/local/jdk1.7.0_25,/etc/这两个目录和/etc/profile.d/hadoop.sh,/etc/profile.d/java.sh复制到另外两台机器,注意改好hadoop权限 1 2 3 4 [hadoop@masterlocal]$scp-r/etc/profile.d/java.shroot@ 10.1 . 2.215 :/etc/profile.d/ [hadoop@masterlocal]$scp-r/etc/profile.d/java.shroot@ 10.1 . 2.215 :/etc/profile.d/ [hadoop@masterlocal]$scp-r/usr/local/hadoop- 1.0 . 4 root@ 10.1 . 2.216 :/usr/local/ [hadoop@masterlocal]$scp-rusr/local/jdk1. 7 .0_25root@ 10.1 . 2.216 :/usr/local/jdk1. 7 .0_25 3.6 格式化名称节点 以hadoop用户运行如下命令 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [hadoop@masterroot]$hadoopnamenode-format 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=master/10.1.2.214 STARTUP_MSG:args=[-format] STARTUP_MSG:version=1.0.4 STARTUP_MSG:build=https://svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290;compiledby'hortonfo'onWedOct305:13:58UTC2012 ************************************************************/ 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:VMtype= 64 -bit 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet: 2 %maxmemory= 19.815 MB 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:capacity= 2 ^ 21 = 2097152 entries 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:recommended= 2097152 ,actual= 2097152 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:fsOwner=hadoop 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:supergroup=supergroup 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:isPermissionEnabled= true 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:dfs.block.invalidate.limit= 100 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:isAccessTokenEnabled= false accessKeyUpdateInterval= 0 min(s),accessTokenLifetime= 0 min(s) 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:Cachingfilenamesoccuringmorethan 10 times 16 / 01 / 08 19 : 11 : 37 ERRORnamenode.NameNode:java.io.IOException:Cannotcreatedirectory/data0/hadoop/dfs/name/current atorg.apache.hadoop.hdfs.server.common.Storage$StorageDirectory.clearDirectory(Storage.java: 297 ) atorg.apache.hadoop.hdfs.server.namenode.FSImage.format(FSImage.java: 1320 ) atorg.apache.hadoop.hdfs.server.namenode.FSImage.format(FSImage.java: 1339 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.format(NameNode.java: 1164 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.createNameNode(NameNode.java: 1271 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.main(NameNode.java: 1288 ) 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatmaster/10.1.2.214 ************************************************************/ 提示出错,无法创建/data0/hadoop目录,由此在三台机集事先创建/data0/hadoop目录并赋值于属主属组hadoop,再来执行 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 [hadoop@masterdata0]$hadoopnamenode-format 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=master/10.1.2.214 STARTUP_MSG:args=[-format] STARTUP_MSG:version=1.0.4 STARTUP_MSG:build=https://svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290;compiledby'hortonfo'onWedOct305:13:58UTC2012 ************************************************************/ 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:VMtype= 64 -bit 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet: 2 %maxmemory= 19.815 MB 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:capacity= 2 ^ 21 = 2097152 entries 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:recommended= 2097152 ,actual= 2097152 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:fsOwner=hadoop 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:supergroup=supergroup 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:isPermissionEnabled= true 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:dfs.block.invalidate.limit= 100 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:isAccessTokenEnabled= false accessKeyUpdateInterval= 0 min(s),accessTokenLifetime= 0 min(s) 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:Cachingfilenamesoccuringmorethan 10 times 16 / 01 / 08 19 : 34 : 30 INFOcommon.Storage:Imagefileofsize 112 saved in 0 seconds. 16 / 01 / 08 19 : 34 : 30 INFOcommon.Storage:Storagedirectory/data0/hadoop/dfs/namehasbeensuccessfullyformatted. 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatmaster/ 10.1 . 2.214 ************************************************************ 出现“Storage directory /data0/hadoop/dfs/name has been successfully formatted.”一行信息表明对应的存储已经格式化成功。 3.7 启动hadoop 1 2 3 4 5 6 7 8 9 10 [hadoop@masterdata0]$start-dfs.sh startingnamenode,loggingto/data0/hadoop/logs/hadoop-hadoop-namenode-master.out 10.1 . 2.216 :startingdatanode,loggingto/data0/hadoop/logs/hadoop-hadoop-datanode-slave-two.out 10.1 . 2.215 :startingdatanode,loggingto/data0/hadoop/logs/hadoop-hadoop-datanode-slave-one.out 10.1 . 2.216 :startingsecondarynamenode,loggingto/data0/hadoop/logs/hadoop-hadoop-secondarynamenode-slave-two.out [hadoop@masterdata0]$start-mapred.sh startingjobtracker,loggingto/data0/hadoop/logs/hadoop-hadoop-jobtracker-master.out 10.1 . 2.216 :startingtasktracker,loggingto/data0/hadoop/logs/hadoop-hadoop-tasktracker-slave-two.out 10.1 . 2.215 :startingtasktracker,loggingto/data0/hadoop/logs/hadoop-hadoop-tasktracker-slave-one.out 也可以start-all.sh来执行 3.8 运行jps命令查看正在运行的Hadoop进程 1 2 3 [hadoop@masterdata0]$jps|grep-iv "jps" 30772 NameNode 30960 JobTracker 1 2 3 4 [hadoop@slave-oneconf]$jps 27826 TaskTracker 27311 DataNode 28640 Jps 1 2 3 4 [hadoop@slave-twoconf]$jps|grep-vijps 12359 SecondaryNameNode 12773 TaskTracker 12268 DataNode 3.9 Hadoop守护进程的地址和端口 Hadoop守护进程一般同时运行RPC和HTTP两个服务器,RPC服务器支技守护进程间的通信,HTTP服务器则提供与用户交互的Web页面。 3.9.1 RPC服务器属性 fs.default.name属性,默认值file:///。被设为一个HDFS的URI时,该属性描述namenode的RPC服务器地址和端口,若未指定,默认8080端口 dfs.datanode.ipc.address属性,默认值0.0.0.0:50020。datanode的RPC服务器地址和端口 mapred.job.tracker属性,默认值local。被设为主机名称和端口号时,该属性指定jobtracker的RPC服务器地址和端口。常用端口号8021 mapred.taksk.tracker.report.address属性,默认值127.0.0.1:0。trakstracker的RPC服务器地址和端口号,tasktracker的子JVM利用它和tasktracker通信。在本例中,使用任一空闲端口均可行的。因为服务器仅绑定回送地址。仅当本机没有回送地址时才需要变更默认设置。 3.9.1 HTTP服务器的属性 mapred.job.tracker.http.address,默认值0.0.0.0:50030。jobtarcker的HTTP服务器地址和端口 mapred.task.tracker.http.address,默认值0.0.0.0:50060。tasktracker的HTTP服务器地址和端口 dfs.http.address,默认值0.0.0.0:50070。namenode的HTTP服务器地址和端口 dfs.datanode.http.address,默认值0.0.0.0:50075。datanode的HTTP服务器地址和端口 dfs.secondary.http.address,默认值0.0.0.0:50090。辅助namenode的HTTP服务器地址和端口 4.jobtracker界面 5.Namenode界面 本文转自 zouqingyun 51CTO博客,原文链接:http://blog.51cto.com/zouqingyun/1732659,如需转载请自行联系原作者

优秀的个人博客,低调大师

ELK日志分析集群部署笔记

ELK是什么?E=ElasticSearch ,一款基于的Lucene的分布式搜索引擎,我们熟悉的github,就是由ElastiSearch提供的搜索,据传已经有10TB+的数据量。L=LogStash , 一款分布式日志收集系统,支持多输入源,并内置一些过滤操作,支持多输入元K=Kibana , 一款配合ElasticSearch的web可视化界面,内置非常各种查询,聚合操作,并拥有漂亮的图形化展示功能为什么要用ELK?在实际应用中,我们的日志是非常重要的,它通常会记录一些比较重要的信息,如应用程序的log记录的error,warn级别的log,通常在量小的情况下,我们可以直接vi+awk+sed+grep定位原因,在量大的时候,这种方式就捉襟见肘了,而且我们还要各种聚合,或者基于异常多个关键词的搜索,并有且,或,交,并,差,补,排序等一些操作,而且相应速度必须给力,如果线上环境出了故障,能够立刻准确定位,ELK就是高手,在百万大军中取上将首级,犹如探囊取物,所以这时候ELK就非常适合了,当然除此之外,ELK也经常在运维工作中大放光彩,在应用级别的实时监控,非常适合一些重要核心服务的预警。ELK如何安装搭建?环境要求:Linux系统:Centos6.5 [root@ELK-Server ~]# cat /etc/redhat-release CentOS release 6.5 (Final) Java版本:JDK1.8 [root@ELK-Server ~]# java -version openjdk version "1.8.0_51" OpenJDK Runtime Environment (build 1.8.0_51-b16) OpenJDK 64-Bit Server VM (build 25.51-b03, mixed mode) ELK均为最新版本:(1)ElasticSearch1.7.2 基于Lucene4.10.4的版本(2)Logstash1.5.4(3)Kibana4.1.2集群拓扑:ElasticSearch 3台机器:集群名:search机器名+es节点名 => ip地址h1 => 192.168.1.120h2 => 192.168.1.121h3 => 192.168.1.122Logstash 192.168.1.120Kibana 192.168.1.120下载:elasticsearch: wget https://download.elastic.co/elasticsearch/elasticsearch/elasticsearch-1.7.3.tar.gzlogstash : wget https://download.elastic.co/logstash/logstash/logstash-1.5.4.tar.gzkibana : wget https://download.elastic.co/kibana/kibana/kibana-4.1.2-linux-x64.tar.gz 一: 安装elasticsearch集群:(1)解压到指定目录(2)配置elasticsearch.yml里面,集群名字和节点名字,如果不配置默认集群名为elasticsearch,节点名随机生成一个(3) 在线安装head和bigdisk插件直接在elasticsearch的根目录下,分别输入:bin/plugin --install mobz/elasticsearch-head 安装headbin/plugin --install lukas-vlcek/bigdesk 安装bigdesk(4)scp分发安装完毕后的elasticsearch(5)依次启动各个机器上的elasticsearch #/usr/local/elasticsearch/bin/elasticsearch 如果启动时遇到以下报错信息: [root@localhost elasticsearch]# ./bin/elasticsearch {1.7.3}: Initialization Failed ... - RuntimeException[Java version: 1.7.0_45 suffers from critical bug https://bugs.openjdk.java.net/browse/JDK-8024830 which can cause data corruption. Please upgrade the JVM, see http://www.elastic.co/guide/en/elasticsearch/reference/current/_installation.html for current recommendations. If you absolutely cannot upgrade, please add -XX:-UseSuperWord to the JVM_OPTS environment variable. Upgrading is preferred, this workaround will result in degraded performance.] 解决方法: # yum -y install java-1.8.0* # yum remove java 查看下java版本号:是否是1.8.0(因为最新版elasticsearch需要最新的java支持) [root@localhost elasticsearch]# java -version openjdk version "1.8.0_71" OpenJDK Runtime Environment (build 1.8.0_71-b15) OpenJDK 64-Bit Server VM (build 25.71-b15, mixed mode) 问题2: [root@localhost elasticsearch]# ./bin/elasticsearch Can't start up: not enough memory 解决方法也是重启安装下java 就行了 (6)head显示如下: (7)bigdisk显示如下:二:安装logstash(1)解压到指定目录(2)在根木下新建一个conf目录,在里面新建一个配置文件first.conf (3)启动logstash执行命令: bin/logstash -f conf/first.conf三:安装kibana(1)解压到指定目录(2)在根目录执行bin/kibana直接启动(3)访问http://192.168.1.120:5601/ 配置一个ElasticSearch索引(4)在logstach里面添加数据(5)查看图表:刚新加的数据四: 至此,ELK组件已经安装完毕,带图形化界面的简单日志查询分析系统就搞定了本篇只是一个简单的入门例子,如需深入可以研究elastic的官网文档:https://www.elastic.co/guide/index.html 本文转自yangxuncai110 51CTO博客,原文链接:http://blog.51cto.com/zlyang/1737622,如需转载请自行联系原作者

优秀的个人博客,低调大师

SMS+SP2的部署

实验拓扑图: 安装条件: 1.Perth上必须有大于8G的空间。 2.在Perth上打开开始——设置——控制面板——添加\删除程序——添加\删除windows组件——应用程序服务中的下列组件,如下图所示 3允许ASP. BITS服务器扩展和WebDAV,在开始——程序——管理工具——IIS服务中的Web服务扩展 4安装SQL2000+sp4 1) 点击安装SQL Server 2000组件 2) 安装数据库服务器 3) 提示不支持低于SQL Server 200 SP2,继续 4) SQL Server 2000安装向导,点击下一步 5) 本地计算机 6) 创建新的SQL Server实例,或安装客户端工具 7) 填写用户信息 8) 同意许可协议 9) 服务器和客户端工具 10)实例名默认 11)选择典型安装 12)注意,使用本地系统帐户 13)Windows身份验证模式 14)开始复制文件,下一步 15)每客户,500继续 16)正在安装 17)安装完成 安装SQL Server 2000的sp4 点击下一步 同意许可协议 下一步 选择windows身份验证 忽略安全威胁警告,保留密码为空 升级Microsoft Search并应用SQL Server 2000 sp4 确定 开始复制文件,下一步 正在安装 确定 安装完成 启动SQL Server和SQL Server Agent 4.扩展AD架构 在florence上进行架构扩展。放入SMS2003的安装光盘,在D:\SMSSETUP\BIN\I386中运行extadsch.exe进行架构扩展。在c:\ExtADSch.log中可以看见扩展内容 5.设置AD权限 放入windows 2003光盘,运行D:\SUPPORT\TOOLS\SUPTOOLS.MSI。点击NEXT 同意许可协议下一步 用户信息,下一步 选择存放目录 安装完成 运行adsiedit.msc.点击Domain [FLORENCE.smstest.com].右击CN=System属性,安全。添加一个计算机Perth(截图出错,应该是Perth) 点击高级,编辑PERTH.赋予perht完全控制权限 OK,现在可以安装SMS2003+sp2了。 放入sms2003光盘,安装向导,点击SMS2003 下一步 下一步 安装SMS主站点 选择定制安装 同意许可协议 输入用户信息和密钥 输入站点代码名成设为001和站点名称为ITET所属域SMATEST 已经为AD进行过扩展,下一步 选择高级安全模式,下一步 用户数为100 勾选Remote Tools Berlin是数据库服务器,选择集成身份验证 Yes,下一步 下一步 下一步 SMS管理控制台数量和SQL Server的最大连接数都使用默认值 完成 正在安装 安装完成 安装sms2003 sp2,放入SMS_SP2光盘,点击SMS 2003 Server Pack2 安装向导,下一步 下一步 升级现有SMS安装 同意许可协议 勾选“…..我准备升级SMS站点 点击立即运行 通过检测 选择不接受未经签名的数据 正在完成SMS安装向导,点击完成 SMS升级成功 升级成功后需要等20多分钟 本文转自 范琳琳 51CTO博客,原文链接:http://blog.51cto.com/fanlinlin/114381,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册