首页 文章 精选 留言 我的

精选列表

搜索[ 文档处理],共10000篇文章
优秀的个人博客,低调大师

大数据处理书籍

apache yarn http://www.amazon.com/Apache-Hadoop-YARN-Processing-Addison-Wesley/dp/0321934504/ref=sr_1_1?ie=UTF8&qid=1383118090&sr=8-1&keywords=apache+yarn zookeeper http://www.amazon.com/ZooKeeper-Distributed-coordination-Flavio-Junqueira/dp/1449361307/ref=sr_1_sc_3?ie=UTF8&qid=1384052593&sr=8-3-spell&keywords=zoomkeeper Data Analysis with Open Source Tools http://www.amazon.com/Data-Analysis-Open-Source-Tools/dp/0596802358/ref=sr_1_13?ie=UTF8&qid=1384052694&sr=8-13&keywords=hbase Fast Data Processing with Spark http://www.amazon.com/Fast-Processing-Spark-Holden-Karau/dp/1782167064/ref=sr_1_2?ie=UTF8&qid=1383118177&sr=8-2&keywords=apache+spark learning spark http://www.amazon.com/Learning-Spark-Lightning-fast-data-analytics/dp/1449358624/ref=pd_sim_sbs_b_3/190-4875999-4382525 http://www.oschina.net/project/tag/191/distributed-and-grid?lang=0&os=0&sort=view&p=1 http://www.oschina.net/project/tag/144/logging 日志关联引擎: http://www.oschina.net/p/masslogprocess kibana http://product.china-pub.com/3768532#ml http://product.china-pub.com/3768650 http://product.china-pub.com/3768791

优秀的个人博客,低调大师

Hadoop Browse the filesystem 无效处理

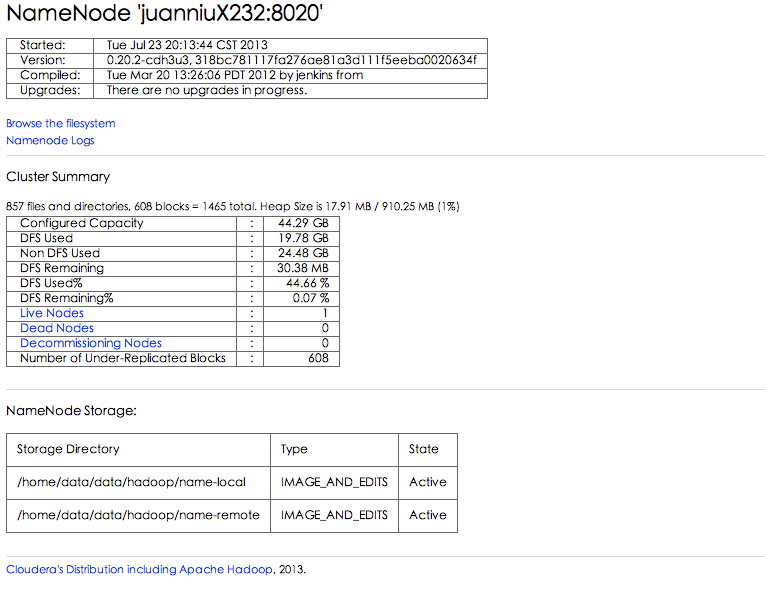
当我们安装好并正常运行hdfs后输入http://xxxxxxxxx:50070会进入下图所示的页面。 其中Browse the filesystem是查看文件系统的入口。 但是在发现这个链接一直无效。通过Chrome的开发工具可以看这个链接访问地址是:nn_browsedfscontent.jsp 下面是nn_browsedfscontent.jsp的代码 1 <%@ page 2 contentType="text/html; charset=UTF-8" 3 import="java.io.*" 4 import="java.security.PrivilegedExceptionAction" 5 import="java.util.*" 6 import="javax.servlet.*" 7 import="javax.servlet.http.*" 8 import="org.apache.hadoop.conf.Configuration" 9 import="org.apache.hadoop.hdfs.*" 10 import="org.apache.hadoop.hdfs.server.namenode.*" 11 import="org.apache.hadoop.hdfs.server.datanode.*" 12 import="org.apache.hadoop.hdfs.protocol.*" 13 import="org.apache.hadoop.hdfs.security.token.delegation.*" 14 import="org.apache.hadoop.io.Text" 15 import="org.apache.hadoop.security.UserGroupInformation" 16 import="org.apache.hadoop.security.token.Token" 17 import="org.apache.hadoop.util.*" 18 import="java.text.DateFormat" 19 import="java.net.InetAddress" 20 import="java.net.URLEncoder" 21 %> 22 <%! 23 static String getDelegationToken(final NameNode nn, 24 HttpServletRequest request, Configuration conf) 25 throws IOException, InterruptedException { 26 final UserGroupInformation ugi = JspHelper.getUGI(request, conf); 27 Token<DelegationTokenIdentifier> token = 28 ugi.doAs( 29 new PrivilegedExceptionAction<Token<DelegationTokenIdentifier>>() 30 { 31 public Token<DelegationTokenIdentifier> run() throws IOException { 32 return nn.getDelegationToken(new Text(ugi.getUserName())); 33 } 34 }); 35 return token.encodeToUrlString(); 36 } 37 38 public void redirectToRandomDataNode( 39 NameNode nn, 40 HttpServletRequest request, 41 HttpServletResponse resp, 42 Configuration conf 43 ) throws IOException, InterruptedException { 44 String tokenString = null; 45 if (UserGroupInformation.isSecurityEnabled()) { 46 tokenString = getDelegationToken(nn, request, conf); 47 } 48 FSNamesystem fsn = nn.getNamesystem(); 49 String datanode = fsn.randomDataNode(); 50 String redirectLocation; 51 String nodeToRedirect; 52 int redirectPort; 53 if (datanode != null) { 54 redirectPort = Integer.parseInt(datanode.substring(datanode.indexOf(':') 55 + 1)); 56 nodeToRedirect = datanode.substring(0, datanode.indexOf(':')); 57 } 58 else { 59 nodeToRedirect = nn.getHttpAddress().getHostName(); 60 redirectPort = nn.getHttpAddress().getPort(); 61 } 62 String fqdn = InetAddress.getByName(nodeToRedirect).getCanonicalHostName(); 63 redirectLocation = "http://" + fqdn + ":" + redirectPort + 64 "/browseDirectory.jsp?namenodeInfoPort=" + 65 nn.getHttpAddress().getPort() + 66 "&dir=/" + 67 (tokenString == null ? "" : 68 JspHelper.getDelegationTokenUrlParam(tokenString)); 69 resp.sendRedirect(redirectLocation); 70 } 71 %> 72 73 <html> 74 75 <title></title> 76 77 <body> 78 <% 79 NameNode nn = (NameNode)application.getAttribute("name.node"); 80 Configuration conf = (Configuration) application.getAttribute(JspHelper.CURRENT_CONF); 81 redirectToRandomDataNode(nn, request, response, conf); 82 %> 83 <hr> 84 85 <h2>Local logs</h2> 86 <a href="/logs/">Log</a> directory 87 88 <% 89 out.println(ServletUtil.htmlFooter()); 90 %> 从代码中可以看出实际是跳转到一台datanode的browseDirectory.jsp,如: http://xxxxxxx:50075/browseDirectory.jsp?namenodeInfoPort=50070&dir=/ 而xxxxxxx是集群中一台datanode的主机名。 那么就可以从以下两个点出发去看为什么无效: 1.50075端口是否正常 2.使用的机器是否能通过主机面访问datanode 检查之后发现自己这两个都没有配置...... 最后通过在hdfs-site.xml中添加如下配置 <property> <name>dfs.datanode.http.address</name> <value>10.0.0.234:50075</value> </property> 在hosts中添加datanode的主机命和ip修复了这个问题 记录、共勉。 如果本文对您有帮助,点一下右下角的“推荐”

优秀的个人博客,低调大师

Tushare接口文档:股票历史列表(bak_basic)

- **功能描述**:获取股票基本信息每日历史记录 - **返回限量**:单次请求最大返回7000行 - **接口权限**:5000积分:500次/分钟 - **说明**: > 本接口是股票基本信息的每日快照,但每天会更新多次。注意当日数据的更新。示例2有更加详细的演示。 ## 输入参数: | 名称 | 类型 | 必选 | 描述 | | - | - | - | - | | trade_date | str | N | 交易日期 | | ts_code | str | N | 股票代码 | ## 输出参数: | 名称 | 类型 | 默认显示 | 描述 | | - | - | - | - | | trade_date | str | Y | 交易日期 | | ts_code | str | Y | TS股票代码 | | name | str | Y | 股票名称 | | industry | str | Y | 行业 | | area | str | Y | 地域 | | pe | float | Y | 市盈率(动) | | float_share | float | Y | 流通股本(亿) | | total_share | float | Y | 总股本(亿) | | total_assets | float | Y | 总资产(亿) | | liquid_assets | float | Y | 流动资产(亿) | | fixed_assets | float | Y | 固定资产(亿) | | reserved | float | Y | 公积金 | | reserved_pershare | float | Y | 每股公积金 | | eps | float | Y | 每股收益 | | bvps | float | Y | 每股净资产 | | pb | float | Y | 市净率 | | list_date | str | Y | 上市日期 | | undp | float | Y | 未分配利润 | | per_undp | float | Y | 每股未分配利润 | | rev_yoy | float | Y | 收入同比(%) | | profit_yoy | float | Y | 利润同比(%) | | gpr | float | Y | 毛利率(%) | | npr | float | Y | 净利润率(%) | | holder_num | int | Y | 股东人数 | ## 示例: ### 示例1:查询指定日期的全市场股票列表 通过传递`trade_date`可指定返回数据的交易日期。传递`fields`参数可指定返回数据的字段列表。 ```python import tushare as ts pro = ts.pro_api() df = pro.bak_basic(trade_date='20260821', fields='trade_date,ts_code,name,industry,pe') df ``` 输出结果: ```xml trade_date ts_code name industry pe 0 20260821 000001.SZ 平安银行 银行 4.30 1 20260821 000002.SZ 万 科A 全国地产 0.00 2 20260821 000006.SZ 深振业A 区域地产 320.13 3 20260821 000007.SZ 全新好 其他商业 0.00 4 20260821 000008.SZ 神州高铁 运输设备 0.00 ... ... ... ... ... ... 5553 20260821 920982.BJ 锦波生物 医疗保健 25.35 5554 20260821 920985.BJ 海泰新能 电气设备 0.00 5555 20260821 920992.BJ 中科美菱 医疗保健 57.09 5556 20260821 920071.BJ 金钛股份 小金属 0.00 5557 20260821 920288.BJ 华大海天 造纸 0.00 5558 rows × 5 columns ``` ### 示例2:查询指定股票的历史数据 通过传递`ts_code`可指定特定的股票。 > 示例运行时间是2026/08/21 14:00,此时已经存在8/21日的数据,此时的PE还是和前一天一样。注意该条记录会在晚上进行更新。 ```python df = pro.bak_basic(ts_code='000001.SZ', fields='trade_date,ts_code,name,industry,pe') df ``` 输出结果: ```xml trade_date ts_code name industry pe 0 20260821 000001.SZ 平安银行 银行 4.30 1 20260820 000001.SZ 平安银行 银行 4.30 2 20260819 000001.SZ 平安银行 银行 4.26 3 20260818 000001.SZ 平安银行 银行 4.17 4 20260817 000001.SZ 平安银行 银行 4.19 ... ... ... ... ... ... 2409 20160815 000001.SZ 平安银行 银行 6.76 2410 20160812 000001.SZ 平安银行 银行 6.70 2411 20160811 000001.SZ 平安银行 银行 6.50 2412 20160809 000001.SZ 平安银行 银行 6.45 2413 20151205 000001.SZ 平安银行 银行 6.51 2414 rows × 5 columns ``` ### 示例3:股东人数变化分析 通过对比不同日期的 holder_num(股东人数)字段,可以分析个股的筹码集中度变化趋势。 ```python import pandas as pd # 获取某只股票在两个时间点的股东人数 ts_code = '000001.SZ' dates = ['20211231', '20221230', '20231229', '20241231', '20251231'] df_list = [] for date in dates: df = pro.bak_basic( trade_date=date, ts_code=ts_code, fields='trade_date,ts_code,name,holder_num' ) df_list.append(df) df_compare = pd.concat(df_list, ignore_index=True) print(df_compare) ``` 输出结果: ```xml trade_date ts_code name holder_num 0 20211231 000001.SZ 平安银行 390490 1 20221230 000001.SZ 平安银行 547735 2 20231229 000001.SZ 平安银行 530229 3 20241231 000001.SZ 平安银行 517695 4 20251231 000001.SZ 平安银行 453515 ``` ## 说明: `bak_basic`返回指定交易日全部股票的基础信息与核心财务指标,包括股票代码、名称、行业、地域、市盈率、股本、资产、每股收益、市净率、股东人数等。与仅提供股票代码和名称的`stock_basic`接口相比,`bak_basic`附带了一个截面上的基本面快照,是进行历史回测、截面分析和因子研究的重要数据源。

优秀的个人博客,低调大师

Tushare接口文档:IPO新股列表(new_share)

- **功能描述**:获取新股上市列表数据 - **返回限量**:单次请求最大返回2000行 - **接口权限**:2000积分:200次/分钟;5000积分:500次/分钟 - **说明**: > 本接口的数据会根据股票上市的进程对相应的字段进行更新。示例1有较为详尽的介绍; ## 输入参数: | 名称 | 类型 | 必选 | 描述 | | - | - | - | - | | start_date | str | N | 上网发行开始日期 | | end_date | str | N | 上网发行结束日期 | ## 输出参数: | 名称 | 类型 | 默认显示 | 描述 | | - | - | - | - | | ts_code | str | Y | TS股票代码 | | sub_code | str | Y | 申购代码 | | name | str | Y | 名称 | | ipo_date | str | Y | 上网发行日期 | | issue_date | str | Y | 上市日期 | | amount | float | Y | 发行总量(万股) | | market_amount | float | Y | 上网发行总量(万股) | | price | float | Y | 发行价格 | | pe | float | Y | 市盈率 | | limit_amount | float | Y | 个人申购上限(万股) | | funds | float | Y | 募集资金(亿元) | | ballot | float | Y | 中签率 | ## 示例: ### 示例1:获取某段时间内A股IPO的股票 通过传递`start_date`和`end_date`可指定返回首次发行日期的范围。本示例运行的时间是2026/08/21 11:00。通过示例输出数据可以看出,虽然还未发行,但在计划内的信息已经能够获取到。本接口的数据会根据股票上市的进程对相应的字段进行更新。 ```python import tushare as ts pro = ts.pro_api() df = pro.new_share(start_date='20260801', end_date='20260831') df ``` 输出结果: ```xml ts_code sub_code name ipo_date issue_date amount market_amount price pe limit_amount funds ballot 0 301689.SZ 301689 电科思仪 20260828 None 10207.0 0.0 0.00 0.00 1.20 0.000 0.00 1 301699.SZ 301699 洛轴股份 20260826 None 12400.0 0.0 0.00 0.00 1.45 0.000 0.00 2 603448.SH 732448 天博智能 20260826 None 3000.0 0.0 0.00 0.00 0.95 0.000 0.00 3 920289.BJ 920289 华汇智能 20260824 None 1700.0 1190.0 17.71 14.99 72.25 3.011 0.00 4 601123.SH 780123 马矿股份 20260821 None 12350.0 2964.0 6.65 13.81 2.95 8.213 0.00 5 301688.SZ 301688 格林生物 20260820 None 3333.0 1250.0 26.33 19.80 0.70 8.777 0.01 6 301697.SZ 301697 贝特利 20260819 None 6570.0 2306.0 12.10 24.33 1.35 7.950 0.02 7 920071.BJ 920071 金钛股份 20260819 None 4500.0 3150.0 9.72 13.41 157.50 4.374 0.00 8 920288.BJ 920288 华大海天 20260817 None 2056.0 1520.0 12.57 13.99 89.40 2.585 0.02 9 688835.SH 787835 高凯技术 20260814 None 2499.0 800.0 61.36 48.33 0.55 15.332 0.02 10 920093.BJ 920093 信胜科技 20260812 20260821 3600.0 2520.0 14.35 9.20 126.00 5.166 0.03 11 301655.SZ 301655 绿控传动 20260810 20260820 6834.0 1914.0 8.50 27.56 0.95 5.809 0.02 12 688836.SH 787836 宇树科技 20260810 20260819 4045.0 971.0 150.80 103.25 0.60 60.993 0.02 13 920059.BJ 920059 双英集团 20260810 20260819 4372.0 2662.0 11.13 13.48 161.59 4.867 0.03 14 688826.SH 787826 频准激光 20260807 20260818 1000.0 321.0 186.88 49.42 0.20 18.688 0.02 15 920107.BJ 920107 恒兴股份 20260805 20260817 2097.0 1887.0 16.02 13.67 94.36 3.359 0.02 16 920138.BJ 920138 杰理科技 20260803 20260812 3300.0 2970.0 18.86 14.99 148.50 6.224 0.04 ``` ### 示例2:中签率分布分析 本示例演示2025年A股新股中签率分布。 ```python import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['SimHei'] # Windows 黑体 plt.rcParams['axes.unicode_minus'] = False # 解决负号显示问题 # 获取新股数据 df = pro.new_share(start_date='20250101', end_date='20251231') # 剔除中签率为0或空值的记录 df_ballot = df[df['ballot'] > 0] print(f"中签率统计:") print(f" 平均值: {df_ballot['ballot'].mean():.4f}%") print(f" 中位数: {df_ballot['ballot'].median():.4f}%") print(f" 最大值: {df_ballot['ballot'].max():.4f}%") print(f" 最小值: {df_ballot['ballot'].min():.4f}%") # 绘制中签率分布直方图 plt.figure(figsize=(10, 6)) plt.hist(df_ballot['ballot'], bins=50, edgecolor='black') plt.xlabel('中签率 (%)') plt.ylabel('新股数量') plt.title('新股中签率分布') plt.show() ``` 输出结果 ```xml 中签率统计: 平均值: 0.0334% 中位数: 0.0300% 最大值: 0.5600% 最小值: 0.0100% ``` ![image.png](https://developer.qcloudimg.com/http-save/yehe-12614088/8a43b2f30f750e41e3172a2ad467b708.png) ### 示例3:筛选高收益潜力新股 结合发行价格、市盈率、中签率等指标,可以初步筛选具有打新价值的新股。 > 注意:本示例仅作为演示,参数和结果均不作为投资建议。 ```python # 获取近期新股数据(假设查询2026年7月以来数据) df = pro.new_share(start_date='20260701', end_date='20260831') # 筛选条件:发行价格较低( 0.01) ] print(f"符合筛选条件的新股数量: {len(df_filtered)}") df_filtered[['name', 'price', 'pe', 'ballot', 'funds']].sort_values('ballot', ascending=False) ``` 输出结果: ```xml 符合筛选条件的新股数量: 14 name price pe ballot funds 31 乔路铭 14.36 14.99 0.05 7.180 16 杰理科技 18.86 14.99 0.04 6.224 10 信胜科技 14.35 9.20 0.03 5.166 13 双英集团 11.13 13.48 0.03 4.867 28 长鹰硬科 18.89 14.99 0.03 3.418 30 泰诺麦博 14.46 0.00 0.03 9.989 32 龙鑫智能 17.83 14.99 0.03 4.005 6 贝特利 12.10 24.33 0.02 7.950 8 华大海天 12.57 13.99 0.02 2.585 11 绿控传动 8.50 27.56 0.02 5.809 15 恒兴股份 16.02 13.67 0.02 3.359 19 珈凯生物 19.26 14.98 0.02 1.395 23 津富士达 17.46 19.25 0.02 7.199 24 聚仁新材 4.48 14.97 0.02 1.792 ``` ## 说明: `new_share`接口用于获取新股上市列表数据,包括新股的基本信息、发行数据和申购数据。该接口覆盖了从新股上网发行到正式上市的全过程数据,是进行打新策略研究、新股市场分析的重要工具。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册