首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10000篇文章
优秀的个人博客,低调大师

带你认识JDK8中超nice的Native Memory Tracking

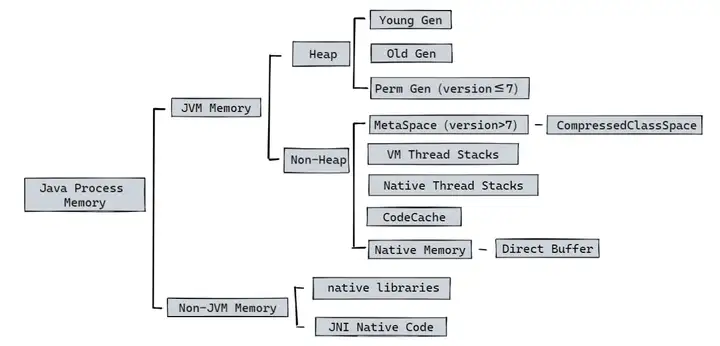
摘要:从 OpenJDK8 起有了一个很 nice 的虚拟机内部功能: Native Memory Tracking (NMT)。 本文分享自华为云社区《Native Memory Tracking 详解(1):基础介绍》,作者:毕昇小助手。 0.引言 我们经常会好奇,我启动了一个 JVM,他到底会占据多大的内存?他的内存都消耗在哪里?为什么 JVM 使用的内存比我设置的 -Xmx 大这么多?我的内存设置参数是否合理?为什么我的 JVM 内存一直缓慢增长?为什么我的 JVM 会被 OOMKiller 等等,这都涉及到 JAVA 虚拟机对内存的一个使用情况,不如让我们来一探其中究竟。 1.简介 除去大家都熟悉的可以使用 -Xms、-Xmx 等参数设置的堆(Java Heap),JVM 还有所谓的非堆内存(Non-Heap Memory)。 可以通过一张图来简单看一下 Java 进程所使用的内存情况(简略情况): 非堆内存包括方法区和Java虚拟机内部做处理或优化所需的内存。 方法区:在所有线程之间共享,存储每个类的结构,如运行时常量池、字段和方法数据,以及方法和构造函数的代码。方法区在逻辑上(虚拟机规范)是堆的一部分,但规范并不限定实现方法区的内存位置和编译代码的管理策略,所以不同的 Java 虚拟机可能有不同的实现方式,此处我们仅讨论 HotSpot。 除了方法区域外,Java 虚拟机实现可能需要内存用于内部的处理或优化。例如,JIT编译器需要内存来存储从Java虚拟机代码转换的本机代码(储存在CodeCache中),以获得高性能。 从 OpenJDK8 起有了一个很 nice 的虚拟机内部功能: Native Memory Tracking (NMT) 。我们可以使用 NMT 来追踪了解 JVM 的内存使用详情(即上图中的 JVM Memory 部分),帮助我们排查内存增长与内存泄漏相关的问题。 2.如何使用 2.1 开启 NMT 默认情况下,NMT是处于关闭状态的,我们可以通过设置 JVM 启动参数来开启:-XX:NativeMemoryTracking=[off | summary | detail]。 注意:启用NMT会导致5% -10%的性能开销。 NMT 使用选项如下表所示: 我们注意到,如果想使用 NMT 观察 JVM 的内存使用情况,我们必须重启 JVM 来设置XX:NativeMemoryTracking 的相关选项,但是重启会使得我们丢失想要查看的现场,只能等到问题复现时才能继续观察。 笔者试图通过一种不用重启 JVM 的方式来开启 NMT ,但是很遗憾目前没有这样的功能。 JVM 启动后只有被标记为 manageable 的参数才可以动态修改或者说赋值,我们可以通过 JDK management interface (com.sun.management.HotSpotDiagnosticMXBean API) 或者 jinfo -flag 命令来进行动态修改的操作,让我们看下所有可以被修改的参数值(JDK8): java -XX:+PrintFlagsFinal | grep manageable intx CMSAbortablePrecleanWaitMillis = 100 {manageable} intx CMSTriggerInterval = -1 {manageable} intx CMSWaitDuration = 2000 {manageable} bool HeapDumpAfterFullGC = false {manageable} bool HeapDumpBeforeFullGC = false {manageable} bool HeapDumpOnOutOfMemoryError = false {manageable} ccstr HeapDumpPath = {manageable} uintx MaxHeapFreeRatio = 100 {manageable} uintx MinHeapFreeRatio = 0 {manageable} bool PrintClassHistogram = false {manageable} bool PrintClassHistogramAfterFullGC = false {manageable} bool PrintClassHistogramBeforeFullGC = false {manageable} bool PrintConcurrentLocks = false {manageable} bool PrintGC = false {manageable} bool PrintGCDateStamps = false {manageable} bool PrintGCDetails = false {manageable} bool PrintGCID = false {manageable} bool PrintGCTimeStamps = false {manageable} 很显然,其中不包含 NativeMemoryTracking 。 2.2 使用 jcmd 访问 NMT 数据 我们可以通过 jcmd 命令来很方便的查看 NMT 相关的数据: jcmd VM.native_memory [summary | detail | baseline | summary.diff | detail.diff | shutdown] [scale= KB | MB | GB] jcmd 操作 NMT 选项如下表所示: NMT 默认打印的报告是 KB 来进行呈现的,为了满足我们不同的需求,我们可以使用scale=MB | GB来更加直观的打印数据。 创建 baseline 之后使用 diff 功能可以很直观地对比出两次 NMT 数据之间的差距。 看到 shutdown 选项,笔者本能的一激灵,既然我们可以通过 shutdown 来关闭 NMT ,那为什么不能通过逆向 shutdown 功能来动态的开启 NMT 呢?笔者找到 shutdown 相关源码(以下都是基于 OpenJDK 8): # hotspot/src/share/vm/services/nmtDCmd.cpp void NMTDCmd::execute(DCmdSource source, TRAPS) { // Check NMT state // native memory tracking has to be on if (MemTracker::tracking_level() == NMT_off) { output()->print_cr("Native memory tracking is not enabled"); return; } else if (MemTracker::tracking_level() == NMT_minimal) { output()->print_cr("Native memory tracking has been shutdown"); return; } ...... //执行 shutdown 操作 else if (_shutdown.value()) { MemTracker::shutdown(); output()->print_cr("Native memory tracking has been turned off"); } ...... } # hotspot/src/share/vm/services/memTracker.cpp // Shutdown can only be issued via JCmd, and NMT JCmd is serialized by lock void MemTracker::shutdown() { // We can only shutdown NMT to minimal tracking level if it is ever on. if (tracking_level () > NMT_minimal) { transition_to(NMT_minimal); } } # hotspot/src/share/vm/services/nmtCommon.hpp // Native memory tracking level //NMT的追踪等级 enum NMT_TrackingLevel { NMT_unknown = 0xFF, NMT_off = 0x00, NMT_minimal = 0x01, NMT_summary = 0x02, NMT_detail = 0x03 }; 遗憾的是通过源码我们发现,shutdown 操作只是将 NMT 的追踪等级 tracking_level 变成了 NMT_minimal 状态(而并不是直接变成了 off 状态),注意注释:We can only shutdown NMT to minimal tracking level if it is ever on(即我们只能将NMT关闭到最低跟踪级别,如果它曾经打开)。 这就导致了如果我们没有开启过 NMT ,那就没办法通过魔改 shutdown 操作逆向打开 NMT ,因为 NMT 追踪的部分内存只在 JVM 启动初始化的阶段进行记录(如在初始化堆内存分配的过程中通过 NMT_TrackingLevel level = MemTracker::tracking_level(); 来获取 NMT 的追踪等级,视等级来记录内存使用情况),JVM 启动之后再开启 NMT 这部分内存的使用情况就无法记录,所以目前来看,还是只能在重启 JVM 后开启 NMT。 至于提供 shutdown 功能的原因,应该就是让用户在开启 NMT 功能之后如果想要关闭,不用再次重启 JVM 进程。shutdown 会清理虚拟内存用来追踪的数据结构,并停止一些追踪的操作(如记录 malloc 内存的分配)来降低开启 NMT 带来的性能耗损,并且通过源码可以发现 tracking_level 变成 NMT_minimal 状态后也不会再执行 jcmd VM.native_memory 命令相关的操作。 2.3 虚拟机退出时获取 NMT 数据 除了在虚拟机运行时获取 NMT 数据,我们还可以通过两个参数:-XX:+UnlockDiagnosticVMOptions和-XX:+PrintNMTStatistics ,来获取虚拟机退出时内存使用情况的数据(输出数据的详细程度取决于你设定的跟踪级别,如 summary/detail 等)。 -XX:+UnlockDiagnosticVMOptions:解锁用于诊断 JVM 的选项,默认关闭。 -XX:+PrintNMTStatistics:当启用 NMT 时,在虚拟机退出时打印内存使用情况,默认关闭,需要开启前置参数 -XX:+UnlockDiagnosticVMOptions才能正常使用。 3.NMT 内存 & OS 内存概念差异性 我们可以做一个简单的测试,使用如下参数启动 JVM : -Xmx1G -Xms1G -XX:+UseG1GC -XX:MaxMetaspaceSize=256m -XX:MaxDirectMemorySize=256m -XX:ReservedCodeCacheSize=256M -XX:NativeMemoryTracking=detail 然后使用 NMT 查看内存使用情况(因各环境资源参数不一样,部分未明确设置数据可能由虚拟机根据资源自行计算得出,以下数据仅供参考): jcmd VM.native_memory detail NMT 会输出如下日志: Native Memory Tracking: Total: reserved=2813709KB, committed=1497485KB - Java Heap (reserved=1048576KB, committed=1048576KB) (mmap: reserved=1048576KB, committed=1048576KB) - Class (reserved=1056899KB, committed=4995KB) (classes #442) (malloc=131KB #259) (mmap: reserved=1056768KB, committed=4864KB) - Thread (reserved=258568KB, committed=258568KB) (thread #127) (stack: reserved=258048KB, committed=258048KB) (malloc=390KB #711) (arena=130KB #234) - Code (reserved=266273KB, committed=4001KB) (malloc=33KB #309) (mmap: reserved=266240KB, committed=3968KB) - GC (reserved=164403KB, committed=164403KB) (malloc=92723KB #6540) (mmap: reserved=71680KB, committed=71680KB) - Compiler (reserved=152KB, committed=152KB) (malloc=4KB #36) (arena=148KB #21) - Internal (reserved=14859KB, committed=14859KB) (malloc=14827KB #3632) (mmap: reserved=32KB, committed=32KB) - Symbol (reserved=1423KB, committed=1423KB) (malloc=936KB #111) (arena=488KB #1) - Native Memory Tracking (reserved=330KB, committed=330KB) (malloc=118KB #1641) (tracking overhead=211KB) - Arena Chunk (reserved=178KB, committed=178KB) (malloc=178KB) - Unknown (reserved=2048KB, committed=0KB) (mmap: reserved=2048KB, committed=0KB) ...... 大家可能会发现 NMT 所追踪的内存(即 JVM 中的 Reserved、Committed)与操作系统 OS (此处指Linux)的内存概念存在一定的差异性。 首先按我们理解的操作系统的概念: 操作系统对内存的分配管理典型地分为两个阶段:保留(reserve)和提交(commit)。保留阶段告知系统从某一地址开始到后面的dwSize大小的连续虚拟内存需要供程序使用,进程其他分配内存的操作不得使用这段内存;提交阶段将虚拟地址映射到对应的真实物理内存中,这样这块内存就可以正常使用 [1]。 如果使用 top 或者 smem 等命令查看刚才启动的 JVM 进程会发现: top PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND 36257 dou+ 20 0 10.8g 54200 17668 S 99.7 0.0 13:04.15 java 此时疑问就产生了,为什么 NMT 中的 committed ,即日志详情中 Total: reserved=2813709KB, committed=1497485KB 中的 1497485KB 与 top 中 RES 的大小54200KB 存在如此大的差异? 使用 man 查看 top 中 RES 的概念(不同版本 Linux 可能不同): RES -- Resident Memory Size (KiB) A subset of the virtual address space (VIRT) representing the non-swapped physical memory a task is currently using. It is also the sum of the RSan, RSfd and RSsh fields. It can include private anonymous pages, private pages mapped to files (including program images and shared libraries) plus shared anonymous pages. All such memory is backed by the swap file represented separately under SWAP. Lastly, this field may also include shared file-backed pages which, when modified, act as a dedicated swap file and thus will never impact SWAP. RES 表示任务当前使用的非交换物理内存(此时未发生swap),那按对操作系统 commit 提交内存的理解,这两者貌似应该对上,为何现在差距那么大呢? 笔者一开始猜测是 JVM 的 uncommit 机制(如 JEP 346[2],支持 G1 在空闲时自动将 Java 堆内存返回给操作系统,BiSheng JDK 对此做了增强与改进[3])造成的,JVM 在 uncommit 将内存返还给 OS 之后,NMT 没有除去返还的内存导致统计错误。 但是在翻阅了源码之后发现,G1 在 shrink 缩容的时候,通常调用链路如下: G1CollectedHeap::shrink-> G1CollectedHeap::shrink_helper-> HeapRegionManager::shrink_by-> HeapRegionManager::uncommit_regions-> G1PageBasedVirtualSpace::uncommit-> G1PageBasedVirtualSpace::uncommit_internal-> os::uncommit_memory 忽略细节,uncommit 会在最后调用 os::uncommit_memory ,查看 os::uncommit_memory 源码: bool os::uncommit_memory(char* addr, size_t bytes) { bool res; if (MemTracker::tracking_level() > NMT_minimal) { Tracker tkr = MemTracker::get_virtual_memory_uncommit_tracker(); res = pd_uncommit_memory(addr, bytes); if (res) { tkr.record((address)addr, bytes); } } else { res = pd_uncommit_memory(addr, bytes); } return res; } 可以发现在返还 OS 内存之后,MemTracker 是进行了统计的,所以此处的误差不是由 uncommit 机制造成的。 既然如此,那又是由什么原因造成的呢?笔者在追踪 JVM 的内存分配逻辑时发现了一些端倪,此处以Code Cache(存放 JVM 生成的 native code、JIT编译、JNI 等都会编译代码到 native code,其中 JIT 生成的 native code 占用了 Code Cache 的绝大部分空间)的初始化分配为例,其大致调用链路为下: InitializeJVM-> Thread::vreate_vm-> init_globals-> codeCache_init-> CodeCache::initialize-> CodeHeap::reserve-> VirtualSpace::initialize-> VirtualSpace::initialize_with_granularity-> VirtualSpace::expand_by-> os::commit_memory 查看 os::commit_memory 相关源码: bool os::commit_memory(char* addr, size_t size, size_t alignment_hint, bool executable) { bool res = os::pd_commit_memory(addr, size, alignment_hint, executable); if (res) { MemTracker::record_virtual_memory_commit((address)addr, size, CALLER_PC); } return res; } 我们发现 MemTracker 在此记录了 commit 的内存供 NMT 用以统计计算,继续查看 os::pd_commit_memory 源码,可以发现其调用了 os::Linux::commit_memory_impl 函数。 查看 os::Linux::commit_memory_impl 源码: int os::Linux::commit_memory_impl(char* addr, size_t size, bool exec) { int prot = exec ? PROT_READ|PROT_WRITE|PROT_EXEC : PROT_READ|PROT_WRITE; uintptr_t res = (uintptr_t) ::mmap(addr, size, prot, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0); if (res != (uintptr_t) MAP_FAILED) { if (UseNUMAInterleaving) { numa_make_global(addr, size); } return 0; } int err = errno; // save errno from mmap() call above if (!recoverable_mmap_error(err)) { warn_fail_commit_memory(addr, size, exec, err); vm_exit_out_of_memory(size, OOM_MMAP_ERROR, "committing reserved memory."); } return err; } 问题的原因就在 uintptr_t res = (uintptr_t) ::mmap(addr, size, prot, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0); 这段代码上。 我们发现,此时申请内存执行的是 mmap 函数,并且传递的 port 参数是 PROT_READ|PROT_WRITE|PROT_EXEC 或 PROT_READ|PROT_WRITE ,使用 man 查看 mmap ,其中相关描述为: The prot argument describes the desired memory protection of the mapping (and must not conflict with the open mode of the file). It is either PROT_NONE or the bitwise OR of one or more of the following flags: PROT_EXEC Pages may be executed. PROT_READ Pages may be read. PROT_WRITE Pages may be written. PROT_NONE Pages may not be accessed. 由此我们可以看出,JVM 中所谓的 commit 内存,只是将内存mmaped映射为可读可写可执行的状态!而在 Linux 中,在分配内存时又是 lazy allocation 的机制,只有在进程真正访问时才分配真实的物理内存。所以 NMT 中所统计的 committed 并不是对应的真实的物理内存,自然与 RES 等统计方式无法对应起来。 所以 JVM 为我们提供了一个参数 -XX:+AlwaysPreTouch,使我们可以在启动之初就按照内存页粒度都访问一遍 Heap,强制为其分配物理内存以减少运行时再分配内存造成的延迟(但是相应的会影响 JVM 进程初始化启动的时间),查看相关代码: void os::pretouch_memory(char* start, char* end) { for (volatile char *p = start; p < end; p += os::vm_page_size()) { *p = 0; } } 让我们来验证下,开启 -XX:+AlwaysPreTouch 前后的效果。 NMT 的 heap 地址范围: Virtual memory map: [0x00000000c0000000 - 0x0000000100000000] reserved 1048576KB for Java Heap from [0x0000ffff93ea36d8] ReservedHeapSpace::ReservedHeapSpace(unsigned long, unsigned long, bool, char*)+0xb8 [0x0000ffff93e67f68] Universe::reserve_heap(unsigned long, unsigned long)+0x2d0 [0x0000ffff93898f28] G1CollectedHeap::initialize()+0x188 [0x0000ffff93e68594] Universe::initialize_heap()+0x15c [0x00000000c0000000 - 0x0000000100000000] committed 1048576KB from [0x0000ffff938bbe8c] G1PageBasedVirtualSpace::commit_internal(unsigned long, unsigned long)+0x14c [0x0000ffff938bc08c] G1PageBasedVirtualSpace::commit(unsigned long, unsigned long)+0x11c [0x0000ffff938bf774] G1RegionsLargerThanCommitSizeMapper::commit_regions(unsigned int, unsigned long)+0x5c [0x0000ffff93943f54] HeapRegionManager::commit_regions(unsigned int, unsigned long)+0x7c 对应该地址的/proc/{pid}/smaps: //开启前 //开启后 c0000000-100080000 rw-p 00000000 00:00 0 c0000000-100080000 rw-p 00000000 00:00 0 Size: 1049088 kB Size: 1049088 kB KernelPageSize: 4 kB KernelPageSize: 4 kB MMUPageSize: 4 kB MMUPageSize: 4 kB Rss: 792 kB Rss: 1049088 kB Pss: 792 kB Pss: 1049088 kB Shared_Clean: 0 kB Shared_Clean: 0 kB Shared_Dirty: 0 kB Shared_Dirty: 0 kB Private_Clean: 0 kB Private_Clean: 0 kB Private_Dirty: 792 kB Private_Dirty: 1049088 kB Referenced: 792 kB Referenced: 1048520 kB Anonymous: 792 kB Anonymous: 1049088 kB LazyFree: 0 kB LazyFree: 0 kB AnonHugePages: 0 kB AnonHugePages: 0 kB ShmemPmdMapped: 0 kB ShmemPmdMapped: 0 kB Shared_Hugetlb: 0 kB Shared_Hugetlb: 0 kB Private_Hugetlb: 0 kB Private_Hugetlb: 0 kB Swap: 0 kB Swap: 0 kB SwapPss: 0 kB SwapPss: 0 kB Locked: 0 kB Locked: 0 kB VmFlags: rd wr mr mw me ac VmFlags: rd wr mr mw me ac 对应的/proc/{pid}/status: //开启前 //开启后 ... ... VmHWM: 54136 kB VmHWM: 1179476 kB VmRSS: 54136 kB VmRSS: 1179476 kB ... ... VmSwap: 0 kB VmSwap: 0 kB ... 开启参数后的 top: PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND 85376 dou+ 20 0 10.8g 1.1g 17784 S 99.7 0.4 14:56.31 java 观察对比我们可以发现,开启 AlwaysPreTouch 参数后,NMT 统计的 commited 已经与 top 中的 RES 差不多了,之所以不完全相同是因为该参数只能 Pre-touch 分配 Java heap 的物理内存,至于其他的非 heap 的内存,还是受到 lazy allocation 机制的影响。 同理我们可以简单看下 JVM 的 reserve 机制: # hotspot/src/share/vm/runtime/os.cpp char* os::reserve_memory(size_t bytes, char* addr, size_t alignment_hint, MEMFLAGS flags) { char* result = pd_reserve_memory(bytes, addr, alignment_hint); if (result != NULL) { MemTracker::record_virtual_memory_reserve((address)result, bytes, CALLER_PC); MemTracker::record_virtual_memory_type((address)result, flags); } return result; } # hotspot/src/os/linux/vm/os_linux.cpp char* os::pd_reserve_memory(size_t bytes, char* requested_addr, size_t alignment_hint) { return anon_mmap(requested_addr, bytes, (requested_addr != NULL)); } static char* anon_mmap(char* requested_addr, size_t bytes, bool fixed) { ...... addr = (char*)::mmap(requested_addr, bytes, PROT_NONE, flags, -1, 0); ...... } reserve 通过 mmap(requested_addr, bytes, PROT_NONE, flags, -1, 0); 来将内存映射为 PROT_NONE,这样其他的 mmap/malloc 等就不能调用使用,从而达到了 guard memory 或者说 guard pages 的目的。 OpenJDK 社区其实也注意到了 NMT 内存与 OS 内存差异性的问题,所以社区也提出了相应的 Enhancement 来增强功能: 1.JDK-8249666[4] : 目前 NMT 将分配的内存显示为 Reserved 或 Committed。而在 top 或 pmap 的输出中,首次使用(即 touch)之前 Reserved 和 Committed 的内存都将显示为 Virtual memory。只有在内存页(通常是4k)首次写入后,它才会消耗物理内存,并出现在 top/pmap 输出的 “常驻内存”(即 RSS)中。 当前NMT输出的主要问题是,它无法区分已 touch 和未 touch 的 Committed 内存。 该 Enhancement 提出可以使用 mincore() [5]来查找 NMT 的 Committed 中 RSS 的部分,mincore() 系统调用让一个进程能够确定一块虚拟内存区域中的分页是否驻留在物理内存中。mincore()已在JDK-8191369 NMT:增强线程堆栈跟踪中实现,需要将其扩展到所有其他类型的内存中(如 Java 堆)。 遗憾的是该 Enhancement 至今仍是 Unresolved 状态。 2.JDK-8191369[6] : 1 中提到的 NMT:增强线程堆栈跟踪。使用 mincore() 来追踪驻留在物理内存中的线程堆栈的大小,用以解决线程堆栈追踪时有时会夸大内存使用情况的痛点。 该 Enhancement 已经在 JDK11 中实现。 参考 https://weread.qq.com/web/reader/53032310717f44515302749k37632cd021737693cfc7149 http://openjdk.java.net/jeps/346 https://gitee.com/openeuler/bishengjdk-8/wikis/G1GC内存伸缩特性介绍?sort_id=3340035 https://bugs.openjdk.org/browse/JDK-8249666 https://man7.org/linux/man-pages/man2/mincore.2.html https://bugs.openjdk.org/browse/JDK-8191369 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

Github 出现大规模恶意提交,受影响仓库超 35000 个

推特用户@Stephen Lacy发现 GitHub 上存在大规模的混淆恶意软件攻击,目前有超过 35,000 个存储库受影响,包括crypto、golang、python、js、bash、docker、k8s 等知名项目。 这些恶意软件攻击伪装得非常好,看起来像人畜无害的提交,比如带着“bump version to 0.3.11”之类的消息: 其中一些被混淆成合法的 PR,但其实仓库没有收到任何 PR,反而仓库中的每个 go 文件都被感染了: 其中一些仓库的历史记录包括来自原作者的提交,但该提交未经 GPG 验证,这就意味着提交是攻击者伪装的。除了原作者,恶意软件也可能伪装成其他开发者,但点进去就会发现用户不存在。 这部分恶意攻击与 GiuHub 本身的漏洞相关,比如之前我们报道过的Linus利用 GitHub 漏洞发布恶作剧 README,用户可以 “通过 git 电子邮件地址冒充用户” ,然后利用 https://github.com/my/project/blob/<faked_commit> 这种 URL 发布任意提交。 这些攻击会将脚本、应用程序、笔记本电脑(电子应用程序)等包括安全密钥、AWS 访问密钥、加密密钥等帐户凭证整个 ENV 发送到攻击者的服务器。目前大部分恶意攻击提交都已被清理,但仍有新的在产生,建议大家使用 GPG 签署每个提交。

优秀的个人博客,低调大师

开源生态|超实用开源 License 基础知识扫盲帖(上)

在一个开源项目,开源许可证(Open Source License)的选择也是一个非常重要的环节。今天我们就来聊一下License的那些事儿。在一个开源项目,开源许可证(Open Source License)的选择也是一个非常重要的环节。今天我们就来聊一下License的那些事儿。 License的本质 01 中国 在中国,License不是基本法的地位存在,它本身没有法律层面的普世约束力。再说通俗一些,License本质上是一个约定,或者说是一个合同。有点儿像我们注册一般的平台账号时,必须要打钩的那个《用户注册协议》,不需要签字的情况下其实我们就已经和平台建立了合同。 资料来源于网络 02 美国 在美国,License更偏向于被看做“版权许可”,也就是一种形式的知识产权。既然被当作知识产权,那肯定是有相关法律保护的。而且涉及到知识产权的法律问题,一般都要走联邦级的处理流程,也就是说License在美国的待遇更加严肃。 License受法律保护 答案是肯定的。在国内,License既然是一种“合同”的待遇,那当然也同样受到《合同法》的保护。近些年,由于开源生态在国家层面越来越得到重视,对于License的保护判例也越来越多。其中最著名的就是广东省深圳市中级人民法院对于“罗盒案件”的判例。关于案件的细节文字解读,可以参考: https://www.oschina.net/news/159435 https://wenshu.court.gov.cn/ License的制定标准 说到开源License的制定标准,我们不得不提到开放源代码促进会(Open Source Initiative, OSI )。OSI成立于1998年2月,是一个努力推动开源软件发展的非盈利组织,它制定了很多开源协议的标准,是目前大众公认的开源“官方”组织。 https://en.wikipedia.org/wiki/Open_Source_Initiative OSI提出,一个License是不是开源的属性,要看它是否符合(Open Source Definition,OSD)的10条要求: 1. Free Redistribution-分发自由 2. Source Code-源代码 3. Derived Works-衍生作品 4. Integrity of The Author's Source Code-原作者源码的完整性 5. No Discrimination Against Persons or Groups-不歧视个人或团体 6. No Discrimination Against Fields of Endeavor-不歧视任何领域 7. Distribution of License-许可的分发 8. License Must Not Be Specific to a Product-许可不能针对特定产品 9. License Must Not Restrict Other Software-许可证不能限制其他软件 10. License Must Be Technology-Neutral-不能以专门的技术或界面完成授权 https://opensource.org/osd 我们这里要说明的是,OSI是被大众接受的“官方”组织,但是并不意味着,只有通过OSI认定的License才是合法的License。我们已经提到License在中国被认为是“合同”,因此我们完全可以撰写符合自己要求的License。当然,在怎样的法律框架下去合理的撰写,还是需要有专业的法律律师来协助会更为实际(MongoDB 创建的开源许可证SSPL ,就存在较大争议, 甚至OSI不认为它是开源许可协议)。如果我们不考虑自己撰写License,同时也希望相关开源权益得到保证,选择OSI认可的License是最高效的。 Github 官方也发布了一个网站,来帮助大家更容易选择合适的License。 https://choosealicense.com/ License的种类 基于OSD的10条标准原则,OSI官方认可的License有近70个。整体可以分为两大类: 宽松自由软件授权条款(Permissive Free Software Licence/Permissive Licenses):开源项目被修改并再发布时,不要求公开源代码。比如MIT、BSD、Apache-2.0等。 著作权授权条款(Copyleft Licenses):开源项目被修改并再发布时,必选依然要公开源代码。比如MPL、GPL、LGPL等。 https://opensource.org/licenses-draft 其中,MIT、GPL、Apache-2.0这三个是最为流行和广泛使用的License,在Github的开源项目中占比超过了60%。为了方便大家理解,下一期我们会提炼下这些License含义和主要的区别,也可以帮助大家选择适合自己开源项目的开源协议,希望大家继续关注! 欢迎大家加入Orillusion开发者社群,陪我们一起见证WebGPU的发展。快来成为Orillusion社区第一批“源”住民吧!让一起打造有价值、有活力、有温度的共创社区!长按或扫描下方二维码添加小鸥微信! Orillusion致力于打造全世界第一款完全开源基于WebGPU标准的一种轻量级渲染引擎,目标是在浏览器中实现桌面级的渲染效果,支持超大复杂场景的3D呈现。易上手,易分享,易迭代,易协作、成本低,跨平台是我们的核心优势,我们将为3D场景爆发时代提供引擎基础工具。 未来我们将会持续把最干货最前沿的WebGPU技术分享给每一位社区成员,也欢迎大家为Orillusion开源社区做出自己的贡献。我们一直坚信,开源社区的技术留痕是每一位技术人员最崇高的追求!因此,我们尊重,我们认可,我们更期待,加入Orillusion,让我们共同进步! ——Link uncharted, 链接未来世界 长按关注Orillusion官方号,第一时间了解WebGPU引擎动向,学习开发技巧,一起打造Web 3D世界!

优秀的个人博客,低调大师

Timescale 完成 C 轮融资,估值已超 10 亿美元

时序数据库 TimescaleDB 背后的公司 Timescale 近日在 C 轮融资中筹集了 1.1 亿美元,使得总融资金额达到 1.8 亿美元。Timescale 成立短短 7 年时间的估值就超过 10 亿美元,已成为数据库领域的又一独角兽企业。 本轮融资由 Tiger Global 领投,所有现有投资者 Benchmark、New Enterprise Associates、Redpoint Ventures、Icon Ventures 和 Two Sigma Ventures 都参与跟投。 在 2021 年、2019 年和 2018 年,Timescale 曾分别完成了 4000 万美元、1500 万美元和 1600 万美元的融资。此次 C 轮融资相比过去几轮金额都高,这也标志着投资者对 Timescale 基础业务十分看好(在过去的两年里,Timescale 的社区增长了 7 倍,收入增长了 20 倍)。 获得该笔融资后,Timescale 计划利用这些资金增加对产品、工程和研发方面的投入,持续发展团队,并为扩大 Timescale 社区、客户,以及为全球开发者服务作出努力。 Timescale 创始人兼首席执行官 Ajay Kulkarni 表示:“时序数据无处不在,基于时序数据构建的应用需要一种新型数据库。这笔资金和 Timescale 的飞速增长证明 TimescaleDB 就是答案。” Timescale 目前为使用 TimescaleDB 的 500 多家付费客户和社区中数万家其他组织提供服务,其中包括苹果、思科、康卡斯特、漫威、通用电气、IBM、微软、特斯拉、三星、施耐德电气、Uber、沃尔玛等公司。

优秀的个人博客,低调大师

LVFS 提供的总下载次数已超 4000 万次

LVFS(Linux Vendor Firmware Service),即 Linux 供应商固件服务,是一个用于向 Linux 用戶分发固件更新的免费平台。允许硬件供应商将其固件添加到网站上,让使用对应硬件的 Linux 设备获得固件更新。LVFS 还能显示哪些供应商致力于确保他们的硬件能够在 Linux 下运行良好。其中有不少厂商不光积极向列表中添加新设备的固件,也为相当老旧的设备提供固件更新。近日,LVFS 达成了一个新的里程碑。 用户通常会使用名为 fwupd 的系统守护程序在基于 Linux 的系统上管理固件更新的安装,LVFS 则在背后提供资源和支持。 LVFS 的上游维护者兼 Red Hat 首席软件工程师 Richard Hughes 昨天在社交网站发布的推文显示,随着 LVFS 的高速发展,如今 LVFS 已提供了超过 4000 万次的下载量,达到了一个新的历史高度。 考虑到今年 3 月 LVFS 的下载量才达到 2500 万次,如今 8 个月增长 60% 的确是一次巨大的进步。除了 4000 万次的下载,LVFS 的其他统计数据显示他们已经囊括了 6555 个组件、5583 个固件文件,以及目前有 121 家供应商参与进来。 未来,LVFS 希望能够有更多的厂商参与这个项目,为消费者的硬件提供更多支持。

优秀的个人博客,低调大师

微软员工利用漏洞盗取超千万美元Xbox礼品卡

近日,外媒Windows Central报道了一则关于微软员工利用漏洞非法获利的消息。一名工程师被微软雇来测试电子商务系统,利用系统中的一个漏洞,该工程师能够通过测试中的方法订购到Xbox电子礼品卡。他用这一方法订购了超过1000万美元的Xbox礼品卡。 这名叫做沃罗德米尔·克瓦舒克(Volodymyr Kvashuk)的工程师在微软公司通用商店团队担任工程师,测试公司的电子商务系统,他利用漏洞使用虚假的信用卡购买到了真实的Xbox电子礼品卡,他还为此制作了一个程序来源源不断地获取Xbox礼品卡地序列号。 2018年2月份,微软的UST欺诈调查打击小组发现了使用数字货币购买Xbox Live订阅量的可疑增长,并顺藤摸瓜抓到了克瓦舒克。现在,这名工程师被判服刑到2027年,刑期结束后还可能面临被遣送回其祖国乌克兰,并且还将赔偿微软公司830万美元。 克瓦舒克在获得这些数字礼品卡后,将其打折出售。检察官表示,其行为已经对Xbox礼品卡在转售市场上的全球价格波动产生了影响。

优秀的个人博客,低调大师

超7亿领英用户数据暗网出售

近日,研究人员发现有超过7亿领英用户数据在暗网出售,是领英史上最大规模的数据泄露事件。 事件分析 6月22日,有黑客在暗网平台出售超过7亿的领英用户数据,并发布了一个包含100万领英用户的样本数据集。 研究人员查看该样本发现其中含有以下信息: 邮箱; 姓名; 电话号码; 家庭地址; 地理位置记录; 领英用户名和介绍的URL; 个人和职业经验、背景信息; 性别; 其他社交媒体账号和用户名。 这是领英史上最大规模的数据泄露事件。 该用户称完整的数据库中包含有7亿领英用户的个人信息。因为领英官方声称有7.56亿用户,也就是说有约92%的领英用户可以在该泄露的数据库中检索到个人的信息。 下面是该黑客给出的样本数据: 从中可以看到用户全名、领英用户名、Facebook用户名、邮件地址、手机号码、职业数据、工资数据等。 根据研究人员的分析和对该数据样本与公开数据的对比发现,数据应该是真实的,并且与现实用户是关联的。此外,该数据也是最新的,因为包含了2020到2021年的一些样本。 研究人员在黑客给出的数据样本中并没有发现登陆凭证或金融数据,但攻击者仍然有可能利用这些数据来进行获利。 数据来源分析 研究人员与发布数据的黑客进行了联系,该黑客称数据是利用领英API获取的用户上传到领英网站的信息。下面是研究人员与该黑客在telegram上的对话: 可以看出黑客对完整数据集要价5000美元,称该数据集是通过领英API获取的。 领英回应 领英已经给出官方回复称,通过初步分析发现并非所有数据都是通过领英API获取的,相反,有部分数据是来自其他来源的。而且这并非领英数据泄露事件,具体结果有待进一步调查。 本文翻译自:https://restoreprivacy.com/linkedin-data-leak-700-million-users 鸿蒙官方战略合作共建――HarmonyOS技术社区 【责任编辑:赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

BeetlSQL 3.2.8 发布,超好用的 Java 数据库访问工具

本次发布增加了一个贴心功能,可以限制Mapper方法中的SQL长度,以避免过长SQL导致难以维护 配置属性 MAPPER_SQL_MAX_LENGTH,限制Mapper中的SQL长度,默认不限制 代码自动生成的ID使用@AssingID 无论是JAP,还是SpringData,还是MyBatis,还是BeetSQL,都支持Mapper中使用注解指明SQL语句,以BeetlSQL为例子 @Sql("select * from user where dept_id=?") List<User> selectByDept(Integer deptId); @Template("select * from user where dept_id=#{deptId}") List<User> selectByDept2(Integer deptId); 原则上应该尽量保持sql语句短小,过长的sql语句应该放到文件里维护。BeetlSQL提供了一个运行时刻检测sql语句长度,如果过长,则拒绝执行。 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.2.8-RELEASE</version> </dependency> BeetlSQL 的目标是提供开发高效,维护高效,运行高效的数据库访问框架,以我20年在电信,金融以及互联网天天CRUD的经验总结得来的框架,适用范围广。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 事务支持本地和全局,以及Saga事务,也可以配合第三方事务管理器。 阅读文档源码和例子性能测试

优秀的个人博客,低调大师

定时任务最简单的3种实现方法(超好用)

这是我的第86篇原创文章 作者 | 王磊 来源 | Java中文社群(ID:javacn666) 转载请联系授权(微信ID:GG_Stone) 定时任务在实际的开发中特别常见,比如电商平台 30 分钟后自动取消未支付的订单,以及凌晨的数据汇总和备份等,都需要借助定时任务来实现,那么我们本文就来看一下定时任务最简单的几种实现方式。 TOP 1:Timer Timer 是 JDK 自带的定时任务执行类,无论任何项目都可以直接使用 Timer 来实现定时任务,所以 Timer 的优点就是使用方便,它的实现代码如下: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义一个任务TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);}} 程序执行结果如下: Run timerTask:Mon Aug 17 21:29:25 CST 2020 Run timerTask:Mon Aug 17 21:29:28 CST 2020 Run timerTask:Mon Aug 17 21:29:31 CST 2020 Timer 缺点分析 Timer 类实现定时任务虽然方便,但在使用时需要注意以下问题。 问题 1:任务执行时间长影响其他任务 当一个任务的执行时间过长时,会影响其他任务的调度,如下代码所示: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义任务1TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("进入 timerTask 1:"+newDate());try{//休眠5秒TimeUnit.SECONDS.sleep(5);}catch(InterruptedExceptione){e.printStackTrace();}System.out.println("Run timerTask 1:"+newDate());}};//定义任务2TimerTasktimerTask2=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask 2:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);timer.schedule(timerTask2,1000,3000);}} 程序执行结果如下: 进入 timerTask 1:Mon Aug 17 21:44:08 CST 2020 Run timerTask 1:Mon Aug 17 21:44:13 CST 2020 Run timerTask 2:Mon Aug 17 21:44:13 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:13 CST 2020 Run timerTask 1:Mon Aug 17 21:44:18 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:18 CST 2020 Run timerTask 1:Mon Aug 17 21:44:23 CST 2020 Run timerTask 2:Mon Aug 17 21:44:23 CST 2020 进入 timerTask 1:Mon Aug 17 21:44:23 CST 2020 从上述结果中可以看出,当任务 1 运行时间超过设定的间隔时间时,任务 2 也会延迟执行。 原本任务 1 和任务 2 的执行时间间隔都是 3s,但因为任务 1 执行了 5s,因此任务 2 的执行时间间隔也变成了 10s(和原定时间不符)。 问题 2:任务异常影响其他任务 使用 Timer 类实现定时任务时,当一个任务抛出异常,其他任务也会终止运行,如下代码所示: publicclassMyTimerTask{publicstaticvoidmain(String[]args){//定义任务1TimerTasktimerTask=newTimerTask(){@Overridepublicvoidrun(){System.out.println("进入 timerTask 1:"+newDate());//模拟异常intnum=8/0;System.out.println("Run timerTask 1:"+newDate());}};//定义任务2TimerTasktimerTask2=newTimerTask(){@Overridepublicvoidrun(){System.out.println("Run timerTask 2:"+newDate());}};//计时器Timertimer=newTimer();//添加执行任务(延迟1s执行,每3s执行一次)timer.schedule(timerTask,1000,3000);timer.schedule(timerTask2,1000,3000);}} 程序执行结果如下: 进入 timerTask 1:Mon Aug 17 22:02:37 CST 2020 Exception in thread "Timer-0" java.lang.ArithmeticException: / by zero at com.example.MyTimerTask$1.run(MyTimerTask.java:21) at java.util.TimerThread.mainLoop(Timer.java:555) at java.util.TimerThread.run(Timer.java:505) Process finished with exit code 0 Timer 小结 Timer 类实现定时任务的优点是方便,因为它是 JDK 自定的定时任务,但缺点是任务如果执行时间太长或者是任务执行异常,会影响其他任务调度,所以在生产环境下建议谨慎使用。 TOP 2:ScheduledExecutorService ScheduledExecutorService 也是 JDK 1.5 自带的 API,我们可以使用它来实现定时任务的功能,也就是说 ScheduledExecutorService 可以实现 Timer 类具备的所有功能,并且它可以解决了 Timer 类存在的所有问题。 ScheduledExecutorService 实现定时任务的代码示例如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//10为线程数量//执行任务scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: Run Schedule:Mon Aug 17 21:44:23 CST 2020 Run Schedule:Mon Aug 17 21:44:26 CST 2020 Run Schedule:Mon Aug 17 21:44:29 CST 2020 ScheduledExecutorService 可靠性测试 ① 任务超时执行测试 ScheduledExecutorService 可以解决 Timer 任务之间相应影响的缺点,首先我们来测试一个任务执行时间过长,会不会对其他任务造成影响,测试代码如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//执行任务1scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("进入 Schedule:"+newDate());try{//休眠5秒TimeUnit.SECONDS.sleep(5);}catch(InterruptedExceptione){e.printStackTrace();}System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次//执行任务2scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule2:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: Run Schedule2:Mon Aug 17 11:27:55 CST 2020 进入 Schedule:Mon Aug 17 11:27:55 CST 2020 Run Schedule2:Mon Aug 17 11:27:58 CST 2020 Run Schedule:Mon Aug 17 11:28:00 CST 2020 进入 Schedule:Mon Aug 17 11:28:00 CST 2020 Run Schedule2:Mon Aug 17 11:28:01 CST 2020 Run Schedule2:Mon Aug 17 11:28:04 CST 2020 从上述结果可以看出,当任务 1 执行时间 5s 超过了执行频率 3s 时,并没有影响任务 2 的正常执行,因此使用 ScheduledExecutorService 可以避免任务执行时间过长对其他任务造成的影响。 ② 任务异常测试 接下来我们来测试一下 ScheduledExecutorService 在一个任务异常时,是否会对其他任务造成影响,测试代码如下: publicclassMyScheduledExecutorService{publicstaticvoidmain(String[]args){//创建任务队列ScheduledExecutorServicescheduledExecutorService=Executors.newScheduledThreadPool(10);//执行任务1scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("进入 Schedule:"+newDate());//模拟异常intnum=8/0;System.out.println("Run Schedule:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次//执行任务2scheduledExecutorService.scheduleAtFixedRate(()->{System.out.println("Run Schedule2:"+newDate());},1,3,TimeUnit.SECONDS);//1s后开始执行,每3s执行一次}} 程序执行结果如下: 进入 Schedule:Mon Aug 17 22:17:37 CST 2020 Run Schedule2:Mon Aug 17 22:17:37 CST 2020 Run Schedule2:Mon Aug 17 22:17:40 CST 2020 Run Schedule2:Mon Aug 17 22:17:43 CST 2020 从上述结果可以看出,当任务 1 出现异常时,并不会影响任务 2 的执行。 ScheduledExecutorService 小结 在单机生产环境下建议使用 ScheduledExecutorService 来执行定时任务,它是 JDK 1.5 之后自带的 API,因此使用起来也比较方便,并且使用 ScheduledExecutorService 来执行任务,不会造成任务间的相互影响。 TOP 3:Spring Task 如果使用的是 Spring 或 Spring Boot 框架,可以直接使用 Spring Framework 自带的定时任务,使用上面两种定时任务的实现方式,很难实现设定了具体时间的定时任务,比如当我们需要每周五来执行某项任务时,但如果使用 Spring Task 就可轻松的实现此需求。 以 Spring Boot 为例,实现定时任务只需两步: 开启定时任务; 添加定时任务。 具体实现步骤如下。 ① 开启定时任务 开启定时任务只需要在 Spring Boot 的启动类上声明 @EnableScheduling即可,实现代码如下: @SpringBootApplication@EnableScheduling//开启定时任务publicclassDemoApplication{//dosomeing} ② 添加定时任务 定时任务的添加只需要使用 @Scheduled注解标注即可,如果有多个定时任务可以创建多个 @Scheduled 注解标注的方法,示例代码如下: importorg.springframework.scheduling.annotation.Scheduled;importorg.springframework.stereotype.Component;@Component//把此类托管给Spring,不能省略publicclassTaskUtils{//添加定时任务@Scheduled(cron="595923005")//cron表达式,每周五23:59:59执行publicvoiddoTask(){System.out.println("我是定时任务~");}} 注意:定时任务是自动触发的无需手动干预,也就是说 Spring Boot 启动后会自动加载并执行定时任务。 Cron 表达式 Spring Task 的实现需要使用 cron 表达式来声明执行的频率和规则,cron 表达式是由 6 位或者 7 位组成的(最后一位可以省略),每位之间以空格分隔,每位从左到右代表的含义如下: 其中 * 和 ? 号都表示匹配所有的时间。 cron 表达式在线生成地址:https://cron.qqe2.com/ 知识扩展:分布式定时任务 上面的方法都是关于单机定时任务的实现,如果是分布式环境可以使用 Redis 来实现定时任务。 使用 Redis 实现延迟任务的方法大体可分为两类:通过 ZSet 的方式和键空间通知的方式。 ① ZSet 实现方式 通过 ZSet 实现定时任务的思路是,将定时任务存放到 ZSet 集合中,并且将过期时间存储到 ZSet 的 Score 字段中,然后通过一个无线循环来判断当前时间内是否有需要执行的定时任务,如果有则进行执行,具体实现代码如下: importredis.clients.jedis.Jedis;importutils.JedisUtils;importjava.time.Instant;importjava.util.Set;publicclassDelayQueueExample{//zsetkeyprivatestaticfinalString_KEY="myTaskQueue";publicstaticvoidmain(String[]args)throwsInterruptedException{Jedisjedis=JedisUtils.getJedis();//30s后执行longdelayTime=Instant.now().plusSeconds(30).getEpochSecond();jedis.zadd(_KEY,delayTime,"order_1");//继续添加测试数据jedis.zadd(_KEY,Instant.now().plusSeconds(2).getEpochSecond(),"order_2");jedis.zadd(_KEY,Instant.now().plusSeconds(2).getEpochSecond(),"order_3");jedis.zadd(_KEY,Instant.now().plusSeconds(7).getEpochSecond(),"order_4");jedis.zadd(_KEY,Instant.now().plusSeconds(10).getEpochSecond(),"order_5");//开启定时任务队列doDelayQueue(jedis);}/***定时任务队列消费*@paramjedisRedis客户端*/publicstaticvoiddoDelayQueue(Jedisjedis)throwsInterruptedException{while(true){//当前时间InstantnowInstant=Instant.now();longlastSecond=nowInstant.plusSeconds(-1).getEpochSecond();//上一秒时间longnowSecond=nowInstant.getEpochSecond();//查询当前时间的所有任务Set<String>data=jedis.zrangeByScore(_KEY,lastSecond,nowSecond);for(Stringitem:data){//消费任务System.out.println("消费:"+item);}//删除已经执行的任务jedis.zremrangeByScore(_KEY,lastSecond,nowSecond);Thread.sleep(1000);//每秒查询一次}}} ② 键空间通知 我们可以通过 Redis 的键空间通知来实现定时任务,它的实现思路是给所有的定时任务设置一个过期时间,等到了过期之后,我们通过订阅过期消息就能感知到定时任务需要被执行了,此时我们执行定时任务即可。 默认情况下 Redis 是不开启键空间通知的,需要我们通过 config set notify-keyspace-events Ex 的命令手动开启,开启之后定时任务的代码如下: importredis.clients.jedis.Jedis;importredis.clients.jedis.JedisPubSub;importutils.JedisUtils;publicclassTaskExample{publicstaticfinalString_TOPIC="__keyevent@0__:expired";//订阅频道名称publicstaticvoidmain(String[]args){Jedisjedis=JedisUtils.getJedis();//执行定时任务doTask(jedis);}/***订阅过期消息,执行定时任务*@paramjedisRedis客户端*/publicstaticvoiddoTask(Jedisjedis){//订阅过期消息jedis.psubscribe(newJedisPubSub(){@OverridepublicvoidonPMessage(Stringpattern,Stringchannel,Stringmessage){//接收到消息,执行定时任务System.out.println("收到消息:"+message);}},_TOPIC);}} 更多关于定时任务的实现,请点击《史上最全的延迟任务实现方式汇总!附代码》。 往期推荐 史上最全的延迟任务实现方式汇总!附代码(强烈推荐) 磊哥最近面试了好多人,聊聊我的感受!(附面试知识点) 关注下方二维码,查看更多干货! 本文分享自微信公众号 - Java中文社群(javacn666)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

10个超棒的GitHub库

直播:近二十载从业老兵谈金融科技赋能的探索与实践 本文转载自公众号“读芯术”(ID:AI_Discovery) GitHub是共享各种技术、框架、库和各种集合的第一大平台。但是,资源这么多,要如何找到最有用的呢。 瀚海寻珍,笔者整理出这十个超高评分的库,它们的相关性、流行性和实用性通通在线,对于所有的软件工程师都有极大的价值。 无论你是想学习新知识,还是想打造炫酷软件,它们都能帮到你。 1. Build Your Own X GitHub星数:61,300 这个奇妙的库基本上是如何构建自己技术的教程集合,它包含了如何构建命令行工具、操作系统、搜索引擎、三维渲染器等的例子。 想要创建自己的编程语言吗?或者自己的Docker或Git?这个库非常适合。 2. Free Programming Books GitHub星数:139,000 尽管库名是免费编程书籍,但是它能提供的远远不止于此。它有多种语言版本,包含免费在线课程、交互式编程资源、问题集和竞争性编程、播客和编程场地。 不过这里面大多数都是编程书籍,真的是一个很棒的合集。 3. System Design Primer GitHub星数:86,200 这是一个极其适合软件工程师的库,它有助于学习如何设计大型系统。这将帮助你成为一个更好的工程师,它提供了一个有组织的资源合集。 在许多公司技术面试过程中,系统设计通常是个必要环节,因此,结合学习指南、面试方法建议、面试问题和解决方案、用于交互学习的学习卡集以及交互编码挑战,该库还有助于准备面试。 4. Oh My Zsh GitHub星数:106,000 这是一个社区驱动的开源框架,应用于管理Zsh配置。Zsh既是一种交互式shell,也是许多开发人员使用的一种功能强大的脚本语言。 Oh My Zsh有着强大的插件和漂亮的主题,可以用于用户的Zsh定制。将其启动并且运行起来是一项比较困难的事情,但是在网上的教程和示例都不少,可以帮你找到适合的设置。 5. Coding Interview University GitHub星数:104,000 图源:unsplash 这是一个月度学习计划,为想要成为亚马逊、谷歌或脸书等大型公司的软件工程师而准备。它是为了那些刚接触软件工程(需要计算机科学知识)的人设计的,同时也提供了如何学习才能成为可靠性工程师或者运营工程师的建议。 该库的作者建立此库的初衷是为了将其用作待办事项列表,来记录自己的学习过程。经过几个月每天8-12个小时的学习,他终于在亚马逊找到了作为软件开发工程师的理想工作。 如果你也在准备在谷歌,微软,Facebook等公司的技术面试,选择它没有错。 6. Gitignore: A Collection of .gitignore Templates GitHub星数:97,000 正如其名,这一个有用的.gitignore模板集合。对于设置为GitHub库的每个新项目,都必须有一个.gitignore文件来过滤上传的内容。 文件的内容因项目和语言而异,它几乎包含所有语言和框架的模板,如Rails, Python, Perl, Laravel, Java等等。甚至还有Fortran的模板! 7. JavaScript Algorithms and Data Structures GitHub星数:64,700 这个库包含了许多流行的JavaScript算法和数据结构的示例。每个示例都有着初学者或高级的标记,以示难度。有散列表(哈希表)、堆、队列、栈、数学、字符串、集合等的示例。 8. Public APIs GitHub星数:73,100 Public APIs包含了一系列可用于项目和应用程序的优秀免费API。它涵盖各种主题,如商业、动漫、动物、新闻、金融、游戏等。 有一些小巧可爱的API,这些API的主题都较为有趣,且娱乐性质较高。但也有实用性强的,如Gmail API或谷歌分析API。 它真的包罗万象,请一定要亲自看看。 9. The Art of Command Line GitHub星数:70,100 如何使用命令行这一问题,常常被开发人员忽略,但作为一名工程师,这真的有助于提高工作效率和灵活性。 这个库包含了在Linux上使用命令行的有用注释和提示,也有专门针对Windows或macOS的部分,概括性提示适用于其他基于UNIX的操作系统。 这不仅适合于初学者,也同样适合经验丰富的人。虽然这个库不再时常更新,但它仍然提供非常好的提示,有助于命令行的使用。用户也可以自掏腰包维护该库。 图源:unsplash 10. Developer Roadmap GitHub星数:98,600 这个库包含一组图表,展示了在2020年想要成为前端、后端或开发运营工程师所需采用的不同道路和技术。 虽然一打眼看起来它可能多得惊人,但是对于这个快速变化的行业,该指南中说明了什么是可能的,什么是必须的。这个库每年更新,以反映行业系统的变化。 优秀的资源已经在这里啦,如何发挥它们的价值就看你的了。好好利用它们,成为一个更棒的软件工程师吧! 【责任编辑: 赵宁宁 TEL:(010)68476606】

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册