首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6193篇文章
优秀的个人博客,低调大师

2020年Java多线程与并发系列22道高频面试题(附思维导图和答案解析)

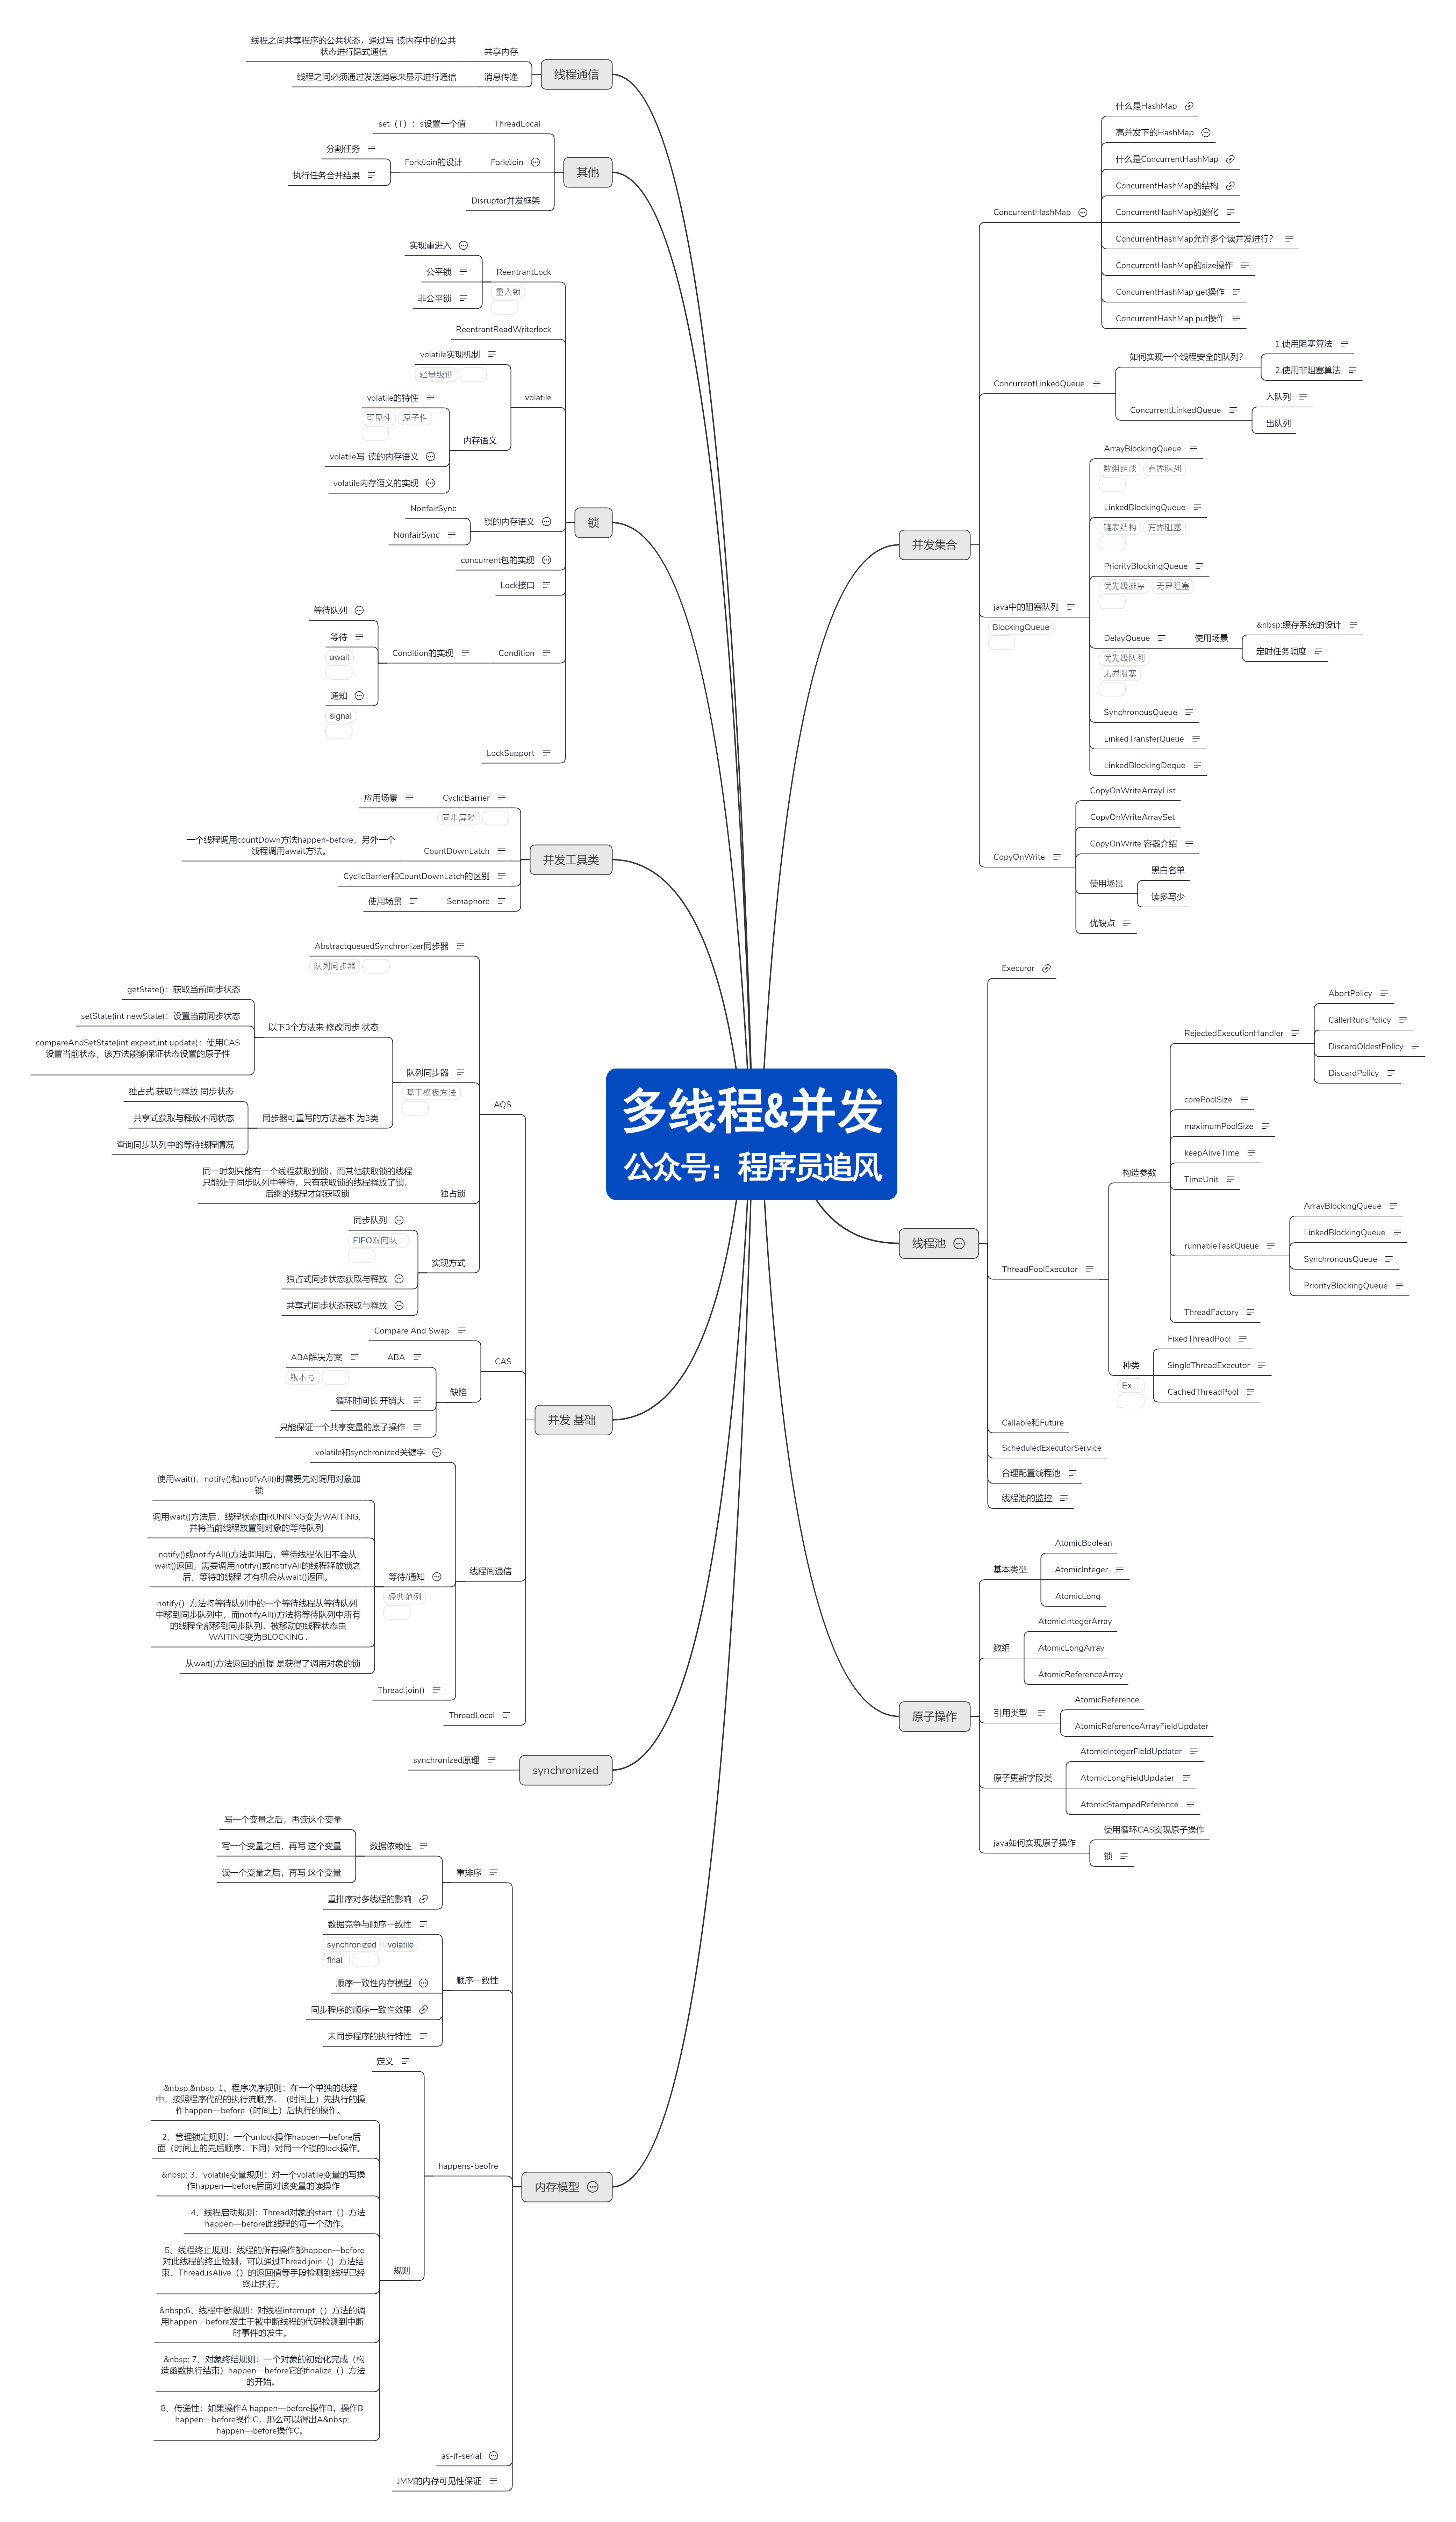
前言 现在不管是大公司还是小公司,去面试都会问到多线程与并发编程的知识,大家面试的时候这方面的知识一定要提前做好储备。关于多线程与并发的知识总结了一个思维导图,分享给大家 1、Java中实现多线程有几种方法 (1)继承Thread类;(2)实现Runnable接口;(3)实现Callable接口通过FutureTask包装器来创建Thread线程;(4)使用ExecutorService、Callable、Future实现有返回结果的多线程(也就是使用了ExecutorService来管理前面的三种方式)。 2、如何停止一个正在运行的线程 (1)使用退出标志,使线程正常退出,也就是当run方法完成后线程终止。(2)使用stop方法强行终止,但是不推荐这个方法,因为stop和suspend及resume一样都是过期作废的方法。(3)使用interrupt方法中断线程。 class MyThread extends Thread { volatile Boolean stop = false; public void run() { while (!stop) { System.out.println(getName() + " is running"); try { sleep(1000); } catch (InterruptedException e) { System.out.println("week up from blcok..."); stop = true; // 在异常处理代码中修改共享变量的状态 } } System.out.println(getName() + " is exiting..."); } } class InterruptThreadDemo3 { public static void main(String[] args) throws InterruptedException { MyThread m1 = new MyThread(); System.out.println("Starting thread..."); m1.start(); Thread.sleep(3000); m1.interrupt(); // 阻塞时退出阻塞状态 Thread.sleep(3000); // 主线程休眠3秒以便观察线程m1的中断情况 System.out.println("Stopping application..."); } } 3、notify()和notifyAll()有什么区别? notify可能会导致死锁,而notifyAll则不会任何时候只有一个线程可以获得锁,也就是说只有一个线程可以运行synchronized 中的代码使用notifyall,可以唤醒所有处于wait状态的线程,使其重新进入锁的争夺队列中,而notify只能唤醒一个。wait() 应配合while循环使用,不应使用if,务必在wait()调用前后都检查条件,如果不满足,必须调用notify()唤醒另外的线程来处理,自己继续wait()直至条件满足再往下执行。notify() 是对notifyAll()的一个优化,但它有很精确的应用场景,并且要求正确使用。不然可能导致死锁。正确的场景应该是 WaitSet中等待的是相同的条件,唤醒任一个都能正确处理接下来的事项,如果唤醒的线程无法正确处理,务必确保继续notify()下一个线程,并且自身需要重新回到WaitSet中。 4、sleep()和wait() 有什么区别? 对于sleep()方法,我们首先要知道该方法是属于Thread类中的。而wait()方法,则是属于Object类中的。sleep()方法导致了程序暂停执行指定的时间,让出cpu该其他线程,但是他的监控状态依然保持者,当指定的时间到了又会自动恢复运行状态。在调用sleep()方法的过程中,线程不会释放对象锁。当调用wait()方法的时候,线程会放弃对象锁,进入等待此对象的等待锁定池,只有针对此对象调用notify()方法后本线程才进入对象锁定池准备,获取对象锁进入运行状态。 5、volatile 是什么?可以保证有序性吗? 一旦一个共享变量(类的成员变量、类的静态成员变量)被volatile修饰之后,那么就具备了两层语义:(1)保证了不同线程对这个变量进行操作时的可见性,即一个线程修改了某个变量的值,这新值对其他线程来说是立即可见的,volatile关键字会强制将修改的值立即写入主存。(2)禁止进行指令重排序。volatile 不是原子性操作什么叫保证部分有序性?当程序执行到volatile变量的读操作或者写操作时,在其前面的操作的更改肯定全部已经进行,且结果已经对后面的操作可见;在其后面的操作肯定还没有进行; x = 2;//语句1 y = 0;//语句2 flag = true;//语句3 x = 4;//语句4 y = -1;//语句5 由于flag变量为volatile变量,那么在进行指令重排序的过程的时候,不会将语句3放到语句1、语句2前面,也不会讲语句3放到语句4、语句5后面。但是要注意语句1和语句2的顺序、语句4和语句5的顺序是不作任何保证的。使用 Volatile 一般用于 状态标记量 和 单例模式的双检锁 6、Thread 类中的start() 和 run() 方法有什么区别? start()方法被用来启动新创建的线程,而且start()内部调用了run()方法,这和直接调用run()方法的效果不一样。当你调用run()方法的时候,只会是在原来的线程中调用,没有新的线程启动,start()方法才会启动新线程。 7、为什么wait, notify 和 notifyAll这些方法不在thread类里面? 明显的原因是JAVA提供的锁是对象级的而不是线程级的,每个对象都有锁,通过线程获得。如果线程需要等待某些锁那么调用对象中的wait()方法就有意义了。如果wait()方法定义在Thread类中,线程正在等待的是哪个锁就不明显了。简单的说,由于wait,notify和notifyAll都是锁级别的操作,所以把他们定义在Object类中因为锁属于对象。 8、为什么wait和notify方法要在同步块中调用? (1)只有在调用线程拥有某个对象的独占锁时,才能够调用该对象的wait(),notify()和notifyAll()方法。(2)如果你不这么做,你的代码会抛出IllegalMonitorStateException异常。(3)还有一个原因是为了避免wait和notify之间产生竞态条件。wait()方法强制当前线程释放对象锁。这意味着在调用某对象的wait()方法之前,当前线程必须已经获得该对象的锁。因此,线程必须在某个对象的同步方法或同步代码块中才能调用该对象的wait()方法。在调用对象的notify()和notifyAll()方法之前,调用线程必须已经得到该对象的锁。因此,必须在某个对象的同步方法或同步代码块中才能调用该对象的notify()或notifyAll()方法。调用wait()方法的原因通常是,调用线程希望某个特殊的状态(或变量)被设置之后再继续执行。调用notify()或notifyAll()方法的原因通常是,调用线程希望告诉其他等待中的线程:"特殊状态已经被设置"。这个状态作为线程间通信的通道,它必须是一个可变的共享状态(或变量)。 9、Java中interrupted 和 isInterruptedd方法的区别? interrupted() 和 isInterrupted()的主要区别是前者会将中断状态清除而后者不会。Java多线程的中断机制是用内部标识来实现的,调用Thread.interrupt()来中断一个线程就会设置中断标识为true。当中断线程调用静态方法Thread.interrupted()来检查中断状态时,中断状态会被清零。而非静态方法isInterrupted()用来查询其它线程的中断状态且不会改变中断状态标识。简单的说就是任何抛出InterruptedException异常的方法都会将中断状态清零。无论如何,一个线程的中断状态有有可能被其它线程调用中断来改变。 10、Java中synchronized 和 ReentrantLock 有什么不同? 相似点:这两种同步方式有很多相似之处,它们都是加锁方式同步,而且都是阻塞式的同步,也就是说当如果一个线程获得了对象锁,进入了同步块,其他访问该同步块的线程都必须阻塞在同步块外面等待,而进行线程阻塞和唤醒的代价是比较高的。区别:这两种方式最大区别就是对于Synchronized来说,它是java语言的关键字,是原生语法层面的互斥,需要jvm实现。而ReentrantLock它是JDK 1.5之后提供的API层面的互斥锁,需要lock()和unlock()方法配合try/finally语句块来完成。Synchronized进过编译,会在同步块的前后分别形成monitorenter和monitorexit这个两个字节码指令。在执行monitorenter指令时,首先要尝试获取对象锁。如果这个对象没被锁定,或者当前线程已经拥有了那个对象锁,把锁的计算器加1,相应的,在执行monitorexit指令时会将锁计算器就减1,当计算器为0时,锁就被释放了。如果获取对象锁失败,那当前线程就要阻塞,直到对象锁被另一个线程释放为止。由于ReentrantLock是java.util.concurrent包下提供的一套互斥锁,相比Synchronized,ReentrantLock类提供了一些高级功能,主要有以下3项:(1)等待可中断,持有锁的线程长期不释放的时候,正在等待的线程可以选择放弃等待,这相当于Synchronized来说可以避免出现死锁的情况。(2)公平锁,多个线程等待同一个锁时,必须按照申请锁的时间顺序获得锁,Synchronized锁非公平锁,ReentrantLock默认的构造函数是创建的非公平锁,可以通过参数true设为公平锁,但公平锁表现的性能不是很好。(3)锁绑定多个条件,一个ReentrantLock对象可以同时绑定对个对象。 11、有三个线程T1,T2,T3,如何保证顺序执行? 在多线程中有多种方法让线程按特定顺序执行,你可以用线程类的join()方法在一个线程中启动另一个线程,另外一个线程完成该线程继续执行。为了确保三个线程的顺序你应该先启动最后一个(T3调用T2,T2调用T1),这样T1就会先完成而T3最后完成。实际上先启动三个线程中哪一个都行,因为在每个线程的run方法中用join方法限定了三个线程的执行顺序。 public class JoinTest2 { // 1.现在有T1、T2、T3三个线程,你怎样保证T2在T1执行完后执行,T3在T2执行完后执行 public static void main(String[] args) { final Thread t1 = new Thread(new Runnable() { @Override public void run() { System.out.println("t1"); } } ); @Override public void run() { try { // 引用t1线程,等待t1线程执行完 t1.join(); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("t2"); } } ); Thread t3 = new Thread(new Runnable() { @Override public void run() { try { // 引用t2线程,等待t2线程执行完 t2.join(); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("t3"); } } ); t3.start(); //这里三个线程的启动顺序可以任意,大家可以试下! t2.start(); t1.start(); } } 12、SynchronizedMap和ConcurrentHashMap有什么区别? SynchronizedMap()和Hashtable一样,实现上在调用map所有方法时,都对整个map进行同步。而ConcurrentHashMap的实现却更加精细,它对map中的所有桶加了锁。所以,只要有一个线程访问map,其他线程就无法进入map,而如果一个线程在访问ConcurrentHashMap某个桶时,其他线程,仍然可以对map执行某些操作。所以,ConcurrentHashMap在性能以及安全性方面,明显比Collections.synchronizedMap()更加有优势。同时,同步操作精确控制到桶,这样,即使在遍历map时,如果其他线程试图对map进行数据修改,也不会抛出ConcurrentModificationException。 13、什么是线程安全 线程安全就是说多线程访问同一代码,不会产生不确定的结果。在多线程环境中,当各线程不共享数据的时候,即都是私有(private)成员,那么一定是线程安全的。但这种情况并不多见,在多数情况下需要共享数据,这时就需要进行适当的同步控制了。线程安全一般都涉及到synchronized, 就是一段代码同时只能有一个线程来操作 不然中间过程可能会产生不可预制的结果。如果你的代码所在的进程中有多个线程在同时运行,而这些线程可能会同时运行这段代码。如果每次运行的ArrayList不是线程安全的。 14、Thread类中的yield方法有什么作用? Yield方法可以暂停当前正在执行的线程对象,让其它有相同优先级的线程执行。它是一个静态方法而且只保证当前线程放弃CPU占用而不能保证使其它线程一定能占用CPU,执行yield()的线程有可能在进入到暂停状态后马上又被执行。 15、Java线程池中submit() 和 execute()方法有什么区别? 两个方法都可以向线程池提交任务,execute()方法的返回类型是void,它定义在Executor接口中, 而submit()方法可以返回持有计算结果的Future对象,它定义在ExecutorService接口中,它扩展了Executor接口,其它线程池类像ThreadPoolExecutor和ScheduledThreadPoolExecutor都有这些方法。 16、说一说自己对于 synchronized 关键字的了解 synchronized关键字解决的是多个线程之间访问资源的同步性,synchronized关键字可以保证被它修饰的方法或者代码块在任意时刻只能有一个线程执行。另外,在 Java 早期版本中,synchronized属于重量级锁,效率低下,因为监视器锁(monitor)是依赖于底层的操作系统的 Mutex Lock 来实现的,Java 的线程是映射到操作系统的原生线程之上的。如果要挂起或者唤醒一个线程,都需要操作系统帮忙完成,而操作系统实现线程之间的切换时需要从用户态转换到内核态,这个状态之间的转换需要相对比较长的时间,时间成本相对较高,这也是为什么早期的synchronized 效率低的原因。庆幸的是在 Java 6 之后 Java 官方对从 JVM 层面对synchronized 较大优化,所以现在的 synchronized 锁效率也优化得很不错了。JDK1.6对锁的实现引入了大量的优化,如自旋锁、适应性自旋锁、锁消除、锁粗化、偏向锁、轻量级锁等技术来减少锁操作的开销。 17、说说自己是怎么使用 synchronized 关键字,在项目中用到了吗synchronized关键字最主要的三种使用方式: (1)修饰实例方法: 作用于当前对象实例加锁,进入同步代码前要获得当前对象实例的锁(2)修饰静态方法: 也就是给当前类加锁,会作用于类的所有对象实例,因为静态成员不属于任何一个实例对象,是类成员( static 表明这是该类的一个静态资源,不管new了多少个对象,只有一份)。所以如果一个线程A调用一个实例对象的非静态 synchronized 方法,而线程B需要调用这个实例对象所属类的静态 synchronized 方法,是允许的,不会发生互斥现象,因为访问静态 synchronized 方法占用的锁是当前类的锁,而访问非静态 synchronized 方法占用的锁是当前实例对象锁。(3)修饰代码块: 指定加锁对象,对给定对象加锁,进入同步代码库前要获得给定对象的锁。总结: synchronized 关键字加到 static 静态方法和 synchronized(class)代码块上都是是给 Class 类上锁。synchronized 关键字加到实例方法上是给对象实例上锁。尽量不要使用 synchronized(String a) 因为JVM中,字符串常量池具有缓存功能! 18、什么是线程安全?Vector是一个线程安全类吗? 如果你的代码所在的进程中有多个线程在同时运行,而这些线程可能会同时运行这段代码。如果每次运行结果和单线程运行的结果是一样的,而且其他的变量 的值也和预期的是一样的,就是线程安全的。 19、 volatile关键字的作用? 一旦一个共享变量(类的成员变量、类的静态成员变量)被volatile修饰之后,那么就具备了两层语义:(1)保证了不同线程对这个变量进行操作时的可见性,即一个线程修改了某个变量的值,这新值对其他线程来说是立即可见的。(2)禁止进行指令重排序。(3)volatile本质是在告诉jvm当前变量在寄存器(工作内存)中的值是不确定的,需要从主存中读取;synchronized则是锁定当前变量,只有当前线程可以访问该变量,其他线程被阻塞住。(4)volatile仅能使用在变量级别;synchronized则可以使用在变量、方法、和类级别的。(5)volatile仅能实现变量的修改可见性,并不能保证原子性;synchronized则可以保证变量的修改可见性和原子性。(6)volatile不会造成线程的阻塞;synchronized可能会造成线程的阻塞。(7)volatile标记的变量不会被编译器优化;synchronized标记的变量可以被编译器优化。 20、常用的线程池有哪些? (1)newSingleThreadExecutor:创建一个单线程的线程池,此线程池保证所有任务的执行顺序按照任务的提交顺序执行。(2)newFixedThreadPool:创建固定大小的线程池,每次提交一个任务就创建一个线程,直到线程达到线程池的最大大小。(3)newCachedThreadPool:创建一个可缓存的线程池,此线程池不会对线程池大小做限制,线程池大小完全依赖于操作系统(或者说JVM)能够创建的最大线程大小。(4)newScheduledThreadPool:创建一个大小无限的线程池,此线程池支持定时以及周期性执行任务的需求。(5)newSingleThreadExecutor:创建一个单线程的线程池。此线程池支持定时以及周期性执行任务的需求。 21、简述一下你对线程池的理解 (如果问到了这样的问题,可以展开的说一下线程池如何用、线程池的好处、线程池的启动策略)合理利用线程池能够带来三个好处。(1)降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。(2)提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。(3)提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。 22、Java程序是如何执行的 我们日常的工作中都使用开发工具(IntelliJ IDEA 或 Eclipse 等)可以很方便的调试程序,或者是通过打包工具把项目打包成 jar 包或者 war 包,放入 Tomcat 等 Web 容器中就可以正常运行了(1)先把 Java 代码编译成字节码,也就是把 .java 类型的文件编译成 .class 类型的文件。这个过程的大致执行流程:Java 源代码 -> 词法分析器 -> 语法分析器 -> 语义分析器 -> 字符码生成器 -> 最终生成字节码,其中任何一个节点执行失败就会造成编译失败;(2)把 class 文件放置到 Java 虚拟机,这个虚拟机通常指的是 Oracle 官方自带的 Hotspot JVM;(3)Java 虚拟机使用类加载器(Class Loader)装载 class 文件;(4)类加载完成之后,会进行字节码效验,字节码效验通过之后 JVM 解释器会把字节码翻译成机器码交由操作系统执行。但不是所有代码都是解释执行的,JVM 对此做了优化,比如,以 Hotspot 虚拟机来说,它本身提供了 JIT(Just In Time)也就是我们通常所说的动态编译器,它能够在运行时将热点代码编译为机器码,这个时候字节码就变成了编译执行。Java 程序执行流程图如下: 最后 欢迎关注公种浩:程序员追风,领取一线大厂Java面试题总结+各知识点学习思维导+一份300页pdf文档的Java核心知识点总结!这些资料的内容都是面试时面试官必问的知识点,篇章包括了很多知识点,其中包括了有基础知识、Java集合、JVM、多线程并发、spring原理、微服务、Netty 与RPC 、Kafka、日记、设计模式、Java算法、数据库、Zookeeper、分布式缓存、数据结构等等。

优秀的个人博客,低调大师

精选21道Java后端面试题,看完你也能唬住面试官拿30K

微信公众号:慕容千语的架构笔记。欢迎关注一起进步。 1. 如何用数组实现队列? 用数组实现队列时要注意 溢出 现象,这时我们可以采用循环数组的方式来解决,即将数组收尾相接。使用front指针指向队列首位,tail指针指向队列末位。 2. 内部类访问局部变量的时候,为什么变量必须加上final修饰? 因为生命周期不同。局部变量在方法结束后就会被销毁,但内部类对象并不一定,这样就会导致内部类引用了一个不存在的变量。 所以编译器会在内部类中生成一个局部变量的拷贝,这个拷贝的生命周期和内部类对象相同,就不会出现上述问题。 但这样就导致了其中一个变量被修改,两个变量值可能不同的问题。为了解决这个问题,编译器就要求局部变量需要被final修饰,以保证两个变量值相同。 在JDK8之后,编译器不要求内部类访问的局部变量必须被final修饰,但局部变量值不能被修改(无论是方法中还是内部类中),否则会报编译错误。利用javap查看编译后的字节码可以发现,编译器已经加上了final。 3. long s = 499999999 * 499999999 在上面的代码中,s的值是多少? 根据代码的计算结果,s的值应该是-1371654655,这是由于Java中右侧值的计算默认是int类型。 4. NIO相关,Channels、Buffers、Selectors NIO(Non-blocking IO)为所有的原始类型提供(Buffer)缓存支持,字符集编码解码解决方案。 Channel :一个新的原始I/O 抽象。 支持锁和内存映射文件的文件访问接口。提供多路(non-bloking) 非阻塞式的高伸缩性网络I/O 。 IO NIO 面向流 面向缓冲 阻塞IO 非阻塞IO 无 选择器 流与缓冲 Java NIO和IO之间第一个最大的区别是,IO是面向流的,NIO是面向缓冲区的。 Java IO面向流意味着每次从流中读一个或多个字节,直至读取所有字节,它们没有被缓存在任何地方。此外,它不能前后移动流中的数据。如果需要前后移动从流中读取的数据,需要先将它缓存到一个缓冲区。 Java NIO的缓冲导向方法略有不同。数据读取到一个它稍后处理的缓冲区,需要时可在缓冲区中前后移动。这就增加了处理过程中的灵活性。但是,还需要检查是否该缓冲区中包含所有您需要处理的数据。而且,需确保当更多的数据读入缓冲区时,不要覆盖缓冲区里尚未处理的数据。 阻塞与非阻塞IO Java IO的各种流是阻塞的。这意味着,当一个线程调用read() 或 write()时,该线程被阻塞,直到有一些数据被读取,或数据完全写入。该线程在此期间不能再干任何事情了。 Java NIO的非阻塞模式,是线程向某通道发送请求读取数据,仅能得到目前可用的数据,如果目前没有数据可用时,就什么都不会获取,当然它不会保持线程阻塞。所以直至数据变的可以读取之前,该线程可以继续做其他的事情。 非阻塞写也是如此。所以一个单独的线程现在可以管理多个输入和输出通道。 选择器(Selectors) Java NIO 的 选择器允许一个单独的线程来监视多个输入通道,你可以注册多个通道使用一个选择器,然后使用一个单独的线程来“选择”通道:这些通道里已经有可以处理的输入,或者选择已准备写入的通道。这种选择机制,使得一个单独的线程很容易来管理多个通道。 5. 反射的用途 Java反射机制可以让我们在编译期(Compile Time)之外的运行期(Runtime)检查类,接口,变量以及方法的信息。反射还可以让我们在运行期实例化对象,调用方法,通过调用get/set方法获取变量的值。同时我们也可以通过反射来获取泛型信息,以及注解。还有更高级的应用–动态代理和动态类加载(ClassLoader.loadclass())。 下面列举一些比较重要的方法: getFields:获取所有 public 的变量。 getDeclaredFields:获取所有包括 private , protected 权限的变量。 setAccessible:设置为 true 可以跳过Java权限检查,从而访问private权限的变量。 getAnnotations:获取注解,可以用在类和方法上。 获取方法的泛型参数: method = Myclass.class.getMethod("setStringList", List.class); Type[] genericParameterTypes = method.getGenericParameterTypes(); for(Type genericParameterType : genericParameterTypes){ if(genericParameterType instanceof ParameterizedType){ ParameterizedType aType = (ParameterizedType) genericParameterType; Type[] parameterArgTypes = aType.getActualTypeArguments(); for(Type parameterArgType : parameterArgTypes){ Class parameterArgClass = (Class) parameterArgType; System.out.println("parameterArgClass = " + parameterArgClass); } } } 动态代理: //Main.java public static void main(String[] args) { HelloWorld helloWorld=new HelloWorldImpl(); InvocationHandler handler=new HelloWorldHandler(helloWorld); //创建动态代理对象 HelloWorld proxy=(HelloWorld)Proxy.newProxyInstance( helloWorld.getClass().getClassLoader(), helloWorld.getClass().getInterfaces(), handler); proxy.sayHelloWorld(); } //HelloWorldHandler.java public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { Object result = null; //调用之前 doBefore(); //调用原始对象的方法 result=method.invoke(obj, args); //调用之后 doAfter(); return result; } 通过反射获取方法注解的参数: Class aClass = TheClass.class; Annotation[] annotations = aClass.getAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 非静态内部类能定义静态方法吗? public class OuterClass{ private static float f = 1.0f; class InnerClass{ public static float func(){return f;} } } 以上代码会出现编译错误,因为只有静态内部类才能定义静态方法。 6. Lock 和 Synchronized 有什么区别? 使用方法的区别 Synchronized:在需要同步的对象中加入此控制,synchronized可以加在方法上,也可以加在特定代码块中,括号中表示需要锁的对象。 Lock:需要显示指定起始位置和终止位置。一般使用ReentrantLock类做为锁,多个线程中必须要使用一个ReentrantLock类做为对象才能保证锁的生效。且在加锁和解锁处需要通过lock()和unlock()显示指出。所以一般会在finally块中写unlock()以防死锁。 性能的区别 synchronized是托管给JVM执行的,而lock是java写的控制锁的代码。在Java1.5中,synchronize是性能低效的。因为这是一个重量级操作,需要调用操作接口,导致有可能加锁消耗的系统时间比加锁以外的操作还多。相比之下使用Java提供的Lock对象,性能更高一些。但是到了Java1.6,发生了变化。synchronize在语义上很清晰,可以进行很多优化,有适应自旋,锁消除,锁粗化,轻量级锁,偏向锁等等。导致在Java1.6上synchronize的性能并不比Lock差。 Synchronized:采用的是CPU悲观锁机制,即线程获得的是独占锁。独占锁意味着 其他线程只能依靠阻塞来等待线程释放锁。而在CPU转换线程阻塞时会引起线程上下文切换,当有很多线程竞争锁的时候,会引起CPU频繁的上下文切换导致效率很低。 Lock:用的是乐观锁方式。所谓乐观锁就是,每次不加锁而是假设没有冲突而去完成某项操作,如果因为冲突失败就重试,直到成功为止。乐观锁实现的机制就是CAS操作。我们可以进一步研究ReentrantLock的源代码,会发现其中比较重要的获得锁的一个方法是compareAndSetState。这里其实就是调用的CPU提供的特殊指令。 ReentrantLock:具有更好的可伸缩性:比如时间锁等候、可中断锁等候、无块结构锁、多个条件变量或者锁投票。 7. float 变量如何与 0 比较? folat类型的还有double类型的,这些小数类型在趋近于0的时候直接等于0的可能性很小,一般都是无限趋近于0,因此不能用==来判断。应该用|x-0| //用程序表示就是 fabs(x) < 0.00001f 8. 如何新建非静态内部类? 内部类在声明的时候必须是 Outer.Inner a,就像int a 一样,至于静态内部类和非静态内部类new的时候有点区别: Outer.Inner a = new Outer().new Inner()(非静态,先有Outer对象才能 new 内部类) Outer.Inner a = new Outer.Inner()(静态内部类) 9. Java标识符命名规则 可以包含:字母、数字、$、_(下划线),不可用数字开头,不能是 Java 的关键字和保留字。 11. 你知道哪些JDK中用到的设计模式? 装饰模式:java.io 单例模式:Runtime类 简单工厂模式:Integer.valueOf方法 享元模式:String常量池、Integer.valueOf(int i)、Character.valueOf(char c) 迭代器模式:Iterator 职责链模式:ClassLoader的双亲委派模型 解释器模式:正则表达式java.util.regex.Pattern 12. ConcurrentHashMap如何保证线程安全 JDK 1.7及以前: ConcurrentHashMap允许多个修改操作并发进行,其关键在于使用了锁分离技术。它使用了多个锁来控制对hash表的不同部分进行的修改。ConcurrentHashMap内部使用段(Segment)来表示这些不同的部分,每个段其实就是一个小的hash table,它们有自己的锁。只要多个修改操作发生在不同的段上,它们就可以并发进行。 JDK 1.8: Segment虽保留,但已经简化属性,仅仅是为了兼容旧版本。 插入时使用CAS算法:unsafe.compareAndSwapInt(this, valueOffset, expect, update)。 CAS(Compare And Swap)意思是如果valueOffset位置包含的值与expect值相同,则更新valueOffset位置的值为update,并返回true,否则不更新,返回false。插入时不允许key或value为null 与Java8的HashMap有相通之处,底层依然由“数组”+链表+红黑树; 底层结构存放的是TreeBin对象,而不是TreeNode对象; CAS作为知名无锁算法,那ConcurrentHashMap就没用锁了么?当然不是,当hash值与链表的头结点相同还是会synchronized上锁,锁链表。 13. i++在多线程环境下是否存在问题,怎么解决? 虽然递增操作++i是一种紧凑的语法,使其看上去只是一个操作,但这个操作并非原子的,因而它并不会作为一个不可分割的操作来执行。实际上,它包含了三个独立的操作:读取count的值,将值加1,然后将计算结果写入count。这是一个“读取 - 修改 - 写入”的操作序列,并且其结果状态依赖于之前的状态。所以在多线程环境下存在问题。 要解决自增操作在多线程环境下线程不安全的问题,可以选择使用Java提供的原子类,如AtomicInteger或者使用synchronized同步方法。 14. new与newInstance()的区别 new是一个关键字,它是调用new指令创建一个对象,然后调用构造方法来初始化这个对象,可以使用带参数的构造器 newInstance()是Class的一个方法,在这个过程中,是先取了这个类的不带参数的构造器Constructor,然后调用构造器的newInstance方法来创建对象。 Class.newInstance不能带参数,如果要带参数需要取得对应的构造器,然后调用该构造器的Constructor.newInstance(Object … initargs)方法 15. 你了解哪些JDK1.8的新特性? 接口的默认方法和静态方法,JDK8允许我们给接口添加一个非抽象的方法实现,只需要使用default关键字即可。也可以定义被static修饰的静态方法。 对HashMap进行了改进,当单个桶的元素个数大于6时就会将实现改为红黑树实现,以避免构造重复的hashCode的攻击 多并发进行了优化。如ConcurrentHashMap实现由分段加锁、锁分离改为CAS实现。 JDK8拓宽了注解的应用场景,注解几乎可以使用在任何元素上,并且允许在同一个地方多次使用同一个注解 Lambda表达式 16. 你用过哪些JVM参数? Xms 堆最小值 Xmx 堆最大值 Xmn: 新生代容量 XX:SurvivorRatio 新生代中Eden与Surivor空间比例 Xss 栈容量 XX:PermSize 方法区初始容量 XX:MaxPermSize 方法区最大容量 XX:+PrintGCDetails 收集器日志参数 17. 如何打破 ClassLoader 双亲委托? 重写loadClass()方法。 18. hashCode() && equals() hashcode() 返回该对象的哈希码值,支持该方法是为哈希表提供一些优点,例如,java.util.Hashtable 提供的哈希表。 在 Java 应用程序执行期间,在同一对象上多次调用 hashCode 方法时,必须一致地返回相同的整数,前提是对象上 equals 比较中所用的信息没有被修改(equals默认返回对象地址是否相等)。如果根据 equals(Object)方法,两个对象是相等的,那么在两个对象中的每个对象上调用 hashCode 方法都必须生成相同的整数结果。 以下情况不是必需的:如果根据 equals(java.lang.Object) 方法,两个对象不相等,那么在两个对象中的任一对象上调用 hashCode 方法必定会生成不同的整数结果。但是,程序员应该知道,为不相等的对象生成不同整数结果可以提高哈希表的性能。 实际上,由 Object 类定义的 hashCode 方法确实会针对不同的对象返回不同的整数。(这一般是通过将该对象的内部地址转换成一个整数来实现的,但是 JavaTM 编程语言不需要这种实现技巧I。) hashCode的存在主要是用于查找的快捷性,如 Hashtable,HashMap等,hashCode 是用来在散列存储结构中确定对象的存储地址的; 如果两个对象相同,就是适用于 equals(java.lang.Object) 方法,那么这两个对象的 hashCode 一定要相同; 如果对象的 equals 方法被重写,那么对象的 hashCode 也尽量重写,并且产生 hashCode 使用的对象,一定要和 equals 方法中使用的一致,否则就会违反上面提到的第2点; 两个对象的hashCode相同,并不一定表示两个对象就相同,也就是不一定适用于equals(java.lang.Object) 方法,只能够说明这两个对象在散列存储结构中,如Hashtable,他们“存放在同一个篮子里”。 19. Thread.sleep() & Thread.yield() sleep()和yield()都会释放CPU。 sleep()使当前线程进入停滞状态,所以执行sleep()的线程在指定的时间内肯定不会执行;yield()只是使当前线程重新回到可执行状态,所以执行yield()的线程有可能在进入到可执行状态后马上又被执行。 sleep()可使优先级低的线程得到执行的机会,当然也可以让同优先级和高优先级的线程有执行的机会;yield()只能使同优先级的线程有执行的机会。 20. #{}和${}的区别是什么? {}是预编译处理,${}是字符串替换。 Mybatis在处理#{}时,会将sql中的#{}替换为?号,调用PreparedStatement的set方法来赋值;Mybatis在处理${}时,就是把${}替换成变量的值。使用#{}可以有效的防止SQL注入,提高系统安全性。 21. 通常一个Xml映射文件,都会写一个Dao接口与之对应,请问,这个Dao接口的工作原理是什么?Dao接口里的方法,参数不同时,方法能重载吗? Dao接口,就是人们常说的Mapper接口,接口的全限名,就是映射文件中的namespace的值,接口的方法名,就是映射文件中MappedStatement的id值,接口方法内的参数,就是传递给sql的参数。Mapper接口是没有实现类的,当调用接口方法时,接口全限名+方法名拼接字符串作为key值,可唯一定位一个MappedStatement,举例:com.mybatis3.mappers.StudentDao.findStudentById,可以唯一找到namespace为com.mybatis3.mappers.StudentDao下面id = findStudentById的MappedStatement。在Mybatis中,每一个、、、标签,都会被解析为一个MappedStatement对象。 Dao接口里的方法,是不能重载的,因为是全限名+方法名的保存和寻找策略。 Dao接口的工作原理是JDK动态代理,Mybatis运行时会使用JDK动态代理为Dao接口生成代理proxy对象,代理对象proxy会拦截接口方法,转而执行MappedStatement所代表的sql,然后将sql执行结果返回。 欢迎关注微信公众号:慕容千语的架构笔记 一起学习提升

优秀的个人博客,低调大师

8月份21道最新Java面试题剖析(数据库+JVM+微服务+高并发)

前言纵观几年来的Java面试题,你会发现每家都差不多。你仔细观察就会发现,HashMap的出现几率未免也太高了吧!连考察的知识点都一样,什么hash碰撞啊,并发问题啊!再比如JVM,无外乎考内存结构,GC算法等!因此,如果是为了面试,完全是有套路可以准备的!记住,基础再好,也架不住面试官天马行空的问,所以刷面试题还是很有必要的! 1、Map 的底层结构?(HashMap)评注:老题目了,各位面试的人员必须熟记!回答:Map是以键值对来存储对象的,它的底层实际上是数组和链表来组成的,经典的一张图如下(别人画的); 当使用put方法时,先查找出数组位置是否存在对象,通过key.hashcode对数组长度取余;存在,则把里面的链表拿出来,判断链表里面是否存在key值与传递过来的key值一样的对象,存在,则把传递过来的value取代链表key对应的value,不存在,则直接通过链表的add()方法加到链表后面;当使用get方法时,先查找出数组位置是否存在对象,通过key.hashcode对数组长度取余;如果不存在,则返回为空,如果存在,则遍历链表,判断链表里面是否存在key值与传递过来的key值一样的对象,存在,则把key值对应的value取出返回,不存在,则返回为空;2、线程安全的 Map (concurrentHashMap)简单的说了下这两 1.7 和 1.8的区别,本想问下要不要深入的讲下(源码级别),结果面试官说不用了。评注:老题目了,如果有时间,再去了解一下,解决HashMap线程安全的各种方法,以及原理!此题只能大概回答一下结构的变化,因为其中的实现代码都变了,细说可以说很久,估计面试官也没时间听!回答:jdk1.7中采用 Segment + HashEntry的方式进行实现,结构如下: Segment数组的意义就是将一个大的table分割成多个小的table来进行加锁,而每一个Segment元素存储的是HashEntry数组+链表,这个和HashMap的数据存储结构一样而jdk1.8中则去除 Segment + HashEntry + Unsafe 的实现,改为 Synchronized + CAS + Node + Unsafe 的实现其结构图如下: 如上图所示,取消了Segment字段,数组中存储的就是Node。它与HashMap中的HashEntry定义很相似,但是有一些差别。它对value和next属性设置了volatile同步锁,它不允许调用setValue方法直接改变Node的value域。另外,将原先table数组+单向链表的数据结构,变更为table数组+单向链表+红黑树的结构,在hash碰撞过多的情况下会将链表转化成红黑树。3、项目 MySQL 的数据量和并发量有多大?评注:此题为走向题,你的回答不同,后面问题走向就变了。关于容量:单表行数超过 500 万行或者单表容量超过2GB,此时就要答分库分表的中间件了!那后面题目的走向就变为mycat、sharing-jdbc等分库分表中间件的底层原理了!关于并发量:如果并发数过1200,此时就要答利用MQ或者redis等中间件,作为补偿措施,而不能直接操作数据库。那后面的题目走向就是redis、mq的原理了!介于面试者还是一个应届生,我斗胆猜测面试者是这么答的回答:数据量估计就三四百万吧,并发量就五六百左右!4、你对数据库了解多少?评注:因为你答的数据量和并发量不大,因此中间件这块没啥好问的。因此,题目走向变为数据库底层!另外,此题为引导题,面试官在给你机会引向你最擅长的方面!回答:了解常见数据库调优方法,索引优化等!5、你说下数据库的索引实现和非主键的二级索引评注:这个问题是根据上面,你的回答而问出来的!记得引向自己最擅长的数据库基础知识!默认是回答mysql数据库的回答:从数据结构角度:B-Tree索引,数据结构就是一颗B+树。Hash索引,Hash索引比较的是进行Hash运算之后的Hash值,所以它只能用于等值的过滤,不能用于基于范围的过滤。基本不用!R-Tree索引,仅支持geometry数据类型,也基本不用!至于非主键的二级索引,这个实际上问的就是非聚簇索引!非聚簇索引本身就是一颗B+树,其根节点指向聚簇索引的B+树。6、项目用的是 SpringBoot ,你能说下 Spring Boot 与 Spring 的区别吗?评注:基础题,会spring boot的,基本都答的上来。就算没准备过,当场思考下都可以回答的出来!也是属于引导题!回答:Spring Boot可以建立独立的Spring应用程序;内嵌了如Tomcat,Jetty和Undertow这样的容器,也就是说可以直接跑起来,用不着再做部署工作了。无需再像Spring那样搞一堆繁琐的xml文件的配置;可以自动配置Spring;提供了一些现有的功能,如量度工具,表单数据验证以及一些外部配置这样的一些第三方功能;提供的POM可以简化Maven的配置7、SpringBoot 的自动配置是怎么做的?评注:此题也是根据你的第七问,进一步提问而得出。回答:先答为什么需要自动配置?顾名思义,自动配置的意义是利用这种模式代替了配置 XML 繁琐模式。以前使用 Spring MVC ,需要进行配置组件扫描、调度器、视图解析器等,使用 Spring Boot 自动配置后,只需要添加 MVC 组件即可自动配置所需要的 Bean。所有自动配置的实现都在 spring-boot-autoconfigure 依赖中,包括 Spring MVC 、Data 和其它框架的自动配置。接着答spring-boot-autoconfigure 依赖的工作原理?spring-boot-autoconfigure 依赖的工作原理很简单,通过 @EnableAutoConfiguration 核心注解初始化,并扫描 ClassPath 目录中自动配置类对应依赖。比如工程中有木有添加 Thymeleaf 的 Starter 组件依赖。如果有,就按按一定规则获取默认配置并自动初始化所需要的 Bean。其实还能再继续答@EnableAutoConfiguration 注解的工作原理!不过篇幅太长,答到上面那个地步就够了!8、MyBatis 定义的接口,怎么找到实现的?评注:mybatis底层原理题,考察有没有看过mybatis的原理。博主刚好曾经自己写过一个mybatis,所以此题恰巧答的上来。博主内心活动:"现在校招的都这么牛逼了么!"回答:一共五步 Mapper 接口在初始SqlSessionFactory 注册的。 Mapper 接口注册在了名为 MapperRegistry 类的 HashMap中, key = Mapper class value = 创建当前Mapper的工厂。 Mapper 注册之后,可以从SqlSession中get SqlSession.getMapper 运用了 JDK动态代理,产生了目标Mapper接口的代理对象。 动态代理的 代理类是 MapperProxy ,这里边最终完成了增删改查方法的调用。9、Java 内存结构 评注:基础题,这个应该学JAVA的都会吧!送分题!如果博主没理解错应该是在问JVM的内存结构!回答:JVM内存结构主要有三大块:堆内存、方法区和栈。堆内存是JVM中最大的一块由年轻代和老年代组成,而年轻代内存又被分成三部分,Eden空间、From Survivor空间、To Survivor空间,默认情况下年轻代按照8:1:1的比例来分配;方法区存储类信息、常量、静态变量等数据,是线程共享的区域,为与Java堆区分,方法区还有一个别名Non-Heap(非堆);栈又分为java虚拟机栈和本地方法栈主要用于方法的执行。 **欢迎大家关注我的公种浩【程序员追风】,文章都会在里面更新,整理的资料也会放在里面。**10、对象是否可 GC?评注:这个问题就是在问,JVM如何判断对象是否需要被回收!不用答引用计数法,答可达性分析算法就行。回答:这个算法的基本思路是通过一些列称为“GC Roots”的对象作为起始点,从这些点开始向下搜索,搜索走过的路径称为引用链,当一个对象到GC Roots没有任何引用链相连时,则证明对象需要被回收.如图: 上图中o3,o4对象没有任何GC Roots可达到,所有这两个对象不可用了,需要被GC回收Java可作为GC Roots的对象包括下面几种:虚拟机栈中引用的对象方法区中类静态属性引用的对象方法区中产量引用的对象本地方法栈中JNI引用的对象11、Minor GC 和 Full GC评注:基础题,会JVM调优的,基本都会!我只是奇怪,怎么没问Major GC呢?我们还是把Major GC也给答了吧!回答:堆内存是JVM中最大的一块由年轻代和老年代组成。那么,从年轻代空间(包括 Eden 和 Survivor 区域)回收内存被称为 Minor GC。Major GC 是清理老年代。Full GC 是清理整个堆空间—包括年轻代和老年代。12、垃圾回收算法评注:基础题,博主斗胆猜测,应该是在问垃圾回收算法有哪些。面试官应该没有耐心去听你一个个去背算法概念!回答:标记-清除算法、标记整理算法、复制算法、分代收集算法13、垃圾回收器 G1评注:上面的题目更深入的问法。JVM可以配置不同的回收器。比如Serial, Parallel和CMS几种垃圾回收器。以Serial Collector(串行回收器)为例,它在在年轻代是一个使用标记-复制算法的回收器。在老年代使用的是标记-清扫-整理算法。另外,关于G1回收器可以问的点很多,此题作者没有描述清楚究竟问的是G1回收器的那个点,就满回答一下概念吧!如果是我来问,我就直接给你场景,问你该用哪种回收器了。直接问回收器,那就比较容易了!常用参数:-XX:+UseSerialGC:在新生代和老年代使用串行收集器-XX:+UseParNewGC:在新生代使用并行收集器//自己查询吧,太多了!回答:G1 GC是Jdk7的新特性之一、Jdk7+版本都可以自主配置G1作为JVM GC选项。G1 将整个堆划分为一个个大小相等的小块(每一块称为一个region),每一块的内存是连续的,每个块也会充当 Eden、Survivor、Old三种角色,但是它们不是固定的,这使得内存使用更加地灵活。如下图所示 执行垃圾收集时,收集线程在标记阶段和应用程序线程并发执行,标记结束后,G1 也就知道哪些区块基本上是垃圾,存活对象极少,G1 会先从这些区块下手,因为从这些区块能很快释放得到很大的可用空间,这也是为什么 G1 被取名为 Garbage-First 的原因。14、项目里用过 ElasticSearch 和 Hbase,有深入了解他们的调优技巧吗?评注:一个应届生搭的ElasticSearch 和 Hbase,一般都只是demo级别的,懂基本的CRUD的使用即可!一般不会去深入了解调优技巧的!这个问题如果答深入了解过,是给自己挖坑!因为这个问题,答案太广了!回答:并没有深入了解过!15、Spring RestTemplate 的具体实现评注:这题问的博主有点懵!如果是我来问,我会先问访问Rest服务的客户端这么多,为什么选Spring RestTemplate?然后才来原理。这个突然就冒出一个具体实现,我是有点懵啦!回答:其实RestTemplate和sl4fj这种门面框架很像,本质就是在Http的网络请求中增加一个马甲,本身并没有自己的实现。底层可以支持多种httpclient的http访问,上层为ClientHttpRequestFactory接口类,底层如下所示: 那么RestTemplate则封装了组装、发送 HTTP消息,以及解析响应的底层细节。答到这个份上可以了,难道你还要把类之间关系的引用图,画出来?太不现实了!16、描述下网页一个 Http 请求,到后端的整个请求过程评注:基础题,感觉属于常识题!必会!回答:利用DNS进行域名解析 --> 发起TCP的3次握手 --> 建立TCP连接后发起http请求 --> 服务器响应http请求,浏览器得到html代码 --> 浏览器解析html代码,并请求html代码中的资源(如js、css、图片等) --> 浏览器对页面进行渲染呈现给用户17、多线程的常用方法和接口类及线程池的机制评注:基础题,基本会点线程知识的,多多少少都会答点!但是这道题,我感觉范围有点大啊!可能是作者没表述清楚吧!回答:常用方法:start,run,sleep,wait,notify,notifyAll,join,isAlive,currentThread,interrupt常用接口类:Runnable、Callable、Future、FutureTask线程池的机制:在面向对象编程中,创建和销毁对象是很费时间的,因为创建一个对象要获取内存资源或者其它更多资源。所以提高服务程序效率的一个手段就是尽可能减少创建和销毁对象的次数,所以出现了池化技术!。简单的线程池包括如下四个组成部分即可:线程池管理器(ThreadPoolManager):用于创建并管理线程池工作线程(WorkThread): 线程池中线程任务接口(Task):每个任务必须实现的接口,以供工作线程调度任务的执行任务队列:用于存放没有处理的任务。提供一种缓冲机制18、总结我的 Java 基础还是不错,但是一些主流的框架源码还是处在使用的状态,需要继续去看源码评注:坦白说,我没看出来哪些问题体现出主流的框架还是处在使用的状态。19、死锁回答:死锁是指两个或两个以上的进程在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去,如果系统资源充足,进程的资源请求都能够得到满足,死锁出现的可能性就很低,否则就会因争夺有限的资源而陷入死锁。产生死锁的原因主要是:(1) 因为系统资源不足。(2) 进程运行推进的顺序不合适。(3) 资源分配不当等。20、自己研究比较新的技术,说下成果!评注:嗯,凸显自己的潜力,大家自由发挥!21、你有什么想问的?我就问了下公司那边的情况,这个自由发挥!评注:问问工作内容即可,千万别问什么福利啊,加班情况啊!这种问题,不要在技术面的时候问! 最后 欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

Java面试中常问的Spring方面问题(涵七大方向共55道题,含答案)

Spring Framework 现在几乎已成为 Java Web 开发的标配框架。那么,作为 Java 程序员,你对 Spring 的主要技术点又掌握了多少呢?不妨用本文的问题来检测一下。 1、一般问题 1.1. 不同版本的 Spring Framework 有哪些主要功能? VersionFeatureSpring 2.5发布于 2007 年。这是第一个支持注解的版本。Spring 3.0发布于 2009 年。它完全利用了 Java5 中的改进,并为 JEE6 提供了支持。Spring 4.0发布于 2013 年。这是第一个完全支持 JAVA8 的版本。 1.2. 什么是 Spring Framework? Spring 是一个开源应用框架,旨在降低应用程序开发的复杂度。 它是轻量级、松散耦合的。 它具有分层体系结构,允许用户选择组件,同时还为 J2EE 应用程序开发提供了一个有凝聚力的框架。 它可以集成其他框架,如 Structs、Hibernate、EJB 等,所以又称为框架的框架。 1.3. 列举 Spring Framework 的优点。 由于 Spring Frameworks 的分层架构,用户可以自由选择自己需要的组件。 Spring Framework 支持 POJO(Plain Old Java Object) 编程,从而具备持续集成和可测试性。 由于依赖注入和控制反转,JDBC 得以简化。 它是开源免费的。 1.4. Spring Framework 有哪些不同的功能? 轻量级 - Spring 在代码量和透明度方面都很轻便。 IOC - 控制反转 AOP - 面向切面编程可以将应用业务逻辑和系统服务分离,以实现高内聚。 容器 - Spring 负责创建和管理对象(Bean)的生命周期和配置。 MVC - 对 web 应用提供了高度可配置性,其他框架的集成也十分方便。 事务管理 - 提供了用于事务管理的通用抽象层。Spring 的事务支持也可用于容器较少的环境。 JDBC 异常 - Spring 的 JDBC 抽象层提供了一个异常层次结构,简化了错误处理策略。 1.5. Spring Framework 中有多少个模块,它们分别是什么? 欢迎加入QQ群架构华山论剑:836442475 Spring 核心容器 – 该层基本上是 Spring Framework 的核心。它包含以下模块: Spring Core Spring Bean SpEL (Spring Expression Language) Spring Context 数据访问/集成 – 该层提供与数据库交互的支持。它包含以下模块: JDBC (Java DataBase Connectivity) ORM (Object Relational Mapping) OXM (Object XML Mappers) JMS (Java Messaging Service) Transaction Web – 该层提供了创建 Web 应用程序的支持。它包含以下模块: Web Web – Servlet Web – Socket Web – Portlet AOP– 该层支持面向切面编程 Instrumentation– 该层为类检测和类加载器实现提供支持。 Test– 该层为使用 JUnit 和 TestNG 进行测试提供支持。 几个杂项模块: Messaging – 该模块为 STOMP 提供支持。它还支持注解编程模型,该模型用于从 WebSocket 客户端路由和处理 STOMP 消息。 Aspects – 该模块为与 AspectJ 的集成提供支持。 1.6. 什么是 Spring 配置文件? Spring 配置文件是 XML 文件。该文件主要包含类信息。它描述了这些类是如何配置以及相互引入的。但是,XML 配置文件冗长且更加干净。如果没有正确规划和编写,那么在大项目中管理变得非常困难。 1.7. Spring 应用程序有哪些不同组件? Spring 应用一般有以下组件: 接口- 定义功能。 Bean 类- 它包含属性,setter 和 getter 方法,函数等。 Spring 面向切面编程(AOP)- 提供面向切面编程的功能。 Bean 配置文件- 包含类的信息以及如何配置它们。 用户程序- 它使用接口。 1.8. 使用 Spring 有哪些方式? 使用 Spring 有以下方式: 作为一个成熟的 Spring Web 应用程序。 作为第三方 Web 框架,使用 Spring Frameworks 中间层。 用于远程使用。 作为企业级 Java Bean,它可以包装现有的 POJO(Plain Old Java Objects)。 2、依赖注入(Ioc) 2.1. 什么是 Spring IOC 容器? Spring 框架的核心是 Spring 容器。容器创建对象,将它们装配在一起,配置它们并管理它们的完整生命周期。Spring 容器使用依赖注入来管理组成应用程序的组件。容器通过读取提供的配置元数据来接收对象进行实例化,配置和组装的指令。该元数据可以通过 XML,Java 注解或 Java 代码提供。 私信555获取免费架构资料 2.2. 什么是依赖注入? 在依赖注入中,您不必创建对象,但必须描述如何创建它们。您不是直接在代码中将组件和服务连接在一起,而是描述配置文件中哪些组件需要哪些服务。由 IoC 容器将它们装配在一起。 2.3. 可以通过多少种方式完成依赖注入? 通常,依赖注入可以通过三种方式完成,即: 构造函数注入 setter 注入 接口注入 在 Spring Framework 中,仅使用构造函数和 setter 注入。 2.4. 区分构造函数注入和 setter 注入。 构造函数注入setter 注入没有部分注入有部分注入不会覆盖 setter 属性会覆盖 setter 属性任意修改都会创建一个新实例任意修改不会创建一个新实例适用于设置很多属性适用于设置少量属性 2.5. spring 中有多少种 IOC 容器? BeanFactory - BeanFactory 就像一个包含 bean 集合的工厂类。它会在客户端要求时实例化 bean。 ApplicationContext - ApplicationContext 接口扩展了 BeanFactory 接口。它在 BeanFactory 基础上提供了一些额外的功能。 2.6. 区分 BeanFactory 和 ApplicationContext。 BeanFactoryApplicationContext它使用懒加载它使用即时加载它使用语法显式提供资源对象它自己创建和管理资源对象不支持国际化支持国际化不支持基于依赖的注解支持基于依赖的注解 2.7. 列举 IoC 的一些好处。 IoC 的一些好处是: 它将最小化应用程序中的代码量。 它将使您的应用程序易于测试,因为它不需要单元测试用例中的任何单例或 JNDI 查找机制。 它以最小的影响和最少的侵入机制促进松耦合。 它支持即时的实例化和延迟加载服务。 2.8. Spring IoC 的实现机制。 Spring 中的 IoC 的实现原理就是工厂模式加反射机制。 示例: 欢迎加入QQ群架构华山论剑:836442475 3. Beans 3.1. 什么是 spring bean? 它们是构成用户应用程序主干的对象。 Bean 由 Spring IoC 容器管理。 它们由 Spring IoC 容器实例化,配置,装配和管理。 Bean 是基于用户提供给容器的配置元数据创建。 3.2. spring 提供了哪些配置方式? 基于 xml 配置 bean 所需的依赖项和服务在 XML 格式的配置文件中指定。这些配置文件通常包含许多 bean 定义和特定于应用程序的配置选项。它们通常以 bean 标签开头。例如: 基于注解配置 您可以通过在相关的类,方法或字段声明上使用注解,将 bean 配置为组件类本身,而不是使用 XML 来描述 bean 装配。默认情况下,Spring 容器中未打开注解装配。因此,您需要在使用它之前在 Spring 配置文件中启用它。例如: 基于 Java API 配置 Spring 的 Java 配置是通过使用 @Bean 和 @Configuration 来实现。 @Bean 注解扮演与 元素相同的角色。 @Configuration 类允许通过简单地调用同一个类中的其他 @Bean 方法来定义 bean 间依赖关系。 例如: @ConfigurationpublicclassStudentConfig{@BeanpublicStudentBeanmyStudent(){returnnewStudentBean(); } } 3.3. spring 支持集中 bean scope? Spring bean 支持 5 种 scope: Singleton- 每个 Spring IoC 容器仅有一个单实例。 Prototype- 每次请求都会产生一个新的实例。 Request- 每一次 HTTP 请求都会产生一个新的实例,并且该 bean 仅在当前 HTTP 请求内有效。 Session- 每一次 HTTP 请求都会产生一个新的 bean,同时该 bean 仅在当前 HTTP session 内有效。 Global-session- 类似于标准的 HTTP Session 作用域,不过它仅仅在基于 portlet 的 web 应用中才有意义。Portlet 规范定义了全局 Session 的概念,它被所有构成某个 portlet web 应用的各种不同的 portlet 所共享。在 global session 作用域中定义的 bean 被限定于全局 portlet Session 的生命周期范围内。如果你在 web 中使用 global session 作用域来标识 bean,那么 web 会自动当成 session 类型来使用。 仅当用户使用支持 Web 的 ApplicationContext 时,最后三个才可用。 3.4. spring bean 容器的生命周期是什么样的? spring bean 容器的生命周期流程如下: Spring 容器根据配置中的 bean 定义中实例化 bean。 Spring 使用依赖注入填充所有属性,如 bean 中所定义的配置。 如果 bean 实现 BeanNameAware 接口,则工厂通过传递 bean 的 ID 来调用 setBeanName()。 如果 bean 实现 BeanFactoryAware 接口,工厂通过传递自身的实例来调用 setBeanFactory()。 如果存在与 bean 关联的任何 BeanPostProcessors,则调用 preProcessBeforeInitialization() 方法。 如果为 bean 指定了 init 方法( 的 init-method 属性),那么将调用它。 最后,如果存在与 bean 关联的任何 BeanPostProcessors,则将调用 postProcessAfterInitialization() 方法。 如果 bean 实现 DisposableBean 接口,当 spring 容器关闭时,会调用 destory()。 如果为 bean 指定了 destroy 方法( 的 destroy-method 属性),那么将调用它。 欢迎加入QQ群架构华山论剑:836442475 3.5. 什么是 spring 的内部 bean? 只有将 bean 用作另一个 bean 的属性时,才能将 bean 声明为内部 bean。为了定义 bean,Spring 的基于 XML 的配置元数据在 或 中提供了 元素的使用。内部 bean 总是匿名的,它们总是作为原型。 例如,假设我们有一个 Student 类,其中引用了 Person 类。这里我们将只创建一个 Person 类实例并在 Student 中使用它。 Student.java public class Student { private Person person; //Setters and Getters } public class Person { private String name; private String address; //Setters and Getters } bean.xml 3.6. 什么是 spring 装配 当 bean 在 Spring 容器中组合在一起时,它被称为装配或 bean 装配。 Spring 容器需要知道需要什么 bean 以及容器应该如何使用依赖注入来将 bean 绑定在一起,同时装配 bean。 3.7. 自动装配有哪些方式? Spring 容器能够自动装配 bean。也就是说,可以通过检查 BeanFactory 的内容让 Spring 自动解析 bean 的协作者。 自动装配的不同模式: no- 这是默认设置,表示没有自动装配。应使用显式 bean 引用进行装配。 byName- 它根据 bean 的名称注入对象依赖项。它匹配并装配其属性与 XML 文件中由相同名称定义的 bean。 byType- 它根据类型注入对象依赖项。如果属性的类型与 XML 文件中的一个 bean 名称匹配,则匹配并装配属性。 构造函数- 它通过调用类的构造函数来注入依赖项。它有大量的参数。 autodetect- 首先容器尝试通过构造函数使用 autowire 装配,如果不能,则尝试通过 byType 自动装配。 3.8. 自动装配有什么局限? 覆盖的可能性 - 您始终可以使用 和 设置指定依赖项,这将覆盖自动装配。 基本元数据类型 - 简单属性(如原数据类型,字符串和类)无法自动装配。 令人困惑的性质 - 总是喜欢使用明确的装配,因为自动装配不太精确。 4、注解 4.1. 什么是基于注解的容器配置 不使用 XML 来描述 bean 装配,开发人员通过在相关的类,方法或字段声明上使用注解将配置移动到组件类本身。它可以作为 XML 设置的替代方案。例如: Spring 的 Java 配置是通过使用 @Bean 和 @Configuration 来实现。 @Bean 注解扮演与 元素相同的角色。 @Configuration 类允许通过简单地调用同一个类中的其他 @Bean 方法来定义 bean 间依赖关系。 例如: @ConfigurationpublicclassStudentConfig{@BeanpublicStudentBeanmyStudent(){returnnewStudentBean(); } } 4.2. 如何在 spring 中启动注解装配? 默认情况下,Spring 容器中未打开注解装配。因此,要使用基于注解装配,我们必须通过配置 元素在 Spring 配置文件中启用它。 4.3. @Component, @Controller, @Repository, @Service 有何区别? @Component:这将 java 类标记为 bean。它是任何 Spring 管理组件的通用构造型。spring 的组件扫描机制现在可以将其拾取并将其拉入应用程序环境中。 @Controller:这将一个类标记为 Spring Web MVC 控制器。标有它的 Bean 会自动导入到 IoC 容器中。 @Service:此注解是组件注解的特化。它不会对 @Component 注解提供任何其他行为。您可以在服务层类中使用 @Service 而不是 @Component,因为它以更好的方式指定了意图。 @Repository:这个注解是具有类似用途和功能的 @Component 注解的特化。它为 DAO 提供了额外的好处。它将 DAO 导入 IoC 容器,并使未经检查的异常有资格转换为 Spring DataAccessException。 4.4. @Required 注解有什么用? @Required 应用于 bean 属性 setter 方法。此注解仅指示必须在配置时使用 bean 定义中的显式属性值或使用自动装配填充受影响的 bean 属性。如果尚未填充受影响的 bean 属性,则容器将抛出 BeanInitializationException。 示例: publicclassEmployee{privateString name;@RequiredpublicvoidsetName(String name){this.name=name; }publicstringgetName(){returnname; } } 4.5. @Autowired 注解有什么用? @Autowired 可以更准确地控制应该在何处以及如何进行自动装配。此注解用于在 setter 方法,构造函数,具有任意名称或多个参数的属性或方法上自动装配 bean。默认情况下,它是类型驱动的注入。 publicclassEmployee{privateString name;@AutowiredpublicvoidsetName(String name){this.name=name; }publicstringgetName(){returnname; } } 4.6. @Qualifier 注解有什么用? 当您创建多个相同类型的 bean 并希望仅使用属性装配其中一个 bean 时,您可以使用@Qualifier 注解和 @Autowired 通过指定应该装配哪个确切的 bean 来消除歧义。 例如,这里我们分别有两个类,Employee 和 EmpAccount。在 EmpAccount 中,使用@Qualifier 指定了必须装配 id 为 emp1 的 bean。 Employee.javapublicclassEmployee{privateString name;@AutowiredpublicvoidsetName(String name){this.name=name; }publicstringgetName(){returnname; } } EmpAccount.javapublicclassEmpAccount{privateEmployee emp;@Autowired@Qualifier(emp1)publicvoidshowName(){ System.out.println(“Employee name : ”+emp.getName); } } 4.7. @RequestMapping 注解有什么用? @RequestMapping 注解用于将特定 HTTP 请求方法映射到将处理相应请求的控制器中的特定类/方法。此注释可应用于两个级别: 类级别:映射请求的 URL 方法级别:映射 URL 以及 HTTP 请求方法 5、数据访问 私信555获取免费架构资料 5.1. spring DAO 有什么用? Spring DAO 使得 JDBC,Hibernate 或 JDO 这样的数据访问技术更容易以一种统一的方式工作。这使得用户容易在持久性技术式工作。这使得用户容易在持久性技术之间切换。它还允许您在编写代码时,无需考虑捕获每种技术不同的异常。 5.2. 列举 Spring DAO 抛出的异常。 欢迎加入QQ群架构华山论剑:836442475 5.3. spring JDBC API 中存在哪些类? JdbcTemplate SimpleJdbcTemplate NamedParameterJdbcTemplate SimpleJdbcInsert SimpleJdbcCall 5.4. 使用 Spring 访问 Hibernate 的方法有哪些? 我们可以通过两种方式使用 Spring 访问 Hibernate: 使用 Hibernate 模板和回调进行控制反转 扩展 HibernateDAOSupport 并应用 AOP 拦截器节点 5.5. 列举 spring 支持的事务管理类型 Spring 支持两种类型的事务管理: 程序化事务管理:在此过程中,在编程的帮助下管理事务。它为您提供极大的灵活性,但维护起来非常困难。 声明式事务管理:在此,事务管理与业务代码分离。仅使用注解或基于 XML 的配置来管理事务。 5.6. spring 支持哪些 ORM 框架 Hibernate iBatis JPA JDO OJB 6、AOP 6.1. 什么是 AOP? AOP(Aspect-Oriented Programming), 即 面向切面编程 , 它与 OOP( Object-Oriented Programming, 面向对象编程) 相辅相成, 提供了与 OOP 不同的抽象软件结构的视角. 在 OOP 中, 我们以类(class)作为我们的基本单元, 而 AOP 中的基本单元是 Aspect(切面) 6.2. 什么是 Aspect? aspect 由 pointcount 和 advice 组成, 它既包含了横切逻辑的定义, 也包括了连接点的定义. Spring AOP 就是负责实施切面的框架, 它将切面所定义的横切逻辑编织到切面所指定的连接点中. AOP 的工作重心在于如何将增强编织目标对象的连接点上, 这里包含两个工作: 如何通过 pointcut 和 advice 定位到特定的 joinpoint 上 如何在 advice 中编写切面代码. 可以简单地认为, 使用 @Aspect 注解的类就是切面. 6.3. 什么是切点(JoinPoint) 程序运行中的一些时间点, 例如一个方法的执行, 或者是一个异常的处理. 在 Spring AOP 中, join point 总是方法的执行点。 6.4. 什么是通知(Advice)? 特定 JoinPoint 处的 Aspect 所采取的动作称为 Advice。Spring AOP 使用一个 Advice 作为拦截器,在 JoinPoint “周围”维护一系列的拦截器。 6.5. 有哪些类型的通知(Advice)? Before- 这些类型的 Advice 在 joinpoint 方法之前执行,并使用 @Before 注解标记进行配置。 After Returning- 这些类型的 Advice 在连接点方法正常执行后执行,并使用@AfterReturning 注解标记进行配置。 After Throwing- 这些类型的 Advice 仅在 joinpoint 方法通过抛出异常退出并使用 @AfterThrowing 注解标记配置时执行。 After (finally)- 这些类型的 Advice 在连接点方法之后执行,无论方法退出是正常还是异常返回,并使用 @After 注解标记进行配置。 Around- 这些类型的 Advice 在连接点之前和之后执行,并使用 @Around 注解标记进行配置。 6.6. 指出在 spring aop 中 concern 和 cross-cutting concern 的不同之处。 concern 是我们想要在应用程序的特定模块中定义的行为。它可以定义为我们想要实现的功能。 cross-cutting concern 是一个适用于整个应用的行为,这会影响整个应用程序。例如,日志记录,安全性和数据传输是应用程序几乎每个模块都需要关注的问题,因此它们是跨领域的问题。 6.7. AOP 有哪些实现方式? 实现 AOP 的技术,主要分为两大类: 静态代理 - 指使用 AOP 框架提供的命令进行编译,从而在编译阶段就可生成 AOP 代理类,因此也称为编译时增强; 编译时编织(特殊编译器实现) 类加载时编织(特殊的类加载器实现)。 动态代理 - 在运行时在内存中“临时”生成 AOP 动态代理类,因此也被称为运行时增强。 JDK 动态代理 CGLIB 6.8. Spring AOP and AspectJ AOP 有什么区别? Spring AOP 基于动态代理方式实现;AspectJ 基于静态代理方式实现。 Spring AOP 仅支持方法级别的 PointCut;提供了完全的 AOP 支持,它还支持属性级别的 PointCut。 6.9. 如何理解 Spring 中的代理? 将 Advice 应用于目标对象后创建的对象称为代理。在客户端对象的情况下,目标对象和代理对象是相同的。 Advice + Target Object = Proxy 6.10. 什么是编织(Weaving)? 为了创建一个 advice 对象而链接一个 aspect 和其它应用类型或对象,称为编织(Weaving)。在 Spring AOP 中,编织在运行时执行。请参考下图: 7、MVC 7.1. Spring MVC 框架有什么用?私信555获取免费架构资料 Spring Web MVC 框架提供 模型-视图-控制器 架构和随时可用的组件,用于开发灵活且松散耦合的 Web 应用程序。 MVC 模式有助于分离应用程序的不同方面,如输入逻辑,业务逻辑和 UI 逻辑,同时在所有这些元素之间提供松散耦合。 7.2. 描述一下 DispatcherServlet 的工作流程 DispatcherServlet 的工作流程可以用一幅图来说明: 欢迎加入QQ群架构华山论剑:836442475 向服务器发送 HTTP 请求,请求被前端控制器 DispatcherServlet 捕获。 DispatcherServlet 根据 -servlet.xml 中的配置对请求的 URL 进行解析,得到请求资源标识符(URI)。然后根据该 URI,调用 HandlerMapping 获得该 Handler 配置的所有相关的对象(包括 Handler 对象以及 Handler 对象对应的拦截器),最后以HandlerExecutionChain 对象的形式返回。 DispatcherServlet 根据获得的Handler,选择一个合适的HandlerAdapter。(附注:如果成功获得HandlerAdapter后,此时将开始执行拦截器的 preHandler(...)方法)。 提取Request中的模型数据,填充Handler入参,开始执行Handler(Controller)。 在填充Handler的入参过程中,根据你的配置,Spring 将帮你做一些额外的工作: HttpMessageConveter: 将请求消息(如 Json、xml 等数据)转换成一个对象,将对象转换为指定的响应信息。 数据转换:对请求消息进行数据转换。如String转换成Integer、Double等。 数据根式化:对请求消息进行数据格式化。 如将字符串转换成格式化数字或格式化日期等。 数据验证: 验证数据的有效性(长度、格式等),验证结果存储到BindingResult或Error中。 Handler(Controller)执行完成后,向 DispatcherServlet 返回一个ModelAndView 对象; 根据返回的ModelAndView,选择一个适合的 ViewResolver(必须是已经注册到 Spring 容器中的ViewResolver)返回给DispatcherServlet。 ViewResolver 结合Model和View,来渲染视图。 视图负责将渲染结果返回给客户端。 私信555获取免费架构资料 7.3. 介绍一下 WebApplicationContext WebApplicationContext 是 ApplicationContext 的扩展。它具有 Web 应用程序所需的一些额外功能。它与普通的 ApplicationContext 在解析主题和决定与哪个 servlet 关联的能力方面有所不同。

优秀的个人博客,低调大师

爱立信:2016年ICT产业五大趋势5G网络演进VR/AR大行其道

“诗家清景在新春,绿柳才黄半未匀”, 2015年全球的经济在低迷中,一些行业转型的影子隐约可现。深入分析这些转型的核心,大约都基于以下两点:第一,ICT所承载的互联网能力成为新的平台或者生产要素,各个行业的转型方向或者主要方式都要与互联网能力进行深层次的融合。第二,创新是转型的灵魂,经济或者行业的转型不是简单的叠加和所谓的二次开发,而是要把互联网的能力融合之后进行的全方位创新,只有如此才能真正摆脱目前经济发展的僵局,创造出新的增长引擎。而这一切,与爱立信的“网络社会”愿景的描述不谋而合。 爱立信预计到2021年,包括5G在内的移动宽带用户数将超过77亿,其中LTE用户数将达到41亿。而全球范围内互联的终端设备的数量将超过280亿,其中约150亿为M2M类型的连接。 行业转型初现端倪: 娱乐即服务(EaaS)。磁带已然成为文物,唱片正在消亡。流媒体技术,彻底把娱乐承载的实体转型为弥漫在空气中的比特流回归教育的本源。网络社会奠定了个性化教育的基础:一是教育资源极大丰富。二是碎片化时间充分利用自由通勤。出租车行业的垄断开始瓦解,更多的车辆参与通勤,公共交通有了更多的个性化选择 趋势一:网络即服务 网络即服务是5G时代按需组网的网络能力提供方式,它利用逻辑而非物理资源。网络即服务的提供方式中,网络编排是非常重要的功能模块。网络编排功能实现对网络能力的创建、管理和撤销。运营商首先根据业务场景需求生成网络切片模板,切片模板包括该业务场景所需的网络功能模块、各网络功能模块之间的接口以及这些功能模块所需的网络资源,然后网络编排功能根据该切片模板申请网络资源,并在申请到的资源上实例化创建虚拟网络功能模块的接口。 趋势二:面向5G的网络演进 2.1 增强的无线宽带能力 (Enhanced-MBB) 演进的LTE技术(LTE-E):基于目前可用的无线频谱,LTE-E主要通过频谱融合实现大带宽的传输。频谱方面需要整合FDD/TDD频谱,以及授权及非授权频谱。此外,多天线技术的演进会在频谱利用率提升方面扮演极为重要的角色。这里包括大规模天线技术(Massive-MIMO),分布式多天线技术(Distributed-MIMO),多维天线技术(3D-MIMO)技术,以及基于云的无线接入技术(Cloud-RAN)技术 极简载波:LTE-E引入精简设计理念如“极简载波”,实现更简单的LTE载波设计,打造更简单更高效的无线小区,提升性能的同时降低运营商的单位比特成本 新的空口技术(NX):新的空口技术主要是探索在新的无线频谱上部署的无线接入技术。新的频谱范围通常指的是6GHz~100GHz 其他,见下图 2.2 物联网接入解决方案 (IoT) 2016年的主要任务为确立大规模机器类MTC的通信标准。2015年11月,由全球领先的运营商联合爱立信、英特尔等厂家成立了窄带物联网联盟,支持低功耗广域网络窄带物联网(NB-IoT)标准。爱立信的窄带物联网(NB-IoT)解决方案已经纳入上述的标准化体系中,这一标准预计2016年将成为3GPP的正式标准。 趋势三:智能无处不在 3.1 越来越聪明的元数据(Smarter Metadata) 移动宽带和智能手机的出现,丰富了网络中元数据的信息维度。如今的元数据除了包含上述的基本信息之外,还包含位置,用户体验,APP使用量,以及拥塞状况等等多维度的信息。这些信息成为建立智能运营和开发智能业务的基础: 对于运营商来说,敏捷运营和智能运营将成为现实对于业务开发者而言能够开发出精确匹配和适应用户需求的业务,从而建立真正的面向客户需求的解决方案 3.2 给机器以智能 (Smart Machine Learning) 机器智能来源于两个方面: 在可以预见的未来,机器将被赋予统计、逻辑判断为核心的数理分析、基本函数和计算模型等技术能力。具备这些能力的智能机器将能够自己读取数字和文本,并通过各种反馈信息进行自我学习,在此基础上实现实时自动化操作此外,云计算的高速发展和演进也会赋予机器更灵活的智能。在高速宽带网络的环境之下,运用云计算的强大运算和存储能力,能够给机器提供一个更智能的“大脑”,增强机器的作业能力,执行更加复杂的任务 趋势四:开放网络能力 网络即服务:基础网络以服务的形式提供时,实际上运营商已经完成了基础网络能力对业务开发者的开放平台即服务:运营商的平台是业务赖以生存的环境,这些环境包括运营管理、计费服务、物联网管理平台、金融支付平台等多方面的要素。业务即服务:运营商的很多业务,比如基础语音业务、信息业务、视频业务是很多综合类业务和第三方开发者的业务组件 2015年,爱立信推出了业务创新框架,其特点是将新业务所需要的运营环境要素以通用模块或者组件的形式提供,允许第三方的开发者或者运营者灵活的调用和组合这些组件,从而加速新业务的部署时间,并有效的降低新业务部署的运营成本。 趋势五:亦真亦幻 将虚拟的信息叠加在真实的场景之中(AR),或者干脆创造一个虚拟现实环境(VR),这些都是为了更好的理解我们存在的现实世界。这些技术的背后依托的是增强型宽带所传送的即时海量数据、更高处理能力的智能终端对于信息的编解码和呈现、以及无所不在的云对于建立三维模型的支持。这些数字化、虚拟化的信息呈现技术,推动的行业转型: 5.1 大规模制造业 (Mass Manufacturing) 在规模化,智能化和复杂程度比较高的工业制造领域,如何进行大规模的技术培训是一个棘手的难题。VR+AR的方式显然能够解决这样的难题,用数字化的虚拟现实复制一份正在进行的制造流程,以三维的形式动态的展示,并与工人的实际培训教程AR相结合,显然成本要低得多,效率也高得多。 5.2 医疗 (Medical) 虚拟现实和增强现实对于医疗行业的影响同样具备革命性的影响。以普通的外科手术为例,如果辅以VR+AR技术,那么未来的场景将是这个样子:首先绘制病人的3D模型,其中的细节具体到影响手术的各个组织、器官等等。结合AR技术,医生们开始针对这个模型进行初步的会诊和实践,直至手术圆满完成。 5.3 在线零售 (Online retail) 实体渠道的消亡。借助于VR+AR的方式产品提供方完全可以在线的形式向用户提供具体产品的动态三维模型。实体销售店的形式变得无足轻重虚拟商品的崛起。VR+AR大规模应用之时人们对于商品的定义将会模糊真实和虚拟的界限。对于一些商品来说,不必拥有真正实体的物品,也许只有虚拟的三维模型就足够了 本文转自d1net(转载)

优秀的个人博客,低调大师

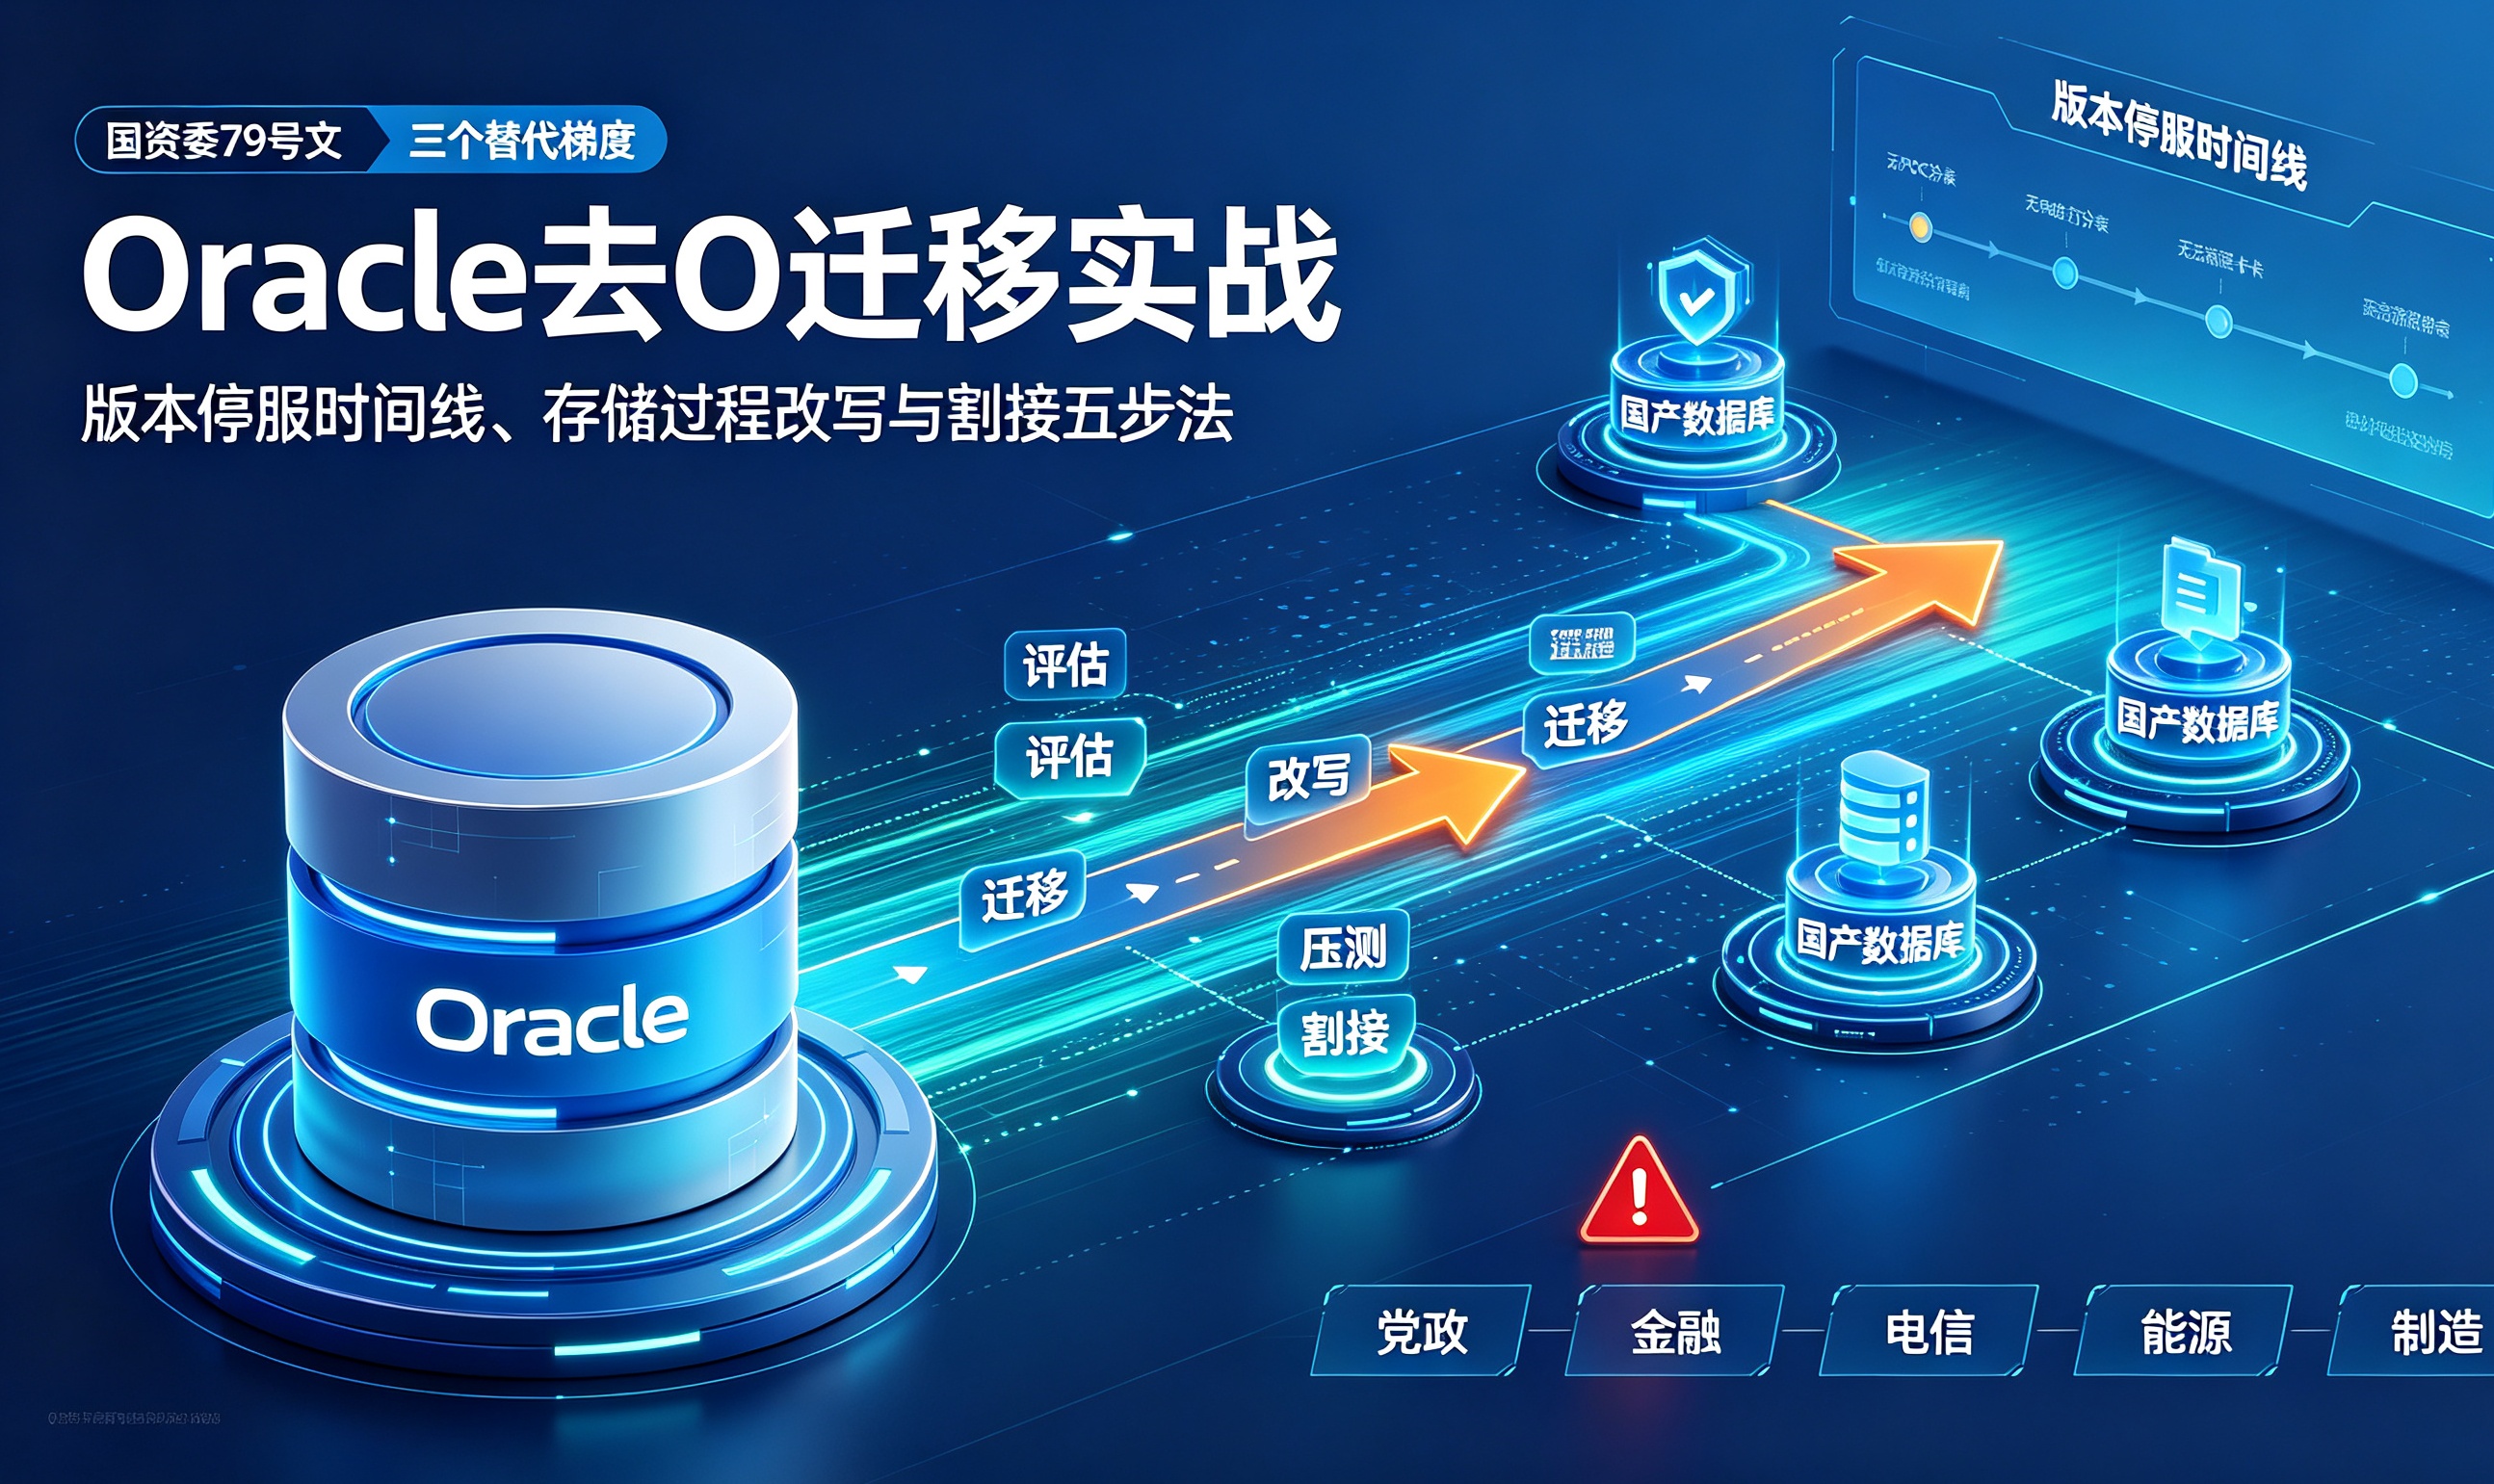
Oracle核心系统替换的三道技术关卡:RAC架构、跑批窗口与行为一致性

上个月团队接了个去O的活,让我先盘家底。系统清单拉出来,二十多个库,一大半还跑在Oracle 11g和12c上。这两个版本早就停服了,没补丁,出了问题没法兜底。报告交上去那天,领导问了一句:这些库2027前都得换完,排期怎么给?说实话,我给不出来。不是不知道工作量,是不知道同行走到哪了。快的是不是已经切完核心了,慢的还在外围打转?自己算快还是算慢,心里真没数。

优秀的个人博客,低调大师

从 1024 个子网到 /21 路由聚合,一道题吃透 A 类网络、C 类网络与超网掩码

这道题很适合用来检验是否真正理解了子网掩码,因为三个空表面都在算地址,实际上考察的是三个不同层次的问题。第一个空是在一个传统 A 类网络内部继续划分子网,第二个空是在估算 2000 台主机需要多少个传统 C 类网络,第三个空却把方向反了过来,要把多个 C 类网络聚合成一个更大的地址块,让路由器只保存一条路由。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册