Dromara 新晋开源项目 MPE ,MybatisPlus 能力拓展增强包
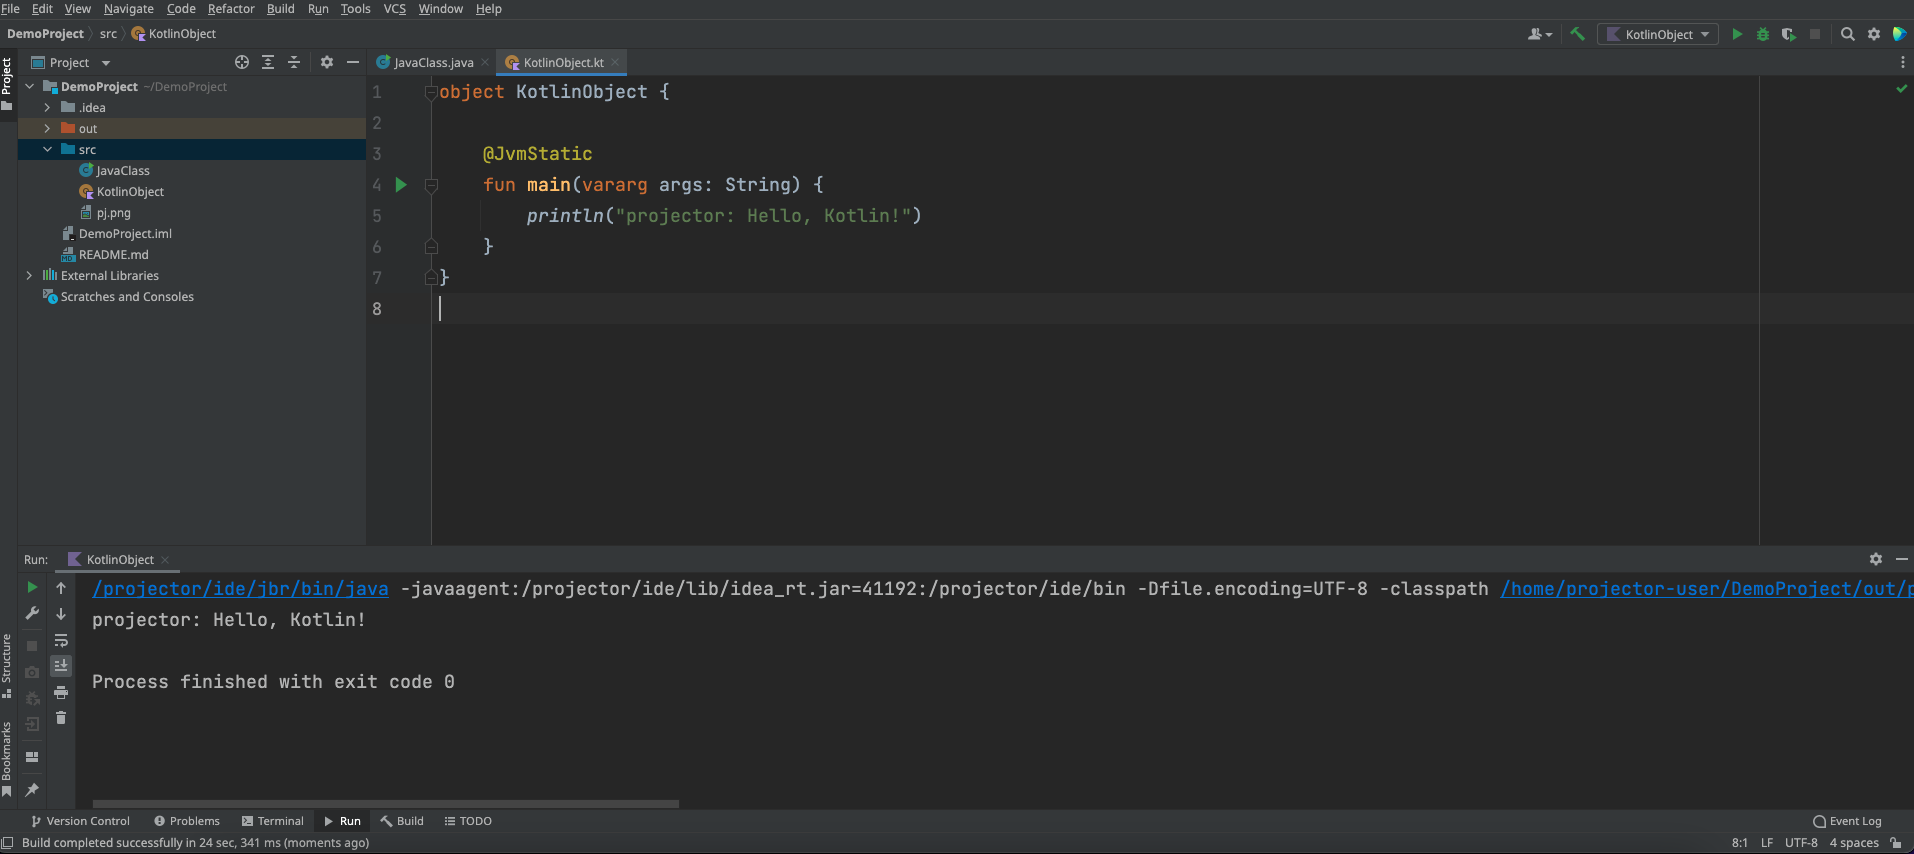
借用 MybatisPlus 的口号:为简化开发工作、提高生产率而生 尽管MybatisPlus(后文简称 MP)相比较 Mybatis 丝滑了很多,但是日常使用中,是否偶尔仍会怀念 JPA(Hibernate)的那种纵享丝滑的感受,更好的一心投入业务开发中,如果你也是如此,那么恭喜你发现了 MybatisPlusExt(后文简称 MPE)。 MPE 对 MP 做了进一步的拓展封装,即保留 MP 原功能,又添加更多有用便捷的功能。同样坚持 MP 的原则,只做增强不做改变,所以,即便是在使用 MPE 的情况下,也可以百分百的只使用 MP 的方式,因此 MP 能做的,MPE 不仅能做还能做的更多。 增强功能具体体现在几个方面:免手写Mapper、自动建表、数据自动填充(类似JPA中的审计)、关联查询(类似sql中的join)、冗余数据自动更新、动态查询条件。 开始 一、引入 jar 包 <!-- spring boot2.* --> <dependency> <groupId>com.tangzc</groupId> <artifactId>mybatis-plus-ext-spring-boot-starter</artifactId> <version>{maven仓库搜索最新版}</version> </dependency> <!-- spring boot3.* --> <dependency> <groupId>com.tangzc</groupId> <artifactId>mybatis-plus-ext-spring-boot3-starter</artifactId> <version>{maven仓库搜索最新版}</version> </dependency> 二、代码预生成 痛点: 某个地方的代码想使用下实体字段的名称,但是又不想写死一个字符串(丑、编译期不可校验)。 手动为每个实体写一个 Mapper 类,但是 Mapper 类中都是空的。 这些交给 MPE 吧!!! 它在代码编译期前,自动预生成实体字段的定义、实体 Mapper 的接口定义、实体 Repository 类的定义(该类是进一步封装 Mapper 的) // 标记生成表字段定义 @AutoDefine // 标记生成Mapper和Repository @AutoRepository @Data public class TestTable { private String id; private String name; private int age; } 效果如下: <img src="https://cdn.nlark.com/yuque/0/2024/png/279660/1709718028160-1660d6a7-f0b6-4c23-aad1-249c3ab11898.png" alt="img" style="zoom:50%;" /> 三、自动建表 MPE 自动建表依托于另一款自研框架AutoTable,MPE 是基于 AutoTable 做了部分注解的拓展,同时做了 Mybatis-plus 的兼容处理。 此处做一个简单的使用介绍 @EnableAutoTable @SpringBootApplication public class DemoAutoTableApplication { public static void main(String[] args) { SpringApplication.run(DemoAutoTableApplication.class, args); } } @Data @Table public class MyTable { private Integer id; private String userName; } 上述代码就会自动把 MyTable 映射为my_table表,字段分别是id:int、user_name:varchar(255) PS:具体表名、字段名是否转下划线是根据 MybatisPlus 的配置来的 下面展示一个注解全面的例子: @Data @AutoDefine // 指定表的编码 @MysqlCharset(value = "utf8mb4", collate = "utf8mb4_general_ci") // 指定表的存储引擎 @MysqlEngine("myisam") // 表头同样可以声明单个索引(此处只是举例,等价于username字段上的@Index) @TableIndex(name = "username_index", fields = {MyTableDefine.username}, type = IndexTypeEnum.UNIQUE) // 需要在表头声明多个索引的情况下,需要用@TableIndexes包裹起来 @TableIndexes({ // 声明普通联合索引 @TableIndex(name = "username_phone_index", fields = {MyTableDefine.username, MyTableDefine.phone}), // 声明唯一联合索引,单独指定phone的索引排序方式,构建索引的时候indexFields中字段的顺序权重高于fields中的字段 @TableIndex(name = "username_phone_uni_index", fields = {MyTableDefine.username}, indexFields = {@IndexField(field = MyTableDefine.phone, sort = IndexSortTypeEnum.DESC)}, type = IndexTypeEnum.UNIQUE), }) // 指定表名、表注释、数据源、忽略字段(不参与建表,等效于字段上的@Ignore) @Table(value = "test_table", comment = "测试表", dsName = "my-mysql", excludeProperty={MyTableDefine.extra}) public class MyTable { // 指定主键自增注释、类型(数据库数字类型可以跟java字符串类型相互转化)、长度 // 注意字段名称id会被自动认定为主键不需要再额外指定 @ColumnComment("id主键(因为我是独立注解,所以我是大哥,会覆盖下面的comment属性)") @ColumnId(mode = IdType.AUTO, comment = "id主键", type = MysqlTypeConstant.BIGINT, length = 32) private String id; // 字段非NULL @NotNull // 字段默认值是空字符串 @ColumnDefault(type = DefaultValueEnum.EMPTY_STRING) // 指定字段长度 @ColumnType(length = 100) // 指定字段注释 @ColumnComment("用户名") // 唯一索引 @Index(type = IndexTypeEnum.UNIQUE) private String username; // 设置默认值为0 @ColumnDefault("0") @ColumnComment("年龄") private Integer age; @ColumnType(length = 20) // 设置注释、默认值、不为空 @Column(comment = "电话", defaultValue = "+00 00000000", notNull = true) // 唯一索引快捷方式 @UniqueIndex private String phone; // 设置注释、小数(等同于@ColumnType(length = 12, decimalLength = 6)) @Column(comment = "资产", length = 12, decimalLength = 6) private BigDecimal money; // boolean值设置默认值 @ColumnDefault("true") @Column(comment = "激活状态") // 普通索引:指定索引名称、注释、索引方法 @Index(name = "active_index", comment = "激活状态索引") private Boolean active; // 单独设置字段类型 @ColumnType(MysqlTypeConstant.TEXT) @ColumnComment("个人简介") private String description; // 设置默认值为当前时间 @ColumnDefault("CURRENT_TIMESTAMP") @Column(comment = "注册时间") private LocalDateTime registerTime; // 忽略该字段,不参与建表 @Ignore private String extra; } 四、数据填充 可以在对数据库做插入或更新操作的时候,自动赋值数据操作人、操作时间、默认值等。 以文章发布为例,在发布 Artice 的时候,我们无需再去关心过多的与业务无关的字段值,最终只需要关心 title、content 两个核心数据即可,其他的数据均会被框架处理。 其中分别涉及了数据插入、数据更新、数据插入及更新三个处理时机,其中每个时机均可以插入系统时间及自定义用户信息。 定义文章实体 @Data @Table(comment = "文章") public class Article { // 字符串类型的ID,默认也是雪花算法的一串数字(MP的默认功能) @ColumnComment("主键") private String id; @ColumnComment("标题") private String title; @ColumnComment("内容") private String content; // 默认值用法:文章默认激活状态,ACTIVE为ActicleStatusEnum[ACTIVE, INACTIVE]的枚举名称字符串 @DefaultValue("ACTIVE") @ColumnComment("内容") private ActicleStatusEnum status; @ColumnComment("发布时间") // 【插入】数据时候会自动获取系统当前时间赋值,支持多种数据类型,具体可参考@FillTime注解详细介绍(注意,这里的时间是MP执行insert的操作的时候的时间,并不是对象构建时候的时间) @InsertFillTime private Date publishedTime; @ColumnComment("发布人") // 【插入】的时候,自动填充用户id,UserIdAutoFillHandler看下面代码 @InsertFillData(UserIdAutoFillHandler.class) private String publishedUserId; @ColumnComment("发布人名字") // 【插入】的时候,自动填充用户名字,UsernameAutoFillHandler看下面代码 @InsertFillData(UsernameAutoFillHandler.class) private String publishedUsername; @ColumnComment("最后更新时间") // 【插入和更新】数据时候会自动获取系统当前时间赋值,支持多种数据类型,具体可参考@FillTime注解详细介绍 @InsertUpdateFillTime private Date publishedTime; @ColumnComment("最后更新人") // 【更新】的时候,自动填充用户id,UserIdAutoFillHandler看下面代码 // @UpdateFillData(UserIdAutoFillHandler.class) // 【插入和更新】的时候,自动填充用户id,UserIdAutoFillHandler看下面代码 @InsertUpdateFillData(UserIdAutoFillHandler.class) private String publishedUserId; @ColumnComment("最后更新人名字") // 【更新】的时候,自动填充用户名字,UsernameAutoFillHandler看下面代码 // @UpdateFillData(UsernameAutoFillHandler.class) // 【插入和更新】的时候,自动填充用户名字,UsernameAutoFillHandler看下面代码 @InsertUpdateFillData(UsernameAutoFillHandler.class) private String publishedUsername; } 实现动态填充【用户 id】的接口 /** * 全局获取用户ID * 此处实现IOptionByAutoFillHandler接口和AutoFillHandler接口均可, * 实现IOptionByAutoFillHandler接口,可以兼容框架内的BaseEntity。 * BaseEntity默认需要IOptionByAutoFillHandler的实现。BaseEntity的使用请查看官网。 */ @Component public class UserIdAutoFillHandler implements IOptionByAutoFillHandler<String> { /** * @param object 当前操作的数据对象 * @param clazz 当前操作的数据对象的class * @param field 当前操作的数据对象上的字段 * @retur */ @Override public String getVal(Object object, Class<?> clazz, Field field) { RequestAttributes requestAttributes = RequestContextHolder.currentRequestAttributes(); HttpServletRequest request = ((ServletRequestAttributes)requestAttributes).getRequest(); // 配合网关或者过滤器,token校验成功后就把用户信息塞到header中 return request.getHeader("user-id"); } } 实现动态填充【用户名】的接口 /** * 全局获取用户名 */ @Component public class UsernameAutoFillHandler implements AutoFillHandler<String> { /** * @param object 当前操作的数据对象 * @param clazz 当前操作的数据对象的class * @param field 当前操作的数据对象上的字段 * @return 当前登录用户id */ @Override public String getVal(Object object, Class<?> clazz, Field field) { RequestAttributes requestAttributes = RequestContextHolder.currentRequestAttributes(); HttpServletRequest request = ((ServletRequestAttributes)requestAttributes).getRequest(); // 配合网关或者过滤器,token校验成功后就把用户信息塞到header中 return request.getHeader("user-name"); } } 五、关联查询 类似 JPA 的数据关联查询解决方案,替代 sql 中的 join 方式(或者内存组装数据的方式),通过注解关联多表之间的关系,查询某实体的时候,自动带出其关联性的数据。 以用户与文章之间的关系来举例 定义实体 @Data @AutoDefine @Table(comment = "文章") public class Article { @ColumnComment("主键") private String id; @ColumnComment("标题") private String title; @Column(comment = "内容", type = MySqlTypeConstant.MEDIUMTEXT) private String content; @ColumnComment("发布人") private String publishedUserId; @ColumnComment("审核: 0 不通过、1 通过") private int audit; @ColumnComment("发布时间(时间戳)") private Long publishedTime; } @Data @AutoDefine @Table(comment = "用户信息") public class User { @ColumnComment("主键") private String id; @ColumnComment("用户名") private String username; @ColumnComment("密码") private String password; // 关联该用户发布的所有文章("audit = 1" 表示的是Article下的audit为1的情况,customCondition的值只能是被关联表下的字段值,且会以and的形式添加在查询条件末尾。) @BindEntity(conditions = @JoinCondition(selfField = UserDefine.id, joinField = ArticleDefine.publishedUserId), customCondition = "audit = 1", orderBy = @JoinOrderBy(field = ArticleDefine.publishedTime, isAsc = false)) private List<Article> articles; } 需求:获取用户信息的同时只想获取用户已通过审核的发布记录,并且根据发布时间倒序排序。(通过自定义 SQL 条件) 【写法一】 // 获取到需要的user集合 User user = userMapper.getByUsername(name); // 【推荐】用法一、指定属性关联。 Binder.bindOn(user, User::getArticles); // 【不推荐】用法二、全关联。此种用法关联user下所有声明需要绑定的属性。 // Binder.bind(user); 【写法二】 // 本框架拓展的lambda查询器lambdaQueryPlus,增加了bindOne、bindList、bindPage // 显然这是一种更加简便的查询方式,但是如果存在多级深度的关联关系,此种方法就不适用了,还需要借助Binder User user = userRepository.lambdaQueryPlus() .eq(User::getUsername, name) // 【推荐】用法一、指定属性关联,只关联文章这个字段。 .bindList(User::getArticles); // 【不推荐】用法二、全关联。此种用法关联user下所有声明需要绑定的属性。 // .bindList(); * 如果你打开 sql 打印,会看到 2 条 sql 语句,第一条根据 name 去 user 查询信息,第二条根据 userId 去 article 中查询关联的所有数据。 篇幅有限,更多用法(中间表查询、多对多查询等),请移步官方文档 注意: 为了解决数据库兼容支持的问题,关联查询底层原理是基于 MybatisPlus 的 BaseMapper<T> 实现的,所以要求所有关联的实体必须要对应的 Mapper 且继承自 MybatisPlus 的 BaseMapper<T>,包括中间表的实体,在使用中间表关联查询的情况下,也需要遵循此约束。 MPE 相当于把实体对应的 Mapper 视为数据访问窗口了,所以但凡需要从数据库查询数据的行为均需要通过对应的 Mapper 完成。 六、数据冗余 为了避免高频的数据关联查询,一种方案是做数据冗余,将其他表的部分字段冗余到当前表。但是这个方案牵扯一个数据修改后如何同步的问题,本功能就是为了解决这个问题而生的。 假设用户评论的场景,评论上需要冗余用户名和头像,如果用户的名字和头像有改动,则需要同步新的改动,代码如下: @Data @AutoDefine @Table(comment = "用户信息") public class User { @ColumnComment("主键") private String id; @ColumnComment("用户名") private String username; @ColumnComment("头像") private String icon; // 省略其他属性 ...... } @Data @AutoDefine @Table(comment = "评论") public class Comment { @ColumnComment("主键") private String id; @ColumnComment("评论内容") private String content; @ColumnComment("评论人id") private String userId; // source指定了数据来源的Entity,同样可以使用sourceName来指定全路径的方式,field指定了映射哪个字段 // conditions中隐含了一个joinField字段,该字段默认是“id”,即@Condition(selfField = "userId", joinField = "id")等同于示例中的写法 @DataSource(source = User.class, field = UserDefine.username, conditions = @Condition(selfField = UserDefine.userId)) @ColumnComment("评论人名称") private String userName; // 如上,同理 @DataSource(source = User.class, field = UserDefine.icon, condition = @Condition(selfField = UserDefine.userId)) @ColumnComment("评论人头像") private String userIcon; } 基于 @DataSource 注解,框架会自动为指定字段注册监听EntityUpdateEvent事件(MPE 内置事件,可手动发起),所有 MP 的 Mapper 的updateById和updateBatchById两个方法执行的时候会自动发布EntityUpdateEvent事件。如果使用其他数据更新方式(比如手动写 sql 的形式)不会自动触发数据自动更新,如果想触发,需要用户自己抛出EntityUpdateEvent事件,即可完成数据自动更新。 具体用法及讲解,请移步官方文档 七、动态条件 根据预先设置的条件函数,对数据的更新、删除、查询做动态的筛选。常用于数据权限方面。 比如根据不同权限获取不同数据,用户只能看到自己的数据,管理员能看到所有人的数据,我们通常需要在每一个查询、更新、删除的 sql 操作上都追加上某个条件,这种操作比较机械化,而且某些情况下很容易忘记,可以抽象成注解直接配置到 Entity 上,就省去了每个数据操作关心这个特殊条件了。 /** * congfig中注册动态条件拦截器【1.3.0之前的版本(不包括1.3.0)可以忽略,不注册该Bean】 */ @Bean public MybatisPlusInterceptor mybatisPlusInterceptor() { MybatisPlusInterceptor interceptor = new MybatisPlusInterceptor(); // 添加动态条件,若同时添加了其他的拦截器,继续添加即可 interceptor.addInnerInterceptor(new DynamicConditionInterceptor()); // 如果使用了分页,请放在DynamicConditionInterceptor之后 interceptor.addInnerInterceptor(new PaginationInnerInterceptor()); return interceptor; } @Data @Table(comment = "文章") public class Article { @ColumnComment("主键") private String id; @ColumnComment("标题") private String title; @ColumnComment("内容") private String content; @ColumnComment("发布人") // 添加了该注解后,针对文章的查询、修改、删除操作,均会被自动带上 published_user_id=?或者published_user_id in (?)的条件,?值来自于CurrentUserDynamicConditionHandler的values()返回值 @DynamicCondition(CurrentUserDynamicConditionHandler.class) private String publishedUserId; // 省略其他字段 ...... } @Component public class CurrentUserDynamicConditionHandler implements IDynamicConditionHandler { @Resource private HttpServletRequest request; @Override public List<Object> values() { // 只有当enable()返回true的时候 本动态条件才生效。 // 返回空集合或者null的时候,sql上体现的是 [column] is null,只返回一个值的时候sql上体现的是 [column]=***, // 返回集合的时候,sql上体现的是 [column] in (***) String userId = request.getHeader("USER_ID"); return Collections.singletonList(userId); } @Override public boolean enable() { // 简单例子:header中取用户权限,如果是非管理员则执行该过滤条件,如果是管理员默认查全部,返回false,本动态条件失效 String userRule = request.getHeader("USER_ROLE"); return !"ADMIN".equals(userRule); } } 具体用法及讲解,请移步官方文档 八、字段序列化与反序列化 数据存储的时候自动序列化字段上的复杂数据类型为字符串(类 json 格式),数据读取的时候自动反序列化回来,无需额外编写转化的 Handler(MP 官方的方案,需要手动为每一个复杂数据类型指定一个 BaseTypeHandler)。 该方案存在一定的局限性,实际是借鉴了 Redisson 的一种数据序列化方案,将数据本身的特征(类全名称)在序列化的时候,一并记录下来,用于反序列的依据,所以序列化之后的字符串并不是一个标准的 json。这种方案的缺点很明显,就是类的全名称(包名 + 类名)不能随意更改,因为一旦更改,会导致找不到 class 的问题,进而无法正常的反序列化已经存在的数据。 @Data @TableName(autoResultMap = true) // 必须 @Table(comment = "用户") public class Users { @ColumnComment("ID") private Long id; @Serializable // 必须 @ColumnComment("爱好") private List<Like> likes; } @Data public class Like { private String id; private String name; } 感谢 感谢dromara.org开源社区提供的机会 感谢支持的小伙伴 作者介绍 90 年,男,已婚,前后端均有涉猎,毕业后一直在济南这座城市,如果有同地区的小伙伴随时可约 作者开源项目,求各位看官动动发财的小手,给个 star https://gitee.com/dromara/mybatis-plus-ext https://gitee.com/tangzc/auto-table