源码分析Dubbo序列化-源码分析kryo序列化实现原理
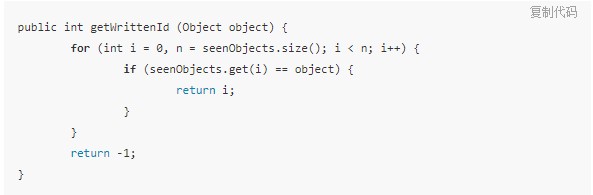
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 本文主要梳理 Kryo 序列化基本实现。重点剖析 Kryo # writeClassAndObject、Kryo # readClassAndObject 方法。 1、源码分析Kryo#writeClassAndObject public void writeClassAndObject (Output output, Object object) { if (output == null) throw new IllegalArgumentException("output cannot be null."); beginObject(); // @1 try { if (object == null) { writeClass(output, null); // @2 return; } Registration registration = writeClass(output, object.getClass()); // @3 if (references && writeReferenceOrNull(output, object, false)) { // @4 registration.getSerializer().setGenerics(this, null); return; } if (TRACE || (DEBUG && depth == 1)) log("Write", object); registration.getSerializer().write(this, output, object); // @5 } finally { if (--depth == 0 && autoReset) reset(); // @6 } } 代码@1:开始序列化,将dept自增,表示当前深度,因为在序列化一个对象时,该方法有可能会被递归调用,每递归调用增加1,一次调用结束后在finally字句中自减。 代码@2:如果对象为空,则调用 writeClass ( DefaultSerializers $ ClassSerializer ),序列化为空。 代码@3:如果对象不为空,首先序列化对象所属的 Class 实例,从这里可以看出,Kryo 在序列化时,首先先序列化类型。 代码@4:如果 references 为 true (默认为 true,可以序列化循环依赖),则调用 writeReferenceOrNull 序列化。 代码@5:如果 references 为 false,则调用 write 序列化,此时如果对象存在循环依赖,则会抛出 throw new KryoException("Max depth exceeded: " + depth ) 异常,如果 object 为基本类型,也将通过该方法完成值的序列化。 代码@6:完成序列化后,恢复相关数据。也就是说 Kryo 实例并不是线程安全的。 默认 references 为 true,表示支持循环嵌套,我们接下来重点跟踪一下 writeReferenceOrNull 方法。 1.1 源码分析writeReferenceOrNull方法 /** @param object May be null if mayBeNull is true. * @return true if no bytes need to be written for the object. */ boolean writeReferenceOrNull (Output output, Object object, boolean mayBeNull) { // @1 if (object == null) { // @2 if (TRACE || (DEBUG && depth == 1)) log("Write", null); output.writeVarInt(Kryo.NULL, true); return true; } if (!referenceResolver.useReferences(object.getClass())) { // @3 if (mayBeNull) output.writeVarInt(Kryo.NOT_NULL, true); return false; } // Determine if this object has already been seen in this object graph. int id = referenceResolver.getWrittenId(object); // @4 // If not the first time encountered, only write reference ID. if (id != -1) { // @5 if (DEBUG) debug("kryo", "Write object reference " + id + ": " + string(object)); output.writeVarInt(id + 2, true); // + 2 because 0 and 1 are used for NULL and NOT_NULL. return true; } // Otherwise write NOT_NULL and then the object bytes. id = referenceResolver.addWrittenObject(object); // @6 output.writeVarInt(NOT_NULL, true); if (TRACE) trace("kryo", "Write initial object reference " + id + ": " + string(object)); return false; // @7 } 代码@1:参数说明:Output output:输出流;Object object:待序列化的对象; 代码@2:如果对象为空,写入 Kryo.NULL(0),然后返回 true,表示需要设置 generic,后续会讲解一下 generic(泛型支持)。 代码@3:如果是基本类型,如果 maybe (值可能为空),但该方法不为空,则设置为 Kryo.NOT_NULL ,然后返回 false,表示非引用类型,需要持久化值。 代码@4:判断该对象是否在对象图中已被序列化一次。(其实现方式 ListReferenceResolver、MapReferenceResolver)。 代码@5:如果 writtenId 不等于 -1,表示该对象已被序列化,直接序列化 ID,直接返回 true,然后结束 writeClassAndObject该方法,表示该对象实例完成。 代码@6:为 object 构建一 个 ID,这个 ID 数据是在一次嵌套调用 writeClassAndObject 内有效,然后 writeClassAndObject 结束后,会调用 reset 方法,将其清空,然后先写入为空标识,并返回 false,也就是第一次序列化对象时,返回 false,会进入到 writeClassAndObject 的代码@5中。 Kryo#writeClassAndObject 代码@5registration.getSerializer().write(this, output, object); // @5复制代码其实其重点关键,还是 writeClassAndObject # writeClass 也就是上文说的代码 @3,在序列化对象之前,首先先序列化该对象的类型,然后需要返回对应的字段序列器。例如,如果类的类型为 java.util.Map,则首先先要记录类型为 Map,然后返回可以序列化 Map 的序列器,再例如类型如果是 java.lang.String,则先序列化类型,然后序列化值,序列化值的序列器则为 DefaultSerializers$StringSerializer,那如果是一个对象类型,例如 cn.uce.demo.Student,自然,第一步是先序列化类型 cn.uce.demo.Student,接下来就需要序列化 Student 的各个字段的信息,返回的序列化为 DefaultSerializers$FieldSerializer,然后可以通过 FieldSeriaizer 返回 Student 的属性列表,然后单独一个字段一个字段的序列化,其顺序也就是,先类型,再序列化值。这样就递归完成了一个对象的序列化操作。 Kryo序列化实现原理: 1、先序列化类型(Class实例),然后根据类型返回相应的序列化器(上一篇详细介绍了各种类型的序列化器)。 2、再序列化该类型的值。 3、如果自定义类型,例如(cn.uce.demo.Student),则返回的值序列化器为DefaultSerializers$FieldSerializer,然后一个字段一个字段的序列化,当然其序列化类型也是,先类型再值的模式,递归进行,最终完成。 4、引入了对象图的概念来消除循环依懒的序列化,已序列化的对象,在循环引用时,只是用一个int类型来表示该对象值,类似一种缓存的概念。 Kryo与java 序列化的区别 kryo 的设计目的是指对象值的序列化,关注的是数据有效数据的传输,减少需要序列化的元数据信息。 这一点通过 Kryo 对 Class 对象的序列化,也就是类型的序列化就能看出端倪。 Kryo 对 Class 的序列化只需要化 Class 的全路径名,在反序列化时根据 Class 通过类加载进行加载,大大减少了序列化后的文件大小,能极大提高性能。 Kryo 的核心设计理念就是尽最大可能减少序列化后的文件大小,其举措1就是通过对long,int等数据类型,采用变长字节存储来代替java中使用固定字节(4,8)字节的模式,因为在软件开发中,对象的这些值基本上都是小值,能节省很多空间,第二个举措是使用了类似缓存的机制,在一次序列化对象中,在整个递归序列化期间,相同的对象,只会序列化一次,后续的用一个局部int值来代替。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-24本文作者:中间件兴趣圈本文来自:“掘金”,了解相关信息可以关注“掘金”