首页 文章 精选 留言 我的

精选列表

搜索[Linux内核],共10000篇文章
优秀的个人博客,低调大师

Android内核剖析读书笔记

第16章 程序包管理 PackageManagerService類 PmS 目錄 16.1 包管理概述 16.2 packages.xml文件格式 16.3 包管理服務的啟動過程 16.4 應用程序的安裝和卸載 16.5 intent匹配框架 16.1 包管理概述 1.包管理服務的程序結構 分別為應用程序層,PmS服務層,及數據文件層 應用程序層 DontextImpl.ApplicationPackageManager Pms服務層 /data/system/packages.xml 所有应用程序与包管理相关信息 /system/etc/permisions/xxx.xml 加载系统feature,并为核心系统进程分配默认权限 PackageManagerService DefaultContainerService : 把安裝程序複製到程序目錄中。 Installer: 實際上是一個Socket客戶端。 程序文件層 /system/app 系统自带应用程序路径 /data/app 第三方应用程序层 /data/dalvik-cache/dex文件输出路径 /system/framework/*.apk;*.jar framework中的程序 /data/secure 加密文件 /data/drm/ drm用户专有目录 /data/app-private/drm用户专有目录 /data/data/ 普通程序数据 16.2 packages.xml文件格式 保存在 /data/system目錄下,裏面有很多標籤,如last-platform-version, permission-trees等。 16.3 包管理服務的啟動過程 包管理服務的啟動過程實際上市讀取XML文件中的信息,并把這些信息存放到相關的類成員變量中。 1.創建PmS。Settings對象 2.mSettings.addShareduserLP() 添加四個共享id。 3.創建一個Installer對象,該對象將輔助程序的安裝。 4.給幾個數據文件賦值。如mAppDataDir,mSecureAppDataDir,mDrmAppPrivateInstallDir。 5.調用readPermission函數。 6.調用沒Setting對象的readLP函數,讀取應用程序和包管理相關信息。 7.對java系統中的庫進行dex提取。 8為三個程序目錄創建一個FileObserver。FileObserver对象内部会检测目录中的添加、删除事件。這三個目錄是 /system/frameworks: 该目录保存了framework內核相關程序 /system/app:系统程序 /verdor/app:第三方程序,一般指厂商开发的自定义程序。 9 调用scanDirLI()掃描(解析程序中的Androidmanifest.xml)以上三個目錄中的所有程序文件,并將掃描結果放到PmS中的mPackages變量中。 10 刪除已經不存在程序對應的數據記錄。 11 清除沒有安裝成功的數據記錄。 12 為一下兩個第三方程序目錄添加FileObserver,并調用scanDirLI()解析目錄下所有的應用程序。 這連個目錄如下。 /data/app: 普通應用程序目錄。 /data/app-private: 該目錄沒錢并沒有被使用。 13 刪除/data/app目錄下以vmdl開頭及以.tmp结尾的文件。 14 如果系統版本升級,調用updatePermissionLP() 重新為應用程序賦予權限。 15 調用writeLP() 將mPackages中的數據重新寫入packages.xml文件中。 以上就是Pms啟動的主體功能。 16.4 應用程序的安裝和卸載 安裝和卸載應用程序都由PmS完成。安裝程序的過程包括在程序目錄下創建以包命名的程序文件、創建程序數據目錄,以及把程序相關的信息保存到相關的配置文件packages.xml文件中,卸載過程則是相反的操作。 16.5 intent匹配框架 intent匹配主要解決應用程序中沒有明確指定Component名稱的情況。 本文转自Work Hard Work Smart博客园博客,原文链接:http://www.cnblogs.com/linlf03/p/3370227.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

腾讯云Agent Memory技术内核剖析

Gartner于2024年10月发布的2025年顶级战略技术趋势报告,将"代理型AI(Agentic AI)"列为首要趋势,指出其融合记忆、规划、环境感知、工具使用与安全准则等功能,能够自主执行任务并达成目标。Gartner预测,到2028年至少15%的日常工作决策将通过自主智能代理完成,而2024年该比例仅为0%。与此同时,Markets and Markets预测全球AI Agent市场规模将从2024年的51亿美元增至2030年的471亿美元,年复合增长率达44.8%。爱分析测算进一步显示,中国智能体记忆市场规模将从2025年的14.4亿元激增至2030年的642.5亿元,复合增长率超过110%。

优秀的个人博客,低调大师

深入工作流调度的内核

在大数据时代,工作流任务调度系统成为了数据处理和业务流程管理的核心组件,在大数据平台的构建和开发过程中尤为重要。随着数据量的激增和业务需求的多样化,合理的任务调度不仅能够提高资源利用率,还能保证业务流程的稳定和高效运行。本文将结合实际场景,探讨目前市面上常见的工作流任务调度及其关键特性。 一、工作流任务调度的定义 工作流任务调度是什么?简单来说,它是指在特定的时间点或条件下,根据预设的规则和依赖关系,自动触发并执行一系列任务的过程。它通常涉及多个任务之间的依赖关系,需要确保这些任务按照正确的顺序和时机执行。 工作流调度主要涉及两个关键概念:作业计划(Job Plan)和任务实例(Task Instance) 。 作业计划 是指预定的任务执行策略,包括何时执行、依赖关系以及执行条件等。而任务实例则是指在具体时间点上执行的任务。在工作流调度中,任务实例的生成通常基于作业计划,通过对作业的依赖关系进行解析,确保作业按照预期顺序和时间执行。 二、常见的工作流任务调度系统 市面上常见的工作流调度可以分为两个大类:定时分片类作业调度系统 和DAG工作流类作业调度系统。 1. 定时分片类调度系统 这种调度系统通常用于定时任务的分片执行。其代表系统如TBSchedule、SchedulerX和Elastic-job等。主要特性包括: 任务分片:将大任务拆分为多个小任务,分配到不同的服务器上并发执行。这不仅提高了处理效率,也能实现负载均衡。 精确定时:要求任务在指定时间点精确触发,以确保业务流程的及时性。例如,定时清理日志文件、定时生成报表等。 在工作流任务调度系统的架构设计中,负载均衡、弹性扩容、状态同步和失效转移是重点考虑的特性。由于支持分片逻辑和失效转移,调度系统对任务通常有侵入性要求,用户作业需要依赖客户端库函数,并实现接口以满足服务端管理需求。为了确保精确定时触发,大部分系统的触发逻辑由执行节点本地处理,减少服务端负载,并提高触发的精度与效率。部分系统如SchedulerX则采用服务端触发逻辑,这要求服务端具备高可用性和良好性能,通常需要集群方案以支持触发队列的维护。 2. DAG工作流类调度系统 DAG全称Directed Acyclic Graph,简称DAG。工作流中的Task任务以有向无环图的形式组装起来,从入度为零的节点进行拓扑遍历,直到无后继节点为止。 这种系统主要关注任务之间的依赖关系,代表系统有Apache DolphinScheduler、Oozie、Azkaban和Zeus等。其核心特性包括: 依赖管理:支持复杂的任务依赖关系,确保任务在满足前置条件时自动触发。例如,数据清洗任务在数据采集成功后才能执行。 灵活的触发机制:支持时间触发、依赖触发等多种方式,满足不同业务场景的需求。 根据具体任务的执行方式,DAG工作流调度系统可分为两种类型:静态执行列表和动态执行列表。 总的来说,静态执行列表通过提前计算生成任务执行实例,适合处理已知的、周期性任务变更,便于进行临时修改和管理。 而动态执行列表则在任务执行时实时计算实例,更适应于复杂的依赖关系和临时变更,但对计划和实例间的同步管理要求较高。静态方案架构简单,适合任务依赖清晰的场景;动态方案覆盖面广,响应变更及时,但实现复杂。在实际应用中,两者可结合使用,以解决各自的局限性。 三、工作流任务调度的关键特性 1. 任务依赖管理 在实际应用中,任务之间往往存在复杂的依赖关系。有效的任务调度系统能够动态管理这些依赖,确保任务按照预定顺序执行,避免因依赖关系不正确导致的执行失败。 2. 高可用性 高可用性是保证系统稳定运行的关键特性。调度系统需要具备故障自动恢复能力,确保在节点崩溃或网络故障时,任务能够自动迁移并继续执行。 3. 监控与报警 有效的监控机制能够及时反馈任务的执行状态。一旦出现故障或超时,系统应能够及时发出警报,以便运维人员快速响应和处理。 4. 灵活的任务配置 用户在定义工作流时,需提供灵活的任务配置选项,包括任务的执行频率、执行条件和执行参数等。便捷的配置方式可以降低用户的操作成本,提高工作效率。 四、工作流任务调度的应用场景 数据处理:在数据采集、清洗和分析过程中,任务调度系统可以确保各个环节有序进行,确保数据的准确性和及时性。 报告生成:定期生成报表的任务可以通过调度系统自动化执行,减少人工干预,提高效率。 监控与维护:定时检查系统状态、清理无用数据等维护任务也可通过调度系统来实现。 在实际应用中,定时分片类调度系统适合执行简单的、周期性任务,例如定时数据备份、报告生成等。这些任务通常具有明确的执行时间和较低的复杂性。 相对而言,DAG工作流类调度系统则更适合处理复杂的数据流水线。 例如,在大数据分析平台中,从数据采集到最终报告生成,往往需要多个作业相互依赖执行。这类系统能够灵活应对任务变更和调度策略调整,提高数据处理的效率和可靠性。 五、常见的工作流调度工具 市场上有多种开源和商业化的工作流调度工具,每种工具都有其独特的优势和适用场景。以下是一些常见的工作流调度系统: Apache DolphinScheduler:专注于提供灵活的任务调度和管理,支持复杂的任务依赖关系,能够高效处理大规模数据处理工作流。DolphinScheduler的可视化界面和丰富的插件机制,使得用户可以方便地定义、调度和监控工作流。此外,DolphinScheduler的分布式架构保证了高可用性和扩展性,适合企业在多种场景下的应用,如数据ETL、报表生成和定期任务调度等。 Apache Oozie:基于Hadoop的工作流调度系统,支持复杂的依赖关系和多种作业类型(如MapReduce、Pig、Hive等)。Oozie使用XML定义工作流,适合需要处理大规模数据的环境。 <!-- --> Azkaban:由LinkedIn开发,专注于简化复杂工作流的管理。Azkaban使用.job文件描述作业的依赖关系,提供了用户友好的Web界面。 Chronos:一个分布式的任务调度器,支持Cron语法的定时任务和依赖关系。Chronos更适合对实时性要求较高的任务调度。 Airflow:由Airbnb开发,强调动态工作流的定义和可视化管理,支持Python作为定义语言,适合需要灵活调度的场景。 六、技术选型怎么做? 市面上的作业调度系统这么多,那么在对工作流任务调度系统进行技术选型时,企业主要需要考虑到哪些因素呢? 通过对众多企业在进行作业调度系统选型的观察,我们了解到企业一般会比较在意调度系统的以下问题: 可扩展性:系统能否随着数据量和任务复杂度的增加而水平扩展。 可靠性:系统的容错能力和高可用性,确保任务执行的稳定性。 性能:任务调度和执行的效率,包括延迟和吞吐量。 易用性:用户界面友好程度、配置和管理的便利性。 集成能力:与现有系统和工具(如数据源、消息队列等)的兼容性和集成能力。 监控与告警:是否提供实时监控、日志记录和告警机制,便于运维管理。 社区与支持:是否有活跃的社区和专业支持,确保问题能够及时解决。 安全性:数据加密、用户权限管理等安全措施的有效性。 成本:总体拥有成本,包括软件许可、基础设施和维护费用。 灵活性:支持多种调度策略、工作流定义和任务类型的能力。 以上这些方面做得比较好的话,企业在进行技术选型时基本上就不会有什么悬念。当然,除了以上因素,企业还应该结合自己的具体应用场景,选择适合自己的调度产品。 这里是目前市面上主流的调度系统优劣势对比图: 结论 随着业务流程的复杂化和数据规模的不断扩大,工作流任务调度系统的重要性愈发突出。选择合适的调度系统不仅能够提升任务处理效率,还能为企业带来更大的灵活性和竞争力。在实际应用中,企业应根据自身的业务需求和场景特点,选择合适的任务调度方案,以实现高效的工作流管理。 本文由 白鲸开源科技 提供发布支持!

优秀的个人博客,低调大师

range内核端口数据转发模块

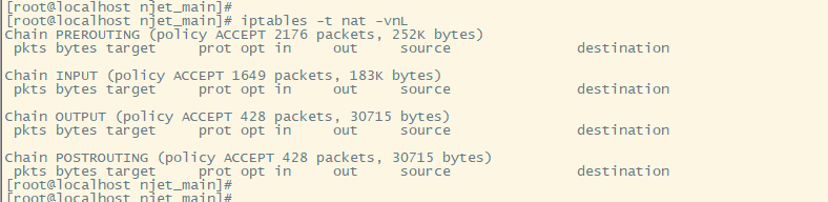
NGINX 向云原生演进,All inOpenNJet range 端口转发模块 1.1 需求 在很多时候,比如流量劫持、ftp被动模式代理等功能需要能够支持流量端口转发。比如需要将10000到11000端口范围的所有流量都统一转到12000端口上,然后在12000端口上接收所有的报文进行后续处理。 1.2 依赖 该功能的实现依赖于iptables,如果通过rpm包安装,则自动为privilege进程为root启动 如果是普通用户启动,需要对opennjet设置setuid权限 setcap cap_setuid=eip /home/njet/sbin/njet 1.3 指令设计 Syntax range type={tcp|udp} src_ports={port1:port2} dst_port={dst_port}; 如果默认iptables path为/usr/sbin/iptables, 如果系统iptables路径不是这个,需要指定使用如下指令 range iptables_path={iptables_path}; Default - Context Core, 支持配置多条 参数说明: 参数 类型 必填 默认值 说明 type string 否 tcp [tcp|udp], 指明是tcp还是udp数据,默认tcp src_ports string 是 - 支持单端口或者端口范围,格式如下: 端口范围(冒号分隔): 11000:12000 一个端口: 11000 dst_port int 是 - 目标端口 iptables_path string 否 /usr/sbin/iptables 这个根据系统而定,调用system执行的时候可能会出现找不到iptables错误,这个时候需要看看对应系统的iptables path,然后设置一下这个参数 如果配置多条range指令,则以最后一个明确指定的iptables_path为准 配置示例(tcp为例): 将发往本机端口为11000到12000范围的数据,转发到13000端口: range type=tcp src_ports=11000:12000 dst_port=13000 将发往本机端口为11000,转发到13000端口: range type=tcp src_ports=11000 dst_port=13000 设置iptables path为/usr/sbin/iptables range iptables_path=/usr/sbin/iptables; 1.4 实现方案 本功能的实现借助于iptables规则,通过range指令解析参数,然后生成对应的iptables规则下发。 range指令支持配置多条规则 模块init的时候会根据规则生成iptables规则 模块exit的时候会将规则进行删除 所有的规则都会放到自定义iptables链 OPENNJET上 1.5 测试 1.5.1 配置示例 njet.conf 配置里配置两条range指令 ... load_module modules/njt_range_module.so; #加载range模块... user nobody; events { worker_connections 1024; } error_log logs/error_privilege.log info;#配置两条range指令range type=tcp src_ports=11000:12000 dst_port=13000;range type=tcp src_ports=10000 dst_port=14000;#默认路径为/usr/sbin/iptables, 如果系统路径不一致需要调用该指令设置下路径range iptables_path=/usr/sbin/iptables;http { access_log logs/access_privilege.log combined; include mime.types; server { ... } } cluster_name helper; node_name node1; 1.5.2 测试结果 启动OpenNJet前 查询系统iptables 规则: 启动OpenNJet后 重新查询iptables规则,发现两条规则生效 reload重启后 重新查询,发现两条规则还在 停止OpenNJet后 重新查询,两条规则删除 2. 命令式 API动态配置端口转发规则 2.1 需求: 能够通过api接口查询全量的range 配置规则 能够通过api增加或者删除一条range配置规则 根据type、src_ports、dst_port三个字段来确定一条规则 2.2 配置 ctrl控制面配置: ...load_module modules/njt_http_range_api_module.so; #load range api module ... server { listen 8081; location /range { dyn_range_api; #配置range api开关 } } ... 2.3 动态API 查询: GET http://192.168.40.136:8081/range { "ranges": [ { "type": "tcp", "src_ports": "11000:12000", "dst_port": 10001 }, { "type": "tcp", "src_ports": "10000", "dst_port": 14000 } ] } PUT http://192.168.40.136:8081/range #添加一条规则 { "action": "add", "type": "tcp", "src_ports": "11000:13000", "dst_port": 10001 } #删除一条规则 { "action": "del", "type": "tcp", "src_ports": "11000:13000", "dst_port": 10001 } 参数 类型 必填 默认值 说明 action string 是 - [add|del] type string 是 - [tcp|udp], 指明是tcp还是udp数据 src_ports string 是 - 支持单端口或者端口范围,格式如下: 端口范围(冒号分隔): 11000:12000 一个端口: 11000 dst_port int 是 - 目标端口 return: { "code": 0, #0 表示成功, 非0 表示失败 "msg": "success" } 错误码 code msg 描述 0 success 成功 2 - 内存分配失败相关的一些错误信息 4 rule is not found 删除一个不存在的规则 4 rule has exist 添加一个已经存在的规则 4 其他错误 2.4 swagger访问 可以通过doc模块提供的swagger界面操作 http://192.168.40.136:8081/doc/swagger/ 2.5 测试 通过swagger页面进行api测试 初始状态get 查询配置 查询iptables 通过swagger页面添加一个规则 再次 查询配置和iptables reload后再次查询,动态添加的配置和iptables都存在刚才动态添加的配置 Stop OpenNJet后,iptables规则消失 OpenNJet 最早是基于 NGINX1.19 基础 fork 并独立演进,具有高性能、稳定、易扩展的特点,同时也解决了 NGINX 长期存在的难于动态配置、管理功能影响业务等问题。邮件组官网

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册