首页 文章 精选 留言 我的

精选列表

搜索[计算机组成原理],共10000篇文章
优秀的个人博客,低调大师

sqlx操作MySQL实战及其原理

sqlx是Golang中的一个知名三方库,其为Go标准库database/sql提供了一组扩展支持。使用它可以方便的在数据行与Golang的结构体、映射和切片之间进行转换,从这个角度可以说它是一个ORM框架;它还封装了一系列地常用SQL操作方法,让我们用起来更爽。 sqlx实战 这里以操作MySQL的增删改查为例。 准备工作 先要准备一个MySQL,这里通过docker快速启动一个MySQL 5.7。 docker run -d --name mysql1 -p 3306:3306 -e MYSQL_ROOT_PASSWORD=123456 mysql:5.7 在MySQL中创建一个名为test的数据库: CREATE DATABASE `test` /*!40100 DEFAULT CHARACTER SET utf8mb4 */; 数据库中创建一个名为Person的数据库表: CREATE TABLE test.Person ( Id integer auto_increment NOT NULL, Name VARCHAR(30) NULL, City VARCHAR(50) NULL, AddTime DATETIME NOT NULL, UpdateTime DATETIME NOT NULL, CONSTRAINT Person_PK PRIMARY KEY (Id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci; 然后创建一个Go项目,安装sqlx: go get github.com/jmoiron/sqlx 因为操作的是MySQL,还需要安装MySQL的驱动: go get github.com/go-sql-driver/mysql 编写代码 添加引用 添加sqlx和mysql驱动的引用: import ( "log" _ "github.com/go-sql-driver/mysql" "github.com/jmoiron/sqlx" ) MySQL的驱动是隐式注册的,并不会在接下来的程序中直接调用,所以这里加了下划线。 创建连接 操作数据库前需要先创建一个连接: db, err := sqlx.Connect("mysql", "root:123456@tcp(127.0.0.1:3306)/test?charset=utf8mb4&parseTime=true&loc=Local") if err != nil { log.Println("数据库连接失败") } 这个连接中指定了程序要用MySQL驱动,以及MySQL的连接地址、用户名和密码、数据库名称、字符编码方式;这里还有两个参数parseTime和loc,parseTime的作用是让MySQL中时间类型的值可以映射到Golang中的time.Time类型,loc的作用是设置time.Time的值的时区为当前系统时区,不使用这个参数的话保存到的数据库的就是UTC时间,会和北京时间差8个小时。 增删改查 sqlx扩展了DB和Tx,继承了它们原有的方法,并扩展了一些方法,这里主要看下这些扩展的方法。 增加 通用占位符的方式: insertResult := db.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Zhang San", "Beijing", time.Now(), time.Now()) lastInsertId, _ := insertResult.LastInsertId() log.Println("Insert Id is ", lastInsertId) 这个表的主键使用了自增的方式,可以通过返回值的LastInsertId方法获取。 命名参数的方式: insertPerson := &Person{ Name: "Li Si", City: "Shanghai", AddTime: time.Now(), UpdateTime: time.Now(), } insertPersonResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPerson) 命名参数的方式是sqlx扩展的,这个方式就是常说的ORM。这里需要注意给struct字段添加上db标签: type Person struct { Id int `db:"Id"` Name string `db:"Name"` City string `db:"City"` AddTime time.Time `db:"AddTime"` UpdateTime time.Time `db:"UpdateTime"` } struct中的字段名称不必和数据库字段相同,只需要通过db标签映射正确就行。注意SQL语句中使用的命名参数需要是db标签中的名字。 除了可以映射struct,sqlx还支持map,请看下面这个示例: insertMap := map[string]interface{}{ "n": "Wang Wu", "c": "HongKong", "a": time.Now(), "u": time.Now(), } insertMapResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:n, :c, :a, :u)", insertMap) 再来看看批增加的方式: insertPersonArray := []Person{ {Name: "BOSIMA", City: "Wu Han", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOSSMA", City: "Xi An", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOMA", City: "Cheng Du", AddTime: time.Now(), UpdateTime: time.Now()}, } insertPersonArrayResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPersonArray) if err != nil { log.Println(err) return } insertPersonArrayId, _ := insertPersonArrayResult.LastInsertId() log.Println("InsertPersonArray Id is ", insertPersonArrayId) 这里还是采用命名参数的方式,参数传递一个struct数组或者切片就可以了。这个执行结果中也可以获取到最后插入数据的自增Id,不过实测返回的是本次插入的第一条的Id,这个有点别扭,但是考虑到增加多条只获取一个Id的场景似乎没有,所以也不用多虑。 除了使用struct数组或切片,也可以使用map数组或切片,这里就不贴出来了,有兴趣的可以去看文末给出的Demo链接。 删除 删除也可以使用通用占位符和命名参数的方式,并且会返回本次执行受影响的行数,某些情况下可以使用这个数字判断SQL实际有没有执行成功。 deleteResult := db.MustExec("Delete from Person where Id=?", 1) log.Println(deleteResult.RowsAffected()) deleteMapResult, err := db.NamedExec("Delete from Person where Id=:Id", map[string]interface{}{"Id": 1}) if err != nil { log.Println(err) return } log.Println(deleteMapResult.RowsAffected()) 修改 Sqlx对修改的支持和删除差不多: updateResult := db.MustExec("Update Person set City=?, UpdateTime=? where Id=?", "Shanghai", time.Now(), 1) log.Println(updateResult.RowsAffected()) updateMapResult, err := db.NamedExec("Update Person set City=:City, UpdateTime=:UpdateTime where Id=:Id", map[string]interface{}{"City": "Chong Qing", "UpdateTime": time.Now(), "Id": 1}) if err != nil { log.Println(err) } log.Println(updateMapResult.RowsAffected()) 查询 Sqlx对查询的支持比较多。 使用Get方法查询一条: getPerson := &Person{} db.Get(getPerson, "select * from Person where Name=?", "Zhang San") 使用Select方法查询多条: selectPersons := []Person{} db.Select(&selectPersons, "select * from Person where Name=?", "Zhang San") 只查询部分字段: getId := new(int64) db.Get(getId, "select Id from Person where Name=?", "Zhang San") selectTowFieldSlice := []Person{} db.Select(&selectTowFieldSlice, "select Id,Name from Person where Name=?", "Zhang San") selectNameSlice := []string{} db.Select(&selectNameSlice, "select Name from Person where Name=?", "Zhang San") 从上可以看出如果只查询部分字段,还可以继续使用struct;特别的只查询一个字段时,使用基本数据类型就可以了。 除了这些高层次的抽象方法,Sqlx也对更低层次的查询方法进行了扩展: 查询单行: row = db.QueryRowx("select * from Person where Name=?", "Zhang San") if row.Err() == sql.ErrNoRows { log.Println("Not found Zhang San") } else { queryPerson := &Person{} err = row.StructScan(queryPerson) if err != nil { log.Println(err) return } log.Println("QueryRowx-StructScan:", queryPerson.City) } 查询多行: rows, err := db.Queryx("select * from Person where Name=?", "Zhang San") if err != nil { log.Println(err) return } for rows.Next() { rowSlice, err := rows.SliceScan() if err != nil { log.Println(err) return } log.Println("Queryx-SliceScan:", string(rowSlice[2].([]byte))) } 命名参数Query: rows, err = db.NamedQuery("select * from Person where Name=:n", map[string]interface{}{"n": "Zhang San"}) 查询出数据行后,这里有多种映射方法:StructScan、SliceScan和MapScan,分别对应映射后的不同数据结构。 预处理语句 对于重复使用的SQL语句,可以采用预处理的方式,减少SQL解析的次数,减少网络通信量,从而提高SQL操作的吞吐量。 下面的代码展示了sqlx中如何使用stmt查询数据,分别采用了命名参数和通用占位符两种传参方式。 bosima := Person{} bossma := Person{} nstmt, err := db.PrepareNamed("SELECT * FROM Person WHERE Name = :n") if err != nil { log.Println(err) return } err = nstmt.Get(&bossma, map[string]interface{}{"n": "BOSSMA"}) if err != nil { log.Println(err) return } log.Println("NamedStmt-Get1:", bossma.City) err = nstmt.Get(&bosima, map[string]interface{}{"n": "BOSIMA"}) if err != nil { log.Println(err) return } log.Println("NamedStmt-Get2:", bosima.City) stmt, err := db.Preparex("SELECT * FROM Person WHERE Name=?") if err != nil { log.Println(err) return } err = stmt.Get(&bosima, "BOSIMA") if err != nil { log.Println(err) return } log.Println("Stmt-Get1:", bosima.City) err = stmt.Get(&bossma, "BOSSMA") if err != nil { log.Println(err) return } log.Println("Stmt-Get2:", bossma.City) 对于上文增删改查的方法,sqlx都有相应的扩展方法。与上文不同的是,需要先使用SQL模版创建一个stmt实例,然后执行相关SQL操作时,不再需要传递SQL语句。 数据库事务 为了在事务中执行sqlx扩展的增删改查方法,sqlx必然也对数据库事务做一些必要的扩展支持。 tx, err = db.Beginx() if err != nil { log.Println(err) return } tx.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Zhang San", "Beijing", time.Now(), time.Now()) tx.MustExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES (?, ?, ?, ?)", "Li Si Hai", "Dong Bei", time.Now(), time.Now()) err = tx.Commit() if err != nil { log.Println(err) return } log.Println("tx-Beginx is successful") 上面这段代码就是一个简单的sqlx数据库事务示例,先通过db.Beginx开启事务,然后执行SQL语句,最后提交事务。 如果想要更改默认的数据库隔离级别,可以使用另一个扩展方法: tx, err = db.BeginTxx(context.Background(), &sql.TxOptions{Isolation: sql.LevelRepeatableRead}) sqlx干了什么 通过上边的实战,基本上就可以使用sqlx进行开发了。为了更好的使用sqlx,我们可以再了解下sqlx是怎么做到上边这些扩展的。 Go的标准库中没有提供任何具体数据库的驱动,只是通过database/sql库定义了操作数据库的通用接口。sqlx中也没有包含具体数据库的驱动,它只是封装了常用SQL的操作方法,让我们的SQL写起来更爽。 MustXXX sqlx提供两个几个MustXXX方法。 Must方法是为了简化错误处理而出现的,当开发者确定SQL操作不会返回错误的时候就可以使用Must方法,但是如果真的出现了未知错误的时候,这个方法内部会触发panic,开发者需要有一个兜底的方案来处理这个panic,比如使用recover。 这里是MustExec的源码: func MustExec(e Execer, query string, args ...interface{}) sql.Result { res, err := e.Exec(query, args...) if err != nil { panic(err) } return res } NamedXXX 对于需要传递SQL参数的方法, sqlx都扩展了命名参数的传参方式。这让我们可以在更高的抽象层次处理数据库操作,而不必关心数据库操作的细节。 这种方法的内部会解析我们的SQL语句,然后从传递的struct、map或者slice中提取命名参数对应的值,然后形成新的SQL语句和参数集合,再交给底层database/sql的方法去执行。 这里摘抄一些代码: func NamedExec(e Ext, query string, arg interface{}) (sql.Result, error) { q, args, err := bindNamedMapper(BindType(e.DriverName()), query, arg, mapperFor(e)) if err != nil { return nil, err } return e.Exec(q, args...) } NamedExec 内部调用了 bindNamedMapper,这个方法就是用于提取参数值的。其内部分别对Map、Slice和Struct有不同的处理。 func bindNamedMapper(bindType int, query string, arg interface{}, m *reflectx.Mapper) (string, []interface{}, error) { ... switch { case k == reflect.Map && t.Key().Kind() == reflect.String: ... return bindMap(bindType, query, m) case k == reflect.Array || k == reflect.Slice: return bindArray(bindType, query, arg, m) default: return bindStruct(bindType, query, arg, m) } } 以批量插入为例,我们的代码是这样写的: insertPersonArray := []Person{ {Name: "BOSIMA", City: "Wu Han", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOSSMA", City: "Xi An", AddTime: time.Now(), UpdateTime: time.Now()}, {Name: "BOMA", City: "Cheng Du", AddTime: time.Now(), UpdateTime: time.Now()}, } insertPersonArrayResult, err := db.NamedExec("INSERT INTO Person (Name, City, AddTime, UpdateTime) VALUES(:Name, :City, :AddTime, :UpdateTime)", insertPersonArray) 经过bindNamedMapper处理后SQL语句和参数是这样的: 这里使用了反射,有些人可能会担心性能的问题,对于这个问题的常见处理方式就是缓存起来,sqlx也是这样做的。 XXXScan 这些Scan方法让数据行到对象的映射更为方便,sqlx提供了StructScan、SliceScan和MapScan,看名字就可以知道它们映射的数据结构。而且在这些映射能力的基础上,sqlx提供了更为抽象的Get和Select方法。 这些Scan内部还是调用了database/sql的Row.Scan方法。 以StructScan为例,其使用方法为: queryPerson := &Person{} err = row.StructScan(queryPerson) 经过sqlx处理后,调用Row.Scan的参数是: 以上就是本文的主要内容,如有错漏,欢迎指正。 老规矩,Demo程序已经上传到Github,欢迎访问:https://github.com/bosima/go-demo/tree/main/sqlx-mysql 收获更多架构知识,请关注微信公众号 萤火架构。原创内容,转载请注明出处。
优秀的个人博客,低调大师

图解MongoDB集群部署原理(3)

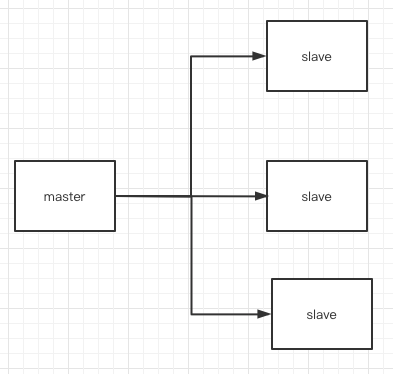
MongoDB的集群部署方案中有三类角色:实际数据存储结点、配置文件存储结点和路由接入结点。 连接的客户端直接与路由结点相连,从配置结点上查询数据,根据查询结果到实际的存储结点上查询和存储数据。MongoDB的部署方案有单机部署、复本集(主备)部署、分片部署、复本集与分片混合部署。 混合的部署方式如图: 混合部署方式下向MongoDB写数据的流程如图: 混合部署方式下读MongoDB里的数据流程如图: 对于副本集,又有主和从两种角色,写数据和读数据也是不同,写数据的过程是只写到主结点中,由主结点以异步的方式同步到从结点中: 而读数据则只要从任一结点中读取,具体到哪个结点读取是可以指定的: 对于MongoDB的分片,假设我们以某一索引键(ID)为片键,ID的区间[0,50],划分成5个chunk,分别存储到3个片服务器中,如图所示: 假如数据量很大,需要增加片服务器时可以只要移动chunk来均分数据即可。 配置结点: 存储配置文件的服务器其实存储的是片键与chunk以及chunk与server的映射关系,用上面的数据表示的配置结点存储的数据模型如下表: Map1 Key range chunk [0,10) chunk1 [10,20) chunk2 [20,30) chunk3 [30,40) chunk4 [40,50) chunk5 Map2 chunk shard chunk1 shard1 chunk2 shard1 chunk3 shard2 chunk4 shard2 chunk5 shard3 路由结点: 路由角色的结点在分片的情况下起到负载均衡的作用。 关注微信公众号『 Tom弹架构 』回复“MongoDB”可获取配套资料。 本文为“Tom弹架构”原创,转载请注明出处。技术在于分享,我分享我快乐! 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。关注微信公众号『 Tom弹架构 』可获取更多技术干货! 原创不易,坚持很酷,都看到这里了,小伙伴记得点赞、收藏、在看,一键三连加关注!如果你觉得内容太干,可以分享转发给朋友滋润滋润!

优秀的个人博客,低调大师

全网最全-混合精度训练原理

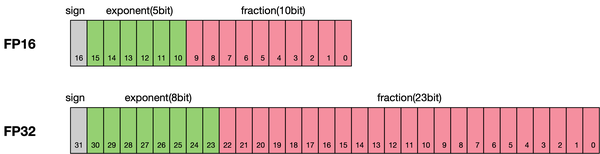
通常我们训练神经网络模型的时候默认使用的数据类型为单精度FP32。近年来,为了加快训练时间、减少网络训练时候所占用的内存,并且保存训练出来的模型精度持平的条件下,业界提出越来越多的混合精度训练的方法。这里的混合精度训练是指在训练的过程中,同时使用单精度(FP32)和半精度(FP16)。 1、浮点数据类型 浮点数据类型主要分为双精度(Fp64)、单精度(Fp32)、半精度(FP16)。在神经网络模型的训练过程中,一般默认采用单精度(FP32)浮点数据类型,来表示网络模型权重和其他参数。在了解混合精度训练之前,这里简单了解浮点数据类型。 根据IEEE二进制浮点数算术标准(IEEE 754)的定义,浮点数据类型分为双精度(Fp64)、单精度(Fp32)、半精度(FP16)三种,其中每一种都有三个不同的位来表示。FP64表示采用8个字节共64位,来进行的编码存储的一种数据类型;同理,FP32表示采用4个字节共32位来表示;FP16则是采用2字节共16位来表示。如图所示: 从图中可以看出,与FP32相比,FP16的存储空间是FP32的一半,FP32则是FP16的一半。主要分为三个部分: 最高位表示符号位sign bit。 中间表示指数位exponent bit。 低位表示分数位fraction bit。 以FP16为例子,第一位符号位sign表示正负符号,接着5位表示指数exponent,最后10位表示分数fraction。公式为: 同理,一个规则化的FP32的真值为: 一个规格化的FP64的真值为: FP16可以表示的最大值为 0 11110 1111111111,计算方法为: FP16可以表示的最小值为 0 00001 0000000000,计算方法为: 因此FP16的最大取值范围是[-65504 - 66504],能表示的精度范围是 2^{-24} ,超过这个数值的数字会被直接置0。 2、使用FP16训练问题 首先来看看为什么需要混合精度。使用FP16训练神经网络,相对比使用FP32带来的优点有: 减少内存占用 :FP16的位宽是FP32的一半,因此权重等参数所占用的内存也是原来的一半,节省下来的内存可以放更大的网络模型或者使用更多的数据进行训练。 加快通讯效率 :针对分布式训练,特别是在大模型训练的过程中,通讯的开销制约了网络模型训练的整体性能,通讯的位宽少了意味着可以提升通讯性能,减少等待时间,加快数据的流通。 计算效率更高 :在特殊的AI加速芯片如华为Ascend 910和310系列,或者NVIDIA VOTAL架构的Titan V and Tesla V100的GPU上,使用FP16的执行运算性能比FP32更加快。 但是使用FP16同样会带来一些问题,其中最重要的是1)精度溢出和2)舍入误差。 数据溢出: 数据溢出比较好理解,FP16的有效数据表示范围为 6.10\times10^{-5}\sim 65504 ,FP32的有效数据表示范围为 1.4\times10^{-45} ~ 1.7\times10^{38} 。可见FP16相比FP32的有效范围要窄很多,使用FP16替换FP32会出现上溢(Overflow)和下溢(Underflow)的情况。而在深度学习中,需要计算网络模型中权重的梯度(一阶导数),因此梯度会比权重值更加小,往往容易出现下溢情况。 舍入误差: Rounding Error指示是当网络模型的反向梯度很小,一般FP32能够表示,但是转换到FP16会小于当前区间内的最小间隔,会导致数据溢出。如0.00006666666在FP32中能正常表示,转换到FP16后会表示成为0.000067,不满足FP16最小间隔的数会强制舍入。 3、混合精度相关技术 为了想让深度学习训练可以使用FP16的好处,又要避免精度溢出和舍入误差。于是可以通过FP16和FP32的混合精度训练(Mixed-Precision),混合精度训练过程中可以引入权重备份(Weight Backup)、损失放大(Loss Scaling)、精度累加(Precision Accumulated)三种相关的技术。 3.1、权重备份(Weight Backup) 权重备份主要用于解决舍入误差的问题。其主要思路是把神经网络训练过程中产生的激活activations、梯度 gradients、中间变量等数据,在训练中都利用FP16来存储,同时复制一份FP32的权重参数weights,用于训练时候的更新。具体如下图所示。 从图中可以了解,在计算过程中所产生的权重weights,激活activations,梯度gradients等均使用 FP16 来进行存储和计算,其中权重使用FP32额外进行备份。由于在更新权重公式为: 深度模型中,lr x gradent的参数值可能会非常小,利用FP16来进行相加的话,则很可能会出现舍入误差问题,导致更新无效。因此通过将权重weights拷贝成FP32格式,并且确保整个更新过程是在 fp32 格式下进行的。即: 权重用FP32格式备份一次,那岂不是使得内存占用反而更高了呢?是的,额外拷贝一份weight的确增加了训练时候内存的占用。 但是实际上,在训练过程中内存中分为动态内存和静态内容,其中动态内存是静态内存的3-4倍,主要是中间变量值和激活activations的值。而这里备份的权重增加的主要是静态内存。只要动态内存的值基本都是使用FP16来进行存储,则最终模型与整网使用FP32进行训练相比起来, 内存占用也基本能够减半。 3.2、损失缩放(Loss Scaling) 如图所示,如果仅仅使用FP32训练,模型收敛得比较好,但是如果用了混合精度训练,会存在网络模型无法收敛的情况。原因是梯度的值太小,使用FP16表示会造成了数据下溢出(Underflow)的问题,导致模型不收敛,如图中灰色的部分。于是需要引入损失缩放(Loss Scaling)技术。 下面是在网络模型训练阶段, 某一层的激活函数梯度分布式中,其中有68%的网络模型激活参数位0,另外有4%的精度在2^-32~2^-20这个区间内,直接使用FP16对这里面的数据进行表示,会截断下溢的数据,所有的梯度值都会变为0。 为了解决梯度过小数据下溢的问题,对前向计算出来的Loss值进行放大操作,也就是把FP32的参数乘以某一个因子系数后,把可能溢出的小数位数据往前移,平移到FP16能表示的数据范围内。根据链式求导法则,放大Loss后会作用在反向传播的每一层梯度,这样比在每一层梯度上进行放大更加高效。 损失放大是需要结合混合精度实现的,其主要的主要思路是: Scale up阶段 ,网络模型前向计算后在反响传播前,将得到的损失变化值DLoss增大2^K倍。 Scale down阶段 ,反向传播后,将权重梯度缩2^K倍,恢复FP32值进行存储。 动态损失缩放(Dynamic Loss Scaling): 上面提到的损失缩放都是使用一个默认值对损失值进行缩放,为了充分利用FP16的动态范围,可以更好地缓解舍入误差,尽量使用比较大的放大倍数。总结动态损失缩放算法,就是每当梯度溢出时候减少损失缩放规模,并且间歇性地尝试增加损失规模,从而实现在不引起溢出的情况下使用最高损失缩放因子,更好地恢复精度。 动态损失缩放的算法如下: 动态损失缩放的算法会从比较高的缩放因子开始(如2^24),然后开始进行训练迭代中检查数是否会溢出(Infs/Nans); 如果没有梯度溢出,则不进行缩放,继续进行迭代;如果检测到梯度溢出,则缩放因子会减半,重新确认梯度更新情况,直到数不产生溢出的范围内; 在训练的后期,loss已经趋近收敛稳定,梯度更新的幅度往往小了,这个时候可以允许更高的损失缩放因子来再次防止数据下溢。 因此,动态损失缩放算法会尝试在每N(N=2000)次迭代将损失缩放增加F倍数,然后执行步骤2检查是否溢出。 3.3、精度累加(Precision Accumulated) 在混合精度的模型训练过程中,使用FP16进行矩阵乘法运算,利用FP32来进行矩阵乘法中间的累加(accumulated),然后再将FP32的值转化为FP16进行存储。简单而言,就是利用FP16进行矩阵相乘,利用FP32来进行加法计算弥补丢失的精度。 这样可以有效减少计算过程中的舍入误差,尽量减缓精度损失的问题。 例如在Nvidia Volta 结构中带有Tensor Core,可以利用FP16混合精度来进行加速,还能保持精度。Tensor Core主要用于实现FP16的矩阵相乘,在利用FP16或者FP32进行累加和存储。在累加阶段能够使用FP32大幅减少混合精度训练的精度损失。 4、混合精度训练策略(Automatic Mixed Precision,AMP) 混合精度训练有很多有意思的地方,不仅仅是在深度学习,另外在HPC的迭代计算场景下,从迭代的开始、迭代中期和迭代后期,都可以使用不同的混合精度策略来提升训练性能的同时保证计算的精度。以动态的混合精度达到计算和内存的最高效率比也是一个较为前言的研究方向。 以NVIDIA的APEX混合精度库为例,里面提供了4种策略,分别是默认使用FP32进行训练的O0,只优化前向计算部分O1、除梯度更新部分以外都使用混合精度的O2和使用FP16进行训练的O3。具体如图所示。 这里面比较有意思的是O1和O2策略。 O1策略中,会根据实际Tensor和Ops之间的关系建立黑白名单来使用FP16。例如GEMM和CNN卷积操作对于FP16操作特别友好的计算,会把输入的数据和权重转换成FP16进行运算,而softmax、batchnorm等标量和向量在FP32操作好的计算,则是继续使用FP32进行运算,另外还提供了动态损失缩放(dynamic loss scaling)。 而O2策略中,模型权重参数会转化为FP16,输入的网络模型参数也转换为FP16,Batchnorms使用FP32,另外模型权重文件复制一份FP32用于跟优化器更新梯度保持一致都是FP32,另外还提供动态损失缩放(dynamic loss scaling)。使用了权重备份来减少舍入误差和使用损失缩放来避免数据溢出。 当然上面提供的策略是跟硬件有关系,并不是所有的AI加速芯片都使用,这时候针对自研的AI芯片,需要找到适合得到混合精度策略。 5、实验结果 从下图的Accuracy结果可以看到,混合精度基本没有精度损失: Loss scale的效果: 题外话,前不久去X公司跟X总监聊下一代AI芯片架构的时候,他认为下一代芯片可以不需要加入INT8数据类型,因为Transformer结构目前有大一统NLP和CV等领域的趋势,从设计、流片到量产,2年后预计Transformer会取代CNN成为最流行的架构。我倒是不同意这个观点,目前来看神经网络的4个主要的结构MLP、CNN、RNN、Transformer都有其对应的使用场景,并没有因为某一种结构的出现而推翻以前的结构。只能说根据使用场景的侧重点比例有所不同,我理解Int8、fp16、fp32的数据类型在AI芯片中仍然会长期存在,针对不同的应用场景和计算单元会有不同的比例。 参考文献: Micikevicius, Paulius, et al. "Mixed precision training." arXiv preprint arXiv:1710.03740 (2017). Ott, Myle, et al. "Scaling neural machine translation." arXiv preprint arXiv:1806.00187 (2018). https://en.wikipedia.org/wiki/Half-precision_floating-point_format apex.amp - Apex 0.1.0 documentation . Automatic Mixed Precision for Deep Learning . Training With Mixed Precision . Dreaming.O:浅谈混合精度训练 .

优秀的个人博客,低调大师

深入了解 ConcurrentHashMap 底层原理

在上一篇文章[【简单了解系列】从基础的使用来深挖HashMap](https://mp.weixin.qq.com/s/-ZE8eA-2CFYsgwRbwjEVnw)里,我从最基础的使用中介绍了HashMap,大致是JDK1.7和1.8中底层实现的变化,和介绍了为什么在多线程下可能会造成死循环,扩容机智是什么样的。感兴趣的可以先看看。 我们知道,HashMap是非线程安全的容器,那么为什么ConcurrentHashMap能够做到线程安全呢? # 底层结构 首先看一下ConcurrentHashMap的底层数据结构,在Java8中,其底层的实现方式与HashMap一样的,同样是数组、链表再加红黑树,具体的可以参考上面的HashMap的文章,下面所有的讨论都是基于Java 1.8。 ```java transient volatile Node [] table; ``` ## volatile关键字 对比HashMap的底层结构可以发现,table的定义中多了一个**volatile**关键字。这个关键字是做什么的呢?我们知道所有的共享变量都存在**主内存**中,就像table。 而线程对变量的所有操作都必须在线程自己的**工作内存**中完成,而不能直接读取主存中的变量,这是JMM的规定。所以每个线程都会有自己的工作内存,工作内存中存放了共享变量的副本。而正是因为这样,才造成了可见性的问题。 ABCD四个线程同时在操作一个共享变量X,此时如果A从主存中读取了X,改变了值,并且写回了内存。那么BCD线程所得到的X副本就已经失效了。此时如果没有被**volatile**修饰,那么BCD线程是不知道自己的变量副本已经失效了。继续使用这个变量就会造成**数据不一致**的问题。 ## 内存可见性 而如果加上了volatile关键字,BCD线程就会立马看到最新的值,这就是**内存可见性**。你可能想问,凭什么加了volatile的关键字就可以保证共享变量的内存可见性? 那是因为如果变量被volatile修饰,在线程进行**写操作**时,会直接将新的值写入到主存中,而不是线程的工作内存中;而在**读操作**时,会直接从主存中读取,而不是线程的工作内存。 # 基础使用 首先这个使用与HashMap没有任何区别,只是实现改成了ConcurrentHashMap。 ```java Map map = new ConcurrentHashMap<>(); map.put("微信搜索", "SH的全栈笔记"); map.get("微信搜索"); // SH的全栈笔记 ``` ## 取值 首先我们来看一下get方法的使用,源码如下。 ```java public V get(Object key) { Node [] tab; Node e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } ``` 大概解释一下这个过程发生了什么,首先根据key计算出哈希值,如果找到了就直接返回值。如果是红黑树的话,就在红黑树中查找值,否则就按照链表的查找方式查找。 这与HashMap也差不多的,元素会首先以链表的方式进行存储,如果该桶中的元素数量大于`TREEIFY_THRESHOLD`的值,就会触发树化。将当前的链表转换为红黑树。因为如果数量太多的话,链表的查询效率就会变得非常低,时间复杂度为O(n),而红黑树的查询时间复杂度则为O(logn),这个阈值在Java 1.8中的默认值为8,定义如下。 ```java static final int TREEIFY_THRESHOLD = 8; ``` ## 赋值 `put`的源码就不放出来了,放在这大家估计也不会一行一行的去看。所以我就简单的解释一下put的过程发生了什么事,并贴上关键代码就好了。 整个过程,除开并发的一些细节,大致的流程和1.8中的HashMap是差不多的。 - 首先会根据传入的key计算出hashcode,如果是第一次被赋值,那自然需要进行初始化table - 如果这个key没有存在过,直接用CAS在当前槽位的头节点创建一个Node,会用自旋来保证成功 - 如果当前的Node的hashcode是否等于-1,如果是则证明有其它的线程正在执行扩容操作,当前线程就加入到扩容的操作中去 - 且如果该槽位(也就是桶)上的数据结构如果是链表,则按照链表的插入方式,直接接在当前的链表的后面。如果数量大于了树化的阈值就会转为红黑树。 - 如果这个key存在,就会直接覆盖。 - 判断是否需要扩容 看到这你可能会有一堆的疑问。 > 例如在多线程的情况下,几个线程同时来执行put操作时,怎么保证只执行一次初始化,或者怎么保证只执行一次扩容呢?万一我已经写入了数据,另一个线程又初始化了一遍,岂不是造成了数据不一致的问题。同样是多线程的情况下, 怎么保证put值的时候不会被其他线程覆盖。CAS又是什么? 接下来我们就来看一下在多线程的情况下,`ConcurrentHashMap`是如何保证线程安全的。 # 初始化的线程安全 首先我们来看初始化的源码。 ```java private final Node [] initTable() { Node [] tab; int sc; while ((tab = table) == null || tab.length == 0) { if ((sc = sizeCtl) < 0) Thread.yield(); // lost initialization race; just spin else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) { try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; @SuppressWarnings("unchecked") Node [] nt = (Node [])new Node[n]; table = tab = nt; sc = n - (n >>> 2); } } finally { sizeCtl = sc; } break; } } return tab; } ``` 可以看到有一个关键的变量,`sizeCtl`,其定义如下。 ```java private transient volatile int sizeCtl; ``` sizeCtl使用了关键字`volatile`修饰,说明这是一个多线程的共享变量,可以看到如果是首次初始化,第一个判断条件`if ((sc = sizeCtl) < 0)`是不会满足的,正常初始化的话sizeCtl的值为0,初始化设定了size的话sizeCtl的值会等于传入的size,而这两个值始终是大于0的。 ## CAS 然后就会进入下面的`U.compareAndSwapInt(this, SIZECTL, sc, -1)`方法,这就是上面提到的**CAS**,Compare and Swap(Set),比较并交换,Unsafe是位于`sun.misc`下的一个类,在Java底层用的比较多,它让Java拥有了类似C语言一样直接操作内存空间的能力。 例如可以操作内存、CAS、内存屏障、线程调度等等,但是如果Unsafe类不能被正确使用,就会使程序变的不安全,所以不建议程序直接使用它。 `compareAndSwapInt`的四个参数分别是,实例、偏移地址、预期值、新值。偏移地址可以快速帮我们在实例中定位到我们要修改的字段,此例中便是`sizeCtl`。如果内存当中的sizeCtl是传入的预期值,则将其更新为新的值。这个Unsafe类的方法可以保证这个操作的**原子性**。当你在使用parallelStream进行并发的foreach遍历时,如果涉及到修改一个整型的共享变量时,你肯定不能直接用i++,因为在多线程下,i++每次操作不能保证原子性。所以你可能会用到如下的方式。 ```java AtomicInteger num = new AtomicInteger(); arr.parallelStream().forEach(item -> num.getAndIncrement()); ``` 你可能会好奇,为什么使用了`AtomicInteger`就可以保证原子性,跟Unsafe类和CAS又有什么关系,让我们接着往下,看`getAndIncrement`方法的底层实现。 ```java public final int getAndIncrement() { return unsafe.getAndAddInt(this, valueOffset, 1); } ``` 可以看到,底层调用的是Unsafe类的方法,这不就联系上了吗,而`getAndIncrement`的实现又长这样。 ```java public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); return var5; } ``` 没错,这里底层调用了`compareAndSwapInt`方法。可以看到这里加了while,如果该方法返回false就一直循环,直到成功为止。这个过程有个牛批的名字,叫**自旋**。特别高端啊,说人话就是无限循环。 什么情况会返回false呢?那就是`var5`变量存储的值,和现在内存中实际`var5`的值**不同**,说明这个变量已经被其他线程修改过了,此时通过自旋来重新获取,直到成功为止,然后自旋结束。 ## 结论 聊的稍微有点多,这小节的问题是如何保证不重复初始化。那就是执行首次扩容时,会将变量`sizeCtl`设置为`-1`,因为其被`volatile`修饰,所以其值的修改对其他线程可见。 其它线程再调用初始化时,就会发现`sizeCtl`的值为`-1`,说明已经有线程正在执行初始化的操作了,就会执行`Thread.yield()`,然后退出。 `yield`相信大家都不陌生,和`sleep`不同,`sleep`可以让线程进入阻塞状态,且可以指定阻塞的时间,同时释放CPU资源。而`yield`不会让线程进入阻塞状态,而且也不能指定时间,它让线程重新进入可执行状态,让出CPU调度,让CPU资源被同优先级或者高优先级的线程使用,稍后再进行尝试,这个时间依赖于当前CPU的时间片划分。 # 如何保证值不被覆盖 我们在上一节举了在并发下i++的例子,说在并发下i++并不是一个具有**原子性**的操作,假设此时`i=1`,线程A和线程B同时取了i的值,同时+1,然后此时又同时的写回。那么此时`i++`的值会是2而不是3,在并发下`1+1+1=2`是可能出现的。 让我们来看一下`ConcurrentHashMap`在目标key已经存在时的赋值操作,因为如果不存在会直接调用Unsafe的方法创建一个Node,所以后续的线程就会进入到下面的逻辑中来,由于太长,我省略了一些代码。 ```java ...... V oldVal = null; synchronized (f) { if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1; for (Node e = f;; ++binCount) { ...... } } else if (f instanceof TreeBin) { Node p; binCount = 2; if ((p = ((TreeBin )f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } ``` 上述代码在赋值的逻辑外层包了一个`synchronized`,这个有什么用呢? ## synchronized关键字 这个地方也可以换一个方式来理解,那就是`synchronized`如何保证线程安全的。线程安全,我认为更多的是描述一种**风险**。在堆内存中的数据由于可以被任何线程访问到,在没有任何限制的情况下存在被意外修改的风险。 而`synchronized`是通过对共享资源加锁的方式,使同一时间只能有一个线程能够访问到临界区(也就是共享资源),共享资源包括了方法、锁代码块和对象。 那是不是使用了`synchronized`就一定能保证线程安全呢?不是的,如果不能正确的使用,很可能就会引发死锁,所以,保证线程安全的前提是**正确的使用**`synchronized`。 # 自动扩容的线程安全 除了初始化、并发的写入值,还有一个问题值得关注,那就是在多线程下,`ConcurrentHashMap`是如何保证自动扩容是线程安全的。 扩容的关键方案是`transfer`,但是由于代码太多了,贴在这个地方可能会影响大家的理解,感兴趣的可以自己的看一下。 还是大概说一下自动扩容的过程,我们以一个线程来举例子。在`putVal`的最后一步,会调用`addCount`方法,然后在方法里判读是否需要扩容,如果容量超过了`实际容量 * 负载因子`(也就是sizeCtl的值)就会调用`transfer`方法。 ## 计算分区的范围 因为`ConcurrentHashMap`是支持多线程同时扩容的,所以为了避免每个线程处理的数量不均匀,也为了提高效率,其对当前的所有桶按数量(也就是上面提到的槽位)进行分区,每个线程只处理自己分到的区域内的桶的数据即可。 当前线程计算当前stride的代码如下。 ```java stride = (NCPU > 1) ? (n >>> 3) / NCPU : n); ``` 如果计算出来的值小于设定的最小范围,也就是`private static final int MIN_TRANSFER_STRIDE = 16;`,就把当前分区范围设置为16。 ## 初始化nextTable `nextTable`也是一个共享变量,定义如下,用于存放在正在扩容之后的`ConcurrentHashMap`的数据,当且仅当正在**扩容**时才不为空。 ```java private transient volatile Node [] nextTable; ``` 如果当前transfer方法传入的nextTab(这是个局部变量,比上面提到的nextTable少了几个字母,不要搞混了)是null,说明是当前线程是第一个调用扩容操作的线程,就需要初始化一个size为原来容量2被的nextTable,核心代码如下。 ```java Node [] nt = (Node [])new Node[n << 1]; // 可以看到传入的初始化容量是n << 1。 ``` 初始化成功之后就更新**共享变量**`nextTable`的值,并设置`transferIndex`的值为扩容前的length,这也是一个共享的变量,表示扩容使还未处理的桶的下标。 ## 设置分区边界 一个新的线程加入扩容操作,在完成上述步骤后,就会开始从现在正在扩容的Map中找到自己的分区。例如,如果是第一个线程,那么其取到的分区就会如下。 ```java start = nextIndex - 1; end = nextIndex > stride ? nextIndex - stride : 0; // 实际上就是当还有足够的桶可以分的时候,线程分到的分区为 [n-stride, n - 1] ``` 可以看到,分区是从尾到首进行的。而如果是首次进入的线程,`nextIndex` 的值会被初始化为共享变量`transferIndex` 的值。 ## Copy分区内的值 当前线程在自己划分到的分区内开始遍历,如果当前桶是null,那么就生成一个 `ForwardingNode`,代码如下。 ```java ForwardingNode fwd = new ForwardingNode (nextTab); ``` 并把当前槽位赋值为fwd,你可以把`ForwardingNode`理解为一个标志位,如果有线程遍历到了这个桶, 发现已经是`ForwardingNode`了,就代表这个桶已经被处理过了,就会跳过这个桶。 如果这个桶没有被处理过,就会开始给当前的桶加锁,我们知道`ConcurrentHashMap`会在多线程的场景下使用,所以当有线程正在扩容的时候,可能还会有线程正在执行put操作,所以如果当前Map正在执行扩容操作,如果此时再写入数据,很可能会造成的数据丢失,所以要对桶进行加锁。 # 总结 对比在1.7中采用的`Segment`分段锁的臃肿设计,1.8中直接使用了`CAS`和`Synchronized`来保证并发下的线程安全。总的来说,在1.8中,ConcurrentHashMap和HashMap的底层实现都差不多,都是数组、链表和红黑树的方式。其主要区别就在于应用场景,非并发的情况可以使用HashMap,而如果要处理并发的情况,就需要使用ConcurrentHashMap。关于ConcurrentHashMap就先聊到这里。 > 好了以上就是本篇博客的全部内容了,欢迎微信搜索关注【**SH的全栈笔记**】,回复【**队列**】获取MQ学习资料,包含基础概念解析和RocketMQ详细的源码解析,持续更新中。 > > > > 如果你觉得这篇文章对你有帮助,还麻烦**点个赞**,**关个注**,**分个享**,**留个言**。 ![](https://tva1.sinaimg.cn/large/008eGmZEgy1go0v5rrqp4j31eg0hcwhm.jpg)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册