首页 文章 精选 留言 我的

精选列表

搜索[智能推荐],共10000篇文章
优秀的个人博客,低调大师

推荐个开源在线文档,助道友领悟 Django 之“道”

本文面向有手(需要一点点 Python Django 基础)的小伙伴,急需文档管理者食用最佳。 作者:HelloGitHub-吱吱(首发于 HelloGitHub 公众号) 嗷嗷待哺的小白:“今天又是沉迷花里胡哨博客的一天,我希望归档一类知识或者是连载一些教程,而博客都是一篇篇散落的,没有连贯性,阅读体验不太良好,怎么办呢?” HelloGitHub:“那你可是问对人了,这期 《讲解开源项目》 系列的新项目:MrDoc 觅道文档,将会解决你的烦恼。” 小白:“这又是什么神奇的开源工具。” HelloGitHub:“这是一个基于 Django 开发的在线文档系统,适合作为个人和小型团队的私有云文档、云笔记和知识管理工具。你看它界面简洁,功能俱全,部署简单。话不多说,直接开始实践检验真理!” 一、简单测试 HelloGitHub:“嘿嘿,先别着急,我们先在本地平台运行,测试测试功能,了解这个项目的基本使用,再一步步往前走。” 仅需 6 步你就可以从零运行起来这个项目! 1、我们本地的实验环境是: Windows 10 64 位操作系统 Python 3.7,pip 21.0.1 2、我们需要将开源项目克隆到本地,使用如下命令: git clone https://github.com/zmister2016/MrDoc 3、为 MrDoc 安装好所需的第三方库:进入 Mrdoc/ 目录,运行如下命令: 4、初始化数据库,该项目默认使用 sqlite 数据库。在命令行下执行: 5、创建管理员账户,来管理整个 MrDoc 应用。注意用户名和电子邮箱地址在整个 MrDoc 应用中是唯一的。 6、本地上线测试:在测试环境中,可以使用 Django 自带的服务器运行 MrDoc。 二、食用说明 小白搓搓手,期待:“我也在本地测试成功了,是不是可以探索一番里面的彩蛋呢?” HelloGitHub:“好嘞,项目主打的关键字就是:个人团队协作和文档管理,让我现在来给你展现一下五脏俱全的 MrDoc。” 2.1 注册登录 HelloGitHub:“当我们访问网站的时候,以游客身份进行的。假如我们需要注册一个普通用户的帐号,则需要填写相应的表单信息,注册完毕后会自动跳转到已登录界面。” 小白:“补充:其实如果游客想点击 新建 → 新建文档,也是需要登录操作的哟。” 2.2 文集文档 HelloGitHub:“当我们登录以后,可以在 新建 → 新建文集 中创建一个文集。” 小白:“我发现了,可以点击首页的文集,进入到文集的浏览阅读页面,还可以用 添加 新建一个文档。在进入文档编辑器页面,我们可以 点击文档树 选择当前文档对应的上级或者 取消上级,以及通过输入 文档排序值,来给不同文档排序。” HelloGitHub:“嗯呐,现在我们就不用担心教程学习类的文章不连续啦,因为他们都有层次顺序的分布在我们的文集中。不过因为目前 MrDoc 最多支持 3 级的文档,可别让自己的文档树太大鸭。” HelloGitHub:“非常重要的一点是团队的共享和协作。我们普通用户可以对自己的文集进行管理,点击 个人中心 → 我的文集 → 文集管理 → 文集成员 处的 协作管理 小图标,可以添加协作人。而且在 文集管理 → 操作 → 文集设置 小图标可以修改 基础信息、权限配置 和 管理控制。当权限设置为公开时,则当以游客身份访问网页的时候能够看到该文集;当权限设置为私密,则只有自己能看到。当然也可以给固定的人看,这也就能实现了小团队的共享。” 2.3 文档编辑 HelloGitHub:“现在我们把目光投向 MrDoc 的文档编辑和修改模块,它支持以 Markdown 和富文本两种方式进行文档编写,给我们提供了 3 种编辑器使用。它能支持插入数学公式、流程图、序列图、脑图、Echarts 图形图表和时间线,能够添加音视频链接和图片附件等,能够创建文档模板,总之是概括不完了,图也上不完了,需要在使用过程中慢慢的熟练。” 小白:“我现在也看得懂了,在 个人中心 → 我的文档 → 文档管理 中可以统一管理创建的所有文档,还可以看到 历史版本管理 信息呢,方便了用户进行对比,也方便了团队协作的管理。” 2.4 后台管理【管理员】 HelloGitHub:“大 boss 的权限必然是很高的,一切都收之眼底,包括用户的文集、文档、文档模块,还可以进行用户管理和站点设置。” 小白:“那我就做自己的主宰好了。” 三、上线部署 HelloGitHub:“已经了解了一些功能了,但是只在本地跑会不会太拉垮了,是不是得考虑将这个项目部署到我们的云服务器上,让自己的小团队实现高大上的知识协作管理呀。” 小白:“可以和组里的小伙伴多了一个摸鱼工具,想想就很开心~” HelloGitHub:“先部署好吧,谁知道过程中会出现一堆坑呢。为了比较顺利的进行,我们这次的方法就选用官方提供的比较完整的教程:使用 Nginx + uWSGI 部署 MrDoc。” 1、我们云主机的环境是: Ubuntu 18.04.4 LTS Python 3.6.9,pip 21.0.1 在 ~ 目录下进行,即用 pwd 命令查看为:/home/purple,小伙伴们改成自己对应的目录 2、安装 uWSGI 和 Nginx: sudo apt-get install uwsgi sudo apt install uwsgi-plugin-python3 sudo apt-get install nginx 3、将 MrDoc 的源码拉取至本地(用之前的命令),但是为了不对服务器上现存的环境造成影响,我们这次需要用到虚拟环境: 4、进入 MrDoc 文件夹,重复简单测试的 3、4、5 步骤,分别实现依赖库的安装、初始化数据库以及创建管理员账号(略)。 5、我们在 ~ 目录下新建一个名为 mrdoc_deploy 的文件夹,命令如下所示,用于存放部署的相关文件。 mkdir /home/purple/mrdoc_deploy (1) uWSGI 配置文件: 在 mrdoc_deploy 目录下新建一个名为 uwsgi_params 的文件,用 vim uwsgi_params 命令进行写入: uwsgi_param QUERY_STRING $query_string; uwsgi_param REQUEST_METHOD $request_method; uwsgi_param CONTENT_TYPE $content_type; uwsgi_param CONTENT_LENGTH $content_length; uwsgi_param REQUEST_URI $request_uri; uwsgi_param PATH_INFO $document_uri; uwsgi_param DOCUMENT_ROOT $document_root; uwsgi_param SERVER_PROTOCOL $server_protocol; uwsgi_param REQUEST_SCHEME $scheme; uwsgi_param HTTPS $https if_not_empty; uwsgi_param REMOTE_ADDR $remote_addr; uwsgi_param REMOTE_PORT $remote_port; uwsgi_param SERVER_PORT $server_port; uwsgi_param SERVER_NAME $server_name; 在 mrdoc_deploy 目录下新建一个名为 mrdoc_uwsgi.ini 的文件,同理用 vim mrdoc_uwsgi.ini 写入: [uwsgi] # Django-related settings socket = :8008 # the base directory (full path) chdir = /home/purple/MrDoc virtualenv = /home/purple/mrdoc_env # Django s wsgi file module = MrDoc.wsgi:application wsgi-file = MrDoc/wsgi.py # process-related settings # master master = true # maximum number of worker processes processes = 1 threads = 2 # ... with appropriate permissions - may be needed # chmod-socket = 664 # clear environment on exit plugins = python3 vacuum = true python-autoreload = 1 # buffer size buffer-size = 65536 注:如果后续运行服务的时候出现如下问题,则需要调整 mrdoc_uwsgi.ini 下的 buffer-size 参数。 spawned uWSGI master process (pid: 21172) spawned uWSGI worker 1 (pid: 21173, cores: 2) invalid request block size: 21573 (max 4096)...skip invalid request block size: 21573 (max 4096)...skip (2) Nginx 配置文件 在 mrdoc_deploy 目录下新建一个名为 mrdoc_nginx.conf 的文件,使用命令 vim mrdoc_nginx.conf 写入如下内容: server { listen 80; server_name 此处填入域名; charset UTF-8; access_log /var/log/nginx/mrdoc_access.log; error_log /var/log/nginx/mrdoc_error.log; client_max_body_size 75M; location / { include /home/purple/mrdoc_deploy/uwsgi_params; uwsgi_pass 127.0.0.1:8008; uwsgi_read_timeout 60; } location /static { expires 30d; autoindex on; add_header Cache-Control private; alias /home/purple/MrDoc/static; } location /media { alias /home/purple/MrDoc/media; } } 注意在 server_name 参数中,需要填入自己的域名。此处我填的是云主机的公网 IP 地址,之后访问网站则需要输入该 IP 地址。 (3) 为了能让 MrDoc 应用按我们的要求运行,使用 systemctl 工具来管理服务。 在 mrdoc_deploy 目录下新建一个名为 mrdoc.service 的文件,用命令 vim mrdoc.service 将如下内容写入文件: [Unit] Description = MrdocApp After = syslog.target [Install] WantedBy = multi-user.target [Service] WorkingDirectory = /home/purple/MrDoc ExecStart = /usr/bin/uwsgi --ini /home/purple/mrdoc_deploy/mrdoc_uwsgi.ini User = purple Restart = always StandardError = syslog~ 6、添加进程管理 sudo systemctl enable /home/zmister/mrdoc_deploy/mrdoc.service 7、创建 Nginx 站点软链接 sudo ln -s /home/zmister/mrdoc_deploy/mrdoc_nginx.conf /etc/nginx/sites-enabled/mrdoc_nginx.conf 8、启动 MrDoc 服务 sudo systemctl start mrdoc.service 注意:当试图启动的时候,出现如下报错。原因是:在配置 mrdoc.service 的时候 ExecStart 参数如果按照官方文档写的是 uwsgi,但实际上应该写成绝对路径(可以查看一下自己的路径),我的是 /usr/bin/uwsgi。 (mrdoc_env) purple@VM-Purplezi-Ubuntu ~ % sudo systemctl start mrdoc.service Failed to start mrdoc.service: Unit mrdoc.service is not loaded properly: Exec format error. See system logs and 'systemctl status mrdoc.service' for details. 四、最后的最后 小白:“课代表来了,一句话总结,只需要在部署的时候费点劲,之后就可以体验这个项目带给我们的方便快捷了,有手即可。” HelloGitHub:“在官方文档中,其实还有一些功能没有覆盖到,比如说作者还提供了 MrDoc 浏览器扩展,有空记得去看看哇。记得要第一时间关注我们,我们将会不间断正常运行为您带来有趣的开源项目分享。” 关注 HelloGitHub 公众号 第一时间收到更新。 还有更多开源项目的介绍和宝藏项目等待你的发现。

优秀的个人博客,低调大师

动态高并发时为什么推荐ReentrantLock而不是Synchronized?

前言碎语 Synchronized 和 ReentrantLock 大家应该都不陌生了,作为java中最常用的本地锁,最初版本中 ReentrantLock 的性能是远远强于 Synchronized 的,后续java在一次次的版本迭代中 对 Synchronized 进行了大量的优化,直到 jdk1.6 之后,两种锁的性能已经相差无几,甚至 Synchronized 的自动释放锁会更好用。 在面试时被问到 Synchronized 和 ReentrantLock 的使用选择时,很多朋友都脱口而出的说用 Synchronized ,甚至在我面试的时候问面试者,也很少有人能够答出所以然来,moon 想说,这可不一定,只对标题感兴趣的同学可以直接划到最后,我可不是标题党~ Synchronized使用 在 java 代码中 synchronized 的使用是非常简单的 1.直接贴在方法上 2.贴在代码块儿上 程序运行期间,Synchronized那一块儿代码发生么什么? 来看一张图 在多线程运行过程中,线程会去先抢对象的监视器,这个监视器是对象独有的,其实就相当于一把钥匙,抢到了,那你就获得了当前代码块儿的执行权。 其他没有抢到的线程会进入队列(SynchronizedQueue)当中等待,等待当前线程执行完后,释放锁. 最后当前线程执行完毕后通知出队然后继续重复当前过程. 从 jvm 的角度来看 monitorenter 和 monitorexit 指令代表着代码的执行与结束。 SynchronizedQueue: SynchronizedQueue 是一个比较特殊的队列,它没有存储功能,它的功能就是维护一组线程,其中每个插入操作必须等待另一个线程的移除操作,同样任何一个移除操作都等待另一个线程的插入操作。因此此队列内部其 实没有任何一个元素,或者说容量是0,严格说并不是一种容器。由于队列没有容量,因此不能调用 peek 操作,因为只有移除元素时才有元素。 举个例子: 喝酒的时候,先把酒倒入酒盅,然后再倒入酒杯,这就是正常的队列。 喝酒的时候,把酒直接倒入酒杯,这就是 SynchronizedQueue 。 这个例子应该很清晰易懂了,它的好处就是可以直接传递,省去了一个第三方传递的过程。 聊聊细节,锁升级的过程 在 jdk1.6 以前,Synchronized 是一个重量级锁,还是先贴一张图 这就是为什么说,Synchronized 是一个重量级锁的原因,因为每一次锁的资源都是直接和 cpu 去申请的,而 cpu 的锁数量是固定的,当 cpu 锁资源使用完后还会进行锁等待,这是一个非常耗时的操作。 但是在jdk1.6,针对代码层面进行了大量的优化,也就是我们常说的锁升级的过程。 这就是一个锁升级的过程,我们简单的说说: 无锁:对象一开始就是无锁状态。 偏向锁:相当于给对象贴了一个标签(将自己的线程 id 存入对象头中),下次我再进来时,发现标签是我的,我就可以继续使用了。 自旋锁:想象一下有一个厕所,里面有一个人在,你很想上但是只有一个坑位,所以你只能徘徊等待,等那个人出来以后,你就可以使用了。 这个自旋是使用 cas 来保证原子性的,关于 cas 我这里就不再赘述了。 重量级锁:直接向 cpu 去申请申请锁,其他的线程都进入队列中等待。 锁升级是什么时候发生的? 偏向锁:一个线程获取锁时会由无锁升级为偏向锁 自旋锁:当产生线程竞争时由偏向锁升级为自旋锁,想象一下 while(true) ; 重量级锁:当线程竞争到达一定数量或超过一定时间时,晋升为重量级锁 锁的信息是记录在哪里的? 这张图是对象头中 markword 的数据结构,锁的信息就是在这里存放的,很清楚的表明了锁在升级的时候锁信息的变动,其实就是通过二进制的数值,来对对象进行一个标记,每个数值代表一种状态。 既然synchronized有锁升级那么有锁降级吗? 这个问题和我们的题目就有很大的关联了。 在 HotSpot 虚拟机中是有锁降级的,但是仅仅只发生在 STW 的时候,只有垃圾回收线程能够观测到它,也就是说,在我们正常使用的过程中是不会发生锁降级的,只有在 GC 的时候才会降级。 所以题目的答案,你懂了吗?哈哈,我们接着往下走。 ReentrantLock的使用 ReentrantLock 的使用也是非常简单的,与 Synchronized 的不同就是需要自己去手动释放锁,为了保证一定释放,所以通常都是和 try~finally 配合使用的。 ReentrantLock的原理 ReentrantLock 意为可重入锁,说起 ReentrantLock 就不得不说 AQS ,因为其底层就是使用 AQS 去实现的。 ReentrantLock有两种模式,一种是公平锁,一种是非公平锁。 公平模式下等待线程入队列后会严格按照队列顺序去执行 非公平模式下等待线程入队列后有可能会出现插队情况 这就是ReentrantLock的结构图,我们看这张图其实是很简单的,因为主要的实现都交给AQS去做了,我们下面着重聊一下AQS。 AQS AQS(AbstractQueuedSynchronizer): AQS 可以理解为就是一个可以实现锁的框架。 简单的流程理解: 公平锁: 第一步:获取状态的 state 的值。 如果 state=0 即代表锁没有被其它线程占用,执行第二步。 如果 state!=0 则代表锁正在被其它线程占用,执行第三步。 第二步:判断队列中是否有线程在排队等待。 如果不存在则直接将锁的所有者设置成当前线程,且更新状态 state 。 如果存在就入队。 第三步:判断锁的所有者是不是当前线程。 如果是则更新状态 state 的值。 如果不是,线程进入队列排队等待。 非公平锁: 第一步:获取状态的 state 的值。 如果 state=0 即代表锁没有被其它线程占用,则设置当前锁的持有者为当前线程,该操作用 CAS 完成。 如果不为0或者设置失败,代表锁被占用进行下一步。 此时获取 state 的值, 如果是0,代表刚好线程释放了锁,此时将锁的持有者设为自己 如果不是0,则查看线程持有者是不是自己 如果是,则给state+1,获取锁 如果不是,则进入队列等待 读完以上的部分相信你对AQS已经有了一个比较清楚的概念了,所以我们来聊聊小细节。 AQS使用state同步状态(0代表无锁,1代表有),并暴露出 getState 、 setState 以及 compareAndSet 操作来读取和更新这个状态,使得仅当同步状态拥有一个期望值的时候,才会被原子地设置成新值。 当有线程获取锁失败后,AQS是通过一个双向的同步队列来完成同步状态的管理,就被添加到队列末尾。 这是定义头尾节点的代码,我们可以先使用 volatile 去修饰的,就是保证让其他线程可见,AQS 实际上就是修改头尾两个节点来完成入队和出队操作的。 AQS 在锁的获取时,并不一定只有一个线程才能持有这个锁,所以此时有了独占模式和共享模式的区别,我们本篇文章中的 ReentrantLock 使用的就是独占模式,在多线程的情况下只会有一个线程获取锁。 独占模式的流程是比较简单的,就根据state是否为0来判断是否有线程已经获得了锁,没有就阻塞,有就继续执行后续代码逻辑。 共享模式的流程根据state是否大于0来判断是否有线程已经获得了锁,如果不大于0,就阻塞,如果大于0,通过CAS的原子操作来自减state的值,然后继续执行后续代码逻辑。 ReentrantLock和Synchronized的区别 其实ReentrantLock和Synchronized最核心的区别就在于Synchronized适合于并发竞争低的情况,因为Synchronized的锁升级如果最终升级为重量级锁在使用的过程中是没有办法消除的,意味着每次都要和cpu去请求锁资源,而ReentrantLock主要是提供了阻塞的能力,通过在高并发下线程的挂起,来减少竞争,提高并发能力,所以我们文章标题的答案,也就显而易见了。 synchronized是一个关键字,是由jvm层面去实现的,而ReentrantLock是由java api去实现的。 synchronized是隐式锁,可以自动释放锁,ReentrantLock是显式锁,需要手动释放锁。 ReentrantLock可以让等待锁的线程响应中断,而synchronized却不行,使用synchronized时,等待的线程会一直等待下去,不能够响应中断。 ReentrantLock可以获取锁状态,而synchronized不能。 说说标题的答案 其实题目的答案就在上一栏目的第一条,也是核心的区别,synchronized升级为重量级锁后无法在正常情况下完成降级,而ReentrantLock是通过阻塞来提高性能的,在设计模式上就体现出了对多线程情况的支持。

优秀的个人博客,低调大师

微服务海量日志怎么处理,推荐你试试这款工具....

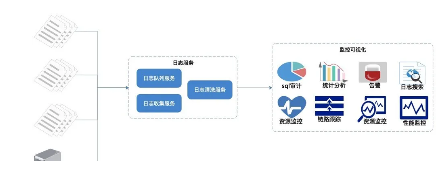
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 背景 在企业级的微服务环境中,跑着成百上千个服务都算是比较小的规模了。在生产环境上,日志扮演着很重要的角色,排查异常需要日志,性能优化需要日志,业务排查需要业务等等。然而在生产上跑着成百上千个服务,每个服务都只会简单的本地化存储,当需要日志协助排查问题时,很难找到日志所在的节点。也很难挖掘业务日志的数据价值。 那么将日志统一输出到一个地方集中管理,然后将日志处理化,把结果输出成运维、研发可用的数据是解决日志管理、协助运维的可行方案,也是企业迫切解决日志的需求。 我们的解决方案 通过上面的需求我们推出了日志监控系统。 日志统一收集、过滤清洗。 生成可视化界面、监控,告警,日志搜索。 功能流程概览 在每个服务节点上埋点,实时采集相关日志。 统一日志收集服务、过滤、清洗日志后生成可视化界面、告警功能。 我们的架构 1、日志文件采集端我们使用filebeat,运维通过我们的后台管理界面化配置,每个机器对应一个filebeat,每个filebeat日志对应的topic可以是一对一、多对一,根据日常的日志量配置不同的策略。 除了采集业务服务日志外,我们还收集了mysql的慢查询日志和错误日志,还有别的第三方服务日志,如:nginx等。最后结合我们的自动化发布平台,自动发布并启动每一个filebeat进程。 2、调用栈、链路、进程监控指标我们使用的代理方式:Elastic APM,这样对于业务侧的程序无需任何改动。对于已经在运营中的业务系统来说,为了加入监控而需要改动代码,那是不可取的,也是无法接受的。Elastic APM可以帮我们收集http接口的调用链路、内部方法调用栈、使用的sql、进程的cpu、内存使用指标等。 可能有人会有疑问,用了Elastic APM,其它日志基本都可以不用采集了。还要用filebeat干嘛?是的,Elastic APM采集的信息确实能帮我们定位80%以上的问题,但是它不是所有的语言都支持的比如:C。 其二、它无法帮你采集你想要的非error日志和所谓的关键日志,比如:某个接口调用时出了错,你想看出错时间点的前后日志;还有打印业务相关方便做分析的日志。 其三、自定义的业务异常,该异常属于非系统异常,属于业务范畴,APM会把这类异常当成系统异常上报,如果你后面对系统异常做告警,那这些异常将会干扰告警的准确度,你也不能去过滤业务异常,因为自定义的业务异常种类也不少。 3、同时我们对agent进行了二开。采集更详细的gc、堆栈、内存、线程信息。 4、服务器采集我们采用普罗米修斯。 5、由于我们是saas服务化,服务N多,很多的服务日志做不到统一规范化,这也跟历史遗留问题有关,一个与业务系统无关的系统去间接或直接地去对接已有的业务系统,为了适配自己而让其更改代码,那是推不动的。牛逼的设计是让自己去兼容别人,把对方当成攻击自己的对象。 很多日志是没有意义的,比如:开发过程中为了方便排查跟踪问题,在if else里打印只是有标志性的日志,代表是走了if代码块还是else代码块。甚至有些服务还打印着debug级别的日志。在成本、资源的有限条件下,所有所有的日志是不现实的,即使资源允许,一年下来将是一比很大的开销。所以我们采用了过滤、清洗、动态调整日志优先级采集等方案。首先把日志全量采集到kafka集群中,设定一个很短的有效期。我们目前设置的是一个小时,一个小时的数据量,我们的资源暂时还能接受。 6、Log Streams是我们的日志过滤、清洗的流处理服务。为什么还要ETL过滤器呢?因为我们的日志服务资源有限,但不对啊,原来的日志分散在各各服务的本地存储介质上也是需要资源的哈。现在我们也只是汇集而已哈,收集上来后,原来在各服务上的资源就可以释放掉日志占用的部分资源了呀。 没错,这样算确实是把原来在各服务上的资源化分到了日志服务资源上来而已,并没有增加资源。不过这只是理论上的,在线上的服务,资源扩大容易,收缩就没那么容易了,实施起来极其困难。所以短时间内是不可能在各服务上使用的日志资源化分到日志服务上来的。这样的话,日志服务的资源就是当前所有服务日志使用资源的量。随存储的时间越长,资源消耗越大。如果解决一个非业务或非解决不可的问题,在短时间内需要投入的成本大于解决当前问题所带来收益的话,我想,在资金有限的情况下,没有哪个领导、公司愿意采纳的方案。 所以从成本上考虑,我们在Log Streams服务引入了过滤器,过滤没有价值的日志数据,从而减少了日志服务使用的资源成本。技术我们采用Kafka Streams作为ETL流处理。通过界面化配置实现动态过滤清洗的规则: 界面化配置日志采集。默认error级别的日志全量采集 以错误时间点为中心,在流处理中开窗,辐射上下可配的N时间点采集非error级别日志,默认只采info级别 每个服务可配100个关键日志,默认关键日志全量采集 在慢sql的基础上,按业务分类配置不同的耗时再次过滤 按业务需求实时统计业务sql,比如:高峰期阶段,统计一小时内同类业务sql的查询频率。可为dba提供优化数据库的依据,如按查询的sql创建索引 高峰时段按业务类型的权重指标、日志等级指标、每个服务在一个时段内日志最大限制量指标、时间段指标等动态清洗过滤日志 根据不同的时间段动态收缩时间窗口 日志索引生成规则:按服务生成的日志文件规则生成对应的index,比如:某个服务日志分为:debug、info、error、xx_keyword,那么生成的索引也是debug、info、error、xx_keyword加日期作后缀。这样做的目的是为研发以原习惯性地去使用日志 7、可视化界面我们主要使用grafana,它支持的众多数据源中,其中就有普罗米修斯和elasticsearch,与普罗米修斯可谓是无缝对接。而kibana我们主要用于apm的可视分析。 日志可视化 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-14本文作者: 非洲羚羊本文来自:“互联网架构师”,了解相关信息可以关注“互联网架构师”

优秀的个人博客,低调大师

斗胆推荐一款刚出的微服务网关

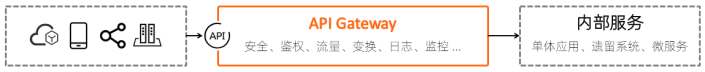
前言 使用 API 网关作为内部服务面向客户端的单一入口,是一种普遍采用的架构模式。企业组织通过良好定义的 API 将内部系统向内部和外部用户公开,通常都会采用 API 网关来处理横向的关注点,包括访问控制、速率限制、负载均衡等等,来实现安全可控的 API 开放。而被广泛实践的微服务架构在提供高度灵活性和弹性的同时,也给 API 网关带来了更多的挑战。 阿里云云服务总线(Cloud Service Bus)新推出微服务网关服务(CSB Micro Gateway),针对微服务架构下 API 开放的特点,提供能与微服务环境的治理策略无缝衔接的网关服务,实现高效的微服务 API 开放。 API 网关的作用 API 网关典型作用 相信许多人都熟悉 API 网关的概念。作为内部服务面向客户端的单一入口,API 网关有两个最典型的作用: 1、内外解耦:对客户端屏蔽内部服务的动态多样化实现细节,如技术框架、拆分粒度、接口结构、实例状态等 2、切面控制:让内部服务能专注在业务逻辑上,集中处理横向的关注点,如路由、安全、限流、日志、监控等 API 网关使用类型 实际使用中,对应 API 网关所在位置和针对场景的不同,可分成两种类型: 1、企业级网关:位于企业组织的外围,面对外部的 API 消费者或服务提供者。通常将企业自身的数据和能力 API 化,对外开放,也有允许外部服务入驻的情况。总的来说,以支撑服务入驻、服务运营和服务门户场景为主,侧重解决管理和运营挑战。 2、微网关:位于企业组织内部,面对内部的 API 消费者,可以看做是内部服务之前的最后一道防线。通常按内部服务的业务划分、物理环境以及技术形态的差异,设立多个微网关来分别负责。总的来说,以提供快捷开放、策略控制、服务适配能力为主,侧重提升开发和运维效率。 实际上,企业级网关和微网关只是两种使用类型,在关注的网关特性上有不同侧重,实践上并非一定需要不同的产品或两套独立的部署。 API 网关流量特征 企业级网关处理的一定是 API 消费方和后端服务之间的流量,也称为南北流量;微网关一般也只是处理南北流量,当负责的服务本身缺乏注册发现机制,例如运行在传统应用服务器上的不同应用,当相互调用需要一个切面管控时,可以用微网关来统一处理服务间流量,也称为东西流量。 微服务网关定义 在这里我们做个定义:用于微服务环境的微网关,称作微服务网关。开源产品中,Kong、Netflix Zuul、Spring Cloud Gateway、Ambassador 等都可以用来作为微服务网关,其中 Ambassador 是基于 Envoy 构建的,属于 K8s 原生微服务网关。那么,微服务网关有什么特别的地方,需要解决什么问题呢? API 网关在微服务架构下面临的挑战 服务治理诉求 在微服务架构模式下,小型化、自包含、相对隔离、随时可运行的应用形态,带来了极大的灵活性和弹性。但是微服务架构高度动态的服务分布和复杂依赖的特点也带来了很多挑战:链路复杂,定位故障点困难;一个服务的故障可能带来雪崩效应;端到端的测试难以实施等等。对应这些问题,出现了一系列典型的服务治理手段: 链路压测 - 端到端实际流量特征的测试,尽可能多暴露问题与风险,好针对制定保障策略 监控报警 - 实时监控各个服务、组件的状态指标,即时报警 链路追踪 - 追踪用户请求产生的服务调用路径,分析瓶颈风险,快速定位问题 日志分析 - 搜集分散的日志,提供快速准确查询,配合链路追踪分析问题 访问控制 - 实施权限检查,规范调用控制 服务发现 - 动态注册发现,同步服务状态和可用性 流量管理 - 结合服务发现,实施灵活的负载策略和流量调度 熔断降级 - 核心业务失效快速响应,避免请求堆积,非核心业务降级处理,保证核心业务流畅 配置中心 - 集中管理配置,高效高可用推送,保护敏感配置信息 在实现上,这些横向的治理能力大都需要微服务应用配合对接,这些公共机制的实现可以通过微服务框架(例如 Spring Cloud、Dubbo)来提供,让应用开发能专注在业务逻辑上。或者采用服务网格(Service Mesh)模式,从应用实现解耦,付出一定性能代价,在应用本地的反向代理组件(Sidecar)中转发流量并处理所有这些逻辑。 微服务网关的配合 由于微服务的调用方可能在微服务环境内部,也可能在微服务环境外部,这些横向的治理能力,有时也需要同时作用到微服务环境与外部之间的南北流量上。这时就需要网关的配合。 以服务发现和流量管理这两个策略为例,考察两个非常普遍的典型场景: 场景一:流量正确路由到可用的微服务实例 场景二:同步在网关上执行金丝雀发布灰度规则 当一个微服务的实例增加、减少,或者不可用时,网关要能把流量正确地路由到可用的微服务实例上;当微服务更新版本,采用金丝雀发布的时候,灰度策略不但需要在微服务环境内的东西流量上生效,在网关上也要执行相同的灰度策略。 很明显,网关进行这样的配合,如果采用人工操作的方式的话,会带来很多问题:首先是实时性差,导致网关流量路由的失效和错误几率增大;其次是运维和管理的压力,对应关系容易错乱,操作可能失误错漏,带来很大风险。 设想一下,要校对实例的可用状态,然后在网关或网关后的负载上挂载、卸载对应端点;或在金丝雀发布、中断、回滚时,在网关上进行对应的灰度判定和路由配置。如果微服务稍微多些,运维和管理的难度、风险都是显而易见的。 因此,微服务的网关,需要能够和微服务环境的治理能力自动化联动。对应上面的例子,就是要求:能够自动基于微服务环境的服务发现策略,将服务请求动态地路由到可用的微服务实例上;能够在微服务环境进行金丝雀发布时,自动同步配合执行对应的灰度策略。 也就是说,需要微服务网关和微服务环境在服务治理策略上能够无缝衔接,自动配合生效。对这个要求的支持,也正是新发布的微服务网关服务(CSB Micro Gateway)的核心特性之一。 微服务网关云服务 使用阿里云云服务总线(Cloud Service Bus)新发布的微服务网关服务(CSB Micro Gateway),用户可以为目标微服务环境快速创建微服务网关。指定注册中心后,微服务网关就可以动态感知微服务节点的变更,将 API 请求动态路由到后端微服务。通过控制台可以基于注册中心的服务列表快速发布 API,支持服务路由规则的动态变更生效,可以方便地管理限流、鉴权、后端负载均衡等控制策略,提供完整的 API 访问日志和统计报告,并且支持和后端微服务治理策略的联动,例如配合微服务应用的升级发布自动执行灰度路由策略。 新发布的微服务网关服务:https://help.aliyun.com/document_detail/156009.html 微服务亲和特性 关联微服务环境,快捷创建、扩容缩容微服务网关 基于微服务环境注册中心的服务列表,方便地选取服务开放为 API 动态感知微服务节点的变更,将 API 请求路由到可用微服务实例上 支持服务路由、限流、鉴权、后端负载均衡等各种控制策略,动态生效无需重启 支持与微服务治理策略的无缝联动,例如无需用户干预,自动配合执行灰度路由策略等 现状与规划 微服务网关服务(CSB Micro Gateway)是阿里云上的托管式微服务网关服务,提供高度的可用性和稳定性,基于开源引擎,支持开源配置方式。将陆续提供多种微服务网关引擎的托管服务,以满足不同场景的侧重需求和使用偏好。 公测首先推出基于 Zuul 的服务版本,支持 Eureka 注册中心以及 Spring Cloud 微服务框架。将很快支持基于 Kong、Ambassador 等引擎的托管服务将很快推出 Nacos 等多种微服务注册中心的支持,将陆续支持 Dubbo、gPRC 等多种微服务框架将陆续提供丰富的控制策略,包括各种鉴权方式、流量控制、安全防护、服务组装变换等等,以及支持用户自定义实现的策略将陆续补充企业级网关所侧重的一些开放管控能力,例如 API 标准规范定义、API 文档、API 测试调用、多版本管理等 欢迎试用 欢迎试用,敬请密切关注微服务网关的发布更新! 微服务网关控制台入口(无需开通,直接使用):https://microgw.console.aliyun.com/ 微服务网关使用说明 :https://help.aliyun.com/document_detail/156009.html 微服务网关公测用户交流群: 相关产品与参考 阿里云云原生微服务系列云服务 链路压测 - 性能测试 PTS 应用监控 - 应用实时监控服务 ARMS 链路追踪 - 链路追踪 Tracing Analysis 服务发现 - 微服务引擎 MSE 流量管理 - 应用高可用服务 AHAS 配置中心 - 应用配置管理 ACM 应用托管 - 企业级分布式应用服务 EDAS 无服务器 - Serverless 应用引擎 SAE 开源与参考资料:Microservice Architecture Spring Cloud Dubbo Istio Netflix Zuul Spring Cloud Gateway Kong Gateway Ambassador Edge Stack Traefik 作者信息:王佺伦,阿里巴巴高级产品专家,负责阿里云云原生应用平台 iPaaS 产品线,目前专注于开放平台、服务网关和应用集成领域。

优秀的个人博客,低调大师

推荐一个写的不错的Java学习路线

一.如何选择职业方向 ​ 我见过很多之前都不是计算机专业出身的,现在从事Java开发或者大数据等职业,而且现在做的都还不错。我想这些人应该都是经过深思熟虑的做出选择的,或者是人云亦云,不过都已经走出来了。我是从事JAVA这块十多年,从初级开发到现在架构师,确实一路经历很多。 ​ 就目前主流互联网公司,JAVA的应用场景还是最多的,比如大型的分布式系统、微服务架构,基本上服务端开发用的多数是JAVA。这就决定了市场需求,如果技术还可以,找工作不是问题。当然,做IT这块有很多选择,大致有几个方向: 1.前端工程师 ​ 大型互联网公司都是前后端分离的,前端负责前端开发,比如H5、APP等工作,后端服务服务端开发。前端现在也很复杂,需要掌握HTML、css、javaScript这些基本技术外,还需要一些流行框架,比如Node、angular2、vue.js、react等,这些更新都很快。 ​ 优势:前端的起薪比较高,我觉得前端现在很紧缺的,薪资普遍比后端高点。 ​ 劣势:对于职业规划上,前端以后可以做前端架构师、前端的Team Leader。但是很少见到技术总监、CTO这些M级职位是前端出身的,当然,也不是绝对。 2.大数据工程师 ​ 大数据之前还是很抢手的,但是目前市场应该趋于饱和,也是不错的职业方向。如果你现在是DBA,我想你转大数据应该很快。比如你做数仓Hive上写sql,估计一天就可以转型成功。所以现在很多DBA转大数据,而且感觉很简单,so easy,但是估计只会写SQL。如果你是数仓Hive上写SQL的,我的建议是写个半年就可以了,多了基本上就废了。技术栈如下: ​ Java语言、Linux 、Hadoop(HDFS+MapReduce+Yarn )、 HBase、Hive(Hql基本操作和原理理解)、 Kafka、Storm/JStorm、Scala、Python、Spark (sparkCore+sparksql+Spark streaming ,或者加上MLLIB) 、还有(Sqoop/Flume/Oozie/Hue等)。 ​ Spark可以用scala或者java,用scala操作RDD比较方便,前提是有学习成本。scala一行代码搞定的,用JAVA有可能几十行,但是一些其他中间件基本上都支持JAVA,用scala就少些,集成个方便比较麻烦。 ​ 流式计算,Flink未来应该是趋势,Spark streaming严格来讲是批处理。 3.JAVA工程师 ​ JAVA已经流行了很多年了,不过现在GO语言慢慢的也在兴起。大型互联网公司分布式架构,服务端语言大多数是Java语言,周边生态也是最全的。 ​ 做后端的以后职业规划可以有技术型,比如技术专家、架构师。管理可以往Team Leader、技术总监、CTO。 ​ 其他还有很多选择,比如数据工程师、机器学习、量化工程师,也是不错的选择。 二. JAVA需要学习的技能 ​ 如果你坚定的选择Java,那就开始吧。 1. JAVA基础 ​ 这个是基础,是以后发展的根本。 ​ 你可以选择从看书开始,比如JAVA编程思想、JAVA核心技术卷,不过我不建议先从这里开始,翻译过来有很多语言比较晦涩,而且书也比较厚,坚持学完估计会花不少精力,也会有挫折感。 ​ 你可以选择网上一些免费的教程,http://www.amcto.net,也有面向零基础的JAVA教程。 ​ 学习过程中,重要的事情说三遍,动手!动手!动手!理解的再好,都没有动手来的彻底,还有一点就是做笔记。 ​ 需要学习,面向对象、注解、泛型、多线程、IO、JVM、集合、反射、网络编程、设计模式、JDBC等技能。学习过程中,随时做些小的项目。 2. JAVA WEB ​ 语言类,html、javaScript、css(了解)、Servlet、XML、AJAX、JQuery、http协议。 ​ 框架类,Spring MVC这个就可以了,像Struts、Hibernate、Webwork这些你可以忽略了,即使遗留项目,现学也来得及。 3. 数据库 ​ 项目都是动态的,肯定离不了数据库,也是以后工作中经常用的。如果时间有限,基本上MySQL要掌握。 DDL、DML 事务隔离级别 数据库索引,比如索引原理(B+Tree)、聚集索引、非聚集索引、不同引擎的索引实现区别。 binlog,MVVC等。这个有点麻烦,可以以后学。 4. 缓存 ​ 系统中很多数据是要放入缓存,缓存速度很快。Memcached由于只放内存,断电会丢数据,Redis现在是主流,需要掌握如下: 五种数据结构,string(字符串),hash(哈希),list(列表),set(集合)及zset(sorted set:有序集合)。 集群方式,初级可以先了解。单节点实例、主从模式、sentinel模式、cluster模式。 常用命令 持久化机制,rdb、AOF。 原理,比如单线程、惰性删除等。 5. 工具类 Java开发工具,Eclipse(免费),IntelliJ IDEA(社区版是免费的)。 版本控制工具,SVN、git(互联网公司大部分用这个)。 JAR包管理工具,Maven(大多数), gradle(少部分)。 6.框架类或中间件 spring是必须的,IOC和AOP是必须掌握的。EJB现在就不要提了。 消息,ActiveMQ、RabbitMQ、RocketMQ、Kafka(大数据场景用的较多)。分布式事务很多都是用消息解决的。 MyBatis,简单易用,大部分都是用这个。Hibernate这个重量级ORMapping框架用的很少了。 RPC通信,Dubbo(常用)、Motan(新浪)、Spring Cloud(现在很火,微服务的一种常用架构)、gRPC(Google的用的也蛮多)。 分布式一致性协调框架,Zookeeper,本是主要用于大数据场景,不过现在很多分布式也是用这个,了解下基本原理,原子消息广播等。 7. 数据结构与算法 ​ 线性表(数组、链表)、栈与队列、树与二叉树(树、二叉树基本概念、二叉查找树、平衡二叉树、红黑树),这些还是要会的。 ​ 关于LeeCode,如果你校招进大厂,这个你要好好刷刷了,你即使是神童,不刷你也搞不定。现在很多社招也会面这个的。 8. 操作系统 ​ Linux操作系统的常用命令会用一些,工作中大概率会用到的。至于select、epoll、Zero以后可以慢慢学习。 三.怎么学习 1. 善于借助搜索工具 ​ 遇到问题,恭喜你,有问题才能进步。先想着自己解决,不行解决搜索引擎,比如百度、google。搜索也是有技巧的,不妨先学习下搜索的技巧。如果能阅读源码肯定是极好的。 ​ 切记,不要很随便的问身边的同事技术问题,除非你觉得是合理的,工作中要树立自己的品牌,千万不要被别人打上不好的标签。 2. 官方文档是不错的学习途径 ​ 想学一门技术,最先去找官方文档,基本上文档都是可以接受的,当然,你的英文要好点,不好也没关系,借助有道,慢慢的就可以了。实在不行就找一些网上的视频教程,但是最新的有可能没有,或者是别人总结过的,有可能被带歪了。 3. 善于做笔记或者写博客 ​ 无论学什么,能用自己的语言总结出来,都会有新的收获。即使过了很久,翻开笔记或者博客,很快就会把只是串起来。还有一点,写博客可以拓宽自己的知名度。 ​ 我其实很少写博客,但是笔记会每天都做的,不断修改。若干时间后,翻开之前的笔记,妈呀,这太low了吧,有这种感觉说明进步了。 4. 动手做项目是成长最快的方式 ​ 重要的不需要解释了。 四.怎么写简历 1. 简历要中肯 ​ 简历写的中肯合理,比如初学者写精通分布式架构,面试官肯定觉得这是神童,会问你分布式常用架构是什么、调用链监控怎么解决的、熔断、限流。或者简单点问分布式事务,两阶段提交、三阶段提交、CAP理论、Base理论,你怎么解决分布式事务问题的? ​ 你可以这么写,了解分布式架构,面试官问你,最起码可以答出来12来。 ​ 切记,简历不可以造假,写的内容自己心里有数即可。 2. 简历中要有亮点 ​ 多写项目经验,不要通篇都是会哪些技能。如果我是面试官,我提问会很迷茫。项目经验多写自己参与的部分,遇到哪些难题,解决方案是什么,这个看起来比较nice。 ​ 我其实比较讨厌,上来就写做过OA、CRM啥的企业管理软件,因为写的人太多了,有点普通,问你工作流引擎还不一定答出来。 ​ 如果你做过电商项目,写个订单状态机设计还是不错的,最起码每个订单不是硬编码,可以自由配置。还有库存超扣怎么解决的,这些都可以的。 ​ 以上就我的个人经验,如有不妥,请指正,愿你在未来的职业中星辰大海。转自:http://www.amcto.net/blogdetail/1

优秀的个人博客,低调大师

推荐:一款分布式的对象存储服务

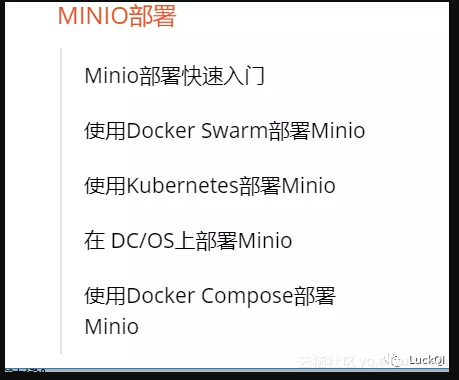
最近公司在准备内部数据上云,并且内部数据库每天的数据量很大,需要采用大数据存储的方案。 方案调研每个程序技术在实现之前,需要进行开源产品的调研,适合自己产品的技术方案才是最好的。 需求我们需要处理是图像信息,大小在1M左右。 供以后各个项目组用来拉取图像。 自定义了一个按照标准存储的一批图像,这批图像大小可能在几百兆或者小到几兆大小 技术选型我们选取了两种技术方案 采用hdfs的集群存储的方案,将数据进行流读取,存储二进制文;将相关的文件内容进行整合成一个大文件存储到hdfs上。 另外一个技术方案采用的是minio,分布式存储方案。 今天要给大家介绍的是minio技术方案。 Minio什么是Miniominio 是一款开源的对象存储服务。可以兼容亚马逊的S3存储服务接口,非常适合存储大容量的非结构化数据。 这些非结构化数据包含 图片,视频,日志文件,备份数据和容器、虚拟机镜像。 对象文件大小可以从几kb到最大5T. 我们可以用来做什么企业上我们可以利用其分布式的功能,内部搭建图片处理服务器,文件存储服务器,公司内部的文件存储服务器,这样就不用限制存储的大小,也不限制存储位置。 我们个人可以直接在家庭内部搭建个人的云盘服务,开心的保存家里面的数据文件,再也不担心数据丢失的问题了。 怎么安装Minio 分布式对象存储,在官网提供了很多的技术选择方案。 根据图中有5种不同的方案,让我们进行选择,可以使用docker 单机部署,也可以采用Docker-compose进行部署伪分布式。 可以使用Docker Swarm 和 k8s 部署分布式架构的选型。 因为是测试阶段,所以采用的是伪分布式的构建方式。使用docker-compose 方式进行部署。 部署docker-compose 部署方案,我们需要进行安装docker 与docker-compose ,这个在docker文档中都有,可以参考docker-compose官网。为了方便小伙伴进行学习,简单流程安装给大小说下。 安装docker centos yum install docker ubuntu apt-get install docker.io 安装docker-compose sudo curl -L"https://github.com/docker/compose/releases/download/1.23.1/ocker-compose-$(uname -s)-$(uname -m)"-o /usr/local/bin/docker-compose 执行下权限操作 sudo chmod +x /usr/local/bin/docker-compose 检验下版本是否是正确的 docker-compose --version docker-compose version 1.23.1, build 1719ceb 以上步骤操作成功后,我们就可以安装minio 来进行实战演练了。 下载docker-compose.yaml文件 version: '2' # starts 4 docker containers running minio server instances. Each # minio server's web interface will be accessible on the host at port # 9001 through 9004. services: minio1: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - data1:/data ports: - "9001:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/datahttp://minio3/data http://minio4/data minio2: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - data2:/data ports: - "9002:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/data http://minio3/data http://minio4/data minio3: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - data3:/data ports: - "9003:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/data http://minio3/datahttp://minio4/data minio4: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - data4:/data ports: - "9004:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http: //minio1/data http://minio2/data http://minio3/data http://minio4/data ## By default this config uses default local driver, ## For custom volumes replace with volume driver configuration. volumes: data1: data2: data3: data4: 在上面我们需要注意两点。 volumes 全局:如果我们不进行配置的话,使用的是默认的路径文件。 在这里向找到相关的存储的文件内容我们可以使用docker inspect 镜像id 来查看。 不配置全局:我们每个镜像id配置一个路径那么我们需要改下文件配置文件 version: '2' # starts 4 docker containers running minio server instances. Each # minio server's web interface will be accessible on the host at port # 9001 through 9004. services: minio1: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - /media/data1:/data:z ports: - "9001:9000" environment: MINIO_ACCESS_KEY:minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/data http://minio3/data http://minio4/data minio2: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - /meida/data2:/data:z ports:-"9002:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http: //minio1/data http://minio2/data http://minio3/data http://minio4/data minio3: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: -/media/data3:/data:z ports: - "9003:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/data http://minio3/datahttp://minio4/data minio4: image: minio/minio:RELEASE.2018-12-19T23-46-24Z volumes: - /media/data4:/data:z ports: -"9004:9000" environment: MINIO_ACCESS_KEY: minio MINIO_SECRET_KEY: minio123 command: server http://minio1/data http://minio2/datahttp://minio3/data http://minio4/data 在这个文件中,我们主要做了两项修改: /media/data1:/data ,我们将data里面的数据映射到media/data1本地目录下。 在:/data 后面增加:z ,这个是为了解决权限问题所增加的。 权限问题是这样的,在我们后面加上: z 就是我们就可以启动成功了 ERROR Unable to initialize posix backend: Unable to write to the backend. minio3_1_2ce510efd213 | > Please ensure Minio binary has write permissions for the backend 启动 首先拉取镜像 docker-compose pull 镜像启动 docker-compose up 如果没有出现错误,那么我们程序就启动成功了 浏览器查看 ip:9001 访问,第一次登陆我们需要填写 ACCESS_KEY 与 SECRET_KEY 。这个两个内容的值在我们配置文件中已存在,直接查看配置文件内容然后填写 浏览器页面展示:出现以上界面就代表我们安装成功了 使用 进入界面后我们需要先点击右下角的加号,然后创建文件目录,我们的图像是存储在文件目录下的。结束 这样我们的一个分布式系统就搭建完成了,怎么样是不是很简单?嘿嘿。 总结分布式文件系统存储,是我们搭建开始的第一步,后面性能问题,存储压力都是我们需要面临的。做好准备工作才能更好的服务我们的产品。 原文发布时间为:2018-12-20本文作者: 琪琪 本文来自云栖社区合作伙伴“ LuckQI”,了解相关信息可以关注“LuckQI”微信公众号

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册