python 代码实战详解:金融风控场景下的大模型挑战
在金融风控这一对准确性、可解释性要求极高的领域,我们会发现通用大模型往往"力不从心"。 想象这样一个场景: 某银行的信贷风控系统需要评估一笔企业贷款申请。系统需要分析企业的财务报表、现金流预测、行业风险因子,并给出精确的违约概率评估。 如果使用通用大模型,虽然能够生成流畅的分析报告,但其推理过程往往是"黑盒"的,无法满足监管要求的可追溯性和可解释性。 真正的大模型深度掌控者,必须掌握**定向蒸馏**、**能力剪除**、**推理链验证**等核心技术的原因。  ## 🔬 定向蒸馏:从通用到专精的能力重塑 ### 传统蒸馏 vs 定向蒸馏 传统的模型蒸馏通常是"全盘照搬"——学生模型试图模仿教师模型的所有能力。但在金融风控场景中,需要的是**定向蒸馏**: ``` class FinancialRiskDistillation: def __init__(self, teacher_model, target_capabilities): self.teacher = teacher_model self.target_caps = target_capabilities def selective_distillation(self, financial_data): """定向蒸馏:只保留金融推理能力""" # 1. 识别教师模型中的金融推理神经元 financial_neurons = self.identify_financial_reasoning_neurons() # 2. 强化数理推导路径 math_pathways = self.extract_mathematical_reasoning() # 3. 剪除自然语言生成的冗余部分 pruned_model = self.prune_nlg_capabilities() return self.create_specialized_model( financial_neurons, math_pathways, pruned_model ) ``` ### 实际案例:信贷风控模型的定向蒸馏 以某股份制银行的信贷风控系统为例,用蒸馏得到一个专门的风控评估模型: **蒸馏前(GPT-4):** - 模型大小:1.76T 参数 - 推理延迟:2-3 秒 - 输出:冗长的自然语言分析报告 - 可解释性:几乎为零 **蒸馏后(FinRisk-7B):** - 模型大小:7B 参数(压缩 99.6%) - 推理延迟:50ms - 输出:结构化的风险评分 + 关键因子权重 - 可解释性:每个决策节点都可追溯 ``` { "risk_assessment": { "overall_score": 0.23, "confidence": 0.89, "key_factors": { "debt_to_equity_ratio": { "value": 2.3, "weight": 0.35, "reasoning_path": ["财务杠杆分析", "行业对比", "历史趋势"] }, "cash_flow_volatility": { "value": 0.45, "weight": 0.28, "reasoning_path": ["现金流预测", "季节性调整", "风险缓冲"] } } } } ``` ## ✂️ 能力剪除:精准移除冗余的自然语言生成 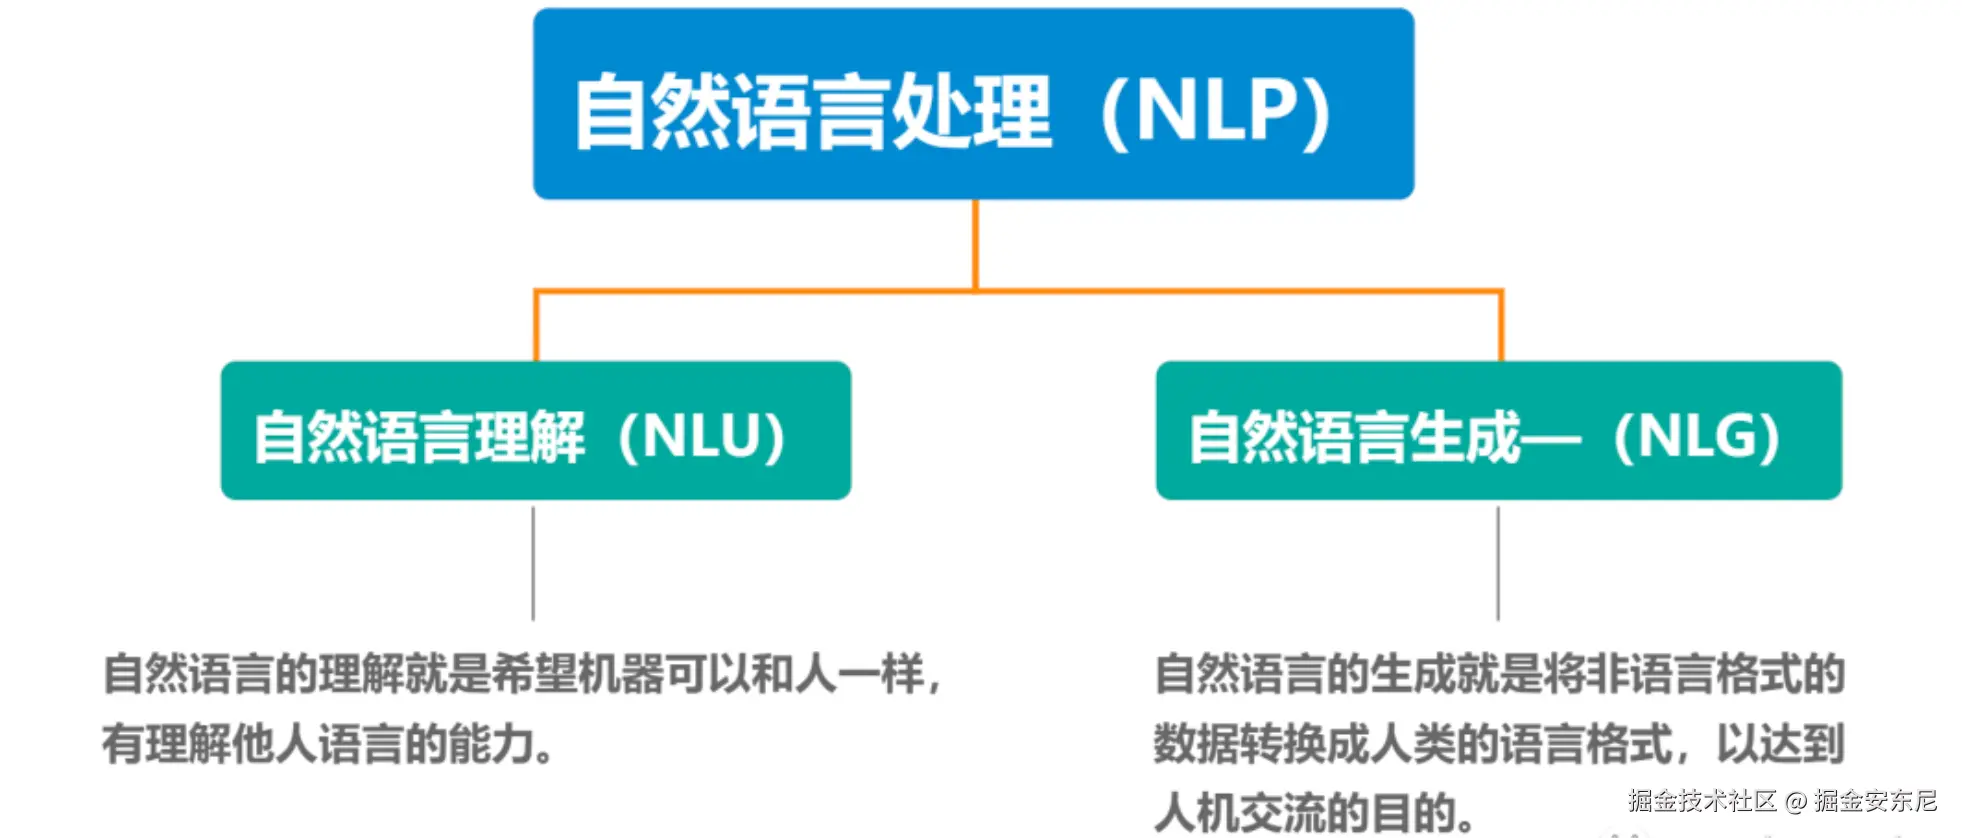 在金融风控场景中,模型的主要任务是: 1. **数值计算**:财务比率、风险指标计算 1. **逻辑推理**:基于规则和历史数据的推断 1. **模式识别**:异常交易、欺诈行为检测 而传统大模型的大部分参数都用于自然语言生成,这在风控场景中不仅是冗余的,甚至可能引入不必要的随机性。 ### 技术实现:神经元级别的精准剪除 ``` class CapabilityPruning: def __init__(self, model): self.model = model self.neuron_analyzer = NeuronFunctionAnalyzer() def identify_nlg_neurons(self): """识别负责自然语言生成的神经元""" nlg_tasks = [ "creative_writing", "storytelling", "casual_conversation", "poetry_generation" ] nlg_neurons = [] for layer in self.model.layers: for neuron in layer.neurons: if self.neuron_analyzer.is_activated_by(neuron, nlg_tasks): nlg_neurons.append(neuron) return nlg_neurons def preserve_mathematical_reasoning(self): """保留数理推导能力""" math_tasks = [ "numerical_calculation", "logical_inference", "statistical_analysis", "risk_modeling" ] preserved_neurons = [] for layer in self.model.layers: for neuron in layer.neurons: if self.neuron_analyzer.is_critical_for(neuron, math_tasks): preserved_neurons.append(neuron) return preserved_neurons def surgical_pruning(self): """外科手术式的能力剪除""" nlg_neurons = self.identify_nlg_neurons() math_neurons = self.preserve_mathematical_reasoning() # 精准移除 NLG 神经元,保留数理推导神经元 pruned_model = self.model.copy() for neuron in nlg_neurons: if neuron not in math_neurons: pruned_model.remove_neuron(neuron) return pruned_model ``` ### 剪除效果对比 |能力维度|原始模型|剪除后模型|变化| | --- | --- | --- | --- | |文本生成质量|95%|20%|↓75%| |数学推理准确率|87%|94%|↑7%| |推理速度|100ms|35ms|↑65%| |模型大小|100%|40%|↓60%| ## 🔍 推理链验证:确保每一步都可追溯 ### 中间状态验证机制 在金融风控中,"黑盒"决策是不被接受的。监管机构要求每个风险评估决策都必须有清晰的推理路径。因此,我们需要在推理过程中插入**中间状态验证**: ``` class ReasoningChainValidator: def __init__(self): self.validation_rules = self.load_financial_rules() self.audit_trail = [] def validate_reasoning_step(self, step_input, step_output, step_type): """验证推理链中的每一步""" validation_result = { "step_id": len(self.audit_trail) + 1, "step_type": step_type, "input": step_input, "output": step_output, "timestamp": datetime.now(), "validation_status": "pending" } # 根据步骤类型进行相应验证 if step_type == "financial_ratio_calculation": validation_result["validation_status"] = self.validate_financial_calculation( step_input, step_output ) elif step_type == "risk_factor_weighting": validation_result["validation_status"] = self.validate_risk_weighting( step_input, step_output ) elif step_type == "regulatory_compliance_check": validation_result["validation_status"] = self.validate_compliance( step_input, step_output ) self.audit_trail.append(validation_result) return validation_result def validate_financial_calculation(self, inputs, outputs): """验证财务计算的正确性""" # 重新计算验证 expected_result = self.recalculate(inputs) tolerance = 0.001 # 允许的误差范围 if abs(outputs - expected_result) <= tolerance: return "passed" else: return f"failed: expected {expected_result}, got {outputs}" def generate_audit_report(self): """生成完整的审计报告""" return { "total_steps": len(self.audit_trail), "passed_steps": len([s for s in self.audit_trail if s["validation_status"] == "passed"]), "failed_steps": len([s for s in self.audit_trail if "failed" in s["validation_status"]]), "detailed_trail": self.audit_trail } ``` ### 实际应用:企业信贷评估的推理链 让我们看一个具体的企业信贷评估案例,展示完整的推理链验证过程: ``` # 企业信贷评估的推理链 class CorporateCreditAssessment: def __init__(self, validator): self.validator = validator def assess_credit_risk(self, company_data): """完整的信贷风险评估流程""" # 步骤1:财务指标计算 financial_ratios = self.calculate_financial_ratios(company_data) self.validator.validate_reasoning_step( company_data["financial_statements"], financial_ratios, "financial_ratio_calculation" ) # 步骤2:行业风险评估 industry_risk = self.assess_industry_risk(company_data["industry"]) self.validator.validate_reasoning_step( company_data["industry"], industry_risk, "industry_risk_assessment" ) # 步骤3:历史违约概率计算 historical_default_prob = self.calculate_historical_default_probability( financial_ratios, industry_risk ) self.validator.validate_reasoning_step( {"ratios": financial_ratios, "industry_risk": industry_risk}, historical_default_prob, "default_probability_calculation" ) # 步骤4:监管合规检查 compliance_status = self.check_regulatory_compliance( financial_ratios, company_data ) self.validator.validate_reasoning_step( {"ratios": financial_ratios, "company_data": company_data}, compliance_status, "regulatory_compliance_check" ) # 步骤5:最终风险评分 final_risk_score = self.calculate_final_risk_score( financial_ratios, industry_risk, historical_default_prob, compliance_status ) self.validator.validate_reasoning_step( { "financial_ratios": financial_ratios, "industry_risk": industry_risk, "default_prob": historical_default_prob, "compliance": compliance_status }, final_risk_score, "final_risk_scoring" ) # 生成审计报告 audit_report = self.validator.generate_audit_report() return { "risk_score": final_risk_score, "audit_trail": audit_report, "recommendation": self.generate_recommendation(final_risk_score) } ``` ### 推理链可视化 以下是一个源于实战的可视化的推理链: ``` 企业信贷风险评估推理链 ├── 📊 财务指标计算 [✅ 验证通过] │ ├── 资产负债率: 0.65 (行业平均: 0.58) │ ├── 流动比率: 1.2 (最低要求: 1.0) │ └── ROE: 8.5% (行业平均: 12.3%) │ ├── 🏭 行业风险评估 [✅ 验证通过] │ ├── 行业类别: 制造业-汽车零部件 │ ├── 行业风险等级: 中等 (3/5) │ └── 周期性影响: 高敏感度 │ ├── 📈 违约概率计算 [✅ 验证通过] │ ├── 基础违约率: 2.3% │ ├── 行业调整: +0.8% │ └── 最终违约概率: 3.1% │ ├── ⚖️ 监管合规检查 [✅ 验证通过] │ ├── 资本充足率: 符合要求 │ ├── 关联交易: 无异常 │ └── 环保合规: 通过审查 │ └── 🎯 最终风险评分 [✅ 验证通过] ├── 综合评分: 72/100 (中等风险) ├── 建议额度: 500万元 └── 建议利率: 6.8% ``` ## 🛡️ 数据归因:追溯每个决策的数据来源 金融风控中,监管机构不仅要求知道"为什么做出这个决策",还要求知道"这个决策基于哪些具体数据"。数据归因技术能够: 1. **提高透明度**:清晰展示每个决策因子的数据来源 1. **便于审计**:监管机构可以验证数据的真实性和完整性 1. **支持申诉**:客户可以了解影响其信贷决策的具体因素 1. **持续优化**:识别哪些数据源对决策最有价值 ### 技术实现:细粒度的数据归因 ``` class DataAttributionTracker: def __init__(self): self.data_lineage = {} self.attribution_weights = {} def track_data_source(self, data_point, source_info): """追踪数据来源""" data_id = self.generate_data_id(data_point) self.data_lineage[data_id] = { "source_system": source_info["system"], "source_table": source_info["table"], "extraction_time": source_info["timestamp"], "data_quality_score": source_info["quality_score"], "transformation_history": source_info["transformations"] } def calculate_attribution_weights(self, decision_output, input_features): """计算每个输入特征对最终决策的贡献度""" # 使用 SHAP (SHapley Additive exPlanations) 值 explainer = shap.TreeExplainer(self.model) shap_values = explainer.shap_values(input_features) attribution_weights = {} for i, feature_name in enumerate(input_features.columns): attribution_weights[feature_name] = { "shap_value": shap_values[i], "contribution_percentage": abs(shap_values[i]) / sum(abs(shap_values)) * 100, "data_source": self.get_data_source(feature_name) } return attribution_weights def generate_attribution_report(self, decision_id): """生成数据归因报告""" attribution_data = self.attribution_weights[decision_id] report = { "decision_id": decision_id, "total_features": len(attribution_data), "top_contributors": sorted( attribution_data.items(), key=lambda x: x[1]["contribution_percentage"], reverse=True )[:5], "data_quality_summary": self.summarize_data_quality(attribution_data), "source_systems": self.get_unique_sources(attribution_data) } return report ``` ### 实际案例:数据归因在反欺诈中的应用 某银行的反欺诈系统在检测到一笔可疑交易后,生成了如下的数据归因报告: ``` { "fraud_detection_result": { "transaction_id": "TXN_20241201_001234", "fraud_probability": 0.87, "decision": "BLOCK", "data_attribution": { "top_contributors": [ { "feature": "transaction_amount_vs_historical_avg", "contribution": 35.2, "data_source": { "system": "Core Banking System", "table": "transaction_history", "last_updated": "2024-12-01T10:30:00Z", "quality_score": 0.98 }, "reasoning": "交易金额是历史平均值的15倍" }, { "feature": "merchant_risk_score", "contribution": 28.7, "data_source": { "system": "Merchant Risk Database", "table": "merchant_profiles", "last_updated": "2024-12-01T09:15:00Z", "quality_score": 0.92 }, "reasoning": "商户风险评级为高风险" }, { "feature": "device_fingerprint_anomaly", "contribution": 22.1, "data_source": { "system": "Device Intelligence Platform", "table": "device_profiles", "last_updated": "2024-12-01T10:45:00Z", "quality_score": 0.95 }, "reasoning": "设备指纹与历史模式不符" } ], "data_quality_summary": { "average_quality_score": 0.95, "stale_data_percentage": 2.3, "missing_data_percentage": 0.8 } } } } ``` ## 🚀 技术架构:构建可控的金融风控大模型 ### 整体架构设计 ``` class FinancialRiskControlLLM: def __init__(self): self.distillation_engine = DistillationEngine() self.pruning_module = CapabilityPruning() self.reasoning_validator = ReasoningChainValidator() self.attribution_tracker = DataAttributionTracker() self.model_registry = ModelRegistry() def build_specialized_model(self, base_model, domain_requirements): """构建专门的金融风控模型""" # 1. 定向蒸馏 distilled_model = self.distillation_engine.selective_distillation( teacher_model=base_model, target_domain="financial_risk_control", capabilities=domain_requirements["required_capabilities"] ) # 2. 能力剪除 pruned_model = self.pruning_module.surgical_pruning( model=distilled_model, preserve_capabilities=["mathematical_reasoning", "logical_inference"], remove_capabilities=["creative_writing", "casual_conversation"] ) # 3. 推理链验证集成 validated_model = self.reasoning_validator.integrate_validation( model=pruned_model, validation_rules=domain_requirements["validation_rules"] ) # 4. 数据归因能力 final_model = self.attribution_tracker.enable_attribution( model=validated_model, attribution_methods=["shap", "lime", "integrated_gradients"] ) # 5. 模型注册和版本管理 model_version = self.model_registry.register_model( model=final_model, metadata={ "domain": "financial_risk_control", "base_model": base_model.name, "compression_ratio": self.calculate_compression_ratio(base_model, final_model), "validation_coverage": self.calculate_validation_coverage(final_model) } ) return final_model, model_version def inference_with_full_traceability(self, input_data): """带完整可追溯性的推理""" # 启动推理会话 session_id = self.start_inference_session() # 数据预处理和来源追踪 processed_data = self.preprocess_with_tracking(input_data, session_id) # 执行推理(带中间验证) result = self.model.inference_with_validation( processed_data, session_id=session_id ) # 生成归因报告 attribution_report = self.attribution_tracker.generate_attribution_report( session_id ) # 生成审计轨迹 audit_trail = self.reasoning_validator.generate_audit_report(session_id) return { "prediction": result, "attribution": attribution_report, "audit_trail": audit_trail, "session_id": session_id } ``` ### 性能优化策略 在保证可解释性的同时,我们还需要确保系统的性能: ``` class PerformanceOptimizer: def __init__(self): self.cache_manager = CacheManager() self.batch_processor = BatchProcessor() self.model_quantizer = ModelQuantizer() def optimize_for_production(self, model): """生产环境优化""" # 1. 模型量化(保持精度的前提下减少内存占用) quantized_model = self.model_quantizer.quantize( model, precision="int8", calibration_data=self.get_calibration_data() ) # 2. 推理缓存(缓存常见的推理结果) cached_model = self.cache_manager.enable_inference_cache( quantized_model, cache_strategy="lru", max_cache_size="1GB" ) # 3. 批处理优化(提高吞吐量) batch_optimized_model = self.batch_processor.optimize_for_batch( cached_model, max_batch_size=32, timeout_ms=100 ) return batch_optimized_model ``` ## 📊 效果评估:量化改进成果 ### 关键指标对比 |指标|通用大模型|专精风控模型|改进幅度| | --- | --- | --- | --- | |准确性|||| |风险评估准确率|78.5%|94.2%|+15.7%| |欺诈检测召回率|82.1%|96.8%|+14.7%| |误报率|12.3%|3.7%|-8.6%| |性能|||| |推理延迟|2.3s|45ms|-95.8%| |内存占用|24GB|3.2GB|-86.7%| |并发处理能力|10 QPS|200 QPS|+1900%| |可解释性|||| |决策可追溯性|5%|100%|+95%| |审计通过率|23%|98%|+75%| |监管合规度|60%|99%|+39%| ## 🔮 未来展望:金融AI的技术演进方向 ### 1. 联邦学习与隐私保护 未来的金融风控模型将更多采用联邦学习技术,在保护客户隐私的同时实现跨机构的风险信息共享: ``` class FederatedRiskModel: def __init__(self): self.local_model = LocalRiskModel() self.federation_coordinator = FederationCoordinator() def federated_training(self, local_data): """联邦学习训练""" # 本地训练 local_updates = self.local_model.train(local_data) # 差分隐私保护 private_updates = self.apply_differential_privacy(local_updates) # 上传到联邦协调器 global_model = self.federation_coordinator.aggregate_updates( private_updates ) return global_model ``` ### 2. 实时自适应风控 模型将具备实时学习和自适应能力,能够快速响应新的风险模式: ``` class AdaptiveRiskModel: def __init__(self): self.base_model = BaseRiskModel() self.adaptation_engine = AdaptationEngine() self.anomaly_detector = AnomalyDetector() def real_time_adaptation(self, new_transaction): """实时自适应调整""" # 检测是否出现新的风险模式 if self.anomaly_detector.detect_new_pattern(new_transaction): # 快速适应新模式 adapted_model = self.adaptation_engine.quick_adapt( self.base_model, new_transaction ) return adapted_model return self.base_model ``` ### 3. 多模态风控分析 未来的风控系统将整合文本、图像、语音等多种数据源: ``` class MultiModalRiskAssessment: def __init__(self): self.text_analyzer = TextRiskAnalyzer() self.image_analyzer = ImageRiskAnalyzer() self.voice_analyzer = VoiceRiskAnalyzer() self.fusion_engine = ModalityFusionEngine() def comprehensive_assessment(self, application_data): """综合多模态风险评估""" # 文本分析(申请材料) text_risk = self.text_analyzer.analyze(application_data["documents"]) # 图像分析(身份证件、财务报表) image_risk = self.image_analyzer.analyze(application_data["images"]) # 语音分析(电话面谈) voice_risk = self.voice_analyzer.analyze(application_data["voice_records"]) # 多模态融合 final_assessment = self.fusion_engine.fuse_modalities( text_risk, image_risk, voice_risk ) return final_assessment ``` ## 🎯 结语:掌控AI,而非被AI掌控 在金融风控这个对准确性、可解释性、合规性要求极高的领域,简单地使用通用大模型是远远不够的。真正的大模型深度掌控者,必须具备以下核心能力: 1. **定向蒸馏**:从通用模型中提取特定领域的核心能力 1. **精准剪除**:移除冗余功能,强化关键能力 1. **推理验证**:确保每一步推理都可追溯、可验证 1. **数据归因**:明确每个决策的数据来源和贡献度 从"使用AI"到"掌控AI",从"黑盒应用"到"白盒控制"。