首页 文章 精选 留言 我的

精选列表

搜索[ 国密算法],共10000篇文章
优秀的个人博客,低调大师

ES 相似度算法设置(续)

Tuning BM25 One of the nice features of BM25 is that, unlike TF/IDF, it has two parameters that allow it to be tuned: k1 This parameter controls how quickly an increase in term frequency results in term-frequency saturation. The default value is 1.2. Lower values result in quicker saturation, and higher values in slower saturation. b This parameter controls how much effect field-length normalization should have.A value of 0.0disables normalization completely, and a value of 1.0normalizes fully. The default is 0.75. The practicalities of tuning BM25 are another matter. The default values fork1andbshould be suitable for most document collections, but the optimal values really depend on the collection. Finding good values for your collection is a matter of adjusting, checking, and adjusting again. The similarity algorithm can be set on a per-field basis.It’s just a matter of specifying the chosen algorithmin the field’s mapping: PUT /my_index { "mappings": { "doc": { "properties": { "title": { "type": "string", "similarity": "BM25" }, "body": { "type": "string", "similarity": "default" } } } } Thetitlefield uses BM25 similarity. Thebodyfield uses the default similarity (seeLucene’s Practical Scoring Function). Currently, it is not possible to change thesimilaritymapping for an existing field. You would need to reindex your data in order to do that. Configuring BM25 Configuring a similarity is muchlike configuring an analyzer. Custom similarities can be specified when creating an index. For instance: PUT /my_index { "settings": { "similarity": { "my_bm25": { "type": "BM25", "b": 0 } } }, "mappings": { "doc": { "properties": { "title": { "type": "string", "similarity": "my_bm25" }, "body": { "type": "string", "similarity": "BM25" } } } } } 参考:https://www.elastic.co/guide/en/elasticsearch/guide/current/changing-similarities.html 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6472828.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

【20160924】GOCVHelper MFC增强算法(5)

CStringExportListToExcel(CStringsExcelFile,CListCtrl*pList,CStringstrTitle) { CStringwarningStr; if(pList->GetItemCount()>0){ CDatabasedatabase; CStringsSql; CStringtableName=strTitle; //检索是否安装有Excel驱动"MicrosoftExcelDriver(*.xls)" CStringsDriver; sDriver=GetExcelDriver(); if(sDriver.IsEmpty()) { //没有发现Excel驱动 AfxMessageBox("没有安装Excel!\n请先安装Excel软件才能使用导出功能!"); returnNULL; } ///默认文件名 /*CStringsExcelFile; if(!GetDefaultXlsFileName(sExcelFile)) returnNULL;*/ //创建进行存取的字符串 sSql.Format("DRIVER={%s};DSN='';FIRSTROWHASNAMES=1;READONLY=FALSE;CREATE_DB=\"%s\";DBQ=%s",sDriver,sExcelFile,sExcelFile); //创建数据库(既Excel表格文件) if(database.OpenEx(sSql,CDatabase::noOdbcDialog)) { //创建表结构 inti; LVCOLUMNcolumnData; CStringcolumnName; intcolumnNum=0; CStringstrH; CStringstrV; sSql=""; strH=""; columnData.mask=LVCF_TEXT; columnData.cchTextMax=100; columnData.pszText=columnName.GetBuffer(100); for(i=0;pList->GetColumn(i,&columnData);i++) { if(i!=0) { sSql=sSql+","; strH=strH+","; } sSql=sSql+""+columnData.pszText+"TEXT"; strH=strH+""+columnData.pszText+""; } columnName.ReleaseBuffer(); columnNum=i; sSql="CREATETABLE"+tableName+"("+sSql+")"; database.ExecuteSQL(sSql); //插入数据项 intnItemIndex; for(nItemIndex=0;nItemIndex<pList->GetItemCount();nItemIndex++){ strV=""; for(i=0;i<columnNum;i++) { if(i!=0) { strV=strV+","; } strV=strV+"'"+pList->GetItemText(nItemIndex,i)+"'"; } sSql="INSERTINTO"+tableName +"("+strH+")" +"VALUES("+strV+")"; database.ExecuteSQL(sSql); } } //关闭数据库 database.Close(); returnsExcelFile; } } 图像处理生成了结果,如果需要保存为报表文件,或者想进一步存入数据库中,Excel都是非常好的选择。在这里集成了vc知识库中提供的代码。版权为 ////////////////////////////////////////////////////////////////////////////// //名称:GetExcelDriver //功能:获取ODBC中Excel驱动 //作者:徐景周(jingzhou_xu@163.net) //组织:未来工作室(FutureStudio) //日期:2002.9.1 ///////////////////////////////////////////////////////////////////////////// 使用的时候,只需要将生成的结果填入 CListCtrl 控件中,而后直接到处就可以。也就是把excel输出的问题变成了向 CListCtrl 控件输出的问题。同时代码中还提供了能够直接写到两个sheet中的方法,可供参考 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

【20160924】GOCVHelper MFC增强算法(2)

//创建或续写目录下的csv文件,填写“文件位置-分类”对 intwriteCsv(conststring&filename,constVector<pair<string,string>>srcVect,charseparator){ ofstreamfile(filename.c_str(),ofstream::app); if(!file) return0; for(inti=0;i<srcVect.size();i++){ file<<srcVect[i].first<<separator<<srcVect[i].second<<endl; } returnsrcVect.size(); } //读取目录下的csv文件,获得“文件位置-分类”对 vector<pair<string,string>>readCsv(conststring&filename,charseparator){ pair<string,string>apair; stringline,path,classlabel; vector<pair<string,string>>retVect; ifstreamfile(filename.c_str(),ifstream::in); if(!file) returnretVect; while(getline(file,line)){ stringstreamliness(line); getline(liness,path,separator); getline(liness,classlabel); if(!path.empty()&&!classlabel.empty()){ apair.first=path; apair.second=classlabel; retVect.push_back(apair); } } returnretVect; } csv文件是最为简单的带格式文件。这种格式在opencv的人脸识别教程中得到了使用,这里是扣的它的代码。 //获得ini文件中的值 CStringGetInitString(CStringName1,CStringName2){ charc[100]; memset(c,0,100); CStringcsCfgFilePath; GetModuleFileName(NULL,csCfgFilePath.GetBufferSetLength(MAX_PATH+1),MAX_PATH); csCfgFilePath.ReleaseBuffer(); intnPos=csCfgFilePath.ReverseFind('\\'); csCfgFilePath=csCfgFilePath.Left(nPos); csCfgFilePath+="\\Config"; BOOLbr=GetPrivateProfileString(Name1,Name2,"0",c,100,csCfgFilePath); CStringrstr; rstr.Format("%s",c); returnrstr; } //写入ini问价中的值 voidWriteInitString(CStringName1,CStringName2,CStringstrvalue){ CStringcsCfgFilePath; GetModuleFileName(NULL,csCfgFilePath.GetBufferSetLength(MAX_PATH+1),MAX_PATH); csCfgFilePath.ReleaseBuffer(); intnPos=csCfgFilePath.ReverseFind('\\'); csCfgFilePath=csCfgFilePath.Left(nPos); csCfgFilePath+="\\Config"; BOOLbr=WritePrivateProfileString(Name1,Name2,strvalue,csCfgFilePath); if(!br) TRACE("savewrong"); } 这两个函数主要是用来保存和修改配置文件的。通过直接将配置文件写入.ini中达到这个目标。 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

【20160924】GOCVHelper MFC增强算法(3)

//获得当前目录路径 staticCStringGetLocalPath(){ CStringcsCfgFilePath; GetModuleFileName(NULL,csCfgFilePath.GetBufferSetLength(MAX_PATH+1),MAX_PATH); csCfgFilePath.ReleaseBuffer(); intnPos=csCfgFilePath.ReverseFind('\\'); csCfgFilePath=csCfgFilePath.Left(nPos); returncsCfgFilePath; } //获得.exe路径 staticCStringGetExePath() { CStringstrPath; GetModuleFileName(NULL,strPath.GetBufferSetLength(MAX_PATH+1),MAX_PATH); strPath.ReleaseBuffer(); returnstrPath; } MFC程序涉及的时候存在一个问题,就是某些操作会修改自动"当前路径"的值。这两个函数能够获得当前的路径。 //开机自动运行 staticBOOLSetAutoRun(CStringstrPath,boolflag) { CStringstr; HKEYhRegKey; BOOLbResult; str=_T("Software\\Microsoft\\Windows\\CurrentVersion\\Run"); if(RegOpenKey(HKEY_LOCAL_MACHINE,str,&hRegKey)!=ERROR_SUCCESS) bResult=FALSE; else { _splitpath(strPath.GetBuffer(0),NULL,NULL,str.GetBufferSetLength(MAX_PATH+1),NULL); strPath.ReleaseBuffer(); str.ReleaseBuffer();//str是键的名字 if(flag){ if(::RegSetValueEx(hRegKey,str,0,REG_SZ,(CONSTBYTE*)strPath.GetBuffer(0),strPath.GetLength())!=ERROR_SUCCESS) bResult=FALSE; else bResult=TRUE; }else{ if(::RegDeleteValue(hRegKey,str)!=ERROR_SUCCESS) bResult=FALSE; else bResult=TRUE; } strPath.ReleaseBuffer(); } returnbResult; } 这个无需更多说明。 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

【20160924】GOCVHelper MFC增强算法(4)

//string替换 voidstring_replace(string&strBig,conststring&strsrc,conststring&strdst) { string::size_typepos=0; string::size_typesrclen=strsrc.size(); string::size_typedstlen=strdst.size(); while((pos=strBig.find(strsrc,pos))!=string::npos) { strBig.replace(pos,srclen,strdst); pos+=dstlen; } } 字符串操作一直都是重要的基础操作。在图像处理的过程中,涉及到文件名等变换都需要字符串操作。string_replace中能够成块地换字符。虽然在std中可能已经有相关函数,不过既然我自己的这个用的比较熟悉,就是使用了。 //C++的spilt函数 voidSplitString(conststring&s,vector<string>&v,conststring&c){ std::string::size_typepos1,pos2; pos2=s.find(c); pos1=0; while(std::string::npos!=pos2){ v.push_back(s.substr(pos1,pos2-pos1)); pos1=pos2+c.size(); pos2=s.find(c,pos1); } if(pos1!=s.length()) v.push_back(s.substr(pos1)); } 依然是增强了std中的相关功能,实际使用的时候非常有用。 //!通过文件夹名称获取文件名,不包括后缀 voidgetFileName(conststring&filepath,string&name,string&lastname){ vector<string>spilt_path; SplitString(filepath,spilt_path,"\\"); intspiltsize=spilt_path.size(); stringfilename=""; if(spiltsize!=0){ filename=spilt_path[spiltsize-1]; vector<string>spilt_name; SplitString(filename,spilt_name,"."); intname_size=spilt_name.size(); if(name_size!=0) name=spilt_name[0]; lastname=spilt_name[name_size-1]; } } 前面的函数getfiles能够获得文件的真实路径。那么getFileName能够进一步处理,直接获得图片的名称。很多时候,图片读取了,需要处理一下,这个都是需要的。 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

NET 本地推理三国杀

如果有人告诉你:纯 C# 写的大模型推理引擎,性能已经追平了手工调优的 C++——你会信吗? 这确实发生了。2026 年,.NET 生态里同时出现了三个"本地跑大模型"的方案,而且它们代表了三种完全不同的技术信仰: - **LLamaSharp**:老老实实给 llama.cpp 当"翻译官" - **dotLLM**:不信邪,从张量到 CUDA 内核全部用 C# 重写 - **TensorSharp**:小孩子才做选择,纯托管和原生内核我全都要 我把三个仓库全部拉下来,从代码量、提交记录、官方基准到许可证逐项拆了一遍。结论有点出人意料。 ### 一、先看家底:这不是一个量级的比赛 ||LLamaSharp|dotLLM|TensorSharp| | --- | --- | --- | --- | |诞生时间|2023 年 5 月|2026 年 2 月|2026 年 4 月| |Stars|3759|483|281| |贡献者|约 100 人|基本 1 人|基本 1 人| |许可证|MIT|GPL-3.0 ⚠️|BSD-3| |C# 代码量|2.9 万行|6.6 万行|21 万行| |定位|进程内推理库|库 + 单机服务器|完整推理平台| LLamaSharp 是这里唯一"久经考验"的选手:三年迭代到 v0.28.0,百人社区,还有微软 Semantic Kernel 和 Kernel Memory(RAG)的**官方集成包**。 而 dotLLM 和 TensorSharp 都是 2026 年的新生儿,核心开发者都只有一个人。 **单人项目是这两个新引擎最大的共同风险**——功能再强,选型时也要把"作者哪天不更新了怎么办"算进去。 ### 二、三条路线,三种信仰 **LLamaSharp:借力派。** 它的 C# 层只有 2.9 万行代码,一行内核都不写,全部张量计算通过 P/Invoke 交给 llama.cpp 原生库。好处显而易见:性能 = llama.cpp 本身,CUDA/Metal/Vulkan 全有现成后端包,`Install-Package` 就能跑。代价是能力天花板 = 上游能力 − 封装损耗,新模型支持永远慢 llama.cpp 一步(README 里那张版本映射表就是证据)。 **dotLLM:自立派。** 作者是《Pro .NET Memory Management》的作者、.NET MVP Konrad Kokosa。这个项目的自我定位带着一点挑衅:"not a wrapper around llama.cpp"——分词、采样、量化矩阵乘全部纯 C#,连 GPU 加速都是通过 CUDA Driver API 直接加载 PTX 内核,**零原生共享库依赖**。这意味着它是三者中唯一能做 Native AOT 单文件分发(启动约 50ms)的引擎。 **TensorSharp:合流派。** 作者 Zhongkai Fu 的思路很务实:自研内核还嫩?那就把 GGML 源码直接纳入构建体系,Metal/CUDA/Vulkan 的成熟内核照用,但在此之上加 llama.cpp 默认没有的东西——**vLLM 式连续批处理、张量并行、跨机 TCP 集群、多模态(图/视/音频)、甚至文本扩散和图像编辑**。21 万行 C# + 16 万行 PTX,体量是 dotLLM 的五倍。 ### 三、性能:三家到底谁快? 这里有个陷阱:三家的官方基准各测各的,直接比数字会失真。但交叉解读后,画面其实很清晰: **CPU 解码(最常用场景)**:dotLLM 官方对比 llama.cpp——135M 模型 0.74×、1B 模型 0.95×、3B 模型 **1.01×,已经持平**。纯托管代码在内存带宽主导的解码路径上,确实追上了手工调优的 C++。 **CPU 预填充(长提示词场景)**:dotLLM 仍是 0.32×–0.57×,差距约 2-3 倍。作者很诚实,直接写在文档里并给了追赶路线。 **GPU 吞吐**:TensorSharp 和 llama.cpp 在同一块 RTX 3080、同一 GGML 后端上硬碰硬——Gemma 4 预填充 **1.28×**、首 token 延迟 **1.27×**,多轮对话最高 **1.49×**。落后的格子(Vulkan MoE 0.87×)也如实列着。它的赢法不是内核更快,而是**调度层更聪明**:连续批处理 + 前缀共享。 一句话总结水位: > 开箱即得的绝对性能,LLamaSharp ≈ TensorSharp(都在跑 ggml 系内核,后者高并发场景还能反超);dotLLM 在 CPU 解码追平了绑定派,其余场景仍在追赶——但它换来了另外两家给不了的东西:**零原生依赖**。 ### 四、许可证:可能一票否决的那一行 三个项目恰好占了三个档位: - ✅ **LLamaSharp:MIT**——随便用 - ✅ **TensorSharp:BSD-3**——随便用 - ⚠️ **dotLLM:GPL-3.0**——通过 NuGet 引用嵌进闭源商业产品,有 copyleft 合规障碍;以独立进程部署、走 HTTP API 调用则通常没问题 对很多公司来说,这一项就直接决定了 dotLLM 能不能进选型名单——和技术好坏无关。 ### 五、怎么选?一张表说清 |你的情况|选谁| | --- | --- | |生产环境求稳,要有人能问|LLamaSharp| |已经用了 Semantic Kernel / Kernel Memory|LLamaSharp(唯一官方集成)| |闭源商用内嵌|LLamaSharp 或 TensorSharp| |纯 CPU、零原生依赖、边缘部署、AOT 单文件|dotLLM(唯一选项)| |GPU 高并发服务(多用户同时请求)|TensorSharp(连续批处理默认开启)| |AMD/Intel 显卡、macOS Metal|LLamaSharp 或 TensorSharp(dotLLM 没这后端)| |多模态、超大 MoE(284B)、多卡多机|TensorSharp| |可解释性研究(logit lens、激活捕获)|dotLLM| |想学"怎么从零写一个推理引擎"|中文读者选 TensorSharp(有配套书),性能工程爱好者选 dotLLM| **求稳选 LLamaSharp,求纯选 dotLLM,求全选 TensorSharp。** ### 六、写在最后 LLamaSharp 用三年时间证明:.NET 可以"借"llama.cpp 的力站稳本地推理。 dotLLM 和 TensorSharp 在 2026 年同时出现,则说明这个社区开始提出更高的要求——**部署自由度和平台化能力**,这恰恰是绑定路线给不了的。 三家并存,比任何一家独大都更能说明问题:C# 在本地大模型推理这件事上,已经不缺答案了。 --- *数据说明:本文所有数据来自 2026-08-02 当日拉取的三仓库源码与官方文档;性能数字均为各项目自报基准,实际表现因硬件与负载而异,选型前请自行复测。* **觉得有用,转给正在做 .NET AI 技术选型的同事——可能正好帮到 TA。** ---

优秀的个人博客,低调大师

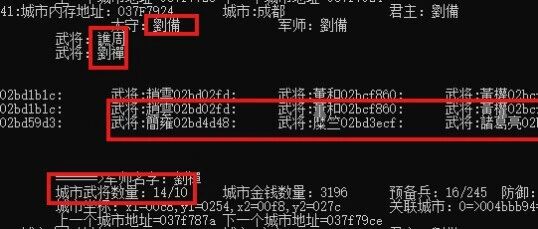
三国群英传2城市和武将的数据关系

城市和武将的关系是典型的一对多的关系,一个城市中有多个武将,一个武将只能在一个城市中。 在这种数据的关系下,一般是两种情况吧。 第一种情况,一对多的关系中,多中保存一的主键,也就是在武将中保存城市的地址; 第二种情况,一中用数组(链表)来存储多,也就是城市中用数组或链表来存储各个武将信息的地址。 其实,通过分析发现它们两种方式都使用了。具体如下: ![](https://developer.qcloudimg.com/http-save/yehe-2278623/dfa4616c48da1b22669b348f000bcd36.png) 城市中有武将的信息,武将之间是个链表,但是貌似不是一条链表,因此此时中武将数量多的时候,武将的信息拿不全。(还得继续分析分析) 另外一点是,武将的信息中也的确保存了所属城市的地址。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册