首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10000篇文章
优秀的个人博客,低调大师

把同步爬虫改成 asyncio 之后,我的单机 QPS 从 12 涨到 380

最近在帮一个做电商比价的客户搞数据采集,他家有个老脚本跑了快两年了,最近频频超时。打开一看,差点没把咖啡喷到键盘上——所有接口都是 requests.get 一把梭,串行循环,单机一天能跑 12 个任务就已经是极限。我接手之后花了两周把它整个改成 asyncio + aiohttp 的版本,最后稳定在单机 380 QPS。这篇文章把那段时间踩过的坑全写下来,给以后接手类似活的朋友们一个参考。

优秀的个人博客,低调大师

爬虫大佬,把他总结的正则表达式使用给我了!

持续坚持原创输出,点击蓝字关注我吧 作者:小傅哥博客:https://bugstack.cn ❝ 沉淀、分享、成长,让自己和他人都能有所收获!😜 ❞ 目录 一、前言 二、规则 1. 常用符号 2. 字母字符 3. 预定义字符 4. POSIX 字符 5. Character 类 6. Unicode 块和类别的类 7. 边界匹配器 8. Greedy 数量词 9. Reluctant 数量词 10. Possessive 数量词 11. Logical 运算符 12. Back 引用 13. 引用 14. 特殊构造(非捕获) 三、案例 四、总结 五、系列推荐 一、前言 编程总在实践中出结果! 正则表达式,又称规则表达式。(英语:Regular Expression,在代码中常简写为regex、regexp或RE),计算机科学的一个概念。正则表达式通常被用来检索、替换那些符合某个模式(规则)的文本。 正则引擎主要可以分为两大类:一种是DFA,一种是NFA。这两种引擎都有了很久的历史(至今二十多年),当中也由这两种引擎产生了很多变体!于是POSIX的出台规避了不必要变体的继续产生。这样一来,主流的正则引擎又分为3类:一、DFA,二、传统型NFA,三、POSIX NFA。 正则也是一种非常有意思的技术,但往往不知道这些符号的编程在实际使用中该如何使用,因此总结了本篇文章,方便所有小伙伴可以当成一个工具文章使用,方便处理一些需要使用正则的技术内容。 二、规则 1. 常用符号 x 字符 x \ 反斜线字符 \0n 带有八进制值 0 的字符 n (0 <= n <= 7) \0nn 带有八进制值 0 的字符 nn (0 <= n <= 7) \0mnn 带有八进制值 0 的字符 mnn(0 <= m <= 3、0 <= n <= 7) \xhh 带有十六进制值 0x 的字符 hh \uhhhh 带有十六进制值 0x 的字符 hhhh \t 制表符 ('\u0009') \n 新行(换行)符 ('\u000A') \r 回车符 ('\u000D') \f 换页符 ('\u000C') \a 报警 (bell) 符 ('\u0007') \e 转义符 ('\u001B') 2. 字母字符 [abc] a、b 或 c(简单类) [^abc] 任何字符,除了 a、b 或 c(否定) [a-zA-Z] a 到 z 或 A 到 Z,两头的字母包括在内(范围) [a-d[m-p]] a 到 d 或 m 到 p:[a-dm-p](并集) [a-z&&[def]] d、e 或 f(交集) [a-z&&[^bc]] a 到 z,除了 b 和 c:[ad-z](减去) [a-z&&[^m-p]] a 到 z,而非 m 到 p:[a-lq-z](减去) 3. 预定义字符 . 任何字符(与行结束符可能匹配也可能不匹配) \d 数字:[0-9] \D 非数字:[^0-9] \s 空白字符:[ \t\n\x0B\f\r] \S 非空白字符:[^\s] \w 单词字符:[a-zA-Z_0-9] \W 非单词字符:[^\w] 4. POSIX 字符 \p{Lower} 小写字母字符:[a-z] \p{Upper} 大写字母字符:[A-Z] \p{ASCII} 所有 ASCII:[\x00-\x7F] \p{Alpha} 字母字符:[\p{Lower}\p{Upper}] \p{Digit} 十进制数字:[0-9] \p{Alnum} 字母数字字符:[\p{Alpha}\p{Digit}] \p Punct} 标点符号:!"#$%&'()*+,-./:;<=>?@[]^_`{~ \p{Graph} 可见字符:[\p{Alnum}\p{Punct}] \p{Print} 可打印字符:[\p{Graph}\x20] \p{Blank} 空格或制表符:[ \t] \p{Cntrl} 控制字符:[\x00-\x1F\x7F] \p{XDigit} 十六进制数字:[0-9a-fA-F] \p{Space} 空白字符:[ \t\n\x0B\f\r] 5. Character 类 \p{javaLowerCase} 等效于 java.lang.Character.isLowerCase() \p{javaUpperCase} 等效于 java.lang.Character.isUpperCase() \p{javaWhitespace} 等效于 java.lang.Character.isWhitespace() \p{javaMirrored} 等效于 java.lang.Character.isMirrored() 6. Unicode 块和类别的类 \p{InGreek} Greek 块(简单块)中的字符 \p{Lu} 大写字母(简单类别) \p{Sc} 货币符号 \P{InGreek} 所有字符,Greek 块中的除外(否定) [\p{L}&&[^\p{Lu}]] 所有字母,大写字母除外(减去) 7. 边界匹配器 ^ 行的开头 $ 行的结尾 \b 单词边界 \B 非单词边界 \A 输入的开头 \G 上一个匹配的结尾 \Z 输入的结尾,仅用于最后的结束符(如果有的话) \z 输入的结尾 8. Greedy 数量词 X? X,一次或一次也没有 X* X,零次或多次 X+ X,一次或多次 X{n} X,恰好 n 次 X{n,} X,至少 n 次 X{n,m} X,至少 n 次,但是不超过 m 次 9. Reluctant 数量词 X?? X,一次或一次也没有 X*? X,零次或多次 X+? X,一次或多次 X{n}? X,恰好 n 次 X{n,}? X,至少 n 次 X{n,m}? X,至少 n 次,但是不超过 m 次 10. Possessive 数量词 X?+ X,一次或一次也没有 X*+ X,零次或多次 X++ X,一次或多次 X{n}+ X,恰好 n 次 X{n,}+ X,至少 n 次 X{n,m}+ X,至少 n 次,但是不超过 m 次 11. Logical 运算符 XY X 后跟 Y X|Y X 或 Y (X) X,作为捕获组 12. Back 引用 \n 任何匹配的 nth 捕获组 13. 引用 \ Nothing,但是引用以下字符 \Q Nothing,但是引用所有字符,直到 \E \E Nothing,但是结束从 \Q 开始的引用 14. 特殊构造(非捕获) (?:X) X,作为非捕获组 (?idmsux-idmsux) Nothing,但是将匹配标志i d m s u x on - off (?idmsux-idmsux:X) X,作为带有给定标志 i d m s u x on - off 的非捕获组 (?=X) X,通过零宽度的正 lookahead (?!X) X,通过零宽度的负 lookahead (?<=X) X,通过零宽度的正 lookbehind (?<!X) X,通过零宽度的负 lookbehind (?>X) X,作为独立的非捕获组 三、案例 1. 字符匹配 "a".matches(".") 结果:true 描述:. 匹配任意字符 "a".matches("[abc]") 结果:true 描述:包含 abc 任意一个字符都匹配,默认匹配一次 "a".matches("[^abc]") 结果:true 描述:任何字符,除了 a、b 或 c(否定) "A".matches("[a-zA-Z]") 结果:false 描述:a 到 z 或 A 到 Z,两头的字母包括在内(范围) "A".matches("[a-z]|[A-Z]") 结果:true 描述:a 到 z 或 A 到 Z,两头的字母包括在内(范围) "A".matches("[a-z(A-Z)]") 结果:true 描述:a-z,A-Z,匹配范围相同,括号是捕获组 "R".matches("[A-Z&&(RFG)]") 结果:true 描述:匹配 A-Z 与 RFG 交集 "a_8".matches("\\w{3}") 结果:true 描述:\w 单词字符等同于 [a-zA-Z_0-9],{3} 匹配三次 "\\".matches("\\\\") 结果:true 描述:\ 表示的是一个 \ "hellosir".matches("h.*") 结果:true 描述:. 任何字符,* 匹配零次到多次 "hellosir".matches(".*ir$") 结果:true 描述:.* 匹配任意字符 ir$ 确定匹配行的结尾 "hellosir".matches("^h[a-z]{1,3}o\\b.*") 结果:true 描述:^h 匹配开头,[a-z]{1,3}o 匹配1到3次的a-z之后匹配字母o,\b 并不匹配这些单词分隔字符中的任何一个,它只匹配一个位置。匹配的是o后面的位置。 "hellosir".matches("^h[a-z]{1,3}o\\b.*") 结果:false 描述:o后面跟着s,是字母,不是空格,\b 不能匹配单词的o的边界。 "\n".matches("^[\\s&&[^\\n]]*\\n$") 结果:true 描述:匹配开头是一个空格 ^[\\s&&[^\\n]],且不能是换行符,最后必须是换行 \\n$ System.out.println("java".matches("(?i)JAVA")); 结果:true 描述:(?i)非捕获组里面这个表示忽略大小写 2. 模式匹配 2.1 验证匹配 Patternp=Pattern.compile("[a-z]{3,}");Matcherm=p.matcher("fgha");System.out.println(m.matches());//true,匹配字符3次及以上 结果:true 描述:Pattern 与 Matcher 一起合作 .Matcher 类提供了对正则表达式的分组支持,以及对正则表达式的多次匹配支持.。单独用Pattern只能使用 Pattern.matches(String regex,CharSequence input) 一种最基础最简单的匹配。 2.2 匹配功能 Patternp=Pattern.compile("\\d{3,5}");Matcherm=p.matcher("123-4536-89789-000");System.out.println(m.matches());m.reset();//把吃进去的字符吐出来重新匹配,否经过m2.matches会吃进去字符下面的匹配就不成功System.out.println(m.find());System.out.println(m.start()+"-"+m.end());//找到了就把首位位置打印下(必须找到才能打印)System.out.println(m.find());System.out.println(m.start()+"-"+m.end());//找到了就把首位位置打印下(必须找到才能打印)System.out.println(m.find());System.out.println(m.start()+"-"+m.end());//找到了就把首位位置打印下(必须找到才能打印)System.out.println(m.find());System.out.println(m.lookingAt());//每次都是才头上开始找 测试结果 falsetrue0-3true4-8true9-14truetrue m.matches(),是全量匹配 m.reset(),把吃进去的字符吐出来重新匹配,否经过m2.matches会吃进去字符 下面的匹配就不成功 m.find(),查找匹配 m.start(),匹配到的字符串,开始位置 m.end(),匹配到的字符串,结束位置 2.3 匹配普通替换 Patternp=Pattern.compile("java",Pattern.CASE_INSENSITIVE);Matcherm=p.matcher("java_Java_jAva_jAVa_IloveJava");System.out.println(m.replaceAll("JAVA")); 结果:JAVA_JAVA_JAVA_JAVA_IloveJAVA 描述:把所有匹配到的小写字母 java、JavA,都匹配为大写 2.4 匹配逻辑替换 Patternp=Pattern.compile("java",Pattern.CASE_INSENSITIVE);Matcherm=p.matcher("java_Java_jAva_jAVa_IloveJavafdasfas");StringBuffersb=newStringBuffer();inti=0;while(m.find()){i++;if(i%2==0){m.appendReplacement(sb,"java");}else{m.appendReplacement(sb,"JAVA");}}m.appendTail(sb);System.out.println(sb); 结果:JAVA_java_JAVA_java_IloveJAVA fdasfas 描述:按照程序逻辑 i % 2,进行单双数替换匹配 2.4 分组匹配 Patternp=Pattern.compile("(\\d{3,5})([a-z]{2})");Matcherm=p.matcher("123bb_78987dd_090po");while(m.find()){System.out.println(m.group(1));} 结果: 12378987090Processfinishedwithexitcode0 描述:分组加括号只取数字一组,grop括号里面第0组是整体,第一组是左起第一个括号,第二组是左起第二个括号 2.5 贪婪的匹配与不贪婪匹配 Patternp=Pattern.compile("(.{3,10}?)[0-9]");Matcherm=p.matcher("aaaa5dddd8");while(m.find()){System.out.println(m.start()+"-"+m.end());} 结果: 0-55-10Processfinishedwithexitcode0 描述:.{3,10}后面没问号就是贪婪匹配会配到最长,如果{3,10}?加?号就是懒蛋匹配之匹配最少的,从3个开始找。如果这里用if(m.find)(){m.start()+"-"+m.end()} 那么之匹配第一个 2.6 普通捕获 Patternp=Pattern.compile(".{3}");Matcherm=p.matcher("ab4dd5");while(m.find()){System.out.println(m.group());} 结果: ab45-10Processfinishedwithexitcode0 描述:每次匹配三个任意字符,用 m.group() 输出。 2.7 非捕获组(?=a) Patternp=Pattern.compile(".{3}(?=a)");Matcherm=p.matcher("ab4add5");while(m.find()){System.out.println("后面不能是a的:"+m.group());} 结果: 后面不能是a的:ab4 描述:(?=a)这个是非捕获组的意思,最后一个是a而且还不把这个a取出来!!(?=a)这个要是写在前面就不一样了 Patternp=Pattern.compile("(?!a).{3}");Matcherm=p.matcher("abbsab89");while(m.find()){System.out.println("前面不能是a的:"+m.group());} 结果:前面不能是a的:bbs、前面不能是a的:b89 描述:(?!a)前面不能是a的,所以找到整个字符串中 bbs、b89 2.8 去除><号匹配 Patternp=Pattern.compile("(?!>).+(?=<)");Matcherm=p.matcher(">小傅哥<");while(m.find()){System.out.println(m.group());} 结果:小傅哥 描述:一般可以匹配网页中的特殊字符串里面的内容信息。 2.9 向前引用 Patternp=Pattern.compile("(\\d\\d)\\1");Matcherm=p.matcher("1212");System.out.println(m.matches()); 结果:true 描述:这里面的1是向前引用,12是第一匹配到的,下一次在匹配出来12和前面相同 所以是true 四、总结 正则中包括了很多的符号、类型、匹配范围、匹配数量、匹配原则等等,像贪婪、排除、向前引用等等,这些个使用方法其实也不难,只要按照正则的标准就可以组合出你想要匹配和拦截出来的字符串内容信息。 五、系列推荐 握草,你竟然在代码里下毒! 程序员为什么热衷于造轮子,升职加薪吗? BATJTMD,大厂招聘,都招什么样Java程序员? 工作3年,看啥资料能月薪30K? 数学,离一个程序员有多近? - END - 下方扫码关注 bugstack虫洞栈,与小傅哥一起学习成长、共同进步,做一个码场最贵Coder! 回复【设计模式】,下载《重学Java设计模式》,这是一本互联网真实案例的实践书籍,从实际业务中抽离出,交易、营销、秒杀、中间件、源码等众多场景进行学习代码设计。 回复【面经手册】,下载《面经手册•拿大厂Offer》,这是一本有深度的Java核心内容,从数据结构、算法、并发编程以及JVM系8不断深入讲解,让懂了就是真的懂。 你好,我是小傅哥。一线互联网 java 工程师、架构师,开发过交易&营销、写过运营&活动、设计过中间件也倒腾过中继器、IO板卡。不只是写Java语言,也搞过C#、PHP,是一个技术活跃的折腾者。 2020年写了一本PDF 《重学Java设计模式》 ,全网下载量30万+,帮助很多同学成长。同年 github 的两个项目, CodeGuide 、 itstack-demo-design ,持续霸榜 Trending,成为全球热门项目 本文分享自微信公众号 - bugstack虫洞栈(bugstack)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

16、web爬虫讲解2—PhantomJS虚拟浏览器+selenium模块操作PhantomJS

【http://bdy.lqkweb.com】 【http://www.swpan.cn】 【转载自:http://www.lqkweb.com】 PhantomJS虚拟浏览器 phantomjs 是一个基于js的webkit内核无头浏览器 也就是没有显示界面的浏览器,利用这个软件,可以获取到网址js加载的任何信息,也就是可以获取浏览器异步加载的信息 下载网址:http://phantomjs.org/download.html 下载对应系统版本 下载后解压PhantomJS文件,将解压文件夹,剪切到python安装文件夹 然后将PhantomJS文件夹里的bin文件夹添加系统环境变量 cdm 输入命令:PhantomJS 出现以下信息说明安装成功 selenium模块是一个python操作PhantomJS软件的一个模块 selenium模块PhantomJS软件 webdriver.PhantomJS()实例化PhantomJS浏览器对象get('url')访问网站find_element_by_xpath('xpath表达式')通过xpath表达式找对应元素clear()清空输入框里的内容send_keys('内容')将内容写入输入框click()点击事件get_screenshot_as_file('截图保存路径名称')将网页截图,保存到此目录page_source获取网页htnl源码quit()关闭PhantomJS浏览器 #!/usr/bin/envpython #-*-coding:utf8-*- fromseleniumimportwebdriver#导入selenium模块来操作PhantomJS importos importtime importre llqdx=webdriver.PhantomJS()#实例化PhantomJS浏览器对象 llqdx.get("https://www.baidu.com/")#访问网址 #time.sleep(3)#等待3秒 #llqdx.get_screenshot_as_file('H:/py/17/img/123.jpg')#将网页截图保存到此目录 #模拟用户操作 llqdx.find_element_by_xpath('//*[@id="kw"]').clear()#通过xpath表达式找到输入框,clear()清空输入框里的内容 llqdx.find_element_by_xpath('//*[@id="kw"]').send_keys('叫卖录音网')#通过xpath表达式找到输入框,send_keys()将内容写入输入框 llqdx.find_element_by_xpath('//*[@id="su"]').click()#通过xpath表达式找到搜索按钮,click()点击事件 time.sleep(3)#等待3秒 llqdx.get_screenshot_as_file('H:/py/17/img/123.jpg')#将网页截图,保存到此目录 neir=llqdx.page_source#获取网页内容 print(neir) llqdx.quit()#关闭浏览器 pat="<title>(.*?)</title>" title=re.compile(pat).findall(neir)#正则匹配网页标题 print(title) PhantomJS浏览器伪装,和滚动滚动条加载数据 有些网站是动态加载数据的,需要滚动条滚动加载数据 实现代码 DesiredCapabilities伪装浏览器对象execute_script()执行js代码 current_url获取当前的url #!/usr/bin/envpython #-*-coding:utf8-*- fromseleniumimportwebdriver#导入selenium模块来操作PhantomJS fromselenium.webdriver.common.desired_capabilitiesimportDesiredCapabilities#导入浏览器伪装模块 importos importtime importre dcap=dict(DesiredCapabilities.PHANTOMJS) dcap['phantomjs.page.settings.userAgent']=('Mozilla/5.0(WindowsNT10.0;WOW64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/49.0.2623.221Safari/537.36SE2.XMetaSr1.0') print(dcap) llqdx=webdriver.PhantomJS(desired_capabilities=dcap)#实例化PhantomJS浏览器对象 llqdx.get("https://www.jd.com/")#访问网址 #模拟用户操作 forjinrange(20): js3='window.scrollTo('+str(j*1280)+','+str((j+1)*1280)+')' llqdx.execute_script(js3)#执行js语言滚动滚动条 time.sleep(1) llqdx.get_screenshot_as_file('H:/py/17/img/123.jpg')#将网页截图,保存到此目录 url=llqdx.current_url print(url) neir=llqdx.page_source#获取网页内容 print(neir) llqdx.quit()#关闭浏览器 pat="<title>(.*?)</title>" title=re.compile(pat).findall(neir)#正则匹配网页标题 print(title) 【转载自:http://www.lqkweb.com】

优秀的个人博客,低调大师

Python爬虫入门教程 20-100 慕课网免费课程抓取

1. 慕课网免费课程-写在前面 美好的一天又开始了,今天咱继续爬取IT在线教育类网站,慕课网,这个平台的数据量并不是很多,所以爬取起来还是比较简单的 2. 慕课网免费课程准备爬取 打开我们要爬取的页面,寻找分页点和查看是否是异步加载的数据。 进行了一些相应的分析,发现并没有异步数据,只需要模拟翻页就,在进行HTML的解析就可以获取数据了,翻页数据如下,合计32页,在数据量上属于非常小的了。 https://www.imooc.com/course/list?page=1 https://www.imooc.com/course/list?page=2 .... https://www.imooc.com/course/list?page=32 3. 慕课网免费课程编写代码 代码分为自动拼接URL,解析HTML,存储到mongodb三个部分组成

优秀的个人博客,低调大师

python爬虫项目实战,爬取用户的信息,让你更好的筛选

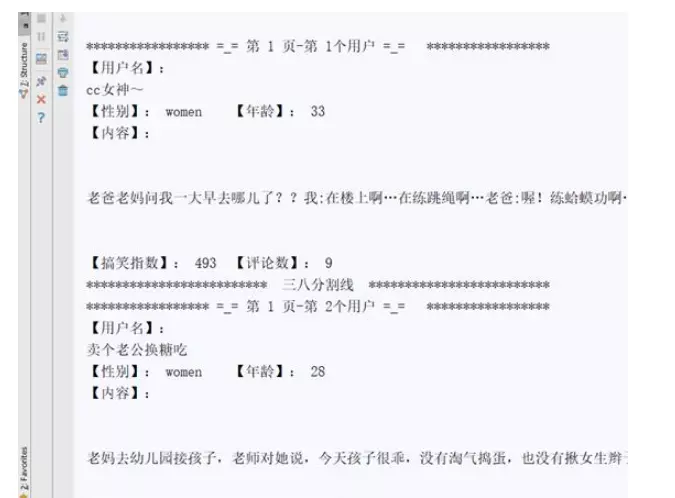
1.导入模块 import urllib.request from bs4 import BeautifulSoup 2.添加头文件,防止爬取过程被拒绝链接 def qiuShi(url,page): ################### 模拟成高仿度浏览器的行为 ############## # 设置多个头文件参数,模拟成高仿度浏览器去爬取网页 heads ={ 'Connection':'keep-alive', 'Accept-Language':'zh-CN,zh;q=0.9', 'Accept':'text/html,application/xhtml+xml,application/xml; q=0.9,image/webp,image/apng,*/*;q=0.8', 'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36', } headall = [] for key,value in heads.items(): items = (key,value) # 将多个头文件参数一个一个添加到headall列表中 headall.append(items) # print(headall) # print('测试1--') # 创建opener对象 opener = urllib.request.build_opener() # 添加头文件到opener对象 opener.addheaders = headall # 将opener对象设置成全局模式 urllib.request.install_opener(opener) # 爬取网页并读取数据到data data = opener.open(url).read().decode() # data1 = urllib.request.urlopen(url).read().decode('utf-8') # print(data1) # print('测试2--') ################## end ######################################## 3.创建soup解析器对象 soup = BeautifulSoup(data,'lxml') x = 0 4.开始使用BeautifulSoup4解析器提取用户名信息 ############### 获取用户名 ######################## name = [] # 使用bs4解析器提取用户名 unames = soup.find_all('h2') # print('测试3--',unames) for uname in unames: # print(uname.get_text(),'第',page,'-',str(x)+'用户名:',end='') # 将用户名一个一个添加到name列表中 name.append(uname.get_text()) # print(name) # print('测试4--') #################end############################# 5.提取发表的内容信息 发表的内容 cont = [] data4 = soup.find_all('div',class_='content') # print(data4) # 记住二次筛选一点要转换成字符串形式,否则报错 data4 = str(data4) # 使用bs4解析器提取内容 soup3 = BeautifulSoup(data4,'lxml') contents = soup3.find_all('span') for content in contents: # print('第',x,'篇糗事的内容:',content.get_text()) # 将内容一个一个添加到cont列表中 cont.append(content.get_text()) # print(cont) # print('测试5--') ##############end#################################### **6.提取搞笑指数** #################搞笑指数########################## happy = [] # 获取搞笑指数 # 第一次筛选 data2 = soup.find_all('span',class_="stats-vote") # 获取搞笑指数 # 第二次筛选 data2 = str(data2) # 将列表转换成字符串形式才可以使用 # print(data2) # print('测试6--') soup1 = BeautifulSoup(data2,'lxml') happynumbers = soup1.find_all('i',class_="number") for happynumber in happynumbers: # print(happynumber.get_text()) # 将将搞笑数一个一个添加到happy列表中 happy.append(happynumber.get_text()) # print(happy) # print('测试7--') ##################end############################# 如果你跟我一样都喜欢python,想成为一名优秀的程序员,也在学习python的道路上奔跑,欢迎你加入python学习群:python群号:491308659 验证码:南烛群内每天都会分享最新业内资料,分享python免费课程,共同交流学习,让学习变(编)成(程)一种习惯! 7.提取评论数 ############## 评论数 ############################ comm = [] data3 = soup.find_all('a',class_='qiushi_comments') data3 = str(data3) # print(data3) soup2 = BeautifulSoup(data3,'lxml') comments = soup2.find_all('i',class_="number") for comment in comments: # print(comment.get_text()) # 将评论数一个一个添加到comm列表中 comm.append(comment.get_text()) ############end##################################### 8.使用正则表达式提取性别和年龄 ######## 获取性别和年龄 ########################## # 使用正则表达式匹配性别和年龄 pattern1 = '<div class="articleGender (w*?)Icon">(d*?)</div>' sexages = re.compile(pattern1).findall(data) # print(sexages) 9.设置用户所有信息输出的格局设置 ################## 批量输出用户的所以个人信息 ################# print() for sexage in sexages: sa = sexage print('*'*17, '=_= 第', page, '页-第', str(x+1) + '个用户 =_= ','*'*17) # 输出用户名 print('【用户名】:',name[x],end='') # 输出性别和年龄 print('【性别】:',sa[0],' 【年龄】:',sa[1]) # 输出内容 print('【内容】:',cont[x]) # 输出搞笑数和评论数 print('【搞笑指数】:',happy[x],' 【评论数】:',comm[x]) print('*'*25,' 三八分割线 ','*'*25) x += 1 ###################end########################## 10.设置循环遍历爬取13页的用户信息 for i in range(1,14): # 糗事百科的网址 url = 'https://www.qiushibaike.com/8hr/page/'+str(i)+'/' qiuShi(url,i) 运行结果,部分截图:
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册