首页 文章 精选 留言 我的

精选列表

搜索[栈],共10000篇文章
优秀的个人博客,低调大师

2026 主流技术栈:hermes agent多环境安装配置:Windows/Mac/Linux

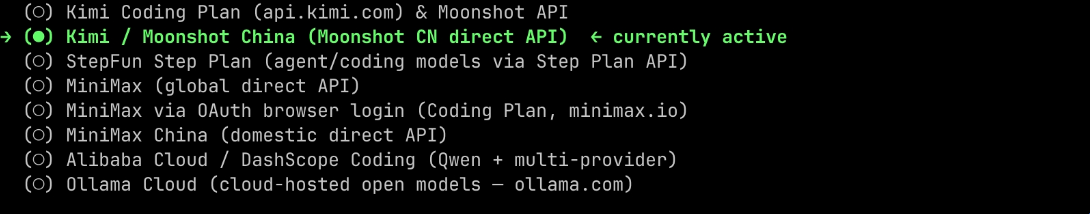
一、Hermes agent 大模型选择 Hermes Agent 通过统一的模型抽象层接入不同厂商的大语言模型服务。实际部署时,建议根据数据合规要求、任务类型和成本预算进行选型。 1.1 国内场景:Kimi K2.6 对于数据需境内处理或存在私有化部署需求的场景,Kimi K2.6 是社区部署验证较多的选项。该模型支持超长上下文窗口,在长链路任务中能够保持相对连贯的状态跟踪,降低中途信息丢失的概率。其原生 Function Calling 实现较为成熟,在多工具协同编排时异常率较低,适合需要频繁调用外部工具的工作流。中文指令理解与本土业务文档解析的精度较高,能够适配国内办公自动化场景。并发场景下,多 Agent 同时运行的限流与超时风险相对可控。私有化部署方案支持内网数据闭环,符合政企安全合规要求。从成本角度看,其 Token 利用率与定价在同类模型中处于较低区间,适合高频调用的生产环境。 1.2 海外场景:OpenAI GPT 系列 若任务涉及复杂逻辑推理、英文内容处理或多模态输入,可考虑接入 OpenAI GPT-3.5/4。该系列在任务拆解与复杂逻辑链处理方面能力较强,支持图像理解与图文混合内容处理,且第三方工具集成生态较为完善。 接入海外模型需确保网络可达,并评估数据跨境传输的合规风险。 二、前置准备 部署前请确认以下环境依赖已就绪: Git:版本不低于 2.0,用于源码拉取与后续版本更新。 API 凭证:已申请 Kimi(Moonshot AI)或 OpenAI 的 API Key。 Windows 环境:如使用 Windows,需预先配置 WSL2;安装脚本执行期间将请求系统管理员权限以完成环境配置。 三、安装 hermes agent 1.1 Windows 详细安装教程 方式一:WSL2 安装(推荐新手使用) 检查 Windows 版本:WSL2 需要 Windows 10(版本 2004 或更高)或 Windows 11。 选择终端 (管理员) 或 Windows PowerShell (管理员),在 UAC 弹窗点击 “是”。 安装 WSL2,在 PowerShell 里输入这条命令,然后按回车: wsl --install 注意:等待安装完成,可能需要几分钟。完成后会提示你重启电脑。 重启后设置 Linux 用户名和密码 在 WSL2 里安装 Hermes Agent,现在你已经在 Ubuntu 里了,输入这条命令: curl -fsSL https://ghfast.top/https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.sh | bash 等几分钟,安装完成后输入: source ~/.bashrc hermes 看到欢迎界面就成功了! 方式二:PowerShell 原生安装 打开 PowerShell:按 Win 键,输入PowerShell,点击"Windows PowerShell"。(这次不需要管理员权限) 运行安装命令,复制下面这行,粘贴到 PowerShell 里,按回车: irm https://ghfast.top/https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.ps1 | iex 等待安装完成:安装过程可能需要 3-5 分钟,期间会自动下载 Python、Node.js 等依赖。看到"Installation complete"就成功了。 1.2 macOS 详细安装教程 克隆项目到本地 git clone https://gitcode.com/GitHub_Trending/he/hermes-agent.git 将下面代码复制到安装目录 mkdir -p ~/.hermes cp -r ~/hermes-agent ~/.hermes/hermes-agent 进入目录并执行安装脚本 cd ~/.hermes/hermes-agent && bash scripts/install.sh 重载环境变量 # Zsh 用户执行source ~/.zshrc # Bash 用户执行(二选一)# source ~/.bashrc 1.3 Linux 详细安装教程 克隆项目到本地 git clone https://gitcode.com/GitHub_Trending/he/hermes-agent.git 将下面代码复制到安装目录 mkdir -p ~/.hermes cp -r ~/hermes-agent ~/.hermes/hermes-agent 进入目录并执行安装脚本 cd ~/.hermes/hermes-agent && bash scripts/install.sh 重载环境变量 # source ~/.zshrc 四、Kimi 大模型接入配置向导 安装完成后,运行 hermes 命令,你会看到一个配置向导界面。输入 1 并按回车,进入快速设置模式。 1、选择模型提供商 在这一步内,可以选择你想使用的 AI 模型提供商。 **国内用户推荐选择 Kimi(Moonshot):**在国内网络环境下,Kimi 凭借稳定的连接速度、出色的中文语义理解能力和高性价比,成为绝大多数开发者部署 Hermes Agent 的优选方案。 **海外用户选择 OpenRouter、Anthropic **等海外主流模型平台,全球网络连通稳定流畅。这类平台模型性能强劲、接口兼容性高,能充分满足海外场景下智能代理的各类运行需求 2、输入 API 密钥 选择提供商后,系统会提示你输入 API 密钥,以 Kimi 提供商为例展示获取方式: 登录 Kimi 网站获取 API Key,访问https://platform.moonshot.cn/console点击登录 点击左侧的 API Key 管理,创建 API Key,复制弹出的密钥字符 回到 hermes agent 继续配置 3、选择默认模型 将复制的 API Key 贴入终端并敲击回车,然后选择 Moonshot/Kimi-K2.6 模型并敲击回车确认。 4、配置工具 接下来会询问你想启用哪些工具。新手建议先启用基础工具: web # 网络搜索和网页提取 terminal # 执行命令 file # 读写文件 browser # 浏览器自动化(可选) 5、配置完成 全部配置完成后,就可以开始对话啦~ 6、安装后的第一件事 装好之后,我建议你立刻做一件事:设置持久记忆。 在对话中输入——hermes "请记住:我的主力编程语言是 Python,我偏好使用 Docker 部署服务,回复请用中文" Hermes Agent 会把这些偏好写入持久记忆文件。之后每次对话,它都会带着这些上下文,让回复更贴合你的习惯。 你也可以直接编辑 ~/.hermes/memory/prompt.md 文件,手动写入你的偏好信息。记住这个文件有 3575 字符的限制,言简意赅就好。 五、常见问题及解决办法 1、环境准备类问题(Windows 用户高发) Windows 直接安装失败(未用 WSL2) 错误表现:安装脚本报错、命令无法执行、界面无响应 核心原因:Hermes Agent 仅支持 Linux/macOS/WSL2,不支持 Windows 原生 PowerShell/CMD 解决方案: # 以管理员身份运行PowerShell,启用WSL2 wsl --install -d Ubuntu # 安装后设置默认启动WSL wsl --set-default Ubuntu 2、网络与资源下载问题(国内用户常见) 官方脚本下载失败(GitHub 访问受限) 错误表现:curl: (7) Failed to connect to ``raw.githubusercontent.com 核心原因:国内网络无法直接访问 GitHub 资源 解决方案: 方法 1(推荐):使用离线安装包 cd /mnt/d/Downloads # 进入安装包目录 sudo apt install -y unzipunzip hermes-agent-2026.4.8.zip cd hermes-agent && bash install.sh 方法 2:配置代理后重试 ``` export http_proxy=http://代理地址:端口 export https_proxy=http://代理地址:端口 curl -sSL https://get.hermesagent.com | bash Python 依赖安装超时(PyPI 访问慢) 错误表现:pip install长时间卡住、ReadTimeoutError 解决方案:使用国内镜像源加速 pip install --trusted-host pypi.tuna.tsinghua.edu.cn -i https://pypi.tuna.tsinghua.edu.cn/simple/ 依赖包名 3、命令与环境变量问题 hermes: command not found(安装后无法识别命令) 错误表现:终端输入hermes提示未找到命令 核心原因:环境变量未加载或 PATH 未更新 解决方案: # 重新加载环境变量source ~/.bashrc # 或~/.zshrc(根据Shell类型)# 或直接重启终端 版本不匹配(Python/Node.js 版本冲突) Python 问题:Python 3.9 or older in PATH,安装器需要 Python 3.11 # 手动创建虚拟环境并指定版本 python3.11 -m venv hermes-venv source hermes-venv/bin/activate Node.js 问题:ENOENT/EACCES错误,Node.js 安装不完整 # 删除残留文件并重新安装rm -rf ~/.nvm ~/.node-gyp curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.39.7/install.sh | bash nvm install 18 4、依赖冲突与缺失问题 Pydantic 版本冲突 错误表现:TypeError: BaseModel.validate() takes 1 positional argument but 2 were given 核心原因:Hermes 依赖 Pydantic v1,系统安装了 v2(语法不兼容) 解决方案: pip uninstall -y pydantic pydantic-core pip install pydantic==1.10.13 六、结语 好消息!我们的 Hermes Agent 系统已经全部部署完成,目前运行一切正常。最后选了 Kimi 作为核心推理引擎,这也是社区里大家用得最多的方案,踩坑少,生态成熟。 实测下来 Kimi 确实给力,长上下文能力拉满,原生工具调用也特别稳,完全能 hold 住 Hermes Agent 的多步任务规划和全流程自主执行。现在代码生成、文档处理、数据分析、自动化运维这些核心功能都调通了,已经正式投入使用,整体效率和任务成功率比之前提升了一大截。

优秀的个人博客,低调大师

不同编程语言在发生stackoverflow之前支持的调用栈最大嵌套层数

今天我的一位同事在微信群里发了一张图片,勾起了我的好奇心:不同编程语言支持的函数递归调用的最大嵌套层数是? Java 1.8 private static void recur(int i){ System.out.println("Stack level: " + i); recur(++i); } 测试结果:8644 Javascript in Chrome Chrome版本: Version 70.0.3538.102 (Official Build) (64-bit) function a(i){ console.log("stack level: " + i) a(i+1); } a(0); 测试结果:11412 JavaScript in nodejs nodejs version: v8.11.

优秀的个人博客,低调大师

Python全栈 MongoDB 数据库(Mongo、 正则基础、一篇通)

终端命令: 在线安装: sudo apt-get install mongodb 默认安装路径 : /var/lib/mongodb 配置文件 : /etc/mongodb.conf 命令集 : /usr/bin /usr/local/bin 下载解压: PATH=$PATH:/opt/mongodb.../bin export PATH 将以上两句写入 /etc/rc.local 备份: mongodump -h 主机地址 -d 库名 -o 文件名 恢复: mongorestore -h 主机地址: 端口号 -d 库名 文件路径 mongod --port 8080 设置端口(默认27017) mongo 进入mongo shell quit() exit ctrl+c/z/d 退出mongo shell mongostat 监测速度 (command 命令次数 flushes IO次数 vsize 虚拟内存) mongotop 监测时长 ( ns 数据集合、 total 总时长、 read 读时长 、write 写时长) Mongo命令: use 库名 创建/选择库 show dbs 查询库 db.dropDatabase() 删除库 db.createCollection(“集合名”) 创建集合 db.集合名.insert(...) 创建集合 show collections 查询集合 show tables 查询集合 db.getCollection("集合名") 查询集合所在库 db.集合名.drop() 删除集合 db.集合名.renameCollion("新集合名") 重命名集合 db.集合名.insert({name:"tom"..}) 插入文档 db.集合名.save({name:"tom",...}) 插入文档 db.集合名.insert([{}, {}...]) 插入多个文档 db.集合名.save([{} {}...]) 插入多个文档(加_id键会覆盖原文档) db.集合名.find(查找条件,域) 查找文档 db.集合名.findOne(查找条件,域) 只显示找到的第一条文档 db.集合名.distinct("集合名") 查看集合内某个域的取值范围 db.集合名.remove(query,justOne) 删除指定条件文档(默认false删除所有) db.集合名.update(query, update,upert,multi) 修改文档 db.集合名.find().count() 计数统计查询结果文档的个数 db.集合名.find().pretty() 将查询结果格式化显示 db.集合名.find().limit(n) 显示查找结果的前n条结果 db.集合名.find().skip(n) 跳n过前条显示后面的结果 db.集合名.find().count() 计数统计查询结果文档的个数 db.集合名.find().sort({filed:1/-1,...}) 排序 1:升序, -1:降序,第项相同按照第项二排序 db.集合名.find({'域名.下标':内容{_id:0}) 操作组中的某一项 db.集合名.find({"外域名.内部文档域":内容}, {_id:0}) 操作内部文档(Object)的域 db.集合名.ensureIndex({域:1/-1}) 创建索引(1:正向索引 -1:反向) db.集合名.getIndexes() 查看某个集合中的索引 db.集合名.ensureIndex({域:1/-1}},{name:'索引名'}) 自定义索引名称 db.集合名.dropIndex(({域:1/-1}) 删除索引 db.集合名.dropIndex("索引名") 删除索引 db.集合名.dropIndexes() 删除所有索引(默认_id索引无法删除) db.集合名.ensureIndex({域名1:1/-1,域名2:1/-1}) 创建符合索引 更节省空间 db.集合名.find({'数组.下标':值},{_id:0}) 如果对数组创建索引 查找值也属于索引查找 db.集合名.ensureIndex({域:1/-1},{unique:true}) 创建唯一索引 db.集合名.ensureIndex({域:1/-1},{sparse:true}) 创建稀疏索引 db.createCollection('集合名',{capped:true,size:10000,max:3}) 创建固定集合 比较操作符: $eq 等于 $lt 小于(字符串也可以比较大小) $lte 小于等于 $gt 大于 $gte 大于等于 $ne 不等于 $in 在什么里(in) $nin 不在什么里(not in) 逻辑操作符: $and 与 query内如果多个条件用逗号隔开默认就是and关系 $or 或 $not 非 $nor 既不也不 数组操作符: $size 只显示指定个size个数的文档] $all 查找数组中包含多项的 $slic 取数组中部分显示,在域(field)中声明 其他query查询: $exists 判断一个域是否存在 $mod 余数查找 $type 数据类型查找 修改操作符: $set 修改一个直 不存在则添加 $unset 删除一个域 $rename 修改域名 $setOnInsert 第三个参数为true作为补充插入数据 否则无用 $inc 加减修改器可以使整数小数正数负数 $mul 乘法修改器可以使整数小数正数负数 $min 设置域的值为上线 超过min修改为min $max 设置域的值为下线 小于max修改为max 数组修改符: $push 向数组中添加一项 $pushAll 向数组中添加多项 $pull 从数组中删除一项 $pullAll 从数组中删除多项 $each 对多个值进行逐一操作 $position 指定插入位置(配合each使用) $sort 对数组进行排序(配合each使用) $pop 弹出一项(1:弹出第一项 -1:最后一项) $addToSet 向数组中添加一项(不允许重复) 时间类型:ISODate() nuw Date() 自动生成当前时间 Date() 获取当前计算机时间格式字符串 ISODate() 生成当前时间 ISODate("2018-01-01 12:12:12") 自定义时间 ISODate("20180101 12:12:12") 自定义时间 ISODate("20180101") 自定义时间 valueOf() 生成时间戳 null 如果某个域的值不存在可以设置为null 修改参数: query: 筛选要查找要修改的文档 update: 将筛选的文档修改为什么内容需要配合修改操作符 upsert: bool值 默认false 如果query的文档不存在则不进行任何操作 设置为true 如果query和文档不存在 就根据query和update插入新文档 multi: bool值 默认false 如果query文档有多条则只修改第一条 设置为true 则修改所有符合条件的文档 查找参数: query(条件): 键值对的形式给出要展示的文档 field(域): 以键值对对的形式给出要展示或不展示的域 0为值不显示该域 1为值显示该域 如果使用0设置某些域不显示默认其他域显示 如果使用1设置某些域显示默认其他域不显示 *_id 只有设置为0才不显示否则默认显示 除_id以外,其他域必须同时设置0或1 索引: 指建立指定键值及所在文档中存储位置的对照清单 使用索引可以方便我们进行快速查找,减少数据遍历次数,从而提高查找效率 覆盖索引: 查找操作需要获取的域,只有索引域没有其他域。 此时索引表可以直接提供给用户想要的内容,提高查找效率 唯一索引: 创建的索引,索引域值无重复,此时可以创建唯一索引 唯一索引数据结构更加便于查找 稀疏索引: 只针对有指定域的文档创建索引表,如果某个文档没有该域则不会插入到索引表中 索引约束: 1. 索引表也需要占用一定的磁盘空间 2. 当数据发生更新时索引表也要随之更新 综上 : 1. 数据量比较大时更适合创建索引,数据量较小时没有必要付出索引代价 2. 频繁进行查找操作而不是更新删除插入操作,此时更适合使用索引 固定集合: 大小固定的集合,称之为固定集合 插入速度更快,顺序查找更快 可以控制集合的空间大小 能够自动淘汰早期数据 参数: capped:true 创建固定集合 size:10000 固定集合的大小 字节数 max :1000 表示最多多少条文档 正则基础 Python re模块正则接口详解

优秀的个人博客,低调大师

Python全栈 正则表达式(概念、、语法、元字符、re模块)

前言: 普通人有三件东西看不懂:医生的处方,道士的鬼符,程序员得正则表达式 什么是正则表达式? 正则表达式,又称规则表达式,英文名为RegularExpression,在代码中常简写为regex、regexp或RE, 是计算机科学的一个概念。 许多程序设计语言都支持利用正则表达式进行字符串操作。 例如,在Python中就内建了一个功能强大的正则表达式接口擎。 正则表达式这个概念最初是由Unix中的工具软件(例如sed和grep)普及开的。 正则表达式通常缩写成“regex”,单数有regexp、regex,复数有regexps、regexes、regexen。 正则就是用有限的符号,处理表达无限的序列 有什么作用? 正则表通常被用来检索、替换那些符合某个模式(规则)的文本。 正则表达式是对字符串(包括普通字符(例如,a 到

优秀的个人博客,低调大师

Python全栈 MySQL 数据库 (表字段增、删、改、查、函数)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 查询SQL变量show variables 1.表字段的操作 1.语法:alter table表名 执行动作; 2.添加字段(add) alter table表名add字段名 数据类型;(尾插) alter table 表名 add 字段名 数据类型first;(头插) alter table 表名 add 字段名 数据类型after字段名;(指定插入) 3.删除字段(drop) alter table 表名drop字段名; 4.修改数据类型(modify) alter table 表名modify字段名 新数据类型; 5.重命名(rename) alter table 表名rename表名;2.字符类型 1.字符类型宽度与数值类型宽度的区别 1.数值类型宽度为显示宽度,只用于select查询显示 占用储存无关,可用zerofill查看效果 2.枚举类型 1.单选(enum):字段名enum(值1,值2...); 2.多选(set):字段名set(值1,值2...); (多项放在一个字符串内用,号隔开) 3.日期时间类型 1.date:“YYYY-MM-DD” 2.time:“HH:MM:SS” 3.datetime:“YYYY-MM-DD HH:MM:SS” 4.timestamp:“YYYY-MM-DD HH:MM:SS” 5.datetime:不给值默认返回Null 6.timestamp:不给值默认返回系统时间 3. 日期时间函数 1.now()返回服务器当前的时间 2.curdate()返回当前时期 3.curtime()返回当前日期 4.year(date)返回指定时间的年份 5.date(date)返回指定时间的日期 6.time(date)返回指定时间的时间4.日期时间运算 1.语法格式 select * from 表名 where 字段名 运算符(时间-interval时间间隔单位); 时间间隔单位: 1 day | 2hour | 1 minute | 2year | month 5.表记录管理 1.删除表记录 1.deletefrom 表名 where 条件; 注意: 如果不加where条件,所有记录全部清空 2.更改表记录 1.update表名 set 字段1=值1,字段名2=值2,... where 条件 注意: 如果不加where条件,所有记录全部更改 3.运算符操作 1.数值比较/字符比较 1.数值比较: = != > >= < <= 2.字符比较: = != 2.逻辑比较 1.and 2.or 3.范围内比较 1.where 字段名between值1 and 值2 2.where 字段名in(值1,值2,....) 3.where 字段名not in(值1,值2,...) 4.匹配空、非空 1.空:where nameisnull 2.非空:where nameis notnull 3.注意 1.NILL:空值,只能用is或is not取匹配 2.“ ”:空字符串,用=或!=去匹配 4.模糊比较 1.where 字段名like表达式 2.表达式 1._:匹配单个字符 2.% :匹配0到多个字符 NULL不会被统计6.SQL查询: 1语法顺序: 3.select... 聚合函数from表名 1.where 2.group by... 4.having... 5.order by... 6.limit...; 2.order by 1.给出查询结果进行排序 2...order by字段名 升序/降序 升序:ASC(默认排序方式) 降序:DESC 3.limit(永远放在SQL语句的最后) 1.作用:显示查询记录的个数 2.用法 limitn 显示n条记录 limit m,n m表示 从m+1条记录开始显示显示n条记录 limit 2,3 显示第3,4,5条记录 3.分页 每页显示5条记录,显示第4页内容 第1页:limit 0,5 #1,2,3,4,5 第2页:limit 5,5 第3页:limit 10,5 第4页:limit 15,5 每页显示n条记录,显示第m页: limit(m-1)*n,n4.聚合函数 avg(字段名):求该字段的平均值 sum(字段名):求和 max(字段名):最大值 min(字段名):最小值 count(字段名):统计该字段的个数 create database MOSHOU; use MOSHOU; create table hero( id int, name char(15), sex enum("男","女"), country char(10) )default charset=utf8; insert into hero values (1,"曹操","男","魏国"), (2,"小乔","女","吴国"), (3,"诸葛亮","男","蜀国"), (4,"貂蝉","女","东汉"), (5,"赵子龙","男","蜀国"), (6,"魏延","男","蜀国"); use MOSHOU; create table sanguo( id int, name char(20), gongji int, fangyu tinyint unsigned, sex enum("男","女"), country varchar(20) )default charset=utf8; insert into sanguo values (1,'诸葛亮',120,20,'男','蜀国'), (2,'司马懿',119,25,'男','魏国'), (3,'关羽',188,60,'男','蜀国'), (4,'赵云',200,66,'男','魏国'), (5,'孙权',110,20,'男','吴国'), (6,'貂蝉',666,10,'女','魏国'), (7,null,1000,99,'男','蜀国'), (8,'',1005,88,'女','蜀国'); 1、创建库 studb2 2、在库中创建表 t1 ,字段有3个:name、age、phnumber 3、查看表结构 4、在表中第一列添加一个 id 字段 5、把 phnumber 的数据类型改为 bigint 6、在表中最后一列添加一个字段 address 7、删除表中的 age 字段 8、查看表结构 答案: use studb2; create table t1( name char(20), age tinyint unsigned, phnumber char(11) ); desc t1; alter table t1 add id int first; alter table t1 modify phnumber bigint; alter table t1 add address varchar(50); alter table t1 drop age; desc t1; 1、在表中插入3条记录 2、查找2018年7月2日有哪些用户充值了 3、查找2018年7月份充值的信息 4、查找7月30日10:00-12:00充值的信息 答案: insert into t7 values (3,"小昭",19000520,3000,20180630000000), (4,"赵敏",19000521,4000,20180702000000), (5,"周芷若",19010522,3500,20180702100000); select * from t7 where date(shijian)="2018-07-02"; select * from t7 where date(shijian)>="2018-07-01" and date(shijian)<="2018-07-31"; select * from t7 where date(shijian)="2018-07-31" and time(shijian)>="10:00:00" and time(shijian)<="12:00:00"; 1、查询1天以内的记录 2、查询1年以前的记录 3、查询1天以前,3天以内的记录 答案: select * from t7 where shijian > (now()-interval 1 day); select * from t7 where shijian < (now()-interval 1 year); select * from t7 where shijian < (now()-interval 1 day) and shijian > (now()-interval 3 day); 1、查找所有蜀国人的信息 2、查找所有女英雄的姓名、性别和国家 3、把id为2的记录改为典韦,性别男,国家魏国 4、删除所有蜀国英雄 5、把貂蝉的国籍改为魏国 6、删除所有表记录 答案: select * from hero where country="蜀国"; select name,sex,country from hero where sex="女"; update hero set name="典韦",sex="男",country="魏国" where id=2; delete from hero where country="蜀国"; update hero set country="魏国" where name="貂蝉"; delete from hero; 1、找出攻击值高于200的蜀国英雄的名字、攻击力 2、将吴国英雄中攻击值为110的英雄的攻击值改为100,防御力改为60 3、查找蜀国和魏国的英雄信息 答案: select name as n,gongji as g from sanguo where gongji>200 and country="蜀国"; update sanguo set gongji=100,fangyu=60 where country="吴国" and gongji=110; select * from sanguo where country="蜀国" or country="魏国"; 1、查找攻击值100-200的蜀国英雄信息 2、找到蜀国和吴国以外的国家的女英雄信息 3、找到id为1、3或5的蜀国英雄 和 貂蝉的信息 答案: select * from sanguo where gongji between 100 and 200 and country="蜀国"; select * from sanguo where country not in("蜀国","吴国") and sex="女"; select * from sanguo where (id in(1,3,5) and country="蜀国") or name="貂蝉"; 1、在蜀国英雄中,查找防御值倒数第二名至倒数第四名的英雄的记录 2、在蜀国英雄中,查找攻击值前3名且名字不为 NULL 的英雄的姓名、攻击值和国家 答案: select * from sanguo where country="蜀国" order by fangyu asc limit 1,3; select name,gongji,country from sanguo where country="蜀国" and name is not NULL order by gongji DESC limit 3; 1、攻击力最强值是多少 2、统计id 、name 两个字段分别有几条记录 ## 空值 NULL 不会被统计,""会被统计 3、计算蜀国英雄的总攻击力 4、统计蜀国英雄中攻击值大于200的英雄的数量 答案: select max(gongji) from MOSHOU.sanguo; select count(id),count(name) from sanguo; select sum(gongji) from MOSHOU.sanguo where country="蜀国"; select count(*) from MOSHOU.sanguo where gongji>200 and country="蜀国";

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册