首页 文章 精选 留言 我的

精选列表

搜索[CloudQ共创征文],共1297篇文章
优秀的个人博客,低调大师

【OpenTiny调研征集】共创技术未来,分享您的声音!

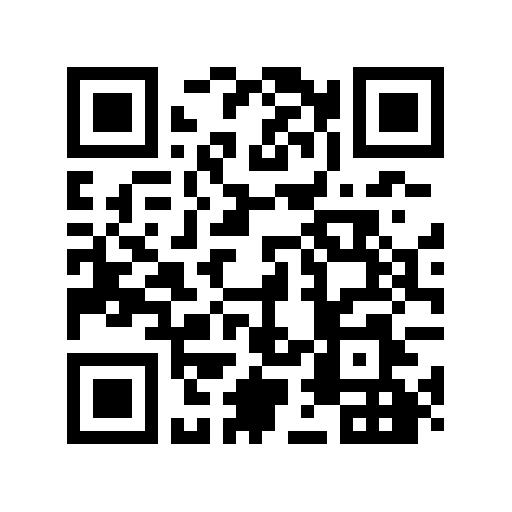
🎉 欢迎参与2025年 OpenTiny 开源社区用户调研征集 🎉 📣 调研背景 随着 OpenTiny 开源项目的不断发展,我们一直致力于为开发者提供高质量的 Web 前端开发解决方案。为了更好地满足用户需求,提升项目的实用性和易用性,我们决定发起一项用户调研活动,诚挚邀请您参与。 🔍 调研目的 了解用户需求:收集您在使用 OpenTiny 开源项目过程中的需求、问题和建议,以便我们更好地改进和优化。 提升用户体验:通过您的反馈,我们将找出项目中的不足,并努力提升项目的性能、稳定性和易用性。 促进社区发展:您的参与和建议将有助于 OpenTiny 开源项目的成长和发展,共同构建一个繁荣的开源社区。 📋 调研内容 您目前使用的开源项目。 您对OpenTiny 文档教程的诉求。 您对 OpenTiny 项目的期望和改进建议。 您希望我们在未来版本中增加或优化的功能。 💡 如何参与 填写问卷 :进入https://www.wjx.cn/vm/rsK8GO1.aspx (或扫描二维码)填写我们的调研问卷,分享您的想法和建议。 参与讨论:加入我们的开源社区[添加小助手:opentiny-official],在指定的讨论区发表您的看法和建议。 🎁 奖励机制 所有参与调研的用户都将获得 OpenTiny 官方颁发的电子感谢证书。 部分优秀建议的提交者并参与贡献的朋友将获得 OpenTiny 项目的特别贡献者荣誉。 🔗 联系方式 如有任何疑问或建议,请随时通过以下方式与我们联系: 邮箱:opentiny@huawei.com GitHub仓库:https://github.com/opentiny 加入社区:opentiny-official 💖 感谢您的参与 您的宝贵意见对于 OpenTiny 开源项目的成长至关重要。我们期待收到您的反馈,并共同努力打造一个更加优秀的开源 Web 前端开发解决方案! 关于OpenTiny 欢迎加入 OpenTiny 开源社区。添加微信小助手:opentiny-official 一起参与交流前端技术~ OpenTiny 官网:https://opentiny.design OpenTiny 代码仓库:https://github.com/opentiny TinyVue 源码:https://github.com/opentiny/tiny-vue TinyEngine 源码: https://github.com/opentiny/tiny-engine 欢迎进入代码仓库 Star🌟TinyEngine、TinyVue、TinyNG、TinyCLI~ 如果你也想要共建,可以进入代码仓库,找到 good first issue标签,一起参与开源贡献~

优秀的个人博客,低调大师

阿里云ACE共创空间——MQ消息队列产品测试

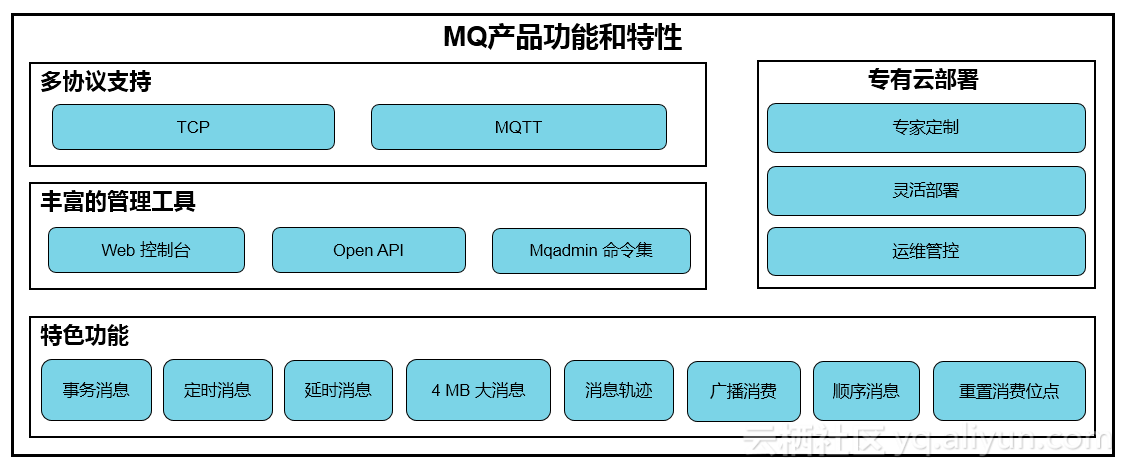
一、产品背景消息队列是阿里巴巴集团自主研发的专业消息中间件。 产品基于高可用分布式集群技术,提供消息订阅和发布、消息轨迹查询、定时(延时)消息、资源统计、监控报警等一系列消息云服务,是企业级互联网架构的核心产品。 MQ 目前提供 TCP 、MQTT 两种协议层面的接入方式,支持 Java、C++ 以及 .NET 不同语言,方便不同编程语言开发的应用快速接入 MQ 消息云服务。 用户可以将应用部署在阿里云 ECS、企业自建云,或者嵌入到移动端、物联网设备中与 MQ 建立连接进行消息收发,同时本地开发者也可以通过公网接入 MQ 服务进行消息收发。从官方文档中看到MQ消息队列的产品为一个提供消息服务的中间件,可以提供端到云的消息服务,这个端的覆盖面包括了移动端和IOT物联网设备,并且为了支持IOT的需要除TCP协议外提供了MQTT来支持

优秀的个人博客,低调大师

东方国信携手Cloudera 共创Hadoop生态圈辉煌

ZD至顶网软件频道消息:近日,国内大数据企业东方国信与Cloudera正式签署战略合作协议,达成战略合作伙伴关系。双方将在Hadoop技术创新、行业拓展、应用落地、客户服务等方面开展深入的合作与共享,推动hadoop技术在中国市场的深入发展与有效落地,并将进一步探讨在产品深度研发、资本运作层面的深度合作。 东方国信携手Cloudera签约 Hadoop是大数据的利器,Hadoop作为开源的数据处理平台,凭借其低成本、高扩展性和灵活性的优势已成为当前主流的大数据分析平台,并赢得多数业界巨头的认可。特别是在国内去IOE的趋势下,行业巨头们纷纷通过产品研发和战略合作发力Hadoop应用,掀起大数据的革命。通过本次合作,东方国信在原有Hadoop产品与能力的基础上,将借鉴hadoop全球领先的技术,加强与国际大数据巨头的技术与研发合作,进一步夯实公司大数据的核心技术优势,并为全球客户提供更优质的大数据服务;Cloudera也将借助东方国信在国内大数据领域多年耕耘的成功经验和本土化优势,拓展中国大数据市场,更好的服务中国客户。这次两家大数据龙头企业的强强联合,将推进双方的深度合作,发力千亿级的大数据市场,携手共建大数据生态,引领中国的大数据应用落地。 东方国信已构建起大数据+的战略布局,自主开发了Hadoop版本 作为国内大数据龙头企业,东方国信一直以“让数据改变工作与生活”为愿景,坚持自主研发与创新。在Hadoop发展早期,东方国信便成立了研发团队对Hadoop技术进行研究,并承建了国内除BAT以外最大的大数据集群,在大数据的实际业务中培养了一支国内领先的Hadoop技术团队,能够真正将Hadoop研发与运营有效结合,解决大数据特别是Hadoop集群落地过程中的各种问题;同时,东方国信还紧跟国内Hadoop的发展趋势,积极引进Hadoop的优秀人才与团队,核心技术团队成员大多来自于大型互联网公司、中科院计算技术研究所、重点高校。目前东方国信全球有3000多人的团队,其中大数据技术人员超过2000人。全国31个省都设有分支机构或项目实施团队。 多年以来,东方国信一直专注于Hadoop核心技术的研究与创新,对开源Hadoop实现了大量升级与增强,并推出了更稳定、更高效的Hadoop软硬件产品,包括东方国信Hadoop企业版软件以及Hadoop大数据分析一体机。东方国信Hadoop产品相比开源Hadoop增加了服务端计算、多种类型索引、透明硬件压缩、性能隔离、访问控制、批量导入、JDBC接口、图形化ETL数据接入等一系列功能,同时也提供了诸如RCFile数据存储格式、CCIndex索引等创新技术,这些技术已被广泛应用并成为行业事实标准。目前,东方国信的Hadoop大数据技术已在电信、金融、互联网等多行业领域成功应用,为国内包括淘宝、搜狐、腾讯,国外包括Facebook、Yahoo在内的众多重量级客户提供了大数据技术服务,到了业界的一致认可,相关产品和行业解决方案获得了良好的口碑。 关于东方国信 东方国信是一家业务遍及全球、国内领先的上市科技公司,大数据龙头企业,市值最高超过300亿。 成立18年来,东方国信已经为全球35个国家和地区的1000多个客户提供大数据产品与服务,涉及电信、金融、智慧城市、公共安全、工业、农业、医疗、互联网等重点业务领域,围绕着大数据全产业链的核心技术能力,不断深化横向跨行业的战略布局。随着中国政府推动大数据发展纲要的落地,东方国信将围绕政府数据公开,全面打开大数据应用的千亿级市场。至今,东方国信帮助客户构建的分布式大数据系统,节点总量超过4000个,每天帮助客户处理超过5000亿条数据,每天处理完成的结构化数据超过200TB,而且这个数据每年都呈几何级的增长 。 关于Cloudera Cloudera 成立于2008年,是全球领先的企业级Apache Hadoop提供商和服务商,无论在产品还是专业服务、技术支持和培训方面都明显处于业界领袖地位。基于CDH——目前为止是世界上部署最为广泛的Apache Hadoop*分发版,Cloudera提供存储、访问、管理、分析、安全和搜索在内的商业关键数据挑战顶尖的软件及服务。全球员工超过1050人,其中超过3/4的员工为技术人员,具有世界上最大的Apache Hadoop*项目Committer团队。Cloudera已成为大数据Hadoop领域的龙头企业。 原文发布时间为:2015年9月23日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

Viu联合华为HMS生态,共创影音娱乐新体验

华为HMS生态携手流媒体平台Viu,为海外消费者打造精品移动娱乐应用体验,并助力提升流量变现能力。Viu在中东非、东南亚等16个国家及地区提供广告合作和付费会员服务,支持优质视频内容高清点播和直播。自2019年起,Viu在中东非区域与华为HMS生态开展一系列紧密合作,并在2022年实现47%的用户增长。 本次,华为邀请Viu中东非区域首席业务官Rohit D'Silva,分享与HMS生态合作的独特见解。 Q1:Viu与华为合作的主要原因是什么?为什么选择华为HMS生态、接入鲸鸿动能广告平台呢? A1:Viu和华为拥有共同的理念和价值观,都坚持以客户为中心。华为致力于为所有终端用户提供优质的使用体验,HMS生态符合我们业务的发展方向。 华为应用市场(HUAWEI AppGallery)是全球三大应用市场之一。通过上架AppGallery,华为用户可以快速、流畅地访问Viu丰富多元的视频内容。此外,作为全球最大的智能终端制造商之一,华为拥有海量设备用户,这对我们来说是一个巨大的市场,可以触达更广泛的用户群体。 鲸鸿动能广告(Petal Ads)是我们合作的重要部分。Petal Ads支持广告数据深度分析,实现目标用户精准投放,帮助我们进一步扩大中东非市场。 Q2:Viu与华为HMS生态持续合作多久了?有什么经验可以跟我们分享吗? A2:2019年起,我们开始与华为的专家团队密切合作。华为团队具备严谨认真的工作态度,提供专业细致的技术支持,这让我们的合作过程非常顺利。通过接入HMS Core多种开放能力,Viu优化了应用性能,在短时间内上架AppGallery实现分发,提供更优质的用户体验。 其中,应用内支付服务(HMS Core In-App Purchases,IAP)支持多种支付方式,帮助我们高效变现;数字版权服务(HMS Core WisePlay DRM)有效防止数字内容未经授权使用和非法盗用,为流媒体平台提供内容版权保护。 除了集成HMS Core的开放能力外,我们接入Petal Ads,通过AB测试等方式,挖掘不同细分市场的价值,瞄准高转化用户。2022年,Viu相比前一年实现华为生态用户数量增长47%。 Huawei and Viu raise the bar for the content and entertainment industry in the region Q3:从商业的角度来看,您对与华为的合作有什么期待? A3:通过加入华为HMS生态,Viu可以触达更多的用户,提升用户黏性。同时,我们和华为达成合作——在中东非区域,用户在购买部分最新发布的华为设备如HUAWEI Mate 50 Pro时,可以享受Viu最多长达6个月的免费高清内容点播和直播订阅权益。 客户满意度是我们成功的关键。集成HMS生态相关服务后,Viu可以下载安装到手机、平板等多种类型的华为设备上,获取更多用户。在华为手机、平板设备显示逼真、音质出色以及界面友好等优势的加持下,Viu的内容展现效果得以保证,提升了用户体验。 此外,通过和Petal Ads合作,我们期待与目标受众建立更多联系,实现中东非地区业务的大幅增长。从目前经验看,我们预计这次合作可以达成理想成果。 Q4:未来Viu与华为还有哪些创新合作? A4:我们正在通过联合营销活动、原创内容产品推广等方式,不断深化与华为的合作,推动业务增长。在中东非区域,我们还计划将Viu引入华为智慧屏,触达更多华为设备用户。华为HMS生态创新的理念、领先的技术以及有力的支持,给我们留下了深刻的印象,这也是我们合作顺利的原因。Viu和华为都坚持以客户为中心,未来我们将深化合作伙伴关系,采用更多尖端技术,把我们对移动影音的愿景变为现实。 了解更多详情>> 访问华为开发者联盟官网 获取开发指导文档 华为移动服务开源仓库地址:GitHub、Gitee 关注我们,第一时间了解 HMS Core 最新技术资讯~

优秀的个人博客,低调大师

阿里云ACE共创空间——大数据方案体验2 Elasticsearch

从阿里云的官方文档中先查看了下Elasticsearch这个产品的特点: 特点及优势 分布式的实时文件存储,每个字段都被索引并可被搜索 分布式的实时分析搜索引擎 商业版X-pack插件,提供企业级权限管控、实时系统监控等强大服务 可弹性扩展到上百台服务器规模,处理PB级结构化或非结构化数据 支持IK analyzer插件 Elastic官方技术支持团队7*24小时技术支持 预置插件 阿里云Elasticsearch预置插件如下(包含但不完全包含): IK Analyzer:IK Analyzer是一个开源的,基于java语言开发的中文分词工具包。是开源社区中处理中分分词非常热门的插件。 pinyin Analyzer:拼音分词器。 Smart Chinese Analysis Plugin:lucene默认的中文分词器。 ICU Analysis plug

优秀的个人博客,低调大师

【征文】WorkBuddy:让 AI 从"会聊天"进化到"会干活"

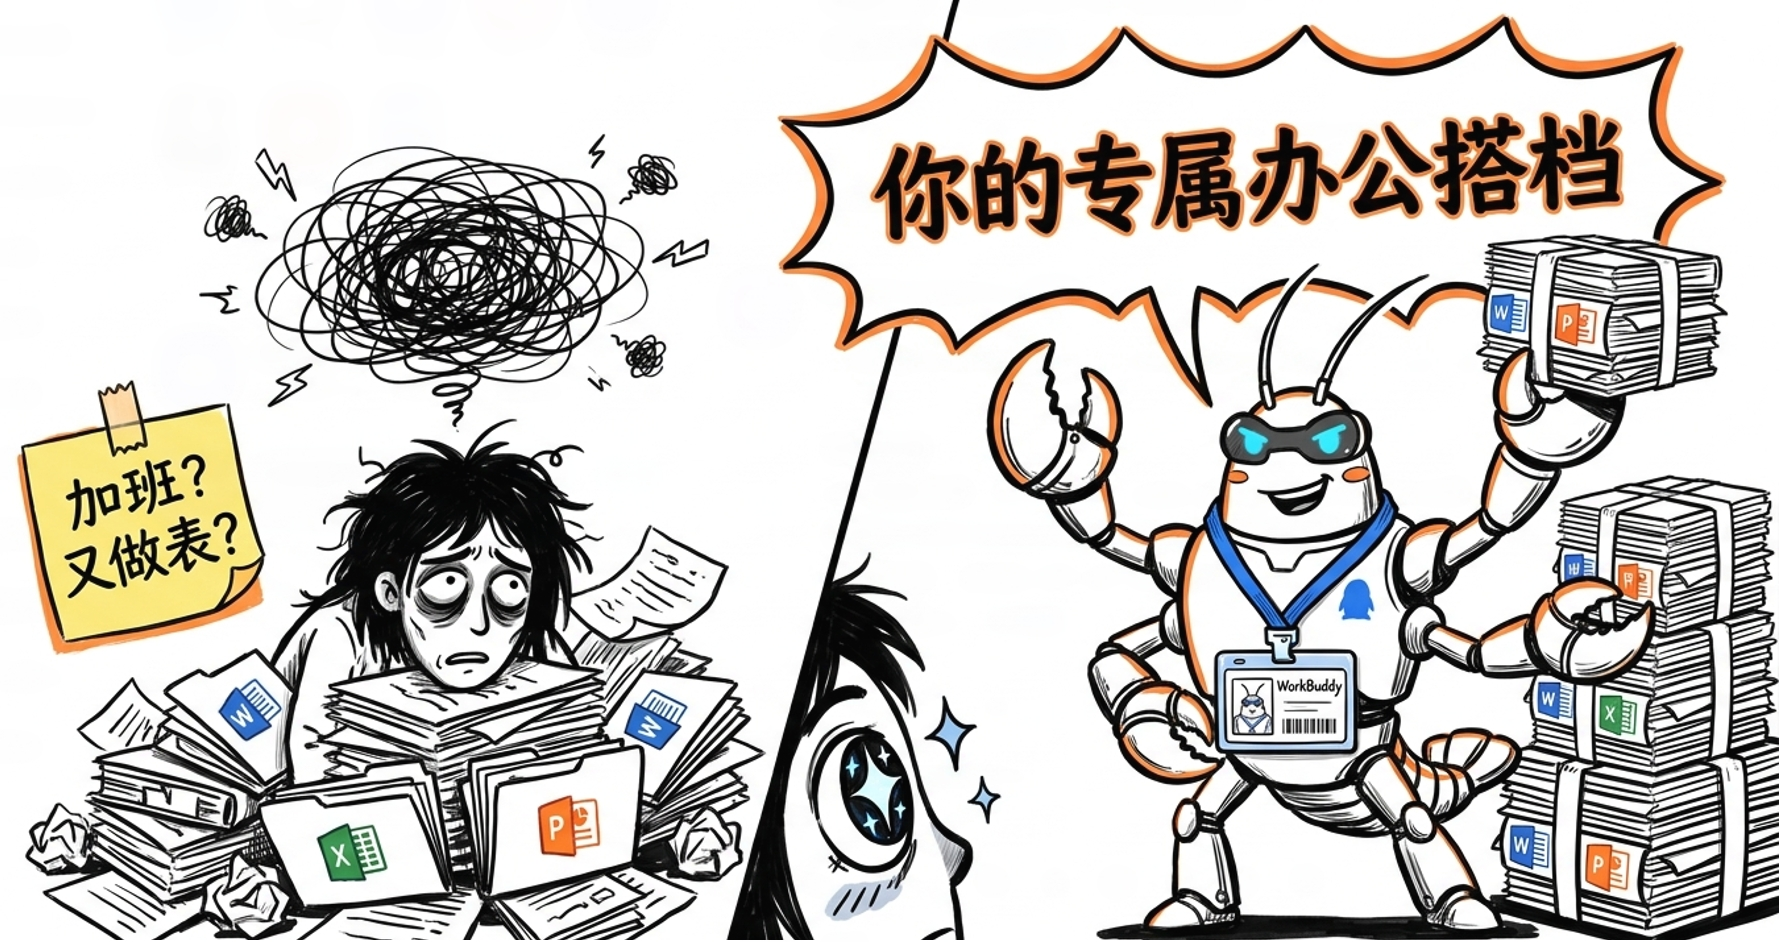
一句话结论:WorkBuddy 是腾讯出品的桌面级 AI 智能体工作台,和编程助手 CodeBuddy 共用同一套底座。它把"大模型 + 工具调用 + 本地执行"这套 Agent 能力从写代码搬到了办公场景——你用一句话下达任务,它自己拆解、规划、动手,直接交付可用的报告 PPT 表格,而不是只给你一段建议。本文面向工程同学,重点讲清它的原理、能力边界和优势局限。为了好理解,后面会不断拿大家熟悉的 Claude Code / Cursor 这类 agentic 工具来类比——某种程度上,WorkBuddy 就是"办公版的 Claude Code"。

优秀的个人博客,低调大师

#2020征文-其它#鸿蒙IDE(DevEco Studio)gradle下载缓慢,咋办

目录: 基于鸿蒙的电子词典项目来了!可以搜索无限单词哦! 调试鸿蒙App源代码的两种方式 开发跨设备的鸿蒙(HarmonyOS)App 我们知道,DevEco Studio是基于IntelliJ IDEA社区版二次开发的,所以免不了要使用Gradle完成项目的构建工作。不过由于国内众所周知的原因,在DevEco Studio中下载Gradle非常慢(并不是无法访问,而是非常慢,而且还经常timeout),所以在网上有很多帖子给出了不同的解决方案。本文先列举一些典型的解决方案。 方案1:使用国内的maven库地址 找到build.gradle文件,然后修改或添加buildscript和allprojects,修改后的代码如下: repositories { maven{url 'http://maven.aliyun.com/nexus/content/groups/public/'} maven { url "https://jitpack.io" } google() } dependencies { classpath 'com.android.tools.build:gradle:3.1.2' } } allprojects { repositories { maven{url 'http://maven.aliyun.com/nexus/content/groups/public/'} google() } } 方案2:事先下载好gradle 下载好的文件是gradle-6.3-all.zip,然后将该文件放在特定的目录。目录的位置与操作系统有关。 Windows下的位置:C:\Users\用户名.gradle macOS下的位置:/Users/用户名/.gradle Linux下的位置:/home/用户名/.gradle 读者根据自己使用的OS进入不同位置的.gradle目录,然后再进入该目录下的wrapper/dists子目录。会看到“gradle-版本号-all”格式 的目录,例如,下图是我的macOS上的目录结构。 然后进入gradle-6.3-all目录(最新的DevEco Studio使用的是gradle6.3),会看到一个由字母和数字组成的目录,如b4awcolw9l59x95tu1obfh9i8,这个目录与gradle版本和路径有关。所以不同版本和路径的gradle,目录名不同。现在将我们下好的gradle-6.3-all.zip文件复制到该目录。再次用DevEco Studio重新打开HarmonyOS工程,就会非常快的同步gradle。这是因为DevEco Studio会优先在特定目录搜索gradle的zip文件是否存在,如果存在,就直接使用了,如果不存在,才会从网上下载。 不过有时特定的gradle目录还没有生成,我们也不知道要将gradle-6.3-all.zip或类似的文件放到哪里,所以也可以采用另外一种方法,换个下载更快的地址。 打开HarmonyOS工程,找到<工程根目录>/gradle/wrapper/gradle-wrapper.properties文件,会看到一个distributionUrl属性,该属性默认指向gradle的官网,可以将其换成国内的地址,或干脆自己用apache、nginx等服务器自己搭建一个本机下载服务,如我将其换成了如下的地址: http://127.0.0.1/gradle-6.3-all.zip 现在再重新打开HarmonyOS工程,就会非常快速地下载(由于是在本地下载,所以在1s之内就能完成gradle的下载任务)和同步gradle及其相关配置了。不过这里还有一个问题,我再创建新的HarmonyOS工程,岂不是还要改一遍这个文件,非常麻烦。所以为了一劳永逸,干脆改一下DevEco Studio的模板。 首先进入<DevEco Studio根目录>/plugins/harmony目录,这是DevEco Studio的插件目录。在该目录下继续找到lib/templates/gradle/wrapper/gradle/wrapper/gradle-wrapper.properties文件,该文件就是每次创建HarmonyOS工程时的gradle-wrapper.properties文件,打开该文件,将distributionUrl改成http://127.0.0.1/gradle-6.3-all.zip即可。然后重新启动DevEco Studio。再创建新的HarmonyOS工程,就会自动使用新的gradle下载地址了。由于此前已经下载了gradle,所以即使不启动本机的http服务器,仍然能快速使用gradle。 作者:李宁 想了解更多内容,请访问: 51CTO和华为官方战略合作共建的鸿蒙技术社区https://harmonyos.51cto.com

优秀的个人博客,低调大师

【AWS征文】AWS安全加固-Fortinet AWS 安全解决方案

作者:昱坤 在公有云方案日益火爆的今天,公有云应用越来越广泛。随之而来的,公有云也遇到了一些挑战:  传统数据中心产品不一定支持云环境 传统的产品不一定支持云弹性的部署以及模块化的部署 云架构的部署思路与传统物理环境部署环境完全不同 传统的安全防护很难在多云环境提供统一安全解决方案 遇到最多的问题就是:我们云环境一定要和物理数据中心架构一样 而在企业进行公有云迁移时对于安全和自动化的要求,AWS上有了新的安全自动部署方案: 在该方案中,可以将防火墙部署在Transit VPC中,以实现VPC与VPC间/VPC与Internet间等的安全加固需求。此文仅介绍Fortinet AWS 的安全解决方案。 Fortinet云部署实例要求 如果要在AWS上部署FortiGate-VM,那么实例需要满足以下要求: Fortinet常见云部署模式 针对AWS云上部署,Fortinet提供两种常见的部署方案: NGFW 和ELB部署形式  两个AZ的FW与WAF工作在AA模式 入向流量通过ELB负载分摊 FW开启NGFW威胁检测功能 FW将流量映射至内部ELB FQDN NGFW以及WAF 和ELB部署形式  FW与WAF完全集成将HTTP转至WAF WAF对HTTP流量进行深度检测 WAF将HTTP流量映射至内部ELB 在该部署模式下,三明治式的部署架构是部署WAF的最佳实践: 入向流量通过ALB负载,并基于内容分流; WAF专注于管理高级WEB安全配置; 两种高级防御模式 • 黑名单提供特征库防御,IP信誉库,HTTP协议规范,防病毒.DLP,高级防御规则,高级APT防护等功能 • 白名单提供网站详细参数设定,扫描报告导入,应用自学,Bot机器学习,参数机器学习等功能云部署的高可用性 Fortinet云部署HA有两种方案: 方案一:  由于AWS VPC中不支持二层协议,所以不能在AWS中运行VRRP HA使用主备模式部署在相同AZ,心跳使用3层 根据事件或SLA自动切换主备 主备切换会自动调用AWS API,备设备将主设备上的secondary IP和EIP切换至备设备 同时备设备将指向主设备网卡的下一条指向自己 方案二:  FortiGate部署在两个不通的可用区,子网信息并不相同 通过Fortinet利用AWS的原生服务AWS API Gateway、Cloudwatch、Lambda构建了一套自动切换VPC路由表的解决方案 当FortiGate自己发现故障,会通过联动API Gateway触发Lambda切换VPC路由表 当Cloud Watch发现设备故障,同样会触发Lambda切换VPC路由表自动扩展模式 自动扩展模式: 在面向公网侧部署NLB,保障公网IP可以透传到FortiGate侧 CloudWatch持续监控FortiGate CPU及MEM信息触发Lambda Lambda在Autoscale成员中增加FW并通过API通知FW同步配置 FW同步完配置通过API通知Lambda Lambda更新ELB配置 DynamoDB存储Autoscaling 状态信息 支持PAYG,Hybrid部署

优秀的个人博客,低调大师

【AWS征文】带你轻松迁移数据库到 AWS

如今,企业上云离不开数据库上云。然而,云上有很多数据库类型,企业该如何选择?将数据库迁移到云端,该有哪些步骤呢?不同的业务场景下,企业该如何选择?本文将介绍 AWS 各种常用数据库特性,以及如何满足客户不同业务需求,并列举数据库迁移案例为大家演示如何轻松便捷的把数据库迁移上云。 一、AWS 数据库概览 在这个互联网极其发达的时代,我们每个人会接收以及生产各式各样的信息,数据的重要性已经***到每个角落,成为每个行业发展和变革的必要元素。我们日常使用的手机应用,比如微信、支付宝、微博等,里面的数据都是需要数据库来进行存储,不同的应用会使用不同类别的数据库,甚至同一个应用可能同时使用多种数据库。 应用离开了数据库就像鱼儿离开了水,由此可见数据库在当今互联网的重要性。我们甚至可以说当今世界最宝贵的资源不再是石油,而是数据。随着业务的快速发展,全球化业务新兴需求增加,本地传统数据库已经无法为快速发展的业务提供支持,我们需要探索一种新的方式,把本地数据库迁移到云中,利用云中数据库的优势来解决本地数据库中遇到的瓶颈问题。 我对各家云厂商数据库种类做了一个比较,发现 AWS 为用户提供的数据库种类最为丰富,几乎把所有数据库相关的应用场景都捕捉到了。下面通过一个列表,来浏览一下 AWS 的数据库种类,其中关系型数据库最为丰富,也是目前应用使用最多的数据库。 以上这些数据库由 AWS 完全托管,用户不用去管理底层硬件系统升级维护等相关工作,这也是推荐使用全托管数据库而非自建数据库的原因。为了方便客户数据库迁移上云,AWS 还为客户提供了非常方便的迁移工具 DMS,帮助用户轻松经济高效的完成迁移任务。 那么面对这么多种类的数据库,尤其是一些新型数据库,我们从来没有使用过,我们该如何选择?我们需要从业务场景为出发点来分析使用哪种数据库,下面我对 AWS 数据库的使用场景做个简单的介绍,也让大家对 AWS 各种数据库的应用场景有一个大致了解。 数据库种类 应用场景 关系数据(RDS) 传统应用程序、ERP、CRM 、电子商务 键值数据(DynamoDB) 高流量 Web 应用、电子商务系统、游戏应用程序、微服务 宽列数据(Keyspaces) 用于设备维护、队列管理和路线优化的大规模工业应用程序 文档数据(DocumentDB) 内容管理、目录、用户配置文件、移动和 Web 应用程序 内存数据(ElasticCache) 缓存、会话管理、游戏排行榜、地理空间应用程序 图数据(Neptune) 欺诈检测、社交网络、推荐引擎、知识图谱 时序数据(Timestream) IoT 应用、开发运营和工业遥测 分类账数据(QLDB) 系统记录、供应链、注册、银行事务 初步了解 AWS 各项数据库的应用场景之后,我们详细介绍 AWS 各项数据库特性,以及 AWS 数据库如何满足用户在各种业务场景下面的需求。 数据库家族 关系型数据库 关系型数据库是起源非常早的数据库,也是目前各种应用使用最多的数据库。我们使用各种应用都需要注册用户,这些用户数据存放在关系型数据库里面;你在电商网站下了一个订单,订单也是存放在关系型数据库里面;我们访问的网站,其后台数据也是存放在关系型数据库里面。所以说关系型数据库无所不在。 说到 AWS 的关系型数据库,那不得不说一下 Amazon Aurora,Aurora 是 AWS 专为云而打造的云原生数据库,它兼容 MySQL 和 PostgreSQL,它可以支撑我们各种关系型数据库的应用场景,性能好、易扩展、安全、便于管理,Aurora 如此好用,也依托于它下面的一些特性: 性价比:吞吐量为标准 MySQL 的五倍,标准 PostgreSQL 的三倍,成本只有商业数据库的十分之一。 扩展性:基于共享存储,主从复制延迟很低,可跨三个可用区扩展至最多 15 个只读副本。 可用性与持久性:具有容错能力的自我修复存储;跨三个可用区建立六个数据副本;持续备份至 S3。 安全性:VPC 网络隔离、静态/传输数据加密、满足大多数地区合规性要求。 全球数据库:数据库跨越多个 AWS 地区同步复制,将数据库置于用户端,可以实现低延迟(典型延迟小于 1 秒)的本地读取和跨区域灾难恢复。 无服务器:可以根据工作负载自动扩容缩容,无需关心底层硬件扩展,适合业务波动的应用。 Aurora 具有很多传统数据库不具有的特性,这样让 Aurora 成为关系型数据库的首选。不过如果你不想更换数据库类型,把本地现有的数据库迁移到云中,AWS 还为用户提供 MySQL、MariaDB、PostgreSQL、SQL Server、Oracle 等关系型数据库,客户可选择相同的数据库引擎进行迁移。并且这些数据库依托于 AWS 强大的基础设施和管理,同样安全稳定。 如果 Aurora 非常吸引你,而你现在用的是 SQL Server 或者 Oracle,那该怎么办?不用担心,AWS 为客户提供了 Schema Conversion Tool、DMS 这两个服务,可以帮助客户评估并且转换数据库对象,非常便捷地将本地数据库迁移到 Aurora。 键值数据库 互联网发展到今天,数据表越来越大,有的应用要求写得快、读的快等需求。关系型数据库已经无法满足我们的需求,因此 NoSQL 数据库也就诞生了。我们把一些不需要关系查询,要求读写快的应用数据放置在 NoSQL 数据库里面来解决性能问题。 考虑到客户的需求,AWS 也为客户提供了自研的 NoSQL 数据库 Amazon DynamoDB,它支持键值存储,也支持文档存储,特别以键值存储为核心,面对海量数据,性能非常强悍。因其由 AWS 完全托管,所以也是无服务器架构中的重要一员。 扩展性:可自动纵向扩展和缩减表,以针对容量做出调整并保持性能,提供任意级别的请求流量。 高性能:对于一般的请求,DynamoDB 在个位数毫秒内可以完成,而且处理请求的速度不会随着数据量的增加而减慢。 分布式:无中心化架构,一个表上的数据可以分布到几百台机器上。 我也在 AWS 官方渠道了解到,汇量科技是一家广告公司,他们也大量使用了 AWS 的服务,尤其是对广告点击的数据,正是采用了 DynamoDB 数据存储,可以支撑 2019 年日均广告请求量 600 亿次,峰值高达 1000 亿次。如此巨大的请求量,放在关系型数据库将无法支撑,由此可见 DynamoDB 在这种应用场景性能多么强悍。 文档数据库 JSON 数据无数不在,它是一种非常灵活的格式,你可以很方便地修改一条数据的 Schema。它是一种轻量级的数据交换格式,目前使用最广泛的 API 标准 RESTfull API,它的输出标准也是 JSON。使用 JSON 进行数据建模最符合人类语言的逻辑。以上这些使用场景,我们都需要一种文档数据库来存储 JSON 数据,它既不是关系型数据库,也不是键值数据库。 哪些应用场景会用到文档数据库呢?因为 JSON 数据的灵活,文档数据已经***到各个领域,比如在游戏中,存储用户信息,装备积分等;在物流中,存储订单信息,订单状态;在社交中,存储用户信息以及用户发表的朋友圈信息;在视频直播中,存储用户信息和礼物信息等。 为了满足客户这些使用场景,AWS 为客户提供了 DocumentDB 数据库,见名知意,它是一个云原生的文档数据库,与 MongoDB 兼容,你可以把现有的 MongoDB 数据库通过 DMS 或 mongodump/mongorestore 等原生方式迁移上 AWS。 DocumentDB 扩展性很强,水平扩展在分钟级别,最多可以扩展到 15 个读副本;垂直扩展也在分钟级,最高扩展至 768 GiB 内存;存储可以自动扩展,最高支持 64TB。这些特性都是我们在自建数据库很难实现的。 内存数据库 如今的应用越做越大,很多都已经开始进行分布式或者微服务架构,这时候就需要一个存储库来储存用户的会话信息,不然用户可能处于频繁的登陆状态;还有应用要求提升数据查询速度,这就需要给数据库添加缓存层等。以上这些应用场景都会需要内存数据库。 那么 AWS 同样在云中为客户提供了完全托管的内存数据库 Amazon ElastiCache,客户可以把一些热数据、会话数据、消息数据、排行数据等存放在其中,以加速数据的存取速度。它支持两种存储引擎,Memcached 和 Redis。 极致性能:能够支持要求最严苛且需要亚毫秒级响应时间的应用程序。 轻松扩展:通过使用 AWS 管理控制台或者简单的 API,用户可以根据应用需要添加或删除缓存集群中的节点。 安全性:支持 Amazon VPC,可以进行网络隔离。通过安全组来管理集群的访问权限。 高可用:可将 2 到 6 个节点归入一个具有副本的集群,如果一个节点出于任何原因发生故障,您不会丢失所有数据。 图数据库 关系型数据库有了,键值和内存数据库也有了,已经基本满足大部分应用的日常需求,对于 AWS 来说,这还不够。用户还会面临性能和 schema 变更不易的问题,因此 AWS 推出了图数据库 Neptune。 使用图形数据库处理社交网络数据非常高效,Amazon Neptune 可以快速轻松地处理大量的用户配置文件和交互,从而构建社交网络应用程序。 时序数据库 顾名思义,时序数据库是和时间相关的数据库。因为很多对数据的查新都是以时间段为基础的, 适用于 IoT 和运营应用程序。因此 AWS 为用户提供了 Amazon Timestream,专门处理时序数据,目前还处于注册预览版。 分类账数据库 分类账数据库的使用场景也很好理解,最适合的场景是“记账本”。“账本”是不能被更改的,每一笔记录都不能被改动,被忠实的记录下来,以备查询。Amazon Quantum Ledger Database 就应运而生了。 这听起来和“区块链”有点关系,不过 QLDB 是有中心的,而“区块链”是去中心化的,那么你可能会问,AWS 有没有去中心化的数据库,回答是有的,那就是 Amazon Managed Blockchain。我们很难去想 AWS 到底不存在什么数据库,用户需要的它有,用户用不到的它也有,可以说达到了“应有尽有”的程度。 迁移工具 介绍了这么多的数据库,以及各种数据库的使用场景和特性,几乎满足日常应用的所有需求,那我们肯定是想知道如何使用这些数据库,以及如何把目前本地自建的数据库迁移到云中。下面我们将介绍 AWS 为客户提供的迁移神器 AWS Database Migration Service,以及 DMS 如何帮助客户便捷高效地把数据迁移到云中的数据库。 同样 DMS 也是完全托管的,这让我们把主要精力放在迁移任务上面来。DMS 支持多种数据库作为迁移的源,也支持多种数据库作为迁移的目标,从下面的表格可以详细了解支持哪些数据库: 数据迁移的源 数据迁移的目标 Oracle、SQL Server、MySQL、MariaDB、PostgreSQL、SAP ASE、MongoDB、DB2 LUW、Azure SQL、Amazon RDS、S3 Oracle、SQL Server、MySQL、MariaDB、PostgreSQL、SAP ASE、Amazon RDS、Amazon Redshift、Amazon S3、Amazon DynamoDB、Amazon Elasticsearch Service、Amazon Kinesis Data Streams、Amazon DocumentDB、Amazon Neptune、Apache Kafka 我们可以从表格中看到各种数据库引擎,AWS DMS 支持同构数据库迁移,如 MySQL 迁移到 MySQL,也支持异构数据迁移,如 Oracle 到 MySQL,在进行异构数据库迁移的过程,AWS 还为用户提供一款工具 AWS Schema Conversion Tool,可以使用 AWS SCT 将源数据库架构和大部分对象自动转换为与目标数据库兼容的格式。 对 DMS 的总结,可以简单概括为下面几个小特性: 简单易用 最少停机时间 持续数据复制 多数据源支持 运行可靠 AWS DMS 可以成为复制和迁移数据库的最佳工具,它可以帮助用户将数据库工作负载迁移到 AWS 并更改数据库引擎,同时最大程度地减少停机时间。根据 AWS 的说明,使用 AWS DMS 已经进行了 20,000 个数据库到 AWS 云的迁移。由于使用该产品获得了如此广泛的成功,因此没有理由不将数据库迁移到 AWS,那么下面就开始我们的数据库迁移之旅吧。 迁移方式 所有的数据库都有自己的备份还原工具,使用这些工具我们可以方便的进行数据离线迁移,但是会造成较长的停机时间,主要看数据量的大小。如果需要最小的停机时间,那 DMS 是最佳选择。下面大致列举了各种迁移方式对业务的一个影响程度,可以根据自己的实际情况进行选择。 因素 离线(转储) 混合 在线(DMS) 复杂度 非常简单 复杂 中等 速度 快 中等 慢 停机时间 高 中 低 二、云上数据库迁移实践 迁移解决方案 我们在本地数据中心有各式各样的自建数据库,如果对数据库迁移上云,我们该如何选择云中的数据库呢,我下面简单整理了一个列表,针对不同的场景,我们可以选择对应的解决方案。 现有应用程序 MySQL ---> Amazon Aurora for MySQL,RDS for MySQL PostgreSQL ---> Amazon Aurora for PostgreSQL,RDS for PostgreSQL MariaDB ---> Amazon Aurora for MySQL,RDS for MariaDB Oracle ---> 利用 AWS SCT 检测复杂性因素 ---> Amazon Aurora,RDS for Oracle SQL Server ---> 利用 AWS SCT 检测复杂性因素 ---> Amazon Aurora,RDS for SQL Server MongoDB ---> DocumentDB 新的应用程序 如果不需要关系类功能 ---> Amazon DynamoDB 如果需要关系类功能 ---> Amazon Aurora 内存存储/缓存 Redis ---> Amazon ElasticCache Memcached ---> Amazon ElasticCache 时序数据 Amazon Timestream(注册预览版) 跟踪各应用程序变更、加密可验证性,具备中央可信权威 Amazon Quantum Ledger Database 迁移须知 数据库是任何应用程序的主要组件之一,因此我们必须谨慎地进行迁移。您需要知道数据库的大小,数据库内部表的大小以及数据库模式。 使用 AWS DMS 将数据迁移到 AWS 很简单。首先在 AWS 环境中创建复制实例,然后 AWS DMS 连接源数据库端点和目标数据库端点。迁移开始时,AWS DMS 会创建表,加载数据并同步数据库。整个复制任务都由复制实例承担,建议创建配置比较大的复制实例。 使用 AWS DMS 执行迁移的总体流程如下: 创建目标数据库。 复制架构。 创建 AWS DMS 复制实例。 定义源数据库和目标数据库的终端节点。 创建并执行迁移任务。 将 MySQL 数据迁移到 Aurora MySQL 这个案例是一个同构数据库迁移,相对来说比较简单,迁移的方案有三种,可以直接使用mysqldump导出数据,然后再导入到 Aurora,适合数据量不大的数据库,另外一种是直接把数据库的源文件复制到 S3 存储桶,可以使用 Xtrabackup 备份数据库然后传到 S3 中,然后用这些文件还原到 Aurora 数据库,适合比较大量的数据,不过这两种数据库都是离线传输,需要停机迁移。 针对实时在线迁移数据库,我们需要用到 AWS DMS,下面我将演示如何从一台 MySQL 数据库,实时迁移数据到 Aurora,对于源数据库,我们可以使用 AWS RDS,或者在 EC2 上面的自建数据库,或是其他云厂商的 MySQL 数据库,下面我选择使用在 EC2 上面自建的数据来进行演示,所以操作均在 AWS us-east-1 区域。 1、配置源数据库 源数据库我们已经有了,你可以创建一个只读权限的临时账户用于数据迁移,我们这里就直接用具有读写权限的账户演示。 2、创建 Aurora 数据库 首先我们在 AWS 控制台中创建一个 Aurora MySQL 数据库作为我们的目标数据库,因为不是主要介绍创建数据库,所以创建过程这里不再演示,创建完成之后,需要记录下数据库地址,账户密码,当然为了安全,你也可以单独创建一个用于迁移的临时账户。 3、创建复制实例 AWS DMS 复制实例执行源和目标之间的实际数据迁移。复制实例负责整个数据的迁移,对更改的数据进行缓存,所以说大一点的实例性能更好,缩短迁移时间。打开 AWS DMS 控制台,选择创建复制实例,注意网络方面的限制,需要复制实例可以连接到两个数据库。 4、创建 MySQL 终端节点 在 AWS DMS 控制台中,在导航窗格中选择 Endpoints (终端节点)。 5、创建 Aurora 终端节点 目标终端节点会更简单一写,因为是 AWS RDS,我们可以直接勾选。 6、创建迁移任务 迁移任务中的迁移类型我们选择复制现有数据以及持续复制变更的数据,记得源数据库开启 binlog 日志。 在表映射选项里面,选择告知 DMS 应该迁移哪些表,迁移过程中还可以对表名进行一些转换,我们这里就选择完全复制整个数据库。 7、监控迁移任务 再等待一段时间之后,我们可以在任务详情里面看到数据迁移完成,并且目标数据库数据检查没有问题。 我们可以看到,通过 DMS 仅仅需要简单几步就可以把数据库迁移到 AWS,并且源数据库变更数据会实时的更新到目标数据库中。 将 SQL Server 数据库迁移到 Aurora MySQL 这个案例是一个异构数据库迁移,我们会用到 AWS SCT 进行 Schema 转换,AWS DMS 支持从 RDS 迁移到 RDS,所以这次的源数据库 SQL Server 是 AWS RDS for SQL Server(Enterprise Edition)。 Schema 转换 1、在本地计算机安装 AWS SCT 需要在自己的电脑上面安装 AWS SCT 工具,以及连接 SQL Server 的 JDBC 驱动和 Aurora MySQL 的 JDBC 驱动。 驱动下载地址参照官方文档 https://docs.aws.amazon.com/zh_cn/SchemaConversionTool/latest/userguide/CHAP_Installing.html#CHAP_Installing.JDBCDrivers 然后启动 SCT,配置一下刚刚下载的 JDBC 驱动。 2、创建迁移项目 打开 AWS SCT,选择创建一个新项目,选择源和目标数据引擎。 分别连接 SQL Server 和 AWS Aurora 数据库。 勾选我们要迁移的数据库,右键选择 Create report。 查看报告,看看有没有问题,如果没有问题,我们就可以直接进行转换了。 我这边遇到一个存储过程 MySQL 不支持,我这边忽略掉,比较懂数据库的人员可以进行修正。 3、Schema 转换 问题处理掉之后,我们就可以进行 Schema 转换了,和前面一样,右键数据库,选择 Convert schema。 执行之后,很快我们在目标数据库看到了转换的 Schema。 数据迁移 对于 SQL Server 的数据迁移方式,我们选择一次性迁移,不进行持续复制,持续复制配置过程稍微复杂一些,需要对源数据库进行一些配置,需要持续复制的用户,可以参照 AWS 官方文档配置。 1、创建复制实例 打开 DMS 控制台,创建复制实例,同样注意网络情况,复制实例需要链接源和目标数据库。 2、创建 AWS DMS 源和目标终端节点 创建完终端节点之后,首先运行一下测试,可以连接成功即可。 3、创建迁移任务 可以按照我下面的表格选择来配置迁移任务。 Parameter Value Task identifier AuroraMigrationTask Replication instance replication-server Source database endpoint sqlserver Target database endpoint dst-mysql-instance-1 Migration type Migrate existing data Start task on create Checked Target table preparation mode Do nothing Include LOB columns in replication Limited LOB mode Max LOB size (KB) 32 Enable validation Unchecked Enable CloudWatch logs Checked 在表映射方面,我们可以这样设定,就不进行表名的转换了,然后创建任务即可。 Parameter Value Schema Tecno Table name % Action Include 4、检查目标库数据 可以看到,迁移任务完成,数据也都转移过来了。 至此我们完成了异构数据库迁移,整个过程会比同构数据库迁移麻烦一些,不过整体也是比较简单了。DMS 完全托管、按量付费、图形界面操作,是数据库上云的利器,推荐大家使用 DMS 对数据库迁移上云。 三、总结 AWS 数据库优势 在众多的云厂商中,我们为什么选择 AWS 数据库服务,AWS 还有哪些独特的优势呢?我主要总结以下几点: 成本优势 使用自建数据,企业首先需要支付一笔资金购买服务器,一些商业数据库的授权,需要再次支付一笔费用。如果迁移到 AWS 的自研数据库,客户不必再支付高昂的商业数据库授权,也不必再去花费大量资金去购买服务器,在云中,客户只需要按量付费,因此很多企业由于把数据库迁移到 AWS 而节省巨大费用支出。 从最近的 AWS 公告中,看到 AWS 帮助三星把数据从商业数据库 Oracle 迁移到了 Aurora,为三星每月的数据库成本降低了 44%,并让三星的数据库运行更加稳定。 完全托管 以上所说的几种数据库都是 AWS 完全托管的数据库,完全托管意味着零运维。首先客户不需要去维护硬件的生命周期、系统的补丁更新、高可用的部署、备份等。如果需要对数据库扩展,也只需点几下鼠标而已,非让方便,让 DBA 从复杂的数据库运维中解脱出来,专注于数据库性能调优。 全球优势 过去我们需要借助非常复杂的技术手段,花费大量的成本、甚至牺牲一定的可用性,才能实现快速、稳定、安全的跨区域的数据复制,现在只要在 AWS 云中轻轻点几下鼠标即可完成。 AWS 云现已在全球 24 个地理区域内运营着 77 个可用区,180个边缘站点等,为 AWS 相应全球数据库提供了基础保障。依托于 AWS 强大的基础设施,目前已经有三款数据库支持全球同步,延迟通常不超过 1 秒,可以满足目前大部分应用的需求。 对于关系型数据库的全球同步需求,Amazon Aurora Global Database 能够允许用户轻松实现跨区域的数据库部署,让用户轻松在区域之间复制数据和解决更新冲突,从而更加专注于应用程序的业务逻辑。 AWS 还提供了 Amazon DynamoDB Global Tables。它基于 DynamoDB 的全球覆盖范围构建,具有多区域、多主表的特性,可让全局分布式应用程序实现快速的本地读写性能,为用户提供一个完全托管的、多区域、多主的 Key-Value 类型数据库。 针对缓存数据库,在众多组织都在利用 Redis 为全球用户提供低延迟访问的背景下,AWS 为更好满足客户的需求,AWS 推出了 Amazon ElastiCache Global Datastore for Redis 全球缓存数据库,为用户提供数据跨区域复制,可以在一个区域写入数据,同时在其他区域读取数据,使缓存的数据更接近用户,减少网络延迟,并提高应用程序的响应能力。 心得与建议 当然,数据库迁移是一个庞大而复杂的工程,尤其将数据库迁移上公有云,除了数据库知识更需要了解公有云上网络,存储,虚拟化等一系列知识。但是,我们不应该仅仅将数据库上云看做一个复杂的任务,更应该把它当做一个优化我们数据库的契机,那么上云过程中有哪些注意事项和建议呢? 对于一些允许停机的应用,这部分数据我们推荐使用离线迁移,整个操作比较简单,速度快,不容易出问题。 如果业务需要在线迁移,那么推荐使用 DMS 进行迁移,需要注意的是,在数据库切换之前先停掉源数据库写入,带数据完全同步到目标数据库之后进行数据库切换。 如果迁移的数据量比较大,建议选择配置比较大的复制实例,这样可以加速我们的复制速度。 如果您想要转换数据库引擎,在使用 SCT 进行 Schema 转换的时候可能会遇到一些目标数据库不支持的地方,请先联系 DBA 人员,对这些地方进行更改,满足之后再进行转换。

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册