首页 文章 精选 留言 我的

精选列表

搜索[AI漏洞挖掘],共10000篇文章
优秀的个人博客,低调大师

《R语言数据挖掘》----导读

Preface 前 言 世界各地的统计学家和分析师正面临着处理许多复杂统计分析项目的迫切问题。由于人们对数据分析领域的兴趣日益增加,所以R语言提供了一个免费且开源的环境,非常适合学习和有效地利用现实世界中的预测建模方案。随着R语言社区的不断发展及其大量程序包的不断增加,它具备了解决众多实际问题的强大功能。R编程语言诞生已经有数十年了,它已经变得非常知名,不但被社区的科学家而且被更广泛的开发者社区所熟知。它已经成长为一个强大的工具,可以帮助开发者在执行数据相关任务时生成有效且一致的源代码。由于R语言开发团队和独立贡献者已经创建了良好的文档,所以使用R语言编程并不困难。进而,你可以使用来自R语言官方网站的程序包。如果你想不断提高自己的专业水平,那么你可能需要阅读在过去几年中已经出版的书籍。你应该始终铭记:创建高水平、安全且国际兼容的代

优秀的个人博客,低调大师

R语言数据挖掘导读

Preface 前 言 世界各地的统计学家和分析师正面临着处理许多复杂统计分析项目的迫切问题。由于人们对数据分析领域的兴趣日益增加,所以R语言提供了一个免费且开源的环境,非常适合学习和有效地利用现实世界中的预测建模方案。随着R语言社区的不断发展及其大量程序包的不断增加,它具备了解决众多实际问题的强大功能。 R编程语言诞生已经有数十年了,它已经变得非常知名,不但被社区的科学家而且被更广泛的开发者社区所熟知。它已经成长为一个强大的工具,可以帮助开发者在执行数据相关任务时生成有效且一致的源代码。由于R语言开发团队和独立贡献者已经创建了良好的文档,所以使用R语言编程并不困难。 进而,你可以使用来自R语言官方网站的程序包。如果你想不断提高自己的专业水平,那么你可能需要阅读在过去几年中已经出版的书籍。你应该始终铭记:创建高水平、安全且国际兼容的代

优秀的个人博客,低调大师

《R语言数据挖掘》——导读

前 言 世界各地的统计学家和分析师正面临着处理许多复杂统计分析项目的迫切问题。由于人们对数据分析领域的兴趣日益增加,所以R语言提供了一个免费且开源的环境,非常适合学习和有效地利用现实世界中的预测建模方案。随着R语言社区的不断发展及其大量程序包的不断增加,它具备了解决众多实际问题的强大功能。R编程语言诞生已经有数十年了,它已经变得非常知名,不但被社区的科学家而且被更广泛的开发者社区所熟知。它已经成长为一个强大的工具,可以帮助开发者在执行数据相关任务时生成有效且一致的源代码。由于R语言开发团队和独立贡献者已经创建了良好的文档,所以使用R语言编程并不困难。进而,你可以使用来自R语言官方网站的程序包。如果你想不断提高自己的专业水平,那么你可能需要阅读在过去几年中已经出版的书籍。你应该始终铭记:创建高水平、安全且国际兼容的代码比初始创建的第

优秀的个人博客,低调大师

充分挖掘大数据资源“富矿”

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 “一些掌握数据资源的机构或部门不愿、不敢、不会开放共享数据。不愿,是因为觉得自己的数据很重要,要掌握在自己手上;不敢,是因为没有法律、标准支撑,担心数据的安全;不会,则是受制于数据技术研发瓶颈。”近日,中科院院士梅宏关于大数据产业的这段论述引发热议。 在信息化时代,数据资源被社会各方所重视,越来越多的市场主体期望通过大数据资源来改善经营,开创日益广阔的新天地。为顺应这一趋势,北京、上海、贵州等地积极布局大数据交易平台,数据交易日趋活跃。然而,数据供求矛盾突出的问题却仍然存在。一方面,以国有数据资源和公共数据资源为主的大量宝贵数据没有得到有效利用;另一方面,地下数据交易规模不小,针对用户信息的非法收集、窃取、贩卖行为猖獗,甚至形成产业链。 大数据资源是一处“富矿”,开掘好了,无疑能使经济社会发展如虎添翼,若开掘不当,则不免加大市场运作成本、降低经济运行效率,同时也给市场经济主体的权益保护、社会和谐稳定带来隐患。促进大数据资源的有效利用,使之更好地服务于社会,就要推进大数据产业发展,规范引导大数据交易。 首先,解决好有些机构、部门“不愿”共享数据的问题。除加强宣传教育,努力转变这些机构、部门人员的思想观念之外,关键还在于尽力创造条件,消除机构、部门之间的数据壁垒,通过进一步推进政务公开,积极构建形式公平、互惠的交易通道,将那些锁在“深闺”的大数据资源“请”出来。 其次,针对有些机构、部门“不敢”共享数据的问题,需要不断加大大数据市场研究,围绕数据交易主体的顾虑、大数据交易过程中易于出现的种种问题,加快制定数据交易相关法律法规,明确数据交易、使用边界。必要时可建立数据交易、使用的评估与审计机制,加强数据交易、使用的动态化监管,以此为数据交易设置保护屏障,使交易各方在保护屏障内放心交易。 ***,必须有效化解有些机构、部门“不会”共享数据的问题。当前,迫切需要推动建立并完善数据交易标准,通过在数据采集、存储、传输、应用等环节出台相应技术标准,提升数据资源的交易适用性。在此基础上,鼓励引导数据交易各方加强数据资源开发利用的技术研发,使数据资源在筛选、分析、建模等一系列深加工之后,形成更多品类的产品,发掘出其更多的实际效能,增强数据产品的市场吸引力与社会贡献度。

优秀的个人博客,低调大师

多引擎集成挖掘湖上数据价值

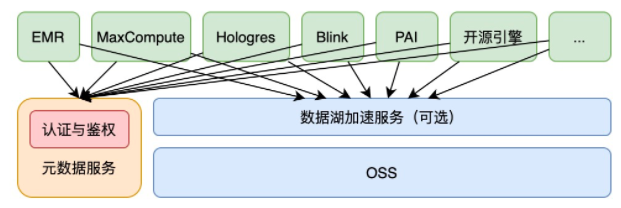
数据湖已经逐步走到了精细化的管理,这意味着原始的计算引擎直接读写存储的方式应当逐步演变为使用标准方式读写数据湖存储。然而“标准方式”实际上并无业界标准,与具体的计算引擎深度绑定,因此,支持计算引擎的丰富程度也就成了衡量数据湖的一个准则。 阿里云数据湖构建服务支持丰富的计算引擎对接,包括但不限于阿里云产品 E-MapReduce(EMR)、MaxCompute(开发中)、Blink(开发中)、Hologres(开发中)、PAI(开发中),以及开源系的 Hive、Spark、Presto 等等。 数据湖的对接主要体现在元数据与存储引擎两个方面。元数据为所有用户所共享,提供统一的元数据访问接口。各个引擎使用定制化的元数据访问客户端来访问元数据。元数据服务为各个用户提供租户隔离保证和认证鉴权服务。在数据存储方面,用户使用自己的 OSS 存储存储数据,各个引擎需要具备访问 OSS 的功能,这对于阿里云服务和大部分支持 HDFS 存储的引擎都不是什么问题。在 OSS 存储上层,数据湖构建服务还提供了可选的数据湖加速服务。而使用该服务也非常简单,只需要在引擎侧将对 OSS 的访问路径替换为加速服务提供的路径即可。 多引擎支持 EMR 使用 EMR 访问数据湖构建服务最为简单。在用户创建 EMR 集群的时候,可以直接选择使用数据湖构建服务的元数据服务作为元数据库,EMR 服务与数据湖构建服务在认证鉴权方面深度打通,只要获得用户的授权,EMR 基于数据湖元数据的使用体验和用本地元数据库体验几乎完全一致。因为在 EMR 集群创建阶段已经自动安装了数据构建服务的相关SDK,同时EMR上的开源计算引擎 Spark、Hive 和 Presto 都完成了对数据湖构建服务的兼容支持,所以用户通过 EMR 引擎可获得数据湖分析的最佳体验。 即便用户在创建集群的时候没有选择使用数据湖元数据服务,也可以在后期通过配置将元数据转移到数据湖元数据服务。在数据存储方面,由于数据湖构建在用户 OSS 之上,因此不存在跨服务认证问题。而 EMR 天然内置了 OSS 的访问支持,并提供了 JindoFS 的增强功能,使得 EMR 用户访问数据湖数据将获得比原生 OSS 访问更佳的性能提升(JindoFS 是构建在 OSS 之上的,专门为大数据使用场景深度定制的文件系统,在元数据操作、数据缓存等方面有独到的优势。更多相关文章请参考文末链接。)。对于那些已经在使用 EMR 的用户,数据湖构建服务提供了一键迁移工具,方便用户将元数据从本地元数据库转移到数据湖元数据服务。对于数据部分,用户可以选择将数据继续存储在本地 HDFS 系统,或者迁移至 OSS。 值得一提的是 EMR 提供了免 AK 访问数据湖构建服务的功能。用户不需要提供 AK 即可访问元数据服务以及 OSS 上的数据,前提是数据湖构建服务获得了用户的授权。该功能的实现基于 EMR 的 MetaService 功能,在用户授权的前提下,MetaService 为本机请求提供 Assume Role 的 AK 信息,从而让调用者以用户身份访问目标服务。免 AK 访问功能最小化了用户机密信息丢失的风险。 阿里云服务 MaxCompute、实时计算、Hologres、PAI 等阿里云服务,通过数据湖构建服务在底层打通数据,在一定程度上达到通过使用一份数据满足多种不同场景的计算需求。例如,MaxCompute 可以直接读取数据湖构建服务的数据内容,配合 DataWorks 给用户良好的数仓使用体验;实时计算服务可以将数据实时注入数据湖,从而实现基于数据湖的流批一体计算;而 Hologres 则可以应对对性能要求较高的场景,既能够对于数据湖内温冷数据做加速分析,也能够配合 Hologres 的内置存储处理温热数据,从而构建数据从产生到归档一整个生命周期的一站式分析方案;PAI 则可以将数据湖作为数据来源,也可以将其他引擎计算的离线特征存储到数据湖做模型构建之用等等。 开源引擎 对于直接使用开源产品的用户,数据湖构建服务也提供了一些方法让这些服务能够快速对接数据湖,不过这可能需要用户基于开源代码打个 patch,以便在开源代码中插件化地嵌入数据湖元数据的访问。对于数据访问,由 EMR 团队贡献 Hadoop 社区的 OSSFileSystem 可以完成对用户 OSS 存储的访问,因此只要引擎支持读写 HDFS,就可以读写 OSS。对于元数据和 OSS 的访问控制,则统一使用阿里云 RAM 方式,体验上保证一致。 特殊格式支持 除了计算引擎本身,某些引擎还可以读写特定的表格式,如近两年兴起的 Delta Lake、Hudi、Iceberg 等等。数据湖构建服务不局限用户使用哪一种存储格式,但是由于这些表格式有自己的元数据,因此在引擎对接方面仍然需要做一些额外的工作。以 Delta Lake 为例,其元数据存储在 OSS 之上,而元数据服务中也会存一份元数据,这样便引出了两个问题:一是引擎应该读取哪份元数据,二是如果有必要存两份元数据的话,元数据的一致性如何保证。对于第一个问题,如果是开源组件,我们应当遵循开源默认的做法,通常是让引擎去读取 OSS 中的元数据。对于元数据服务中的元数据也非常有必要保存,这可以服务于页面显示,并且可以省去 OSS 元数据解析的巨大性能损耗。对于第二个问题,数据湖构建服务开发了一个 hook 工具,每当 Delta Lake 有事务提交时,便会自动触发 hook,将 OSS 中的元数据同步到元数据服务中。除此之外,Delta Lake 元数据的设计最大程度的保证了一份元数据同时支持 Spark、Hive、Presto 等多个引擎,用户不必像开源产品那样为不同引擎维护不同的元数据。 如图所示,元数据服务中的元数据(Delta Table)为 OSS 中 Delta 表元数据(Delta Log)的映像,并通过 commit hook(3)保持同步;Delta Tabe 为页面展示,以及 Hive、Spark 引擎读取必要信息(如 table path、InputFormat/OutputFormat 等)所用(1);当引擎获得必要信息后读取 table path 下 Delta 表的元数据,完成元数据解析和数据读取工作(2);当引擎完成数据操作并提交事务后,Delta Log 通过 commit hook 同步至 Delta Table(3),完成一个循环。 未来工作 数据湖构建服务的多引擎支持在诸多方面尚在快速发展之中。未来我们将围绕以下几点继续开展工作: 阿里云服务对接:从解决方案角度完善阿里云产品对接,给用户更平滑的体验; 开源引擎支持:更多的开源引擎支持,如 Impala、Flink 等; 功能丰富:如完善统计信息支持,支持事务接口等; 性能提升:做到超越本地元数据与本地 HDFS 存储的性能。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册