首页 文章 精选 留言 我的

精选列表

搜索[源码学习],共10010篇文章
优秀的个人博客,低调大师

Docker快速安装Oracle11G,搭建oracle11g学习环境

安装说明 1.操作系统CentOS7_x64 2.安装的数据库为Oracle11G 3.已经安装了Docker环境 4.安装一些必要的软件 sh 复制代码 yum install unzip -y unzip:解压oracle安装文件 5.提前准备Oracle11G安装镜像 下载地址:https://www.oracle.com/technetwork/database/enterprise-edition/downloads/index.html 6.需要检查是否有swap分区,如果没有请设置 安装 1.镜像准备 将下载的Oracle安装包上传到指定目录并解压 如:/data0/oracle 解压命令 sh 复制代码 unzip linux.x64_11gR2_database_1of2.zip && unzip linux.x64_11gR2_database_2of2.zip 2.Docker安装 镜像准备 sh 复制代码 docker pull jaspeen/oracle-11g 启动镜像 sh 复制代码 docker run --privileged --name oracle11g -p 11030:1521 -v /data0/oracle:/install jaspeen/oracle-11g 注: /data0/oracle为刚刚Oracle解压路径 oracle11g为Docker容器名称 1521:1521为内部端口映射外部端口 等待安装结束 3.切换镜像配置密码 查看镜像是否在运行 sh 复制代码 docker ps 进入oracle11g容器 sh 复制代码 docker exec -it oracle11g /bin/bash 注:oracle11g为Docker容器名称,注意与上面对应 切换到image的oracle用户 sh 复制代码 su - oracle 进入oracle数据库 sh 复制代码 sqlplus / as sysdba 查看数据库运行状态 sh 复制代码 select status from v$instance; 修改sys用户密码 sh 复制代码 alter user sys identified by oracle; 4.外网连接测试 用户名:sys 密码:oracle 服务名:orcl 端口:1521

优秀的个人博客,低调大师

时序数据库Influx-IOx源码学习二(环境搭建)

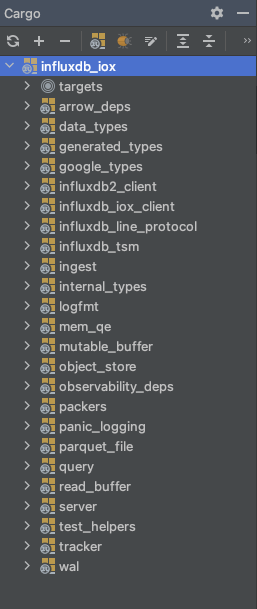
欢迎关注微信公众号:atoildw (数据库技术研究) 上一篇介绍了InfluxDB IOx的一些项目背景及现有架构中存在的问题,详情见:https://my.oschina.net/u/3374539/blog/5015114 1.克隆仓库 git clone https://github.com/influxdata/influxdb_iox.git 2.安装基础语言依赖 根据readme文件中的的描述,项目依赖两个基础环境,分别是rust和clang。 rust是使用rustup来进行版本管理的。默认的情况下,会为你安装最后的stable版本,但是IOx项目为了使用不太稳定的SIMD特性,从而达到更高的性能,所以在rust-toolchain文件中指定了一个nightly的版本。 rust安装 脚本: curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh 测试版本号: rustc --version rustc 1.51.0 (2fd73fabe 2021-03-23) cd influxdb_iox rustc --version rustc 1.50.0-nightly (825637983 2020-11-18) clang安装 安装clang是为了编译croaring这个依赖(RoaringBitmap,根据查询语句进行逐列查询的时候使用),安装脚本根据系统的不同。 mac: xcode-select --install clang --version Apple clang version 12.0.0 (clang-1200.0.32.29) Target: x86_64-apple-darwin20.3.0 Thread model: posix InstalledDir: /Library/Developer/CommandLineTools/usr/bin 3.IDE搭建 我个人使用的goland,感觉相比于IDEA要速度更快一些。 GoLand下载:https://www.jetbrains.com/go/ 安装Toml插件: https://plugins.jetbrains.com/plugin/8195-toml 安装Rust插件: https://plugins.jetbrains.com/plugin/8182-rust 4.导入工程 当全部完成后,你可以在IDE的右侧看到如下截图: 你也可以在命令行中执行: cargo build 具体速度快慢就要看命了,网络至少需要访问github、crates.io 5.在IDE中启动 打开src/main.rs文件,然后右键-->Run. 在运行之后,在命令行里会提示一个错误,然后退出。原因是我们并没有输入系统可以识别的启动命令。 打开启动配置页面,在command中贴入, run --package influxdb_iox --bin influxdb_iox run 然后就能看到程序启动成功的提示: 祝玩儿的开心!

优秀的个人博客,低调大师

时序数据库Influx-IOx源码学习一(项目背景)

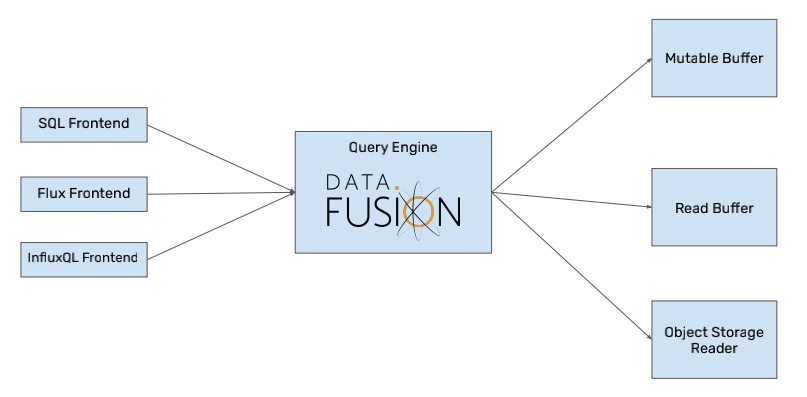
为什么会发起IOx项目 原文请参见: https://www.influxdata.com/blog/announcing-influxdb-iox/ 1. 下一步的目标 原文中介绍到,过去的7年时间的发展中,InfluxDB 在 metrics 数据的处理上已经成为了非常出色的数据库,并且在 analytics 方面也很不错。但对于现有的架构来讲有一个限制就是不能处理非常大的基数 (significant cardinality),也就是说tags里不能设置太多的值。比如说:不能处理分布式追踪数据 (distributed tracing data) 的这种场景。 另外在开源方面,InfluxDB 仅仅支持单机版本的开源,对于分布式版本只有企业版本或者云上才会提供,这个决定给分布式时序数据库留下了很大一块空白的市场。 所以在大方向上,InfluxDB 定义了13个要求,大家可以在原文中找到,总结为: 从设计上减少对于用户的限制:比如 tag 或者 field. 交给用户更多的控制权:比如内存、分区、副本、读写、索引等 支持container的运行环境 大数据的倒入倒出 细粒度的订阅数据 兼容更多的生态,包括数据标准及分析等 可以运行在边缘或者数据中心 可以支持内嵌脚本(我理解为UDF这类) 2. 更开放的许可 InfluxDB对于分布式版本是闭源的,这使得它在市场上和其它产品相比存在很大的差距,使得过去的几年中出现了很多时序数据库。并且如果开源协议对商业是有限制的,那么一些大的公司就会再开发自己的数据库出来,或者是采用其它开源的数据库,这样就造成了大家相互之间的不兼容的。 如果开源的协议采用有限制的协议,那么很多开发者除了内部使用外,即便是已经拿到开源的代码都别无选择的需要重新再开发。 开源创造了一个寒武纪大爆发,会创造出一个非常大的价值。开源不是零和博弈,一个非常大的社区和生态会为所有人和供应商带来更多的机会。 如果InfluxDB想成为无数公司的传感器、监测、数据分析的基础方案,那么唯一的方法就是可扩展、可采用、任何人可以商业化。综上所述,InfluxDB选择了 MIT & Apache 2双重许可。 那么InfluxDB如何盈利呢?在分布式的版本中,可能需要一系列的运维、监控等外围的工具,作为盈利的点。这样无论是云产品还是开源版都是相同的代码,不产生fork。 3. 更新的设计 在现有的InfluxDB中,数据是这样: cpu,host=serverA,region=west user=23.2,system=53.2 1604944036000000000 意思是,存储的cpu这个measurement;他有两个tag,分别是host和region;有两个field,分别是user和system;最后是一个纳秒的时间戳。数据被存储和索引为: measurement, tag key/value pairs, field name 基于时间排序的(time-value)的键值对被存储为了一个单独的时间序列。measurement、tag (key-value)、field 被保存成了一个倒排索引。所以InfluxDB实际上是两个数据库,一个倒排索引和一个时间序列。这意味着,只要tag中存在里新的值,就必须存储在倒排索引中。比如在分布式追踪(distributed tracing ) 的场景里,每行数据都有一个唯一的id,这意味着二级索引比时序数据还要大,服务器就需要浪费大量的cpu和内存来处理索引数据。 有一个解决的方案就是使用field来存储,但是这样限制来用户的使用,必须考虑什么时候为标签、什么时候是字段,查询的时候也需要考虑是否能使用到索引。 如果修改成为无限的基数(cardinality),唯一的方式就是合并时序数据和倒排索引,这是数据库设计的核心。 文章中还提到了严格的内存控制,如果想做内存控制,就不能使用MMAP,所有的数据(索引和时序数据)在InfluxDB中使用到的内存都需要被计算。 对象存储作为持久性层和批量数据导入导出的需求很难通过InfluxDB构建的底层存储引擎来实现。现有的设计基本上假定是一个本地SSD,并且不允许将其中的数据导出到对象存储并在查询时导入。采用这种索引和时间序列数据分开的存储结构也难以实现大量数据的导入和导出。 这些潜在的问题导致无法让InfluxDB做的更好,所以需要从根本上重新思考数据库的存储结构及核心架构是该如何组织。 4. Rust, Arrow, 列式存储 在决定重构核心的功能时,就必须要考虑使用什么工具能够让这个重构的过程变得更快、更可靠、更面向社区。Rust作为系统级编程语言及Apache Arrow作为内存分析工具集,这两款开源工具在过去的几年中,取得了巨大的进步。 Rust可以为我们提供了运行时行为和内存管理的更细粒度控制。还有一个额外的好处就是并发编程更容易,消除了数据竞争。在Crates.io中又几乎包含了所有你需要用到的东西。 Apache Arrow定义了一个内存的列式数据结构并且可以对接Parquet(列式持久化文件格式)、Flight(一个client/server的通信协议框架,传输大数据集的高性能网络接口)。使用Rust和Arrow还有一个额外的好处就是DataFusion(为Apache Arrow提供Rust原生支持的SQL查询引擎)。使用DataFusion作为核心,意味着InfluxDB IOx将提供一个开箱即用的SQL子集。当然除了SQL之外,还会继续支持InfluxQL和Flux。 基于列式存储的数据模型: Measurements会变为Table(每一个measurement都是一张表) Tags和Fields会成为表中的列(这样就需要通过measurement来锁定一个范围) Tag和Field的Key在一个measurement中必须是唯一的 时间也会作为表中的列 除了scheme的组织,还选择了Parquet作为持久化文件格式。每个Parquet文件都包含了一张表中的部分数据,也就是每个Parquet文件只包含一个measurement的数据。实验表明,Parquet比InfluxDB自己的TSM引擎具有更好的压缩比。 另外是用户必须在创建数据库的时候指定分区策略(比如基于时间的每2个小时)。对于每个分区,可以存储一些摘要性的数据在内存中,包含分区都拥有哪些表,有什么列,这些列的最大最小值等。这意味着查询计划可以在执行前通过这个元数据排除大量的分区数据。同时这种分区方案更容易使用对象存储作为长期存储,并管理从内存到对象存储再到索引的Parquet文件的数据生命周期。 现有的列式数据库,并没有单独针对于时序数据做优化并且分离计算和存储,尤其是具有非常优秀的字典和窗口聚合查询。 最后文中提到了一点很有意思的研究方向,他说:我们需要一个能够在内存中保存压缩数据并对其执行查询的系统。所以正在积极扩展DataFusion使其能够处理更多的内存中的时序数据。 5.个人总结 整体看来,InfluxDB想把所有功能开源、分离计算和存储,支持对象存储的方式、精细的控制内存、并且可以在内存中处理压缩的数据。不是什么颠覆式创新,只是为了更好的处理时序数据。

优秀的个人博客,低调大师

时序数据库Influx-IOx源码学习五(创建数据库)

欢迎关注公众号: 上篇介绍到:InfluxDB-IOx的Run命令启动过程,详情见:https://my.oschina.net/u/3374539/blog/5021654 这章记录一下Database create命令的执行过程。 在第三章命令行中介绍了,所有的子命令都有一个独立的参数或配置称为subcommand。 enum Command { Convert { // 省略 ...}, Meta {// 省略 ...}, Database(commands::database::Config), Run(Box<commands::run::Config>), Stats(commands::stats::Config), Server(commands::server::Config), Writer(commands::writer::Config), Operation(commands::operations::Config), } 这章我们打开看一眼commands::database下的config包含了什么。 pub struct Config { #[structopt(subcommand)] command: Command, } //见名知意,基本猜测一下就行了,慢慢使用到再回来看 enum Command { Create(Create), List(List), Get(Get), Write(Write), Query(Query), Chunk(chunk::Config), Partition(partition::Config), } 先来看一下create命令的执行。 Command::Create(command) => { //创建一个grpc的client let mut client = management::Client::new(connection); //设置基本的配置项 let rules = DatabaseRules { //数据库名字 name: command.name, //内存的各种配置,包含缓存大小,时间等等 lifecycle_rules: Some(LifecycleRules { //省略。。 }), //设置分区的策略 partition_template: Some(PartitionTemplate { //省略。。 }), //其它都填充default ..Default::default() }; //使用配置信息创建数据库,这里是生成了一个CreateDatabaseRequest去调用了远程服务器的方法 client.create_database(rules).await?; println!("Ok"); } 在上一章中提到了grpc的启动,这里就涉及到了之前提到的grpc的框架tonic,在tonic中使用#[tonic::async_trait]了标记一个服务器端的实现开始。我在ide中搜索,可以在src/influxdb_ioxd/rpc/management.rs:50行中找到ManagementService相关的实现。 有关tonic更多的资料请阅读:https://github.com/hyperium/tonic #[tonic::async_trait] impl<M> management_service_server::ManagementService for ManagementService<M> where M: ConnectionManager + Send + Sync + Debug + 'static, { //省略其它方法。。。 async fn create_database( &self, //这里就是接收CreateDatabaseRequest的请求 request: Request<CreateDatabaseRequest>, ) -> Result<Response<CreateDatabaseResponse>, Status> { //对数据进行一下校验,然后获得在上面配置的rules规则 let rules: DatabaseRules = request .into_inner() .rules .ok_or_else(|| FieldViolation::required("")) .and_then(TryInto::try_into) .map_err(|e| e.scope("rules"))?; //这里就是在第三章中提到的server_id,如果没配置就会报错了 let server_id = match self.server.require_id().ok() { Some(id) => id, None => return Err(NotFound::default().into()), }; //这里就是真正的去创建,在下面继续跟踪 match self.server.create_database(rules, server_id).await { Ok(_) => Ok(Response::new(CreateDatabaseResponse {})), Err(Error::DatabaseAlreadyExists { db_name }) => { return Err(AlreadyExists { resource_type: "database".to_string(), resource_name: db_name, ..Default::default() } .into()) } Err(e) => Err(default_server_error_handler(e)), } } } 接下来要继续查看数据库真正的被创建出来,我读到这里存在一个问题,文件格式是什么样子的? pub async fn create_database(&self, rules: DatabaseRules, server_id: NonZeroU32) -> Result<()> { //检查server_id self.require_id()?; //把数据库名字存储到内存中,最终保存到一个btreemap中 let db_reservation = self.config.create_db(rules)?; //对数据进行持久化保存 self.persist_database_rules(db_reservation.rules().clone()) .await?; //启动数据库后台线程,在内存中写入数据库状态 db_reservation.commit(server_id, Arc::clone(&self.store), Arc::clone(&self.exec)); Ok(()) } 来解答上面的疑问,文件是怎样持久化、格式是什么样子的。 pub async fn persist_database_rules<'a>(&self, rules: DatabaseRules) -> Result<()> { //生成一个新的数据库路径 let location = object_store_path_for_database_config(&self.root_path()?, &rules.name); //序列化DatabaseRules这个pb到byte流 let mut data = BytesMut::new(); rules.encode(&mut data).context(ErrorSerializing)?; let len = data.len(); let stream_data = std::io::Result::Ok(data.freeze()); //将pb的内容进行存储 self.store .put( &location, futures::stream::once(async move { stream_data }), Some(len), ) .await .context(StoreError)?; Ok(()) } 这里调用了rules.encode()转换到pb的格式,这里是rust语言的一个方法,实现了From特性的,就得到了一个into的方法,如:impl From<DatabaseRules> for management::DatabaseRules. 到这里数据库的一个描述文件rules.pb就被写入到磁盘中了,路径是启动命令中指定的--data-dir参数路径 + --writer-id + 数据库名字。 例如,我的启动和创建命令为: ./influxdb_iox run --writer-id 1 --object-store file --data-dir ~/influxtest/ ./influxdb_iox database create test 那么得到的路径就为:~/influxtest/1/test/rules.pb. 之后可以运行一个pb的脚本来反查rules.pb中的数据内容,如下: $ ./scripts/prototxt decode influxdata.iox.management.v1.DatabaseRules \ < ~/influxtest/1/test/rules.pb influxdata/iox/management/v1/service.proto:6:1: warning: Import google/protobuf/field_mask.proto is unused. name: "test" partition_template { parts { time: "%Y-%m-%d %H:00:00" } } lifecycle_rules { mutable_linger_seconds: 300 mutable_size_threshold: 10485760 buffer_size_soft: 52428800 buffer_size_hard: 104857600 sort_order { order: ORDER_ASC created_at_time { } } } 看到这里已经知道整个生成过程及文件内容。 祝玩儿的开心。

优秀的个人博客,低调大师

时序数据库Influx-IOx源码学习四(Run命令的执行)

欢迎关注公众号: 上篇介绍到:InfluxDB-IOx的命令行及配置,详情见:https://my.oschina.net/u/3374539/blog/5017858 这章记录一下Run命令的执行过程。 //根据用户在命令行配置的num_threads参数 //来选择创建一个多线程的模型,还是current_thread的模型 //后面有时间深入研究tokio的时候再来分析有什么异同 let tokio_runtime = get_runtime(config.num_threads)?; //block_on会让线程一直等待方法里的future执行完成 //这是让闭包中的方法占有了io driver 和 timer context tokio_runtime.block_on(async move { let host = config.host; match config.command { // 省略其它command ... Command::Run(config) => { //具体去子类型里执行,然后await一个结果 if let Err(e) = commands::run::command(logging_level, *config).await { eprintln!("Server command failed: {}", e); std::process::exit(ReturnCode::Failure as _) } } } }); 在influxdb_ioxd::main方法中,忽略一些不太需要重点关注的,分别是初始化log的管理、PanicsTracing、CancellationToken等。 //初始化对象存储 let object_store = ObjectStore::try_from(&config)?; //可以看到,目前已经支持了 //1.内存(在container环境运行时候使用) //2.Google //3.S3 //4.Azure //5.File 本地文件,方便开发者调试运行在云上时候的文件变化 fn try_from(config: &Config) -> Result<Self, Self::Error> { match config.object_store { Some(ObjStoreOpt::Memory) | None => { //创建一个btreemap用来缓存或者搜索 Ok(Self::new_in_memory(object_store::memory::InMemory::new())) } Some(ObjStoreOpt::Google) => { // 省略 } Some(ObjStoreOpt::S3) => { // 省略 } Some(ObjStoreOpt::Azure) => { // 省略 } Some(ObjStoreOpt::File) => match config.database_directory.as_ref() { Some(db_dir) => { //去递归创建这个配置路径中的文件夹 //context也是使用的snafu来处理错误的 fs::create_dir_all(db_dir) .context(CreatingDatabaseDirectory { path: db_dir })?; //都创建完成,并且没出错误,把路径保存起来 Ok(Self::new_file(object_store::disk::File::new(&db_dir))) } // 如果database_directory这个参数没有配置的时候 //使用snafu这个crate来返回一个错误 None => MissingObjectStoreConfig { object_store: ObjStoreOpt::File, missing: "data-dir", } .fail(), }, } } 关于错误处理的代码: #[snafu(display("Unable to create database directory {:?}: {}", path, source))] CreatingDatabaseDirectory { path: PathBuf, source: std::io::Error, }, #[snafu(display( "Specified {} for the object store, required configuration missing for {}", object_store, missing ))] MissingObjectStoreConfig { object_store: ObjStoreOpt, missing: String, }, 我们来测试一下错误的场景,来看看是否符合代码的预期。 // 不传入路径 cargo run run --object-store file Finished dev [unoptimized + debuginfo] target(s) in 0.42s Running `./influxdb_iox run --object-store file` Apr 15 13:38:34.352 INFO influxdb_iox::influxdb_ioxd: Using File for object storage Server command failed: Run: Specified File for the object store, required configuration missing for data-dir //传入一个创建不了的路径 cargo run run --object-store file --data-dir /root/1/1 Finished dev [unoptimized + debuginfo] target(s) in 0.47s Running `./influxdb_iox run --object-store file --data-dir /root/1/1` Apr 15 13:45:26.664 INFO influxdb_iox::influxdb_ioxd: Using File for object storage Server command failed: Run: Unable to create database directory "/root/1/1": Read-only file system (os error 30) 可以看到是符合预期的,bingo //创建一个空的结构体 let connection_manager = ConnectionManager {}; //创建AppServer结构体用来保存基本的信息 //server_config里就是保存的对象存储的信息及线程配置 //如果num_worker_threads没有填写,默认就使用cpu数量 let app_server = Arc::new(AppServer::new(connection_manager, server_config)); //不设置这个writer_id能启动,但是不能做任何操作 if let Some(id) = config.writer_id { //compare and set 一个非0的数值,错误就打印一个指定的panic app_server.set_id(id).expect("writer id already set"); //校验所有的配置 if let Err(e) = app_server.load_database_configs().await { error!( "unable to load database configurations from object storage: {}", e ) } } else { warn!("server ID not set. ID must be set via the INFLUXDB_IOX_ID config or API before writing or querying data."); } 接下来进入load_database_configs方法看看, let list_result = self .store //把write_id和配置的文件路径组合一下,作为一个目录 //遍历文件夹中的所有东西,用一个BTreeSet存所有子文件夹 //用Vec存下所有的文件信息,包括路径、修改时间、大小等 .list_with_delimiter(&self.root_path()?) .await .context(StoreError)?; //拿到配置的server的write_id let server_id = self.require_id()?; let handles: Vec<_> = list_result //配置的文件夹下的所有文件夹 .common_prefixes .into_iter() //全部进行map转换 .map(|mut path| { let store = Arc::clone(&self.store); let config = Arc::clone(&self.config); let exec = Arc::clone(&self.exec); //先找database的相关信息文件,名字叫rules.pb path.set_file_name(DB_RULES_FILE_NAME); //感觉是需要io来读取文件内容,所以开一个异步 tokio::task::spawn(async move { let mut res = get_store_bytes(&path, &store).await; //省略错误处理。。 let res = res.unwrap().freeze(); //解析文件内容,根据文件名可以看出是个pb文件。 match DatabaseRules::decode(res) { Err(e) => { //省略错误。。 } //根据解析出来的文件内容,在内存中恢复回来db的相关信息 Ok(rules) => match config.create_db(rules) { Err(e) => error!("error adding database to config: {}", e), //提交一个后台任务,用来不断的检测chunks的状态 //比如达到了某个大小,然后写入到存储等 Ok(handle) => handle.commit(server_id, store, exec), }, } }) }) .collect(); //等待所有任务完成 futures::future::join_all(handles).await; 这里就启动完成了一个基本的服务,创建了存储路径、初始化数据库的基本配置、启动了一个用来刷盘、整理chunk的后台任务。 接下来就是启动连接相关的了。 //从启动命令行中读取grpc的地址 let grpc_bind_addr = config.grpc_bind_address; //绑定这个地址 let socket = tokio::net::TcpListener::bind(grpc_bind_addr) .await .context(StartListeningGrpc { grpc_bind_addr })?; //真正的协议启动 let grpc_server = rpc::serve(socket, Arc::clone(&app_server), frontend_shutdown.clone()).fuse(); //同样的启动http相关的服务,使用的hyper库 let bind_addr = config.http_bind_address; let addr = AddrIncoming::bind(&bind_addr).context(StartListeningHttp { bind_addr })?; let http_server = http::serve(addr, Arc::clone(&app_server), frontend_shutdown.clone()).fuse(); //省略后面的停止流程。。。 然后看grpc的启动的服务 //启动起来健康检查的服务 let stream = TcpListenerStream::new(socket); let (mut health_reporter, health_service) = tonic_health::server::health_reporter(); //标识相对应的服务已经是可以提供服务的状态了 let services = [ generated_types::STORAGE_SERVICE, generated_types::IOX_TESTING_SERVICE, generated_types::ARROW_SERVICE, ]; for service in &services { health_reporter .set_service_status(service, tonic_health::ServingStatus::Serving) .await; } //增加一堆使用grpc的服务,并启动起来 tonic::transport::Server::builder() .add_service(health_service) .add_service(testing::make_server()) .add_service(storage::make_server(Arc::clone(&server))) .add_service(flight::make_server(Arc::clone(&server))) .add_service(write::make_server(Arc::clone(&server))) .add_service(management::make_server(Arc::clone(&server))) .add_service(operations::make_server(server)) .serve_with_incoming_shutdown(stream, shutdown.cancelled()) .await 然后是http相关的启动 pub async fn serve<M>( addr: AddrIncoming, server: Arc<AppServer<M>>, shutdown: CancellationToken, ) -> Result<(), hyper::Error> where M: ConnectionManager + Send + Sync + Debug + 'static, { //初始化路由相关的信息 let router = router(server); let service = RouterService::new(router).unwrap(); //启动服务 hyper::Server::builder(addr) .serve(service) .with_graceful_shutdown(shutdown.cancelled()) .await } 顺便看一下都提供了哪些地址可以被访问的: Router::builder() .data(server) //写了一个拦截,打印请求参数和返回结果 .middleware(Middleware::pre(|req| async move { debug!(request = ?req, "Processing request"); Ok(req) })) .middleware(Middleware::post(|res| async move { debug!(response = ?res, "Successfully processed request"); Ok(res) })) // this endpoint is for API backward compatibility with InfluxDB 2.x .post("/api/v2/write", write::<M>) .get("/health", health) .get("/metrics", handle_metrics) .get("/iox/api/v1/databases/:name/query", query::<M>) .get("/iox/api/v1/databases/:name/wal/meta", get_wal_meta::<M>) .get("/api/v1/partitions", list_partitions::<M>) .post("/api/v1/snapshot", snapshot_partition::<M>) //错误的时候调用的处理拦截 .err_handler_with_info(error_handler) .build() .unwrap() 做一个/health的测试: curl localhost:8080/health OK% 可以看到成功返回了值。 到这里基本启动就完成了,后面再用到的时候会继续对启动里的细节做研究,比如Panics,Log等等吧,欢迎持续关注。 祝玩儿的开心

优秀的个人博客,低调大师

时序数据库Influx-IOx源码学习六-1(数据写入之分区)

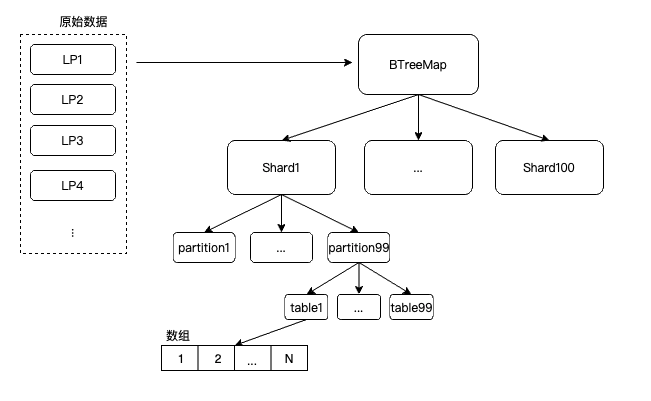
欢迎关注公众号: 上一章说到如何创建一个数据库,并且数据库的描述信息是如何保存的。详情见:https://my.oschina.net/u/3374539/blog/5025128 这一章记录一下,数据是如何写入并保存的,具体会分为两篇来写: 一篇介绍分区是如何完成的 一篇介绍具体的写入 说到数据写入,必然是需要能够连接到服务器。IOx项目为提供了多种方式可以于服务器进行交互,分别是Grpc和Http基于这两种通信方式,又扩展支持了influxdb2_client以及influxdb_iox_client。 基于influxdb_iox_client我写了一个数据写入及查询的示例来观测接口是如何组织的,代码如下: #[tokio::main] async fn main() { { let connection = Builder::default() .build("http://127.0.0.1:8081") .await .unwrap(); write::Client::new(connection) .write("a", r#"myMeasurement,tag1=value1,tag2=value2 fieldKey="123" 1556813561098000000"#) .await .expect("failed to write data"); } let connection = Builder::default() .build("http://127.0.0.1:8081") .await .unwrap(); let mut query = flight::Client::new(connection) .perform_query("a", "select * from myMeasurement") .await .expect("query request should work"); let mut batches = vec![]; while let Some(data) = query.next().await.expect("valid batches") { batches.push(data); } let format1 = format::QueryOutputFormat::Pretty; println!("{}", format1.format(&batches).unwrap()); } +------------+--------+--------+-------------------------+ | fieldKey | tag1 | tag2 | time | +------------+--------+--------+-------------------------+ | 123 | value1 | value2 | 2019-05-02 16:12:41.098 | | 123 | value1 | value2 | 2019-05-02 16:12:41.098 | | fieldValue | value1 | value2 | 2019-05-02 16:12:41.098 | | fieldValue | value1 | value2 | 2019-05-02 16:12:41.098 | | 123 | value1 | value2 | 2019-05-02 16:12:41.098 | +------------+--------+--------+-------------------------+ 因为我多运行了几次,所以能看到数据被重复插入了。 这里还需要说一下的是写入的语句格式可以参见: [LineProtocol] https://docs.influxdata.com/influxdb/v2.0/reference/syntax/line-protocol/#data-types-and-format write::Client中的write方法生成了一个WriteRequest结构,并使用RPC调用远程的write方法。打开src/influxdb_ioxd/rpc/write.rs : 22行可以看到方法的具体实现。 async fn write( &self, request: tonic::Request<WriteRequest>, ) -> Result<tonic::Response<WriteResponse>, tonic::Status> { let request = request.into_inner(); //得到上面在客户端中写入的数据库名字,在上面的例子中传入的"a" let db_name = request.db_name; //这里得到了写入的LineProtocol let lp_data = request.lp_data; let lp_chars = lp_data.len(); //解析LineProtocol的内容 //示例中的lp会被解析为: //measurement: "myMeasurement" //tag_set: [("tag1", "value1"), ("tag2", "value2")] //field_set: [("fieldKey", "123")] //timestamp: 1556813561098000000 let lines = parse_lines(&lp_data) .collect::<Result<Vec<_>, influxdb_line_protocol::Error>>() .map_err(|e| FieldViolation { field: "lp_data".into(), description: format!("Invalid Line Protocol: {}", e), })?; let lp_line_count = lines.len(); debug!(%db_name, %lp_chars, lp_line_count, "Writing lines into database"); //对数据进行保存 self.server .write_lines(&db_name, &lines) .await .map_err(default_server_error_handler)?; //返回成功 let lines_written = lp_line_count as u64; Ok(Response::new(WriteResponse { lines_written })) } 继续看self.server.write_lines的执行: pub async fn write_lines(&self, db_name: &str, lines: &[ParsedLine<'_>]) -> Result<()> { self.require_id()?; //验证一下名字,然后拿到之前创建数据库时候在内存中存储的相关信息 let db_name = DatabaseName::new(db_name).context(InvalidDatabaseName)?; let db = self .config .db(&db_name) .context(DatabaseNotFound { db_name: &*db_name })?; //这里就开始执行分片相关的策略 let (sharded_entries, shards) = { //读取创建数据库时候配置的分片策略 let rules = db.rules.read(); let shard_config = &rules.shard_config; //根据数据和shard策略,把逐个数据对应的分区找到 //写入到一个List<分区标识,List<数据>>这样的结构中 //具体的结构信息后面看 let sharded_entries = lines_to_sharded_entries(lines, shard_config.as_ref(), &*rules) .context(LineConversion)?; //再把所有分区的配置返回给调用者 let shards = shard_config .as_ref() .map(|cfg| Arc::clone(&cfg.shards)) .unwrap_or_default(); (sharded_entries, shards) }; //根据上面返回的集合进行map方法遍历,写到每个分区中 futures_util::future::try_join_all( sharded_entries .into_iter() .map(|e| self.write_sharded_entry(&db_name, &db, Arc::clone(&shards), e)), ) .await?; Ok(()) } 这里描述了写入一条数据的主逻辑:数据写入的时候,先把数据划分到具体的分区里(使用List结构存储下所有的分区对应的数据),然后并行的进行数据写入 接下来看,数据是如何进行分区的: pub fn lines_to_sharded_entries( lines: &[ParsedLine<'_>], sharder: Option<&impl Sharder>, partitioner: &impl Partitioner, ) -> Result<Vec<ShardedEntry>> { let default_time = Utc::now(); let mut sharded_lines = BTreeMap::new(); //对所有要插入的数据进行遍历 for line in lines { //先找到符合哪个shard let shard_id = match &sharder { Some(s) => Some(s.shard(line).context(GeneratingShardId)?), None => None, }; //再判断属于哪个分区 let partition_key = partitioner .partition_key(line, &default_time) .context(GeneratingPartitionKey)?; let table = line.series.measurement.as_str(); //最后存储到一个map中 //shard-> partition -> table -> List<data> 的映射关系 sharded_lines .entry(shard_id) .or_insert_with(BTreeMap::new) .entry(partition_key) .or_insert_with(BTreeMap::new) .entry(table) .or_insert_with(Vec::new) .push(line); } let default_time = Utc::now(); //最后遍历这个map 转换到之前提到的List结构中 let sharded_entries = sharded_lines .into_iter() .map(|(shard_id, partitions)| build_sharded_entry(shard_id, partitions, &default_time)) .collect::<Result<Vec<_>>>()?; Ok(sharded_entries) } 这里理解shard的概念就是一个或者一组机器,称为一个shard,他们负责真正的存储数据。 partition理解为一个个文件夹,在shard上具体的存储路径。 这里看一下是怎样完成shard的划分的: impl Sharder for ShardConfig { fn shard(&self, line: &ParsedLine<'_>) -> Result<ShardId, Error> { if let Some(specific_targets) = &self.specific_targets { //如果对数据进行匹配,如果符合规则就返回,可以采用当前的shard //官方的代码中只实现了根据表名进行shard的策略 //这个配置似乎只能通过grpc来进行设置,这样好处可能是将来有个什么管理界面能动态修改 if specific_targets.matcher.match_line(line) { return Ok(specific_targets.shard); } } //如果没有配置就使用hash的方式 //对整条数据进行hash,然后比较机器的hash,找到合适的节点 //如果没找到,就放在hashring的第一个节点 //hash算法见后面 if let Some(hash_ring) = &self.hash_ring { return hash_ring .shards .find(LineHasher { line, hash_ring }) .context(NoShardsDefined); } NoShardingRuleMatches { line: line.to_string(), } .fail() } } //具体的Hash算法,如果全配置的话分的就会特别散,几乎不同测点都放到了不同的地方 impl<'a, 'b, 'c> Hash for LineHasher<'a, 'b, 'c> { fn hash<H: Hasher>(&self, state: &mut H) { //如果配置了使用table名字就在hash中加入tablename if self.hash_ring.table_name { self.line.series.measurement.hash(state); } //然后按照配置的列的值进行hash for column in &self.hash_ring.columns { if let Some(tag_value) = self.line.tag_value(column) { tag_value.hash(state); } else if let Some(field_value) = self.line.field_value(column) { field_value.to_string().hash(state);t } state.write_u8(0); // column separator } } } 接下来看默认的partition分区方式: impl Partitioner for PartitionTemplate { fn partition_key(&self, line: &ParsedLine<'_>, default_time: &DateTime<Utc>) -> Result<String> { let parts: Vec<_> = self .parts .iter() //匹配分区策略,或者是单一的,或者是复合的 //目前支持基于表、值、时间 //其余还会支持正则表达式和strftime模式 .map(|p| match p { TemplatePart::Table => line.series.measurement.to_string(), TemplatePart::Column(column) => match line.tag_value(&column) { Some(v) => format!("{}_{}", column, v), None => match line.field_value(&column) { Some(v) => format!("{}_{}", column, v), None => "".to_string(), }, }, TemplatePart::TimeFormat(format) => match line.timestamp { Some(t) => Utc.timestamp_nanos(t).format(&format).to_string(), None => default_time.format(&format).to_string(), }, _ => unimplemented!(), }) .collect(); //最后返回一个组合文件名,或者是 a-b-c 或者是一个单一的值 Ok(parts.join("-")) } } 到这里分区的工作就完成了,下一篇继续分析是怎样写入的。 祝玩儿的开心

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册