首页 文章 精选 留言 我的

精选列表

搜索[分类算法],共10004篇文章
优秀的个人博客,低调大师

无限极分类

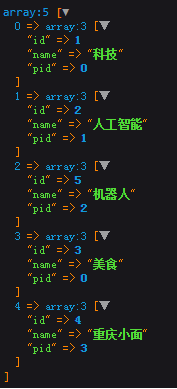
$arr = array( 0=>[ 'id'=>1, 'name'=>'科技', 'pid'=>0, ], 1=>[ 'id'=>2, 'name'=>'人工智能', 'pid'=>1, ], 2=>[ 'id'=>3, 'name'=>'美食', 'pid'=>0 ], 3=>[ 'id'=>4, 'name'=>'重庆小面', 'pid'=>3 ], 4=>[ 'id'=>5, 'name'=>'机器人', 'pid'=>2 ] ); public function category($arr,$pid=0,$level=0){ //定义一个静态变量,存储一个空数组,用静态变量,是因为静态变量不会被销毁,会保存之前保留的值,普通变量在函数结束时,会死亡,生长周期函数开始到函数结束,再次调用重新开始生长 //保存一个空数组 static $list=array(); //通过遍历查找是否属于顶级父类,pid=0为顶级父类, foreach($arr as $value){ //进行判断如果pid=0,那么为顶级父类,放入定义的空数组里 if($value['pid']==$pid){ //添加空格进行分层 $arr['level']=$level; $list[]=$value; //递归点,调用自身,把顶级父类的主键id作为父类进行再调用循环,空格+1 self::category($arr,$value['id'],$level+1); } } return $list;//递归出口 } $list = category($arr,0,0);

优秀的个人博客,低调大师

Android 动画的分类

分为三类: View Animation (补间动画 Tween动画) Drawable Animation(帧动画 Frame动画) Property Animation(android 3.0引入) ViewAnimation: 基于View的渐变动画,只改变View的绘制效果,而实际属性值没变,比如按钮移动位置,其实实际位置并没有发生变化。 代码中可以通过AnimationSet类和Animation的子类来实现; xml可以再res/anim/文件夹中定义xml文件。 Drawable Animation: 加载一系列Drawable 资源来创建动画,这种传统动画某种程度上就是创建不同图片序列,顺序播放,就像电影。 代码中通过AnimationDrawable类; xml文件能更加简单的组成动画帧,再res/drawable文件夹中,使用<animation-list>采用<item>来定义不同的帧,感受只能设置的属性石动画间隔时间。 Property Animation: android3.0引入,动画的属性值实在的改变了,能够改变view的实际属性来实现view的动画,任何时候view属性的改变,view都会调用invalidate()来刷新。 属性动画知识点见我以前写的博客:http://www.cnblogs.com/androidsuperman/p/4474604.html

优秀的个人博客,低调大师

Hadoop源码分类概要整理

最近突然觉得, 很多掌握的都还是很浅的原理,需要更深入细粒度去了解整个分布式系统的运转机制。于是。。开始作死而又作死而又作死的源码之旅。 Hadoop包的功能总共有下列几类: tool:提供一些命令行工具,如DistCp,archive mapreduce,:Hadoop的Map/Reduce实现 filecache:提供HDFS文件的本地缓存,用于加快Map/Reduce的数据访问速度 fs:文件系统的抽象,可以理解为支持多种文件系统实现的统一文件访问接口 hdfs:HDFS,Hadoop的分布式文件系统实现 ipc:一个简单的IPC的实现,依赖于IO提供的编解码功能 io:表示层,将各种数据编码/解码,方便在网络上的传输 net:封装部分网络功能,如DNS,socket security:用户和用户组信息 conf:系统的配置参数 metrics:系统攻击数据的收集,用于网管范畴 util:工具类 record:根据DDL自动生成他们的编码函数,目前可以提供C++和java http:基于Jetty的HTTP Servlet,用户通过浏览器可以观察文件系统的一些状态信息和日志 log:提供HTTP访问日志的HTTP Servlet 一、RPC 它是一种通过网络从远程计算机程序上请求服务,而不需要了解底层网络技术的协议。RPC协议假定某些传输协议的存在,如TCP或UDP,为通信程序之间携带信息数据。 RPC采用客户机/服务器模式,请求程序就是一个客户机,而服务提供程序就是一个服务器。例如HDFS的通信就包括: 1、Client-NameNode之间,其中NameNode是服务器。 2、Client-DataNode之间,其中DataNode是服务器。 3、DataNode-NameNode之间,其中NameNode是服务器。 4、DataNode-DataNode之间,其中某一个DataNode是服务器,另一个是客户端。 org.apache.hadoop.rpc中包含Client类和Server类。Server类是一个抽象类,类RPC封装了Server,利用反射,把某个对象的方法开放出来,变成RPC中的服务器。 二、DataNode与NameNode 一个HDFS集群可能包含上千DataNode节点,这些DataNode定时与NameNode通信,为了减轻NameNode的负担,NameNode上并不永久保存DataNode上那些数据块信息,而是通过DataNode启动时上报,来更新NameNode上的映射表。 相关包:org.apache.hadoop.hdfs.server.common、org.apache.hadoop.hdfs.server.datanode... 所有和数据块相关的操作,都在FSDataset相关的类中进行处理,一个DataNode上可以指定多个Storage来存储数据块,由于HDFS规定了一个目录能存放Block的数目,所以一个storage上存在多个目录。对应的,FSDataset中用FSVolume来对应一个Storage,FSDir对应一个目录,所有的FSVolume由FSVolumeSet管理,FSDataset中通过一个FSVolumeSet对象,就可以管理它的所有存储空间。 相关包:org.apache.hadoop.hdfs.server.dataNode.fsDataSet NameNode作为系统文件目录的管理者,DataNode关注的是数据块,NameNode保存的主要信息是文件名-数据块,数据块-DataNode列表。 DataNode实现了InterDatanodeProtocol和ClientDatanodeProtocol,剩下的,由NameNode实现。 相关包:org.apache.hadoop.hdfs.server.protocol、org.apache.hadoop.hdfs.protocol、org.apache.hadoop.hdfs.server.namenode (重点FSNamesystem.java) 三、MapReduce 相关包:org.apache.hadoop.mapreduce.JobContext、org.apache.hadoop.mapreduce、org.apache.hadoop.mapreduce.lib.*(包含inputFomat等..) 这些还是很小的一部分,但是一点一点深入好了~

优秀的个人博客,低调大师

Java算法-排序算法

冒泡排序 方法sort是基本的冒泡排序, sort1/sort2是冒泡排序的两种优化 package me.zx.algorithm.program.sort; import org.slf4j.Logger; import org.slf4j.LoggerFactory; /** * 冒泡排序. * Created by zhangxin on 2017/12/27. * * @author zhangxin * @since 0.0.1 */ public final class BubbleSort { private static final Logger LOGGER = LoggerFactory.getLogger(BubbleSort.class); /** * 基本的冒泡排序. * @param a 待排序数组 */ public static void sort(int[] a) { int temp = 0; for(int i = a.length - 1; i > 0; i--) { for(int j = 0; j < i; j++) { if(a[j + 1] < a[j]) { temp = a[j]; a[j] = a[j + 1]; a[j + 1] = temp; } } } } /** * 优化的冒泡排序1. * 当某一趟遍历没有交换,就说明已经遍历好了,就不用再迭代了 * @param a 待排序数组 */ public static void sort1(int[] a) { int temp = 0; boolean sorted = false; for(int i = a.length - 1; i > 0; i--) { sorted = false; //初始值设置为未排序 for(int j = 0; j < i; j++) { if(a[j + 1] < a[j]) { temp = a[j]; a[j] = a[j + 1]; a[j + 1] = temp; sorted = true; //发生排序时重新设值 } } if(!sorted){ //当经过一次遍历没有发生一次排序, 或者上次排序位置与本次排序位置相同 break; } } } /** * 优化的冒泡排序2. * 记录每次遍历数据之后交换次序的位置,显然这个位置之后的数据已经有序了不用再排序了。因此通过记录最后发生数据交换的位置就可以确定下次循环的范围了 * @param a 待排序数组 */ public static void sort2(int[] a) { int temp = 0; int lastChangeLocation; //上次排序发生的位置 int nowChangeLocation = a.length - 1; //本次排序发生的位置 for(int i = a.length - 1; i > 0; i--) { lastChangeLocation = nowChangeLocation; for(int j = 0; j < i; j++) { if(a[j + 1] < a[j]) { temp = a[j]; a[j] = a[j + 1]; a[j + 1] = temp; nowChangeLocation = j; //发生排序时重新设值 } } if(lastChangeLocation == nowChangeLocation){ //当经过一次遍历没有发生一次排序, 或者上次排序位置与本次排序位置相同 break; } } } public static void main(final String[] args){ // int[] a = {0, 1, 2, 3, 4, 5, 6}; int[] a = {6, 5, 4, 3, 2, 1, 0}; LOGGER.info("原数组:{}", a); sort1(a); LOGGER.info("现数组:{}", a); } }

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册