首页 文章 精选 留言 我的

精选列表

搜索[javascript库],共10000篇文章
优秀的个人博客,低调大师

JavaScript 基础排序的实现(一)

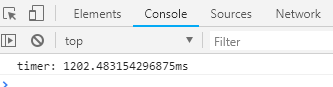
作为一个有追求的前端,忙里偷闲(闲得发慌)地复习了一下基础的排序算法,以此文留念. 本篇主要记录O(n²)复杂度的基础算法O(nlogn)的算法将在下次有空(闲得发慌)时更新 在记录时发现Es6语法中的解构赋值与传统的中间变量交换相比效率低下,经过几次测试发现其耗时大约为交换中间变量的两倍 1.冒泡排序 众所周知排序最基础的算法,也就是大名鼎鼎的冒泡了,为了方便日后回顾还是简单提一下冒泡的原理: 其核心思想在于不停地比较相邻元素的大小关系,如果前面的比后面的大则两个元素互换位置(此处以顺序为例);每当一次大的循环后总能将当前剩余数中最大的数交换到数组的末尾,类似于一个泡泡从底部浮出水面,故得名冒泡算法.下方代码为未使用任何优化的原始冒泡算法. 其时间复杂度为O(n²)不需要额外空间; 1 //冒泡排序 2 function BubbleSort(arr) {//arr即需要排序的数组;本文后续中的arr均为此意 3 console.time('timer');//用于统计代码执行时间 4 for (let i = 0; i < arr.length; i++) { 5 for (let j = 0; j < arr.length; j++) { 6 if (arr[j] > arr[j + 1]) 7 [arr[j], arr[j + 1]] = [arr[j + 1], arr[j]];//交换元素(解构赋值ES6) 8 } 9 } 10 console.timeEnd('timer'); 11 } 以一万个数构成的倒序(从大到小)数组变为顺序的时间如下图(与个人电脑及其它因素有关请勿较真)用解构赋值交换: 后续算法的时间均以同一数组测试 2.鸡尾酒排序 这种排序算法乃是对冒泡算法的一种小优化,其与冒泡的区别在于,在一趟排序中可以将一个最大的移到后端,同时将一个最小的移到前端,从而对冒泡算法进行优化 核心代码如下: //鸡尾酒排序 function CocktailSort(arr) { console.time('timer'); let [start, end] = [0, arr.length]; while (start < end) { //此循环与正常冒泡一致 for (let i = start; i < end; i++) { if (arr[i] > arr[i + 1]) [arr[i], arr[i + 1]] = [arr[i + 1], arr[i]]; } end--;//由于数组最后一位已经是最大的所以没有必要再让其参与后续的排序 for (let i = end - 1; i >= start; i--) { if (arr[i] < arr[i - 1]) [arr[i], arr[i - 1]] = [arr[i - 1], arr[i]]; } start++; } console.timeEnd('timer'); } 耗费时间如下 由于其本质与冒泡算法类似,虽然好上些许,但其本质仍为O(n²)的时间复杂度故时间并未得到太大的缩减(由于解构赋值的原因优化后的算法还不如不优化,是真的骚) 3.选择排序 选择排序也是大家所熟知的一种基础算法,其核心在于每一次选出最小(或最大)的一个数放到已经有序的数列后,经过如此重复操作后获得有序的数列 代码如下: //选择排序 function SelecttionSort(arr) { console.time('timer'); for (let i = 0; i < arr.length; i++) { let min = i;//min表示当前最小值的下标 for (let j = i + 1; j < arr.length; j++) { min = arr[j] < arr[min] ? j : min; //如果当前下标的值比arr[min]的值要小则以当前值替换 } [arr[i], arr[min]] = [arr[min], arr[i]]; } console.timeEnd('timer'); } 花费时间如下: 按理说同为n平方的复杂度时间耗费应该相差不大才对,结果由于交换次数的减少导致耗时大幅下降,感觉Js在这方面效率有点低 4.插入排序 插入排序的原理为将当前下标的数插入之前已经有序的数列中,从后往前遍历找到合适的位置后将值插入,并将该位置之后的元素依次后移从而进行排序 代码如下: function InsertionSort(arr) { console.time('timer'); for (let i = 1; i < arr.length; i++) { for (let j = i; j > 0 && arr[j] < arr[j - 1]; j--) { [arr[j], arr[j - 1]] = [arr[j - 1], arr[j]]; } } console.timeEnd('timer'); } 同数组耗时如下: 总结:在Js的情况下交换数据应尽量少的使用解构赋值,虽然其便利性很强,但是当网页对性能要求较高时应减少解构赋值的使用,如果非用不可,在同等级时间复杂度算法的情况下应使用数字交换次数少的算法以提升页面性能

优秀的个人博客,低调大师

JavaScript 作用域链 难不难?

介绍 在变量对象中已经介绍过,执行上下文(变量,函数声明和函数形式参数)的数据被存储为变量对象的属性 此外,我们知道每次进入上下文时都会创建变量对象并填充初始值,并且它的更新发生在代码执行阶段 举个栗子 function test(a, b) { console.log(c); // function c() {} var c = 10; function c() {}; console.log(c); // 10 c = 1; console.log(c); // 1 var e = function _e() {}; (function x() {}); } test(10); 这次我们讨论作用域链 Scope Chain 定义 如果要简要说明,作用域链主要与内部函数有关 正如我们所知,ECMAScript允许创建内部函数,我们甚至可以从父函数返回这些内部函数 var x = 10; function foo() { var y = 20; function bar() { alert(x + y); } return bar; } foo()(); // 30 众所周知,每个上下文都有自己的变量对象:对于全局上下文,其变量对象就是全局对象本身,对于函数,其变量对象是活动对象 作用域链是内部上下文的所有变量对象的列表,该作用域链用于变量查找,在上面的例子中,“bar”上下文的作用域链包括AO(bar),AO(foo)和VO(global) 让我们从定义开始,进一步讨论更多的例子 作用域链与执行上下文相关联,是一条变量对象的链,用于在处理标识符时的变量查找 函数上下文的作用域链在函数调用时创建,由该函数的活动对象和内部[[Scope]]属性组成 用伪代码可以表示为: activeExecutionContext = { VO: {...}, // or AO this: thisValue, Scope: [ // Scope chain // list of all variable objects // for identifiers lookup ] }; 根据定义,Scope可以表示为: Scope = AO + [[Scope]] 我们可以将Scope和[[Scope]]表示为ECMAScript数组: var Scope = [VO1, VO2, ..., VOn]; // scope chain 我们下面将讨论AO + [[Scope]]组合以及标识符解析过程,都与函数生命周期有关 函数生命周期 函数的生命周期分为创建阶段和激活(调用)阶段 函数创建 众所周知,函数声明在进入上下文阶段时被放入变量/活动对象(VO / AO)中,让我们看一下全局上下文中的变量和函数声明(其中变量对象是全局对象本身): var x = 10; function foo() { var y = 20; alert(x + y); } foo(); // 30 在函数激活时,我们看到了正确(预期)的结果 => 30 在这里,我们看到“y”变量在函数“foo”中定义(这意味着它在“foo”上下文的AO中),但变量“x”没有在“foo”的上下文中定义,因此不会被添加到“foo”的AO 乍一看,“foo”函数根本不存在“x”变量,正如我们将在下面看到的,“foo”上下文的活动对象只包含一个属性“y”: fooContext.AO = { y: undefined // undefined – on entering the context, 20 – at activation }; 函数“foo”如何访问“x”变量呢?函数应该可以访问更高层上下文的变量对象,实际上,确实如此,这个机制是通过函数的内部[[Scope]]属性来实现的 [[Scope]]是包含了所有父级变量对象的层级链,它位于当前函数上下文中,在函数创建时被保存到函数中 [[Scope]]是在创建函数时保存的,静态的(不变的),只有一次并且一直都存在,直到函数销毁 注意一点,[[Scope]]与Scope(作用域链)是不同的,前者是函数的属性,后者是上下文的属性 以上述例子为例,“foo”函数的[[Scope]]如下所示: foo.[[Scope]] = [ globalContext.VO // === Global ]; 之后,函数调用时,会进入一个函数上下文,其中活动对象被创建,并且this值和Scope(作用域链)被确定 函数激活 正如定义中提到的那样,在进入上下文并且在创建AO / VO之后,上下文的Scope属性(作用域链,用于变量查找)定义为: Scope = AO|VO + [[Scope]] 这里要强调活动对象是Scope数组的第一个元素,即添加到作用域链的最前面: Scope = [AO].concat([[Scope]]) 这个特征对标识符解析过程非常重要 标识符解析是确定变量(或函数声明)属于作用域链中哪个变量对象的过程 这个算法返回的是一个Reference类型的值,其base属性是相应的变量对象(如果没有找到变量,则为null),其property name属性的名字是查找到的标识符的名称,细节可参考 this 标识符解析的过程包括与变量名称对应的属性查找,即从作用域链的最底层上下文一直到最上层上下文 因此,查找过程中上下文的局部变量比父上下文的变量具有更高的优先级,如果两个相同名字的变量存在于不同的上下文中时,处于底层上下文的变量会优先被找到 让我们看一个稍微复杂的例子: var x = 10; function foo() { var y = 20; function bar() { var z = 30; alert(x + y + z); } bar(); } foo(); // 60 上述代码,对应了如下的变量/活动对象,函数的[[Scope]]属性以及上下文的作用域链: 全局上下文的变量对象是: globalContext.VO === Global = { x: 10 foo: <reference to function> }; 在创建foo时,foo的[[Scope]]属性为: foo.[[Scope]] = [ globalContext.VO ]; 在foo函数调用中,foo函数上下文的活动对象是: fooContext.AO = { y: 20, bar: <reference to function> }; foo函数上下文的作用域链是: fooContext.Scope = fooContext.AO + foo.[[Scope]] // i.e.: fooContext.Scope = [ fooContext.AO, globalContext.VO ]; 在创建内部“bar”函数时[[Scope]]属性是: bar.[[Scope]] = [ fooContext.AO, globalContext.VO ]; 在bar函数调用中,bar函数上下文的活动对象是: barContext.AO = { z: 30 }; “bar”函数上下文的作用域链是: barContext.Scope = barContext.AO + bar.[[Scope]] // i.e.: barContext.Scope = [ barContext.AO, fooContext.AO, globalContext.VO ]; “x”,“y”和“z”标识符的查找过程: - "x" -- barContext.AO // not found -- fooContext.AO // not found -- globalContext.VO // found - 10 - "y" -- barContext.AO // not found -- fooContext.AO // found - 20 - "z" -- barContext.AO // found - 30 作用域的特性 让我们考虑一些与作用域链和函数[[Scope]]属性相关的重要特性 闭包 ECMAScript中的闭包与函数的[[Scope]]属性直接相关,正如前面指出的那样,[[Scope]]在创建函数时保存并存在,直到函数对象被销毁。实际上,闭包恰好是函数代码和其[[Scope]]属性的组合,因此,[[Scope]]包含了函数创建所在的词法环境(父变量对象),上层上下文中的变量,可以在函数激活的时候,通过变量对象的词法链(函数创建时保存)查找到 例子: var x = 10; function foo() { alert(x); } (function () { var x = 20; foo(); // 10, but not 20 })(); 我们看到x变量在foo函数的[[Scope]中被找到,也就是说,变量的查找是在函数创建时定义的词法(闭包)链,而不是调用的动态链(否则x变量将被解析为20) 闭包的另一个经典例子: function foo() { var x = 10; var y = 20; return function () { alert([x, y]); }; } var x = 30; var bar = foo(); // anonymous function is returned bar(); // [10, 20] 我们再次看到,对于标识符解析,使用函数创建时定义的词法作用域链,变量x被解析为10,而不是30 此外,这个例子清楚地表明函数的[[Scope]]属性,即使在函数上下文已经结束,也会继续存在 通过Function构造器创建的函数的[[Scope]]属性 在上面的例子中,我们看到函数创建时就获得[[Scope]]属性,并通过此属性访问所有父上下文的变量,但这有一个重要的例外,就是通过Function构造器创建的函数 var x = 10; function foo() { var y = 20; function barFD() { // FunctionDeclaration alert(x); alert(y); } var barFE = function () { // FunctionExpression alert(x); alert(y); }; var barFn = Function('alert(x); alert(y);'); barFD(); // 10, 20 barFE(); // 10, 20 barFn(); // 10, "y" is not defined } foo(); 正如我们所看到的,对于通过Function构造器创建的barFn函数,变量y不可访问,但它并不意味着barFn函数没有内部的[[Scope]]属性(否则它将无法访问变量x) 问题是通过Function构造器创建的函数的[[Scope]]属性始终只包含全局对象 二维作用域链查找 在作用域链查找中的一个重点是变量对象的原型,因为ECMAScript的原型特性: 如果在对象中没有直接找到属性,则查找会在原型链中进行 在作用域链的链接上 在每个作用域链接上,深入原型链链接 如果在Object.prototype中定义属性,我们可以观察到这种效果: function foo() { alert(x); } Object.prototype.x = 10; foo(); // 10 活动对象没有原型,我们可以在下面的例子中看到: function foo() { var x = 20; function bar() { alert(x); } bar(); } Object.prototype.x = 10; foo(); // 20 如果bar函数上下文的活动对象有一个原型,那么属性x应该在Object.prototype中找到,因为它不存在于AO中 但是在上面的第一个例子中,遍历标识符查找中的作用域链,我们到达全局对象,该对象从Object.prototype继承,因此x被解析为10 全局和eval上下文的作用域链 全局上下文的作用域链中只包含全局对象 “eval”代码的上下文和调用上下文(calling context)有相同的作用域链 globalContext.Scope = [ Global ]; evalContext.Scope === callingContext.Scope; 引用 ECMA-262-3 in detail. Chapter 4. Scope chain. 原文发布时间:2018-03-06 本文来源掘金如需转载请紧急联系作者

优秀的个人博客,低调大师

JavaScript字符串的分割

说完字符串的裁剪,这次来说说字符串的分割。 你可能会有所疑惑,裁剪和分割,这两者到底有什么区别呢? 裁剪: 一次裁剪一部分子字符串并返回,可使用slice()、substring()和substr()方法实现分割: 一次可将字符串分割成多个子字符串并返回由这些子字符串组成的数组,可使用split()实现 好,了解了裁剪和分割的区别之后,我们接下来看看具体如何使用split()方法来实现字符串的分割。 首先,我们先定义一个字符串: var str = 'Hello World!'; 一、只传一个参数 1. 传入非空字符串 console.log(str.split('l')); // [ "He","","o Wor","d!" ] 很简单,我们把字符“l”作为分隔符传入split()方法,最后返回被字符"l"分割成的子字符串组成的数组。 2. 传入空字符串 我们也可以将字符串分割成一个个字母组成的数组,只需给split()传入空字符串即可。 console.log(str.split('')); // [ "H","e","l","l","o","","W","o","r","l","d","!" ] 3. 传入正则表达式 console.log(str.split(/l+/)); // [ "He","o Wor","d!" ] 这个其实就是使用与正则相匹配的子字符串来分割原字符串,而这里匹配到的有两个:“l”和“ll”,所以结果其实就是使用这两个字符串来分割。 二、传入两个参数 第一个参数还是一样,字符串或正则,而第二个参数则是一个数字,用于指定返回数组的大小。例如: console.log(str.split('',5)); // [ "H","e","l","l","o" ] 这实际就是在str.split('')的基础上又截取了输出数组的前5项,与下面两种方式的运行结果是一样的: console.log(str.slice(0,5).split('')); // [ "H","e","l","l","o" ] console.log(str.split('').slice(0,5)); // [ "H","e","l","l","o" ] 这两种方式,一个是先裁后分,另一个则是先分后裁,最终结果都是一样的。而给split()方法传入第二个参数则相当于是个简化版,效果其实是一样的。 三、逆操作方法 说完了split()的用法,再顺便提一提该方法的逆操作方法——join()。 split(): 将字符串分割成数组join(): 将数组合并成字符串 1. 不传参 console.log(str.split('',5).join()); // "H,e,l,l,o" 默认使用逗号来连接数组的每一项而组成字符串并返回。 2. 传入空字符串 console.log(str.split('',5).join('')); // "Hello" 直接将数组中的每一项连接起来组成字符串并返回。 3. 传入非空字符串 console.log(str.split('',5).join('|')); // "H|e|l|l|o" 使用所传字符串参数来连接数组的每一项而组成字符串并返回。 四、活学活用 以上说了这么多,其实真正的内容没多少,关键还是应该掌握如何在实际工作当中去灵活使用。 下面我就随便举个简单的小例子吧~ 如何删除字符串中的某个字符或字符串? 实现这个功能的方法可能有很多,但我个人觉得最简单方便的就是同时使用split()和join()了。 还是使用最开始的字符串,我们下面将所有的字符 “l” 删除。 console.log(str.split('l').join('')); // "Heo Word!" 很简单,先分割后合并,不再赘述。 事实上,只要对数组可以实现的功能,在字符串上也能实现,只要先使用split()将字符串转换成数组,使用数组方法处理过后,再用join()将其转换回字符串即可。 本文重点总结: ① split() 可以传字符串或正则,也能传第二参数 ② split() 的逆操作是 join() ③ 字符串和数组可以自由转换,所以相当于它们所具备的很多方法是可以通用的

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册