首页 文章 精选 留言 我的

精选列表

搜索[Linux],共10000篇文章
优秀的个人博客,低调大师

Linux集群架构介绍

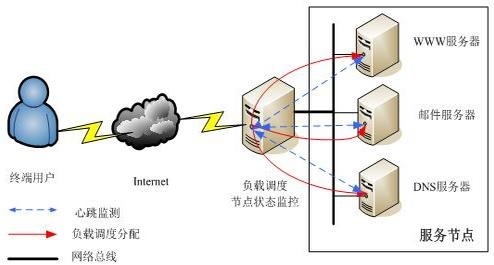
▎根据功能划分为两大类: 高可用 负载均衡 高可用 高可用集群通常为两台服务器,一台工作,另外一台作为冗余,当提供服务的机器宕机,冗余将接替继续提供服务。 实现高可用的开源软件有:heartbeat、keepalived等,其中heartbeat这款软件在CentOs6上面的bug略多,假如主服务器宕机,备用服务器不可以在短时间正常切换提供服务,而且长时间没有更新,所以不建议使用。 负载均衡 负载均衡集群,需要有一台服务器作为分发器,它负责把用户的请求分发给后端的服务器处理,在这个集群里,除了分发器外,就是给用户提供服务的服务器了,这些服务器数量至少为2台。 实现负载均衡的开源软件有LVS、keepalived、haproxy、nginx,商业的有F5、Netscaler,商业的价格比较昂贵,优点:高并发量支持,稳定性不错,如果使用开源的软件去搭建,其稳定性在于设备, keepalived通过VRRP(Virtual Router Redundancy Protocl)来实现高可用。 在这个协议里会将多台功能相同的路由器组成一个小组,这个小组里会有1个master角色和N(N>=1)个backup角色。 master会通过组播的形式向各个backup发送VRRP协议的数据包,当backup收不到master发来的VRRP数据包时,就会认为master宕机了。此时就需要根据各个backup的优先级来决定谁成为新的mater。 Keepalived要有三个模块,分别是core、check和vrrp。其中core模块为keepalived的核心,负责主进程的启动、维护以及全局配置文件的加载和解析,check模块负责健康检查,vrrp模块是来实现VRRP协议的。 本文转自Grodd51CTO博客,原文链接:http://blog.51cto.com/juispan/1963995 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

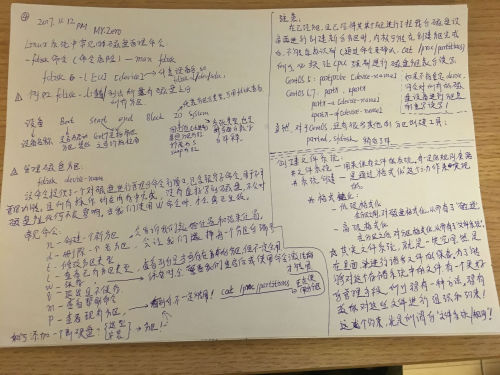
Linux 基础 - 磁盘管理 -02

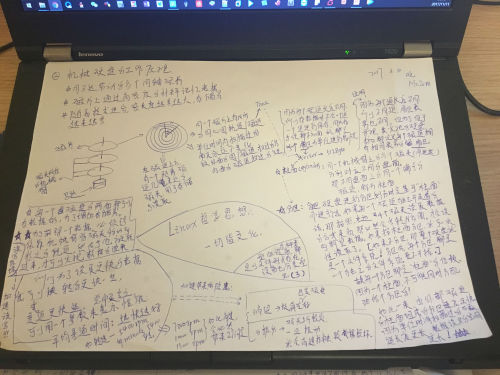
前面写了“磁盘”位于整个计算机体系架构的什么位置, 并且也了解到了“硬盘”与 “总线”的连接接口, 分为很多类型,具体有“串行”和 “并行”两大类。 总体而言,串行的速度,要比并行的快很多。 但是,接口速度,并不能对数据读写速度起到决定性作用, 还得看硬盘本身的速度,所以又提到了硬盘的类型 - 机械硬盘和固态硬盘。 接下来,我们看下“机械硬盘的工作原理”,主要目的是为了更好的理解 -磁盘 -盘片 -磁道 -磁头 -扇区 -柱面 -分区 等基本概念,以及它们之间的关系。为后面的“文件系统管理”做铺垫!(基础最重要~) 本文转自Mr2Left 51CTO博客,原文链接:http://blog.51cto.com/caihong/1980924

优秀的个人博客,低调大师

Linux ssh免密钥认证

hadoop和ansible都需要这个东西,其实很简单。 第一,在需要免秘钥登录的机器上生成公钥和私钥: 1 ssh -keygen 第二,拷贝生成的公钥id_rsa.pub到远程机器上: 1 ssh -copy- id -i /root/ . ssh /id_rsa .pubroot@192.168.0.247 #用此方式拷贝的好处是不用改名 这时再登录192.168.0.247的机器就无需密码了。 1 2 3 [root@zabbix_server~] #ssh192.168.0.247 Lastlogin:MonNov2813:48:332016from192.168.0.3 [root@localhost~] # 如果是普通账号免登录则需先切换普通账号,然后再生成公钥和私钥。 本文转自 王家东哥 51CTO博客,原文链接:http://blog.51cto.com/xiaodongge/1877339

优秀的个人博客,低调大师

linux下安装hadoop步骤

下面的安装手册是我在hadoop第一版时做的,和现在的hadoop不太符合 一、前期准备: 下载hadoop: http://hadoop.apache.org/core/releases.html http://hadoop.apache.org/common/releases.html http://www.apache.org/dyn/closer.cgi/hadoop/core/ http://labs.xiaonei.com/apache-mirror/hadoop/core/hadoop-0.20.1/hadoop-0.20.1.tar.gz http://labs.xiaonei.com/apache-mirror/hadoop/ 二、硬件环境 共有3台机器,均使用的CentOS,Java使用的是jdk1.6.0。 三、安装JAVA6 sudo apt-get install sun-java6-jdk /etc/environment 打开之后加入:#中间是以英文的冒号隔开,记得windows中是以英文的分号做为分隔的 CLASSPATH=.:/usr/local/java/lib JAVA_HOME=/usr/local/java 三、配置host表 [root@hadoop ~]# vi /etc/hosts 127.0.0.1 localhost 192.168.13.100 namenode 192.168.13.108 datanode1 192.168.13.110 datanode2 [root@test ~]# vi /etc/hosts 127.0.0.1 localhost 192.168.13.100 namenode 192.168.13.108 datanode1 [root@test2 ~]# vi /etc/host 127.0.0.1 localhost 192.168.13.100 namenode 192.168.13.110 datanode2 添加用户和用户组 addgroup hadoop adduser hadoop usermod -a -G hadoop hadoop passwd hadoop 配置ssh: 服务端: su hadoop ssh-keygen -t rsa cp id_rsa.pub authorized_keys 客户端 chmod 700 /home/hadoop chmod 755 /home/hadoop/.ssh su hadoop cd /home mkdir .ssh 服务端: chmod 644 /home/hadoop/.ssh/authorized_keys scp authorized_keys datanode1:/home/hadoop/.ssh/ scp authorized_keys datanode2:/home/hadoop/.ssh/ ssh datanode1 ssh datanode2 如果ssh配置好了就会出现以下提示信息 The authenticity of host [dbrg-2] can't be established. Key fingerpr is 1024 5f:a0:0b:65:d3:82:df:ab:44:62:6d:98:9c:fe:e9:52. Are you sure you want to continue connecting (yes/no)? OpenSSH告诉你它不知道这台主机但是你不用担心这个问题你是第次登录这台主机键入“yes”这将把 这台主机“识别标记”加到“~/.ssh/know_hosts”文件中第 2次访问这台主机时候就不会再显示这条提示信 不过别忘了测试本机ssh dbrg-1 mkdir /home/hadoop/HadoopInstall tar -zxvf hadoop-0.20.1.tar.gz -C /home/hadoop/HadoopInstall/ cd /home/hadoop/HadoopInstall/ ln -s hadoop-0.20.1 hadoop export JAVA_HOME=/usr/local/java export CLASSPATH=.:/usr/local/java/lib export HADOOP_HOME=/home/hadoop/HadoopInstall/hadoop export HADOOP_CONF_DIR=/home/hadoop/hadoop-conf export PATH=$HADOOP_HOME/bin:$PATH cd $HADOOP_HOME/conf/ mkdir /home/hadoop/hadoop-conf cp hadoop-env.sh core-site.xml hdfs-site.xml mapred-site.xml masters slaves /home/hadoop/hadoop-conf vi $HADOOP_HOME/hadoop-conf/hadoop-env.sh # The java implementation to use. Required. --修改成你自己jdk安装的目录 export JAVA_HOME=/usr/local/java export HADOOP_CLASSPATH=.:/usr/local/java/lib # The maximum amount of heap to use, in MB. Default is 1000.--根据你的内存大小调整 export HADOOP_HEAPSIZE=200 vi /home/hadoop/.bashrc export JAVA_HOME=/usr/local/java export CLASSPATH=.:/usr/local/java/lib export HADOOP_HOME=/home/hadoop/HadoopInstall/hadoop export HADOOP_CONF_DIR=/home/hadoop/hadoop-conf export PATH=$HADOOP_HOME/bin:$PATH 配置 namenode #vi $HADOOP_CONF_DIR/slaves 192.168.13.108 192.168.13.110 #vi $HADOOP_CONF_DIR/core-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>fs.default.name</name> <value>hdfs://192.168.13.100:9000</value> </property> </configuration> #vi $HADOOP_CONF_DIR/hdfs-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>dfs.replication</name> <value>3</value> <description>Default block replication. The actual number of replications can be specified when the file is created. The default is used if replication is not specified in create time. </description> </property> </configuration> #vi $HADOOP_CONF_DIR/mapred-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>mapred.job.tracker</name> <value>192.168.13.100:11000</value> </property> </configuration> ~ 在slave上的配置文件如下(hdfs-site.xml不需要配置): [root@test12 conf]# cat core-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>fs.default.name</name> <value>hdfs://namenode:9000</value> </property> </configuration> [root@test12 conf]# cat mapred-site.xml <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <!-- Put site-specific property overrides in this file. --> <configuration> <property> <name>mapred.job.tracker</name> <value>namenode:11000</value> </property> </configuration> 启动 export PATH=$HADOOP_HOME/bin:$PATH hadoop namenode -format start-all.sh 停止stop-all.sh 在hdfs上创建danchentest文件夹,上传文件到此目录下 $HADOOP_HOME/bin/hadoop fs -mkdir danchentest $HADOOP_HOME/bin/hadoop fs -put $HADOOP_HOME/README.txt danchentest cd $HADOOP_HOME hadoop jar hadoop-0.20.1-examples.jar wordcount /user/hadoop/danchentest/README.txt output1 09/12/21 18:31:44 INFO input.FileInputFormat: Total input paths to process : 1 09/12/21 18:31:45 INFO mapred.JobClient: Running job: job_200912211824_0002 09/12/21 18:31:46 INFO mapred.JobClient: map 0% reduce 0% 09/12/21 18:31:53 INFO mapred.JobClient: map 100% reduce 0% 09/12/21 18:32:05 INFO mapred.JobClient: map 100% reduce 100% 09/12/21 18:32:07 INFO mapred.JobClient: Job complete: job_200912211824_0002 09/12/21 18:32:07 INFO mapred.JobClient: Counters: 17 09/12/21 18:32:07 INFO mapred.JobClient: Job Counters 09/12/21 18:32:07 INFO mapred.JobClient: Launched reduce tasks=1 查看输出结果文件,这个文件在hdfs上 [root@test11 hadoop]# hadoop fs -ls output1 Found 2 items drwxr-xr-x - root supergroup 0 2009-09-30 16:01 /user/root/output1/_logs -rw-r--r-- 3 root supergroup 1306 2009-09-30 16:01 /user/root/output1/part-r-00000 [root@test11 hadoop]# hadoop fs -cat output1/part-r-00000 (BIS), 1 (ECCN) 1 查看hdfs运行状态,可以通过web界面来访问http://192.168.13.100:50070/dfshealth.jsp;查看map-reduce信息, 可以通过web界面来访问http://192.168.13.100:50030/jobtracker.jsp;下面是直接命令行看到的结果。 出现08/01/25 16:31:40 INFO ipc.Client: Retrying connect to server: foo.bar.com/1.1.1.1:53567. Already tried 1 time(s). 的原因是没有格式化:hadoop namenode -format 本文转自yifangyou 51CTO博客,原文链接:http://blog.51cto.com/yifangyou/615898,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册