首页 文章 精选 留言 我的

精选列表

搜索[全场景互联],共10000篇文章
优秀的个人博客,低调大师

init模块全解析 | 解读鸿蒙源码

从系统启动流程来看,init位于kernel启动之后,user程序启动以前。user程序,是指用户可交互的程序(比如Home、Shell、智能快递柜的交互程序等),也指最终的业务程序(比如智能音箱的业务程序、扫地机器人的工作程序等)。 init进程是系统的第一号用户空间进程,所有的系统进程和user进程都是由它fork()而来,即都是它的子进程。 init模块负责解析系统引导配置文件,并执行里面的命令,完成系统的引导操作。鸿蒙OS的引导配置文件使用JSON格式。系统开发人员会在这里接触到鸿蒙系统的第一个配置文件。这一点应该是借鉴Linux系操作系统。我们知道Android系统也是基于Linux内核开发的,也有自己实现的init引导程序和自己的Android initial language编写的init.rc引导配置文件。这些都是遵从或借鉴Linux操作系统,Linux操作系统就是通过init引导程序解析执行不同目录的shell脚本来进行系统引导的。 下面直接撸代码,来看一下鸿蒙init引导程序的实现。(源码部分会有些枯燥,操作代码+注释的形式开展) init模块源码分析 code-1.0/base/startup/services/init_lite/ 上面这个是init模块的代码目录。这个模块很小巧,整个目录所有文件加起来只有108KB,源文件只有8个。最大的源文件代码不超过350行。 init主流程 code-1.0/base/startup/services/init_lite/src/main.c int main(int argc, char * const argv[]) { // 1. print system info PrintSysInfo(); // 2. signal register SignalInitModule(); // 3. read configuration file and do jobs InitReadCfg(); // 4. keep process alive printf("[Init] main, entering wait.\n"); while (1) { // pause only returns when a signal was caught and the signal-catching function returned. // pause only returns -1, no need to process the return value. (void)pause(); } return 0; } 以上就是init进程进行系统引导的主流程: 打印系统信息 注册信号 读取系统引导配置文件并执行相应的任务 init进程进入无限循环状态 这个流程很清晰简洁。看过Android操作系统init模块源代码的人,应该会很有感触,这份代码短小精悍,阅读起来很轻松。或许,毕竟这只是HarmonyOS 2.0,不知道经过几个版本的迭代会不会也变得很臃肿呢。 下面详细分析每一步的原理和代码实现。 打印系统信息 这一步是把系统信息输出到控制台,系统信息是由多个字段拼接而成的。这个系统信息类似Android操作系统的fingerprint,是一个很长的字符串,里面包含厂商、品牌、编译类型等。 code-1.0/base/startup/services/init_lite/src/main.c static void PrintSysInfo() { char* sysInfo = GetVersionId(); if (sysInfo != NULL) { printf("[Init] %s\n", sysInfo); // 看这两行代码,主动释放内存,用完立刻释放。 // 鸿蒙OS对内存管理的很好,阅读系统源码的时候,随处可以看到这个设计信条 free(sysInfo); sysInfo = NULL; return; } printf("[Init] main, GetVersionId failed!\n"); } code-1.0/base/startup/frameworks/syspara_lite/parameter/src/parameter_common.c char* GetVersionId(void) { char* value = (char*)malloc(VERSION_ID_LEN); if (value == NULL) { return NULL; } if (memset_s(value, VERSION_ID_LEN, 0, VERSION_ID_LEN) != 0) { free(value); value = NULL; return NULL; } char* productType = GetProductType(); char* manufacture = GetManufacture(); char* brand = GetBrand(); char* productSerial = GetProductSeries(); char* productModel = GetProductModel(); char* softwareModel = GetSoftwareModel(); if (productType == NULL || manufacture == NULL || brand == NULL || productSerial == NULL || productModel == NULL || softwareModel == NULL) { free(productType); free(manufacture); free(brand); free(productSerial); free(productModel); free(softwareModel); free(value); value = NULL; return NULL; } int len = sprintf_s(value, VERSION_ID_LEN, "%s/%s/%s/%s/%s/%s/%s/%s/%s/%s", productType, manufacture, brand, productSerial, g_roBuildOs, productModel, softwareModel, g_roSdkApiLevel, INCREMENTAL_VERSION, BUILD_TYPE); free(productType); free(manufacture); free(brand); free(productSerial); free(productModel); free(softwareModel); if (len < 0) { free(value); value = NULL; return NULL; } return value; } 这里涉及到10个参数,分别是:产品类型、制造商、品牌、产品串号、产品型号、软件型号、操作系统名称、SDK版本号、软件版本、编译类型。用“/”隔开各个字段,形成的字符串就是打印的系统信息。 其中前面6个参数是设备厂商定义的,这包代码在下面的文件进行配置: code-1.0/vendor/huawei/camera/hals/utils/sys_param/hal_sys_param.c static const char OHOS_PRODUCT_TYPE[] = {"****"}; static const char OHOS_MANUFACTURE[] = {"****"}; static const char OHOS_BRAND[] = {"****"}; static const char OHOS_PRODUCT_SERIES[] = {"****"}; static const char OHOS_PRODUCT_MODEL[] = {"****"}; static const char OHOS_SOFTWARE_MODEL[] = {"****"}; 第7、8个参数是在下面的文件中定义的,标示操作系统名称和SDK版本: code-1.0/base/startup/frameworks/syspara_lite/parameter/src/parameter_common.c static char g_roBuildOs[] = {"OpenHarmony"}; static char g_roSdkApiLevel[] = {"3"}; 第9个参数是在产品配置的json脚本中配置的,然后通过编译选项传给源代码使用: code-1.0/base/startup/frameworks/syspara_lite/parameter/src/BUILD.gn code-1.0/build/lite/product/ipcamera_hi3518ev300.json 第10个参数是编译系统时,传入的参数,然后再通过编译选项传给源代码使用: code-1.0/base/startup/frameworks/syspara_lite/parameter/src/BUILD.gn defines = [ "INCREMENTAL_VERSION=\"${ohos_version}\"", "BUILD_TYPE=\"${ohos_build_type}\"", "BUILD_USER=\"${ohos_build_user}\"", "BUILD_TIME=\"${ohos_build_time}\"", "BUILD_HOST=\"${ohos_build_host}\"", "BUILD_ROOTHASH=\"${ohos_build_roothash}\"", ] 没有开发板,没办法把系统跑起来,就不贴实际输出效果图了。 注册信号 code-1.0/base/startup/services/init_lite/src/init_signal_handler.c void SignalInitModule() { struct sigaction act; act.sa_handler = SigHandler; act.sa_flags = SA_RESTART; (void)sigfillset(&act.sa_mask); sigaction(SIGCHLD, &act, NULL); sigaction(SIGTERM, &act, NULL); } 当信号SIGCHLD和SIGTERM发生的时候,会回调函数SigHandler()。 static void SigHandler(int sig) { switch (sig) { case SIGCHLD: { pid_t sigPID; int procStat = 0; printf("[Init] SigHandler, SIGCHLD received.\n"); while (1) { // 非阻塞状态下,等待任意子进程结束返回 sigPID = waitpid(-1, &procStat, WNOHANG); if (sigPID <= 0) { break; } ReapServiceByPID((int)sigPID); } break; } case SIGTERM: { printf("[Init] SigHandler, SIGTERM received.\n"); StopAllServices(); break; } default: printf("[Init] SigHandler, unsupported signal %d.\n", sig); break; } } SIGCHLD:当子进程停止或退出时通知父进程。 SIGTERM:程序结束信号,与SIGKILL不同的是该信号可以被阻塞和处理。通常用来要求程序自己正常退出。 杀死所有服务 code-1.0/base/startup/services/init_lite/src/init_service_manager.c void StopAllServices() { for (size_t i = 0; i < g_servicesCnt; i++) { if (ServiceStop(&g_services[i]) != SERVICE_SUCCESS) { printf("[Init] StopAllServices, service %s stop failed!\n", g_services[i].name); } } } code-1.0/base/startup/services/init_lite/src/init_service.c int ServiceStop(Service *service) { service->attribute &= ~SERVICE_ATTR_NEED_RESTART; service->attribute |= SERVICE_ATTR_NEED_STOP; if (service->pid <= 0) { return SERVICE_SUCCESS; } // 直接向服务进程发送SIGKILL信号,杀死进程 if (kill(service->pid, SIGKILL) != 0) { printf("[Init] stop service %s pid %d failed! err %d.\n", service->name, service->pid, errno); return SERVICE_FAILURE; } printf("[Init] stop service %s, pid %d.\n", service->name, service->pid); return SERVICE_SUCCESS; } 如果收到程序结束信号SIGTERM,会遍历服务列表,服务列表里面保存着所有服务的pid,通过向pid发送SIGKILL信号,来杀死进程。 Reap Service 如果收到子进程停止或退出的信号SIGCHLD code-1.0/base/startup/services/init_lite/src/init_service_manager.c void ReapServiceByPID(int pid) { for (size_t i = 0; i < g_servicesCnt; i++) { if (g_services[i].pid == pid) { if (g_services[i].attribute & SERVICE_ATTR_IMPORTANT) { // important process exit, need to reboot system g_services[i].pid = -1; StopAllServices(); RebootSystem(); } ServiceReap(&g_services[i]); break; } } } 这里分两种情况:如果死掉的是一个important process,则需要杀死所有服务进程,然后重启系统;否则,进行服务收割。 code-1.0/base/startup/services/init_lite/src/init_service.c void ServiceReap(Service *service) { // 首先将服务pid设置为-1 service->pid = -1; // init设置了服务属性NEED_STOP,所以不需要重启,直接返回 if (service->attribute & SERVICE_ATTR_NEED_STOP) { service->attribute &= (~SERVICE_ATTR_NEED_STOP); service->crashCnt = 0; return; } // 具有ONCE属性的服务 if (service->attribute & SERVICE_ATTR_ONCE) { // no need to restart if (!(service->attribute & SERVICE_ATTR_NEED_RESTART)) { service->attribute &= (~SERVICE_ATTR_NEED_STOP); return; } // the service could be restart even if it is one-shot service } // the service that does not need to be restarted restarts, indicating that it has crashed if (!(service->attribute & SERVICE_ATTR_NEED_RESTART)) { // crash time and count check time_t curTime = time(NULL); // 记录崩溃次数和时间 if (service->crashCnt == 0) { service->firstCrashTime = curTime; ++service->crashCnt; } else if (difftime(curTime, service->firstCrashTime) > CRASH_TIME_LIMIT) { service->firstCrashTime = curTime; service->crashCnt = 1; } else { ++service->crashCnt; // 崩溃超过4次,就不在尝试重启 if (service->crashCnt > CRASH_COUNT_LIMIT) { printf("[Init] reap service %s, crash too many times!\n", service->name); return; } } } // 重启服务 int ret = ServiceStart(service); if (ret != SERVICE_SUCCESS) { printf("[Init] reap service %s start failed!\n", service->name); } // 清除服务的NEED_RESTART属性 service->attribute &= (~SERVICE_ATTR_NEED_RESTART); } 服务属性的状态变化似有点绕,没太看懂!!! 启动服务 code-1.0/base/startup/services/init_lite/src/init_service.c int ServiceStart(Service *service) { // 首先检查服务属性,如果是无效属性,不执行服务启动 if (service->attribute & SERVICE_ATTR_INVALID) { printf("[Init] start service %s invalid.\n", service->name); return SERVICE_FAILURE; } struct stat pathStat = {0}; service->attribute &= (~(SERVICE_ATTR_NEED_RESTART | SERVICE_ATTR_NEED_STOP)); // 检查服务可执行文件路径,如果文件不存在,则不执行服务启动 if (stat(service->path, &pathStat) != 0) { service->attribute |= SERVICE_ATTR_INVALID; printf("[Init] start service %s invalid, please check %s.\n", service->name, service->path); return SERVICE_FAILURE; } // 调用fork(),创建子进程 int pid = fork(); if (pid == 0) { // permissions if (SetPerms(service) != SERVICE_SUCCESS) { printf("[Init] service %s exit! set perms failed! err %d.\n", service->name, errno); _exit(0x7f); // 0x7f: user specified } char* argv[] = {service->name, NULL}; char* env[] = {NULL}; // 启动服务的可执行文件,传入文件名称参数 if (execve(service->path, argv, env) != 0) { printf("[Init] service %s execve failed! err %d.\n", service->name, errno); } _exit(0x7f); // 0x7f: user specified } else if (pid < 0) { // 子进程创建失败 printf("[Init] start service %s fork failed!\n", service->name); return SERVICE_FAILURE; } // 将得到的pid保存在服务的数据结构里面 service->pid = pid; printf("[Init] start service %s succeed, pid %d.\n", service->name, service->pid); return SERVICE_SUCCESS; } 启动服务,采用fork+execve。 重启系统 code-1.0/base/startup/services/init_lite/src/init_adapter.c void RebootSystem() { #ifdef __LINUX__ int ret = reboot(RB_DISABLE_CAD); #else int ret = syscall(__NR_shellexec, "reset", "reset"); #endif if (ret != 0) { printf("[Init] reboot failed! syscall ret %d, err %d.\n", ret, errno); } } 读取配置文件并执行任务 这是init模块的重点。 code-1.0/base/startup/services/init_lite/src/init_read_cfg.c void InitReadCfg() { // 读取json格式的引导配置文件 char* fileBuf = ReadFileToBuf(); if (fileBuf == NULL) { printf("[Init] InitReadCfg, read file %s failed! err %d.\n", INIT_CONFIGURATION_FILE, errno); return; } // 解析json文件 cJSON* fileRoot = cJSON_Parse(fileBuf); free(fileBuf); fileBuf = NULL; if (fileRoot == NULL) { printf("[Init] InitReadCfg, parse failed! please check file %s format.\n", INIT_CONFIGURATION_FILE); return; } // 得到服务数据 ParseAllServices(fileRoot); // 得到任务数据 ParseAllJobs(fileRoot); // 释放内存 cJSON_Delete(fileRoot); // 执行任务 DoJob("pre-init"); DoJob("init"); DoJob("post-init"); // 释放Jobs数据结构占据的内存 ReleaseAllJobs(); } 读取配置文件 #define INIT_CONFIGURATION_FILE "/etc/init.cfg" static char* ReadFileToBuf() { char* buffer = NULL; FILE* fd = NULL; struct stat fileStat = {0}; // ??? do...while...0 看不懂,不知道在搞啥? do { // 检查文件有效性 if (stat(INIT_CONFIGURATION_FILE, &fileStat) != 0 || fileStat.st_size <= 0 || fileStat.st_size > MAX_JSON_FILE_LEN) { break; } // 以只读方式打开文件 fd = fopen(INIT_CONFIGURATION_FILE, "r"); if (fd == NULL) { break; } // 分配文件size+1的空间 buffer = (char*)malloc(fileStat.st_size + 1); if (buffer == NULL) { break; } // 从文件读取数据到buffer if (fread(buffer, fileStat.st_size, 1, fd) != 1) { free(buffer); buffer = NULL; break; } // buffer最后一个字节写空字符 buffer[fileStat.st_size] = '\0'; } while (0); if (fd != NULL) { fclose(fd); fd = NULL; } return buffer; } 解析JSON文件 workspace/code-1.0/third_party/cJSON/cJSON.c CJSON_PUBLIC(cJSON *) cJSON_Parse(const char *value) { return cJSON_ParseWithOpts(value, 0, 0); } CJSON_PUBLIC(cJSON *) cJSON_ParseWithOpts(const char *value, const char **return_parse_end, cJSON_bool require_null_terminated) { size_t buffer_length; if (NULL == value) { return NULL; } /* Adding null character size due to require_null_terminated. */ buffer_length = strlen(value) + sizeof(""); return cJSON_ParseWithLengthOpts(value, buffer_length, return_parse_end, require_null_terminated); } 这里使用开源的cJSON库来进行JSON文件解析。 得到服务数据 code-1.0/base/startup/services/init_lite/src/init_read_cfg.c static void ParseAllServices(const cJSON* fileRoot) { int servArrSize = 0; cJSON* serviceArr = GetArrItem(fileRoot, &servArrSize, SERVICES_ARR_NAME_IN_JSON); if (serviceArr == NULL) { printf("[Init] InitReadCfg, get array %s failed.\n", SERVICES_ARR_NAME_IN_JSON); return; } // 限制配置服务的最大数量是100个 if (servArrSize > MAX_SERVICES_CNT_IN_FILE) { printf("[Init] InitReadCfg, too many services[cnt %d] detected, should not exceed %d.\n",\ servArrSize, MAX_SERVICES_CNT_IN_FILE); return; } // 申请空间存放服务数据 Service* retServices = (Service*)malloc(sizeof(Service) * servArrSize); if (retServices == NULL) { printf("[Init] InitReadCfg, malloc for %s arr failed! %d.\n", SERVICES_ARR_NAME_IN_JSON, servArrSize); return; } if (memset_s(retServices, sizeof(Service) * servArrSize, 0, sizeof(Service) * servArrSize) != EOK) { free(retServices); retServices = NULL; return; } // 遍历服务队列,读取数据到`retServices` for (int i = 0; i < servArrSize; ++i) { // 取得一个JSON格式的服务数据 cJSON* curItem = cJSON_GetArrayItem(serviceArr, i); // 获取服务name和path if (GetServiceString(curItem, &retServices[i], "name", MAX_SERVICE_NAME) != SERVICE_SUCCESS || GetServiceString(curItem, &retServices[i], "path", MAX_SERVICE_PATH) != SERVICE_SUCCESS) { retServices[i].attribute |= SERVICE_ATTR_INVALID; printf("[Init] InitReadCfg, bad string values for service %d.\n", i); continue; } // 获取服务uid、gid、once、importance、 if (GetServiceNumber(curItem, &retServices[i], UID_STR_IN_CFG) != SERVICE_SUCCESS || GetServiceNumber(curItem, &retServices[i], GID_STR_IN_CFG) != SERVICE_SUCCESS || GetServiceNumber(curItem, &retServices[i], ONCE_STR_IN_CFG) != SERVICE_SUCCESS || GetServiceNumber(curItem, &retServices[i], IMPORTANT_STR_IN_CFG) != SERVICE_SUCCESS) { retServices[i].attribute |= SERVICE_ATTR_INVALID; printf("[Init] InitReadCfg, bad number values for service %d.\n", i); continue; } // 获取服务caps if (GetServiceCaps(curItem, &retServices[i]) != SERVICE_SUCCESS) { retServices[i].attribute |= SERVICE_ATTR_INVALID; printf("[Init] InitReadCfg, bad caps values for service %d.\n", i); } } // 赋值给全局变量`g_services` RegisterServices(retServices, servArrSize); } // All serivce processes that init will fork+exec. static Service* g_services = NULL; static int g_servicesCnt = 0; void RegisterServices(Service* services, int servicesCnt) { g_services = services; g_servicesCnt = servicesCnt; } 得到任务数据 code-1.0/base/startup/services/init_lite/src/init_jobs.c void ParseAllJobs(const cJSON* fileRoot) { if (fileRoot == NULL) { printf("[Init] ParseAllJobs, input fileRoot is NULL!\n"); return; } // 取得`jobs`的JSON格式的队列 cJSON* jobArr = cJSON_GetObjectItemCaseSensitive(fileRoot, JOBS_ARR_NAME_IN_JSON); int jobArrSize = 0; if (cJSON_IsArray(jobArr)) { jobArrSize = cJSON_GetArraySize(jobArr); } // 最大支持10个任务(组) if (jobArrSize <= 0 || jobArrSize > MAX_JOBS_COUNT) { printf("[Init] ParseAllJobs, jobs count %d is invalid, should be positive and not exceeding %d.\n",\ jobArrSize, MAX_JOBS_COUNT); return; } // 分配内存 Job* retJobs = (Job*)malloc(sizeof(Job) * jobArrSize); if (retJobs == NULL) { printf("[Init] ParseAllJobs, malloc failed! job arrSize %d.\n", jobArrSize); return; } if (memset_s(retJobs, sizeof(Job) * jobArrSize, 0, sizeof(Job) * jobArrSize) != EOK) { printf("[Init] ParseAllJobs, memset_s failed.\n"); free(retJobs); retJobs = NULL; return; } for (int i = 0; i < jobArrSize; ++i) { cJSON* jobItem = cJSON_GetArrayItem(jobArr, i); ParseJob(jobItem, &(retJobs[i])); } // 赋值给全局变量`g_jobs` g_jobs = retJobs; g_jobCnt = jobArrSize; } static void ParseJob(const cJSON* jobItem, Job* resJob) { // 取得任务名称。 // 任务名称为pre-init/init/post-init三个中一个 if (!GetJobName(jobItem, resJob)) { (void)memset_s(resJob, sizeof(*resJob), 0, sizeof(*resJob)); return; } // 获取任务对应的cmd的JSON数据 cJSON* cmdsItem = cJSON_GetObjectItem(jobItem, CMDS_ARR_NAME_IN_JSON); if (!cJSON_IsArray(cmdsItem)) { return; } // 获取cmd的数量 int cmdLinesCnt = cJSON_GetArraySize(cmdsItem); if (cmdLinesCnt <= 0) { // empty job, no cmd return; } // 一个任务组的cmd不能超过30个 if (cmdLinesCnt > MAX_CMD_CNT_IN_ONE_JOB) { printf("[Init] ParseAllJobs, too many cmds[cnt %d] in one job, it should not exceed %d.\n",\ cmdLinesCnt, MAX_CMD_CNT_IN_ONE_JOB); return; } // 分配内存 resJob->cmdLines = (CmdLine*)malloc(cmdLinesCnt * sizeof(CmdLine)); if (resJob->cmdLines == NULL) { return; } if (memset_s(resJob->cmdLines, cmdLinesCnt * sizeof(CmdLine), 0, cmdLinesCnt * sizeof(CmdLine)) != EOK) { free(resJob->cmdLines); resJob->cmdLines = NULL; return; } resJob->cmdLinesCnt = cmdLinesCnt; for (int i = 0; i < cmdLinesCnt; ++i) { char* cmdLineStr = cJSON_GetStringValue(cJSON_GetArrayItem(cmdsItem, i)); ParseCmdLine(cmdLineStr, &(resJob->cmdLines[i])); } } code-1.0/base/startup/services/init_lite/src/init_cmds.c void ParseCmdLine(const char* cmdStr, CmdLine* resCmd) { if (cmdStr == NULL || strlen(cmdStr) == 0 || resCmd == NULL) { return; } // 取得cmd line字符串长度 size_t cmdLineLen = strlen(cmdStr); // 获得支持的命令数量 size_t supportCmdCnt = sizeof(g_supportedCmds) / sizeof(g_supportedCmds[0]); // 声明并初始化标志位:是否找到命令并解析成功 int foundAndSucceed = 0; // 遍历支持的命令列表,判断这个命令是否在支持的列表里面 for (size_t i = 0; i < supportCmdCnt; ++i) { size_t curCmdNameLen = strlen(g_supportedCmds[i]); // 如果cmd line的长度比比较的这个命令长,并且这个命令+max_cmd_content_len的长度小 // 并且cmd line中的命令和这个命令一样 if (cmdLineLen > curCmdNameLen && cmdLineLen <= (curCmdNameLen + MAX_CMD_CONTENT_LEN) && strncmp(g_supportedCmds[i], cmdStr, curCmdNameLen) == 0) { // 写入cmd_name,并把尾字符写入一个空字符 if (memcpy_s(resCmd->name, MAX_CMD_NAME_LEN, cmdStr, curCmdNameLen) != EOK) { break; } resCmd->name[curCmdNameLen] = '\0'; // 写入cmd_content,并把尾字符写入一个空字符 const char* cmdContent = cmdStr + curCmdNameLen; size_t cmdContentLen = cmdLineLen - curCmdNameLen; if (memcpy_s(resCmd->cmdContent, MAX_CMD_CONTENT_LEN, cmdContent, cmdContentLen) != EOK) { break; } resCmd->cmdContent[cmdContentLen] = '\0'; // 设置标志位:找到命令并解析成功 foundAndSucceed = 1; break; } } // 如果没有找到或解析失败,则向其中全部写入0 if (!foundAndSucceed) { (void)memset_s(resCmd, sizeof(*resCmd), 0, sizeof(*resCmd)); } } 纯字符串操作,看着就是这么舒服! 执行任务 任务的执行分三个阶段,按照时间顺序,依次是:pre-init、init、post-init。 根据init_liteos_a_3518ev300.cfg配置来看: pre-init阶段主要进行目录创建、文件权限设置、分区挂载等。 init阶段主要进行服务程序启动 post-init阶段主要进行设备文件权限更改 code-1.0\base\startup\services\init_lite\src\init_jobs.c void DoJob(const char* jobName) { if (jobName == NULL) { printf("[Init] DoJob, input jobName NULL!\n"); return; } for (int i = 0; i < g_jobCnt; ++i) { if (strncmp(jobName, g_jobs[i].name, strlen(g_jobs[i].name)) == 0) { CmdLine* cmdLines = g_jobs[i].cmdLines; for (int j = 0; j < g_jobs[i].cmdLinesCnt; ++j) { DoCmd(&(cmdLines[j])); } break; } } } void DoCmd(const CmdLine* curCmd) { if (curCmd == NULL) { return; } if (strncmp(curCmd->name, "start ", strlen("start ")) == 0) { DoStart(curCmd->cmdContent); } else if (strncmp(curCmd->name, "mkdir ", strlen("mkdir ")) == 0) { DoMkDir(curCmd->cmdContent); } else if (strncmp(curCmd->name, "chmod ", strlen("chmod ")) == 0) { DoChmod(curCmd->cmdContent); } else if (strncmp(curCmd->name, "chown ", strlen("chown ")) == 0) { DoChown(curCmd->cmdContent); } else if (strncmp(curCmd->name, "mount ", strlen("mount ")) == 0) { DoMount(curCmd->cmdContent); } else { printf("[Init] DoCmd, unknown cmd name %s.\n", curCmd->name); } } 目前鸿蒙2.0支持的命令还很少(或是为了简介),只有5个命令:start、mkdir、chmod、chown、mount。start命令指,启动services配置的服务。其它四个命令就是linux系统的同名命令的功能。 DoStart()展开一下,其它四个命令,感兴趣的可以自己跟一下代码。 static void DoStart(const char* cmdContent) { StartServiceByName(cmdContent); } void StartServiceByName(const char* servName) { // 从全局的服务数据结构里面,通过名字查找服务 int servIdx = FindServiceByName(servName); if (servIdx < 0) { printf("[Init] StartServiceByName, cannot find service %s.\n", servName); return; } // 调用ServiceStart()函数启动服务,前面已经展开过 if (ServiceStart(&g_services[servIdx]) != SERVICE_SUCCESS) { printf("[Init] StartServiceByName, service %s start failed!\n", g_services[servIdx].name); } // ??? 这个有啥作用? sleep(SLEEP_DURATION); return; } service属性 code-1.0/base/startup/services/init_lite/include/init_service.h #define SERVICE_ATTR_INVALID 0x001 // option invalid #define SERVICE_ATTR_ONCE 0x002 // do not restart when it exits #define SERVICE_ATTR_NEED_RESTART 0x004 // will restart in the near future #define SERVICE_ATTR_NEED_STOP 0x008 // will stop in reap #define SERVICE_ATTR_IMPORTANT 0x010 // will reboot if it crash service一共有5种属性,每个属性占据一个bit位,依次为: INVALID 服务不存在 ONCE 服务退出后,不进行重启 NEED_RESTART 服务退出后,需要(在不就的将来进行)重启 NEED_STOP 如果是init进程强行杀死的服务,会设置服务的这个bit位为1 IMPORTANT 重要服务,如果服务退出(异常),会导致系统重启 关键数据结构 Service code-1.0\base\startup\services\init_lite\include\init_service.h typedef struct { uid_t uID; gid_t gID; unsigned int *caps; unsigned int capsCnt; } Perms; typedef struct { char name[MAX_SERVICE_NAME + 1]; char path[MAX_SERVICE_PATH + 1]; int pid; int crashCnt; time_t firstCrashTime; unsigned int attribute; Perms servPerm; } Service; Service数据结构,定义一个结构体,然后在结构体里面写入服务的每个数据字段。 Job code-1.0\base\startup\services\init_lite\include\init_jobs.h // one job, could have many cmd lines typedef struct { char name[MAX_JOB_NAME_LEN + 1]; int cmdLinesCnt; CmdLine* cmdLines; } Job; code-1.0\base\startup\services\init_lite\include\init_cmds.h // one cmd line typedef struct { char name[MAX_CMD_NAME_LEN + 1]; char cmdContent[MAX_CMD_CONTENT_LEN + 1]; } CmdLine; Job数据结构,一个Job可能含有多个cmd,所以结构体设计了三个字段,分别是:Job名字、cmd数量、cmd指针。 全局变量 code-1.0\base\startup\services\init_lite\src\init_service_manager.c static Service* g_services = NULL; static int g_servicesCnt = 0; 全局变量g_services保存了所有配置的服务。 引导配置文件 code-1.0\vendor\huawei\camera\init_configs\init_liteos_a_3516dv300.cfg { "jobs" : [{ "name" : "pre-init", "cmds" : [ "mkdir /sdcard", "chmod 0777 /sdcard", "mount vfat /dev/mmcblk1 /sdcard rw,umask=000" ] }, { "name" : "init", "cmds" : [ "start foundation", "start appspawn" ] }, { "name" : "post-init", "cmds" : [ "chown 0 99 /dev/dev_mgr", "chown 0 99 /dev/hdfwifi" ] } ], "services" : [{ "name" : "foundation", "path" : "/bin/foundation", "uid" : 7, "gid" : 7, "once" : 0, "importance" : 1, "caps" : [10, 11, 12, 13] }, { "name" : "appspawn", "path" : "/bin/appspawn", "uid" : 1, "gid" : 1, "once" : 0, "importance" : 0, "caps" : [2, 6, 7, 8, 23] } ] } 目前一共支持两种类型的定义,一类是services,一类是jobs。services配置的服务可以在jobs中调用start命令来启动。 services有7个配置项,分别是:name、path、uid、gid、once、importance、caps。其中比较重要的是服务名称、可执行文件路径、挂掉之后要不要重启、重要性。可配置的服务最大数量是100个。 name: 服务名称 path: 可执行文件路径 uid: 用户ID gid: 组ID once: 挂掉之后需不需要重新拉起来 importance: 服务的重要性 caps: 暂不明确有什么作用 jobs是设置一些要执行的命令。目前支持5个命令,分别是start、mkdir、chown、chmod、mount。start命令就是用来启动services中定义的服务。 这个JSON配置文件是有很多限制条件的: 文件大小不能超过100KB 配置的服务数量不能超过100个 服务的名字不能超过32个字符 服务的路径不能超过64个字符 配置的任务(任务组)数量不能超过10个 一个任务组配置的cmd不能超过30个 一行一个cmd,包括cmd_name和cmd_content cmd_name长度不能超过10个字符 cmd_content长度不能超过128个字符 3518开发板默认配置开机引导都做了什么 创建log文件夹,创建软总线softbus文件夹,创建sdcard文件夹,挂载sdcard,依次启动服务shell、apphilogcat、foundation、bundle_daemon、media_server、appspawn,修改一些设备权限。 后续学习计划 研究完了init模块,后续该如何继续学习呢? 其实根据系统的启动流程来学习就是一个不错的学习路径。init进程启动之后,接着就是这6大服务的启动,后续会根据shell、apphilogcat、foundation、bundle_daemon、media_server、appspawn,这个顺序,依次研究每一个服务。这只是大概的计划,关键模块肯定会非常庞大,遇到的时候需要分而学之。 本文参与了「解读鸿蒙源码」技术征文,欢迎正在阅读的你也加入。


优秀的个人博客,低调大师

Docker部署Bytom全节点钱包

微服务和容器目前比较流行,相信很多小伙伴都比较熟悉docker, 如果你不是太了解,可以查看文档docker学习手册。那如何用docker搭建比原链(Bytom)的节点呢? 在操作之前,请自行安装docker。然后在你的终端输入(windows对应cmd): docker 出现如下图说明你已经安装成功了docker: 获取bytom的docker镜像 docker pull bytom/bytom:latest 用docker images 查看自己下载的bytom镜像 docker images 然后出现如下图说明已经获取到了镜像: 初始化: docker run -v < Bytom / data / directory / on / host / machine >:/ root /.bytom bytom:latest bytomd init --chain_id < chainId > 默认的Bytom数据目录(在主机上)是: Mac: ~/Library/Bytom Linux: ~/.bytom windows: %APPDATA%\Bytom chainId 有三种选择: mainnet:连接到主网 testnet:连接到测试网 solonet:单节点 如下例(mac/testnet): docker run -v ~/Library/Bytom:/root/.bytom bytom/bytom:latest bytomd init --chain_id testnet 开启docker终端交互模式: docker run -it -p 9888:9888 -v ~/Library/Bytom:/root/.bytom bytom/bytom:latest 开启守护进程模式: docker run -d -p 9888:9888 -v ~/Library/Bytom:/root/.bytom bytom/bytom:latest bytomd node --web.closed --auth.disable 查看正在运行的容器: docker ps 下图中我们可以看到我们在运行的容器: 最后在浏览器中请求:http://0.0.0.0:9888,可以就可以查看我们钱包。

优秀的个人博客,低调大师

Python全栈 Web (项目部署)

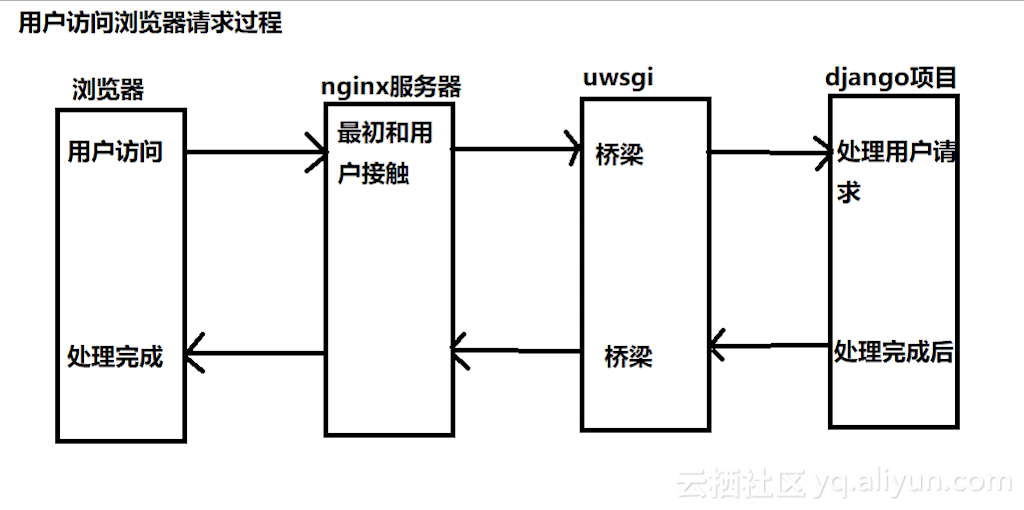
Django项目(Web应用) Web服务 1、nginx :高并发处理的好 2、Apache :稳定 LAMP :Linux Apache MySQL Python/Php/Perl LNMP :Linux Nginx MySQL Python/Php/Perl 3、uwsgi 是Web服务器与Web框架之间一种简单而通用的接口 单项目部署(nginx+uwsgi+Django) 确保django项目能够运行 安装nginx(用apt-get去安装) 1、安装 sudo apt-get install nginx 2、启动 sudo /etc/init.d/nginx restart 3、验证 打开浏览器-->127.0.0.1:80-->Welcome to Nginx! 安装uwsgi(用pip3去安装) 1、安装 sudo pip3 install uwsgi 2、验证 uwsgi --http :9998 --chdir /home/tarena/myproject/friutday_1/ --module friutday.wsgi 部署 配置uwsgi(配置文件) 1、 mkdir uwsgi 2、 cd uwsgi 3、 vi fruitday_uwsgi.ini [uwsgi] # 和nginx通信的端口 socket=127.0.0.1:8001 # 项目路径 chdir=/home/tarena/myproject/friutday_1 # wsgi.py路径 wsgi-file=friutday/wsgi.py # 进程数 processes=4 # 线程数 thread=2 # 本项目占用uwsgi端口 stats=127.0.0.1:8081 配置nginx(配置文件) sudo -i cd /etc/nginx/sites-enabled vi project_nginx.conf # 配置文件内容 server{ # 监听本项目端口,浏览器输入的端口 listen 8201; server_name frituday.com; charset utf-8; client_max_body_size 75M; # 收集项目静态文件路径 location /static{ alias /home/tarena/myproject/friutday_1/static; } # 和uwsgi通信端口和项目通信文件uwsgi_params location /{ include uwsgi_params; uwsgi_pass 127.0.0.1:8001; } } 4、重启nginx服务 sudo /etc/init.d/nginx restart 5、拷贝uwsgi_params文件到项目目录 cp uwsgi_params /home/tarena/myproject/friutday_1/ 收集静态文件 1、在settings.py文件中添加路径(STATIC_ROOT) STATIC_ROOT = '/home/tarena/myproject/friutday_1/static/' 2、收集静态文件 python3 manage.py collectstatic uwsgi启动项目 cd /home/tarena/uwsgi uwsgi --ini fruitday_uwsgi.ini 3、多项目部署 uwsgi 每个项目需要单独创建uwsgi配置文件,选用不同端口 nginx 配置文件,1个就可以,添加server{} 部署个人博客项目 浏览器访问端口 :8202 /etc/nginx/sites-enabled/project_nginx.conf # listen 8202 uwsgi和nginx通信端口 :8002 cd uwsgi vi blog_uwsgi.ini # socket=127.0.0.1:8002 uwsgi启动个人博客项目占用端口 :8082 vi blog_uwsgi.ini stats=127.0.0.1:8082

优秀的个人博客,低调大师

Python全栈 Web(Django框架、模板)

1.Django中的模板(Templates) 1.什么是模板 模板就是要动态呈现给用户的网页 模板的本质就是网页- 前后端,动静结合的网页 Django的模板引擎是由Django自己提供的,并不是Jinja2, 所以Django的模板语法与Flask(Jinja2)的语法会有一些不同 2.模板的设置 在 settings.py 中 有一个 TEMPLATES 变量 1.BACKEND:指定使用的模板的引擎 2.DIRS :指定模板的存放目录们 1.如果写东西:则按照写好的路径去找模板 2.如果未写东西:那么Django会自动的到每个应用中所有一个叫templates的目录来作为模板的存放目录 3.APP_DIRS : 是否自动搜索应用中的目录 True:表示搜索应用中的 templates 的目录 # Static files (CSS, JavaScript, Images) # https://docs.djangoproject.com/en/1.11/howto/static-files/ # 静态文件的访问路径 STATIC_URL = '/static/' # 静态文件的存储路径 STATICFILES_DIRS = (os.path.join(BASE_DIR, 'static'),) 1.通过 loader 对象获取模板,再通过HttpResponse进行响应 from django.template import loader def xxViews(request): #1.通过 loader 加载模板 t = loader.get_template("模板名称") #2.将模板渲染成字符串 html = t.render() #3.将字符串通过HttpResponse响应给客户端 return HttpResponse(html) 2.使用 render 直接加载并响应模板 def xxViews(request): return render(request,'模板的名称') # Create your views here. def temp_views(request): #1.通过loader加载模板 t=loader.get_template('01-temp.html') #2.将模板渲染成字符串 html=t.render() #3.再通过HttpResponse将字符串响应给浏览器 return HttpResponse(html) # 使用render加载模板 def temp02_views(request): return render(request, '01-temp.html') 4.模板的语法 1.变量 1.作用:将后端的数据传递给模板进行显示 2.在Django中允许作为变量传递给模板的数据类型 字符串,整数,列表,元组,字典,函数,对象 3.变量的语法 变量们必须要封装到字典中才能传递给模板 1.使用 loader 加载模板 dic = { '变量名1':'值1', '变量名2':'值2', } t = loader.get_template('xxx.html') html = t.render(locals() 或 dic) return HttpResponse(html) 2.使用 render 加载并返回模板 dic = { '变量名1':'值1', '变量名2':'值2', } return render(request,'xx.html',dic) 4.在模板中使用变量 {{变量名}} # http://localhost:8000/03-var def var_views(request): str = "模板中的变量-字符串" num = 3306 tup = ('谢逊','韦一笑','殷素素','金花婆婆') list = ['孙悟空','猪八戒','沙和尚'] dic = { 'BJ':'北京', 'SZ':'深圳', 'SH':'上海', } say = sayHi() dog = Dog() return render(request,'03-var.html',locals()) <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <!-- 取出每个变量进行显示 --> <h3>str:{{ str }}</h3> <h3>num:{{ num }}</h3> <h3>tup:{{ tup }}</h3> <h3>tup[0]:{{ tup.0 }}</h3> <h3>list:{{ list }}</h3> <h3>list[1]:{{ list.1 }}</h3> <h3>dic:{{ dic }}</h3> <h3>dic['SZ']:{{ dic.SZ }}</h3> <h3>say:{{ say }}</h3> <h3>dog.name:{{ dog.name }}</h3> <h3>dog.eat:{{ dog.eat }}</h3> <!-- 宠物名称:{{ dog.name }} --> {% comment "宠物名称" %} 宠物名称:{{ dog.name }} {% endcomment %} </body> </html> django中不同于jinja2的模板 django的模板中不能使用索引和切片 只能通过·的方式来获取元素 但不影响循环 2.标签 1.作用 将服务器端的功能嵌入到模板中 2.语法 {% 标签内容 %} 3.常用标签 1. comment 标签 2. for 标签 作用:循环遍历 列表,字典,元组 语法: {% for 变量 in 列表|元组|字典 %} {% endfor %} 循环中允许使用 forloop 内置变量来获取循环的信息 forloop.counter : 当前循环遍历的次数 forloop.first : 判断是否为第一次循环 forloop.last : 判断是否为最后一次循环 3.if 标签 作用:在模板中完成变量的判断操作 语法: 1. if {% if 条件 %} 满足条件时要执行的内容 {% endif %} 2. if ... else {% if 条件 %} 满足条件时要执行的内容 {% else %} 不满足条件时要执行的内容 {% endif %} 3.if ... elif ... else {% if 条件1 %} 满足条件1时要执行的内容 {% elif 条件2 %} 或满足条件2时要执行的内容 {% elif 条件3 %} 或满足条件3时要执行的内容 {% else %} 或以上条件都不满足时要执行的内容 {% endif %} <!-- 通过for循环便利tup --> <h1>使用for循环便利tup</h1> {% for t in tup %} <p {% if forloop.first %} style="background:red;" {% elif forloop.last %} style="background:blue;" {% else %} style="background:pink;" {% endif %} > <span>内容:{{ t }}</span> <br> <span>下标:{{ forloop.counter0 }}</span> <br> <span>次数:{{ forloop.counter }}</span> <br> <span>第一次循环:{{ forloop.first }}</span> <br> <span>最后一次循环:{{ forloop.last }}</span> </p> {% endfor %} <h1>通过for实现的select</h1> <select> {% for t in tup %} <option value="{{ forloop.counter0 }}" {% if forloop.last %} selected {% endif %} >{{ t }}</option> {% endfor %} </select> 3.过滤器 1.什么是过滤器 在变量输出显示之前,对变量进行筛选和过滤 2.过滤器的语法 {{变量|过滤器:参数}} 3.常用过滤器 1.{{value|upper}} 将value变为大写 2.{{value|lower}} 将value变为小写 3.{{value|add:num}} 将num值累加到value之后 4.{{value|floatformat:n}} 将value四舍五入到n位小数 5.{{value|truncatechars:n}} 将value截取保留至n位字符(包含...) 4.静态文件 1.什么是静态文件 在Django中,不被解释器所动态解析的文件就是静态文件 2.Django中静态文件的处理 在settings.py中设置有关静态文件的信息: 1.设置静态文件的访问路径 在浏览器中通过哪个地址能够找到静态文件 STATIC_URL = '/static/' 如果访问路径是 http://localhost:8000/static/...,那么就到静态文件存储路径中找文件而不走路由(urls.py) 2.设置静态文件的存储路径 指定静态文件存储在服务器上的哪个位置处 STATICFILES_DIRS=(os.path.join(BASE_DIR,'static'),) 静态文件目录的存放位置: 1.在项目的根目录处创建一个 static 目录,用于保存静态文件们 2.每个应用中也可以创建一个 static 目录,用于保存静态文件们 3.访问静态文件 1.直接使用静态文件访问路径进行访问 http://localhost:8000/static/.. ex: <img src="/static/images/a.jpg"> <img src="http://localhost:8000/static/images/a.jpg"> 2.使用 {% static %} 访问静态资源 {% static %} 表示的就是静态资源的访问路径 1.在模板的最顶层增加 {% load static %} 2.在使用静态资源时 <img src="{% static 'images/a.jpg'%}"> # http://localhost:8000/04-static def static_views(request): return render(request, '04-static.html') {% load static %} <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <!-- 显示静态资源文件 --> <p> <img src="/static/images/shuaige.jpg"> </p> <p> <img src="http://localhost:8000/static/images/shuaige.jpg"> </p> <p> <img src="{% static 'images/shuaige.jpg' %}"> </p> </body> </html>

优秀的个人博客,低调大师

Python全栈 Web(Ajax 概述 创建)

什么是AJAX Asynchronous JavaScript And Xml 异步的 JS 和 Xml 通过js异步的向服务器发送请求并接受响应数据 同步访问: 当客户端向服务器发送请求时 服务器在处理的过程中浏览器只能等待 异步访问: 当客户端向服务器发送请求时 服务器在处理的过程中 客户端可以做其他操作 不需要一直等待 AJAX优点: 异步访问 局部刷新 使用场合: 搜索建议 表单验证 前后端完全分离 AJAX核心对象 异步核心对象(XMLHttprequest): 什么是XMLHTTPRequest 代替浏览器向服务器发送异步请求并接受响应的 “异步对象” 是由js来提供的 创建异步对象 主流的异步对象是XMLHTTPRequest类型的 并且主流浏览器(IE+ Chrome Firefox Safari Opera)都支持 低版本浏览器中(IE6以下)就不

优秀的个人博客,低调大师

Python全栈 Web(Ajax JSON JQuery)

JOSN: Javascript Object Notation 作用: 主要约束前后端交互数据的格式 JSON的格式 表示单个对象 使用{} 采用键值对的格式保存数据 键必须使用双引号引起来 相当于Python的字典 表示多个对象 使用[]表示一个数组 数组中允许包含多个字符串或对象 jQuery中的循环: $arr.each(function(i, obj)){ $arr:表示jQuery中的数组 i:表示当前元素的下标 obj:表示的是当前元素 }; $.each(arr,function(i, o

优秀的个人博客,低调大师

Python全栈 Web(jQuery 外卖套餐)

说实话 前端这些东西 真就是一个字 背就完事了 背的越多 就越牛逼 1.jQuery动画 1.基本显示 / 隐藏 $obj.show() / $obj.show(执行时长); $obj.hide() / $obj.hide(执行时长); 2.滑动式显示 / 隐藏 $obj.slideDown() / $obj.slideDown(执行时长); $obj.slideUp() / $obj.slideUp(执行时长); 3.淡入淡出式显示 / 隐藏 $obj.fadeIn() / $obj.fadeIn(执行时长); $obj.fadeOut() / $obj.fadeOut(执行时长); 2.jQuery插件 1.下载插件并引入(jquery,插件文件,css文件) 2.结合当前网页修改css 3.去插件中修改数据(替换图片/图片名称) 无聊的前端三剑客终

优秀的个人博客,低调大师

Python全栈 Web(JavaScript 函数、数组)

循环: for循环 简化版while循环 语法: for(表达式1;表达式2;表达式3) { 循环体 } 表达式1:循环条件初始化 表达式2:循环终止条件 表达式3:更新循环条件 流程: 1.先执行表达式1 声明条件 并且自走一次 2.表达式2 与循环条件的boolean值 3.进行循环操作 4.表达式3 更新循环条件 返回判断表达式2 for 和 while对比: 相同: 先判断条件然后在进行循环操作 不同: while:优先使用在不确定循环次数的场合下 for:优先使用在已知循环次数的条件下 通常用来遍历数据结构 循环的嵌套: 允许一个循环内部再出现一个循环 for(var i = 0; i <= 10; i++){ for(var x = 0; x <= 10; x++){ 循环体 } } 外层循环走以次内层循环走一轮 函数: function 是一段被定义好并且可以独立反复执行 并包含多条执行语句的代码块 在JS中创建函数: function 函数名 (参数){ 函数体 [返回值] //[] 代表可省略 } 参数列表; 如果没有参数为空 有则用逗号隔开多个参数 调用时有参数没有传参的参数值为undefined 返回值: 在函数体内经过运算后 返回给函数调用者的值 有返回值需要用 return进行返回 但是只能返回一个值 函数的调用: 在任意能写JS代码的地方 都可以调用函数 有参数 传递参数 否则参数列表为空 有返回值可以用变量接收 没有则返回 undefined 匿名函数: 匿名函数是一个没有名称的函数 该类函数会针对某一个 功能而存在 不能独立声明 语法: function (参数列表){ 函数体 } window.onload = function(){ console.log("hello world!"); } 网页加载的时所执行的内容都可以放在window.onload里 变量的作用域: 什么是变量的作用域? 指的是变量的可访问范围 js的作用域: 局部变量 使用var关键字声明在函数内的变量 就是局部变量 只能在函数内使用 全局变量 在function外声明的变量都是全局变量 声明变量只要不使用var关键字申明的变量都是全局变量 全局变量可以在任意函数内使用 尽量所有的变量都使用var关键字声明 变量的声明提前: 在JS中使用var关键字声明的变量在程序执行之前 都会被预读到所在作用域的顶端 但是赋值还会保留在原位 在变量赋值之前调用 不会报错 值为undefined 数组 - Array: 什么是数组? 以一种用于保存批量数据的数据结构 数组是按照线性结构来保存数据的 除第一元素外每一个元素都有一个“前驱元素” 除最后一个元素外每一个元素都有一个“后驱元素” 创建数组: 数组直接量创建: var 数组名 = []; var 数组名 = [1, 2, 3, "a", "b"]; 构造函数创建: var 数组名 = new Array(); var 数组名 = new Array(1, 2, 3, "a", "b"); *var 数组名 = new Array(5); //默认5个 undefined值 下标从5开始 数组的使用; 获取或设置数组的元素值 一律使用数组的下标 范围: 0 ~ arr1.length - 1 var arr1 = [1, 2, 3, 4, 5]; 索引: arr1[3] // 4; 索引超出范围是不会报错的 返回值为:undefined 索引赋值: arr1[3] = 9 // [1, 2, 3, 9, 5] 赋值也可以超出范围 在已有的最后一个元素和 超出范围元素之间的所有元素都为 empty 如果进行索引取值 结果都为:undefined 获取数组的长度: 属性: length 用法: 数组名.length 使用场合: 1.可以向数组的尾部插入元素 2.数组的长度 3.配合循环遍历数组中的每个元素 for (var i = 0; i < arr1.length; i++){ console.log(arr1[i]) } 在控制台中打印以下图形 * 4个空格1个* *** 3个空格3个* ***** 2个空格5个* ******* 1个空格7个* ********* 0个空格9个* <!DOCTYPE html> <html> <head> <title></title> <meta charset="utf-8"> <script type="text/javascript"> var line = 5; for (var i = 1; i <= line; i++){ var msg = ""; for (var j = 1; j <= line - i; j++){ msg += " "; } for (var k = 1; k <= i * 2 -1; k++){ if (k == 1 || k == i * 2 - 1){ msg += "*"; } else { msg += " "; } } console.log(msg); } for (var i = 1; i <= line; i++){ var msg = ""; for (var j = 1; j <= i; j++){ msg += " "; } for (var k = 1; k <= (line - i) * 2 -1; k++){ if (k == 1 || k == (line -i) * 2 -1){ msg += "*"; } else { msg += " "; } } console.log(msg) } </script> </head> <body> </body> </html>

优秀的个人博客,低调大师

Python全栈 Web(HTML标签大全)

<!-- H5的声明方式 --> <!DOCTYPE html> <br><br><br> <h4> <p>©ParisGabriel</p> <dir> 2018/9/1<br> QQ:1546079656<br> Eminl:1546079656@qq.com<br> </dir> <br><br><br><br><br> </h4> <!-- 文档的结束标记 --> <html> <!-- 网页的头部信息 --> <!-- 标题、选项卡图标、关键字、作者、描述等 --> <head> <!-- 网页标题 --> <title>首页</title> <!-- 字符编码 --> <meta charset="utf-8"> <!-- 选项卡图标 --> <link rel="shortcut icon" href="web.ico" type="image/x-icon"> </head> <p> <img src="./color.jpg"> </p> <!-- 网页的主体信息 --> <!-- 网页所呈现的内容等 --> <body> <!-- 空格:&nbsp;<br> 换行:<br> 小于:&lt;<br> 大于:&gt;<br> 版权符号:&copy;<br> 人民币:&yen;<br> --> 空格:<br> 换行:<br> 小于:<<br> 大于:><br> 版权符号:©<br> 人民币:¥<br> 斜体显示:<i>斜体</i><br> 下划线:<u>下划线</u><br> 文本加粗:<b>加粗</b><br> 删除线:<s>删除</s><br> 上标记:<sup>上标</sup><br> 下标记:<sub>下标</sub><br> 标题: <h1>一级标题</h1> <h2>二级标题</h2> <h3>三级标题</h3> <h4>四级标题</h4> <h5>五级标题</h5> <h6>六级标题</h6> 水平对其方式: <h4 align="left">默认居右</h4> <h4 align="center">设置居中</h4> <h4 align="right">设置居左</h4> 水平线:<hr> 段落:<p></p> 分块: <div> 这是<br> 一块<br> 元素<br> </div> 分区:这是<span>绿色</span>、<span>黄色</span>、<span>红色的字体</span> 有序列表: <!-- type 属性:1、a、A、i --> <!-- start属性:开始位置 --> <ol type="1" start="10"> <li>有序列表列表项一</li> <li>有序列表列表项二</li> <li>有序列表列表项三</li> </ol> <!-- type属性:disc(实心圆)、circle(空心圆)、square(实心方框)、none(不显示) --> 无序列表: <ul type="square"> <li>无序列表列表项一</li> <li>无序列表列表项二</li> <li>无序列表列表项三</li> </ul> <!-- 有序列表无序列表可以任意嵌套 --> 图像标签: <!-- 属性:src(路径)、width、height、title(鼠标悬停标题)、alt(错误提示) --> <p>绝对路径:</p> <img src="C:\Users\Administrator\Desktop\HTML标签\501018476.jpg" width="800px" height="430px"> <p>相对路径:</p> <img src="项目.jpg" alt="文件路径不存在 项目.jpg" title="项目开发流程"> <p> 超链接: <!-- target属性:_self(默认窗口打开)、_blank(新建窗口打开)--> <a href="https://www.baidu.com" target="_blank">百度</a> <a href="C:\Users\Administrator\Desktop\HTML标签\bgvideo-720-2.mp4">视频</a> <a href="图片.zip">下载</a> <a name="bottom">设置锚点</a> <a href="#bottom">链接锚点</a> </p> <!-- 表格:<table> --> <!-- 行标签:<tr> --> <!-- 单元格:<td> --> <br> 表格: <!-- 属性:border(边框)、width、height、align(水平对齐) --> <!-- cellpadding(内边距)、cellspacing(外边距)、bgcolor(背景色) --> <table border="1px" width="200px" height="200px" cellspacing="10px" cellpadding="10px"> <!-- 属性:bgcolor、align(水平)、valign(垂直对齐):top、middle、bottom --> <tr> <!-- 属性:width、height、align、valign、bgcolor --> <!-- colspan(跨行合并单元格)、rowspan(跨列) --> <td align="center">单元格</td> <td align="center">单元格</td> </tr> <tr> <td align="center">单元格</td> <td align="center">单元格</td> </tr> </table> <br> 行分组: <table border="1px" width="300px" height="300px" cellspacing="10px" cellpadding="10px"> <thead> <tr> <td>表头</td> <td>表头</td> <td>表头</td> </tr> </thead> <tfoot> <tr> <td>表尾</td> <td>表尾</td> <td>表尾</td> </tr> </tfoot> <tbody> <tr> <td>表主体</td> <td>表主体</td> <td>表主体</td> </tr> </tbody> </table> <br> 合并单元格: <table border="1px" width="300px" height="300px" cellspacing="10px" cellpadding="10px"> <tr> <td colspan="2">跨列合并</td> <td>单元格</td> </tr> <tr> <td>单元格</td> <td rowspan="2">跨行合并</td> <td>单元格</td> </tr> <tr> <td>单元格</td> <td>单元格</td> </tr> </table> <br> 表单控件: <!-- 属性:action(指定数据提交地址)、method(请求方式) --> <form>表单控件</form> <br> 表单控件: <form> <!-- 属性:name(必填自定义名称)、value(控件上的默认值) --> <!-- maxlength(字符限制)、placeholder(文本框提示文本) --> 文本框:<input type="text" name="utext" placeholder="username"><br> 密码框:<input type="password" name="upaddeord"> </form> <br> 选择框: <form> <!-- 属性:name(用来同名分组)、value(控件代表的值)、checked(默认选择) --> 单选框:<input type="radio" name="radio"> 单选框:<input type="radio" name="radio" checked><br> 多选框:<input type="checkbox" name="checkbox"> 多选框:<input type="checkbox" name="checkbox"> </form> <br> 隐藏域: <frame> <!-- 属性:name(控件名)、value(控件值) --> <input type="hidden" name="uname" value="张三"><br> <!-- 属性:name(控件名称) --> <br> 文件选择框:<input type="file" name="图谱"><br> </frame> <br> 下拉菜单: <frame> <!-- 属性:name(URL后拼接数、value(选项值) --> <select name="province"> <option value="山东">山东省</option> <option value="山西">山西省</option> </select> </frame> <br><br> 文本域: <p> <!-- 属性:name(控件名)、cols(列数)、rows(行数) --> <textarea name="个性签名" cols="50" rows="10"></textarea> </p> 按钮: <p> <form> <!-- 属性:value(按钮名) --> <input type="submit" name="提交按钮" value="提交按钮"> <input type="reset" name="重置按钮" value="重置按钮"> <input type="button" name="普通按钮" value="普通按钮"> </form> </p> <!-- 在form外是普通按钮form内默认是提交 --> <!-- 可以添加属性type:submit、reset、button --> <p> <button> 普通按钮 </button> </p> 点击块: <form> <!-- 将文字和单选框之类的小按钮合并 点击文字也能选择 --> <label for="male">男</label> <input type="radio" name="gender" value="男" id="male"> <label for="female">女</label> <input type="radio" name="gender" value="女" id="female"> </form> </body> <!-- 文档的结束标记 --> </html>

优秀的个人博客,低调大师

Python全栈 Web(HTML基础语法)

超链接标签: 什么是超链接标签? 能够实现从当前文件跳转到其它文件的标签 语法: <a>超链接文本</a> 属性: href: 链接地址 #表示当前页面 可以为空“ ”也表示当前但是包含了网络请求 刷新页面的效果 本地文件协议: file:/// target:设置目标文件打开方式 _self:默认当前窗口打开 _blank:新建窗口打开 锚点链接: 链接到当前文件的指定位置 语法: 设置锚点 <a name="bottom"></a> 链接锚点 <a href="#bottom">跳转</a> 表格: 语法: 表格标签: <table> </table> 属性: border:设置边框(px) width:宽度 geight:高度 align:水平对齐对齐方式 cellpadding: 设置单元格内边距(内容与边框距离)(px) cellspacing: 设置单元格外边距(单元格与单元格、表格之间的距离)(px) bgcolor: 设置表格背景颜色 取值:英文的单向 行标签: <tr> </tr> (table row) 属性: bgcolor:设置当前行背景颜色 align:设置水平对齐方式 valign:设置垂直对齐方式 top:上 middle:中 bottom:下 单元格: <td> </td> (table data) 属性: width:单元格的宽度 height:单元格高度 align:水平对齐方式 valign:垂直对齐 bgcolor:背景颜色 创建顺序: 创建表格表标签 在表格标内嵌套行标签每个tr代表一行 在标签中创建单元格用来存放数据 <table> <tr> <td>name</td> <td>age</td> <td>score</td> <td>gander</td> </tr> </table> 单元格合并: 单元格独有的属性: colspan 跨 列合并: 从当前位置开始 横向合并n个单元(包含自身) 合并后要删除当行中多余的单元格 rowspan 跨 行合并: 从当前位置开始 纵向合并n个单元格(包含自身) 合并后要删除每列中多余的单元格 行分组: 允许将表格中若干行划分为一组 便于管理 这些标签可以省略 默认所有行都会添加到tbody中 如果需要手动添加分组, 建议thead --> tfoot --> tbody顺序书写 语法: 表头行分组: <thead> <tr></tr> </thead> 表尾行分组: <tfoot> <tr></tr> </tfoot> 主体行分组: <tbody> <tr> </tr> </tbody> 表单: 表单二要素: 1.form表单元素: 收集用户信息并发送给服务器 本身是不可见的 但是不能省略 因为数据的提交功能要由form元素完成 语法: <form>表单控件</form> 属性: action:用来指定数据提交的目的地址 method:数据请求方式 GET(默认)、POST... GET请求: 通常用于向服务器端获取数据 提交的数据会以参数的方式拼接在URL后面 安全性较低 提交的数据最大为 2KB POST: 将数据提交给服务器处理 隐式提交 看不到提交的数据 安全性较高 提交数据大小无限制 2.表单控件: 提供能够跟用户交互的可视化控件 只有放在表单元素中的表单控件才允许被提交 分类: 1). 文本框: 语法: <input type="text"> 密码框; 语法: <input type="password"> *属性: name: 定义当前控件的名称 缺省的话无法提交 value: 提交给服务器的值 同时也是默认显示在控件上的值 maxlength: 限时用户输入的最大字符数 placeholder: 用户输入之前显示在输入框中的提示文本 2). 单选框: <input type="radio"> 复选框: <input type="checkbox"> *属性: name: 定义控件名称,还起到分组的作用 一组的的按钮名称必须一致 value: 设置当前控件的值 最终提交给服务器 checked: 设置预选择状态 可以省略属性值或使用“checked” 3). 隐藏域: 需要用户提交给服务器却不需要呈现给用户 语法: <input type="hidden"> 属性: name:控件名称 value:控件值 文件选择框: 选择文件上传,发送给服务器 语法: <input type="file" 属性: name:定义控件名称 4). 下拉选择框: <select name="province"> <option value="山东省">山东省</option> <option values="山西省">山西省</option> </select> 使用 GET方式请求: URL后 拼接数据为 provide 5). 文本域: 语法: 支持用户输入多行文本 <textarea> </textarea> 属性: name:控件名 cols:指定文本域默认显示的列数 一行中文显示的英文量 减半 rows:文本域能够显示的函数 文本域可以由用户调整大小 6). 按钮: 提交按钮: <input type="submit"> 将表单数据发送给服务器 重置按钮: <input type="reset"> 重置表单 将表单内容初始化 普通按钮: <input type="button" value="点击"> 绑定自定义按钮事件 value:显示按钮的显示值 按钮标签: <button>按钮提示文本</button> 可以在任何局限中使用 不局限于form 按钮标签使用在 form中默认具有提交功能 --- input submit 可以添加属性type:submit、reset、button 在 表单外作为普通按钮需要通过js动态绑定事件实现 7). label for ID 将文字和单选框之类的小按钮合并 点击文字也能选择 语法: <label for="表单控件的ID"> </label> <input type="radio" name="gender" value="male" id="male">

优秀的个人博客,低调大师

[剑指offer] JAVA版题解(全)

序号 题解 牛客 OJ 数据结构类型 03 [剑指offer] 二维数组中的查找 二维数组中的查找 数组 04 [剑指offer] 替换空格 替换空格 字符串 05 [剑指offer] 从尾到头打印链表 从尾到头打印链表 链表 06 [剑指offer] 重建二叉树 重建二叉树 树 07 [剑指offer] 用两个栈实现队列 用两个栈实现队列 栈、队列 08 [剑指offer] 旋转数组的最小数字 旋转数组的最小数字 数组 09 [剑指offer] 斐波那契数列 斐波那契数列 数组 10 [剑指offer] 二进制中1的个数 二进制中1的个数 数组 11 [剑指offer] 数值的整数次方 数值的整数次方 数值 14 [剑指offer] 调整数组顺序使奇数位于偶数前面 调整数组顺序使奇数位于偶数前面 数组 15 [剑指offer] 链表中倒数第k个结点 链表中倒数第k个结点 链表 16 [剑指offer] 反转链表 反转链表 链表 17 [剑指offer] 合并两个排序的链表 合并两个排序的链表 链表 18 [剑指offer] 树的子结构 树的子结构 树 19 [剑指offer] 二叉树的镜像 二叉树的镜像 树 20 [剑指offer] 顺时针打印矩阵 顺时针打印矩阵 数组 21 [剑指offer] 包含min函数的栈 包含min函数的栈 栈 22 [剑指offer] 栈的压入、弹出序列 栈的压入、弹出序列 栈 23 [剑指offer] 从上往下打印二叉树 从上往下打印二叉树 树 24 [剑指offer] 二叉搜索树的后序遍历序列 二叉搜索树的后序遍历序列 树 25 [剑指offer] 二叉树中和为某一值的路径 二叉树中和为某一值的路径 树 26 [剑指offer] 复杂链表的复制 复杂链表的复制 链表 27 [剑指offer] 二叉搜索树与双向链表 二叉搜索树与双向链表 树、链表 28 [剑指offer] 字符串的排列 字符串的排列 字符串 29 [剑指offer] 数组中出现次数超过一半的数字 数组中出现次数超过一半的数字 数组 30 [剑指offer] 最小的K个数 最小的k个数 数组 31 [剑指offer] 连续子数组的最大和 连续子数组的最大和 数组 32 [剑指offer] 整数中1出现的次数(从1到n整数中1出现的次数) 从1到n整数中1出现的次数 数组 33 [剑指offer] 把数组排成最小的数 把数组排成最小的数 数组 34 [剑指offer] 丑数 丑数 数值 35 [剑指offer] 第一个只出现一次的字符 第一个只出现一次的字符 字符串 36 [剑指offer] 数组中的逆序对 数组中的逆序对 数组 37 [剑指offer] 两个链表的第一个公共结点 两个链表的第一个公共结点 链表 38 [剑指offer] 数字在排序数组中出现的次数 数字在排序数组中出现的次数 数组 39 [剑指offer] 二叉树的深度 二叉树的深度 树 40 [剑指offer] 数组中只出现一次的数字 数组中只出现一次的数字 数组 41 [剑指offer] 和为S的两个数字 VS [剑指offer] 和为S的连续正数序列 和为s的两个数字 VS 和为S的连续正数序列 数值 42 [剑指offer] 翻转单词顺序列 VS [剑指offer] 左旋转字符串 翻转单词顺序 VS 左旋转字符串 字符串 44 [剑指offer] 扑克牌顺子 扑克牌的顺子 数组 45 [剑指offer] 孩子们的游戏(圆圈中最后剩下的数) 圆圈中最后剩下的数字 数组 46 [剑指offer] 求1+2+3+…+n 求1+2+…+n 233 数值 47 [剑指offer] 不用加减乘除做加法 不用加减乘除做加法 数值 49 [剑指offer] 把字符串转换成整数 把字符串转换成整数 字符串 51 [剑指offer] 数组中重复的数字 数组中重复的数字 数组 52 [剑指offer] 构建乘积数组 构建乘积数组 数组 53 [剑指offer] 正则表达式匹配 正则表达式匹配 字符串 54 [剑指offer] 表示数值的字符串 表示数值的字符串 字符串 55 [剑指offer] 字符流中第一个不重复的字符 字符流中第一个不重复的字符 字符串 56 [剑指offer] 链表中环的入口结点 链表中环的入口结点 链表 57 [剑指offer] 删除链表中重复的结点 删除链表中重复的结点 链表 58 [剑指offer] 二叉树的下一个结点 二叉树的下一个结点 树 59 [剑指offer] 对称的二叉树 对称的二叉树 树 60 [剑指offer] 按之字形顺序打印二叉树 按之字形顺序打印二叉树 树 61 [剑指offer] 把二叉树打印成多行 把二叉树打印成多行 树 62 [剑指offer] 序列化二叉树 序列化二叉树 树 63 [剑指offer] 二叉搜索树的第k个结点 二叉搜索树的第k个结点 树 64 [剑指offer] 数据流中的中位数 数据流中的中位数 数值 65 [剑指offer] 滑动窗口的最大值 滑动窗口的最大值 数组 66 [剑指offer] 矩阵中的路径 矩阵中的路径 数组 67 [剑指offer] 机器人的运动范围 机器人的运动范围 数组 Array 数组题目汇总[18题] [剑指offer] 二维数组中的查找 [剑指offer] 旋转数组的最小数字 [剑指offer] 调整数组顺序使奇数位于偶数前面 [剑指offer] 顺时针打印矩阵 [剑指offer] 数组中出现次数超过一半的数字 [剑指offer] 最小的K个数 [剑指offer] 连续子数组的最大和 [剑指offer] 把数组排成最小的数 [剑指offer] 数组中的逆序对 [剑指offer] 数字在排序数组中出现的次数 [剑指offer] 数组中只出现一次的数字 [剑指offer] 扑克牌顺子 [剑指offer] 孩子们的游戏(圆圈中最后剩下的数) [剑指offer] 数组中重复的数字 [剑指offer] 构建乘积数组 [剑指offer] 滑动窗口的最大值 [剑指offer] 矩阵中的路径 [剑指offer] 机器人的运动范围 链表题目汇总[8题] [剑指offer] 从尾到头打印链表 [剑指offer] 反转链表 [剑指offer] 链表中倒数第k个结点 [剑指offer] 合并两个排序的链表 [剑指offer] 复杂链表的复制 [剑指offer] 删除链表中重复的结点 [剑指offer] 链表中环的入口结点 [剑指offer] 两个链表的第一个公共结点 更多关于链表面试题的总结,请移步[算法总结] 一文搞懂面试链表题 二叉树题目汇总[13题] [剑指offer] 重建二叉树 [剑指offer] 树的子结构 [剑指offer] 二叉树的镜像 [剑指offer] 从上往下打印二叉树 [剑指offer] 二叉搜索树的后序遍历序列 [剑指offer] 二叉树中和为某一值的路径 [剑指offer] 二叉树的深度 [剑指offer] 二叉树的下一个结点 [剑指offer] 对称的二叉树 [剑指offer] 按之字形顺序打印二叉树 [剑指offer] 把二叉树打印成多行 [剑指offer] 序列化二叉树 [剑指offer] 二叉搜索树的第k个结点 更多关于二叉树面试题的总结,请移步 [算法总结] 20 道题搞定 BAT 面试——二叉树 堆栈和队列题目汇总[3题] [剑指offer] 用两个栈实现队列 [剑指offer] 包含min函数的栈 [剑指offer] 栈的压入、弹出序列 更多关于堆栈和队列面试题的总结,请移步 [算法总结] 6 道题搞定 BAT 面试——堆栈和队列

优秀的个人博客,低调大师

Python全栈工程师 (exercises)

# 1:给定一个数,判断他是正数,负数,还是0 a = int(input("请输入一该个整数")) if a == 0: print(a, "是0") elif a > 0: print(a, "是正数") else: print(a, "是负数") # 练习2:输入一个季度的数字 输出该季度有那几个月 b = int(input("请输入一个季度:1.春季2.夏季3.秋季4.冬季")) if b > 4: print(b, "不是季节") elif b < 0: print(b, "不是季节") else: if b == 1: print(b, "春季有:一月,二月,三月") elif b == 2: print(b, "夏季有:四月,五月,六月") elif b == 3: print(b, "秋季有:七月,八月,九月") else: print(b, "冬季有:十月,十一月,十二月") # 联系3:输入一个月份 输出这个月份在那个季度 c = int(input("请输入一个月份判断在那个季度")) if c < 0: print(c, "不是月份") elif c > 12: print(c, "不是月份") elif c < 4: print(c, "在春季") elif c < 7: print(c, "在夏季") elif c < 10: print(c, "在秋季") elif c <= 12: print(c, "在冬季") # 练习4:3公里内10元 超出1.9元/公里 超过15公里 每公里加50%回空费 3.15元/公里 # 输入公里 打印车费 d = int(input("请输入行驶公里数:")) if d <= 3: print("车费:10元") elif d > 4: if d < 15: g = (d - 3) * 1.9 + 10 print(d, "公里:", g, "元") else: f = (d - 15) * 3.15 * 1.5 + 12 * 1.9 + 10 print(d, "公里:", f, "元") elif d < 0: print("公里数输入错误") 练习: 1. 一个商店卖西瓜,7元一个,您带20元钱能买到几个西瓜? 剩多少元? 2. 一个学生毕业薪资10000元,每个涨薪 20%,请问十年后这个学生的薪资是多少? 1. 打印如下图形: ******* * * * * ******* 2. 已知矩形的长边长为6cm,短边长为4cm,用表达式求 1) 周长是多少? 2) 面积是多少? 练习: 1. 指定一个圆的半径是r = 9cm 1) 计算圆的周长 2) 计算圆的面积 2. 交量交换练习: 已知有两个变量: a 绑定 10000 b 绑定 20000 问,在不创建任何新数据对象的情况下,如何让a 和 b 交换绑定的对象 a = 10000 b = 20000 .... print(a) # 20000 print(b) # 10000 练习: 1. 中国古代的秤是16两一斤,请问古代对216两是古代的几斤几两,写程序打印出来? 2. 从凌晨 0:0:0 计时,到现在已经过了63320秒, 请问现在是几时,几分,几秒,写程序打印出来 提示: 可以用地板除和求余实现 3. 温度转换: 摄氏温度 = 5.0/9.0*(华氏温度-32) 请问100华氏温度是多少摄氏温度.写程序算出来 思考: 如果知道当前温度是摄氏温度度,能否算出华氏温度是多少? 练习: 将数字3.14 用变量pi绑定 将pi变量转为整数,用变量i绑定 将 pi 变量 与 i变量相减,结果用f变量绑定 1. 判断f是否等于 0.14? 为什么? 2. 删除所有的变量 (用交互模式来实现) 练习: 1. 输入两个整数, 分别用变量x, y绑定 1) 计算这两个数的和,并打印结果 2) 计算这两个数的积,并打印结果 3) 计算x的y次方并打印结果 如: 请输入x: 10 请输入y: 20 打印如下: 10 + 20 = 30 10 * 20 = 200 10 ** 20 = ... 2. 今天是小明20周岁的生日,假设每年有365天,计算它过了多少个星期天,余多少天 3. 分三次输入当前的小时,分钟和秒数,在终端打印时此距离凌晨0:0:0 秒过了多少秒 练习: 任意输入一个数 1) 判断这个数是否大于100 2) 判断这个数是否小于0 3)判断这个数是否在80~100之间 练习: 1. 输入一个季度 1~4的整数.输出这个季度有哪儿几个月,如果输入的不是1~4的整数,则提示用户您输错了 2. 输入一年中的月份(1~12) 输出这个月在哪儿个季度,如果输入的是其它数,则提示您输错了 思考: score = input('请输入学生成绩:') or '0' score = int(score) 请问这个or是在做什么? 练习: 1. 北京出租车计价: 收费标准: 3公里以内收费13元 基本单价: 2.3元/公里 (超出3公里以外) 空驶费:超过15公里后,每公里加收单价的50%的空驶费(即3.45元/公里) 要求: 输入公里数,打印出费用金额(以元为单位四舍五入) 2. 输入一个学生的三科成绩(三个整数): 打印出最高分是多少? 打印出最低分是多少? 打印出平均分是多少? 3. BMI指数(Body Mass Index) 以称身体质量指数 BMI值计算公式: BMI = 体重(公斤) / 身高的平方(米) 例如: 一个人69公斤,身高是173公分 BMI = 69 / 1.73**2 = 23.05 标准表: BMI < 18.5 体重过轻 18.5 <= BMI < 24 体重正常 BMI > 24 体重过重 要求: 输入身高的体重,打印出BMI的值并打印体重状况 思考: 如果一个字符串同时包含如下字符该怎么办? ' " ''' """ 练习: 试求出以下字符串含有多少个字符? '1234abcd' # 8 '5\'4"' # 4 '\"A\x34\U00006041' # 4 '\b\n\td\r' '\\nn\\x41' 练习: 写一个程序,打印一个高度为4行的矩形方框 要求输入一个整形数字,此整数代表矩形的宽度,输出此矩形 如: 请输入矩形宽度: 10 ########## # # # # ########## 请输入矩形宽度: 5 ##### # # # # ##### 练习: 输入一个字符串,打印如下内容: 1. 打印这个字符串的第一个字符 2. 打印这个字符串的最后一个字符 3. 如果这个字符串的长度是奇数,打印中间这个字符 注: 求字符串的长度的函数len(s) 练习: 1. 写一个程序,输入一个字符串,把字符串的第一个字符和最后一个字符去掉后,打印出处理后的字符串 2. 输入任意一个字符串,判断这个字符串是否是回文 回文示例: 上海自来水来自海上 ABCCBA 12321 (回文是指中心对称的文字) 练习: 1. 写一个程序,输入一段字符串,如果字符串不为空,把第一个字符的编码值打印出来 2. 写一个程序,输入一个整数值(0~65535), 打印出这个数值所对应的字符 练习: 1. 输入一个字符串用变量s绑定 1) 判断您输入的字符串有几个空格 2) 将原字符串的左右空白字符去掉, 打印出剩余的字符个数 3)判断您输入的是否是数字 4) 如果是数字,判断这个数字是否大于100 2. 输入三行文字,让这三行文字在一个方框内居中显示 如输入: hello! I'm studing python! I like python 显示如下 +---------------------+ | hello! | | I'm studing python! | | I like python | +---------------------+ 注:请不要输入中文 练习: 输入三行文字,让这三行文字依次以20个字符的宽度右对齐输出 如: 请输入第1行: hello world 请输入第2行: aaa 请输入第3行: ABCDEFG 输出结果如下: hello world aaa ABCDEFG 做完上面的题后思考: 能否以最长的字符串的长度进行右对齐显示(左侧填充空格) 问题: 输入一个整数n, 写程序打印如下: 这是第 1 行 这是第 2 行 这是第 3 行 ... 这是第 n 行 问题: 如何让一条语句重复执行多次? 用: print("这是第", i, '行') 能否实现 练习: 1. 输入一行字符串,将字符串中Unicode编码值最大的一个字符打印出来(不允许用max函数) (提示: while语句内可以嵌入 if 语句进行判断) 2. 打印 从零开始的浮点数,每个数增加 0.5, 打印出10以内的这样的数: 0.0 0.5 1.0 1.5 ... 9.5 练习: 1. 打印 1 ~ 20的整数 2. 打印从10开始 到 0(不包含0)之间的整数 3. 打印 1 ~ 20的整数,打印在一行内 4. 打印 1 ~ 20的整数,每行打印5个,打印四行如: 1 2 3 4 5 6 7 8 9 10 11 12 ..... ..... 提示: while中可以嵌入if语句来换行 5. 输入一个整数n, 打印出一个长方形 n 代表长方形的宽度的字符数和高的行数 例如: 请输入:4 打印: #### # # # # #### 请输入:6 打印: ###### # # # # # # # # ###### 练习: 输入一个数,打印指定宽度的正方形 如: 输入: 5 打印如下正方形: 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 如: 输入: 3 打印如下正方形: 1 2 3 1 2 3 1 2 3 练习: 1. 写程序,计算: 1 + 2 + 3 + 4 + ..... + 99 + 100的和 2. 写程序,任意输入一个数n,计算: 1 + 2 + 3 + 4 + ..... + (n-1) + n的和 问题: 如果在循环过程中不想再继续此循环语句的执行了,怎么办? 练习: 1. 任意输入一些数,当输入负数时结束输入 当输入完成后,打印您输入的这些数的和是多少? 2. 写程序求: Sn = 1 + 1/2 + 1/4 + 1/8 + .... + 1/(2**n) 求当n等同于100时,sn的值是多少? 3. 用while语句实现打印三角形,输入一个整数,表示三角形的宽度和高度,打印出相应的直角三角形: 如: 请输入三角形的宽度: 4 1) 打印如下: * ** *** **** 2) 打印如下: * ** *** **** 3) 打印如下: **** *** ** * 4) 打印如下: **** *** ** * 练习: 任意输入一段字符串 1) 计算您输入的字符'A' 的个数,并打印出来 2) 计算出空格的个数,并打印出来 (要求用for语句,不允许使用, S.count方法) 思考用while语句能否实现上述功能 练习: 用for 语句打印1~20 打印在一行内 练习: 求 100以内有哪儿些整数与自身+1的乘积再对11求余的结果等于8? x * (x+1) % 11 == 8 x附合条件 1. 写程序计算 1 + 3 + 5 + 7 + ...+ 99的和 (要求用for语句和while语句两种方式实现) 2. 用while语句实现打印: 1 3 5 7 9. .... 19 打印在一行内 3. 将上题用for语句来实现 练习: 用for 语句实现下题 : 1. 输入一个数w代表正方形的宽度,打印如下正方形: 如输入:5 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 1 2 3 4 5 2. 写程序来改写上题: 如输入: 5 打印如下: 1 2 3 4 5 2 3 4 5 6 3 4 5 6 7 4 5 6 7 8 5 6 7 8 9 如输入: 3 打印如下: 1 2 3 2 3 4 3 4 5 练习: 1. 输入一个整数用begin绑定, 再输入一个整数用end绑定 打印从begin开始,到end结束内的全部奇数(不包含end) 2. 将上述练习改写为 用while语句实现 3. 求 1~100 之间所有不被 5, 7, 11 整除的数的和 (可以考虑用continue实现) 练习: 1 输入三行文字,将这三行文字, 保存于一个列表L中,并打印 如: 请输入: abc<回车> 请输入: 123<回车> 请输入: 你好<回车> 生成列表如下: L = ['abc', '123', '你好'] print(L) 打印 练习: 1. 输入任意行文字,存于列表L中,当不输入任何内容直接回车后结束输入 1) 打印L列表中的内容 2) 计算您共输入了几行内容 3) 计算您共输入了多少个字符 2. 输入一个整数(代表树干的高度) 打印出如下一棵树 输入: 2 打印: * *** * * 输入:3 * *** ***** * * * 3. 写一个程序,任意输入一个整数,判断这个数是否是素数(prime) 素数(也叫质数), 是只能被1和自身整除的正整数: 如: 2 3 5 7 11 等 提示: 用排除法: 当判断x是否是素数是,只要让x分别除以: 2, 3, 4, 5, .... x-1, 只要整除了,那x不是素数,否则x是素数 4.算出100~1000以内的水仙化数(Naricissistic Number) 水仙花数是指百位的3次方 加上 十位的3次方 加上 个位的3次方等于原数的数 如: 153 = 1**3 + 5**3 + 3**3 答案: 153, 370, .... 练习: 已知有列表: L = [3, 5] 1) 用索引和切片等操作,将原列表改变为: L = [1, 2, 3, 4, 5, 6] 2) 将列表反转,删除最后一个元素后打印此列表 ... print(L) # [6, 5, 4, 3, 2] 练习: 1. 写程序,让用户输入一些整数,当输入-1时结束输入,将这些数存于列表L中 1) 打印用户共输入了几个数? 2) 打印您输入的数的最大数是多少 3) 打印您输入的数的最小数是多少 4) 打印您输入的这些数的平均值是多少? 练习: 输入多行文字,存入列表中, 每次输入回车后算一行 任意输入多行,当输入回车(即输入空行时结束输入) 1) 按原输入内容在屏幕上输出内容 2) 打印出您共输入了多少行文字 3) 打印出您共输入了多少个字符 练习: 1. 有字符串"hello" 请用此字符串生成: 'h e l l o' 和 'h-e-l-l-o' 答案: s = "hello" a = ' '.join(s) # a = 'h e l l o' b = '-'.join(s) # b = 'h-e-l-l-o' 2. 写一个程序,让用户输入很多正整数,当输入小于零的数时结束输入, 1) 打印这些数中最大的一个数 2) 打印这些数中第二大的一个数 3) 删除最小的一个数 4) 打印剩余数的和 练习: 用列表推导式生成1~100内奇数的列表 结果是: [1, 3, 5, 7, ..... 99] L = [x for x in range(1, 100, 2)] 示例: 生成1~00内的奇数的列表: L = [x for x in range(1, 100) if x % 2 == 1] 练习: 生成一个数值为 1 ~ 9的平方的列表,去掉所有的奇数的平方 L = [x**2 for x in range(1, 10)] # L = [4, 16, 36, 64] 练习: 1. 已知有一个字符串 s = '100,200,300,500,800' 将其转化为整数的列表存于L列表中 L = [100, 200, 300, 500, 800] 2. 生成前40个斐波那契数(Fibonacci) 1 1 2 3 5 8 13 ..... 要求将这些数保存在列表中 打印这些数 3. 有一些数存于列表中: L = [1, 3, 2, 1, 6, 4, 2, ..... 98, 82] 将列表中出现的数字存入到另一个列表L2中 要求: 重复出现多次的数字在L2列表中只保留一份(去重) 写程序,实现以下要求: 1) 将如下数据形成一个字典seasons: '键' '值' 1 '春季有1, 2, 3月' 2 '夏季有4, 5, 6月' 3 '秋季有7, 8, 9月' 4 '冬季有10,11,12月' 2) 让用户输入一个整数,代表一个季度,打印这个季度对应的信息,如果用户输入的信息不在字典内,则打印信息不存在 练习: 输入一段字符串,打印出这个字符串中出现过的字符的出现次数 如: 输入: abcdabcaba 打印: a: 4次 b: 3次 d: 1次 c: 2次 注: 不要求打印的顺序 练习: 有字符串的列表如下: L = ['tarena', 'xiaozhang', 'tyke'] 用上述列表生成如下字典: d = {'tarena': 6, 'xiaozhang': 9, 'tyke':4} 注: 字典的值为键的长度 练习: 1. 已知有两个等长的列表 list1 和 list2 以list1中的元素为键,以list2中的元素为值,生成相应的字典 list1 = [1001, 1002, 1003, 1004] list2 = ['Tom', 'Jerry', 'Spike', 'Tyke'] 生成的字典为: {1001: 'Tom', 1002:'Jerry', .....} 2. 输入任意个学生的姓名,年龄,成绩,每个学生的信息存入字典中,然后放入至列表中,每个学生的信息需要手动输入 当输入姓名为空时结束输入: 如: 请输入姓名: xiaozhang 请输入年龄: 20 请输入成绩: 100 请输入姓名: xiaoli 请输入年龄: 18 请输入成绩: 98 请输入姓名: <回车> 结束输入 要求内部存储格式如下: [{'name':'xiaozhang', 'age':20, 'score':100}, {'name':'xiaoli', 'age':18, 'score':98}] 打印所有学生的信息如下: +---------------+----------+----------+ | name | age | score | +---------------+----------+----------+ | xiaozhang | 20 | 100 | | xiaoli | 18 | 98 | +---------------+----------+----------+ 集合练习: 经理有: 曹操,刘备,孙权 技术员有: 曹操,孙权,张飞,关羽 用集合求: 1) 即是经理,也是技术员的有谁? 2) 是经理,但不是技术员的人员都有谁? 3) 是技术员,不是经理的都有谁 4) 张飞是经理吗? 5) 身兼一职的人都有谁? 6) 经理和技术员共有几个人? 练习: 任意输入一些数字,存于列表L中。当输入负数时结束输入 1) 打印这些数的和 2) 打印这些数有多少种(去重) 3) 除重复的数字后,打印这些剩余数字的和 提示,可以用集合去重 练习: 1. 写一个函数myadd, 此函数中的参数列表里有两个参数x, y 此函数的功能是打印 x + y 的和 def myadd(....): .... # 注: .... 部是是我们要填写代码的地方 myadd(100, 200) # 300 print("ABC", "123") # ABC123 2. 写一个函数 mysum, 传入一个参数x代表终止整数, 打印出 1 + 2 + 3 + 4 + ..... + x的和 def mysum(x): .... mysum(100) # 5050 mysum(4) # 10 return 语句 语法: return [表达式] 注: [] 代表可省略 作用: 用于函数中,结束当前函数的执行,返回到调用该函数的地方,同时返回一个对象的引用关系 return 语句说明 1. return 语句后跟的表达式可以省略,省略后相 当于return None 2. 如果函数内没有return 语句,则函数执行完最后一条语句后返回None(相当于在最后加了一条return None语句) 示例见: return.py 练习: 1. 写一个函数 mymax, 给函数传递两个参数,返回两个实参中最大的一个 def mymax(a, b): .... v = mymax(100, 200) print('v =', v) # v = 200 print(mymax('ABC', 'abc')) # abc 2. 写一个函数 input_number def input_number(): .... 此函数用来获取用户循环输入的整数,当用户输入负数时结束输入。将用户输入的数字以列表的形式返回,再用内建函数max, min, sum取出户输入的最大值,最小值及和 L = input_number() print(L) # 打印此列表 print("用户输入的最大数是:", max(L)) print("用户输入的最小数是:", min(L)) print("用户输入的数的和是:", sum(L)) 练习: 1. 写一个函数 print_odd, 打印从begin开始,到end结束(不包含end)内的全部的奇数 def print_odd(begin, end): .... print_odd(1, 10) # 打印 1 3 5 7 9d ptint_odd(10, 20) # 打印 11 13 15 17 19 2. 定义两个函数: sum3(a, b, c) 用于返回三个数的和 pow3(x) 用于返回x的三次方 用以上函数计算: 1. 计算1的立方 + 2的立方 + 3的立方的和 即: 1**3 + 2**3 + 3**3的和 2. 计算1 + 2 + 3 的和的立方, 即:(1+2+3)**3 3. 改写之前的学生信息管理程序 改为两个函数: 1. 写一个函数 input_student() 用于返回学生信息的字典的列表(以前格式一样) 2. 写一个函数 output_student(lst) 此函数传入一个列表lst,即字典的列表 此函数把lst的内容以表格形式打印出来 def input_student(): .... def output_student(lst): ... L = input_student() # 获取学生信息的列表 output_student(L) # 把L 以列表的形式打印 练习: 写一个函数minmax(a, b, c) 有三个参数,这回这三个参数中的最小值和最大值, 要求,形成元组,最小值在前,最大值在后,如: def minmax(a, b, c): ... t = minmax(11, 33, 22) print(t) # (11, 33) # <<< 打印元组 xiao, da = minmax(6, 5, 4) print('最小值:', xiao, '最大值:', da) 练习: 写一个函数 myadd, 此函数可以计算两个数的和,也可以计算三个数的和 def myadd(......): .... print(myadd(10, 20)) # 30 print(myadd(100, 200, 300)) # 600 2. 写一个函数,print_odd, 此函数可以传递一个实参,也可以传递两个实参,当传递一个实参时代表结束值 当传递两个实参时,第一个实参代表起始值,第二个实参代表结束值 打印出以此区间内的全部奇数,不包含结束数: print_odd(10) # 1 3 5 7 9 print_odd(11, 20) # 11 13 15 17 19 练习: 写一个函数, mysum可以传入任意个实参的数字,返回所有实参的和 def mysum(*args): ... print(mysum(1, 2, 3, 4)) # 10 print(mysum(10, 20, 30)) # 60 练习: 写一个函数,mymax类似于 内键的函数max 详见: >>> help(max) 仿造 max 写一信mymax函数,功能与max完全相同 (要求不允许调用max函数) print(mymax([6, 8, 3, 5])) # 8 print(mymax(100, 200)) # 200 print(mymax(1, 3, 5, 9, 7)) # 9 思考题: 查看 >>>help(print)猜想print函烽的参数列表 是如何定义的? 练习: 创建一个全局变量 L = [] 写一个函数: def input_number(): .... 此函数每次调用将从键盘读入一些数字追加到列表L中 如: L = [] def input_number(): .... input_number() print(L) # [ .... 这些是您从键盘输入的数..] 练习: 1. 写一个函数isprime(x) 判断x是否为素数。如果是素数,返回True,否则返回False 2. 写一个函数prime_m2n(m, n) 返回从m开始,到n结束(不包含n)范围内的素数,返回这些素数的列表并打印 如: L = prime_m2n(5, 10) print(L) [5, 7] 3. 写一个函数pimes(n) 返回小于n的全部素数的列表,并打印这些素数 如: L = primes(10) print(L) # [2, 3, 5, 7] 1) 打印100 以内的全部素数 2) 打印200 以内的全部素数的和 4. 编写函数 fn(n) 此函数返回下列级数的和: fn(n) = 1/(1*2) + 1/(2*3) + .... + 1/(n*(n-1)) 的和 print(fn(100)) 练习: 写一个计算公式的解释执行器 已知有如下一些函数: def myadd(x, y): return x + y def mysub(x, y): return x - y def mymul(x, y): return x * y 写一个函数,传入字符串,返回相应的函数 def get_op(s): # 此函数根据字符串来返回相应的函数. # 如果传入字符串"加" 则返回myadd函数 # .... '乘',则返回mymul函数 ... 此处自己实现 主程序如下: while True: s = input("请输入计算公式: ")# 10 加 20 L = s.split() a = int(L[0]) b = int(L[2]) fn = get_op(L[1]) print("结果是:", fn(a, b)) # 30 练习: 写一个函数叫hello(name),部分代码如下: count = 0 def hello(name): print('你好', name) ... 此处代码省略,需要同学们自己填写 ... 此处代码需要改变全局变量来记录此函数曾经被调用过多少次. hello('小张') hello('小李') print('hello 函数被调用', count, '次') # 2次 练习: 1. 写一个lambda 表达式,判断这个数的2次方+1是否能被5整除,如果能被整除返回True, 否则返回False 例: fa = lambda x: ..... print(fa(2)) # True print(fa(4)) # False 2. 写一个lambda表达式,求两个变量的最大值 例如: def mymax(x, y): ... mymax = lambda ... print(mymax(100, 200)) # 200 练习: 1. 给出一个整数n,写一个函数myfac来计算n!(n的阶乘) n! = 1 * 2 * 3 * 4 * ..... * n 如: print(myfac(5)) # 120 2. 给出一个整数n,写一个函数计算myfn(n): 1 + 2**2 + 3**3 + .... + n**n的和 如: print(myfn(10)) # ??? 3. 完全数: 1 + 2 + 3 = 6 (6为完全数) 1,2,3都为6的因数(因数是能被一个数x整除的整数为y,则y为x的因数) 1 x 6 = 6 2 x 3 = 6 完全数是指除自身以外的所有因数相加之和等于自身的数 求 4~5个完全数并打印出来 答案: 6 28 496 ...... 4 实现带有界面的学生信息管理系统 程序启动时先弹出操作菜单: +-------------------------+ | 1) 添加学生信息 | | 2) 显示学生信息 | | 3) 删除学生信息 | | 4) 修改学生成绩 | | q) 退出 | +-------------------------+ 请选择: 1 要求 : 每个选择都要有一个函数来实现 练习: 1. 用map函数求: 1**3 + 2**3 + 3 ** 3 + .... 9**3 的和 2. 用map函数求: 1**4 + 2**4 + 3 ** 4 + .... 20**4 的和 提示: sum(map(.....)) 练习: 1. 将 1 ~ 20 的偶数用filter生成可迭代对象后将可迭代对象生成的数放入到列表L中 2. 写一个函数is_prime(x) 判断x是否是素数 用filter函数打印出: 20 ~ 30之间的全部素数 练习: names = ['Tom', 'Jerry', 'Spike', 'Tyke'] 排序的依据为字符串的反序: 'moT' yrreJ ekipS ekyT 结果: ['Spike', 'Tyke', 'Tom', 'Jerry'] 练习: 写函数 mysum(n)用递归方式实现求和 def mysum(n): # 用递归方式求和 ... print(mysum(100)) # 5050 思考题: 已知五位朋友在一起 第五位朋友比第四位朋友大2岁 第四位朋友比第三位朋友大2岁 第三位朋友比第二位朋友大2岁 第二位朋友比第一位朋友大2岁 第一位朋友说它10岁 练习: 1. 已知五位朋友在一起 第五位朋友比第四位朋友大2岁 第四位朋友比第三位朋友大2岁 第三位朋友比第二位朋友大2岁 第二位朋友比第一位朋友大2岁 第一位朋友说它10岁 写程序打印出第五位朋友 和第三位朋友 的年龄 2. 已知有列表: L = [[3, 5, 8], 10, [[13, 14], 15, 18], 20] 1) 写一个函数print_list(lst) 打印出所有元素 print(L) # 打印 3 5 8 10 13 14 .... 2) 写一个函数sum_list(lst) 返回这个列表中所有元素的和 print(sum_list(L)) # 86 注: type(x) 可以返回一个变量的类型 如: >>> type(20) is int # True >>> type([1, 2, 3]) is list # True 3. 改写之前的学生信息管理程序 要求添加四个功能: | 5) 按学生成绩高-低显示学生信息 | | 6) 按学生成绩低-高显示学生信息 | | 7) 按学生年龄高-低显示学生信息 | | 8) 按学生年龄低-高显示学生信息 | 练习: 1. 输入一个圆的半径,打印出这个圆的面积 2. 输入一个圆的面积,打印出这个圆的半径 (要求用math模块内的函数和数据实现) 练习: 写一个程序,输入你的出生日期, 1) 算出你已经出生多少天? 2) 算出你出生的那天是星期几? 练习: 1. 请编写函数fun 其功能是计算下列多项式的和: fn = 1 + 1/1! + 1/2! + 1/3! + 1/4! + .. + 1/n! (建义用数学模块的factorial实现) 求当n 等于100时,fn的值 看一下fn(100)的值是什么 2. 写一个程序,以电子时钟格式: HH:MM:SS格式显示时间 要求每隔一秒变化一次 3 写函数f(n)求下多项式的和 fn = 1/1 - 1/3 + 1/5 - 1/7 + 1/9 .... 1/(2*n-1)的和 求当n取值为1000000时, 1) 打印 f(1000000) 的值 2) 打印 f(1000000) * 4的值,看看是什么 练习: 1. 猜数字游戏 随机生成一个 0~100之间的一个整数,用变量x绑定 让用户输入一个数y,输出猜数字的结果: 1) 如果y大于x则提示: "您猜大了" 2) 如果y小于x则提示: "您猜小了" 3) 如果y等于生成的数x,则提供示用户"恭喜您猜对了 "并退出猜数字 循环重复上述步聚,直到猜对为止。 猜对了,显示用户猜数字的次数,然后退出程序 练习: 1. 写一个闹钟程序,启动时设置定时时间, 到时间后打印一句"时间到...." 然后退出程序 2. 模拟斗地主发牌,扑克牌共54张 黑桃('\u2660'), 梅花('\u2663'), 方块('\u2665'), 红桃('\u2666') A2-10JQK 大王、小王 三个人玩,每人发17张牌,底牌留三张 输入回车, 打印出第1个人的17张牌 输入回车, 打印出第2个人的17张牌 输入回车, 打印出第3个人的17张牌 输入回车, 打印三张底牌 3. 修改学生信息管理程序,将原student_info.py 拆分为模块 要求: 1. 主事件循环放在main.py中 2. show_menu 函数放在menu.py中 3. 与学生操作相关的函数放在 student_info.py中 练习: 写一个函数 get_score() 来获取学生成绩, 要求用户输入 1~100的整数,输果输入出现异常,返此函数返回0, 否则返回用户输入的成绩 示例: def get_score(): ... score = get_score() print("学生的成绩是:", score) python中全部的错误类型: 参见文档: python_base_docs_html/Python全部的异常类型.html 练习: 写一个函数 get_age()用来获取一个人的年龄信息 此函数规定用户只能输入1~140之间的整数,如果用户输入其它的数则直接触发ValueError类型的错误通知 如果用户输入的年龄大于140,则触发 ValueError("年龄超出了正常值") 如果用户输入的年龄小于1,则触发 ValueError("年龄太小...") def get_age(): ... try: age = get_age() print("用户输入的年龄是:", age) except ValueError as err: print('用户输入的不是1~140的整数,获取年龄失败') print("原因是:", err) 练习: 1. 一个球从100米高空落下,每次落地后反弹高度是原高度的一半,再落下, 1) 写程序算出皮球在第10次落地后反弹高度是多高? 2) 打印出球共经过多少米的路程 2. 分解质因数, 输入一个正整数,分解质因数, 如: 输入: 90 则打印: '90=2*3*3*5' (质因数是指最小能被原数整除的素数(不包括1)) 3. 修改原学生信息管理程序,加入异常处理语句,让程序在任何情况下都能够按逻辑正常执行. 例如: 输入成绩和年龄时,如果用户输入非法字符串也不会导致程序崩溃 练习: 有一个集合: s = {'唐僧', '悟空', '八戒', '沙僧'} 用 for语句来遍历所有元素如下: for x in s: print(x) else: print('遍历结束') 请将上面的for语句改写为 用while语句和迭代器实现 练习: 写一个生成器函数 myeven(start, stop) 此函数用来生成从 start开始到stop结束(不包含)区间内的一系列偶数 def myeven(start, stop): .... evens = list(myeven(10, 20)) print(evens) # [10, 12, 14, 16, 18] for x in myeven(21, 30): print(x) # 22, 24, 26, 28 L = [x**2 for x in myeven(3, 10)] print(L) # 16 36 64 练习: 已知有一个列表L L = [2, 3, 5, 7] 用生成器表达式从此列表中拿到数,生成 列表中数据的平方 gen = ...... # 此处用生成器表达式实现 L2 = list(gen) # L2 = [4, 9, 25, 49] 思考: L = [2, 3, 5, 7] L2 = [x ** 2 for x in L] # 列表推导式 it = iter(L2) print(next(it)) # 4 L[1] = 10 print(next(it)) # 9 L = [2, 3, 5, 7] G3 = (x ** 2 for x in L) # 生成器表达式 it = iter(G3) print(next(it)) # 4 L[1] = 10 print(next(it)) # 100 练习: 写一个程序,读入任意行的文字,当输入空行时结束输入 打印带有行号的输入结果: 如: 请输入: hello<回车> 请输入: world<回车> 请输入: tarena<回车> 请输入: <回车> # 直接回车结束输入 输出如下: 第1行: hello 第2行: world 第3行: tarena 练习: 写一个程序,从键盘输入一段字符串存入s变量 1. 将此字符串转为字节串用变量b绑定,并打印出b 2. 打印字符串s的长度和字节串b的长度 3. 将b字节串再转换为字符串用变量s2 绑定,判断 s2 和 s是否相同? 练习: 1. 写一个生成器函数primes生成素数, 此生成器函数为 primes(begin, end) 如: [x for x in primes(10, 20)] 将得到列表 [11, 13, 17, 19] 2. 写一个生成器函数,生成斐波那契数列的前n个数 1 1 2 3 5 8 13 def fibonacci(n): ... yield... 1) 输出前20个数: for x in fibonacci(20): print(x) 2) 打印前40个数的和: print(sum(fibonacci(40))) 3. 写程序打印杨辉三角(只打印6层) 1 1 1 1 2 1 1 3 3 1 1 4 6 4 1 1 5 10 10 5 1 练习: 自己写一个文件 'info.txt' 内部存一些文字信息 如: 张三 20 100 李四 21 96 小王 22 98 写程序将这些数据读取出来,打印到终端上 练习: 1. 写程序,循环输入很多个人的姓名,电话号码, 当输入结束后将这些信息存入到文件phonenumber.txt中 (建议先用列表暂存数据,格式自己定义) 2. 写程序,将phonenumber.txt文件中的数据读取出来. 再用以下格式打印出来: 如: 小张 的电话是 13888888888 小李 的电话是 13999999999 练习: 1. 写程序实现复制文件的功能 要求: 1. 要考虑特大文件问题 2. 要关闭文件 3. 要能复制二进制文件 如: 请输入源文件路径名: /home/tarena/xxx.tar.gz 请输入目标文件路径名: ./a.tar.gz 显示: 文件已成功复制 2. 修改学生信息管理程序,要求加入两个功能: 9) 保存信息到文件(si.txt) 10) 从文件中读取数据(si.txt) 练习: 自己写一个'人'类: Human class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' ... # << 此处自己实现 def show_info(self): '''显示此人的全部信息''' ... # 此处自己实现 如: h1 = Human() h1.set_info('小张', 20, '北京市朝阳区') h2 = Human() h2.set_info('小李', 18) h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 h2.show_info() # 小李今年 18 岁,家庭住址:末知 练习: 写一个Student类 1) 为该类添加初始化方法, 实现在创建对象时自动设置 '姓名','年龄', '成绩' 属性 2) 添加set_score方法能修改成绩信息 3) 添加show_info方法打印学生对象的信息 如: class Student: def __init__(...): ... ... s1 = Student('小王', 15, 59) s1.show_info() # 小王 今年 17 岁, 成绩是: 59 s1.set_score(80) s1.show_info() # 小王 今年 17 岁, 成绩是: 80 面向对向的综合示例: 有两个人(Human): 1. 姓名: 张三 年龄: 35 2. 姓名: 李四 年龄: 8 行为: 1. 教别人学东西 teach 2. 赚钱 works 3. 借钱 borrow 事情: 张三 教 李四 学 python 李四 教 张三 学 跳皮筋 张三 上班赚了 1000 元钱 李四 向 张三 借了 200 元钱 打印张三的信息: 35岁 的 张三 有钱 800元, 它学会跳皮筋 打印李四的信息: 8岁 的 李四 有钱 200元, 它学会python 练习: 修改原来的学生信息管理程序,将原来字典来存储学生信息, 现改为用对象来存储学生信息 # file : student.py class Student: def __init__(self, n, a, s): .... L = [] # L.append({...}) 改为对象 L.append(Student('xiaozhang', 20, 100)) (要求类Student 要写在模块 student.py中) 练习: 用类来描述一个学生的信息(可以修改之前写的Student类) class Student: .... 此处自己实现 学生信息有: 姓名, 年龄, 成绩 将一些学生的对象存于列表中,可以任意添加和删除学生信息 1) 打印出学生的个数 2) 打印出所有学生的平均成绩 3) 打印出所有学生的平均年龄 思考: list类里只有一个append向末尾加一个元素的方法,但没有向列表头部添加元素的方法,试想能否为列表在不改变原有类的基础上添加一个insert_head(n) 方法,实现在列表的头部(前部)添加元素 如: class MyList(list): def insert_head(self, n): ... # 需要自己添加代表 myl = MyList(range(3, 6)) print(myl) # [3, 4, 5] myl.insert_head(2) print(myl) # [2, 3, 4, 5] myl.append(6) print(myl) # [2, 3, 4, 5, 6] 练习: 1. 看懂学生管理程序,每一步做的事情及思想 2. 把同学们自己的学生信息管理程序用Student学生对象来存储信息;要求,不要在外部直接操作学生的属性,所有操作行为用方法来代替 练习: 写一个类Bicycle类 ,有 run方法.调用时显示骑行里程km class Bicycle: def run(self, km): print('自行车骑行了', km, '公里') 再写一个类EBicycle(电动自行车类), 在Bicycle类的基础上添加了电池电量 volume 属性, 有两个方法: 1. fill_charge(self, vol) 用来充电, vol为电量 2. run(self, km) 方法每骑行10km消耗电量1度,同时显示当前电量,当电量耗尽时调用 父类的run方法继续骑行 b = EBicycle(5) # 新买的电动有内有5度电 b.run(10) # 电动骑行了10km还剩 4 度电 b.run(100) #电动骑行了40km,还剩0度电,其余60用脚登骑行 b.fill_charge(10) # 又充了10度电 b.run(50) # 骑行了50公里剩5度电 练习: 1. 修改原有的学生信息管理系统, 将学生对象的,全部属性 都变为私有属性,不让外部直接访问来实现封装 2. 写一个列表类MyList实现存储整数列表,写类的定义如下: class MyList: def __init__(self, iterator): self.data = ... 让此类的对象能用for语句进行迭代访问 L = MyList(range(5)) print(L) L2 = [x ** 2 for x in L] print(L2) # [0, 1, 4, 9, 16] 3. 写一个类Fibonacci 实现迭代器协议 ,此类的对象可以作为可迭代对象生成相应的斐波那契数 1 1 2 3 5 class Fibonacci: def __init__(self, n) # n代表数据的个数 ... ... 实现如下操作: for x in Fibonacci(10): print(x) # 1 1 3 5 8 .... L = [x for x in Fibonacii(50)] print(L) F = fibonicci(30) print(sum(F)) 练习: 1. 实现两个自定义的列表相加 class MyList: .... 此处自己实现 L1 = MyList([1, 2, 3]) L2 = MyList(range(4, 7)) L3 = L1 + L2 print(L3) # MyList([1, 2, 3, 4, 5, 6]) L4 = L2 + L1 print(L4) # MyList([4, 5, 6, 1, 2, 3]) L5 = L1 * 2 print(L5) # MyList([1, 2, 3, 1, 2, 3]) 练习: 实现有序集合类 OrderSet() 能实现两个集合的交集 &,全集 |, 补集 - 对称补集 ^, ==/!= , in/ not in 等操作 要求集合内部用 list 存储 class OrderSet: ... s1 = OrderSet([1, 2, 3, 4]) s2 = OrderSet([3, 4, 5]) print(s1 & s2) # OrderSet([3, 4]) print(s1 | s2) # OrderSet([1, 2, 3, 4, 5]) print(s1 ^ s2) # OrderSet([1, 2, 5]) if OrderSet([1, 2, 3]) != OrderSet([3, 4, 5]): print("不相等") if s2 == OrderSet(3, 4, 5): print('s2 == OrderSet(3, 4, 5) is True') if 2 in s1: print("2在 s1中")

优秀的个人博客,低调大师

Python全栈工程师(for、列表)

ParisGabriel Python 入门基础 for:用来遍历可迭代对象的数据元素可迭代对象是指以此获取数据元素的对象可迭代对象包括:字符串 str 列表 list元组 tuple字典 dict语法:for 变量列表 in 可迭代对象: L = ["a", "abc", "中国", 123] for x in L: print(x) else: print("结束") 说明:当循环内部使用break结束循环时,else将不再执行并且else 可以省略range()函数:range(stop) 从零开始,每次生成一个整数后加1操作,直到stop为止(不包含stop)range(star,stop[,step])从star开始每次生成一个整数后移动step,直到stop为止(不包含stop,且step可以是负数)help(range) 查询帮助作用:用来创建一个生成一系列整数的可迭代对象(也叫整数序列生成器) for x in range(0, 10, 3): print(x) 说明:range函数带调用返回的对象可用于for语句来进行依次迭代取出其中的函数for嵌套: for x in range(5): for y in range(3): print(x, y, "ABC") continue:用于循环语句中(while、 for )不再执行本次循环内continue之后的语句重新开始一次新的循环 for x in range(10): if x % 2 == 0: continue print(x) 说明:在while中直接跳到真值表达式重新判断在for中直接将可迭代对象内的元素绑定到下一个再次循环 列表 list:列表是一种容器(通常用来储存计算机的数据对象)列表是可以被改变的序列是由一系列特定元素组成的 元素与元素之间可能没有任何关联关系但他们由先后顺序关系空列表创建方式: L=[ ]列表是可迭代对象: 非空列表创建方式: 空列表: L = [] 非空列表: L = [1, 2, 3, 4] L = ["a", "b", "c"] L = [1, 2, ["a", "b", "c", "d"], 3, 4] 列表的构造函数list:list()等于空列表list(iterable)用可迭代对象创建一个列表列表的运算:+ 用于拼接列表+= 用于将右侧的可迭代对象的数据追加到原列表中* 用于生成重复列表*=列表的比较运算:< <= > >= == !=比较规则和字符串完全相同列表的in、notin:判断一个元素是否存在于列表中 如果纯在返true否则falsein 和 nat in 返回值相反 练习:1.用for实现:输入一个数W代表正方形的宽度:如1 2 3 4 51 2 3 4 51 2 3 4 51 2 3 4 51 2 3 4 5 答案: a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(1, a + 1): print(y, end = " ") print() 改写上上题:1 2 3 4 52 3 4 5 63 4 5 6 74 5 6 7 85 6 7 8 9 第一种:a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(x, a + x): print("0%2d" % y, end = " ") print() 第二种: a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(x, a + x): print(y, end = " ") print() 2.输入任意文字,存于列表L中,当不输入任何内容直接回车后结束输入打印L列表中的内容计算你共输入几行内容、和多少个字符 答案: L = [] i = 0 while True: a = input("plaese input at will string:") if a == "": break i += len(a) L += [a] print(''' L = : %s you have entered:%d row %d Entries character ''' % (L, len(L), i)) 3.输入一个整数 (代表树干高度)打印出如下一颗树输入:2****** 输入3 ********* * * * 答案: a = int(input("plaese input at will integer:")) for x in range(1, a * 2, 2): print(("*" * x).center(a * 2)) else: for s in range(1, a * 2, 2): print("*".center(a * 2)) 4.任意输入一个整数 判断这个数是否是素数(prime)素数也叫质数,是只能被1和自身整除的数:如:2 3 5 7 11 等提示:用排除法:判断x是否是素数是,只要让x分别除以:2 3 4 5 ...-1只要整除了 那x不是素数,否则x是素数 答案: a = int(input("plaese input at will integer:")) for x in range(2, a): if a % x == 0: s = "it's not a prime" break else: s = "This is a prime" print(s 5.算出100 ~ 1000以内的水仙花数(naricissistic)水仙花数是指百位的3次方 加上十位的3次方 加上各位的3次方等于原数的数153=1**3+5**3+3**3 153 370 答案: for x in range(100, 1000): if (x // 100) ** 3 + ((x % 100) // 10) ** 3 + (x % 10) ** 3 == x: print(x)

优秀的个人博客,低调大师

Python全栈工程师(编码)

ParisGabriel Python 入门基础 补充: 主流3操作大系统 Windows: Winxp Win7 Win8 Win10 Unix: Solaris(SUN) IOS(Apple移动端) Mac OS Linux :(linux基于Unix 独立出来的系统) 安卓(Android) Ubuntu 16.04(当前教学版本) ReadHat CentOS 回顾: Ctrl + Alt + Enter :虚拟机全屏/退出全屏 Ctrl + Alt :释放鼠标 ctrl + shift + "+" : 终端字体放大 ctrl + "-" : 终端字体缩小 ctrl + d:退出终端 ctrl + l : 清屏 ctrl + c : 终止当前命令的执行 ctrl + s : 隐藏终端输出 ctrl + q : 恢复终端输出 init 0 : 关机 init 6 : 重启 pwd:显示当前的路径位置 ls:查看当前位置有什么内容 ls -l :以列表形式显示 ls -a :显示所有内容(包含隐藏) cd:改变当前的工作路径 cd 绝对路径 :cd /home/tarena/aid1806/ cd 相对路径 cd .. :回退到上一级目录 cd :回到用户主目录 mkdir:创建一个或者多个文件 touch:创建一个或者多个文 tree:显示目录树 rm -r : 递归删除文件夹内所有内容 rm -f : 强制删除,不给任何提示 rm -i : 删除前给提示(y代表yes,n代表no) sudo:用超级用户root的权限执行一条命令 tar -zcvf 压缩包名字.tar.gz 文件夹/文件:打包压缩 tar -zxvf 压缩包名字.tar.gz [-C 路径]:解压缩包 z : gzip对包进行压缩 c : 创建包 create x : 解包 v : 显示操作的文件细节 verbose f : 文件名 file cp:复制文件/文件夹 mv:剪切 / 重命名 练习1: 1、切换到目录:/home/tarena/anaconda3/bin 2、查看当前所在的路径 3、以列表形式列出当前路径中所有内容(包含隐藏文件或者目录) 4、切换到当前路径的上一级目录 5、切换到 /etc 目录,查看 /etc 有哪些内容 6、直接切换到用户主目录 答案: tarena@tedu:~$ cd anaconda3/bin/ tarena@tedu:~/anaconda3/bin$ pwd /home/tarena/anaconda3/bin tarena@tedu:~/anaconda3/bin$ ls -la 总用量 27888 drwxrwxr-x 2 tarena tarena 12288 7月 17 2017 . drwxrwxr-x 20 tarena tarena 4096 7月 17 2017 .. lrwxrwxrwx 1 tarena tarena 8 7月 17 2017 2to3 -> 2to3-3.6 -rwxrwxr-x 1 tarena tarena 110 7月 17 2017 2to3-3.6 -rwxrwxr-x 2 tarena tarena 3802 5月 26 2017 activate -rwxrwxr-x 1 tarena tarena 165 7月 17 2017 anaconda -rwxrwxr-x 1 tarena tarena 167 7月 17 2017 anaconda-navigator -rwxrwxr-x 1 tarena tarena 153 7月 17 2017 anaconda-project -rwxrwxr-x 1 tarena tarena 12003 7月 17 2017 asadmin tarena@tedu:~/anaconda3/bin$ cd .. tarena@tedu:~/anaconda3$ cd etc/ tarena@tedu:~/anaconda3/etc$ ls dbus-1 fish fonts jupyter rc.d tarena@tedu:~/anaconda3/etc$ cd 练习2: 1、在用户主目录下创建目录 mydir1 、mydir2 2、在mydir1下创建文件:file1、file2、file3 3、将mydir1打包压缩为mydir1.tar.gz,放在用户主目录下 4、将mydir1.tar.gz剪切到mydir1目录下 5、将mydir1.tar.gz解压缩,放到mydir2目录下(-C选项) 答案: tarena@tedu:~$ mkdir mydir1 mydir2 tarena@tedu:~$ cd mydir1 tarena@tedu:~/mydir1$ touch file1 file2 file3 tarena@tedu:~/mydir1$ cd .. tarena@tedu:~$ tar -zcvf mydir1.tar.gz mydir1 mydir1/ mydir1/file3 mydir1/file1 mydir1/file2 tarena@tedu:~$ ls anaconda3 mydir2 yang 文档 core my_env 公共的 下载 examples.desktop pycharm-2017.1.5 模板 音乐 mydir1 pycharm-professional-2017.1.5.tar.gz 视频 桌面 mydir1.tar.gz PycharmProjects 图片 tarena@tedu:~$ mv mydir1.tar.gz mydir1 tarena@tedu:~$ cd mydir1 tarena@tedu:~/mydir1$ ls file1 file2 file3 mydir1.tar.gz tarena@tedu:~/mydir1$ tar -zxvf mydir1.tar.gz -C ~/mydir2 mydir1/ mydir1/file3 mydir1/file1 mydir1/file2 tarena@tedu:~/mydir1$ cd ~/mydir2 tarena@tedu:~/mydir2$ ls mydir1 tarena@tedu:~/mydir2$ cd mydir1/ tarena@tedu:~/mydir2/mydir1$ ls file1 file2 file3 tarena@tedu:~/mydir2/mydir1$ 练习3: 1、在用户主目录下创建目录:AI/Python/Linux 2、在Linux下创建文件:linux1 、linux2 3、在Python下创建文件:python1 、python2: 4、切换到AI目录,查看当前所在路径 5、直接切换到用户主目录 答案: tarena@tedu:~$ mkdir -p AI/python/linux tarena@tedu:~$ cd AI/python/linux tarena@tedu:~/AI/python/linux$ touch linux1 linux2 tarena@tedu:~/AI/python/linux$ cd .. tarena@tedu:~/AI/python$ touch python1 python2 tarena@tedu:~/AI/python$ cd ~/AI tarena@tedu:~/AI$ cd 练习4: 1、在用户主目录创建如下结构:PYTHON/Linux/day01 2、在 day01 下创建三个文件:day01.txt day02.txt day03.txt 3、将 day03.txt 删除 4、将 day02.txt 文件时间更新为当前时间 5、在用户主目录下创建 python/Base 6、在Base下创建 day01 day02 day03 三个文件夹 7、在day01下创建一个文件 day01.txt 8、删除 python/Base 文件夹内的全部内容 答案: tarena@tedu:~$ mkdir -p PYTHON/linux/day01 tarena@tedu:~$ cd PYTHON/linux/day01 tarena@tedu:~/PYTHON/linux/day01$ touch day01.txt day02.txt day03.ttx tarena@tedu:~/PYTHON/linux/day01$ rm -rf day03.txt tarena@tedu:~/PYTHON/linux/day01$ touch day02.txt tarena@tedu:~/PYTHON/linux/day01$ mkdir -p ~/python/base tarena@tedu:~/PYTHON/linux/day01$ pwd /home/tarena/PYTHON/linux/day01 tarena@tedu:~/PYTHON/linux/day01$ ls day01.txt day02.txt day03.ttx tarena@tedu:~/PYTHON/linux/day01$ cd ~/python/base tarena@tedu:~/python/base$ mkdir day01 day02 day03 tarena@tedu:~/python/base$ cd day01 tarena@tedu:~/python/base/day01$ touch day01.txt tarena@tedu:~/python/base/day01$ cd tarena@tedu:~$ rm -rf python 一、二进制 1 2 4 8 16 32 64 128 256 512 1024 2048 4096 8192 163841 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0=0 1=1 2=10 3=11 4=100 5=101 6=110 7=111 8=1000 9=1001 .... 127=1111111二进制算法= 2**n-1 幂运算-1 · 十进制整数转二进制数:“除以2取余,逆序排列”(除二取 余法) 89÷2 ……1 44÷2 ……0 22÷2 ……0 11÷2 ……1 5÷2 ……1 2÷2 ……0 十进制整数转八进制数: 000 -> 0 | 004-> 4 | 010=8 001 -> 1 |005 -> 5| 011=9 002 -> 2 |006 -> 6 | 012=10 003 -> 3 |007 -> 7 | 013=11 十进制整数转十六进制数: 0000 -> 0 0100 -> 4 1000 -> 8 1100 -> C 0001 -> 1 0101 -> 5 1001 -> 9 1101 -> D 0010 -> 2 0110 -> 6 1010 -> A 1110 -> E 0011 -> 3 0111 -> 7 1011 -> B 1111 -> F 二、编码 Ascll码 255个字符 Ascll码表每个字符统一占用1个字节 Ascll码表不支持中文 支持中文的第一张表 叫GB2312 1980年 GB3212 支持6700+字 1995年 GBK1.0 支持20000字 2000年 GB18030 支持27000字 unicode :万国码 (支持所有国家的编码) 并且一个字符 统一占用2个字节 由于出于它的效率不高,对于存储和传输来说都很耗资源。为了提高Unicode的编码效率,于是就出现了UTF-8编码 UTF-8 、 UTF-8是 unicode的扩展集 英文占一个字节 东南亚 欧洲国家2个字节 中文3个字节 Assic --> GB2312 --> GBK1.0 --> GB18030 --> unicode --> UTF-8 Unicode是可以向下兼容GB2312、GBK 、GB17030而UTF8 重新划分分类和次序 不再是原来的次序编码 #!-*-coding:utf-8 -*- (声明使用utf8编码)#codig:utf-8(声明使用utf8编码) print u“我爱北京天安门?”(u代表转换Unicode格式)转换编码打印

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册