写个网盘而已,我怎么就掉进了 Node.js 的深水区?50MB 文件下载只要 112 毫秒:Node.js 流式传输、SQLite 的默认值和 Express
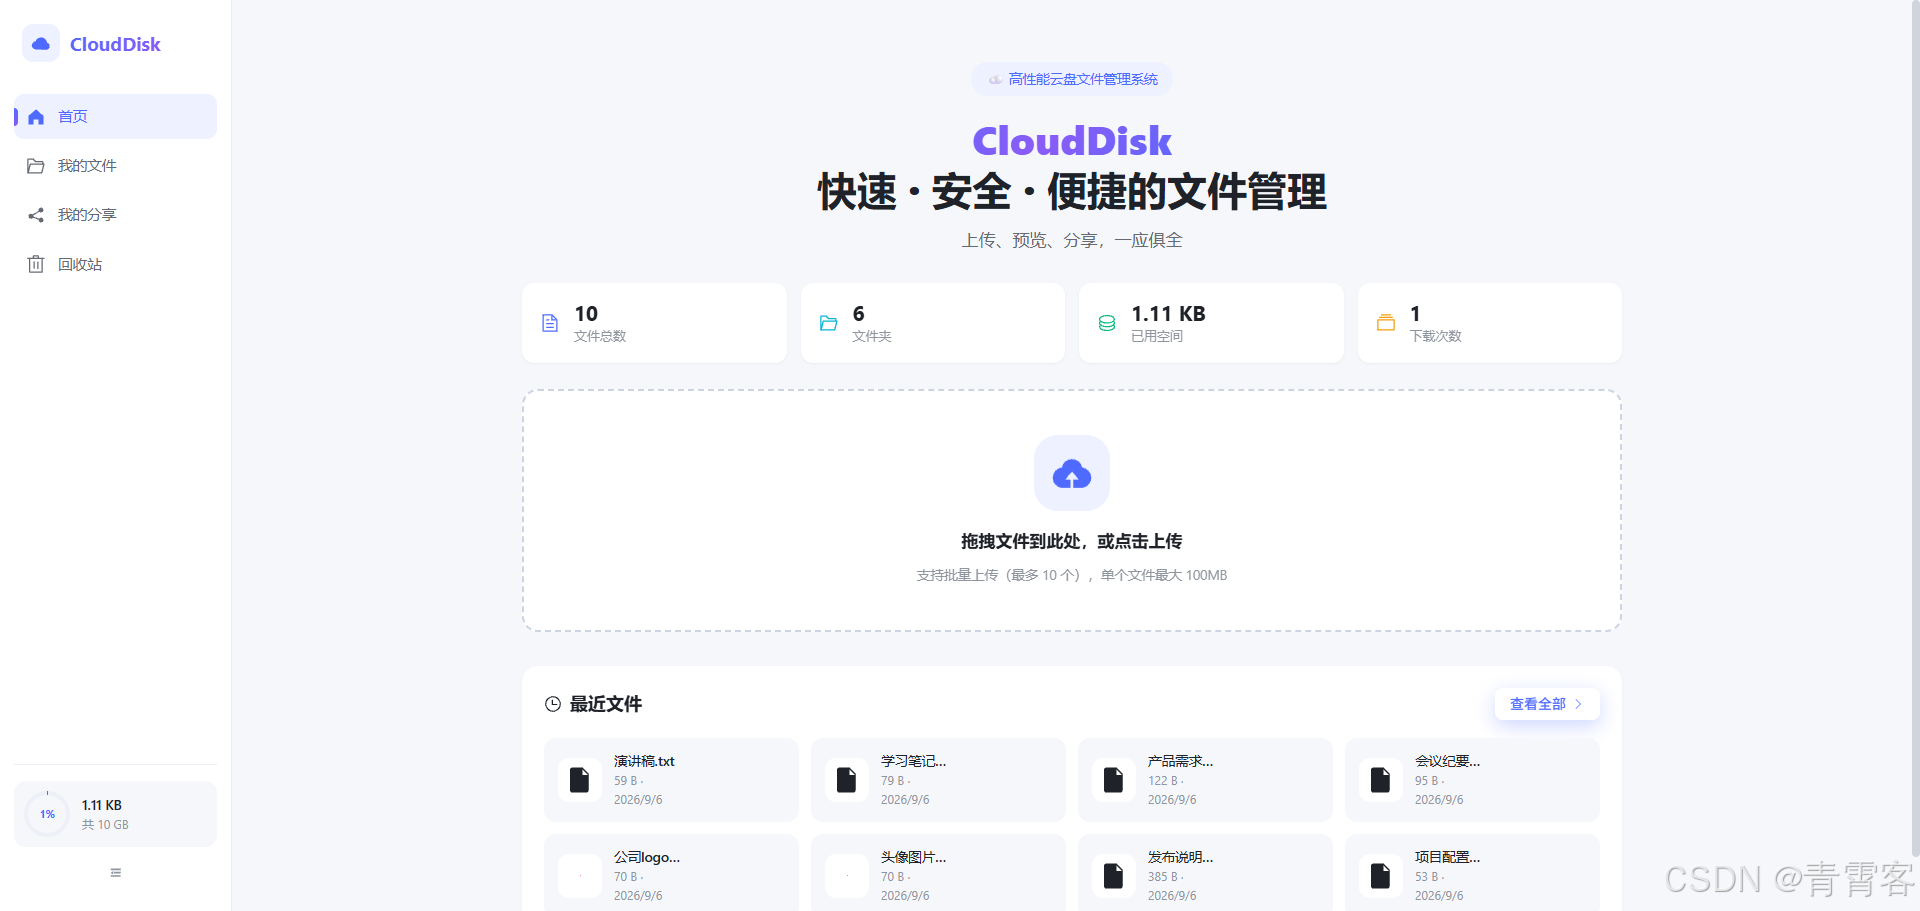 ### 引子:这个需求看起来只需要一个下午 "做一个文件上传下载服务,支持生成带验证码的分享链接。" 如果只看这句话,任何一个写过 Express 的开发者都会在心里估算:模型两张表、十一个接口、前端三个页面,一个下午加一杯咖啡。我最初也是这么估的。 这个项目最终跑起来了:Vue 3 + Element Plus 的前端,Express + better-sqlite3 的后端,63 个 Playwright 端到端用例,50MB 文件在本地实测上传 30.3 MB/s、下载 446 MB/s。功能清单很长——多文件上传、进度条、分页搜索、六位验证码分享、次数锁定、过期撤销——但真正值得写下来的,是那些需求文档里一个字都没提、却差点把项目拖进泥潭的东西。 这篇文章是复盘。所有代码都来自这个真实项目,所有数字都是实测,包括那些让我在深夜里骂出声的 bug。 ### 一、pipe() 的两毫米厚度:流式传输为什么不是可选项 文件服务的性能天花板,几乎在写下第一行下载代码时就决定了。 最直觉的写法是把文件读进内存再发给客户端: ```js // 错误示范:看起来没问题,直到有人在你的服务上放一部电影 const data = fs.readFileSync(filePath); res.send(data); ``` 一个 100MB 的文件,Node 堆里就要躺一份完整拷贝。十个用户同时下载,就是 1GB 内存凭空蒸发,GC 开始长时间停顿,事件循环被拖住,连带着所有其他请求一起变慢。这不是"优化问题",是这套服务在真实负载下能不能活下来的问题。 所以下载走的是流: ```js // fileController.js 中的真实实现 res.setHeader('Content-Type', mimeType); res.setHeader('Content-Disposition', `attachment; filename*=UTF-8''${encodedName}`); res.setHeader('Content-Length', file.size); const fileStream = fs.createReadStream(filePath); fileStream.pipe(res); ``` `pipe()` 这行代码只有两毫米厚,底下垫着的是 Node 流的核心机制——**背压(backpressure)**。网络socket的写入速度远慢于磁盘读取,`pipe()` 会自动在 writable buffer 满时暂停读流、腾出空间后恢复,让内存占用始终稳定在一个 buffer 的大小,跟文件体积无关。这就是为什么实测下载 50MB 文件只用了 112 毫秒(446 MB/s)——这个数字当然不能直接当成公网性能承诺,它是在本机回环地址上测的,没有 TLS 握手、没有真实网络往返、没有拥塞控制。但它能说明一件事:**应用层本身不是瓶颈**,磁盘顺序读加 socket 写入这条路径被完整地保留下来了。同一个 50MB,上传只有 30.3 MB/s,差距的两端分别是:下载路径是"读盘 → 网卡",上传路径是"解析 multipart → 写盘",multer 的协议解析和磁盘写入吃掉了时间。要在公网上继续压榨,方向不在 JavaScript 代码里,而在传输层和磁盘本身——Nginx 这类用 C 写的服务器能利用操作系统的零拷贝能力,让文件字节绕过用户态直接进网卡,这正是生产部署里把静态下载交给 Nginx 的原因之一。  真正吃内存的坑反而藏在一个不起眼的地方——multer 的 `memoryStorage`。这个项目用的是 `diskStorage`,请求体边解析边落盘,内存里只过文件名和元数据: ```js const storage = multer.diskStorage({ destination: (req, file, cb) => cb(null, config.upload.directory), filename: (req, file, cb) => cb(null, `${uuidv4()}${path.extname(file.originalname)}`) }); ``` 存储名用 UUID 重新生成,原始文件名只存在数据库里。这个设计顺手解决了一个安全隐患:用户上传一个叫 `../../etc/passwd` 的文件名,永远碰不到磁盘路径的拼接。**用户输入永远不进文件系统路径**,这一条值得写进任何文件服务的 code review 清单。 ### 二、Express 错误中间件 这个 bug 是我在测试阶段自己抓到的,过程有点丢人,但特别值得讲。 按语义,"上传超过 100MB" 应该返回 413(Payload Too Large),"文件类型不在白名单" 应该返回 400。multer 的错误处理中间件是这么写的: ```js const handleUploadError = (err, req, res, next) => { if (err instanceof multer.MulterError) { if (err.code === 'LIMIT_FILE_SIZE') { return res.status(413).json({ error: 'File too large' }); } // ... } if (err.message === 'File type not allowed') { return res.status(400).json({ error: 'File type not allowed' }); } next(err); }; ``` 逻辑无懈可击。但当时上传一个不在白名单里的类型(比如 `.exe`),返回的却是 500 和一句干巴巴的 "Internal server error"——这段中间件压根没被执行。 我在 Express 4.22.2 + multer 1.4.5-lts.2 上按两种注册顺序各跑了一遍,结果是这样的: | 请求 | 错误处理注册在路由**之前** | 注册在路由**之后** | |------|--------------------------|-------------------| | 超过 100MB | 413 | 413 | | 类型不在白名单 | **500** `Internal server error` | **400** `File type not allowed` | 表里最值得琢磨的是第一行:**超限文件"一直是好的"**。因为兜底的 `errorHandler` 里重复实现了一份 `err.code === 'LIMIT_FILE_SIZE'` 的判断,歪打正着地把 413 挡住了。也就是说,顺序错误的一半症状被一份重复代码掩盖了,只有"类型不合法"这条路径暴露了真问题——哪天有人重构 `errorHandler` 顺手删掉那段 multer 逻辑,413 会一起变成 500,而没人会想到根因在几十行外的注册顺序上。 原因藏在 app.js 的中间件注册顺序里。原代码是: ```js // 错误示范:错误处理注册在路由之前 app.use(handleUploadError); // ← 在这里 app.use('/api/files', fileRoutes); app.use('/api/share', shareRoutes); app.use(errorHandler); ``` Express 4 的错误传播有一条铁律:**`next(err)` 只向后查找错误处理中间件**。multer 在路由内部抛错,Express 从出错的位置开始向后扫,`handleUploadError` 注册在所有路由**之前**,扫描根本不会回头看它一眼——错误一路穿透到排在最后的兜底 `errorHandler`,被当成未知错误打包成 500。 修复只需要挪动三行: ```js app.use('/api/files', fileRoutes); app.use('/api/share', shareRoutes); // 错误处理必须注册在路由之后,Express 的 next(err) 只向后传播 app.use(handleUploadError); app.use(errorHandler); ``` 改完之后,非法类型请求返回 400,超限文件继续返回 413——但这次 413 由正确的中间件负责,不再依赖兜底逻辑的重复实现。语义归位的同时,重复代码也该一并清掉。 这件事让我对"中间件顺序"有了肌肉记忆级的敬畏。Express 的洋葱模型在正常请求流上是"先注册先执行",在错误流上是"先注册永不执行"。原代码里那句注释 `// Upload error handler (MUST be before routes)` 是错的——写注释的人(好吧,也是我)把正常流的直觉错误地推广到了错误流。**注释会撒谎,测试不会**:后来补的 API 级回归用例直接断言状态码(400 / 401 / 404 / 410 / 429 都盯住了)。不过这里也有个诚实的缺口——**413 至今没有端到端断言**,超限只有前端提示兜着,服务端那条路径没被回归测试盖住,这算是我欠下的一笔债。 ### 三、SQLite 的两个 pragma:WAL ,外键 后端选 better-sqlite3 是个需要说服自己的决定。它是同步 API——`db.prepare(...).get()` 会阻塞事件循环——在 Node 这个单线程异步的生态里,这看起来像是异端。 但在文件服务这个场景里,同步恰恰是对的。所有数据库操作都是微秒级的索引查询和主键插入,一次阻塞不到一毫秒;换来的是没有连接池管理、没有回调地狱、事务用 `db.transaction()` 包一层函数就完事。多文件上传时,N 条 INSERT 被包在一个事务里: ```js const insertMany = db.transaction((files) => { const stmt = db.prepare(` INSERT INTO files (id, original_name, stored_name, size, mime_type) VALUES (?, ?, ?, ?, ?) `); for (const file of files) { const fileId = uuidv4(); const originalName = Buffer.from(file.originalname, 'latin1').toString('utf8'); stmt.run(fileId, originalName, file.filename, file.size, file.mimetype); } }); insertMany(req.files); ``` 批量插入从 N 次磁盘同步变成 1 次,这在 SQLite 上是数量级的差距。代价是必须守住一条纪律:**数据库里永远不跑慢查询**。表结构里只有两张表,走主键和索引,数据量也可控,这条纪律自然成立。如果哪天查询复杂到需要跑几十毫秒,就是该换 PostgreSQL 的信号——工具没有高下,边界要清楚。 WAL 模式是打开的第一个 pragma: ```js db.pragma('journal_mode = WAL'); ``` 它的实际效果是读写不再互斥:一个用户在下载文件(读),另一个在上传(写),互不阻塞。对文件服务这种读多写少的负载,WAL 几乎是免费的性能。 第二个 pragma 是这次项目里最有教育意义的发现。建表语句里写着: ```sql FOREIGN KEY (file_id) REFERENCES files(id) ON DELETE CASCADE ``` 几乎所有 SQLite 教程都会警告你:**外键默认是关闭的,必须每个连接显式执行 `PRAGMA foreign_keys = ON`**,否则 `ON DELETE CASCADE` 只是一句好看的注释。我带着这个预期去验证,结果被打脸了——用 better-sqlite3 打开一个全新的连接,外键居然是开着的: ```js const db = new Database(':memory:'); console.log(db.pragma('foreign_keys', { simple: true })); // 1 ``` 原因在编译选项里。better-sqlite3 自带的 SQLite amalgamation 是用 `SQLITE_DEFAULT_FOREIGN_KEYS` 编译的: ```js db.pragma('compile_options'); // [..., 'DEFAULT_FOREIGN_KEYS', 'DEFAULT_RECURSIVE_TRIGGERS', ...] ``` 也就是说,**"默认关闭"是 SQLite 的文档默认值,不是我机器上这个驱动的实际行为**。项目数据库也印证了这一点:129 条分享链接里孤儿行是 0 条,级联删除一直是生效的。 那这行 `db.pragma('foreign_keys = ON')` 还写不写?**必须写。** 因为不写的话,正确性就押在"驱动作者选了哪个编译选项"上——换驱动(node-sqlite3)、换版本、或者运维同学用 `sqlite3` CLI 打开同一个文件做手工修复,行为立刻变回 OFF,级联删除当场失效,分享链接变成指向虚空的孤儿行,而且**没有任何报错**。涉及正确性的默认值,永远不要靠环境去猜。 这两个 pragma 放在一起看特别有味道:WAL 不写就损失性能,外键不写就把正确性押在别人的编译选项上。**用嵌入式数据库,每一行 pragma 都是在把你对它的假设写下来**——假设不写下来,数据库(和它的构建者)就按它们自己的来。 ### 四、文件名的编码地狱 看到 `req.file.originalname` 变成一串不认识的字符,第一反应通常是"编码崩了"。这个判断只对了一半——关键是先搞清楚信息丢在哪一侧。 问题出在 multipart 协议的模糊地带。RFC 7578 §4.2 关于 filename 的编码只说了这么一句: > Some commonly deployed systems use multipart/form-data with file names directly encoded including octets outside the US-ASCII range. The encoding used for the file names is **typically UTF-8**, although HTML forms will use the charset associated with the form. 注意是"typically UTF-8",不是 SHOULD。RFC 只承认"通常是",HTML 表单还会跟随 form-charset,从头到尾没给出一个强制字符集——这就是模糊地带的来源。(顺带一个冷知识:RFC 7578 明确禁止在 multipart/form-data 里使用 RFC 5987 的 `filename*` 参数,所以客户端没法绕开这个坑。) 而 multer 底层的 busboy(本项目是 1.6.0)默认按 **latin1** 解码参数。于是中文文件名的 UTF-8 字节被逐字节解释成 latin1 字符,变成一串"看着乱码、但信息无损"的字符串。实测发送 `季度报告.pdf`: ```js req.file.originalname // 'å£åº¦æ¥å.pdf' ``` latin1 是单字节到单字节的映射,这趟变换是完美的双射——UTF-8 字节流被 latin1 "读"进去什么样,就能原样"吐"回来。做一次逆变换即可还原,这个 round-trip 技巧在邮件和 HTTP 头处理里活了几十年,今天依然是处理 multipart 文件名的标准手段: ```js const originalName = Buffer.from(req.file.originalname, 'latin1').toString('utf8'); // '季度报告.pdf' ``` 真正麻烦的是另一种症状:文件名变成 `?????.pdf`。问号不是编码问题——**信息在到达服务端之前就已经被替换掉了,而且是不可逆的**。服务端再怎么还原也只能得到 `?????.pdf`。 我最初把锅扣在了测试客户端头上,认定是 Playwright 构造 multipart 时把非 latin1 字符替换成了问号。但在当前环境(Playwright 1.62.1 + busboy 1.6.0)上复现时,API 多部分上传的中文文件名能被完整还原,没有出现问号——这个结论我没法写成通用结论。**能留下来的是定位方法,不是"是谁的锅"这个判断:** 排查乱码,第一步是确认信息丢在哪一侧—— - **编码错了(可逆)**:字节一个不少,只是被按错误的字符集解释,服务端一次逆变换就能还原。 - **被替换了(不可逆)**:问号是替换符,原始字节已经不在报文里了。此时必须往上游找——构造 multipart 的客户端、中间代理、或者写入时终端/文件系统的编码,服务端无论怎么写都救不回来。 区分手段很朴素:把原始字节 hex dump 出来。UTF-8 的中文是多字节序列;如果看到 `3F`(`?`),就已经是替换后的结果,直接往上游追,别在服务端浪费时间。 下载响应头要反过来做一次编码,让各种浏览器都能拿到正确的中文文件名: ```js res.setHeader('Content-Disposition', `attachment; filename*=UTF-8''${encodedName}`); ``` `filename*` 的扩展参数语法由 RFC 5987 定义(已被 RFC 8187 取代),RFC 6266 把它引入 HTTP 的 `Content-Disposition`。只用 `filename="中文名"` 的老写法,在部分客户端上就是乱码来源。 ### 五、分享链接的安全账本 分享功能的产品逻辑很直白:生成一个链接和一个六位验证码,二者分开传输,凑齐才能下载。这是把**能力型 URL(capability URL)**和**双通道验证**揉在一起的方案——链接泄露而验证码不泄露,文件拿不走;验证码被猜出来的概率,可以算: 验证码字符表是 `ABCDEFGHJKLMNPQRSTUVWXYZ23456789`,32 个字符——刻意剔除了 0/O 和 1/I 这两对在无衬线字体里几乎无法区分的字符。32⁶ = 1,073,741,824,约 10.7 亿种组合。服务端限制每个链接最多 5 次验证尝试,超限锁定(429),单链接被猜中的概率是 5 / 1,073,741,824 ≈ **两亿分之一**(约 0.00000047%)。链接本身是 UUIDv4,122 位随机数,枚举攻击不在讨论范围内。再加上过期时间(1 小时到 7 天可选)和主动撤销(撤销后返回 410),这套方案的安全下限是明确的。 但有一个细节我必须诚实地说:验证码的生成用的是 `Math.random()`: ```js function generateCode(length = 6) { const chars = 'ABCDEFGHJKLMNPQRSTUVWXYZ23456789'; let code = ''; for (let i = 0; i { try { await navigator.clipboard.writeText(text) return true } catch { // Fallback for non-secure context or unfocused document const textarea = document.createElement('textarea') textarea.value = text textarea.style.position = 'fixed' textarea.style.opacity = '0' document.body.appendChild(textarea) textarea.select() try { return document.execCommand('copy') } catch { return false } finally { document.body.removeChild(textarea) } } } ``` `document.execCommand('copy')` 虽然被 MDN 标记为废弃,但它工作在同步世界、不挑聚焦状态,作为降级路径至今仍然广泛可用。**渐进增强不是学术名词,是让功能在所有环境里都活着的务实手段。** **第三个最有趣:对话框关不掉,但只有特定环境关不掉。** 自动化浏览器面板里,分享对话框点"取消",Vue 状态链全部正确——`modelValue` 已经是 false——但遮罩层岿然不动,`display: block` 纹丝不动。同样的代码在独立 Chromium 里一次就关上。最后用 `element.getAnimations()` 抓现场,发现关闭动画(Vue transition `dialog-fade` 的 leave 阶段,对应类名 `.dialog-fade-leave-active`)的状态永远卡在 `running`:Element Plus 的对话框关闭依赖 CSS 动画的 `animationend` 事件,而 Chromium 对被遮挡的页面会做渲染节流,动画帧不推进,`animationend` 永远不来,Vue 的 transition 就永远等在 leave 钩子上。 这是典型的**环境伪影**:产品代码没有任何问题,真实用户永远不会遇到。但它给自动化测试提了一个非常重要的纪律——**测试失败时,先区分"产品缺陷"和"环境伪影",否则你要么给产品修一个不存在的 bug,要么容忍测试天天狼来了**。区分手段也很朴素:换一个干净环境(独立浏览器)跑同一条路径,结果不一致就是环境的锅。 顺带一提,六位验证码输入组件本身(自动跳格、退格回退、粘贴分发、自动大写、输完自动提交)是前端面试的老题,但生产实现里全是细节:粘贴时要过滤非合法字符并自动大写,`maxlength=1` 的格子与 `fill()` 这类批量赋值方式存在交互陷阱,聚焦时要 `select()` 便于覆盖输入。这些点加起来,组件不到两百行,但每一行都有理由。 ### 七、把测试当用户 这个项目的自动化测试是 Playwright 写的 63 个端到端用例,配置刻意保守——`workers: 1`,串行执行,模拟的就是一个真实的、只有一个手的用户: ```js // tests/playwright.config.js(节选,省略了 reporter 与 projects 配置) module.exports = defineConfig({ testDir: './e2e', timeout: 60000, fullyParallel: false, workers: 1, use: { baseURL: 'http://localhost:5173', screenshot: 'only-on-failure', trace: 'on-first-retry', navigationTimeout: 30000, actionTimeout: 15000, }, }); ``` 覆盖面上,九个 spec 文件各自认领一摊,加起来正好 63 条:首页 5 条(渲染、导航、最近文件、上传后列表刷新)、文件管理 9 条(统计卡片、搜索、分页)、上传 6 条(单文件、多文件、移除、清空、重复选择、对话框开关)、下载 1 条、删除 3 条(确认与取消)、分享对话框 8 条(6 种有效期、生成、复制、关闭)、分享下载页 10 条(验证码正确与错误、剩余次数递减、大写、粘贴、404)、验证码组件与边界 8 条(自动跳格、退格回退、方向键、按钮禁用、>100MB 警告、非法类型拒绝、空文件),最后一组 13 条直接打 API,覆盖分享验证下载、错误码 401、撤销 410、5 次上限 429、删除级联、下载计数和各种 404/400。 用例写多了之后,真正有价值的经验反而是三条"反直觉"的。 **第一,断言要等异步链走完,而不是等第一眼看到的元素出现。** 统计卡片的用例翻过车:它等表格第一行出现就断言"文件总数 > 0",全量跑的时候偶发失败——因为统计数据是另一条异步链(全量分页拉取),表格渲染完不代表统计算完。修复用 `expect.poll` 把断言变成轮询: ```js await expect .poll(async () => { const text = await page.locator('.stat-card').nth(0).locator('.stat-value').textContent(); return parseInt(text); }, { timeout: 15000 }) .toBeGreaterThan(0); ``` **Flaky 测试九成是断言时机问题,修断言,不要修数据。** **第二,测试客户端不是真实用户,但也别急着给它定罪。** 文件名乱码那次我第一反应是 Playwright 把中文名替换成了问号,后来在当前版本上复现,发现它的 API multipart 是能正确传 UTF-8 文件名的——锅不在它身上。这件事的教训比"Playwright 有问题"更有用:**测试工具在模拟用户,任何模拟都有保真度边界,涉及编码、协议细节的地方要留一个心眼,必要时用真实浏览器路径交叉验证;但"测试失败"和"测试工具有 bug"之间,隔着一次复现。** **第三,测试环境里"浏览器"和"页面"是两个变量。** 同样的用例,独立 Chromium 和嵌入式面板跑出不同结果(那个 CSS 动画冻结),说明测试基础设施本身也是被测系统的一部分。测试报告里每一行失败,都值得问一句:这是产品的问题,还是我看产品的窗户有问题? 这些纪律换来的回报很实在:功能迭代和 bug 修复都靠同一套 63 个用例做回归,最后一轮全绿。**回归测试的价值不在抓新 bug,而在让你敢改代码。** ### 八、部署 部署方案设计时做了个关键取舍:让 Express 在检测到前端构建产物时自动托管。 ```js const clientDist = path.join(__dirname, '../../client/dist'); if (fs.existsSync(clientDist)) { app.use(express.static(clientDist)); app.get(/^\/(?!api|uploads).*/, (req, res) => { res.sendFile(path.join(clientDist, 'index.html')); }); } ``` `existsSync` 探测让开发模式(Vite dev server + Express 分离)和生产模式(单端口 3000)共用同一份代码。正则 `/^\/(?!api|uploads).*/` 是 SPA 回退的关键——除了 API 和上传目录,所有路径都返回 `index.html`,让 Vue Router 的 history 模式在刷新 `/download/xxx` 这种深层链接时不会 404。 正式生产再叠一层 Nginx:静态资源走 `expires 30d` 长缓存,API 反代到本机 3000 端口(Node 不暴露公网),`client_max_body_size 110M` 对齐后端 100MB 上限。这个架构里有一个容易被忽视的时间观问题:Vite 构建的业务代码带内容 hash(`Dashboard-Cc7xTLt_.js`),改一行业务代码只有几 KB 需要重新下载;但 Element Plus 如果和业务代码打在同一个 chunk 里,改一个按钮的颜色,用户就要重新下载这 1.04 MB(`element-plus-Bt8MfA2o.js`,实测 1,088,615 字节)的组件库。所以构建配置里显式做了 vendor 分包: ```js manualChunks: { 'element-plus': ['element-plus'], 'vue-vendor': ['vue', 'vue-router', 'pinia', 'axios'] } ``` 组件库单独成 chunk 后获得独立的缓存生命周期。**对"加载要快"这个需求,最好的优化不在压榨网络,而在让字节被重复使用。** 部署教程(DEPLOY.md)里把 SQLite 迁移写得非常朴素:停服务、打包 `data/` 和 `uploads/`、新服务器解压、启动。没有主从复制,没有增量同步——单文件数据库的可迁移性本身就是选它的理由之一,几十 GB 以内的体量,"停机五分钟拷文件"是最诚实的方案。 ### 九、往前看:这套架构的未来,和它的边界 诚实地评估,Express + SQLite + 流式传输这套组合,当下的适用边界非常清晰:**单机、中小团队、GB 级以下的存储体量**。越过这条线,每个环节都有明确的演进路径,而且有趣的是,好几条演进路径正在被前端基础设施的变化重新定义。 **上传的下一个台阶是断点续传和直传。** 现在的 multer 单请求上传有个隐含契约:网络断了,100MB 从头来。业界成熟答案是 tus 协议(断点续传的事实标准)或者 S3 式的分块上传:客户端把文件切成块,逐块上传、服务端按序合并,失败只重传失败块。再往前一步是"直传"——服务端只签发带签名的上传凭证,客户端直传对象存储(OSS/S3),应用服务器彻底退出大文件的数据面,只留在控制面。这个模式在国内云厂商的 SDK 里已经成熟到几行代码,它的代价是架构从"一个进程"变成"一个进程加一个对象存储",对 tiny team 未必划算,但对公开服务几乎是必选项——带宽成本和服务器出口流量是真实账单上的真实数字。 **SQLite 本身正在经历一场身份升级。** 过去两年,SQLite 从"嵌入式玩具"被重新发现有模有样的生产相:Turso(基于 libSQL 分支)把 SQLite 做成了网络服务,LiteFS 和 Litestream 用复制把 SQLite 推进高可用领域,Durable Objects、Cloudflare 的数据库产品线里 SQLite 都是底座。这股风潮的逻辑和本文第三节的判断一致——**对读多写少、数据量可控的场景,SQLite 的简单性就是生产力**。边缘计算又加了一把火:数据复制到离用户最近的节点,读延迟进入个位数毫秒。一个今天跑在单机上的网盘,五年后的同构演进路径可能就是"SQLite at the edge"。 **传输协议层面,HTTP/3(QUIC)对大文件传输是实质利好。** 基于 UDP 的 QUIC 消除了 TCP 队头阻塞,弱网环境(恰恰是手机传大文件的典型场景)下吞吐显著改善;WebTransport 在其上提供流式 API,Node 侧的兼容也在推进。不过这些改善主要发生在传输层,应用代码(流式管道、背压)可以原样受益——这也是坚持用标准 HTTP 语义而非 WebSocket 自造协议的好处:**底层协议升级时,上层不用重写。** **还有两件"脏活"会随着规模自然出现。** 一是病毒扫描(ClamAV 管道)和内容寻址去重(SHA-256 做存储键,相同文件只存一份——上传接口顺势获得秒传能力);二是预览:图片缩略图、PDF 首页、视频抽帧,都需要一个异步任务队列,那会是这套同步架构里第一个真正意义上的异步组件。 至于当下影响,一句话总结:**在 99% 的内部工具和中小产品场景里,一个精心处理的单机架构,比一个过早引入的分布式架构更可靠、更便宜、更快上线**。分布式系统的复杂度是真实的成本,"我们以后可能需要"不构成现在支付它的理由。这条边界的两端各有一句提醒:别把单机方案吹成万能,也别在体量到来之前为它预付复杂度。 ### 结语 回到开头那个"一个下午"的估算。这个项目最终交付的不只是一个能跑的网盘,而是一串可以复用的判断: 流式管道不是优化项,是生存项;错误中间件的注册顺序是语义的一部分,不是代码风格;嵌入式数据库的每个默认值都要显式确认;编码问题要在信息丢失的位置解决;安全方案的阈值用攻击者的最优策略来算;测试失败先分清产品的锅和环境的锅。 这些判断没有一条来自教程,每一条背后都是一次真实的排障。工程能力大概就是这样长的——不是学了更多的框架,而是在同一个领域里,把坑踩得比别人深一层,并且记得住。 --- *本文所有代码片段均来自真实项目 [cloud-disk],性能数据为本地实测(50MB 文件:上传 30.3 MB/s / 下载 446 MB/s,回环地址,无 TLS),测试基线为 Playwright 63 个端到端用例。*