首页 文章 精选 留言 我的

精选列表

搜索[文档抽取],共10000篇文章
优秀的个人博客,低调大师

Android 中文 API 文档 (44) —— Chronometer.OnChronometerTickListener

正文 一、结构 public static interfaceChronometer.OnChronometerTickListener 二、概述 计时器递增的时候通知这个回调。 三、公共方法 public abstract voidonChronometerTick(Chronometer chronometer) 在计时器变化时通知。 参数 chronometer计时器对象。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582600,如需转载请自行联系原作者

优秀的个人博客,低调大师

Rancher-k8s加速安装文档

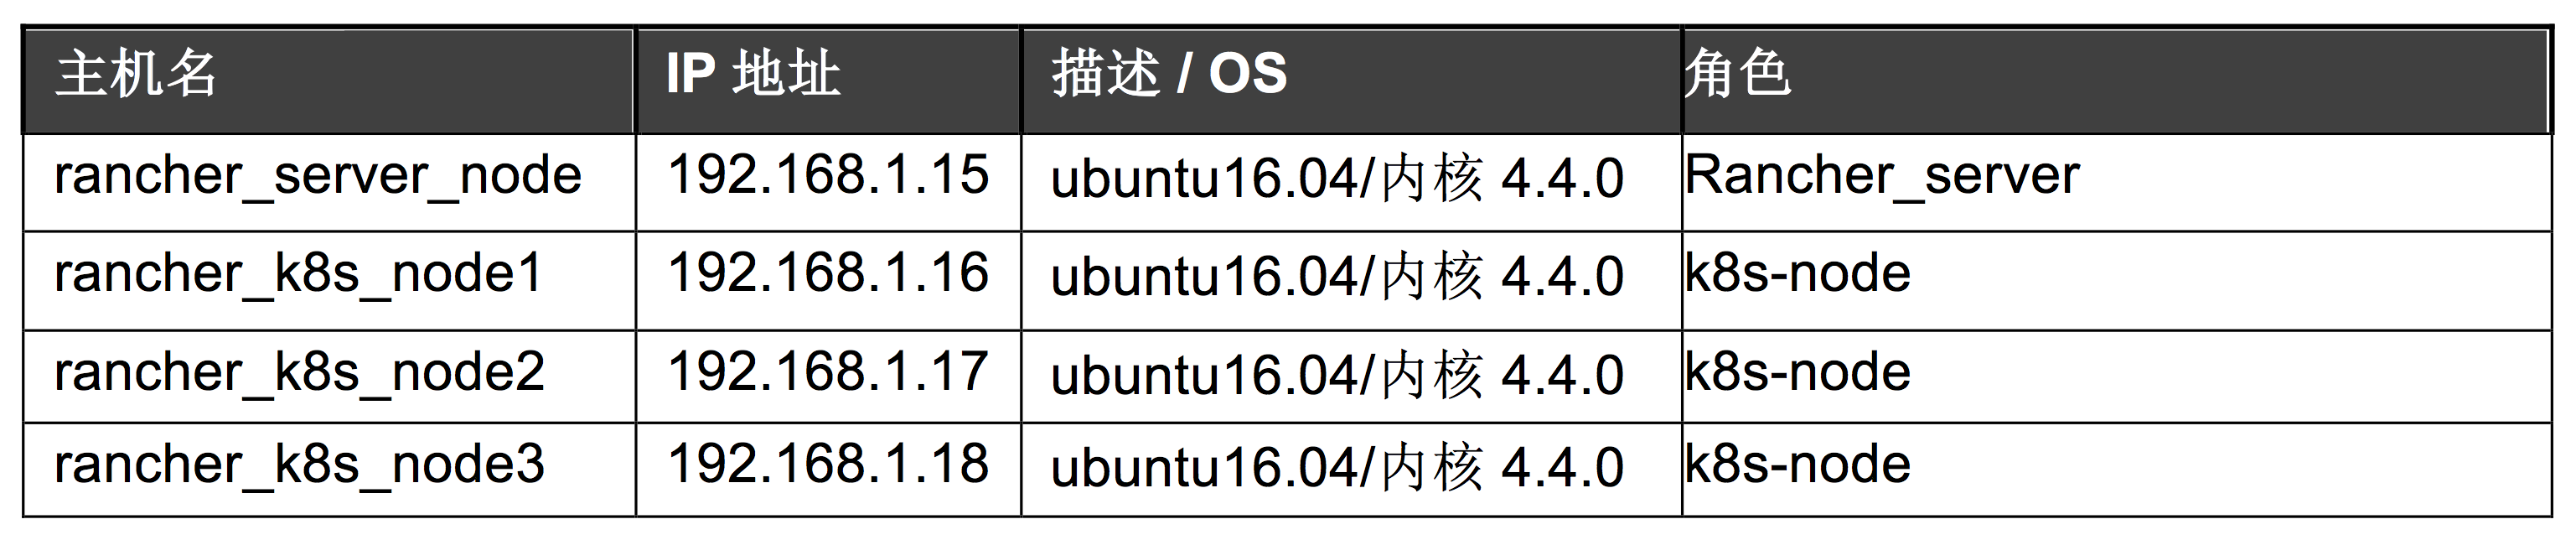
Kubernetes是一个强大的容器编排工具,帮助用户在可伸缩性系统上可靠部署和运行容器化应用。Rancher容器管理平台原生支持K8s,使用户可以简单轻松地部署K8s集群。 很多同学正常部署k8s环境后无法进入Dashboard,基础设施应用栈均无报错。但通过查看 基础架构|容器 发现并没有Dashboard相关的容器。 因为k8s在拉起相关服务(如Dashboard、内置DNS等服务)是通过应用商店里面的YML文件来定义的,YML文件中定义了相关的镜像名和版本。而Rancher部署的k8s应用栈属于k8s的基础框架,相关的镜像通过dockerhub/rancher 仓库拉取。 默认Rancher-catalog k8s YML中服务镜像都是从谷歌仓库拉取,在没有科学上网的情况下,国内环境几乎无法成功拉取镜像。 为了解决这一问题,优化中国区用户的使用体验,我们修改了http://git.oschina.net/rancher/rancher-catalog仓库中的YML文件,将相关的镜像也同步到国内仓库,通过替换默认商店地址来实现加速部署。 环境准备 整个演示环境由以下4台本地虚拟机组成,相关信息说明如下: 操作说明 具体演示操作说明如下: 第一步 1、直接运行Rancher_server: 1 Sudodockerrun-d--restartalways–namerancher_server-p 8080 : 8080 rancher/server:stable&&sudodockerlogs-francher-server 容器初始化完成后,通过主机IP:8080访问WEB。 2、添加变量启动Rancher_server: 1 2 3 Sudodockerrun-d--namerancher-server-p 8080 : 8080 --restart=unless-stopped-eDEFAULT_CATTLE_CATALOG_URL= '{"catalogs":{"library":{"url":"http://git.oschina.net/rancher/rancher-catalog.git","branch":"k8s-cn"}}}' \ rancher/server:stable&&sudodockerlogs-francher-server 变量的作用后面介绍。 第二步,Rancher基本配置: 因为Rancher修改过的设置参数无法同步到已创建的环境,所以在创建环境前要把相关设置配置好。比如,如果你想让Rancher默认去拉取私有仓库的镜像,需要配置registry.default= 参数等。 应用商店(Catalog)地址配置:在系统管理\系统设置中,找到应用商店。禁用Rancher 官方认证仓库并按照下图配置。 名称:library (全小写) 地址:https://git.oschina.net/rancher/rancher-catalog.git 分支: k8s-cn PS:回到最开始的启动命令,如果以第二种方式启动,这个地方就会被默认配置好。所以,根据自己的情况选择哪一种配置方式, 最后点击保存。 第三步,Kubernetes环境配置查看对比: 重启并进入WEB后,选择环境管理。如图: 在环境模板中,找到Kubernetes 模板,点击右边的编辑图标,接着点击编辑配置。 以下是Rancher-k8s的默认配置对比,图一为默认商店的参数,图二为自定义商店的参数。 这里只是查看参数不做相关修改。点击cancel返回模板编辑页面。 在这里,根据需要可以定制组件,比如可以把默认的ipsec网络改为vxlan网络等,这里不再叙述。 最后点保存或者cancle返回环境管理界面。 第四步,添加环境: 在环境管理界面中,点击页面上方的添加环境按钮: 填写环境名称,选择环境模板(Kubernetes),点击创建。创建后: PS:default环境由于没有添加host,会显示Unhealthy。 切换模板 等待添加主机 第五步,添加主机: 如上图,进入添加主机界面 指定用于注册这台主机的公网IP。如果留空,Rancher会自动检测IP注册。通常在主机有唯一公网IP 的情况下这是可以的。如果主机位于防火墙/NAT设备之后,或者主机同时也是运行rancher/server容器的主机时,则必须设置此IP。 以上这段话会在添加主机页面显示,这段话的意思就是:如果准备添加的节点有运行Rancher-server容器,那么在添加节点的时候就要输入节点可被直接访问的主机IP地址(如果做的Rancher-HA,那么每台运行Rancher-server的节点都要添加主机IP地址),如果不添加主机IP地址,那么在添加节点后获取到的地址很可能会是Rancher-server容器内部的私网地址,导致无法使各节点通信。所以需要注意一下! 本示例三个节点都没有运行rancher_server,所以直接复制生成的代码,在三个节点执行。 节点添加成功,应用栈创建完毕,正在启动服务: 镜像拉取中 到此为止,k8s就部署完成。 服务容器查看:点击基础架构|主机 对比基础设施中kubernetes 应用栈,可以发现有以下容器是不在应用栈中的: 这些应用是在k8s框架运行起来之后,再通过YML配置文件拉起的k8s服务,比如Dashboard服务 那些点击 kubernetes UI 提示服务不可达的。 可以先看看有没有此服务容器。 接下来在k8s中简单部署一个应用。 第六步,k8s应用部署: 进入k8s的Dashboard后,默认显示的是default 命名空间。 可以通过下拉箭头切换到kube-system命名空间,这里显示了CPU、内存使用率,以及一些系统组件的运行状况。 应用部署: 页面右上角点击create 按钮,进入部署配置界面,并简单做一写设置: 注:在service中,如果选择Internal, 将需要ingress功能,ingress类似于LB的功能,这个后续讲解。这里我们选择External 。 最后点击deploy .点击deploy后将会跳转到部署状态界面,如图: 部署完成后显示状态: 页面右侧点击service 可以看到部署的服务以及访问信息。 返回Rancher,进入基础设施 可以看到自动增加了一个kubernetes-loadbalancers 应用栈。 这个应用栈的信息是通过k8s传递到Rancher,所以在部署应用后,在Rancher中很容易找到服务访问点。 原文来源:Rancher Labs 本文转自 RancherLabs 51CTO博客,原文链接:http://blog.51cto.com/12462495/1946612

优秀的个人博客,低调大师

App开发架构指南(谷歌官方文档译文)

这篇文章面向的是已经掌握app开发基本知识,想知道如何开发健壮app的读者。 注:本指南假设读者对 Android Framework 已经很熟悉。如果你还是app开发的新手,请查看 Getting Started 系列教程,该教程涵盖了本指南的预备知识。 app开发者面临的常见问题 跟传统的桌面应用开发不同,Android app的架构要复杂得多。一个典型的Android app是由多个app组件构成的,包括activity,Fragment,service,content provider以及broadcast receiver。而传统的桌面应用往往在一个庞大的单一的进程中就完成了。 大多数的app组件都声明在app manifest中,Android OS用它来决定如何将你的app与设备整合形成统一的用户体验。虽然就如刚说的,桌面app只运行一个进程,但是一个优秀的Android app却需要更加灵活,因为用户操作在不同app之间,不断的切换流程和任务。 比如,当你要在自己最喜欢的社交网络app中分享一张照片的时候,你可以想象一下会发生什么。app触发一个camera intent,然后Android OS启动一个camera app来处理这一动作。此时用户已经离开了社交网络的app,但是用户的操作体验却是无缝对接的。而 camera app反过来也可能触发另一个intent,比如启动一个文件选择器,这可能会再次打开另一个app。最后用户回到社交网络app并分享照片。在这期间的任意时刻用户都可被电话打断,打完电话之后继续回来分享照片。 在Android中,这种app并行操作的行为是很常见的,因此你的app必须正确处理这些流程。还要记住移动设备的资源是有限的,因此任何时候操作系统都有可能杀死某些app,为新运行的app腾出空间。 总的来说就是,你的app组件可能是单独启动并且是无序的,而且在任何时候都有可能被系统或者用户销毁。因为app组件生命的短暂性以及生命周期的不可控制性,任何数据都不应该把存放在app组件中,同时app组件之间也不应该相互依赖。 通用的架构准则 如果app组件不能存放数据和状态,那么app还是可架构的吗? 最重要的一个原则就是尽量在app中做到separation of concerns(关注点分离)。常见的错误就是把所有代码都写在Activity或者Fragment中。任何跟UI和系统交互无关的事情都不应该放在这些类当中。尽可能让它们保持简单轻量可以避免很多生命周期方面的问题。别忘了能并不拥有这些类,它们只是连接app和操作系统的桥梁。根据用户的操作和其它因素,比如低内存,Android OS可能在任何时候销毁它们。为了提供可靠的用户体验,最好把对它们的依赖最小化。 第二个很重要的准则是用。之所以要持久化是基于两个原因:如果OS销毁app释放资源,用户数据不会丢失;当网络很差或者断网的时候app可以继续工作。Model是负责app数据处理的组件。它们不依赖于View或者app 组件(Activity,Fragment等),因此它们不会受那些组件的生命周期的影响。保持UI代码的简单,于业务逻辑分离可以让它更易管理。 app架构推荐 在这一小节中,我们将通过一个用例演示如何使用Architecture Component构建一个app。 注:没有一种适合所有场景的app编写方式。也就是说,这里推荐的架构适合作为大多数用户案例的开端。但是如果你已经有了一种好的架构,没有必要再去修改。 假设我们在创建一个显示用户简介的UI。用户信息取自我们自己的私有的后端REST API。 创建用户界面 UI由UserProfileFragment.java以及相应的布局文件user_profile_layout.xml组成。 要驱动UI,我们的data model需要持有两个数据元素。 User ID: 用户的身份识别。最好使用fragment argument来传递这个数据。如果OS杀死了你的进程,这个数据可以被保存下来,所以app再次启动的时候id仍是可用的。 User object: 一个持有用户信息数据的POJO对象。 我们将创建一个继承ViewModel类的UserProfileViewModel来保存这一信息。 一个ViewModel为特定的UI组件提供数据,比如fragment 或者 activity,并负责和数据处理的业务逻辑部分通信,比如调用其它组件加载数据或者转发用户的修改。ViewModel并不知道View的存在,也不会被configuration change影响。 现在我们有了三个文件。 user_profile.xml: 定义页面的UI UserProfileViewModel.java: 为UI准备数据的类 UserProfileFragment.java: 显示ViewModel中的数据与响应用户交互的控制器 下面我们开始实现(为简单起见,省略了布局文件): publicclassUserProfileViewModelextendsViewModel{ privateStringuserId; privateUseruser; publicvoidinit(StringuserId){ this.userId=userId; } publicUsergetUser(){ returnuser; } } publicclassUserProfileFragmentextendsLifecycleFragment{ privatestaticfinalStringUID_KEY="uid"; privateUserProfileViewModelviewModel; @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); StringuserId=getArguments().getString(UID_KEY); viewModel=ViewModelProviders.of(this).get(UserProfileViewModel.class); viewModel.init(userId); } @Override publicViewonCreateView(LayoutInflaterinflater, @NullableViewGroupcontainer,@NullableBundlesavedInstanceState){ returninflater.inflate(R.layout.user_profile,container,false); } } 注:上面的例子中继承的是LifecycleFragment而不是Fragment类。等Architecture Component中的lifecycles API稳定之后,Android Support Library中的Fragment类也将实现LifecycleOwner。 现在我们有了这些代码模块,如何连接它们呢?毕竟当ViewModel的user成员设置之后,我们还需要把它显示到界面上。这就要用到LiveData了。 LiveData是一个可观察的数据持有者。 无需明确在它与app组件之间创建依赖就可以观察LiveData对象的变化。LiveData还考虑了app组件(activities, fragments, services)的生命周期状态,做了防止对象泄漏的事情。 注:如果你已经在使用RxJava或者Agera这样的库,你可以继续使用它们,而不使用LiveData。但是使用它们的时候要确保正确的处理生命周期的问题,与之相关的LifecycleOwner stopped的时候数据流要停止,LifecycleOwner destroyed的时候数据流也要销毁。你也可以使用android.arch.lifecycle:reactivestreams让LiveData和其它的响应式数据流库一起使用(比如, RxJava2)。 现在我们把UserProfileViewModel中的User成员替换成LiveData,这样当数据发生变化的时候fragment就会接到通知。LiveData的妙处在于它是有生命周期意识的,当它不再被需要的时候会自动清理引用。 publicclassUserProfileViewModelextendsViewModel{ ... privateUseruser; privateLiveData<User>user; publicLiveData<User>getUser(){ returnuser; } } 现在我们修改UserProfileFragment,让它观察数据并更新UI。 @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); viewModel.getUser().observe(this,user->{ //updateUI }); } 每当User数据更新的时候 onChanged 回调将被触发,然后刷新UI。 如果你熟悉其它library的observable callback的用法,你会意识到我们不需要重写fragment的onStop()方法停止对数据的观察。因为LiveData是有生命周期意识的,也就是说除非fragment处于活动状态,否则callback不会触发。LiveData还可以在fragmentonDestroy()的时候自动移除observer。 对我们也没有做任何特殊的操作来处理 configuration changes(比如旋转屏幕)。ViewModel可以在configuration change的时候自动保存下来,一旦新的fragment进入生命周期,它将收到相同的ViewModel实例,并且携带当前数据的callback将立即被调用。这就是为什么ViewModel不应该直接引用任何View,它们游离在View的生命周期之外。参见ViewModel的生命周期。 获取数据 现在我们把ViewModel和fragment联系了起来,但是ViewModel该如何获取数据呢?在我们的例子中,假设后端提供一个REST API,我们使用Retrofit从后端提取数据。你也可以使用任何其它的library来达到相同的目的。 下面是和后端交互的retrofit Webservice: publicinterfaceWebservice{ /** *@GETdeclaresanHTTPGETrequest *@Path("user")annotationontheuserIdparametermarksitasa *replacementforthe{user}placeholderinthe@GETpath */ @GET("/users/{user}") Call<User>getUser(@Path("user")StringuserId); } ViewModel的一个简单的实现方式是直接调用Webservice获取数据,然后把它赋值给User对象。虽然这样可行,但是随着app的增大会变得难以维护。ViewModel的职责过多也违背了前面提到的关注点分离(separation of concerns)原则。另外,ViewModel的有效时间是和Activity和Fragment的生命周期绑定的,因此当它的生命周期结束便丢失所有数据是一种不好的用户体验。相反,我们的ViewModel将把这个工作代理给Repository模块。 Repository模块负责处理数据方面的操作。它们为app提供一个简洁的API。它们知道从哪里得到数据以及数据更新的时候调用什么API。你可以把它们看成是不同数据源(persistent model, web service, cache, 等等)之间的媒介。 下面的UserRepository类使用了WebService来获取用户数据。 publicclassUserRepository{ privateWebservicewebservice; //... publicLiveData<User>getUser(intuserId){ //Thisisnotanoptimalimplementation,we'llfixitbelow finalMutableLiveData<User>data=newMutableLiveData<>(); webservice.getUser(userId).enqueue(newCallback<User>(){ @Override publicvoidonResponse(Call<User>call,Response<User>response){ //errorcaseisleftoutforbrevity data.setValue(response.body()); } }); returndata; } } 虽然repository模块看起来没什么必要,但它其实演扮演着重要的角色;它把数据源从app中抽象出来。现在我们的ViewModel并不知道数据是由Webservice提供的,意味着有必要的话可以替换成其它的实现方式。 注:为简单起见我们省略了网络错误出现的情况。实现了暴露网络错误和加载状态的版本见下面的Addendum: exposing network status。 管理不同组件间的依赖: 前面的UserRepository类需要Webservice的实例才能完成它的工作。可以直接创建它就是了,但是为此我们还需要知道Webservice所依赖的东西才能构建它。这显著的增减了代码的复杂度和偶合度(比如,每个需要Webservice实例的类都需要知道如何用它的依赖去构建它)。另外,UserRepository很可能不是唯一需要Webservice的类。如果每个类都创建一个新的WebService,就变得很重了。 有两种模式可以解决这个问题: 依赖注入: 依赖注入允许类在无需构造依赖的情况下定义自己的依赖对象。在运行时由另一个类来负责提供这些依赖。在Android app中我们推荐使用谷歌的Dagger 2来实现依赖注入。Dagger 2 通过遍历依赖树自动构建对象,并提供编译时的依赖。 Service Locator:Service Locator 提供一个registry,类可以从这里得到它们的依赖而不是构建它们。相对依赖注入来说要简单些,所以如果你对依赖注入不熟悉,可以使用 Service Locator 。 这些模式允许你扩展自己的代码,因为它们提供了清晰的模式来管理依赖,而不是不断的重复代码。两者均支持替换成mock依赖来测试,这也是使用它们主要优势之一。 在这个例子中,我们将使用 Dagger 2 来管理依赖。 连接ViewModel和repository 现在我们修改UserProfileViewModel以使用repository。 publicclassUserProfileViewModelextendsViewModel{ privateLiveData<User>user; privateUserRepositoryuserRepo; @Inject//UserRepositoryparameterisprovidedbyDagger2 publicUserProfileViewModel(UserRepositoryuserRepo){ this.userRepo=userRepo; } publicvoidinit(StringuserId){ if(this.user!=null){ //ViewModeliscreatedperFragmentso //weknowtheuserIdwon'tchange return; } user=userRepo.getUser(userId); } publicLiveData<User>getUser(){ returnthis.user; } } 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

akka文档(java)——akka的用例示例

我们看到akka正被许多大型组织所采用,已被广泛应用于投资与商业银行业务,零食与社交媒体,虚拟仿真,游戏与博彩,数据分析等等行业。任何需要高吞吐量和低延迟的系统都是使用akka的良好候选者。 这里有一些良好的关于akka用例的讨论以及在生产环境的使用评论。 下面是一些已将akka部署到生产环境的领域 事务处理(在线游戏,金融、银行,贸易,统计,博彩,社会化媒体,电信) 纵向扩展,横向扩展,容错/HA 后端服务 (任何行业,任何应用) REST服务, SOAP, Cometd, WebSockets等,充当信息枢纽/集成层纵向扩展 、横向扩展,容错/HA 并发/并行性(任何应用) 简单正确的使用与理解akka仅仅是将它的jar添加到你的JVM工程(使用Scala、Java、Groovy或JRuby) 虚拟仿真 主/从,计算风格,MapReduce等 批处理(任何行业) Camel与批量数据源整合,角色对工作负载分而治之 通讯枢纽(电信、网络媒体、移动媒体) 纵向扩展,横向扩展,容错/HA 游戏与博彩(MOM(消息中间件),网络游戏,博彩) 纵向扩展,横向扩展,容错/HA 商业智能/数据挖掘/通用运算 纵向扩展,横向扩展,容错/HA 复杂的事件流处理 纵向扩展,横向扩展,容错/HA 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Ack 框架的实现

Storm 的acker使用哈希校验和来跟踪每个 tuple 树的完成情况:每个 tuple 在被发送出的时候,它的值会与校验和进行异或运算,然后在 tuple 被 ack 的时候这个值又会再次与校验和进行异或运算。这样,一旦所有的 tuple 都被成功 ack,校验和就会变为 0(随机生成的校验和为 0 的概率极小,可以忽略不计)。 你可以在wiki中了解更多关于可靠性机制的信息。 ackerexecute() Acker 实际上也是一个 bolt,它的execute 方法是定义在mk-acker-bolt中的。在一个新的 tuple 树生成的时候,spout 为每个 tuple 发送一个用于异或的固有 id,acker 会将这些 id 记录在它的挂起队列中。每次 executor ack 一个 tuple 的时候,acker 会接收到一个部分校验和,这个校验和是 tuple 自身的 id(将其从挂起队列中清除)和 executor 发送的每个下游 tuple 的 id(放入挂起队列中)的异或值。 这个过程是这样的: 在接收到 tick tuple 信号的时候,将 tuple 树的校验值向超时方向移动并且返回。同时,在 tuple 树中更新或者创建一个记录。 初始化阶段:使用指定的校验和值进行初始化,并且记录 spout 的 id; ack 阶段:将部分校验和与当前的校验和进行异或运算; fail 阶段:仅仅将 tuple 标记为 failed 状态。 接下来,将记录存入RotatingMap(重新设置超时计数值)并且继续以下过程: 如果总校验和为 0, 表明 tuple 树已经完成:将记录从挂起队列中移除,并通知 spout 处理成功; 如果 tuple 树失败了,也会有一种完成状态:将记录从挂起队列中移除,并通知 spout 处理失败。 最后,发送一个我们自己的 ack 信号。 挂起 tuples 与RotatingMap Acker 将挂起树存放在一个RotatingMap中。RotatingMap是一个在 Storm 中多处使用的简单工具,它主要用于高效地处理过程的超时。 RotatingMap 与 HashMap 类似,支持 O(1) 时间的 get 操作。 在 RotatingMap 内部有多个 HashMap(称为槽,buckets),每个 HashMap 都保存有一群会在同一时间超时的记录。我们称存在时间最长的 bucket 为死亡牢房(death row),而访问最多的 bucket 称为苗圃(nursery)。一个新的值在被.put()到 RotatingMap 中,它都会被重定位到 nursery 中,并且从其他的它之前可能在的 bucket 中移除(这是一种高效的重新设置延时时间的方法)。 在 RotatingMap 的所有者调用.rotate()方法的时候,RotatingMap 会将每个 bucket 向着超时的方向移动一步(一般 Storm 对象会在收到一个系统 tick 流 tuple 的时候调用 rotate 方法)。如果此时在前面所说的 death row bucket 中有 key-value 键值对,RotatingMap 会为每个 key-value 键值对触发一个回调函数(在构造器中定义的),让他们的所有者选择一个合适的操作(例如,将 tuple 标记为处理 转载自并发编程网 - ifeve.com 失败)。

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 分布式 RPC

分布式 RPC(DRPC)的设计目标是充分利用 Storm 的计算能力实现高密度的并行实时计算。Storm 接收若干个函数参数作为输入流,然后通过 DRPC 输出这些函数调用的结果。严格来说,DRPC 并不能算作是 Storm 的一个特性,因为它只是一种基于 Storm 原语 (Stream、Spout、Bolt、Topology) 实现的计算模式。虽然可以将 DRPC 从 Storm 中打包出来作为一个独立的库,但是与 Storm 集成在一起显然更有用。 概述 DRPC 是通过一个 DRPC 服务端(DRPC server)来实现分布式 RPC 功能的。DRPC server 负责接收 RPC 请求,并将该请求发送到 Storm 中运行的 Topology,等待接收 Topology 发送的处理结果,并将该结果返回给发送请求的客户端。因此,从客户端的角度来说,DPRC 与普通的 RPC 调用并没有什么区别。例如,以下是一个使用参数 “http://twitter.com”调用 “reach” 函数计算结果的例子: DRPCClient client = new DRPCClient("drpc-host", 3772); String result = client.execute("reach", "http://twitter.com"); 下图是 DRPC 的原理示意图。 客户端通过向 DRPC 服务器发送待执行函数的名称以及该函数的参数来获取处理结果。实现该函数的拓扑使用一个DRPCSpout从 DRPC 服务器中接收一个函数调用流。DRPC 服务器会为每个函数调用都标记了一个唯一的 id。随后拓扑会执行函数来计算结果,并在拓扑的最后使用一个名为ReturnResults的 bolt 连接到 DRPC 服务器,根据函数调用的 id 来将函数调用的结果返回。 定义 DRPC 拓扑 可以直接使用普通的拓扑构造方法来构造 DRPC 拓扑,如下所示: public static class ExclaimBolt extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String input = tuple.getString(1); collector.emit(new Values(tuple.getValue(0), input + "!")); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("id", "result")); } } public static void main(String[] args) throws Exception { TopologyBuilder builder = new TopologyBuilder(); // builder.setSpout(drpcSpout); // builder.setBolt(new ExclaimBolt(), 3); // submit(builder.createTopology()); } 本地模式 DRPC DRPC 可以在本地模式下运行。以下是使用本地模式构造拓扑的例子: LocalDRPC drpc = new LocalDRPC(); DRPCSpout spout = new DRPCSpout("exclamation", drpc); builder.setSpout("drpc", spout); builder.setBolt("exclaim", new ExclaimBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 3) .shuffleGrouping("exclaim"); LocalCluster cluster = new LocalCluster(); Config conf = new Config(); cluster.submitTopology("drpc-demo", conf, builder.createTopology()); // local mode 测试代码 System.out.println(drpc.execute("exclamation", "hello")); cluster.shutdown(); drpc.shutdown(); 在这种模式下,首先你会创建一个LocalDPRC对象,该对象会在进程中模拟一个 DRPC 服务器,其作用类似于LocalCluster在进程中模拟 Storm 集群的功能。在定义好拓扑的各个组件之后,就可以使用LocalCluster来提交拓扑。在本地模式下LocalDPRC对象不会绑定到任何一个实际的端口,所以需要通过向DRPCSpout传入参数的方式来关联到拓扑中。 在启动拓扑后,你可以使用execute方法来完成 DRPC 调用。 远程模式 DRPC 在一个实际的集群中使用 DRPC 有以下三个步骤: 配置并启动 DRPC 服务器; 在集群的各个服务器上配置 DRPC 服务器的地址; 将 DRPC 拓扑提交到集群运行。 可以像 Nimbus、Supervisor 那样使用storm命令来启动 DRPC 服务器(注意,此 server 的基本配置,如 nimbus,ZooKeeper 等参数应该与 Storm 集群其他机器相同): bin/storm drpc 接下来,你需要在集群的各个服务器上配置 DRPC 服务器的地址。这是为了让DRPCSpout了解从哪里获取函数调用的方法。可以通过编辑storm.yaml或者添加拓扑配置的方式实现配置。配置storm.yaml的方式类似于下面这样: drpc.servers: - "drpc1.foo.com" - "drpc2.foo.com" 最后,你可以像其他拓扑一样使用StormSubmitter来启动拓扑。 以下是使用远程模式构造拓扑的一个例子: TopologyBuilder builder = new TopologyBuilder(); DRPCSpout spout = new DRPCSpout("exclamation"); builder.setSpout("drpc", spout, 3); builder.setBolt("exclaim", new ExclamationBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 7) .shuffleGrouping("exclaim"); Config conf = new Config(); conf.setNumWorkers(2); StormSubmitter.submitTopology("drpc-demo", conf, builder.createTopology()); 更复杂的例子 请参考Trident 教程一文中计算指定 URL 的 Reach 数的例子。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 命令行操作

本文介绍了 Storm 命令行客户端中的所有命令操作。如果想要了解怎样设置你的 Strom 客户端和远程集群的交互,请按照配置开发环境一文中的步骤操作。 Storm 中支持的命令包括: jar kill activate deactivate rebalance repl classpath localconfvalue remoteconfvalue nimbus supervisor ui drpc jar 语法:storm jar topology-jar-path class ... 使用指定的参数运行 main 方法(也就是打包好的拓扑 jar 包中的 main 方法)。Storm 所需要的 jar 包和配置信息都在类路径(classpath)中。这个运行过程已经配置好了,这样StormSubmitter就可以在提交拓扑的时候将topology-jar-path中的 jar 包上传到集群中。 kill 语法:storm kill topology-name [-w wait-time-secs] 杀死集群中正在运行的名为topology-name的拓扑。执行该操作后,Storm 首先会注销拓扑中的 spout,使得拓扑中的消息超时,这样当前的所有消息就会结束执行。随后,Storm 会将所有的 worker 关闭,并清除他们的状态。你可以使用-w参数来调整 Storm 在注销与关闭拓扑之间的间隔时间。 activate 语法:storm activate topology-name 激活运行指定拓扑的所有 spout。 deactivate 语法:storm deactivate topology-name 停止指定拓扑的所有 spout 的运行。 rebalance 语法:storm rebalance topology-name [-w wait-time-secs] 有些场景下需要对正在运行的拓扑的工作进程(worker)进行弹性扩展。例如,加入你有 10 个节点,每个节点上运行有 4 个 worker,现在由于各种原因你需要为集群添加 10 个新节点。这时你就会希望通过扩展正在运行的拓扑的 worker 来使得每个节点只运行两个 worker,降低集群的负载。实现这个目的的一种直接的办法是 kill 掉正在运行的拓扑,然后重新向集群提交。不过 Storm 提供了再平衡命令可以以一种更简单的方法实现目的。 再平衡首先会在一个超时时间内(这个时间是可以通过-w参数配置的)注销掉拓扑,然后在整个集群中重新分配 worker。接着拓扑就会自动回到之前的状态(也就是说之前处于注销状态的拓扑仍然会保持注销状态,而处于激活状态的拓扑则会返回激活状态)。 repl 语法:storm repl 打开一个带有类路径上的 jar 包和配置信息的 Clojure 的交互式解释器(REPL)。该命令主要用于调试。 classpath 语法:storm classpath 打印客户端执行命令时使用的类路径环境变量。 localconfvalue 语法:storm localconfvalue conf-name 打印出本地 Storm 配置中conf-name属性的值。这里的本地配置指的是~/.storm/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。 remoteconfvalue 语法:storm remoteconfvalue conf-name 打印出集群配置中conf-name属性的值。这里的集群配置指的是$STORM-PATH/conf/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。该命令必须在一个集群机器上执行。 nimbus 语法:storm nimbus 启动 nimbus 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 supervisor 语法:storm supervisor 启动 supervisor 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 ui 语法:storm ui 启动 UI 后台进程。UI 提供了一个访问 Storm 集群的 Web 接口,其中包含有运行中的拓扑的详细信息。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 drpc 语法:storm drpc 启动 DRPC 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考分布式 RPC一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Adopt Open JDK官方文档(五) Docker镜像

5.1 复制镜像 镜像可以从别的设备复制并导入本地的Docker仓库。 保存镜像的命令为: docker save -o <save image to path> <image name> 或者 docker save <image name> > <save image to path> 保存镜像示例 docker save -o base-image-openjdk9.tar neomatrix369/openjdk9-base-image:latest 或者 docker save neomatrix369/openjdk9-base-image:latest > openjdk9-base-image.tar 或者 docker save neomatrix369/openjdk9-base-image:latest | gzip > openjdk9-base-image.tar.gz openjdk9-base-image.tar 和 openjdk9-base-image.tar.gz 的镜像已默认保存至Docker仓库。 加载镜像的命令为 docker load -i <path to image tar file> 或者 docker load < <path to image tar file> 加载镜像示例 docker load -i openjdk9-base-image.tar 或者 docker load < openjdk9-base-image.tar 或者 docker load < gzip < openjdk9-base-image.tar.gz 5.2 创建镜像 提示:在之前的介绍章节中,已经给出了Docker在相关平台使用的介绍。 在Linux,MacOS,Windows平台创建OpenJDK9 docker镜像的详细步骤如下: Why not build #OpenJDK 9 using #Docker ? – Part 1 of 2 Why not build #OpenJDK 9 using #Docker ? – Part 2 of 2 5.3 检查镜像 提示:这一步针对的OpenJDK镜像,是已经创建好的或者从别处导入至本地的Docker仓库的。 不同的操作系统启动docker的方法也不相同,在Mac和Windows平台,通常通过命令boot2docker启动docker,Linux系统在启动时会自动加载。 在docker启动之后运行命令: $ docker images 会得到如下输出: REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE neomatrix369/openjdk9 latest 5877e8efd939 4 days ago 5.82 GB neomatrix369/full-image-openjdk9 latest 32b0a686e93b 4 days ago 5.82 GB neomatrix369/base-image-openjdk9 latest ce63b2673e6a 4 days ago 781.7 MB phusion/baseimage latest 5a14c1498ff4 4 months ago 279.7 MB 继续执行如下命令: $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 /bin/bash 这一步是跳转到docker容器中执行bash shell命令 $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 java -version 这一步会运行java命令(需要事先配置好java环境变量,通过PATH或者JAVA_HOME可以找到java命令)获取如下信息: openjdk version "1.9.0-internal" OpenJDK Runtime Environment (build 1.9.0-internal-_2015_06_04_06_46-b00) OpenJDK 64-Bit Server VM (build 1.9.0-internal-_2015_06_04_06_46-b00, mixed mode) 转载自并发编程网 - ifeve.com

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册