首页 文章 精选 留言 我的

精选列表

搜索[效率提升],共10000篇文章
优秀的个人博客,低调大师

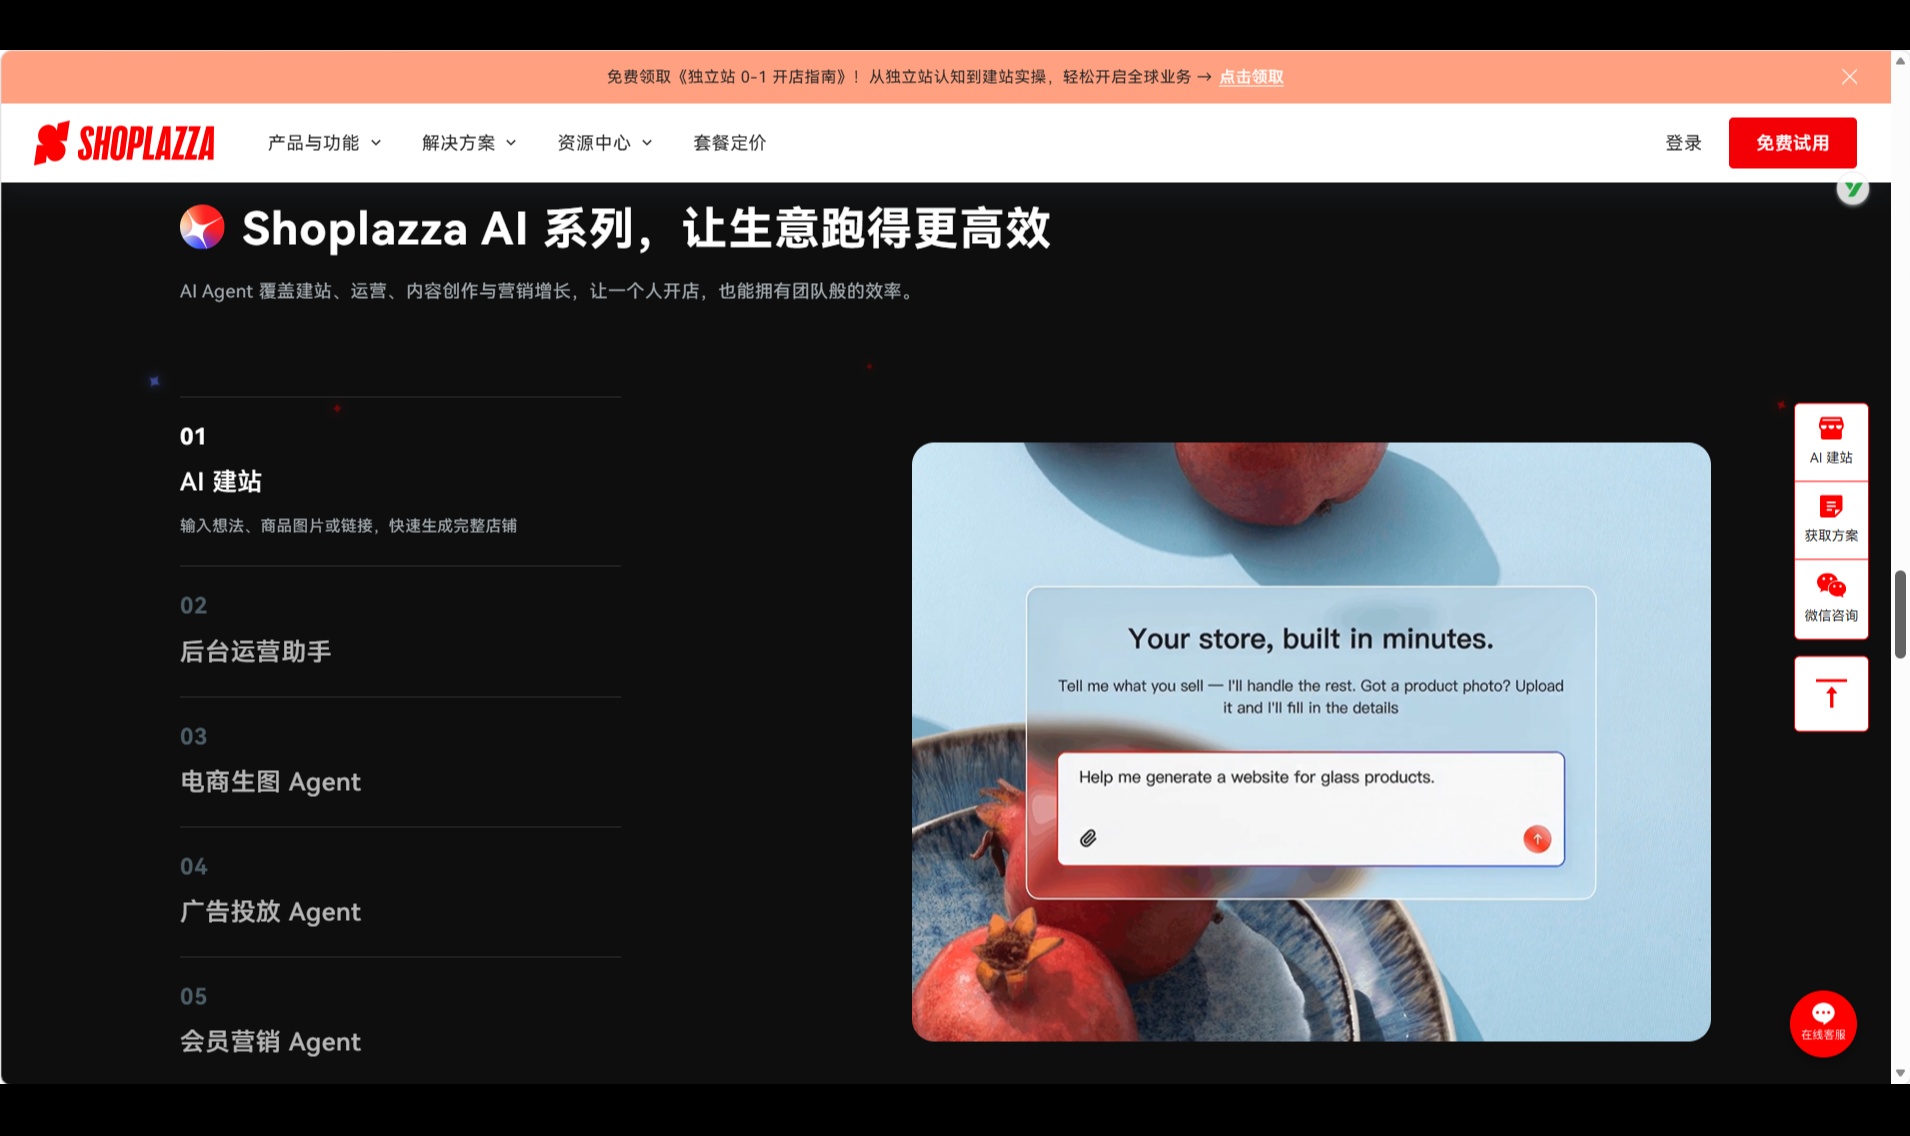
怎么用店匠AI原生系统提高运营效率?

2026年8月,店匠Shoplazza发布了全球首个AI原生电商操作系统AI-native Commerce OS,并推出统一入口——AI智能体Athena,独立站经营从此迈入“意图驱动时代”。过去十几年,独立站软件迭代始终停留在让“工具更好用”的层面,却未能解决人的协同成本问题。店匠这次通过多智能体系统连接建站、内容、投放、支付等核心环节,商家只需用自然语言告诉Athena想做什么,系统便会自动调用相应Agent完成任务。

优秀的个人博客,低调大师

Python提取PDF内容,4个方法让效率翻倍!
![](https://developer.qcloudimg.com/http-save/yehe-11081884/46d54d0bd585a61be2d334caf609a874.jpg) 你是不是经常需要从PDF里提取数据? 手动复制粘贴太慢了,格式还乱七八糟。 说实话,我之前也为此头疼。 直到我发现了Python的强大。 今天分享4个提取PDF内容的方法,让你告别复制粘贴。 --- ## **方法一:PyPDF2提取文字** 最简单的方式就是用PyPDF2。 它像个基础版的PDF阅读器,能快速把文字抠出来。 ``` import PyPDF2 def extract_text_pypdf2(pdf_path): """提取PDF中的文字内容""" with open(pdf_path, 'rb') as file: pdf_reader = PyPDF2.PdfReader(file) text = "" for page in pdf_reader.pages: text += page.extract_text() return text ``` 用起来很简单对吧? 打开PDF,一页页读,把文字拼起来就行。 不过它只能提取文字,表格和图片就无能为力了。 > **适合场景**:只需要提取纯文字,PDF结构简单 ## **方法二:pdfplumber(强烈推荐)** 这个库我必须重点推荐。 为什么?因为它能提取文字、表格、图片三种内容。 就像一个全能选手,什么都能干。 ``` import pdfplumber import pandas as pd def extract_pdf_content(pdf_path): """使用 pdfplumber 提取 PDF 的文字、表格、图片信息""" results = { 'text': '', 'tables': [], 'images': [] } with pdfplumber.open(pdf_path) as pdf: for page in pdf.pages: # 1. 文字 text = page.extract_text() if text: results['text'] += text + '\n' # 2. 表格 tables = page.extract_tables() for table in tables: if table: df = pd.DataFrame(table[1:], columns=table[0]) results['tables'].append(df) # 3. 图片 for img in page.images: results['images'].append({ 'page': page.page_number, 'bbox': (img['x0'], img['y0'], img['x1'], img['y1']), 'width': img.get('width'), 'height': img.get('height') }) return results ``` 你看,代码也不复杂。 但功能强大多了,表格提取尤其出色。 > **适合场景**:需要提取文字+表格的PDF,最常用的方案 ## **方法三:PyMuPDF提取图片** PyMuPDF(也叫fitz)的特点是什么? 图片提取效果好,速度快。 如果你需要把PDF里的图片都抠出来,选它准没错。 ``` import fitz from PIL import Image import io def extract_pdf_fitz(pdf_path): doc = fitz.open(pdf_path) results = {'text': '', 'images': []} for page_num in range(len(doc)): page = doc[page_num] # 1. 文字 results['text'] += page.get_text() # 2. 图片 for img in page.get_images(): xref = img[0] pix = fitz.Pixmap(doc, xref) if pix.n - pix.alpha **适合场景**:重点需要提取PDF中的图片 ## **方法四:camelot专门提取表格** camelot是个专才,只干一件事:提取表格。 但这一件事,它做得比谁都好。 特别是那些复杂的表格,它的准确率最高。 ``` import camelot def extract_tables_camelot(pdf_path): """使用camelot专门提取表格(适合复杂的表格)""" tables = camelot.read_pdf(pdf_path, pages='all') results = [] for i, table in enumerate(tables): df = table.df results.append({ 'table_number': i + 1, 'accuracy': table.accuracy, 'dataframe': df, 'shape': df.shape }) return results ``` 它还能告诉你提取的准确率,很贴心。 > **适合场景**:PDF里有大量复杂表格,对准确率要求高 ## **这四个方法怎么选?** 给你一个简单的对比表: |库名称|文字提取|表格提取|图片提取|特点| | --- | --- | --- | --- | --- | |PyPDF2|基础|不支持|不支持|轻量级,简单好用| |pdfplumber|优秀|优秀|基础|推荐,全能选手| |PyMuPDF|优秀|一般|优秀|图片提取快| |camelot|一般|专业|不支持|表格提取专家| **我的建议**: 如果只要文字:PyPDF2够用了 如果要文字+表格:pdfplumber是首选 如果要图片:PyMuPDF 如果表格复杂:camelot > **终极组合**pdfplumber + PyMuPDF,文字、表格、图片全覆盖 --- ## **写在最后** Python处理PDF确实强大。 选对库,事半功倍。 希望这4个方法能帮到你。 如果有其他问题,评论区聊聊~ 💬 你平时用Python处理PDF遇到过什么坑?欢迎分享! 如果这篇文章对你有帮助,点个**在看**让更多人看到吧 **“无他,惟手熟尔”!**有需要的用起来!


优秀的个人博客,低调大师

探索 LanceDB 在多种存储方案下的查询效率

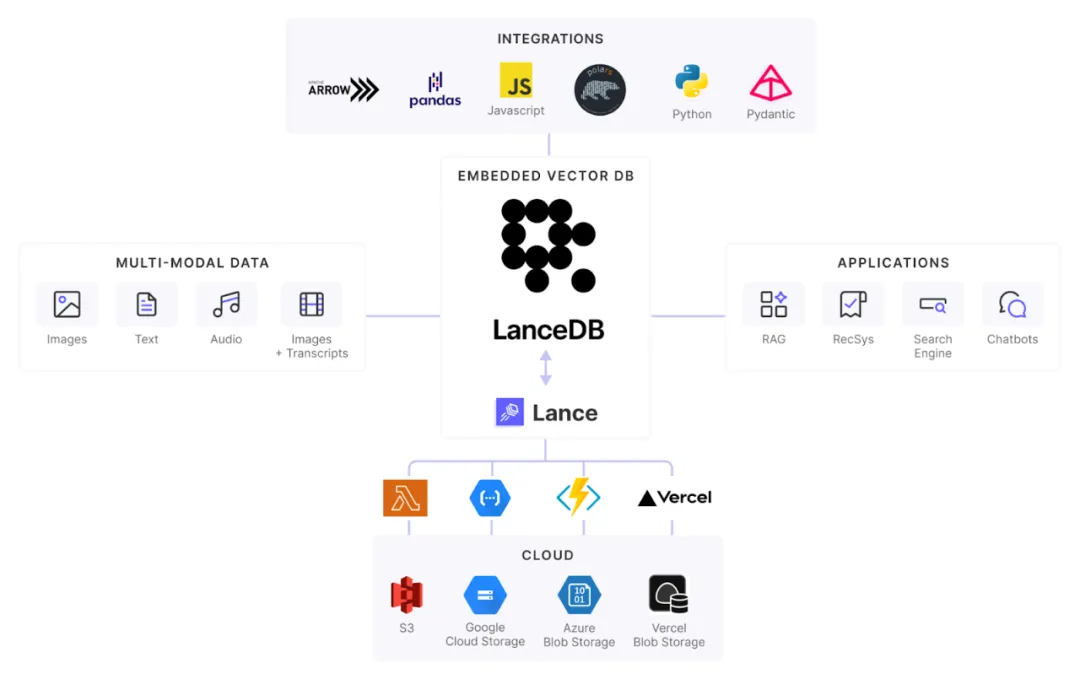
随着 LLM 和多模态 AI 的兴起,非结构化数据的规模呈指数级增长,这对数据存储、检索和分析提出了更高的要求。LanceDB 是 AI 原生多模态数据湖产品,采用自研的开源数据格式 Lance,以解决传统数据格式在大规模非结构化数据场景中的局限性,已被多家 AI 公司,如 Runway 和 Midjourney 等采纳。 LanceDB 在存储后端方面提供了多种选择,以满足用户在成本、延迟、可扩展性和可靠性方面的不同需求。近期,我们对 LanceDB 在不同存储方案中的性能进行了测试,测试涵盖 JuiceFS、本地 NVMe、AWS EBS、EFS、FSx for Lustre 等方案。结果表明,JuiceFS 在性能上优于 AWS EFS 和 FSx for Lustre,接近 EBS,能够稳定支持 LanceDB 的查询。 LanceDB 概述 LanceDB 是一个专为多模态数据设计的高性能向量数据库,旨在高效管理和搜索大规模的向量数据,特别适合用于 AI/ML 等应用场景,尤其是在多模态数据(如图像与文本嵌入)场景。 JuiceFS 概述 JuiceFS 是一个为云原生环境设计的分布式 POSIX 文件系统。它采用元数据与数据分离架构,从而实现了对跨多个存储后端的大型数据集的高效管理。JuiceFS 提供了极高的可扩展性,适用于需要多个节点并行访问数据的场景,如大规模的 AI/ML 工作负载。 02 多模态数据集测试 在本次测试中,我们的主要评估 JuiceFS 与多种存储介质,在性能上的差异。我们所使用的 multimodal_clip_diffusiondb 数据集包含大约 5.8GB 的多模态数据(例如图像和文本嵌入)。测试通过运行 100 条不同的查询请求,比较在不同存储方案下的查询性能。测试代码和数据可以在此链接中找到。 数据表模式如下: prompt: string seed: uint32 step: uint16 cfg: float sampler: string width: uint16 height: uint16 timestamp: timestamp[s] image_nsfw: float prompt_nsfw: float vector: fixed_size_list<item: float>[512] child 0, item: float image: binary 测试步骤如下: 将数据集位置更新为测试目标的本地路径(例如,JuiceFS 的挂载路径,或 EFS 或 FSx for Lustre)。 启动 multimodal_clip_diffusiondb 作为 HTTP 服务,获取来自服务器的100 个不同提示词,并将其保存为 JSON 文件。 以下是一个 JSON 文件示例: $ cat close.json { "data": [ "close" ], "event_data": null, "fn_index": 0, "session_hash": "ejnrxozcc9l" } 使用脚本并行调用全文搜索 API,执行 100 个不同关键词的查询请求。实际效果等同于运行下方代码中的逻辑。 $ cat run.sh: #!/bin/bash for i in data/*.json do curl 'http://127.0.0.1:7860/run/predict' -X POST -H 'User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.15; rv:130.0) Gecko/20100101 Firefox/130.0' -H 'Accept: */*' -H 'Accept-Language: en-CA,en-US;q=0.7,en;q=0.3' -H 'Accept-Encoding: gzip, deflate, br, zstd' -H 'Referer: http://127.0.0.1:7860/' -H 'Content-Type: application/json' -H 'Origin: http://127.0.0.1:7860' -H 'Connection: keep-alive' -H 'Sec-Fetch-Dest: empty' -H 'Sec-Fetch-Mode: cors' -H 'Sec-Fetch-Site: same-origin' -H 'Priority: u=0' -H 'Pragma: no-cache' -H 'Cache-Control: no-cache' --data @$i done 查询服务背后的访问代码: import lancedb db = lancedb.connect('~/datasets/demo') tbl = db.open_table('diffusiondb') tbl.search('{query}').limit(9).to_df() 03 测试结果 我们将 LanceDB 数据集复制到多个存储位置进行测试: 本地 NVMe 存储:数据存储在本地 PCIe 4.0x4 NVMe SSD 上。 EBS(弹性块存储) JuiceFS AWS EFS(Elastic File System) AWS FSx for Lustre:1.2TB、3000MB/s 规格。 以下是使用不同存储配置下查询完成所需时间: 本地 NVMe 性能最佳,为 129 秒。 JuiceFS 性能接近 EBS:JuiceFS 的查询耗时为 177 秒,略高于 EBS 的 176 秒。 EFS 和 FSx for Lustre 的查询耗时分别为 194 秒和 195 秒,明显高于 JuiceFS 和 EBS。 04 小结 通过本次测试,我们验证了 LanceDB 在结合不同存储方案下的实际查询性能表现。JuiceFS 相比 AWS EFS 和 FSx for Lustre 有更好的性能。 JuiceFS 提供了出色的可扩展性和云原生适应性,满足分布式 AI/ML 应用对高效存储和数据访问的需求。对于大规模数据集、跨多个节点共享数据以及进行高并发查询的应用,JuiceFS + LanceDB 是一个值得探索的解决方案。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册