首页 文章 精选 留言 我的

精选列表

搜索[思考模型],共10000篇文章
优秀的个人博客,低调大师

从JVM角度思考--如何预估线上环境机器资源大小

听说微信搜索《Java鱼仔》会变更强哦! 本文收录于github和gitee ,里面有我完整的Java系列文章,学习或面试都可以看看哦 (一)概述 如何给JVM虚拟机巧妙地设计参数对大部分开发来说一直是个随缘的事情,可能是去网上拷贝一套参数,可能是沿用公司其他应用的参数。但是这个随缘的操作可能就会给未来留下隐患。给JVM分配的内存过大倒是没什么问题,无非浪费点资源,但是如果分配的内存过小,就有可能导致频繁的Full GC,给人一种系统一直很卡的感觉。这篇文章就通过一个实例分析一下如何结合场景设置JVM虚拟机参数。 当然,本文更重要的是希望能通过预估参数的这个过程,让你更加了解虚拟机内部的一些东西,要想最准确的参数设置,用一些工具记录下JVM各个区域的变化会更有效。 (二)前置准备 系统基于JDK1.8,堆结构如下。 为了方便理解业务,本文以电商的交易系统为例进行讲解。在微服务架构下,目前主流的互联网公司都会把自己的业务拆分成多个服务架构,比如电商系统会分为交易微服务、购物车微服务、商品微服务等等,可能这个粒度会更细。一个底层架构会将这些微服务集成起来。实际上就是一个大的容器里放了一个个jar包。 (三)通常业务场景下的预估流程 一个交易微服务中会涉及到订单对象、优惠券对象、用户对象、交易记录对象等一系列对象,我们可以简单预估在一次交易中这些对象会占用的空间。预估的方式也很简单,八种基本类型直接带入字节大小,对象类型以基本类型为基础预估大小。只需要一个大致的值就行。 比如每次交易中一个订单对象大约是1kb,优惠券对象2kb,用户对象4kb,交易记录对象4kb,除此之外还可能会存在的List集合、数组等等。大约一次交易中产生的对象大约在25kb左右。 一个每日交易量在100万的系统,交易量主要集中在6个小时中,平均每秒最大会有40笔订单的产生。也就意味着每秒产生对象大小是1M。这些产生的对象在一次交易结束后都会被当成垃圾,也就意味着每秒会产生1M的垃圾。 假设我们只有一台2核4G的服务器,分配给堆的内存一般就1.5G左右,通过计算,可以算出堆中每个区域的大小,如下图: 通过计算可以得出,每400秒,400M的Eden区就满了,会进行一次young GC。98%的垃圾会被回收,意味着将会有8M左右的垃圾进入在survivor转移。一些对象在经过几次young GC之后会进入到老年代中,这种情况Full GC的频率会很低。虽然400秒一次youngGC略微还是快了些,但是对于系统而言基本上没有影响。 (四)特殊业务场景下的预估流程 现在公司打算开展一次一小时的补贴活动,在活动的这一个小时时间内,订单数量可能会是之前的20倍,也就意味着每秒会有800笔订单的产生,每秒会产生20M的垃圾,这下会发生什么呢? Eden区20秒就被占满,20秒执行一次youngGC,此时由于订单过于多,可能部分接口响应会达到几秒甚至几十秒,这些对象在经过几次youngGC之后就会逐步就会进入到老年代中。一般在线上一个小时内出现2次以上FullGC就得告警了。 这种情况下就意味着我们对机器资源以及JVM虚拟机内存需要重新考虑了。 首先考虑提升JVM虚拟机内存,由于硬件限制,JVM虚拟机内存的提高首先要提高机器的性能,我们从双核4G升级成4核8G。分配给堆4.5G的内存。这个时候Eden区就会有1200M的内存,同样条件下,1分钟才会执行一次youngGC。20秒提高到1分钟能保证响应慢的接口对象也能在youngGC中被消灭,而不会进入到老年代中。 同时我们可以把一台机器升级为3台机器,负载均衡后每台机器的订单压力是原来的1/3,youngGC时间提升为原来的3倍,同时接口响应时间加快。基本上3台4核8G的机器就能满足这次活动。 (五)总结 预估之后,并非意味着就完全没问题了,还需要在上线时备好更多机器,防止意外发生。实践能给你带来最好的答案。

优秀的个人博客,低调大师

聊聊各端手势体系以及对 Web 标准手势的思考

「北海 Kraken」是一款基于 Flutter 的 Web 渲染引擎,通过基于 W3C 标准来开发实现前端开发者常用的能力。 Kraken 团队也积极探索定义新的问题以及能力,期望通过参推动标准定制的方式让 Web 技术变得更好。 欢迎大家关注 「北海 Kraken」: http://openkraken.com/ 在过去,早期的 Web 更多用做内容展示的页面,最早从后端框架中直出,再配上各种 CSS 以及 JS 的交互内容,以完成最终对页面内容的展示,那时候的 Web 更多属于 【内容开发】,做内容的直出与展示。而如今现代 Web 开发体系已经有了翻天覆地的变化,早已超出了【内容开发】的范畴,在各个领域都有 JavaScript 的身影。同样,Web 也已经脱离了客户端以及浏览器的限制,各式各样基于 Web 标准或者私有标准的 Web runtime 层出不穷。【Web 应用开发】区别于传统的【内容开发】,它对开发者提出了更高的要求,也对 Web 的能力提出了更高的要求,无论是基于标准化方面的考量,还是基于对易用性的考虑,我们都期望 Web 开发者可以获得通过更高级的封装的标准的高性能的能力。 而手势能力就是其中的一块。 目前在 Web 标准中,手势能力是属于缺失的一块能力,更多的开发者通过 hammer.js 来获得一个通过 JavaScript 模拟出来的手势事件来开发一个手势强交互的应用,或者是直接基于更底层的 Touch event来做进一步的封装。 但是无论是类 hammer.js 的前端手势方案,还是 Touch event的封装,都会导致一些问题,我将从易用性、性能、标准化的角度来做进一步的分析: 易用性: 开发者必须手动去实现或者封装更高一级的手势能力,无法直接从 element 上获得某个高级手势的 event 事件。无论是开发成本,都需要额外加载或者执行额外的 CDN,都是对前端资源的一种损耗。 性能: 通过 JavaScript 实现的方案需要频繁地通过 Bridge 将手势的能力传递到前端,然后再去计算模拟相关的手势事件。频繁的传递数据增加了 Bridge 的消耗,不断执行的 JavaScript 会阻塞 UI 线程,如果需要更强大的手势能力支撑,我们必须进一步封装【竞争场】等能力的实现来达到手势竞争的目的,而这部分能力本应下沉到渲染引擎本身,而不是在 JavaScript 中处理。 标准化: 各个开发者实现的标准不统一,判断的基准不一致,透出的 event 能力不对齐会导致各个平台甚至到各个页面的标准不统一。譬如说在同一个 iOS 设备上访问两个不同开发者开发的页面,不统一的手势能力可能会给用户带来及其糟糕的体验。非标准化的手势能力在各个端上也显得格外突出,下面我介绍各端的手势能力时会介绍这些差异点。 连续手势与离散手势 首先我需要介绍一下连续手势与离散手势的概念,以便读者可以更好地区分这两种手势的不同,以及了解实现不同的手势能力对开发、性能、易用性等纬度的影响。 首先,我们需要知道,由于在端侧有各种各样的屏幕操作的设备,常见的比如说类 apple pencil 的电子笔设备(pen),手指直接触摸操作(touch),还有鼠标(mouse)等。所以在 W3C 标准中, 将所有的接触屏幕的物理设备抽象成了一个 pointer,无论上层是那种物理设备,对于屏幕只感知与抽象这一个触摸到的点,基于 type 区分具体的上层的物理设备。 一个完整的手势包含了手指开始接触屏幕(pointer down),然后手指在屏幕上进行偏移(pointer move),以及手指抬起离开屏幕(pointer up),暂时不讨论 cancel、out 等情况。当然,其中中间 pointer move 的过程是可以省略的,最常见的省略 pointer move 的手势譬如说 click 或者 long press 等(当然,如果点击设备不是一个鼠标而是一根手指,其实手指实际接触是肯定会产生轻微移动情况的,譬如在 FLutter 中,允许这个细微的移动距离在 18 个像素点内,即视为不移动)。可以预见的是未来会有更多的物理设备操作屏(甚至不是屏),基于底层触摸点的 pointer 抽象有利于上层做更多的扩展。 了解了这些,接下来我们来了解一下连续手势与离散手势的差异。 连续手势:从 pointer down 到 pointer moves 到 pointer up,中间过程可以通过 state 状态来描述的手势,可以清楚地通过不同的回调或者不同的状态让开发者感知目前手势所处的状态的手势。常见连续手势:pan。 离散手势:完整手势触发完毕后才会通过回调来通知开发者,无中间状态的转换。常见离散手势:click。 连续手势会频繁通过回调或者状态来通知开发者目前手势所处的状态,我们来看一种情况: element.addEventLisenter('pan', (gestureEvent) => { if (gestureEvent.state === 'up') { // do something... } }) 假设我们需要在 Web 标准中实现 pan 这个手势,如果它是一个连续手势,而我们的场景只需要用 up 这种状态,就需要不断地将当前的状态通过 Bridge 以及 JS engine 传递到 JavaScript 中,这频繁的传递开销是对设备性能的一种浪费。当然,也有框架方案通过更加细分的粒度去解决这个事情,譬如说拆分成 panstart、panupdate、panend等,当开发者不给这些方法注册回调时,可以在框架内部判断并做相应优化。然而细分的 API 抽象不够底层,对于开发者来说也并不那么友好。 而对于离散手势,我们则不需要考虑手势过程中的状态传递,只需要把最终的结果返回给开发者即可,离散手势屏蔽了许多内部处理的细节,保证了开发者注册的回调只能完整的手势操作完以后才能被命中。有效地降低了连续手势数据的传递量。但是相较于连续手势,离散手势的缺点是开发者无法很好地感知中间状态。 接下来我们来看一下各个端上实现的手势体系、优缺点以及差异性。 各端手势体系 hammer.js Pan Pan 的需要有一个最小距离以及方向,只要达到这个条件可以频繁触发。 详见:https://github.com/hammerjs/hammer.js/blob/master/src/recognizers/pan.js#L42 Swipe 距离与速度达到一定阈值的滑动。 详见:https://github.com/hammerjs/hammer.js/blob/master/src/recognizers/swipe.js#L36 Pinch (向外捏时放大,向内捏时缩小) Press (长按,默认时间在 250 ms 以上 ,替代了 long press) 详见:https://github.com/hammerjs/hammer.js/blob/master/src/recognizers/press.js#L78 hammer.js 作为一个前端实现的 gesture lib,通过注册 Touch 事件做封装来完成具体的操作的判断,在前端做手势的方案在前面已经提过,需要不断地通过 Bridge 以及 JS engine 传递到 JavaScript 中,然后才能最终在 JavaScript 中处理手势操作,只要有操作就会被抛到 JavaScript 中进行处理,频繁的传递耗费了许多不必要的性能。我们更希望这部分能力可以下沉到渲染引擎本身,这样可以节省非常多不必要的数据传递开销。 如果在基础手势判断之上想进一步引入更加复杂的【竞技场】等能力,这部分会使得 JavaScript 中的逻辑更加复杂,即便抛开“能不能”在前端做相关实现来说,过多的 JavaScript 运行占用计算资源也是我们并不想要的。 同时,需要单独引入一个 CDN 脚本来支持相关的功能,对于包体积以及首屏也增加了额外的成本。但是又考虑到本身浏览器并不自带这些功能,一般开发者也无法很好地将这套方案优化并下沉到浏览器中,所以在反而在大部分前端业务场景成为来较优的技术选型。 Flutter Tap Double tap Long press (500 ms 以上的长按) Vertical(Horizontal) drag 横(纵)滑 在 drag 上做了进一步封装,在 x 轴或者 y 轴偏移超过最小距离并达到阈值速度可触发。 scale scale 会包含放大缩小以及旋转的手势,相当于其他端中的 Pinch + Rotation Pan Pan 内部实现,需要达到一个最小速度以及最小移动距离的 drag 才能触发 Pan,Pan 是基于 drag 之上的封装,增加了判断。Flutter 内置一个 pointer down + pointer moves + pointer up 只能触发一次手势,所以 Pan 只能触发一次(与 hammer 不同,为有状态手势) 详见: https://github.com/flutter/flutter/blob/master/packages/flutter/lib/src/gestures/monodrag.dart#L579 Flutter 的手势体系除了 Long press 均为连续手势,无离散手势,Tap 也会通过 TapDown、TapUp 等状态来完成。每个中间状态会通过不同的回调函数来支持开发者处理逻辑,返回参数也根据中间状态的不同而不同。排除 Widget 的统一封装来看,跟安卓类似,回调过多,且返回参数不统一,不利于标准化。但是对于内部的手势回调来说,细分的接口各司其职,传递所需的参数都是必须的,开发者可以直接获取具体的返回信息。 iOS Tap(离散手势,100 ms 左右的点击行为) Long Press (连续手势,500 ms 以上的点击行为) Pan (连续手势,平移,类似 drag,但是可以在移动过程中不断变化方向) Swipe (离散手势) Pinch(连续手势,向外捏时放大,向内捏时缩小) Rotation(连续手势,旋转) 为了方便大家了解各个手势的区别,尤其是 Pan 跟 Swipe 的区别,特地放上了iOS 开发者文档的一些图片。 iOS 的手势可以带上多个 touch pointer,同时满足了几个手指操作的能力。比如三指滑动(三根手指的swipe)、双指点击(两根手指的 Tap)等。它提供了开发者对某一个手势处理成一个注册回调函数,通过 state 判断目前手势的状态。离散手势与连续手势共存。 Android View 上直接提供 click 以及 touch 的一些方法 OnDragListener:拖动事件。 OnLongClickListener:长按抬起时的事件。 GestureDetector.OnGestureListener onDown:手势识别器的 down 事件。 onFling: 类似 swipe。 onLongPress: 长按。 onScroll:scroll view 滚动时的事件。 onShowPress:按下后没抬起,相当于(up、move、down 的中间 move 状态,只是没move)。 onSingleTapUp: 点击抬起,对应 onDown。 GestureDetector.OnDoubleTapListener: 双击。 ScaleGestureDetector:旋转,捏,分 begin、onScale、end。 相对来说,Android 的手势体系比较细分,大致上跟 FLutter 比较像,但是 Flutter 是不同手势在不同类中的,Flutter 基本上都是离散手势,安卓很多连续手势,但是更加细分。 标准 综上分析了 Flutter、iOS、Android 以及一个前端实现的 gesture lib(hammer.js),不难发现,每个端实现的手势方案都大同小异。无非都实现了这几种方法: click(Tap)、swipe、Pan、Long Press (Press)、Pinch 与 Rotation(或者 Scale)。但是各个平台对每个手势的实现还是有些许的差异,无论是具体手势的代码逻辑判断还是具体手势的拆分或者命名,均有不同。 那在 Web 技术上,我们应该使用怎么样一套手势规范,来兼顾易用性、性能以及标准化呢?就目前来看,基于 Web 技术体系发展来的 Web runtime 的已经非常多了,诸如 Web、React Native、小程序等体系已经在端侧带来了巨大的运行时碎片化。未来不止于移动端上,还有各种 IOT 设备出现,可能会有越来越多的 Web runtime 会出现。未来可能会有更多领域会有不一样的终端设备,而折叠屏、柔性屏的到来也可能会让端侧的设备(手机、IOT、车载等)形成更多更复杂的的跨端场景,随之而来的也是更多的交互手势来与这些设备进行“沟通交流”。 很遗憾的是目前 W3C 上没有相应的手势规范,我们更期望有一个统一的既定标准来规范,我们也在 W3C 中文兴趣小组上发起了一个讨论,目前此讨论已经提到了 UIEvent。我们期望通过易用性、性能以及标准化这几个纬度去讨论手势规范以及对应的手势标准化能力的必要性,以及最终推动规范建立的可行性,也欢迎更多的小伙伴加入该讨论。 此外,该标准提案目前已经在 北海 Kraken 上实现,开发者可以直接使用 增强的手势能力 来开发复杂的交互应用。后续 北海 Kraken 团队将会在复杂的业务场景上定义出更多问题以及通用能力,期望可以通过参与推动标准定制的方式让 Web 技术变得更好。

优秀的个人博客,低调大师

5G思考发展篇:5G发展正当其时

移动通信技术每十年一代,当前正是全球移动通信网络从4G向5G过渡的时期,我国站在全球前沿布局5G网络推动5G应用创新发展,是满足国家和产业发展需要的恰当决策。 首先,利用5G拓展经济发展空间,是当下国家战略发展需要。 当前,我国已进入以技术创新推动经济发展的新阶段。“十四五”规划纲要强调,必须坚持深化供给侧结构性改革,以创新驱动、高质量供给引领和创造新需求。为保证经济高质量、可持续发展,我国需要通过前沿技术创新来拓宽经济增长空间,而且通过多年的技术追赶和资本积累,我国也已经具备这样的能力和基础。 现阶段建设5G网络探索拓宽经济增长空间是最佳选择。5G是新一轮科技和产业革命中的核心关键技术之一,它将与物联网、大数据、云计算、人工智能等技术融合,不仅有可能形成一系列新业态,成为经济增长的新动能,还有可能为经济社会各领域赋能,带来经济形态乃至社会形态的革命性变化。据中国信息通信研究院预测,预计到2025年,5G可拉动电信运营商网络投资约1.2万亿元;带来的信息消费规模累计将超过8.3万亿元;累计直接带动经济总产出约10.1万亿元。 目前我国是5G技术标准的重要主导者之一,并在设备、网络、应用方面拥有优势。2019年全球5G商用,与全球同步部署5G网络,探索5G应用发展,将有助于把我国领先的技术创新优势转化为市场创新优势,并在这一过程中积累利用技术创新构建新产业、新生态的经验,这种经验对于我国未来的长期发展将弥足珍贵。 当然,作为全球先行者利用5G创新拓展市场空间,不可避免会面临更多的风险和投入。3G/4G时期,我国作为移动通信领域的追随者发展移动互联网,减少了培育商用设备与网络成熟的投入,降低了市场变化不定的风险,取得了巨大的成功。但反观其他发达经济体,它们作为全球3G/4G创新的引领者,虽然为创新承担了更大的风险和成本,但也获得更大的收益,包括确定产品和应用标准的地位、建立产业生态的机会、选择全球最好市场的机会、建立产业门槛的机会等等。风险和收益是成正比的,今天发展的内外部环境已使我国迫切需要参与前沿技术和市场的竞争,所以当前推进5G商业探索和创新是必要的。 其次,移动用户流量增长推动网络扩容,移动网络向5G演进是顺势而为。 近年来,随着移动流量资费的下降和移动互联网应用的丰富,移动用户的流量持续增长。新冠肺炎疫情和“宅家”新生活模式等进一步推高了移动互联网应用需求,短视频、直播、在线视频教育、在线会议等大流量应用场景已成为用户消费的主流应用,推动移动互联网流量迅猛增长。2020年,我国移动互联网接入流量比上年增长35.7%,全年移动互联网月户均流量(DOU)达10.35GB/户·月,比上年增长32%,是2016年月户均流量的13.6倍。随着用户流量的增长,部分一线城市的热点区域高峰时期4G网络利用率已达到90%,用户体验受到影响。移动用户数据流量的不断提升,使得我国原有网络难于支撑众多用户的业务需求,迫切需要能够承载更大容量的网络。 在这一趋势下原有移动网络急需升级扩容,向5G网络演进是大势所趋。我国5G采用中低频段组网,5G与4G基站基本实现同站址,也就是说5G基站数量基本与4G一致。5G单个基站容量是4G基站的10倍以上,价格约为2倍。这意味着5G基站建设的性价比是4G的5倍以上。当然,5G网络还面临基站能耗大、网络需要优化等问题。但总体来看,当前建设5G网络无论是从近期投资还是立足长远都更加有利。 最后,经济社会数字化转型进程加速,需要5G基础设施予以支持。 新冠肺炎疫情在给经济社会带来重大负面冲击的同时,也加快了各领域数字化转型的进程,使5G+多种新兴技术得以更快地融合到千行百业之中。一方面,疫情防控让更多的企业家、管理者认识到数字化的价值和投资的必要性。据清华大学的调查报告显示,企业在疫情结束后有意愿进行数字化转型的企业比例超过53%,远超过去。另一方面,疫情激发了对5G的应用需求。疫情期间“宅”经济迅速发展,5G+高清视频、5G+远程医疗、5G+智慧防控等应用也极大地提高了防疫效率。疫情激发了公众对更大容量、更快速度信息通信的需求,让5G的应用场景变得更加清晰可行。在过去一年里,5G行业应用在多个领域展开探索,目前已在工厂、矿山、港口、医疗、电网、交通、安防、教育、文旅及智慧城市等10个领域,逐步获得业界认可,并初步形成有望规模商用的应用场景。 综上,当前加快5G网络建设,是适合国家、经济社会和产业发展需求的。当然,这并不意味着5G网络建设就是要盲目地大干快上,不考虑投入产出比。我国5G网络要坚持适度超前原则,匹配应用的发展路径和节奏,持续优化建网策略、运营策略和政策环境,不断降低全网的部署成本与运营成本,以尽可能低的成本来支持应用的培育。

优秀的个人博客,低调大师

手机失窃引发的安全思考,“脸”之危局从何说起?

月前,一篇《一部手机失窃而揭露的窃取个人信息实现资金盗取的黑色产业链》(原作者已删除)引发热议。作者老骆驼讲述自己家人手机被盗之后,经历了一场与一伙专业老练、利用窃取个人信息盗取他人银行账户资金的犯罪团伙斗智斗勇的事件。文章提到了众多企业,也引发了众多网友对人脸信息安全的担忧。 黑产窃取个人信息实现资金盗取流程示意 10月10日消息,支付宝相关部门人员回应称,支付宝“非攻”安全实验室的同学第一时间和老骆驼联系上了,并了解了相关情况。回应指出,文章所披露的黑产在支付宝里没套到钱和信息;且支付宝承诺资金被盗全额赔付,包括手机丢失导致的。 在后续的具体回复中,支付宝相关部门人员还指出黑产并没有突破(支付宝)人脸识别,能注册新号是通过其他渠道已掌握的身份信息和短信验证码,在常用设备上实现的。 人脸识别的应用危局 当下,人脸识别技术作为人工智能与大数据技术发展的产物,近年来,随着世界范围内的人脸识别技术研发的突破,已经被广泛应用于如行政服务、金融业务、单位考勤、门禁系统以及司法办案之中。 “人脸解锁”、“刷脸支付”、“刷脸进出”为百姓生活中的一部分,但人们在享受其给工作和生活带来便利的同时,基于此产生的数据隐私安全性问题也引起了社会普遍的关注,如何对其设置更为合理和科学的监管规则来保护个人隐私与数据安全成为时代的难题。 标准所造成的困境 而另一个令人忧心的现实是,当下除开金融机构之外,对个人信息保护并没有一个国家标准,同时由于其性质与金融行业不同,敏感性较低,因此在大多数情况下采用的人脸识别系统都较为落后。 除此之外,根据广西某公司员工爆料,目前市面上人脸识别系统比较大的问题在于买不起。该员工称,她购买国内某个知名CV企业的108点人脸识别系统(注①),对方报价要30余万元,但购买名号稍小的企业系统对方的质量又难以把握。几经挑选,最后选择了某美妆软件的人脸识别系统。 而这又引发了另一个问题,在试图使用人脸识别这一技术的众多企业中,中小企业无力承担优秀系统所带来的成本问题,而较为落后的人脸识别系统虽然便宜,但却有可能影响安全,这几乎成为了一个死循环。 那么在标准的缺失与成本的影响这双重因素下,就极为容易让资本在逐利的过程中产生这样一种举措:“没钱买好的就用相对一般的,左右没有标准规定什么级别的人脸识别技术才允许被使用。” 妥协下的应用 除却上文中的标准问题外,人脸识别自身的技术问题也极易让企业为了用户体验而妥协。 具体来说,图像质量越差,那么人脸识别的准确率就越低。因此在日常应用中,由于模糊、遮挡、大角度、逆光暗光等复杂环境引起的人脸图像质量问题会导致人脸识别准确率过低,需要多次重复识别才能成功,从而整体耗时被大大拉长。 在人脸识别技术的应用中,无论是早已融入我们日常的移动端应用,亦或是人脸识别闸机等安防端应用中,多次识别不通过、不停变换人脸角度等待识别通过的尴尬场景多有遇到。 从用户体验的角度来说,人脸识别对于用户而言并非是不可或缺的“安全选择”,对于移动端用户来说,密码、指纹识别等安防手段早已移植并成熟,而对于闸机等安防端应用所服务的客户来说,指纹、射频卡等原有成熟模式依旧可以为其服务。 这就导致另一个现象,一但用户体验过差,那么轻则将人脸识别技术搁置不用,重则还会对品牌的口碑造成不可挽回的下滑。在这种“胁迫”下,有不少企业选择降低人脸识别技术的关键点位,对用户体验、口碑进行妥协,也是过去人脸识别技术频频被破解的原因之一。 日常威胁不止步于人脸 对于当前的人脸识别危局来说,适当的提升算法可在相当程度上降低人脸识别被破解的风险,例如为支付宝提供技术支持的旷视已具备千点级别关键检测能力。相较于第一代关键点,千点可以将人脸的脸型、眉毛、眼睛、鼻子、嘴等部位完全勾勒出形状,进行更为精确的人脸识别。 另外对于用户的体验而言,实质上可采取技术手段进行弥补而非妥协,去除低质量图片,将筛选后质量符合标准的图像才送往下一个流程中,可令识别效率将大大提升。 基于特征提取原理,可通过神经网络从海量数据中学习获取人脸质量检测关注的特征(主要包括光线、模糊、角度、遮挡、表情、噪声等)并进行质量判断。 而回归日常,就本次事件来说,由于手机号嗅探和短信嗅探,前者可以捕获周围在网的手机号,后者可以在 2G 网络下嗅探到某个手机号的短信。因此即便是你在锁屏状态下隐藏了通知详情,即便是你有 SIM 卡 PIN,攻击者仍然可以通过这种技术获取手机的验证码,进而展开相同的攻击,这一点也值得我们引起注意。 不过令人庆幸的是,无论短信嗅探还是手机号嗅探,都只在 2G 网络下才能进行。当然,这对攻击者并不难,一方面攻击者可以找一个 3G 4G 信号不好只能连入 2G 的环境进行攻击,另一方面攻击者也可以展开降级攻击 将连入 LTE 网络的手机降到 2G,这个技术也算非常成熟的。 怎么防这套攻击呢?很简单,在蜂窝移动网络设置里面将网络模式设置为仅 4G,或者 5G/4G 即可。

优秀的个人博客,低调大师

高德算法工程一体化实践和思考

背景随着高德地图业务的快速开展,除了导航本身的算法业务外,其他中小型业务对算法策略的需求越来越多、越来越快,近两年参与的一些新项目从算法调研到应用上线都在一周级,例如与共享出行相关的各种算法服务,风控、调度、营销等各个体系的业务需求。类似于传统导航中成熟的长周期、高流量、低时延的架构和开发方式已无法满足此类业务初期的快速试错和优化改进诉求,找到合适的为业务赋能的算法服务方式就变得势在必行。 在落地实施的过程中,采用一体化架构。所谓的一体化是指整个算法、工程一体化,涉及数据、系统等全链路打通,实现数据流的系统化流动;算法业务调研兼顾工程服务开发,测试、验证过程自动化、智能化,从而形成业务闭环,推动业务的快速迭代。 项目初期,需要快速试错和策略优化。此时,业务需求的QPS往往不高(<1k),因此,传统的应用开发和部署方式,一方面拖慢

优秀的个人博客,低调大师

关于Java健壮性的一些思考与实践!

程序健壮性非常重要,要怎么玩怎么写才能让程序更加鲁棒呢?我又这么几点小建议。 一、进行统一的业务处理响应 根据蚂蚁金服开放平台的标准返回,一个 response 至少应当有4个返回值。 1、isSuccess:调用是否成功 2、data:返回的响应数据 3、errorCode:错误码 4、errorMsg:错误信息 这就要求我们的接口要有标准的统一的 response ,那怎么实现呢? 1、Spring 切面, JDK 动态代理,Cglib 动态代理等用代理类实现 2、匿名子类,使用一个公共的 Executor 来负责处理所有的请求。 上面两种模式都可以实现标准的 response 的封装,那么具体要封装哪些东西呢?其实最主要的就是统一的 try catch,防止出现任何的 500 错误给到调用方。 ------ 为什么要在最外层去完成呢?------ 因为 500 错误对于调用方来说是致命而且是毫无价值的,无论调用方是前端还是其他的业务系统 ------ 设定统一的错误码 ------ 例如: 参数错误:PARAMETER_ERROR 数据库错误: DATABASE_ERROR 外部系统错误:OUTER_SYSTEM_ERROR 如果有了上面的这些错误码以及错误信息,业务方至少可以告知用户究竟发生了什么事,也可以设定一些列的告警以及自动化运维的方式来处理这些错误。 二、参数检查 在进行真正的逻辑处理前,应当对入参进行一系列的校验,以保持后续业务处理逻辑的轻量,这也是 fast fail 思想的指导,有错误尽早结束处理。 具体是怎样的呢?我们假设参数为 m. if( null == m ){return ;} 进行空判断,防止后续滴啊用m发生 NullPointerException,但这里也不建议抛出NPE,因为看到日志也会很迷惑。 if( StringUtils.isEmpty( m ) ){return ;} 字符串是否为空串 if( CollectionUtils.isEmpty.isEmpty( m ) ){return ;} 集合是否为空或者null try{ JSON.parseObject( m ); return true; } catch(JSONExceptin e){ return false; } 判断字符串是否为 JSON 格式 三、重试机制 对于特定的外部系统错误,可以尝试多次重试这种策略,当然这也是简历在对方的服务是幂等的前提下。这样做在某些网络不稳定的情况下可以提高响应成功率。 四、幂等机制 什么叫幂等?意思就是 无论何时何处何人,只要是先攻的请求,就应当有相同的响应,直到到达终态。 这个原则并不关注上一次的执行结果,企鹅本次结果不应当因为上一次请求的部分成功或者失败而导致某些中间状态不一致导致请求失败。 五、Lambda Optionl.of( target ) .getOrElse( new ArrayList() ) .filter( Object::NotNull) .forEach( () -> {} ) 这种写法可以确保绝大部分的异常不出现,特别是在对于集合进行处理的时候,因为集合中只要有其中一个值是会导致程序失败的,整个程序都会报错。这样写因为对数据做了比较多的检查和兼容,所以出现错误的概率会比较低,但也会有一个弊端,就是当这样的程序都出现异常的时候,开发者一般不知从何查起,要定位出是哪行数据就已经很费劲了。 原文发布时间为:2018-07-17本文作者:大蕉本文来自云栖社区合作伙伴“Java后端技术”,了解相关信息可以关注“Java后端技术”。

优秀的个人博客,低调大师

【小思考】Python的float转换精度损失所想到的

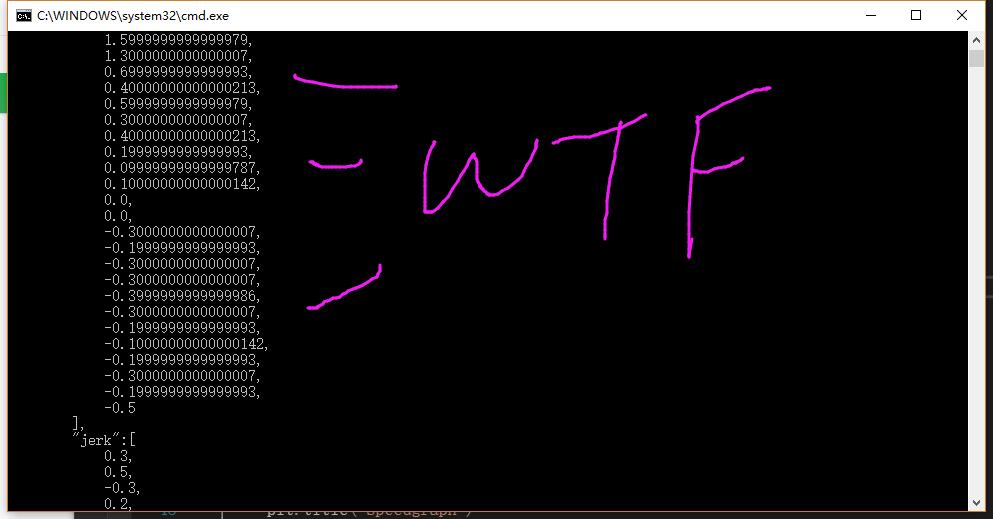
首先,为啥会要讨论这个问题。 我得为昨天拖了小组后腿深表歉意。其实程序逻辑很快就理通了的,但自己总是会因为各种各样的小问题束缚手脚,看接下来这个图片: 稍微有数据敏感性的同学就能看出,中间这么一大堆又是0000又是999还是这么多位的小数,一看就是异常数据。这块数据的产生,源于代码里对两个字符串做了float转换并相减,导致出现了这种数据异常的错误。那么问题来了,1.这种异常是如何产生的?2.有哪些方法可以解决这种问题呢?3.编程中间还有哪些与这个问题相关的注意事项呢? 第一部分:这种异常是如何产生的呢? 我们先来看演示: 看来,直接输出float型数据,以及对字符串进行的float转换,本身并没有什么问题,那么为什么浮点数相减就会出现这个可恶的小尾巴呢?我们有必要从计算机本身数字加减的机制进行探究。有学习过《计算机组成原理》等基本课程、哪怕只是简单了解计算机内部运行机制的同学都明白,计算机内部的加减乘除都是要把数字转化成为二进制实现的。那么,我们此处的浮点数,也要转换为二进制,才能进行计算。Python内浮点数是用机器上浮点数的本机双精度(64 bit)表示的。提供大约17位的精度和范围从-308到308的指数。和C语言里面的double类型相同【可参考C语言double类型的解释】。 我们来看一个简单的例子。十进制1.1转换成二进制是什么数?十进制整数部分转化成二进制,用短除法处以2倒序取余。小数部分转化为二进制是用乘法乘2正序取整。见下面一个浮点数转二进制数的例子。 1.10整数部分就是1,转换成二进制1(这里整数转二进制不再赘述)小数部分:0.10.1*2=0.2取整数部分0,基数=0.20.2*2=0.4取整数部分0,基数=0.40.4*2=0.8取整数部分0,基数=0.80.8*2=1.6取整数部分1,基数=1.6-1=0.60.6*2=1.2取整数部分1,基数=1.2-1=0.20.2*2=0.4取整数部分0,基数=0.4...直至基数为0。1.1用二进制表示为:1.000110...xxxx....(后面表示省略) 关于之前的演示,相当于,因为3.4的存储,发生了精度损失(3.5不会,因为3.5的二进制是11.1,补码存储依然不会发生精度损失),所以在相减的时候,发生了一次精度损失,最后结果存储的时候,再次发生一次精度损失。所以,才会出现最后的小尾巴情况。 第二部分:有哪些方法可以解决这个问题呢? 解决这个问题?不存在的,除非是提高精度——让计算机内能够完整的存储数字的二进制(二进制补码)表示,否则的话,只要有精度损失,就指不定什么时候会冒出来小尾巴。我们追求的解决,自然也是从提高精度,和“表面看起来正确”这两条道路去追求。 提高精度——Python本身自带的float已经是可支持浮点数的最高精度形式。当然,这个肯定是不能阻挡我们对更高精度的要求,这里可以自己实现高精度的数据形式,也可以使用Python扩展模块:Decimal。使用Decimal本身需要导入decimal包,初始化decimal数据可以使用整型数据和字符串,而不能使用float型数据,正如之前我们所说的那样,某些浮点数存储会发生精度损失——这意味着float本身就不够精确。 当然,还有很多抖机灵的方法,比如说结果转换成字符串然后再截取?! 你可能体会不到,这个是一种针对数据波动范围相对确定,相当实用的方法——虽然应该没有任何一个脑子正常的程序员会推崇这种方法。这种方法就是追求的“表面上看起来正确”,你看,最后的显示出来的结果不就是-0.1么? 自然,还有print的%精度控制,这里就不赘述。而且也不想详述这个,毕竟这个惊为天人的字符串截取方法,都还是对字符串进行了处理,而%精度控制只是显示的时候做了处理,可真是够“表面”的。 不得不说,也是受这种方法的启发,本人使用的方法,是利用Python int转换“舍去小数点后所有数字”的特点,把原浮点数乘以需要保留精度的位数,然后转换成整数,再除回去,这样就形成了“表面正确”的数据,效果不要太好。 总结一下!解决这个精度损失带来的“恶魔小尾巴”问题,我们大体上有提高数据格式精度和只追求最终显示改变两大思路。 提高数据格式精度:使用扩展包decimal 只追求最终显示改变:printf %精度控制 ,字符串截取指定位数,先移动小数点、转换成整型舍去末尾、再把小数点移动回来。等方法。 第三部分:编程中间还有哪些和这个问题相关的注意事项呢? 这个小尾巴让我可谓一开始是焦头烂额,也严重耽误了小组研究进度。通过我们之前的探究,可以发现,浮点数本身表示由于受计算机限制,经常是不精确的。所以,日常数据中,最好不要用浮点数。 可能有些人觉得精度损失一些没有什么,然而浮点数的精度损失关键时候可不只只是精度损失,甚至会影响流程控制!浮点数不只有Python里面有,咱们用更加基本的C++来说明这个问题: 当精度损失已经让程序的走向开始不符合逻辑的时候,你还会轻视这个问题么? 这里给广大同仁们分享一篇专门讲解浮点数的文章,深入了解,真的有很多可圈可点之处! 深入了解计算机浮点数机制——程序员必备!

优秀的个人博客,低调大师

量子学习及思考7-量子基本数学知识

NM的才刚入门就是一堆数学知识,可见数学才是一切科学的本源.所谓狗屁科学,只不过是数学的一个实例或者是一个近似的表达而已.越接近数学的,离正确性越近. 本人数学基础太垃圾,好在现在有互联网,本人说过,程序员+互联网=超人,有说过吗?有,只不过现在明确提出这个超人定理: 超人定理:超人=程序员+互联网 我们再看看其它的算法: 计算机系统=软件+硬件 人=肉体+灵魂(就是你大脑里正在运行的程序,或者叫思想) 程序=算法+数据结构 程序员=人+程序 互联网=数据+知识+数据+知识+数据 + ... 超人=肉体+灵魂+算法+数据结构+数据+知识+数据+知识+... 所以这里的程序员并非一般意义上的程序员,而是指可以具有能力无限应用计算机系统及互联网的人,人的精力,时间是有限的,所

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册