首页 文章 精选 留言 我的

精选列表

搜索[orm框架],共10000篇文章
优秀的个人博客,低调大师

Python全栈 Web(Django框架、后台管理,ORM关系)

F查询和Q查询: F() 在之执行中获取某字段的值 F("字段名") 将所有人的年龄加10 form django.db.models import F Author.objects.all().update(age=F("age")+10) def doF_views(request): Author.objects.all().update(age=F('age')+10) return redirect('/07-queryall') Q() 在查询条件中可以完成or操作 Q(条件)|Q(条件) 查询所有id为1或年龄为48的人的信息 form django.db.models import Q Author.objects.filter(Q(id=1)|Q(age=48)) authors = Author.objects.filter(Q(age=30|Q(id__gt=20))) 原生的数据库操作方法: 查询: 函数:raw(sql) Entry.objects.raw(sql) 返回值:QuerySet 增删改: from django.db import connection with connection.cursor() as cursor sql = "delete from ..." cursor.execute(sql) return "" def raw_views(request): sql = "select * from index_author where age>45" authors = Author.objects.raw(sql) for au in authors: print(au.name,au.age,au.email) return HttpResponse("Query OK") 使用后台管理 models 创建后台管理员 ./manage.py createsuperuser username:输入用户名 如果不写默认为系统名称 email Address:电子邮件 Password:密码 Password(agian):重复密码 基本管理: 在应用中的admin.py中注册要管理的数据 1.admin.py 注册需管理的models类 只有在此注册的models类才允许被管理 2.注册models from .models import * admin.site.register(Entry) 通过models类的内部类 meta 来定义展现形式 class Author(models.Model): ... ... class Meta: db_table 指定实体类映射到表的名字 (该属性设置完成后会同步到数据库) verbose_name 定义实体类在admin中现显示的名字(单数) verbose_name_plural 定义实体类在admin中显示的名字(复数) #创建 Author 的实体类 #1.name - 姓名(CharField -> varchar) #2.age - 年龄(IntegerField -> int) #3.email - 电子邮件(EmailField -> varchar) class Author(models.Model): name = models.CharField(max_length=30,verbose_name='姓名') age = models.IntegerField(verbose_name='年龄') email = models.EmailField(null=True,verbose_name='邮件') #表示用户的激活状态:True,表示已激活,False,表示未激活 #由于是新增列,所以必须要给默认值或允许为空 #由于BooleanField默认是不允许为空的,所以此处选择了增加默认值 isActive = models.BooleanField(default=True,verbose_name='激活用户') #增加一个字段,表示用户的头像,可以上传的 picture = models.ImageField(upload_to="static/upload",null=True,verbose_name='头像') # 重写 __str__ ,来定义该对象的字符串表示 def __str__(self): return self.name #增加内部类Meta来定义其展现形式 class Meta: #1.修改表名为author db_table = 'author' #2.指定后台管理时要显示的名字 verbose_name = '作者' verbose_name_plural = verbose_name #3.指定排序规则 ordering = ['-age'] def __repr__(self): return "<Author:%r>" % self.name 高级管理: 在admin.py中创建高级管理类并注册 定义EntryAdmin 类 继承admin.ModelAdmin class AuthorAdmin(admin.ModelAdmin): pass 注册高级管理类 admin.site.register(Entry, EntryAdmin) 允许在EntryAdmin中增加属性 list_display 定义在列表页上显示的字段们 取值: 由属性名组成的元组或列表 list_display_links 定义在列表页也能链接到详情页的字段们 取值: 同上 这里的取值必须要出现在list_display中 list_editable 定义在列表页中允许被修改的字段们 取值: 同上 必须出现在list_display中 但是不能出现在list_display_links中 search_fields 添加允许搜索的字段们 取值 同上 list_filter 列表页的右测增加过滤器 实现快速筛选 date_hierarchy 列表页的顶部增加时间选择器 DateField 或 DateTimeField的列名 fields 在详情页中 指定显示那些字段 并按照什么样式的顺序显示 取值: 由属性名组成的列表或元组 fieldsets 在详情页面中 对字段们进行分组显示的 fieldsets 与 fields不能共存 取值: fieldsets = [ # 分组1 ("分组名称", { "fields":("属性1", "属性2") "classes": ("collapse") }), # 分组2 (), ] from django.contrib import admin from .models import * #声明高级管理类 class AuthorAdmin(admin.ModelAdmin): #指定在列表页中显示的字段们 list_display = ('name','age','email') #指定能够连接到详情页的字段们 list_display_links = ('name','email') #指定在列表页中就允许被修改的字段们 list_editable = ('age',) #指定条件的搜索字段们 search_fields = ('name','email') #指定右侧过滤器 list_filter=('name',) #指定显示的字段以及显示的顺序 # fields = ('name','isActive','email') #指定显示的字段分组 fieldsets = ( #分组1 ('基本信息',{ 'fields':('name','email'), }), #分组2 ('可选信息',{ 'fields':('age','isActive','picture'), 'classes':('collapse',), }) ) class BookAdmin(admin.ModelAdmin): #指定时间选择器 date_hierarchy = "publicate_date" class PublisherAdmin(admin.ModelAdmin): list_display = ('name','address','city','website') list_editable = ('address','city') list_filter = ('address','city') search_fields = ('name','website') fieldsets = ( ('基本选项',{ 'fields':('name','address','city'), }), ( '高级选项',{ 'fields':('country','website'), 'classes':('collapse',) } ) ) # Register your models here. # 注册高级管理类 admin.site.register(Author,AuthorAdmin) admin.site.register(Publisher,PublisherAdmin) admin.site.register(Book,BookAdmin) # 注册普通管理类 admin.site.register(Wife) 关系映射: 一对一的关系映射 语法: 在关联的连个类的任何一个中增加 属性 = models.OneToOneField(Entry) class Author(models.Model): .... class Wife(models.Model); .... # 增加对Author的一对一引用 author = models.OneToOneField(Author) # 在数据库中生成一个外键列在wife表中 要引用自author 表中的主键 # 在Author模型中也会增加一个隐式属性叫wife #引用Author,实现一对一映射 author = models.OneToOneField(Author,verbose_name='相公') 查询: 正向查询: 直接通过关联属性就能获取到关联数据 通过wife找author wife = Wife.objects.get(id=1) author = wife.author 反向查询: 通过反向引用属性查询 通过author找wife author = Author.objects.get(id=1) # 反向引用的属性就是模型类的全小写 wife = author.wife #正向查询 wife = Wife.objects.get(id=1) wife_author = wife.author #反向查询 author = Author.objects.get(id=1) author_wife = author.wife return render(request,'14-oto.html',locals()) 一对多关系映射: 语法: 在"多"的模型中对"一"的模型引用 属性 = models.ForeignKey(Entry) class Publisher(models.Model): .... class Book(models.Model): .... publisher = modelsForeignKey(Publisher) #增加对Publisher的引用(1:M) publisher = models.ForeignKey(Publisher,null=True) 查询: 正向查询: book = Book.objects.get(id=1) publisher = book.publisher 反向查询: django 会默认在publisher中增加book_set属性 来表示对应的所有书籍的查询对象 publisher = Publisher.objects.get(id=1) publisher = publisher.book_set.all() def otm_views(request): # 正向查询:通过Book查询Publisher,在15-otm.html中显示每个book对应的publisher books = Book.objects.all() # 反向查询 pub = Publisher.objects.get(id=1) pub_books = pub.book_set.all() return render(request,'15-otm.html',locals()) 多对多关系映射: 语法: 在关联地 任意一个类中都可以增加 属性 = models.ManyToManyField(Entry) class Author(models.Model): .... class Book(models.Model): .... authors = models.ManyToManyField(Author) #增加对Author的引用(M:N) authors = models.ManyToManyField(Author) 查询: 正向查询; 通过Book查询Author authors 属性只是提供了关联表的查询引用 还需要使用all() values()等方法来获取真实的数据 def mtm_views(request): #正向查询:通过 book 查询 authors book = Book.objects.get(id=1) authors = book.authors.all() #反向查询:通过 author 查询 book author = Author.objects.get(id=2) books = author.book_set.all() return render(request,'16-mtm.html',locals())
优秀的个人博客,低调大师

Django ORM model 操作

from django.db.models import Q,F from user.models import Users 数据基础操作包括增删查改,常用的过滤属性,Q,F库的使用,外键的反向查询 _set() class Users(models.Model): nickname = models.CharField('昵称', max_length=256, null=True) head_portrait = models.CharField('头像', max_length=256, null=True) appkey = models.CharField('appkey', max_length=256, null=True) status = models.CharField('状态', max_length=1, choices=STATUS_CHOICES, default='e') create_date = models.DateTimeField('创建时间', auto_now_add=True) update_date = models.DateTimeField('更新时间', auto_now=True) user = models.ForeignKey('auth.user', verbose_name='用户', null=True, on_delete=models.SET_NULL) class Branch(models.Model): name = models.CharField('公司名称', max_length=128, null=True) code = models.CharField('公司编码', max_length=64, null=True) logo = models.CharField('公司logo', max_length=256, null=True) invitation_code = models.CharField('邀请码', max_length=128, null=True) website = models.CharField('公司网站', max_length=128, null=True) address = models.CharField('地址', max_length=128, null=True) telephone = models.CharField('公司联系电话', max_length=32, null=True) introduction = models.TextField('公司简介', null=True) status = models.CharField('状态', max_length=1, choices=STATUS_CHOICES, default='e') create_date = models.DateTimeField('创建时间', auto_now_add=True) update_date = models.DateTimeField('更新时间', auto_now=True) users = models.ManyToManyField('Users', verbose_name='昵称', null=True, blank=True) # 增加 save users = Users( user_account=user_account, org_id=org ) users.save() # 删除 delete Users.objects.filter(id=user_id).delete() # 修改 update Users.objects.filter(id=user_id).update( user_account=user_account, org_id=org ) # 查询 # 检索记录 get #get获取单个符合条件的记录,没找到或者超过一个都会抛出异常 user = Users.objects.get(id=10) # 检索所有的记录 all user = Users.objects.all() #取前5个 Users.objects.all()[:5] #取第五个到第十个 Users.objects.all()[5:10] # 检索第一条记录 first user = Users.objects.first() # 检索记录条数 count user = Users.objects.count() # 检索记录排序 order_by user = Users.objects.order_by(‘id’) user = Users.objects.order_by(‘id’)[0:1] # 如果需要逆序 在字段前加负号 例 (‘-id’) # 检索记录特定字段 values user = Users.objects.values('id', 'nickname').all() # 返回 指定字段的数据列表 # 这里也可以指定外键字段 使用双下划线指定,返回的键值与values中的参数一致 # 检索记录特定字段 values user = Users.objects.values_list('id', flat=True).all() # 返回 id 列表 # 这里也可以指定外键字段 使用双下划线指定,返回的键值与values中的参数一致 # 条件查询exclude #和filter相反,查找不符合条件的那些记录 # 条件查询 filter # 或条件查询 user = Users.objects.filter(Q(nickname='qxt_common') | Q(nickname=u'系统管理员')).all() # 非条件查询 user = Users.objects.filter(~Q(nickname='administrator')).all() user = Users.objects.exclude(nickname='administrator').all() # 字段名加关键字 例:filter(id__gt='10') # id 大于10 常用的过滤属性 __exact 精确等于 like 'aaa' __iexact 精确等于 忽略大小写 ilike 'aaa' __contains 包含 like '%aaa%' __icontains 包含 忽略大小写 ilike '%aaa%',但是对于sqlite来说,contains的作用效果等同于icontains。 __gt 大于 __gte 大于等于 __lt 小于 __lte 小于等于 __in 存在于一个list范围内 __startswith 以...开头 __istartswith 以...开头 忽略大小写 __endswith 以...结尾 __iendswith 以...结尾,忽略大小写 __range 在...范围内 __year 日期字段的年份 __month 日期字段的月份 __day 日期字段的日 __isnull=True/False __isnull=True 与 __exact=None的区别 # Q # 或 条件查询 user = Users.objects.filter(Q(nickname='qxt_common') | Q(nickname=u'系统管理员')).all() # 非条件查询 user = Users.objects.filter(~Q(nickname='administrator')).all() # F # 例如我们有个统计点击量的字段,每次更新的操作其实就是把字段的值加1. # 一般我们的做法是把这条记录取出来,把相应字段加+1,然后在save: articles = Article.objects.filter(id=self.product_id).first() articles.likes += 1 articles.save() # 使用 F 改写: Article.objects.filter(id=self.product_id).update(likes=F('likes') + 1) # 外键反向查询 # 一对多外键,多对多外键反向查询方法一致 users = Users.objects.all() users.branch_set.all() # 反查 branchs = Branch.objects.all() branchs.users.all() # 正查 # 一对多外键绑定 # 可使用 外键对象,也可以使用外键id直接绑定 # 多对多外键绑定 branchs.users.add(users_obj) branchs.users.add(users_id) # 多对多外键删除 branchs.users.remove(users_obj) branchs.users.remove(users_id) # 多对多删除所有外键 branchs.users.clear() # 批量插入 users_list = [] users_list.append(Users(nickname='11')) users_list.append(Users(nickname='22')) users_list.append(Users(nickname='33')) Users.objects.bulk_create(users_list) distinct 去重 如果需要就一次性取出你所需要的数据 单一动作(如:同一个页面)需要多次连接数据库时,最好一次性取出所有需要的数据,减少连接数据库次数。此类需求推荐使用QuerySet.select_related() 和 prefetch_related() 相反,别取出你不需要的东西,模版templates里往往只需要实体的某几个字段而不是全部,这时QuerySet.values() 和 values_list(),对你有用,它们只取你需要的字段,返回字典dict和列表list类型的东西,在模版里够用即可,这可减少内存损耗,提高性能 同样QuerySet.defer()和only()对提高性能也有很大的帮助,一个实体里可能有不少的字段,有些字段包含很多元数据,比如博客的正文,很多字符组成,Django获取实体时(取出实体过程中会进行一些python类型转换工作),我们可以延迟大量元数据字段的处理,只处理需要的关键字段,这时QuerySet.defer()就派上用场了,在函数里传入需要延时处理的字段即可;而only()和defer()是相反功能 使用QuerySet.count()代替len(queryset),虽然这两个处理得出的结果是一样的,但前者性能优秀很多。同理判断记录存在时,QuerySet.exists()比if queryset实在强得太多了 推荐文章: https://www.sitepoint.com/doing-more-with-your-django-models/

优秀的个人博客,低调大师

🔥xbatis-ddl-auto 1.0.2 ORM DDL,最强 mybatis ORM DDL

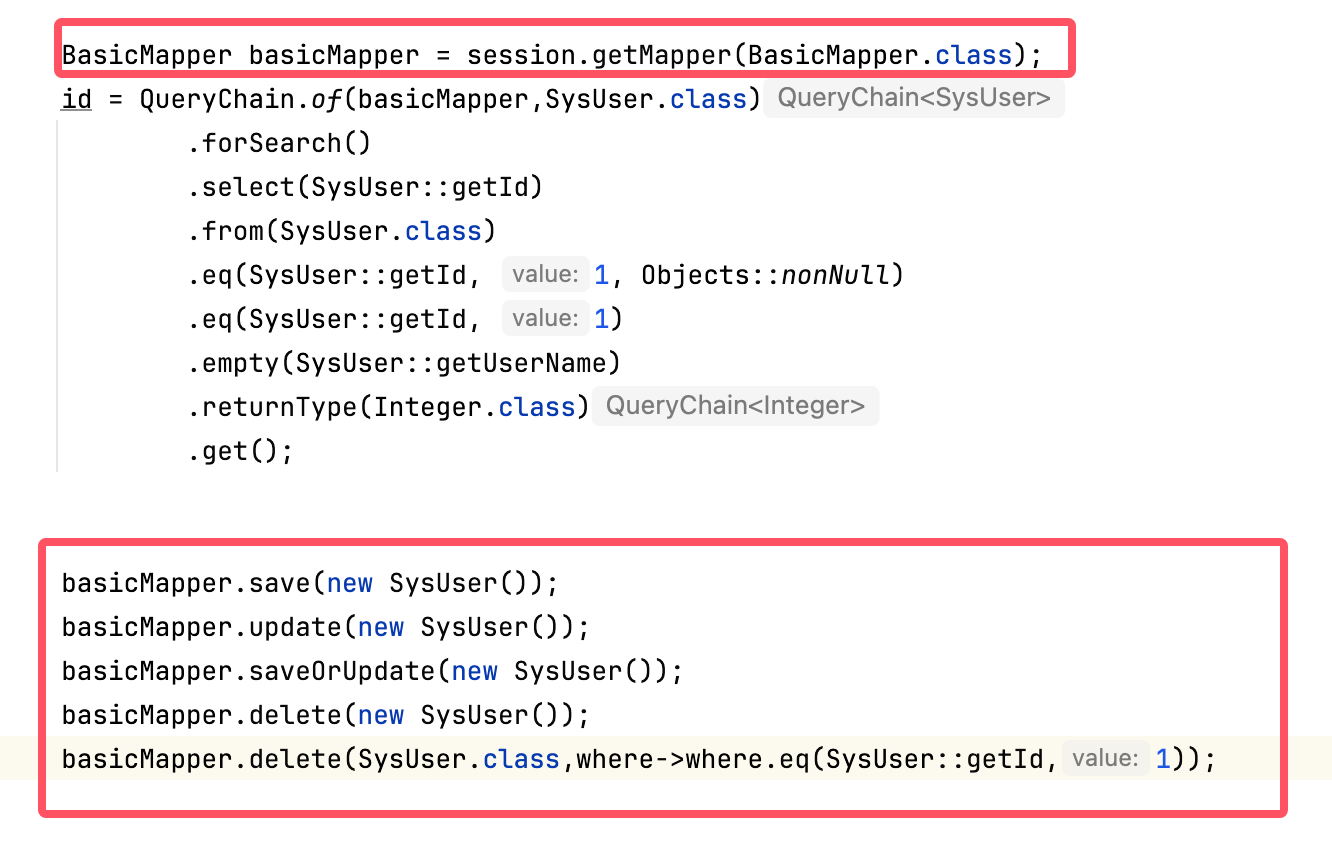
官网 https://xbatis.cn xbatis-ddl-auto 是一个基于 xbatis 实体元数据的轻量自动建表工具。 它复用 xbatis 的 @Table、@TableId、@TableField、@ColumnDefinition 等注解解析结果,根据实体类生成并执行数据库 DDL,提供接近 JPA ddl-auto=create/update 的使用体验,但不引入 JPA 或 Hibernate。 1.0.2 更新 增加SYNC模式,支持 列 索引 变更同步模式 功能 根据 xbatis 实体生成 CREATE TABLE SQL 表不存在时自动建表 表存在时可在 UPDATE 模式下自动追加新增字段 支持只生成 SQL,不执行数据库操作 通过 JDBC DatabaseMetaData 判断表、字段和索引是否存在 支持常见 Java 类型到数据库列类型映射 支持 @ColumnDefinition 配置字段长度、精度、小数位、默认值、唯一约束、非空和字段注释 支持类级 @Index 创建普通索引和唯一索引 安全边界 UPDATE 模式只会自动新增字段和缺失索引,不会自动执行以下高风险操作: 删除数据库已有字段 修改字段类型 修改字段长度 修改字段是否可空 修改默认值 重命名字段 修改或删除已有索引 删除或重建表 这些操作可能造成数据丢失或生产事故,建议通过人工审核 SQL 或专业迁移工具处理。 Maven 本工具 Maven 坐标: <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-ddl-auto</artifactId> <version>1.0.1</version> </dependency> 运行依赖 xbatis core <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-core</artifactId> <version>1.10.6</version> </dependency> 默认测试使用 JUnit 5 和 H2;需要真实数据库的集成测试通过 Maven profile 单独执行。 快速开始 定义 xbatis 实体 import cn.xbatis.db.annotations.ColumnDefinition; import cn.xbatis.db.annotations.Table; import cn.xbatis.db.annotations.TableId; import java.math.BigDecimal; import java.time.LocalDateTime; @Table("sys_user") public class SysUser { @TableId private Long id; @ColumnDefinition(length = 64, nullable = false) private String username; @ColumnDefinition(precision = 10, scale = 2, defaultValue = "0") private BigDecimal balance; private LocalDateTime createdAt; } 执行自动建表: import db.sql.api.DbType; DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); CREATE 模式 CREATE 是默认模式: DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行 CREATE TABLE 表已存在:跳过,不做任何变更 UPDATE 模式 UPDATE 模式用于补新增字段和缺失索引: import cn.xbatis.ddl.auto.Mode; DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行 CREATE TABLE 表已存在:读取数据库已有列和索引,只对实体中新增的字段执行 ALTER TABLE ... ADD COLUMN ...,并创建缺失索引 重复执行 UPDATE 模式不会重复添加已存在字段或已存在索引。 只生成 SQL / 预览 SQL 不连接数据库,只生成建表 SQL: List<String> sqlList = DDLAuto.of(DbType.PGSQL) .add(SysUser.class) .sqlList(); 如果要按当前数据库状态预览将要执行的 SQL,可以传入 DataSource 或 Connection。该方法只读取 JDBC 元数据并生成 SQL,不会执行 DDL: List<String> sqlList = DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .sqlList(dataSource); 行为: 表不存在:返回 CREATE TABLE 及附属 DDL 表已存在且是 CREATE 模式:返回空列表 表已存在且是 UPDATE 模式:只返回缺失字段的 ALTER TABLE ... ADD COLUMN ... 及附属 DDL,以及缺失索引的 CREATE INDEX 也可以使用底层构建器生成单个字段的新增列 SQL: import cn.xbatis.ddl.auto.DDLBuilder; import cn.xbatis.ddl.auto.DefaultDDLBuilder; DDLBuilder builder = new DefaultDDLBuilder(); String sql = builder.addColumnSql(DbType.MYSQL, SysUser.class, "email"); 生产或准生产环境建议先通过 sqlList(dataSource) 或 sqlList(connection) 生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 生产或准生产环境建议先通过 sqlList(dataSource) 或 sqlList(connection) 生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 执行失败时抛出的 SQLException 消息也会包含当前失败 SQL 和失败前已执行 SQL。 支持的注解 @Table 用于解析表名和 schema: @Table("sys_user") public class SysUser { } @TableId 用于识别主键和数据库自增: @TableId private Long id; 默认自增类型为 xbatis 的 IdAutoType.AUTO。 单主键会按数据库方言生成自增片段;联合主键不会为每个主键字段自动生成自增片段。 如果主键使用 IdAutoType.SQL 通过数据库序列取值,会从 sql 中解析序列名并在建表前生成 CREATE SEQUENCE: @TableId(dbType = DbType.Name.PGSQL, value = IdAutoType.SQL, sql = "select nextval('id_test_id_seq')") @TableId(dbType = DbType.Name.ORACLE, value = IdAutoType.SQL, sql = "select id_test_seq.NEXTVAL FROM dual") @TableId(dbType = DbType.Name.SQL_SERVER, value = IdAutoType.SQL, sql = "select next value for id_test_sqlserver_seq") @TableId(dbType = DbType.Name.DB2, value = IdAutoType.SQL, sql = "select next value for id_test_db2_seq from sysibm.sysdummy1") private Long id; 当前支持解析 PostgreSQL:nextval('sequence_name') Oracle / DM:sequence_name.NEXTVAL SQL Server / DB2:NEXT VALUE FOR sequence_name 其他数据库:兜底解析上述常见形式,并生成通用序列 DDL: CREATE SEQUENCE my_sequence START WITH 1 INCREMENT BY 1; UPDATE 模式会读取数据库已有序列,只创建缺失序列,不重复创建。 @ColumnDefinition 用于控制建表字段定义: @ColumnDefinition( length = 64, nullable = false, unique = true, comment = "用户名" ) private String username; 常用配置: length:字符串长度 precision:数值精度 scale:小数位数 defaultValue:数据库默认值 SQL 片段 nullable:是否允许为空 unique:是否唯一 definition:字段类型片段,配置后优先替代 Java 类型到数据库类型的自动推导,length、precision、scale、defaultValue、nullable、unique、comment 等其他配置仍会继续生效 comment:字段注释;MySQL 使用列内联 COMMENT,PostgreSQL / Oracle / DM 使用独立 COMMENT ON COLUMN,SQL Server 使用 sys.sp_addextendedproperty 当 definition 本身没有包含括号参数时,会按配置补齐长度或精度,例如 @ColumnDefinition(definition = "VARCHAR", length = 64) 会生成 VARCHAR(64);如果已经写成 VARCHAR(64),则不会再追加参数。 unique = true 目前表示单字段唯一约束: CREATE 模式下,多数关系型数据库使用列内联 UNIQUE UPDATE 模式新增字段时,SQLite 不支持 ALTER TABLE ADD COLUMN ... UNIQUE,会改为先新增字段再生成 CREATE UNIQUE INDEX ClickHouse 不支持传统唯一约束,配置 unique = true 时会直接抛出异常,避免生成无效 SQL 不支持联合唯一、部分唯一索引、命名唯一约束和已存在字段的唯一约束同步 @Index 用于在实体类上声明数据库索引: import cn.xbatis.db.IndexDirection; import cn.xbatis.db.annotations.Index; import cn.xbatis.db.annotations.IndexField; import cn.xbatis.db.annotations.Table; @Index(name = "idx_sys_user_username", fields = @IndexField(name = "username")) @Index( name = "uk_sys_user_username_created_at", unique = true, fields = { @IndexField(name = "username"), @IndexField(name = "createdAt", direction = IndexDirection.DESC) } ) @Table("sys_user") public class SysUser { } 说明: name:索引名;为空时按表名和列名生成稳定索引名 unique:是否唯一索引 fields:索引字段,name 使用实体字段名,也兼容已映射的列名 direction:索引字段排序,支持 ASC、DESC,默认不追加排序片段 CREATE 模式下,建表后生成 CREATE INDEX UPDATE 模式下,只按索引名创建数据库中缺失的索引,不修改或删除已有索引 ClickHouse 不支持传统 CREATE INDEX 时会直接抛出异常,避免生成无效 SQL PostgreSQL 字段注释会生成额外 SQL: COMMENT ON COLUMN sys_user.username IS '用户名'; SQL Server 字段注释会生成扩展属性 SQL: DECLARE @schema sysname = SCHEMA_NAME(); EXEC sys.sp_addextendedproperty @name=N'MS_Description', @value=N'用户名', @level0type=N'SCHEMA', @level0name=@schema, @level1type=N'TABLE', @level1name=N'sys_user', @level2type=N'COLUMN', @level2name=N'username'; 类型映射 默认类型映射包括: String / Character / UUID -> VARCHAR Integer / int -> INTEGER Long / long / BigInteger -> BIGINT Short / short -> SMALLINT Boolean / boolean -> BOOLEAN、MySQL 为 TINYINT(1) BigDecimal -> DECIMAL(precision, scale) Float / Double -> 浮点类型 byte[] -> 二进制大字段 LocalDate -> DATE LocalTime -> TIME,Oracle / DM 使用 TIMESTAMP LocalDateTime / Timestamp / Date -> TIMESTAMP,MySQL 使用 DATETIME,SQL Server 使用 DATETIME2 普通 enum -> VARCHAR(64) 实现 xbatis EnumSupport<T> 的枚举 -> 按 T 的类型映射,例如 EnumSupport<Integer> -> INTEGER 具体类型会根据 DbType 做方言调整。

优秀的个人博客,低调大师

🔥xbatis-ddl-auto 1.0.1 ORM DDL,最强 mybatis ORM DDL

官网https://xbatis.cn xbatis-ddl-auto 是一个基于 xbatis 实体元数据的轻量自动建表工具。 它复用 xbatis 的@Table、@TableId、@TableField、@ColumnDefinition等注解解析结果,根据实体类生成并执行数据库 DDL,提供接近 JPAddl-auto=create/update的使用体验,但不引入 JPA 或 Hibernate。 功能 根据 xbatis 实体生成CREATE TABLESQL 表不存在时自动建表 表存在时可在UPDATE模式下自动追加新增字段 支持只生成 SQL,不执行数据库操作 通过 JDBCDatabaseMetaData判断表、字段和索引是否存在 支持常见 Java 类型到数据库列类型映射 支持@ColumnDefinition配置字段长度、精度、小数位、默认值、唯一约束、非空和字段注释 支持类级@Index创建普通索引和唯一索引 安全边界 UPDATE模式只会自动新增字段和缺失索引,不会自动执行以下高风险操作: 删除数据库已有字段 修改字段类型 修改字段长度 修改字段是否可空 修改默认值 重命名字段 修改或删除已有索引 删除或重建表 这些操作可能造成数据丢失或生产事故,建议通过人工审核 SQL 或专业迁移工具处理。 Maven 本工具 Maven 坐标: <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-ddl-auto</artifactId> <version>1.0.1</version> </dependency> 运行依赖 xbatis core <dependency> <groupId>cn.xbatis</groupId> <artifactId>xbatis-core</artifactId> <version>1.10.6</version> </dependency> 默认测试使用 JUnit 5 和 H2;需要真实数据库的集成测试通过 Maven profile 单独执行。 快速开始 定义 xbatis 实体 import cn.xbatis.db.annotations.ColumnDefinition; import cn.xbatis.db.annotations.Table; import cn.xbatis.db.annotations.TableId; import java.math.BigDecimal; import java.time.LocalDateTime; @Table("sys_user") public class SysUser { @TableId private Long id; @ColumnDefinition(length = 64, nullable = false) private String username; @ColumnDefinition(precision = 10, scale = 2, defaultValue = "0") private BigDecimal balance; private LocalDateTime createdAt; } 执行自动建表: import db.sql.api.DbType; DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); CREATE 模式 CREATE是默认模式: DDLAuto.of(DbType.MYSQL) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:跳过,不做任何变更 UPDATE 模式 UPDATE模式用于补新增字段和缺失索引: import cn.xbatis.ddl.auto.Mode; DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .execute(dataSource); 行为: 表不存在:执行CREATE TABLE 表已存在:读取数据库已有列和索引,只对实体中新增的字段执行ALTER TABLE ... ADD COLUMN ...,并创建缺失索引 重复执行UPDATE模式不会重复添加已存在字段或已存在索引。 只生成 SQL / 预览 SQL 不连接数据库,只生成建表 SQL: List<String> sqlList = DDLAuto.of(DbType.PGSQL) .add(SysUser.class) .sqlList(); 如果要按当前数据库状态预览将要执行的 SQL,可以传入DataSource或Connection。该方法只读取 JDBC 元数据并生成 SQL,不会执行 DDL: List<String> sqlList = DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .add(SysUser.class) .sqlList(dataSource); 行为: 表不存在:返回CREATE TABLE及附属 DDL 表已存在且是CREATE模式:返回空列表 表已存在且是UPDATE模式:只返回缺失字段的ALTER TABLE ... ADD COLUMN ...及附属 DDL,以及缺失索引的CREATE INDEX 也可以使用底层构建器生成单个字段的新增列 SQL: import cn.xbatis.ddl.auto.DDLBuilder; import cn.xbatis.ddl.auto.DefaultDDLBuilder; DDLBuilder builder = new DefaultDDLBuilder(); String sql = builder.addColumnSql(DbType.MYSQL, SysUser.class, "email"); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 生产或准生产环境建议先通过sqlList(dataSource)或sqlList(connection)生成 SQL 并审核,再决定是否执行。 执行监听 DDL 会按 SQL 列表逐条执行。若中途失败,数据库可能已经保留前面成功执行的 DDL。可以配置执行监听器记录已执行 SQL: import cn.xbatis.ddl.auto.Mode; import cn.xbatis.ddl.auto.DDLExecutionListener; import java.util.ArrayList; import java.util.List; List<String> executedSqlLog = new ArrayList<>(); DDLAuto.of(DbType.MYSQL) .mode(Mode.UPDATE) .executionListener(new DDLExecutionListener() { @Override public void afterExecute(String sql, List<String> executedSqlList) { executedSqlLog.add(sql); } @Override public void onExecuteError(String sql, SQLException exception, List<String> executedSqlList) { // sql 为当前失败 SQL,executedSqlList 为失败前已成功执行的 SQL。 } }) .add(SysUser.class) .execute(dataSource); 执行失败时抛出的SQLException消息也会包含当前失败 SQL 和失败前已执行 SQL。 支持的注解 @Table 用于解析表名和 schema: @Table("sys_user") public class SysUser { } @TableId 用于识别主键和数据库自增: @TableId private Long id; 默认自增类型为 xbatis 的IdAutoType.AUTO。单主键会按数据库方言生成自增片段;联合主键不会为每个主键字段自动生成自增片段。 如果主键使用IdAutoType.SQL通过数据库序列取值,会从sql中解析序列名并在建表前生成CREATE SEQUENCE: @TableId(dbType = DbType.Name.PGSQL, value = IdAutoType.SQL, sql = "select nextval('id_test_id_seq')") @TableId(dbType = DbType.Name.ORACLE, value = IdAutoType.SQL, sql = "select id_test_seq.NEXTVAL FROM dual") @TableId(dbType = DbType.Name.SQL_SERVER, value = IdAutoType.SQL, sql = "select next value for id_test_sqlserver_seq") @TableId(dbType = DbType.Name.DB2, value = IdAutoType.SQL, sql = "select next value for id_test_db2_seq from sysibm.sysdummy1") private Long id; 当前支持解析 PostgreSQL:nextval('sequence_name') Oracle / DM:sequence_name.NEXTVAL SQL Server / DB2:NEXT VALUE FOR sequence_name 其他数据库:兜底解析上述常见形式,并生成通用序列 DDL: CREATE SEQUENCE my_sequence START WITH 1 INCREMENT BY 1; UPDATE模式会读取数据库已有序列,只创建缺失序列,不重复创建。 @ColumnDefinition 用于控制建表字段定义: @ColumnDefinition( length = 64, nullable = false, unique = true, comment = "用户名" ) private String username; 常用配置: length:字符串长度 precision:数值精度 scale:小数位数 defaultValue:数据库默认值 SQL 片段 nullable:是否允许为空 unique:是否唯一 definition:字段类型片段,配置后优先替代 Java 类型到数据库类型的自动推导,length、precision、scale、defaultValue、nullable、unique、comment等其他配置仍会继续生效 comment:字段注释;MySQL 使用列内联COMMENT,PostgreSQL / Oracle / DM 使用独立COMMENT ON COLUMN,SQL Server 使用sys.sp_addextendedproperty 当definition本身没有包含括号参数时,会按配置补齐长度或精度,例如@ColumnDefinition(definition = "VARCHAR", length = 64)会生成VARCHAR(64);如果已经写成VARCHAR(64),则不会再追加参数。 unique = true目前表示单字段唯一约束: CREATE模式下,多数关系型数据库使用列内联UNIQUE UPDATE模式新增字段时,SQLite 不支持ALTER TABLE ADD COLUMN ... UNIQUE,会改为先新增字段再生成CREATE UNIQUE INDEX ClickHouse 不支持传统唯一约束,配置unique = true时会直接抛出异常,避免生成无效 SQL 不支持联合唯一、部分唯一索引、命名唯一约束和已存在字段的唯一约束同步 @Index 用于在实体类上声明数据库索引: import cn.xbatis.db.IndexDirection; import cn.xbatis.db.annotations.Index; import cn.xbatis.db.annotations.IndexField; import cn.xbatis.db.annotations.Table; @Index(name = "idx_sys_user_username", fields = @IndexField(name = "username")) @Index( name = "uk_sys_user_username_created_at", unique = true, fields = { @IndexField(name = "username"), @IndexField(name = "createdAt", direction = IndexDirection.DESC) } ) @Table("sys_user") public class SysUser { } 说明: name:索引名;为空时按表名和列名生成稳定索引名 unique:是否唯一索引 fields:索引字段,name使用实体字段名,也兼容已映射的列名 direction:索引字段排序,支持ASC、DESC,默认不追加排序片段 CREATE模式下,建表后生成CREATE INDEX UPDATE模式下,只按索引名创建数据库中缺失的索引,不修改或删除已有索引 ClickHouse 不支持传统CREATE INDEX时会直接抛出异常,避免生成无效 SQL PostgreSQL 字段注释会生成额外 SQL: COMMENT ON COLUMN sys_user.username IS '用户名'; SQL Server 字段注释会生成扩展属性 SQL: DECLARE @schema sysname = SCHEMA_NAME(); EXEC sys.sp_addextendedproperty @name=N'MS_Description', @value=N'用户名', @level0type=N'SCHEMA', @level0name=@schema, @level1type=N'TABLE', @level1name=N'sys_user', @level2type=N'COLUMN', @level2name=N'username'; 类型映射 默认类型映射包括: String/Character/UUID->VARCHAR Integer/int->INTEGER Long/long/BigInteger->BIGINT Short/short->SMALLINT Boolean/boolean->BOOLEAN、MySQL 为TINYINT(1) BigDecimal->DECIMAL(precision, scale) Float/Double-> 浮点类型 byte[]-> 二进制大字段 LocalDate->DATE LocalTime->TIME,Oracle / DM 使用TIMESTAMP LocalDateTime/Timestamp/Date->TIMESTAMP,MySQL 使用DATETIME,SQL Server 使用DATETIME2 普通enum->VARCHAR(64) 实现 xbatisEnumSupport<T>的枚举 -> 按T的类型映射,例如EnumSupport<Integer>->INTEGER 具体类型会根据DbType做方言调整。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册