首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Android Animation学习笔记

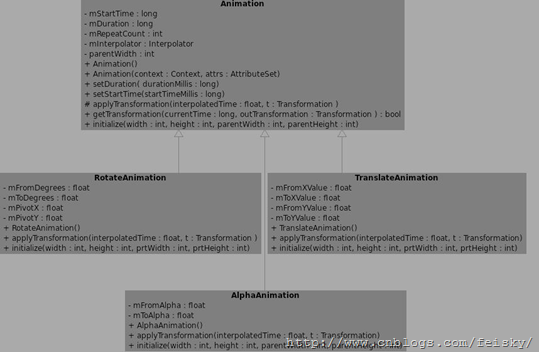
关于动画的实现,Android提供了Animation,在Android SDK介绍了2种Animation模式: 1. Tween Animation:通过对场景里的对象不断做图像变换(平移、缩放、旋转)产生动画效果,即是一种渐变动画; 2. Frame Animation:顺序播放事先做好的图像,是一种画面转换动画。 动画类型 下面先来看看Android提供的动画类型。Android的animation由四种类型组成 在XML文件中: alpha 渐变透明度动画效果 scale 渐变尺寸伸缩动画效果 translate 画面转换位置移动动画效果 rotate 画面转移旋转动画效果 在Java 源码中定义了相应的类,可以使用这些类的方法来获取和操作相应的属性: AlphaAnimation渐变透明度动画效果 ScaleAnimation渐变尺寸伸缩动画效果 TranslateAnimation画面转换位置移动动画效果 RotateAnimation画面转移旋转动画效果 Tween Animation 一个tween动画将对视图对象中的内容进行一系列简单的转换(位置,大小,旋转,透明性)。如果你有一个文本视图对象,你可以移动它,旋转它,让它变大或让它变小,如果文字下面还有背景图像,背景图像也会随着文件进行转换。 使用XML来定义Tween Animation 动画的XML文件在工程中res/anim目录,这个文件必须包含一个根元素,可以使<alpha><scale> <translate> <rotate>插值元素或者是把上面的元素都放入<set>元素组中,默认情况下,所以的动画指令都是同时发生的,为了让他们按序列发生,需要设置一个特殊的属性startOffset。动画的指令定义了你想要发生什么样的转换,当他们发生了,应该执行多长时间,转换可以是连续的也可以使同时的。例如,你让文本内容从左边移动到右边,然后旋转180度,或者在移动的过程中同时旋转,没个转换需要设置一些特殊的参数(开始和结束的大小尺寸的大小变化,开始和结束的旋转角度等等,也可以设置些基本的参数(例如,开始时间与周期),如果让几个转换同时发生,可以给它们设置相同的开始时间,如果按序列的话,计算开始时间加上其周期。 Tween Animation共同的节点属性 属性[类型] 功能 备注 Duration[long] 属性为动画持续时间 时间以毫秒为单位 fillAfter [boolean] 当设置为true ,该动画转化在动画结束后被应用 fillBefore[boolean] 当设置为true ,该动画转化在动画开始前被应用 interpolator 指定一个动画的插入器 有一些常见的插入器 accelerate_decelerate_interpolator 加速-减速 动画插入器 accelerate_interpolator 加速-动画插入器 decelerate_interpolator 减速- 动画插入器 其他的属于特定的动画效果 repeatCount[int] 动画的重复次数 RepeatMode[int] 定义重复的行为 1:重新开始 2:plays backward startOffset[long] 动画之间的时间间隔,从上次动画停多少时间开始执行下个动画 zAdjustment[int] 定义动画的Z Order的改变 0:保持Z Order不变 1:保持在最上层 -1:保持在最下层 表二 XML节点 功能说明 alpha 渐变透明度动画效果 <alpha android:fromAlpha=”0.1″ android:toAlpha=”1.0″ android:duration=”3000″ /> fromAlpha 属性为动画起始时透明度 0.0表示完全透明 1.0表示完全不透明 以上值取0.0-1.0之间的float数据类型的数字 duration为动画持续时间,ms单位 toAlpha 属性为动画结束时透明度 表三 scale 渐变尺寸伸缩动画效果 <scale android:interpolator= “@android:anim/accelerate_decelerate_interpolator” android:fromXScale=”0.0″ android:toXScale=”1.4″ android:fromYScale=”0.0″ android:toYScale=”1.4″ android:pivotX=”50%” android:pivotY=”50%” android:fillAfter=”false” android:startOffset=“700” android:duration=”700″ android:repeatCount=”10″ /> fromXScale[float] fromYScale[float] 为动画起始时,X、Y坐标上的伸缩尺寸 0.0表示收缩到没有 1.0表示正常无伸缩 值小于1.0表示收缩 值大于1.0表示放大 toXScale [float] toYScale[float] 为动画结束时,X、Y坐标上的伸缩尺寸 pivotX[float] pivotY[float] 为动画相对于物件的X、Y坐标的开始位置 属性值说明:从0%-100%中取值,50%为物件的X或Y方向坐标上的中点位置 表四 translate 画面转换位置移动动画效果 <translate android:fromXDelta=”30″ android:toXDelta=”-80″ android:fromYDelta=”30″ android:toYDelta=”300″ android:duration=”2000″ /> fromXDelta toXDelta 为动画、结束起始时 X坐标上的位置 fromYDelta toYDelta 为动画、结束起始时 Y坐标上的位置 表五 rotate 画面转移旋转动画效果 <rotate android:interpolator=”@android:anim/accelerate_decelerate_interpolator” android:fromDegrees=”0″ android:toDegrees=”+350″ android:pivotX=”50%” android:pivotY=”50%” android:duration=”3000″ /> fromDegrees 为动画起始时物件的角度 说明 当角度为负数——表示逆时针旋转 当角度为正数——表示顺时针旋转 (负数from——to正数:顺时针旋转) (负数from——to负数:逆时针旋转) (正数from——to正数:顺时针旋转) (正数from——to负数:逆时针旋转) toDegrees 属性为动画结束时物件旋转的角度 可以大于360度 pivotX pivotY 为动画相对于物件的X、Y坐标的开始位 说明:以上两个属性值 从0%-100%中取值 50%为物件的X或Y方向坐标上的中点位置 下面给出一个完整的XML定义(SDK提供) <set android:shareInterpolator="false" xmlns:android="http://schemas.android.com/apk/res/android"> <scale android:interpolator="@android:anim/accelerate_decelerate_interpolator" android:fromXScale="1.0" android:toXScale="1.4" android:fromYScale="1.0" android:toYScale="0.6" android:pivotX="50%" android:pivotY="50%" android:fillAfter="false" android:duration="700" /> <set android:interpolator="@android:anim/decelerate_interpolator"> <scale android:fromXScale="1.4" android:toXScale="0.0" android:fromYScale="0.6" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" android:fillBefore="false" /> <rotate android:fromDegrees="0" android:toDegrees="-45" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" /> </set> </set> Tween Animation如何使用 使用AnimationUtils类的静态方法loadAnimation()来加载XML中的动画XML文件 //main.xml中的ImageView ImageView spaceshipImage = (ImageView) findViewById(R.id.spaceshipImage); //加载动画 Animation hyperspaceJumpAnimation =AnimationUtils.loadAnimation(this, R.anim.hyperspace_jump); //使用ImageView显示动画 spaceshipImage.startAnimation(hyperspaceJumpAnimation); 如何在Java代码中定义动画 //在代码中定义 动画实例对象 private Animation myAnimation_Alpha; private Animation myAnimation_Scale; private Animation myAnimation_Translate; private Animation myAnimation_Rotate; //根据各自的构造方法来初始化一个实例对象 myAnimation_Alpha=new AlphaAnimation(0.1f, 1.0f); myAnimation_Scale =new ScaleAnimation(0.0f, 1.4f, 0.0f, 1.4f, Animation.RELATIVE_TO_SELF, 0.5f, Animation.RELATIVE_TO_SELF, 0.5f); myAnimation_Translate=new TranslateAnimation(30.0f, -80.0f, 30.0f, 300.0f); myAnimation_Rotate=new RotateAnimation(0.0f, +350.0f, Animation.RELATIVE_TO_SELF,0.5f,Animation.RELATIVE_TO_SELF, 0.5f); interpolator的解释 interpolator定义一个动画的变化率(the rate of change)。这使得基本的动画效果(alpha, scale, translate, rotate)得以加速,减速,重复等。 Interpolator 定义了动画的变化速度,可以实现匀速、正加速、负加速、无规则变加速等。Interpolator 是基类,封装了所有 Interpolator 的共同方法,它只有一个方法,即 getInterpolation (float input),该方法 maps a point on the timeline to a multiplier to be applied to the transformations of an animation。Android 提供了几个 Interpolator 子类,实现了不同的速度曲线,如下: AccelerateDecelerateInterpolator 在动画开始与介绍的地方速率改变比较慢,在中间的时候加速 AccelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始加速 CycleInterpolator 动画循环播放特定的次数,速率改变沿着正弦曲线 DecelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始减速 LinearInterpolator 在动画的以均匀的速率改变 Frame Animation Frame Animation是顺序播放事先做好的图像,跟电影类似。不同于animation package, Android SDK提供了另外一个类AnimationDrawable来定义、使用Frame Animation。 Frame Animation可以在XML Resource定义(还是存放到res\anim文件夹下),也可以使用AnimationDrawable中的API定义。由于Tween Animation与Frame Animation有着很大的不同,因此XML定义的格式也完全不一样,其格式是:首先是animation-list根节点,animation-list根节点中包含多个item子节点,每个item节点定义一帧动画,当前帧的drawable资源和当前帧持续的时间。下面对节点的元素加以说明: XML属性 说明 drawable 当前帧引用的drawable资源 duration 当前帧显示的时间(毫秒为单位) oneshot 如果为true,表示动画只播放一次停止在最后一帧上,如果设置为false表示动画循环播放。 variablePadding If true, allows the drawable’s padding to change based on the current state that is selected. visible 规定drawable的初始可见性,默认为flase; 下面就给个具体的XML例子,来定义一帧一帧的动画: <animation-list xmlns:android="http://schemas.android.com/apk/res/android" android:oneshot="true"> <item android:drawable="@drawable/rocket_thrust1" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust2" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust3" android:duration="200" /></animation-list> 上面的XML就定义了一个Frame Animation,其包含3帧动画,3帧动画中分别应用了drawable中的3张图片:rocket_thrust1,rocket_thrust2,rocket_thrust3,每帧动画持续200毫秒。 然后我们将以上XML保存在res/anim/文件夹下,命名为rocket_thrust.xml,显示动画的代码: AnimationDrawable rocketAnimation;public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); ImageView rocketImage = (ImageView) findViewById(R.id.rocket_image); rocketImage.setBackgroundResource(R.anim.rocket_thrust); rocketAnimation = (AnimationDrawable) rocketImage.getBackground();}public boolean onTouchEvent(MotionEvent event) { if (event.getAction() == MotionEvent.ACTION_DOWN) { rocketAnimation.start(); return true; } return super.onTouchEvent(event);} 代码运行的结果:3张图片按照顺序的播放一次. 有一点需要强调的是:启动Frame Animation动画的代码rocketAnimation.start();不能在OnCreate()中,因为在OnCreate()中AnimationDrawable还没有完全的与ImageView绑定,在OnCreate()中启动动画,就只能看到第一张图片。这里实在拖曳事件中实现的。 下面,阅读Android SDK中对AnimationDrawable的介绍,有个简单的了解: AnimationDrawable 获取、设置动画的属性 int getDuration() 获取动画的时长 int getNumberOfFrames() 获取动画的帧数 boolean isOneShot() Void setOneShot(boolean oneshot) 获取oneshot属性 设置oneshot属性 void inflate(Resurce r,XmlPullParser p, AttributeSet attrs) 增加、获取帧动画 Drawable getFrame(int index) 获取某帧的Drawable资源 void addFrame(Drawable frame,int duration) 为当前动画增加帧(资源,持续时长) 动画控制 void start() 开始动画 void run() 外界不能直接掉调用,使用start()替代 boolean isRunning() 当前动画是否在运行 void stop() 停止当前动画 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/11/1644482.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Service学习笔记

一 什么是Service 服务是运行在后台的一段代码。它可以运行在它自己的进程,也可以运行在其他应用程序进程的上下文(context)里面,这取决于自身的需要。其它的组件可以绑定到一个服务(Service)上面,通过远程过程调用(RPC)来调用这个方法。例如媒体播放器的服务,当用户退出媒体选择用户界面,仍然希望音乐依然可以继续播放,这时就是由服务(service)来保证当用户界面关闭时音乐继续播放的。 它跟Activity的级别差不多,但是他不能自己运行,需要通过某一个Activity或者其他Context对象来调用,Context.startService()和Context.bindService()。两种启动Service的方式有所不同。这里要说明一下的是如果你在Service的onCreate或者onStart做一些很耗时间的事情,最好在Service里启动一个线程来完成,因为Service是跑在主线程中,会影响到你的UI操作或者阻塞主线程中的其他事情。什么时候需要Service呢?比如播放多媒体的时候用户启动了其他Activity这个时候程序要在后台继续播放,比如检测SD卡上文件的变化,再或者在后台记录你地理信息位置的改变等等。 二 如何使用Service 1.第一种是通过调用Context.startService()启动,调用Context.stopService()结束,startService()可以传递参数给Service。 2.第二种方式是通过调用Context.bindService()启动,调用Context.unbindservice()结束,还可以通过ServiceConnection访问Service。 二者可以混合使用,比如说我可以先startService再bindservice。 三 service生命周期 startService后,即使调用startService的进程结束了,Service仍然还存在,直到有进程调用stopService,或者Service自己自杀(stopSelf())。bindService后,Service就和调用bindService的进程同生共死了,也就是说当调用bindService的进程死了,那么它bind的Service也要跟着被结束,当然期间也可以调用unbindservice让Service结束。 两种方式混合使用时,比如说你startService了,我bindService了,那么只有你stopService了而且也unbindservice了,这个Service才会被结束。 Android系统将会尝试保留那些启动了的或者是绑定了服务的进程。如果该服务正在进程的onCreate(), onStart(),或者onDestroy()这些方法中执行时,那么主进程将会成为一个前台进程,以确保此代码不会被停止。如果服务已经开始,那么它的主进程会就重要性而言低于所有可见的进程但高于不可见的进程,由于只有少数几个进程是用户可见的,所以只要不是内存特别低,该服务不会停止.。如果有多个客户端绑定了服务,只要客户端中的一个对于用户是可见的,即认为该服务可见。 如果Service还没有运行,则android先调用onCreate()然后调用onStart();如果Service已经运行,则只调用onStart(),所以一个Service的onStart方法可能会重复调用多次。 stopService的时候直接onDestroy,如果是调用者自己直接退出而没有调用stopService的话,Service会一直在后台运行。该Service的调用者再启动起来后可以通过stopService关闭Service。 所以调用startService的生命周期为:onCreate --> onStart(可多次调用) --> onDestroy 使用context.bindService()启动Service会经历: context.bindService()->onCreate()->onBind()->Service running onUnbind() -> onDestroy() ->Service stop onBind将返回给客户端一个IBind接口实例,IBind允许客户端回调服务的方法,比如得到Service运行的状态或其他操作。这个时候把调用者(Context,例如Activity)会和Service绑定在一起,Context退出了,Srevice就会调用onUnbind->onDestroy相应退出。 所以调用bindService的生命周期为:onCreate --> onBind(只一次,不可多次绑定) --> onUnbind --> onDestory。 所以,在Service每一次的开启关闭过程中,只有onStart可被多次调用(通过多次startService调用),其他onCreate,onBind,onUnbind,onDestory在一个生命周期中只能被调用一次。 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/06/14/1758336.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

docker学习 - docker run

docker run流程 创建容器 通过用户指定的镜像名和tag,在TagStore中查找image_id,获取image对象(本地的image json文件里有镜像信息) 检查镜像layer数(不超过127),镜像层数太多会造成性能问题 将runconfig.Config和image.Config合并 创建{Container.ID}-init和Container.ID镜像的目录,在init layer创建.dockerinit、/etc/hosts、/etc/hostname等, Container.ID镜像是read-write layer 将Container对象持久化到path.Join(Container.ID, “config.json”) 在Daemon.idIndex中注册Container.ID,在Daemon.contSt

优秀的个人博客,低调大师

MaxCompute 学习计划(三)

MapReduce/Graph 当业务逻辑实在是复杂的时候,用SQL配合UDF(包括UDAF和UDTF)也无法实现的时候,可以使用MapReduce或Graph来实现。 作业 MapReduce MapReduce文档里的十多个示例程序每个都很重要,务必每个都看懂每行代码的作用。参考链接文档。 使用Eclipse / InteliJ IDEA配置开发环境,可以修改warehouse里的数据然后观察任务的运行结果的变化。 并用客户端工具运行任务,并了解-classpath和-resources参数的区别。 通过System.out和System.err输出日志信息,并使用Logview观察服务器上的日志。 使用开发工具开发实现开窗函数。 了解沙箱。 数加的大数据开发套件里的Open MR里的每个配置,对应到MR的main函数里是什么?可以参考SDK的说

优秀的个人博客,低调大师

Python 学习笔记 - Memcached

Memcached是一个分布式内存对象缓存系统,他把数据缓存在内存里面来减少对数据库的访问,从而提高动态网页的访问速度。他的基本结构是key/value(键值对)。下面看看在Python里面如何使用。 首先来安装一下服务器端,豆子直接在一个CentOS7的机器上安装 [root@sydnagios~]#yuminstallmemcachedLoadedplugins:fastestmirror,langpacksRepodataisover2weeksold.Installyum-cron?Orrun:yummakecachefastbase|3.6kB00:00epel/x86_64/metalink|2.0kB00:00epel|4.3kB00:00extras|3.4kB00:00updates|3.4kB00:00(1/5):epel/x86_64/group_gz|170kB00:00(2/5):epel/x86_64/updateinfo|671kB00:00 然后服务器端跑起来,这个里面我指定的端口是12000,因此如果有防火墙别忘记打开对应端口 [root@sydnagios~]#memcached-d-m10-uroot-l10.2.1.107-p12000-c256-P/tmp/memcached.pid 参数说明: - d 是启动一个守护进程 - m 是分配给Memcache使用的内存数量,单位是MB - u 是运行Memcache的用户 - l 是监听的服务器IP地址 - p 是设置Memcache监听的端口,最好是 1024 以上的端口 - c 选项是最大运行的并发连接数,默认是 1024 ,按照你服务器的负载量来设定 - P 是设置保存Memcache的pid文件 打开防火墙端口 firewall-cmd--add-port=12000/tcp--permanent 接下来安装Python的客户端模块 从这里下载https://pypi.python.org/pypi/python-memcached 解压拷贝到sys.path对应的目录,就能直接用了 看看第一个例子,可以通过set来设置数据,get来获取数据。里面debug是为了显示错误的 生产环境里面不要用 #!/usr/bin/envpython#-*-coding:utf-8-*-#AuthorYuanLiimportmemcachemc=memcache.Client(['10.2.1.107:12000'],debug=True)mc.set("foo","bar")mc.add("name","John")print(mc.get('foo'))print(mc.get('name'))-----------barJohn memcached的第二个特点是他默认支持集群,原理是内存里面创建一个主机的列表;每个主机有一个权重,权重的数目和主机在列表里面出现的数目成正比。通过算法可以决定把键值对放在哪个服务器的内存里面。 例2 mc=memcache.Client([('1.1.1.1:12000',1),('1.1.1.2:12000',2),('1.1.1.3:12000',1)],debug=True)mc.set('k1','v1') 除了get和set以外,他还具有以下常用函数 add添加一条键值对,如果已经存在的 key,重复执行add操作异常 replacereplace 修改某个key的值,如果key不存在,则异常 set 和 set_multi set 设置一个键值对,如果key不存在,则创建,如果key存在,则修改set_multi 设置多个键值对,如果key不存在,则创建,如果key存在,则修改 delete 和 delete_multi delete 在Memcached中删除指定的一个键值对delete_multi 在Memcached中删除指定的多个键值对 append 和 prepend append 修改指定key的值,在该值 后面 追加内容prepend 修改指定key的值,在该值 前面 插入内容 decr 和 incr incr 自增,将Memcached中的某一个值增加 N ( N默认为1 )decr 自减,将Memcached中的某一个值减少 N ( N默认为1 ) gets 和cas 这个组合可以避免脏数据的产生,如果在gets数据,和cas数据回去这个过程中有其他用户执行了get,那么则不允许修改

优秀的个人博客,低调大师

iOS ARC学习汇总

ARC ARC是什么 ARC是iOS 5推出的新功能,全称叫 ARC(Automatic Reference Counting)。简单地说,就是编译阶段自动做了retain/release,原先需要手动添加的用来处理内存管理的引用计数的代码可以自动地由编译器完成了。就ARC并不是GC,不是运行时内存管理,不会做malloc/free的工作,它只是一种代码静态分析(Static Analyzer)工具。 比如,我们生成一个对象: addretain.png 编译器会给我们添加上retain/release/autorelease add2.png 比如,block的写法,编译器背后给我们做的事: add3.png ARC之前的手工管理内存 我们需要手动retain和 release对象。如下: // First you create an object, which you then own ("retain") // Retain count = 1 Customer *newCustomer = [[Customer alloc] init]; // Next, you do something with the new object, such as add it to an // array, which also now retains it. Retain count = 2 [customerArray addObject:newCustomer]; // When finished with the object, you relinquish (release) ownership. // Retain count = 1 [newCustomer release]; // At some point customerArray is also released, releasing all of the // objects it contains. Retain count = 0, and the original object is // finally deallocated [customerArray release]; 这个过程很容易出错。所以苹果引入ARC,在编译阶段自动帮我们做retain/release的工作,如下图,减少了很多代码。 add4.png 手工引用计数规则 用“alloc”, “new”, “copy”, or “mutableCopy”等方法生成object的时候,object 的引用计数为1. When you create an object, it has a retain count of 1. You create an object using a method whose name begins with “alloc”, “new”, “copy”, or “mutableCopy” (for example, alloc, newObject, or mutableCopy). 向object发送retain消息,它的引用计数+1. When you send an object a retain message, its retain count is incremented by 1. 向object发送release消息,引用计数-1. When you send an object a release message, its retain count is decremented by 1. 向object发送autorelease消息,引用计数-1.当引用计数为0,object被释放 。 When you send an object a autorelease message, its retain count is decremented by 1 at the end of the current autorelease pool block.If an object’s retain count is reduced to zero, it is deallocated. trace_obj.png ARC:自动引用计数 ARC模式下,引用计数的规则还起作用,只是编译器做retain,release,autorelease的工作。 内存管理和引用计数 WWDC Adopting Automatic Reference Counting 翻译 ARC基本规则 参考: Transitioning to ARC Release Notes 规则总结 规则: You cannot explicitly invoke dealloc, or implement or invoke retain, release, retainCount, or autorelease. You cannot use NSAllocateObject or NSDeallocateObject. You cannot use object pointers in C structures. There is no casual casting between id and void *. You cannot use NSAutoreleasePool objects. You cannot use memory zones. You cannot give an accessor a name that begins with new. This in turn means that you can’t, for example, // Won't work: @property NSString *newTitle; // Works: @property (getter=theNewTitle) NSString *newTitle;` Is ARC slow? It depends on what you’re measuring, but generally “no.” The compiler efficiently eliminates many extraneous retain/release calls and much effort has been invested in speeding up the Objective-C runtime in general. In particular, the common “return a retain/autoreleased object” pattern is much faster and does not actually put the object into the autorelease pool, when the caller of the method is ARC code. 引用类型: ARC强引用和弱引用 Strong reference : 强引用指针增加对象引用计数。 Weak reference :弱引用指针不增加对象引用计数,对象被释放后,指针被置为nil 引用关键字: __strong:_strong修饰符表示对对象的“强引用”。持有强引用的变量在超出其作用域时被废弃,随着强引用的失效,引用的对象会随之释放 __weak: 使用_strong修饰符的成员变量在持有对象时,很容易发生循环引用。 循环引用容易发生内存泄露。内存泄露就是应当废弃的对象在超出其生存周期后继续存在。 使用_weak修饰符可以避免循环引用。_weak修饰符还有另一有优点。在持有某对象的弱引用时,若该对象被废弃,则此弱引用将自动失效且处于nil被赋值的状态(空弱引用)。 __unsafe_unretained__ autoreleasing 使用关键字的格式,关键字在*号之后 MyClass * __weak myWeakReference; MyClass * __unsafe_unretained myUnsafeReference; 循环引用 三种循环引用的模式: 对象之间有“父子关系 Delegate模式 Blocks 解决方法: ARC循环引用 管理Autorelease Pools @autoreleasepool-内存的分配与释放 https://developer.apple.com/library/mac/documentation/Cocoa/Conceptual/MemoryMgmt/Articles/mmAutoreleasePools.html#//apple_ref/doc/uid/20000047-CJBFBEDI 使用autorelease pool 的场景: 程序不基于 UI framework. If you are writing a program that is not based on a UI framework, such as a command-line tool. 在循环中生成大量的临时变量,可以在for循环中用autorelease pool block。 If you write a loop that creates many temporary objects. You may use an autorelease pool block inside the loop to dispose of those objects before the next iteration. Using an autorelease pool block in the loop helps to reduce the maximum memory footprint of the application. Cocoa application中的每个线程维护自己的 autorelease pool block堆栈,所以开子线程需要生成自己的autorelease pool block. You must create your own autorelease pool block as soon as the thread begins executing; otherwise, your application will leak objects. (See Autorelease Pool Blocks and Threads for details.) 对象转换 在iOS世界,主要有两种对象:Objective-C 对象和 Core Foundation 对象0。Core Foundation 对象主要是有C语言实现的 Core Foundation Framework 的对象,其中也有对象引用计数的概念,只是不是 Cocoa Framework::Foundation Framework 的 retain/release,而是自身的 CFRetain/CFRelease 接口。 这两种对象间可以互相转换和操作,不使用ARC的时候,单纯的用C原因的类型转换,不需要消耗CPU的资源,所以叫做 Toll-Free bridged 对象转换 Transitioning to ARC Release Notes __bridge` transfers a pointer between Objective-C and Core Foundation with no transfer of ownership. __bridge_retained or CFBridgingRetain casts an Objective-C pointer to a Core Foundation pointer and also transfers ownership to you. You are responsible for calling CFRelease or a related function to relinquish ownership of the object. __bridge_transfer or CFBridgingRelease moves a non-Objective-C pointer to Objective-C and also transfers ownership to ARC. ARC is responsible for relinquishing ownership of the object. 易飞扬,ARC系列 理解ARC强引用和弱引用指针类型 BeginARC WWDC Adopting Automatic Reference Counting 内存管理和引用计数

优秀的个人博客,低调大师

Hbase 学习(三)Coprocessors

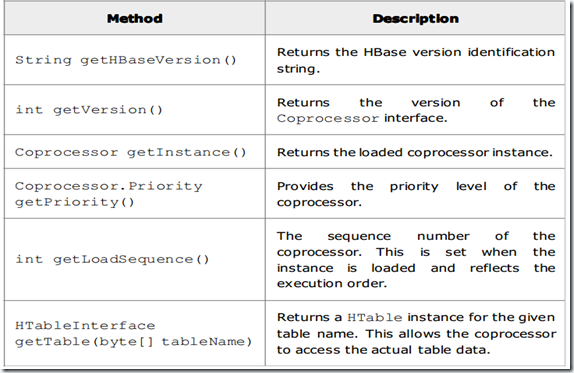
Coprocessors 之前我们的filter都是在客户端定义,然后传到服务端去执行的,这个Coprocessors是在服务端定义,在客户端调用,然后在服务端执行,他有点儿想我们熟悉的存储过程,传一些参数进去,然后进行我们事先定义好的操作,我们常常用它来做一些比如二次索引啊,统计函数什么的,它也和自定义filter一样,需要事先定好,然后在hbase-env.sh中的HBASE_CLASSPATH中指明,就像我的上一篇中的写的那样。 Coprocessors分两种,observer和endpoint。 (1)observer就像触发器一样,当某个事件发生的时候,它就出发。 已经有一些内置的接口让我们去实现,RegionObserver、MasterObserver、WALObserver,看名字就大概知道他们是干嘛的。 (2)endpoint可以认为是自定义函数,可以把这个理解为关系数据库的存储过程。 所有的Coprocessor都是实现自Coprocessor 接口,它分SYSTEM和USER,前者的优先级比后者的优先级高,先执行。 它有两个方法,start和stop方法,两个方法都有一个相同的上下文对象CoprocessorEnvironment。 void start(CoprocessorEnvironment env) throws IOException; void stop(CoprocessorEnvironment env) throws IOException; 这是CoprocessorEnvironment的方法。 Working with Tables 对表进行操作的时候,必须先调用getTable方法活得HTable,不可以自己定义一个HTable,目前貌似没有禁止,但是将来会禁止。 并且在对表操作的时候,不能对行加锁。 Coprocessor Loading Coprocessor加载需要在配置文件里面全局加载,比如在hbase-site.xml中设置。 <property> <name>hbase.coprocessor.region.classes</name> <value>coprocessor.RegionObserverExample,coprocessor.AnotherCoprocessor</value> </property> <property> <name>hbase.coprocessor.master.classes</name> <value>coprocessor.MasterObserverExample</value> </property> <property> <name>hbase.coprocessor.wal.classes</name> <value>coprocessor.WALObserverExample,bar.foo.MyWALObserver</value> </property> 我们自定义的时间可以注册到三个配置项上,分别是hbase.coprocessor.region.classes,hbase.coprocessor.master.classes, hbase.coprocessor.wal.classes上,他们分别负责region,master,wal,注册到region的要特别注意小心,因为它是针对所有表的。 <property> <name>hbase.coprocessor.region.classes</name> <value>coprocessor.RegionObserverExample</value> </property> 注册到这三个触发器上,可以监控到几乎所有我们的操作上面,非常恐怖。。可以说是想要什么就有什么,详细的代码大家自己去摸索。 EndPoint的可以用来定义聚合函数,我们可以调用CoprocessorProtocol中的方法来实现我们的需求。 调用coprocessorProxy() 传一个单独的row key,这是在单独一个region上操作的。 要在所有region上面操作,我们要调用coprocessorExec()方法 传一个开始row key 和结束row key。 Demo 说了那么多废话,我都不好意思再说了,来个例子吧,统计行数的。 public interface RowCountProtocol extends CoprocessorProtocol { long getRowCount() throws IOException; long getRowCount(Filter filter) throws IOException; long getKeyValueCount() throws IOException; } public class RowCountEndpoint extends BaseEndpointCoprocessor implements RowCountProtocol { private long getCount(Filter filter, boolean countKeyValues) throws IOException { Scan scan = new Scan(); scan.setMaxVersions(1); if (filter != null) { scan.setFilter(filter); } RegionCoprocessorEnvironment environment = (RegionCoprocessorEnvironment) getEnvironment(); // use an internal scanner to perform scanning. InternalScanner scanner = environment.getRegion().getScanner(scan); int result = 0; try { List<KeyValue> curVals = new ArrayList<KeyValue>(); boolean done = false; do { curVals.clear(); done = scanner.next(curVals); result += countKeyValues ? curVals.size() : 1; } while (done); } finally { scanner.close(); } return result; } @Override public long getRowCount() throws IOException { return getRowCount(new FirstKeyOnlyFilter()); } @Override public long getRowCount(Filter filter) throws IOException { return getCount(filter, false); } @Override public long getKeyValueCount() throws IOException { return getCount(null, true); } }写完之后,注册一下吧。 <property> <name>hbase.coprocessor.region.classes</name> <value>coprocessor.RowCountEndpoint</value> </property> JAVA 客户端调用 在服务端定义之后,我们怎么在客户端用java代码调用呢,看下面的例子你就明白啦! public class EndPointExample { public static void main(String[] args) throws IOException { Configuration conf = HBaseConfiguration.create(); HTable table = new HTable(conf, "testtable"); try { Map<byte[], Long> results = table.coprocessorExec( RowCountProtocol.class, null, null, new Batch.Call<RowCountProtocol, Long>() { @Override public Long call(RowCountProtocol counter) throws IOException { return counter.getRowCount(); } }); long total = 0; for (Map.Entry<byte[], Long> entry : results.entrySet()) { total += entry.getValue().longValue(); System.out.println("Region: " + Bytes.toString(entry.getKey()) + ", Count: " + entry.getValue()); } System.out.println("Total Count: " + total); } catch (Throwable throwable) { throwable.printStackTrace(); } } } 通过table的coprocessorExec方法调用,然后调用RowCountProtocol接口的getRowCount()方法。 然后遍历每个Region返回的结果,合起来就是最终的结果,打印结果如下。 Region: testtable,,1303417572005.51f9e2251c29ccb2...cbcb0c66858f., Count: 2 Region: testtable,row3,1303417572005.7f3df4dcba3f...dbc99fce5d87., Count: 3 Total Count: 5在上面的例子当中,我们是用Batch.Call()方法来调用接口当中的方法,我们可以用另外一个方法来简化上述代码,来看例子。 Batch.Call call =Batch.forMethod(RowCountProtocol.class,"getKeyValueCount"); Map<byte[], Long> results = table.coprocessorExec(RowCountProtocol.class, null, null, call); 采用Batch.Call方法调用同时调用多个方法 Map<byte[], Pair<Long, Long>> results =table.coprocessorExec( RowCountProtocol.class, null, null, new Batch.Call<RowCountProtocol, Pair<Long, Long>>() { public Pair<Long, Long> call(RowCountProtocol counter) throws IOException { return new Pair(counter.getRowCount(),counter.getKeyValueCount()); } }); long totalRows = 0; long totalKeyValues = 0; for (Map.Entry<byte[], Pair<Long, Long>> entry :results.entrySet()) { totalRows += entry.getValue().getFirst().longValue(); totalKeyValues +=entry.getValue().getSecond().longValue(); System.out.println("Region: " +Bytes.toString(entry.getKey()) +", Count: " + entry.getValue()); } System.out.println("Total Row Count: " + totalRows); System.out.println("Total KeyValue Count: " +totalKeyValues); 调用coprocessorProxy()在单个region上执行 RowCountProtocol protocol = table.coprocessorProxy(RowCountProtocol.class, Bytes.toBytes("row4")); long rowsInRegion = protocol.getRowCount(); System.out.println("Region Row Count: " +rowsInRegion);上面这个例子是查找row4行所在region的数据条数,这个可以帮助我们统计每个region上面的数据分布。

优秀的个人博客,低调大师

Sqoop基础学习(1)

1. Sqoop的导入过程 在开始导入之前,Sqoop会通过JDBC来获得所需要的数据库元数据 1.导入表的列名、数据类型等; 2.接着这些数据库的数据类型(varchar、number等)会把映射成Java的数据类型(String、int等),根据这些信息,Sqoop会生成一个与表名同名的类用来完成反序列的工作,保持表中的每一行记录; 3.Sqoop启动MapReduce作业 4.启动的作业在input的过程中,会通过JDBC读取数据库表中的内容; 5.这是会使用Sqoop生成的类进行反序列话 6.最后再将这些记录写到HDFS中,在写入HDFS的过程中,同样会使用Sqoop生成的类进行序列化。 2. Sqoop的导出过程 1/2 Sqoop根据目标表的结构会生成一个Java类 3.该类作用为序列化和反序列化 4.接着启动一个MapReduce作业 5.在作业中会生成的Java类从HDFS中读取数据 6.并生成一批INSERT语句,每条语句都会向MySQL的目标表中插入多条记录

优秀的个人博客,低调大师

MapReduce设计模式学习

一:概要模式 1:简介 概要设计模式更接近简单的MR应用,因为基于键将数据分组是MR范型的核心功能,所有的键将被分组汇入reducer中 本章涉及的概要模式有数值概要(numerical summarization),倒排索引(inverted index),计数器计数(counting with counter) 2:概要设计模式包含 2.1:关于Combiner和paritioner combiner:reducer之前调用reducer函数,对数据进行聚合,极大的减少通过网络传输到reducer端的key/value数量,适用的条件是你可以任意的改变值的顺序,并且可以随意的将计算进行分组,同时需要注意的是一个combiner函数只对一个map函数有作用 partitioner:许多概要模式通过定制partitioner函数实现更优的将键值对分发到n个reducer中,着这样的需求场景会比较少,但如果任务的执行时间要求很高,数据量非常大,且存在数据倾斜的情况,定制partitioner将是非常有效的解决方案 源码分析请点击 编程实例请点击 2.2:数值概要模式 2.2.1:数值概要模式:计算数据聚合统计的一般性模式 2.2.2:数值概要应用的场景需要满足以下亮点: 1:要处理的数据是数值数据或者计数 2:数据可以按照某些特定的字段分组 2.2.3:适用场景: 1:单词计数 (可以使用combiner) 2:最大值/最小值/计数 (可以使用combiner) 3:平均值 (可以使用combiner,但必须做相应的处理,即迂回算法,举例如下) 给定用户的评论列表,按天计算每小时的评论长度 Map:context.write(1,tuple(1,1小时的平均长度)) reducer: 处理:sum += tulpe.gethour * tuple.getavrg count += tuple.gethour 输出: key=1 value=sum/count 4:中位数/标准差 2.3:倒排索引概要 适用场景:通常用在需要快速搜索查询响应的场景,可以对一个查询结果进行预处理并存储在一个数据库中 倒排索引实战1 倒排索引实战2 2.4:计数器计数 已知应用 统计记录数:简单的对指定时间段的记录数进行统计是很常见的,统计小数量级的唯一实例计数 汇总:用来执行对数据的某些字段进行汇总 二:过滤模式 1:简介 过滤模式也可以被认为是一种搜索形式,如果你对找出所有具备特定信息的记录感兴趣,就可以过滤掉不匹配搜索条件的其他记录,与大多数基础模式类似,过滤作为一种抽象模式为其他模式服务,过滤简单的对某一条记录进行评估,并基于某个条件作出判断,以确定当前这条记录是保留还是丢弃 2:适用场景 2.1:过滤, 使用过滤的唯一必要条件是数据可以被解析成记录,并可以通过非常特定的准则来确定它们是否需要保留,不需要reducer函数 近距离观察数据:准备一个特定的子集,子集中的记录有某些共同属性或者具备某些有趣的特性,需要进一步深入的分析。 跟踪某个事件的线索:从一个较大数据集中抽取一个连续事件作为线索来做案例研究。 分布式grep:通过一个正则表达式匹配每一行,输出满足条件的行 数据清理:数据有时是畸形的,不完整的 或者是格式错误的,过滤可以用于验证每一条数据是否满足记录,将不满足的数据删除 简单随机抽样:可以使用随机返回True or False的评估函数做过滤,可以通过调小true返回的概率实现对结果集合大小的控制 移除低分值数据:将不满足某个特定阀值的记录过滤出去 2.2:布隆过滤, 对每一条记录,抽取其中一个特征,如果抽取的特性是布隆过滤中所表示的值的集合成员,则保留记录 移除大多数不受监视的值:最直接的使用案例是清楚不感兴趣的值 对成本很高的集合成员资格检查做数据的预先过滤: 2.3:Top10,不管输入数据的大小是多少,你都可以精确的知道输出的结果的记录数 异类分析: 选取感兴趣的数据: 引人注目的指标面板: 2.4:去重,过滤掉数据集中的相似数据,找出唯一的集合 数据去重:代码举例 抽取重复值: 规避内连接的数据膨胀: 三:数据组织模式 1:分层结构模式 分层模式是从数据中创造出不同于原结构的新纪录 适用场景:数据源被外部链接,数据是结构化的并且是基于行的 <MultipleInputs类:用于指定多个Mapper任务进行不同格式文件的输入> 2:分区和分箱模式 分区:将记录进行分类(即分片,分区或者分箱),但他并不关心记录的顺序,目地是将数据集中相似的记录分成不同的,更小的数据集,在该模式下数据是通过自定义Map的分区器进行分区的。 分箱:是在不考虑记录顺序的情况下对记录进行分类,目的是将数据集中每条记录归档到一个或者多个举例 两者的不同之处在于分箱是在Map阶段对数据进行拆分,其好处是减少reduce的工作量,通常使资源分布更有效,缺点是每个mapper将为每个可能输出的箱子创建文件,对后续的分析十分不利 3:全排序和混排模式 全排序:关注的是数据从记录到记录的顺序,目的是能够按照指定的键进行并行排序。适用的范围是排序的键必须具有可比性只有这样数据才能被排序 混排序:关注记录在数据集中的顺序,目的是将一个给定的记录完全随机化 4:数据生成模式 四:连接模式 SQL连接模式包括内连接和外连接 eg:A表 B表 内连接:只连接两个表中都用的外键连接(eg 以ID作为连接键,只连接有相同ID) 外连接: 1:做外连接 以用户ID为外键的A+B做外连接 以A表为基准,A表数据全部显示,B表中不在A表中的ID显示为null 2:右外连接 和做外连接相反 3:全外连接 左外连接和右外连接的合并,有相同ID 的显示,没有相同ID的显示为NULL 反连接:全外连接减去内连接的结果 1:reduce端连接: 相当其他连接模式来讲用时最长,但是也是实现简单并且支持所有不同类型的操作 适用场景:1:多个大数据需要按一个外键做链接操作,如果除了一个数据集以外,其他所有的数据集都可以放入内存,可以尝试使用复制连接 2:你需要灵活的执行任意类型的连接操作 等效的SQL:Select user.id,user.location,comment.uprotes from user [inner | left | right] join comments on user.id=comments.userid 优化方案:可以使用布隆过滤器执行reduce端的连接 2:复制连接: 是一种特殊类型的连接操作,是在一个打的数据集和许多小的数据集之间通过MAP端执行的连接的操作,该模式完全消除了混排数据到reduce的需求 适用场景: 1:要执行的连接类型是由内连接或者左外连接,且大的输入数据集在连接操作符的“左边”时 2:除一个大的数据集外,所有的数据集都可以存入每个Map任务的内存中 性能分析:因为不需要reduce,因此在所有连接模式是最快的一种,代价是数据量,数据要能完全的储存在JVM中,这极大的受限于你愿意为每个Map和reduce分配多少内存 3:组合连接: 是一种非常特殊的连接操作,他可以在map端对许多非常大的格式化输入做连接,需要预先组织好的或者是使用特定的方式预处理过的,即在使用这个类型的连接操作之前,必须按照外键对数据集进行排序个分区,并以一种非常特殊的方式读入数据集 Hadoop通过CompositeInputFormat来支持组合连接方式 仅适用于内连接和全外连,每一个mapper的输入都需要按照指定的方式做分区和排序,对于每一个输入数据集都要分成相同数目的分区,此外,对应于某个特定的外链所做的所有记录必须处于同一分区中 通常情况下这发生在几个作业的输出有相同数量的reducer和相同的外键,并且输出文件是不可拆分的即不大于一个hdfs文件快的大小或是gzip压缩的 适用场景: 1:需要执行的是内连接或者全外连接 2:所有的数据集都足够大 3:所有的数据集都可以用相同的外键当mapper的输入键读取 4:所有的数据集有相同的数据的分区 5:数据集不会经常改变 6:每一个分区都是按照外键排序的,并且所有的外键都出现在关联分区的每个数据集中 4:笛卡尔积: 是一种有效的将多个输入源的灭一个记录跟所有其他记录配对的方式 适用场景: 1:需要分析各个记录的所有配对之间的关系 2:没有其他方法可以解决这个问题 3:对执行时间没有限制 等效的SQL:SELECT * FROM t1,t2 等效的PIG:CROSS a,b; 五:元模式 关于模式的模式 1:作业链 针对MapReduce处理小的文件时,优化的办法是可以在作业中始终执行CombineFileInputFormat加载间歇性的输出,在进入mapper处理之前,CombineFileInputFormat会将小的块组合在一起形成较大的输入split当执行做个作业的作业链时,可以使用job.submit方法代替job.waitForCompletion()来并行的启动多个作业,调用submit方法后会立即返回至当前线程,而作业在后台运行,该方法允许一次执行多个任务,job.isComplete()是检查一个作业是否完成的非阻塞方法,该方法可以通过不断轮询的方式判断所有作业是否完成如果检测到一个依赖的作业失败了,此时你应该退出整个作业链,而不是试图让他继续示例:(1)基本作业(2)并行作业链(3)关于Shelll脚本(4)关于JobControl 2:链折叠 链折叠是应用于MapReduce作业链的一种优化方法,基本上他是一个经验法则,即每一条记录都可以提交至多个mapper或者一个reducer,然后再交给一个mapper这种合并处理能够减少很多读取文件和传输数据的时间,作业链的这种结构使得这种方法是可行的,因为map阶段是完全无法共享的,因此map并不关心数据的组织形式和或者数据有没有分组,在构建大的作业链时,通过将作业链折叠,使得map阶段合并起来带来很大的性能提升链折叠的主要优点是减少mapreduce管道中移动的数据量作业链中有许多模式,可以通过下面介绍的这些方法来查找和确认哪些可以折叠(1)看看作业链的map阶段,如果多个map阶段是相邻的,将他们合并到一个阶段(2)如果作业链是以map阶段结束,将这个阶段移动到前一个reducer里边,他除去了写临时数据的IO操作,然后在reduce中执行只有map的作业,这同一也能减少任务启动的开销(3)注意,作业链的第一个map阶段无法 从下一个优化中获益,尽可能的在减少数据量(如过滤)的操作和增加数据量(如丰富)的操作之间拆分每个map阶段(合并或者其他)注意:(1)合并阶段需要大量的内存,例如将5个复制连接合并在一起可能不是一个好的选择,因为他将可能超过任务可用的总内存,在这些情况下,最好将这些操作分开(2)不管一个作业是不是作业链,都要尽早尽可能的去过滤掉更多的数据,mr作业开销最大的部分通常都是管道推送数据:加载数据,混排/排序阶段,以及存储数据实现折叠链有两种主要方法:(1)手动裁剪然后将代码粘贴在一起(2)使用特殊类ChainMapper和ChainReducer(特殊类介绍参考:http://www.iteye.com/topic/1134144) 3:作业归并 和作业链折叠一样,作业归并是另一种减少MR管道IO管道的优化方法,通过作业归并可以使得加载同一份数据的两个不相关作业共享MR管道,作业归并最主要的优点是数据只需要加载和解析一次。先决条件是:两个作业必须有相同的中间键和输出格式,因为他们将共享管道,因而需要使用相同的数据类型,如果这的确是一个问题的话,可以使用序列化或者多态,但会增加复制度作业归并步骤如下:(1)将两个mapper代码放在一起(2)在mapper中生成键和值时,需要用标签加以标记,以区别map源(3)在reducer中,在解析出标签后使用if语句切换到相应的reducer代码中去执行(4)使用multipleOutputs将作业的输出分来 六:输入输出模式 自定义输入与输出 在hadoop自定义输入和输出 Hadoop允许用户修改从磁盘加载数据的方式,修改方式有两种: 1:配置如何根据HDFS的块生成连续的输入分块,配置记录在map阶段如何实现。 为此将要用到的两个类即,RecordReader和InputFormat 2:hadoop也允许用户通过类似的方式修改数据的存储形式 通过OutputFormat和RecordWriter实现 1:生成数据 这个模式下是只有Map的 (1)InputFormat凭空创建split (2)RecordReader读入虚的split并根据他生成随机记录 (3)某些情况下,能够在split中赋予一些信息,告诉recordreader生成什么 (4)通常情况下,IdentityMap仅仅将读入的数据原样输出 2:外部源输出 外部源输出详细描述:在作业提交之前,OutputFormat将验证作业配置中指定的输出规范。RecordReader负责将所有的键值对写入外部源 性能分析:必须小心数据接收者能否处理并行连接。有1000个任务将数据写入到单个SQL数据库中,者=这工作起来并不好,为避免这种情况你可能不得不让每个reducer多处理一些数据以减少写入到数据接收者的并行度,如果数据接收者支持并行写入,那么这未必是个问题。 3:外部源输入 在MapReduce中数据是以并行的方式加载而不是以串行的方式,为了能够大规模的读取数据,源需要有定义良好的边界 MR实现该模式的瓶颈将是数据源或网络,数据源对于多连接可能不具很好的扩展性,同时给定的数据源可能与MR集群的网络不在同一个网络环境下 4:分区裁剪 分区裁剪模式将通过配置决定框架如何选取输入split以及如何基于文件名过滤加载到MR作业的文件 描述:分区裁剪模式是在InputFormat中实现的,其中getsplit方法是我们需要特别注意的,因为他确定了要创建的输入split,进而确定map任务的个数, RecordReader的实现依赖于数据是如何存储的

优秀的个人博客,低调大师

【整理】Hadoop学习资料

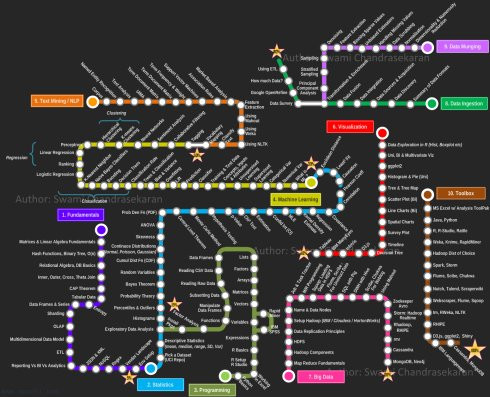
Hadoop视频资料: http://pan.baidu.com/s/1o7YPdTC 注:有些视频是转载的,没有解压密码!so sorry!!! Hadoop运维全纪录: http://blog.51cto.com/zt/505 加入群【clouderahadoop】:258669058不定期发布资料的word文档、个人在工作中的遇见的bug和心得! Hadoop 的调优和运维对于 Hadoop 来说是很重要的一个环节。对于大规模数据集来说更是如此。 性能调优对于 Hadoop 来说无异于打通“任督二脉”,对于 Hadoop 的计算能力会有质的提升, 而运维之于 Hadoop 来说,就好像"金钟罩,铁布衫"一般,有了稳定的运维, Hadoop 才能在海量数据中大展拳脚,两者相辅相成,缺一不可。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册