首页 文章 精选 留言 我的

精选列表

搜索[知识库增强],共10000篇文章
优秀的个人博客,低调大师

JeeSite V5.3.2 发布,CMS 增强,Java 快速开发平台

升级内容 新增 CMS 增加 ES 全文检索功能 新增 CMS 页面高速缓存网页静态化缓存 新增 CMS 的栏目权限(基于数据权限配置) 新增 ELK 日志搜集、可视化查询分析系统配置及文档 新增 Global.getConfigToArray、getPropertyToArray、getConfigToLong 方法 新增 PropertiesUtils.getPropertyToArray 方法 新增 js.addTabPage 方法增加 lazyload 懒加载参数 新增 开源 jeesite-module-app 手机端服务模块 优化 缓存管理 当 key 出现特殊字符的时候,也可以读取显示 优化 PropertiesUtils 支持多个 profiles 获取 优化 CMS 根据栏目查询,包含下级栏目的文章 优化 Log 访问日志查询功能优化改进 优化 微服务下的 job 实例名称默认配置参数 优化 idea 检测不到 SentinelApplication 的问题 修正 Vue 树表切换不同上级的时候,没有更新辅助字段问题 修正 DataGrid 防止有冻结列的时候进行全部隐藏和显示后出现重复列问题 #I6Y5SQ 修正 CMS 的 ViewConfig 配置存取问题 升级依赖jodconverter 4.4.6 Vue分离端 升级依赖vite4.3.1、antdv3.2.17、等等 新增 根据角色分配用户、取消角色授权、查询功能 优化 主题抽屉,可以点击遮罩关闭,遮罩为透明色 优化 表单验证规则默认修改为blur,解决下拉框选择扔提示验证空的问题 优化 ListSelect 组件 setSelectList 方法接口,方便设置选择 优化 Upload 上传文件类型从后台获取参数 增加 Table 表头自定义过滤实例 升级方法 修改pom.xml文件中的jeesite-parent版本号为5.3.2-SNAPSHOT 如果你修改了parent、common、core项目源码,请与git上的代码进行同步 如果你是跨版本升级,请注意每一个版本的升级方法,业务上有调整的地方进行修改 执行root/package.bat(sh)打包脚本,强制更新依赖。 Vue分离端升级 默认表单验证规则有change 修改为 blur,可能会对你现有表单验证产生影响 请与jeesite-vue代码仓库源码进行同步,合并代码,手动解决冲突代码。 匹配后端版本为JeeSite v5.3.2,可以兼容JeeSite v5.1.0+ 了解更多 JeeSite 官网地址:http://jeesite.com JeeSite 在线文档:http://docs.jeesite.com JeeSite 演示地址:http://demo.jeesite.com JeeSite Vue 演示地址:http://vue.jeesite.com JeeSite 源码仓库:https://gitee.com/thinkgem/jeesite4 JeeSite Vue 前端源码:https://gitee.com/thinkgem/jeesite-vue JeeSite 跨平台手机端:https://gitee.com/thinkgem/jeesite4-uniapp JeeSite Cloud 微服务:https://gitee.com/thinkgem/jeesite4-cloud JeeSite 客户端安装程序:https://gitee.com/thinkgem/jeesite-client

优秀的个人博客,低调大师

ModStartBlog v6.6.0 多语言增强,缓存后台优化

ModStart 是一个基于 Laravel 模块化极速开发框架。模块市场拥有丰富的功能应用,支持后台一键快速安装,让开发者能快的实现业务功能开发。 系统完全开源,基于 Apache 2.0 开源协议。 功能特性 丰富的模块市场,后台一键快速安装 会员模块通用且完整,支持完整的API调用 大文件分片上传,进度条显示,已上传文件管理 强大的模块扩展功能,所有模块可以无缝集成,支持在线安装、卸载模块 完善的开发助手,实现模块、主题的的一键创建 完善的后台权限管理,支持基于RBAC的权限管理系统 后台管理支持使用手机、平板、PC,无论何时何地都可方便管理 第三方登录(QQ、微信、微博、支付宝、微信小程序) 第三方支付支持(微信、支付宝、支付宝当面付、微信扫码、微信小程序) 第三方云存储支持,支持云储存分片上传(阿里云、百度云、华为云、腾讯云、FTP、七牛云、UCloud、又拍云) 第三方短信支持(阿里云、腾讯云、华为云、百度云、253云通讯、聚合、七牛云、融云、赛邮、UCloud、云片、网易云) V6.6.0版本更新 2023年02月02日ModStartBlog发布v6.6.0版本,增加了以下14个特性: [新功能] 多语言文件支持放置在 resources/lang 目录下 [新功能] 轮播图底部导航图标显示优化 [新功能] 调整HTML过滤规则缓存目录为 cache/purifier [新功能] MS.header前端组件对象获取支持多个头部 [系统优化] 文件上传兼容多云存储驱动,可配置 [系统优化] 多层代理获取真实IP异常问题 [系统优化] 性能跟踪代码性能优化,提升执行效率 [系统优化] 后台升级图标样式,大小显示优化 [系统优化] 后台页面Tab点击触发时鼠标移动忽略规则 [系统优化] 后台管理员日志记录数据序列化优化 [Bug修复] 导航栏新窗口打开异常问题修复 [Bug修复] 后台多标签页面关闭窗口样式激活修复 [Bug修复] 组件SelectRemote和CanCascade条件显示异常问题 [Bug修复] 导航轮播适配最新版本方法调用 模块市场一键安装 系统内置模块市场,有行业应用、插件、云存储、云短信等功能模块,后台支持一键安装、启用、禁用、卸载,可快速搭建属于自己的系统应用。 系统演示与文档 码云仓库:https://gitee.com/modstart/ModStartBlog Github仓库:https://github.com/modstart/ModStartBlog 系统演示:https://blog.demo.tecmz.com/ 下载试用:https://modstart.com/download 开发者文档:https://modstart.com/doc 模块市场:https://modstart.com/store

优秀的个人博客,低调大师

ohUrlShortener 短链接系统 v1.6 发布,统计功能增强

上个版本发布之后,ohUrlShortener 短链接系统收到热心网友们提出的不少问题,这个版本中对遗留的 issue 进行了处理,主要变化内容包括: 重新设计了统计功能的实现方法,解决统计页面相应超时或卡顿等情况 升级 Base58 相关库 btcsuite/btcutil 到 btcd/btcutil 并升级版本 Dashboard 页面新增更加丰富的统计指标 处理批量新增短链接时可能出现的重复 bug 其他部分必要的改进 详细提交记录可以查阅https://gitee.com/barat/ohurlshortener/commits/main ohUrlShortener 是适合中小型社区网站使用的短链接服务系统,支持短链接生产、查询及302转向,并自带点击量统计、独立IP数统计、访问日志查询: 支持 Docker One Step Start 部署、Makefile 编译打包 支持短链接生产、查询、存储、302转向 支持访问日志查询、访问量统计、独立IP数统计 支持 HTTP API 方式新建短链接、禁用/启用短链接、查看短链接统计信息、新建管理员、修改管理员密码 支持访问日志导出,方便线下分析

优秀的个人博客,低调大师

ohUrlShortener 短链接系统 v1.5 发布,管理功能增强

距上一个版本更新快2个月了,ohUrlShortener 短链接系统今天正式发布 v1.5 版本,该版本主要的变化包括: 新增:短链接已,重复短链接的判断及提示 新增:删除短链接功能(界面及API) bugfix:修复了一处 SQL 视图,解决统计面板中数字不准确的问题 其他一些必要的系列更新 从这个版本开始,ohUrlShortener 将使用 GoReleaser 打包、checksum 制作、deb/rpm/tar.gz 等生成、及二进制程序签名。 在使用二进制下载包之前,强烈推荐验证 checksum 已保证程序未被第三方修改。 新版本下载:https://gitee.com/barat/ohurlshortener/releases/v1.5 ohUrlShortener 适合中小型社区网站使用的短链接服务系统,支持短链接生产、查询及 302 转向,并自带点击量统计、独立 IP 数统计、访问日志查询: 支持 Docker One Step Start 部署、Makefile 编译打包 支持短链接生产、查询、存储、302 转向 支持访问日志查询、访问量统计、独立 IP 数统计 支持 HTTP API 方式新建短链接、禁用 / 启用短链接、查看短链接统计信息、新建管理员、修改管理员密码 详情介绍请访问 https://gitee.com/barat/ohurlshortener

优秀的个人博客,低调大师

XXL-JOB v2.3.1 发布 | 稳定性增强

v2.3.1 Release Notes 1、【修复】修复风险漏洞,升级问题低版本项目依赖:CVE-2021-2471、CVE-2022-22965等。 2、【修复】修复故障告警逻辑,邮箱校验逻辑下放至EmailJobAlarm中,避免对其他告警方式的干扰。 3、【优化】调度通讯默认启用accessToken,提升系统安全性(建议生产环境自定义accessToken)。 4、【优化】合并多项PR,项目代码结构、健壮性优化:PR-2833、PR-2812、PR-2541、PR-2537、PR-2514、PR-2509、PR-2591。 5、【优化】任务线程名优化,提升可读性与问题定位效率(ISSUE-2527)。 简介 XXL-JOB是一个轻量级分布式任务调度平台,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。现已开放源代码并接入多家公司线上产品线,开箱即用。 文档地址 中文文档 技术交流 社区交流 特性 1、简单:支持通过Web页面对任务进行CRUD操作,操作简单,一分钟上手; 2、动态:支持动态修改任务状态、启动/停止任务,以及终止运行中任务,即时生效; 3、调度中心HA(中心式):调度采用中心式设计,“调度中心”自研调度组件并支持集群部署,可保证调度中心HA; 4、执行器HA(分布式):任务分布式执行,任务"执行器"支持集群部署,可保证任务执行HA; 5、注册中心: 执行器会周期性自动注册任务, 调度中心将会自动发现注册的任务并触发执行。同时,也支持手动录入执行器地址; 6、弹性扩容缩容:一旦有新执行器机器上线或者下线,下次调度时将会重新分配任务; 7、路由策略:执行器集群部署时提供丰富的路由策略,包括:第一个、最后一个、轮询、随机、一致性HASH、最不经常使用、最近最久未使用、故障转移、忙碌转移等; 8、故障转移:任务路由策略选择"故障转移"情况下,如果执行器集群中某一台机器故障,将会自动Failover切换到一台正常的执行器发送调度请求。 9、阻塞处理策略:调度过于密集执行器来不及处理时的处理策略,策略包括:单机串行(默认)、丢弃后续调度、覆盖之前调度; 10、任务超时控制:支持自定义任务超时时间,任务运行超时将会主动中断任务; 11、任务失败重试:支持自定义任务失败重试次数,当任务失败时将会按照预设的失败重试次数主动进行重试;其中分片任务支持分片粒度的失败重试; 12、任务失败告警;默认提供邮件方式失败告警,同时预留扩展接口,可方便的扩展短信、钉钉等告警方式; 13、分片广播任务:执行器集群部署时,任务路由策略选择"分片广播"情况下,一次任务调度将会广播触发集群中所有执行器执行一次任务,可根据分片参数开发分片任务; 14、动态分片:分片广播任务以执行器为维度进行分片,支持动态扩容执行器集群从而动态增加分片数量,协同进行业务处理;在进行大数据量业务操作时可显著提升任务处理能力和速度。 15、事件触发:除了"Cron方式"和"任务依赖方式"触发任务执行之外,支持基于事件的触发任务方式。调度中心提供触发任务单次执行的API服务,可根据业务事件灵活触发。 16、任务进度监控:支持实时监控任务进度; 17、Rolling实时日志:支持在线查看调度结果,并且支持以Rolling方式实时查看执行器输出的完整的执行日志; 18、GLUE:提供Web IDE,支持在线开发任务逻辑代码,动态发布,实时编译生效,省略部署上线的过程。支持30个版本的历史版本回溯。 19、脚本任务:支持以GLUE模式开发和运行脚本任务,包括Shell、Python、NodeJS、PHP、PowerShell等类型脚本; 20、命令行任务:原生提供通用命令行任务Handler(Bean任务,"CommandJobHandler");业务方只需要提供命令行即可; 21、任务依赖:支持配置子任务依赖,当父任务执行结束且执行成功后将会主动触发一次子任务的执行, 多个子任务用逗号分隔; 22、一致性:“调度中心”通过DB锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行; 23、自定义任务参数:支持在线配置调度任务入参,即时生效; 24、调度线程池:调度系统多线程触发调度运行,确保调度精确执行,不被堵塞; 25、数据加密:调度中心和执行器之间的通讯进行数据加密,提升调度信息安全性; 26、邮件报警:任务失败时支持邮件报警,支持配置多邮件地址群发报警邮件; 27、推送maven中央仓库: 将会把最新稳定版推送到maven中央仓库, 方便用户接入和使用; 28、运行报表:支持实时查看运行数据,如任务数量、调度次数、执行器数量等;以及调度报表,如调度日期分布图,调度成功分布图等; 29、全异步:任务调度流程全异步化设计实现,如异步调度、异步运行、异步回调等,有效对密集调度进行流量削峰,理论上支持任意时长任务的运行; 30、跨语言:调度中心与执行器提供语言无关的 RESTful API 服务,第三方任意语言可据此对接调度中心或者实现执行器。除此之外,还提供了 “多任务模式”和“httpJobHandler”等其他跨语言方案; 31、国际化:调度中心支持国际化设置,提供中文、英文两种可选语言,默认为中文; 32、容器化:提供官方docker镜像,并实时更新推送dockerhub,进一步实现产品开箱即用; 33、线程池隔离:调度线程池进行隔离拆分,慢任务自动降级进入"Slow"线程池,避免耗尽调度线程,提高系统稳定性; 34、用户管理:支持在线管理系统用户,存在管理员、普通用户两种角色; 35、权限控制:执行器维度进行权限控制,管理员拥有全量权限,普通用户需要分配执行器权限后才允许相关操作;

优秀的个人博客,低调大师

HasorDB 4.3.2 发布,增强纯 Map 模式下 CRUD 的使用

介绍 HasorDB 是一个全功能数据库访问工具,提供对象映射、丰富的类型处理、动态SQL、存储过程、内置分页方言20+、支持嵌套事务、多数据源、条件构造器、INSERT 策略、多语句/多结果。并兼容 Spring 及 MyBatis 用法。它不依赖任何其它框架,因此可以很方便的和任意一个框架整合在一起使用。 功能特性 熟悉的方式 JdbcTemplate 接口方式(高度兼容 Spring JDBC) Mapper 文件方式(高度兼容 MyBatis) LambdaTemplate (高度接近 MyBatis Plus、jOOQ 和 BeetlSQL) @Insert、@Update、@Delete、@Query、@Callable 注解(类似 JPA) 事务支持 支持 5 个事务隔离级别、7 个事务传播行为(与 Spring tx 相同) 提供 TransactionTemplate、TransactionManager 接口方式声明式事务控制能力(用法与 Spring 相同) 特色优势 支持 分页查询 并且提供多种数据库方言(20+) 支持 INSERT 策略(INTO、UPDATE、IGNORE) 更加丰富的 TypeHandler(MyBatis 40+,HasorDB 60+) Mapper XML 支持多语句、多结果 提供独特的@{xxx, expr , xxxxx }规则扩展机制,让动态 SQL 更加简单 支持 存储过程 支持 JDBC 4.2 和 Java8 中时间类型 支持多数据源 Release.Node 新特性,针对纯 Map 的 Lambda 支持更加友好,目前可以无实体方式使用 LambdaTemplate 官方文档站:http://www.hasor.cn、https://www.hasordb.net 引入依赖 截止到目前为止 HasorDB 的最新版本为:4.3.2 在https://mvnrepository.com/artifact/net.hasor/hasor-db上也可以查询到最新版本 <dependency> <groupId>net.hasor</groupId> <artifactId>hasor-db</artifactId> <version>4.3.2</version> </dependency> 然后再引入数据库驱动以 MySQL,Maven 方式为例: <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.22</version> </dependency> 使用 HasorDB 可以不依赖数据库连接池,但有数据库连接池是大多数项目的标配。这里选用 Alibaba 的 Druid <dependency> <groupId>com.alibaba</groupId> <artifactId>druid</artifactId> <version>1.1.23</version> </dependency> 最后准备一个数据库表,并初始化一些数据(CreateDB.sql文件) drop table if exists `test_user`; create table `test_user` ( `id` int(11) auto_increment, `name` varchar(255), `age` int, `create_time` datetime, primary key (`id`) ); insert into `test_user` values (1, 'mali', 26, now()); insert into `test_user` values (2, 'dative', 32, now()); insert into `test_user` values (3, 'jon wes', 41, now()); insert into `test_user` values (4, 'mary', 66, now()); insert into `test_user` values (5, 'matt', 25, now()); 执行 SQL 使用 SQL 的方式读取数据,PrintUtils和DsUtils两个工具类可以在例子工程中找到 // 创建数据源 DataSource dataSource = DsUtils.dsMySql(); LambdaTemplate lambdaTemplate = new LambdaTemplate(dataSource); // 新增Map<String, Object> newValue = new HashMap<>(); newValue.put("id", 20); newValue.put("name", "new name"); newValue.put("age", 88); newValue.put("create_time", new Date()); InsertOperation<Map<String, Object>> insert = lambdaTemplate.lambdaInsert("test_user"); int result = insert.applyMap(newValue).executeSumResult() // 更新Map<String, Object> updateValue = new HashMap<>(); updateValue.put("name", "new name"); updateValue.put("age", 88); MapUpdateOperation update = lambdaTemplate.lambdaUpdate("test_user"); int result = update.eq("id", 1).updateByMap(updateValue).doUpdate(); // 查询 List<Map<String, Object>> mapList = jdbcTemplate.queryForList("select * from test_user"); // 打印测试数据 PrintUtils.printMapList(mapList)

优秀的个人博客,低调大师

JPower v2.1.0 发布 重新实现 TREE 查询,MP 增强

https://gitee.com/gdzWork/JPower JPower 只是刚起步,很多功能还在开发中敬请期待...... 简介 JPower是由一款政务商业项目升级优化而来。 JPower 基于SpringCloud(2020.0.x) + SpringBoot(2.4.x)的微服务快速开发平台. 具备网关统一鉴权、Xss防跨站攻击、分布式事务等多个模块,支持多业务系统并行开发, 支持多服务并行开发,可以作为后端服务的开发脚手架。代码简洁,注释齐全,架构清晰,非常适合学习和作为基础框架使用。 JPower 的目标蓝图是能够打造一款集成各种比较好用的工具于一体的快速开发框架,例如可在页面配置各种报表,集成echarts可实现快速生成页面,各种场景下的数据传输等等各类工具。 目前只是开发了基础的架构,后续会逐渐开发各种各样的工具到框架中。 核心技术采用Spring Cloud Alibaba、SpringBoot、Mybatis、Seata、Sentinel、SkyWalking等主要框架和中间件。 希望能努力打造一套集 基础框架 —>分布式微服务架构 —> 工具集成 —> 系统监测 的解决方案。本项目旨在实现基础能力,不涉及具体业务。 采用JWT做Token认证,可拓展集成Redis等细颗粒度控制方案。 注册中心、配置中心选型Nacos,为工程瘦身的同时加强各模块之间的联动。 集成Sentinel从流量控制、熔断降级等多个维度保护服务的稳定性。 2.1.0 发布特性: up 2.1.0 重新实现 TREE 构建 文件上传支持 FASTDFS、SERVER、DATABASE 三种方式 up mybatis-plus 3.4.3.4 up hutool 5.7.16 mybatis-plus 插件可配置开启 重新实现字典查询,删除 BaseDictWrapper 只需要注解 @Dict 即可 新增 BaseDaoWrapper,可做查询后的数据转换 新增 JpowerMybatisInterceptor 拦截器实现 mybatis 查询过滤,可继承 MybatisInterceptor 实现逻辑 部分工具类整改 文档 官方文档 项目地址 前往 Gitee 搜索 JPower或点击后面的链接即可访问项目主页:https://gitee.com/gdzWork/JPower 项目演示地址 项目演示地址:http://jpower.top:81 超级用户登录(租户编码:000000): 超级管理员: root/123456 租户用户登录(租户编码:LXD0DP): 普通账号: admin/123456

优秀的个人博客,低调大师

Twitter 广告平台实时计费系统的架构增强之道

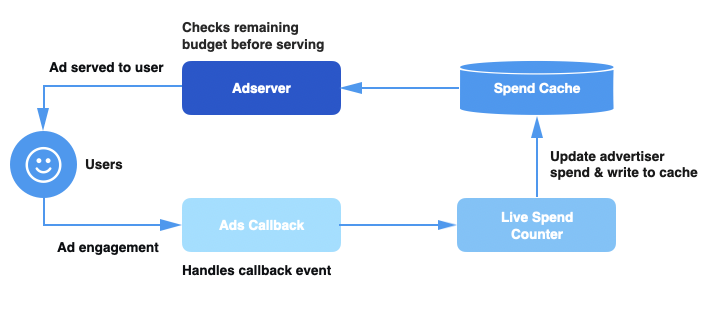
Twitter 是广告商吸引受众的一个热门平台。当广告商发起一个新的广告活动,它们会限定一个广告预算。Twitter 的广告服务器会检查广告活动的预算,以便确定是否还能继续投放广告。如果没有这个检查机制,我们可能会在广告活动达到预算限额后继续提供广告服务。我们把这种情况叫作超支。超支会导致 Twitter 的收入损失(由于机会成本的增加——例如,我们本可以在那个位置显示其他广告)。所以,我们要建立一个可靠的系统来防止发生超支。 - 背景简述 - 在深入研究超支是如何发生前,先来了解一下我们的广告系统是如何提供广告服务的。下面是我们广告服务管道的高级架构图: 支出缓存(Spend Cache)——一个分布式缓存服务,可以跟踪每个广告活动的当前预算支出。 实时广告支出计数器(Live Spend Counter,LSC)——一个基于 Apache Heron 的服务,负责聚合广告活动并更新支出缓存。 广告回调(Ads Callback)——处理用户浏览事件的管道,为事件添加上下文信息,并将它们发送到 LSC。 广告服务器(Ad Server)——在处理请求时,决定是否应该从广告支出缓存中获取当前活动的支出。需要注意的是,这里所说的广告服务器包括了向用户提供广告的多种服务。 当用户在 Twitter 上浏览广告时,我们会向广告回调管道发送一个事件。一旦活动支出计数器收到这个事件,它将计算活动的总支出,并在支出缓存中更新活动的支出。对于每个传入的请求,广告服务器管道都会查询支出缓存,以便获得活动的当前支出,并根据剩余的预算确定是否继续提供服务。 - 广告预算超支 - 因为我们处理的广告活动的规模比较大(数据中心每秒有数以百万计的广告浏览事件),所以延迟或硬件故障随时都可能在我们的系统中发生。如果支出缓存没有更新最新的活动支出,广告服务器就会获取到陈旧的信息,并继续为已经达到预算上限的活动提供广告服务。我们将永远无法收取超出广告预算的那部分费用,导致 Twitter 的收入损失。 例如,假设有一个每天预算为 100 美元的广告活动,每一次点击的价格为 0.01 美元。在没有超支的情况下,这将为活动创造每天 10000 次点击的机会。 假设广告回调管道或 LSC 出现故障,导致支出缓存没有更新,丢失了价值 10 美元的事件,支出缓存只会报告支出为 90 美元,而实际上活动已经支出了 100 美元,那么该活动将获得额外的 1000 次免费点击机会。 - 跨数据中心一致性 - Twitter 有多个数据中心,每个数据中心都部署了整个广告服务管道的副本,包括广告回调管道、实时支出计数器和支出缓存。当用户点击广告时,回调事件被路由到其中的一个数据中心,这个数据中心里的回调管道将负责处理这个事件。 那么,问题就来了:每个数据中心计算的总支出只计算该数据中心接收到的事件,不包括其他数据中心的数据。由于广告客户的预算是跨数据中心的,这意味着每个数据中心的支出信息是不完整的,可能会少算了广告客户的实际支出。 为了解决这个问题,我们给回调事件队列添加了跨数据中心复制功能,以便让每个数据中心都能够处理所有的事件。这确保了每个数据中心中的支出信息是完整和准确的。 - 单个数据中心的故障 - 尽管复制事件为我们带来了更好的一致性和更准确的支出信息,但系统的容错能力仍然不是很强。例如,每隔几周,跨数据中心复制失败就会导致支出缓存由于事件丢失或滞后而失效。通常,广告回调管道会出现系统问题,例如垃圾收集停顿或数据中心的不可靠网络连接导致的事件处理延迟。由于这些问题发生在数据中心本地,该数据中心中的 LSC 接收到的事件与延迟成正比,因此支出缓存的更新也将延迟,从而导致超支。 在过去,如果一个数据中心发生这些故障,我们会禁用这个数据中心的 LSC,并让其他数据中心的 LSC 同时更新本地缓存和发生故障的数据中心的 LSC,直到出现滞后的广告调管道和 LSC 重新追上来。 这种解决方法有效地避免了临时性的超支问题,但仍然有几个不足的地方: 手动切换:启用跨数据中心写入是一个手动执行的过程,需要按一定的顺序进行多个设置更改。我们最终使用了脚本,但仍然需要一个待命工程师手动执行脚本。 手动选择数据中心:需要一个包含多个步骤的手动执行过程来确定哪个数据中心是健康的以及启用跨数据中心写入是否安全。当故障恢复需要回到初始配置时,必须重复类似的过程。有时候,这个过程需要来自不同团队的多个待命工程师共同努力。 高运维成本:由于管理工作区涉及了多个手动步骤,回调基础设施问题会带来很高的运维成本。 - 跨数据中心写入方案 - 由于这种架构存在很多问题,我们重新设计了管道,让它能更有弹性地应对故障,并减少运维人员的干预。这个解决方案有两个主要组成部分: 跨数据中心写入:LSC 总是同时更新“备用”数据中心的支出缓存和本地缓存。它还会写入一些有关数据运行状况的元数据。每个 LSC 实例维护两个单独的数据集,一个只计算本地的信息,另一个只计算来自远程实例写入的数据。 数据集健康检查:在处理请求时,广告服务器管道读取两个版本的数据,并根据哪个数据集更健康自动选择使用哪个版本。 在正常情况下,新解决方案的工作原理与之前的设计完全一致。但是,如果本地支出缓存落后了,广告服务器能够检测到,并自动切换到包含来自远程写入数据的数据集。当本地的问题解决之后,广告服务器将自动切换回本地数据集。 我们怎么知道哪个数据集更健康? 我们通过常见的故障场景来决定数据集的健康情况: 延迟:当广告回调管道/LSC 无法及时处理大量的事件,就会出现延迟。事件是按照它们到达的顺序处理的,所以我们更倾向于选择包含最新事件的数据集。 丢失事件:在某些故障场景中,事件可能会完全丢失掉。例如,如果广告回调管道的跨数据中心复制失败,其中一个数据中心将丢失一些远程事件。因为所有的数据中心都应该处理所有的事件,所以我们应该选择处理了最多事件的那个数据集。 为了构建一个包含这两个因素的健康检查机制,我们引入了支出直方图的概念。 - 支出直方图 - 假设我们有一个滚动窗口,显示每个数据中心的 LSC 在任意给定时刻正在处理的事件计数。滚动窗口包含最近 60 秒内每毫秒处理了多少事件的计数。当到达窗口的末尾,我们删除头部的计数,并计算后面 1 毫秒的计数。我们可以看到 LSC 在 60 秒内处理的“事件计数”的直方图。直方图如下图所示: 为了能够选择最佳的数据集(在广告服务端),我们利用了这个直方图和最近的事件时间戳。LSC 将这些元数据与支出数据一起写入支出缓存。 LSC 在写入时不会序列化/反序列化整个直方图。在写入之前,它会汇总窗口中所有计数器的计数,并写入一个聚合值。这里使用事件的近似值就足够了,近似值可以作为这个数据中心的 LSC 总体健康状况的信号。这是由故障的本质决定的——如果故障足够严重,我们将立即看到故障的影响,计数会显著下降。如果不是很严重的话,数量几乎是一样的。 包含元数据的结构体是这样的: struct SpendHistogram { i64 approximateCount; i64 timestampMilliSecs;} 复制代码 在处理请求时,广告服务器同时读取本地和远程的数据集。它使用 SpendHistogram 根据下面描述的数据中心选择逻辑来决定使用哪个数据集作为事实数据来源。 - 数据中心的选择 - 选择数据集的逻辑如下: · 从两个数据中心获取 SpendHistogram。 · 首选具有最新时间戳和最高事件计数的数据集。 · 如果它们非常相近且都处于正常状态,就首选本地数据集,这样可以避免由于小的延迟而在两个数据中心之间来回切换。 这可以总结成以下的真值表: x = LocalTimeStamp - RemoteTimeStamp y = LocalApproxCount - RemoteApproxCount ts = ThresholdTimeStamp tc = ThresholdApproxCountPercent 在切换到使用来自远程数据中心的数据集之前,我们使用 ts 和 tc 来确定容忍度阈值。如果差值在阈值内,我们会更倾向于使用本地数据集。我们尝试找到阈值,以便在不需要进行数据中心切换的情况下尽早检测故障。广告服务器在处理每个请求时都会发生这个选择过程,因此我们会在本地进行缓存,每隔几秒刷新一次,以防止频繁的网络访问影响整体性能。 下面是切换使用数据中心数据的可视化表示。当 DC1 的 LSC 发生故障时,会导致 DC1 的广告服务器自动选择使用 DC2 的数据。 - 扩展到多个数据中心 - 到目前为止,我们讨论的方法只涉及两个数据中心。通过引入跨数据中心复制因子的概念,我们可以将设计扩展到“N”个数据中心。复制因子控制每个 LSC 服务写入的远程数据中心的数量。在读取数据时,我们使用了相同的逻辑,并做了一些优化,比如一次读取(批读取)所有必要数据,而不是分多次读取。 例如,假设 ReplicationFactor 设置为 2,DC1 中的 LSC 将写入到 DC1、DC2 和 DC3 的支出缓存,DC2 中的 LSC 将写入到 DC2、DC3 和 DC4 的支出缓存,DC3 中的 LSC 将写入到 DC3、DC4 和 DC1 的支出缓存。下图显示了三个数据中心的复制原理图。在每个数据中心中,广告服务器将读取三个支出直方图,并从所有这些数据中心选择首选的数据集。根据我们的网络和存储约束,我们选择 2 作为复制因子。 - 结论 - 在推出这些变更之后,我们注意到团队的运维成本发生了重大变化。之前每个季度由于系统问题会导致多次超支事件,而在过去的一年,都没有发生此类事件。这节省了大量的工程时间,并避免了由于基础设施问题而向广告商发放补偿。 通过识别系统健康关键指标,设计出最简单的工程解决方案,并根据这些指标自动采取行动,我们解决了一个影响服务管道正确性的关键性问题。我们不仅构建了一个具有容错能力和弹性的系统,而且释放了工程资源,把它们用在更有价值的地方。 - END - 往期回顾 ◆使用契约测试提高分布式系统的质量 ◆构建前瞻性应用架构的优秀实践 ◆监控全覆盖,接入只需 5 分钟:爱奇艺内容中台基于 CAT 的服务监控实践 本文分享自微信公众号 - 互联网后端架构(fullstack888)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册