首页 文章 精选 留言 我的

精选列表

搜索[数据库知识开放麦],共10000篇文章
优秀的个人博客,低调大师

Java网络知识点总结

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80627294 通过IP地址和子网掩码与运算计算相关地址 http://blog.csdn.net/perddy/article/details/3137637 1、TCP/IP 1.1 TCP/IP四层模型 http://blog.csdn.net/hbtj_1216/article/details/76472747 1.2 IP、TCP、UDP首部详解 http://blog.csdn.net/hbtj_1216/article/details/76473088 1.3 IP是面向无连接的协议 IP是面向无连接的。在发包之前,不需要建立与对端目标地址之间的连接。上层如果有发送给IP的数据,该数据会立即被压缩成IP包发送出去。 可能存在的问题:丢包、错位、数据量翻倍等。 为什么IP要采用面向无连接的呢?主要有两点原因:(1)为了简化;(2)为了提速。面向连接比面向无连接处理相对复杂。甚至管理每个连接本身就是一个相当繁琐的事情。此外,每次通信之前都要事先建立连接,又会降低处理速度。需要有连接的时候,可以委托上一层的协议提供此项服务。因此,IP为了实现简单化与高速化采用了面向无连接的方式。并且,网络通信中如果能够进行有效的分层,就可以明确TCP与IP各自协议的最终目的,也有利于后续对这些协议进行扩展和性能上的优化。 1.4 TCP和UDP的区别 TCP与UDP区别总结: TCP面向连接。UDP是无连接的,即发送数据之前不需要建立连接。 TCP提供可靠的服务。也就是说,通过TCP连接传送的数据,无差错,不丢失,不重复,且按序到达;UDP尽最大努力交付,也就是说,不保证可靠交付。 TCP面向字节流,实际上是TCP把数据看成一连串无结构的字节流;UDP是面向报文的。UDP没有拥塞控制,因此网络出现拥塞不会使源主机的发送速率降低(对实时应用很有用,如IP电话,实时视频会议等)。 每一条TCP连接只能是点到点的;UDP支持一对一,一对多,多对一和多对多的交互通信。 TCP首部开销20字节;UDP的首部开销小,只有8个字节。 TCP的逻辑通信信道是全双工的可靠信道,UDP则是不可靠信道。http://blog.csdn.net/li_ning_/article/details/52117463 1.5 TCP三次握手和四次挥手 http://blog.csdn.net/hbtj_1216/article/details/76498441 1.5 TCP拥塞控制 http://www.jianshu.com/p/5f7fefed4d85 TCP参数 Netty中的ChannelOption常用参数详解http://blog.csdn.net/hbtj_1216/article/details/74199162 网络编程send,recv,read,write区别 http://blog.163.com/clevertanglei900@126/blog/static/111352259201122001933162/ 一篇文章完全搞清楚 scoket read/write 返回码、阻塞与非阻塞、异常处理 等让你头疼已久的问题 http://www.cnblogs.com/junneyang/p/6126635.html 2、HTTP 2.1 HTTP请求报文 http://blog.csdn.net/hbtj_1216/article/details/76525112 2.2 HTTP响应报文 http://blog.csdn.net/hbtj_1216/article/details/76528361 2.3 HTTP常见状态码 http://blog.csdn.net/hbtj_1216/article/details/76550362 HTTP状态码大全:http://www.runoob.com/http/http-status-codes.html 2.4 HTTP 长连接和短连接 http://blog.csdn.net/hbtj_1216/article/details/77529623 从用户浏览器输入 url 到用户看到页面结果的过程,发生了什么事情?(HTTP请求的过程) http://www.cnblogs.com/ddddemo/p/5624053.html HTTP、HTTPS 的区别 HTTPS协议和HTTP协议的区别: HTTPS协议需要到ca申请证书,一般免费证书很少,需要交费。 HTTP是超文本传输协议,信息是明文传输,HTTPS 则是具有安全性的SSL加密传输协议。 HTTP和HTTPS使用的是完全不同的连接方式用的端口也不一样,HTTP是80,HTTPS是443。 HTTP的连接很简单,是无状态的 。 HTTPS协议是由SSL+HTTP协议构建的可进行加密传输、身份认证的网络协议,要比HTTP协议安全。 http://www.jianshu.com/p/37654eb66b58 https加密完整过程 http://www.jianshu.com/p/2f6c93308370 HTTP1.0、HTTP2.0 的区别 http://blog.csdn.net/linsongbin1/article/details/54980801 GET、POST 的区别 http://blog.csdn.net/hbtj_1216/article/details/76552018 cookie 和 session 的区别 http://www.jianshu.com/p/aed2d6140c0a HTTP请求中 Session 实现原理 http://blog.csdn.net/zhq426/article/details/2992488 redirect与forward区别 http://blog.csdn.net/hbtj_1216/article/details/76607076 URI、URL、URN区别 URI全名为Uniform Resource Indentifier(统一资源标识),用来唯一的标识一个资源,是一个通用的概念,URI由两个主要的子集URL和URN组成 URL全名为Uniform Resource Locator(统一资源定位),通过描述资源的位置来标识资源 URN全名为Uniform Resource Name(统一资源命名),通过资源的名字来标识资源,与其所处的位置无关,这样即使资源的位置发生变动,其URN也不会变化 HTTP规范将更通用的概念URI作为其资源标识符,但是实际上,HTTP应用程序处理的只是URI的URL子集 DNS解析的过程 http://blog.csdn.net/charleslei/article/details/50116061 计算机各层网络协议 http://www.jianshu.com/p/d70d54879ca6 2、介绍一下Java NIO中的Buffer、Channel和Selector的概念和作用 http://blog.csdn.net/hbtj_1216/article/details/76446547Buffer和Channel详解:http://www.jianshu.com/p/052035037297 1、select、poll、epoll详解 http://blog.csdn.net/hbtj_1216/article/details/70568402 Level_triggered(水平触发):当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据一次性全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它还会通知你在上没读写完的文件描述符上继续读写,当然如果你一直不去读写,它会一直通知你!!!如果系统中有大量你不需要读写的就绪文件描述符,而它们每次都会返回,这样会大大降低处理程序检索自己关心的就绪文件描述符的效率!!! Edge_triggered(边缘触发):当被监控的文件描述符上有可读写事件发生时,epoll_wait()会通知处理程序去读写。如果这次没有把数据全部读写完(如读写缓冲区太小),那么下次调用epoll_wait()时,它不会通知你,也就是它只会通知你一次,直到该文件描述符上出现第二次可读写事件才会通知你!!!这种模式比水平触发效率高,系统不会充斥大量你不关心的就绪文件描述符!!! 阻塞IO:当你去读一个阻塞的文件描述符时,如果在该文件描述符上没有数据可读,那么它会一直阻塞(通俗一点就是一直卡在调用函数那里),直到有数据可读。当你去写一个阻塞的文件描述符时,如果在该文件描述符上没有空间(通常是缓冲区)可写,那么它会一直阻塞,直到有空间可写。以上的读和写我们统一指在某个文件描述符进行的操作,不单单指真正的读数据,写数据,还包括接收连接accept(),发起连接connect()等操作… 非阻塞IO:当你去读写一个非阻塞的文件描述符时,不管可不可以读写,它都会立即返回,返回成功说明读写操作完成了,返回失败会设置相应errno状态码,根据这个errno可以进一步执行其他处理。它不会像阻塞IO那样,卡在那里不动!!! 阻塞和非阻塞、同步和异步 http://blog.csdn.net/hbtj_1216/article/details/77866384

优秀的个人博客,低调大师

python学习-基础知识-1

1、计算机历史 计算机使用高低电压的两种状态来描述信息。计算机可以理解的只有二进制数据即010100011....,1个比特位可以表示的状态只有2种,n个比特位可以表示的状态有2的n次方种。 所以如果想要描述天气状态:天晴、下雨、刮风、下雪、霜冻,则需要使用3个比特位。 2、编程语言历史 计算机只能理解二进制数据,二进制数据中蕴含了很多指令、操作、数据,计算机通过cpu直接运行二进制代码执行不同的功能,二进制代码被称为机器语言。 但是机器语言(二进制代码)对于人类而言可读性太差、编写太困难,所以人类需要使用适合自身的语言来编程以操作计算机。 一开始,人类将机器语言中的代码进行分类、标记,把蕴含操作行为、蕴含数据的二进制代码使用英语单词标记,形成了汇编语言。汇编语言的模式是:操作行为+被操作数。 操作行为和被操作数都使用英语单词代替了一串010101的二进制代码,这样人类只需要编写汇编语言,再将汇编语言通过之前的映射关系转换成二进制即可。 通过汇编语言,人类即可以方便的编写代码,又可以通过转化得到对应的二进制代码让计算机运行。 但是,汇编语言依然可读性较差、编写也不是非常的方便,要实现一个简单的功能需要非常多的汇编代码,代码冗余性依然很高。 于是,人类模仿汇编和二进制的对应关系,将高级语言和汇编又对应起来,这时候人类就只需要编写高级语言,再通过编译器将高级语言转换成汇编语言或者直接转换成二进制代码。 高级语言的代码非常接近人类的英语,所以使用起来很方便。 因语法规则、语义的不同,高级语言分为很多种,如:python,java、c、c++、JavaScript,ruby等等。 3、编译型高级语言/解释性高级语言 高级语言接近人类英语,编写的代码可读性也很强,但是计算机是无法直接理解和执行源代码的,因为计算机只认识二进制代码,所以不论是哪一种高级语言,都需要将源代码转换成二进制代码后才能被计算机执行。 在转换过程中,有2种不同的情况: 1、编译型 编译型高级语言,在程序执行之前,需要提前将源代码通过编译器转换成目标文件(二进制代码),然后计算机直接执行目标文件。 优点:计算机执行效率高、速度快 缺点: 如果程序需要修改,必须修改源代码并再次编译,修改不方便 一旦编译完成,目标文件就只能在当前操作系统和cpu架构上运行,无法在其他平台使用,除非重新编译 举例:c、c++、c# 2、解释型 解释型高级语言,由解释器实时读取源代码并编译成二级制代码交由计算机执行。 优点: 程序的修改直接操作源文件即可,修改方便 只要计算机安装了对应平台的解释器,源代码就可以被执行,即一份源代码可以在不同平台运行,平台兼容性好 缺点: 因为需要实时编译,所以运行效率低、速度较慢 需要一个匹配版本和平台的解释器与源代码共同工作 举例:python、java、ruby 4、python版本 python有2个相互不兼容的大版本,版本2最高是2.7,版本3截止20180603最高是3.6.5。版本2官方宣布将会维护到2020年,建议现在选择版本3编码。 5、python解释器 解释器也是一种程序,功能是将python源代码翻译成机器语言。解释器可以使用多种语言编写,有如下几种: cpython,官方发布的解释器,使用c语言编写 ipython,在cpython基础上套了一个壳,提高用户交互性 pypy,据说使用jit技术动态实时编译使得代码运行速度更快,但是目前暂不成熟 jpython和icronpython,使用java和.net编写,一般不使用 6、python文件执行 两种方式执行python文件,一种是启动解释器并将python源文件作为参数,解释器读取文件中代码。一种是启动解释器,在交互环境编写代码执行。 7、变量 1、变量存在的原因 用于保存阶段性计算的结果,同时变量用于描述程序中的一些数据,良好的变量命名和使用会增加代码的可读性。 2、变量命名规范 变量名可以是数字、字母、下划线的任意组合,注意:不可使用除了下划线之外的特殊字符 变量名开头不能是数字 变量名不能和python预定义的关键字重名 注意:python竟然可以使用中文作为变量名! 3、变量定义语法 age = 26 定义一个变量,它的名字是age,此变量指向内存中的一个对象,此对象值是26 8、常量 常量的命名规范和变量一样,不过常量的命名约定俗成的是全大写。 常量用于保存基本不变的数据,python没有提供类似c语言的const关键字来强制规定常量的不可变性,所以python中的常量是约定俗成的不可变。 9、python安装 www.python.org官网下载最新版本3.6.5,根据电脑配置选择32或者64位,安装的时候选择add to path并自定义安装位置和其他高级选项,安装完成可以直接shell进入python解释器。 10、输入/输出 python中通过input函数提供shell输入,通过print函数提供shell打印。 input函数会阻塞程序执行直到获取shell输入值 11、注释 不论哪一种高级语言,我们在编码的时候都是将脑海中的思路、信息、步骤简化成实际的代码。将大脑中的信息转换成实际代码的时候,会有很大的信息量丢失,即代码所表达的信息量是很少的。 所以单独的代码无法还原编码时的全部信息量,此时我们就需要使用注释来弥补代码缺失的信息量。优秀的注释+代码可以提供很高的可读性,也方便后续代码使用和维护。 注释有几个需要遵守的规范: 1、注释的内容应该保持与代码的强一致性,注释应该精简、准确的表达代码的含义、编码背景等 2、可以使用中文或者英文 3、注意注释的使用量,在适当且必要的地方使用注释,如:重要流程节点、复杂代码块解释等 12、数据类型 计算机只认识二进制,对于计算机而言,数据没有类别,全部都是010101010... 但是对于人类而言,人类世界中的数据、信息是五花八门的,我们编码的过程其实就是在计算机世界中对现实世界进行建模的过程,所以我们需要对人类世界的数据划分类别。 基础的数据类型有:数字(整数+小数)、字符串、布尔值 我们使用int来表示整数类型、float表示小数类型 我们使用str表示字符串类型 我们使用bool表示布尔值类型 数字类型用于计算、字符串类型用于表示信息、布尔类型用于判断 13、字符串格式化输出 所谓格式化输出,其实就是在编码过程中定义展示模板,在模板中通过占位符代表后续有对应数据填充在此。 占位符: %d 整数类型 %f 小数类型 %s 字符串类型(%s是万能匹配,即任意数据类型都可以填充到%s占位符中) %r 原格式(将数据的原始格式存放到%r占位符中,如字符串的原格式就包含引号) 14、运算符 算数运算符 + - * / (注意,/ 除法运算符得到的商可以是小数,即5/2 = 2.5) // % (地板除得到的结果是商的整数部分,如5//2 = 2。取模得到的结果是未整除的结果,如5%2 = 1,对2取模可以判断奇偶。) ** (幂运算,5**2 = 25) 比较运算符 == > < >= <= != (==表示的是两边对象的值是否相等,python3中使用!=表示不等于,不再使用<>) 赋值运算符 = (赋值) += -= *= /= //= %= **= (在原有值的基础上做运算,并赋值给原有变量,如a = 5, a %= 2,此时a = 1) 逻辑运算符 and or no (逻辑判断会使用短路判断,所以:使用and的时候,概率小的放前面。使用or的时候,概率大的放前面。) 15、流程控制-分支 程序默认是自上而下没有分支的执行代码。很多时候我们需要通过判断程序运行中间的某一种状态、情况、值,来决策程序下一步该执行哪些代码。 通过分支提供多条执行路线,分支有双分支、多分支。 之所以可以划分多种分支是因为可能出现多种不同条件,而这些条件的概率和应该为1。 分支需要特别注意条件判断的逻辑性,多种条件只会执行其中一个条件,条件之间是相互对立的。 通过if elif elif else来提供多分支,通过条件的布尔值结果判断条件是否成立。 注意:条件判断应该把概率大的放在前面,概率小的放后面,对于无法明确具体判断条件的可以放在else统一匹配。另外,判断input的返回值的时候注意,input返回值一定是字符串。 16、流程控制-循环-while while关键字后面的语义是:判断条件是否成立?成立的话执行一次循环体然后再次判断条件是否成立。不成立的话跳过此循环体执行后续代码。 因为循环代码有导致死循环的风险,所以任何一个循环定义,都需要预先设计循环跳出条件。循环可以在循环体中通过break跳出,或者通过while条件判断不成立跳过。(当然,也可以在循环体中exit) 通过continue可以提前结束当前循环,直接开始下一次的循环while判断,注意:continue应用于跳过后续本应该执行的代码。 因为continue可以跳过后续本应该执行的代码,而后续执行代码中可能包含循环跳出的设置如:i += 1。所以continue的使用会有死循环风险,需要单独处理循环跳出问题。 17、while...else... 据说使用while后面的else,如果while正常执行完毕,则执行else。如果while没有正常执行完毕如被break打断,则不会执行else。可以使用else是否执行来判断循环是否正常执行完毕,我觉得这并不合理,考虑下述代码: 1 i = 11 2 while i < 10: 3 print('i is:', i) 4 i += 1 5 if i == 3: 6 break 7 else: 8 print('循环正常执行完毕') 9 10 # 循环没有正常执行完毕,实际上循环根本就没执行,else也被执行了。所以else被用于判断 11 # while是否正常执行我觉得并不合理。 18、while的使用 思考如下练习: # 使用while,完成以下图形的输出 # # * # * * # * * * # * * * * # * * * * * # * * * * # * * * # * * # * 1 star = 1 2 most_star = 5 3 while star <= most_star: 4 print(' *' * star) 5 if star == most_star: 6 while most_star > 0: 7 most_star -= 1 8 print(' *' * most_star) 9 break 10 star += 1 11 12 row = 1 13 most_row = 5 14 while row <= most_row: 15 print(' *' * row) 16 row += 1 17 row = most_row - 1 18 while row > 0: 19 print(' *' * row) 20 row -= 1 while循环只能打印一个方向,如果是两个相反的方向,需要两个while。两个while可以写成第二个while放在第一个while的末尾。

优秀的个人博客,低调大师

代码审计补充知识点

参考文献:https://hacksec.xyz/2018/03/23/php-trick/?nsukey=cWDNgiIxMsJayPNWtqM8Rc9amSOIgC0SI9Ko3jxxW2uV9mcoLNLdl4Q1U%2BrV9UhKIs3das0Cizzc8atumDKxG5nHSDPPthMpgeq5Xqa02MDie21AnddLn9BUUyOdXVEOsbvHRrlq1S61OS4%2BRpRffcBRIuwbJUdeL%2FEcZRNmvBtBzhuGQhuRU9fs%2BM9pyrRyVvKRlq5SmzZRSXFYcAjYcQ%3D%3D https://www.jianshu.com/p/9c8c9272e12e ①is_numeric函数 在判断是否是数字时会忽略字符串开头的’ ‘、’\t’、’\n’、’\r’、’\v’、’\f’。 ​ 而’.’可以出现在任意位置,E、e能出现在参数中间,仍可以被判断为数字。也就是说is_numeric(“\r\n\t 0.1e2”) >> TRUE intval()函数会忽略’’ ‘\n’、’\r’、’\t’、’\v’、’\0’ ,也就是说intval(“\r\n\t 12”) >> 12 ②PHP变量名不能带有点[.] 和空格,否则在会被转化为下划线[_] parse_str("na.me=admin&pass wd=123",$test); var_dump($test); 结果: ["na_me"]=> string(5) "admin" ["pass_wd"]=> string(3) "123" } ③htmlspecialchars()函数默认只转义双引号不转义单引号,如果都转义的话需要添加上参数ENT_QUOTES ④in_arrary()函数默认进行松散比较(进行类型转换) in_arrary(“1asd”,arrart(1,2,3,4)) => true in_arrary(“1asd”,arrart(1,2,3,4),TRUE) => false \\(需要设置strict参数为true才会进行严格比较,进行类型检测) ⑤sprintf()格式化漏洞(可以吃掉转义后的单引号) 当我们输入的特殊字符被放到引号中进行转义时,但是又使用了sprintf函数进行拼接时,例如%1$’%s’ 中的 ‘%被当成使用%进行padding,导致后一个’逃逸了 还有一种情况就是’被转义成了\’,例如输入%’ and 1=1#进入,存在SQL过滤,’被转成了\’,于是sql语句变成了 select * from user where username = ‘%\’ and 1=1#’;如果这个语句被使用sprintf函数进行了拼接,%后的\被吃掉了,导致了’逃逸 $sql = "select * from user where username = '%\' and 1=1#';"; $args = "admin"; echo sprintf( $sql, $args ) ; //result: select * from user where username = '' and 1=1#' ?> 不过这样容易遇到 PHP Warning: sprintf(): Too few arguments的报错,这个时候我们可以使用%1$来吃掉转义添加的\ <?php $sql = "select * from user where username = '%1$\' and 1=1#' and password='%s';"; $args = "admin"; echo sprintf( $sql, $args) ; //result: select * from user where username = '' and 1=1#' and password='admin'; ?> ⑥php中 = 赋值运算的优先级高于and $c = is_numeric($a) and is_numeric($b)程序本意是要a、b都为数字才会继续,但是当$a为数字时,会先赋值给$c,所以可能导致$b绕过检测 ⑦url标准的灵活性导致绕过filter_var与parse_url进行ssrf parse_url() 是专门用来解析 URL 而不是 URI 的。不过为遵从 PHP 向后兼容的需要有个例外,对 file:// 协议允许三个斜线(file:///...)。其它任何协议都不能这样. filter_var()函数对于http://evil.com;google.com 会返回false也就是认为url格式错误,但是对于0://evil.com:80;google.com:80/、0://evil.com:80,google.com:80/、0://evil.com:80\google.com:80/却返回true。 ⑧通过file_get_contents获取网页内容并返回到客户端有可能造成xss if(filter_var($argv[1], FILTER_VALIDATE_URL)) { // parse URL $r = parse_url($argv[1]); print_r($r); // check if host ends with google.com if(preg_match('/baidu\.com$/', $r['host'])) { // get page from URL $a = file_get_contents($argv[1]); echo($a); } else { echo "Error: Host not allowed"; } } else { echo "Error: Invalid URL"; } 虽然通过filter_var函数对url的格式进行检查,并且使用正则对url的host进行限定, 但是可以通过data://baidu.com/plain;base64,PHNjcmlwdD5hbGVydCgxKTwvc2NyaXB0Pgo== 页面会将<script>alert(1)</script>返回给客户端,就有可能造成xss ⑨parse_url与libcurl对与url的解析差异可能导致ssrf 当url中有多个@符号时,parse_url中获取的host是最后一个@符号后面的host,而libcurl则是获取的第一个@符号之后的。因此当代码对http://user@eval.com:80@baidu.com 进行解析时,PHP获取的host是baidu.com是允许访问的域名,而最后调用libcurl进行请求时则是请求的eval.com域名,可以造成ssrf绕过。此外对于https://evil@baidu.com这样的域名进行解析时,php获取的host是evil@baidu.com,但是libcurl获取的host却是evil.com ⑩md5碰撞 $Param1="\x4d\xc9\x68\xff\x0e\xe3\x5c\x20\x95\x72\xd4\x77\x7b\x72\x15\x87\xd3\x6f\xa7\xb2\x1b\xdc\x56\xb7\x4a\x3d\xc0\x78\x3e\x7b\x95\x18\xaf\xbf\xa2\x00\xa8\x28\x4b\xf3\x6e\x8e\x4b\x55\xb3\x5f\x42\x75\x93\xd8\x49\x67\x6d\xa0\xd1\x55\x5d\x83\x60\xfb\x5f\x07\xfe\xa2"; $Param2="\x4d\xc9\x68\xff\x0e\xe3\x5c\x20\x95\x72\xd4\x77\x7b\x72\x15\x87\xd3\x6f\xa7\xb2\x1b\xdc\x56\xb7\x4a\x3d\xc0\x78\x3e\x7b\x95\x18\xaf\xbf\xa2\x02\xa8\x28\x4b\xf3\x6e\x8e\x4b\x55\xb3\x5f\x42\x75\x93\xd8\x49\x67\x6d\xa0\xd1\xd5\x5d\x83\x60\xfb\x5f\x07\xfe\xa2"; #008ee33a9d58b51cfeb425b0959121c9 $data1="\xd1\x31\xdd\x02\xc5\xe6\xee\xc4\x69\x3d\x9a\x06\x98\xaf\xf9\x5c\x2f\xca\xb5\x07\x12\x46\x7e\xab\x40\x04\x58\x3e\xb8\xfb\x7f\x89\x55\xad\x34\x06\x09\xf4\xb3\x02\x83\xe4\x88\x83\x25\xf1\x41\x5a\x08\x51\x25\xe8\xf7\xcd\xc9\x9f\xd9\x1d\xbd\x72\x80\x37\x3c\x5b\xd8\x82\x3e\x31\x56\x34\x8f\x5b\xae\x6d\xac\xd4\x36\xc9\x19\xc6\xdd\x53\xe2\x34\x87\xda\x03\xfd\x02\x39\x63\x06\xd2\x48\xcd\xa0\xe9\x9f\x33\x42\x0f\x57\x7e\xe8\xce\x54\xb6\x70\x80\x28\x0d\x1e\xc6\x98\x21\xbc\xb6\xa8\x83\x93\x96\xf9\x65\xab\x6f\xf7\x2a\x70"; $data2="\xd1\x31\xdd\x02\xc5\xe6\xee\xc4\x69\x3d\x9a\x06\x98\xaf\xf9\x5c\x2f\xca\xb5\x87\x12\x46\x7e\xab\x40\x04\x58\x3e\xb8\xfb\x7f\x89\x55\xad\x34\x06\x09\xf4\xb3\x02\x83\xe4\x88\x83\x25\x71\x41\x5a\x08\x51\x25\xe8\xf7\xcd\xc9\x9f\xd9\x1d\xbd\xf2\x80\x37\x3c\x5b\xd8\x82\x3e\x31\x56\x34\x8f\x5b\xae\x6d\xac\xd4\x36\xc9\x19\xc6\xdd\x53\xe2\xb4\x87\xda\x03\xfd\x02\x39\x63\x06\xd2\x48\xcd\xa0\xe9\x9f\x33\x42\x0f\x57\x7e\xe8\xce\x54\xb6\x70\x80\xa8\x0d\x1e\xc6\x98\x21\xbc\xb6\xa8\x83\x93\x96\xf9\x65\x2b\x6f\xf7\x2a\x70"; #79054025255fb1a26e4bc422aef54eb4

优秀的个人博客,低调大师

JavaScript的常用基础知识

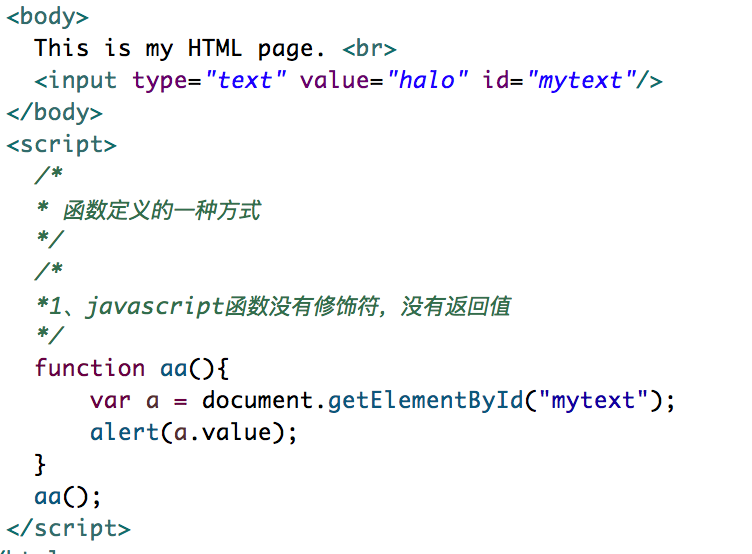
前言 稻光养晦,未雨绸缪 函数的定义 函数定义的第一种方式 屏幕快照 2018-01-26 17.39.05.png 说明 1 . 这是最正常的一种函数表达式 2 . 函数aa可以接受任意的参数 3 . 可以有返回值,可以用变量来接受其返回值 4 . 如果没有return,则返回undefined. 函数定义的第二种方式 屏幕快照 2018-01-26 17.41.48.png 说明 1 . 直接给变量赋值一个函数 2 . 在项目开发中是一种比较常见的形式 Dom对象 DOM是Document Object Model文档对象模型的缩写。根据W3C DOM规范,DOM是一种与浏览器,平台,语言无关的接口,使得你可以访问页面其他的标准组件。 D:文档 – html 文档 或 xml 文档 O:对象 – 把document里的所有节点都看成对象 M:模型(用于建立从文档到对象的模型) 结构如下: 屏幕快照 2018-01-27 00.02.59.png 对应的html页面: 屏幕快照 2018-01-27 00.03.11.png 从上述两个图中可以看出: 1 . 整个html称为dom树,而dom的引用为document,也称为一个节点。 2 . 每一个HTML标签都为一个元素节点 3 . 标签中的文字则是文本节点 4 . 标签中的属性则是属性节点 5 . dom中元素、文本、属性都是节点 6 . dom树是由节点构成的 7 . 每个节点都代表一个对象 常用的API getElementById() 说明: 1、 查询给定ID属性值的元素,返回该元素的元素节点。也称为元素对象。 2、 因为在一个html页面中id的值是唯一的,所以返回值也是唯一的。所以方法的名称为getElementById()而不是getElementsById()。 3、 该方法只能用于document对象,类似与java的static关键字。 例子 屏幕快照 2018-01-27 00.24.44.png getElementsByName() 说明: 1、查找给定name属性的所有元素,这个方法将返回一个节点集合,也可以称为对象集合。 2、这个集合可以作为数组来对待,length属性的值表示集合的个数。 3、因为在html页面中,name不能唯一确定一个元素,所以方法的名称为getElementsByName而不是getElementByName。 例子 屏幕快照 2018-01-27 00.25.53.png getElementsByTagName() 说明: 1、查询给定标签名的所有元素 2、因为在html页面中,标签名不是唯一的,所以返回值为节点的集合。 3、这个集合可以当做数组来处理,length属性为集合里所有元素的个数 例子 <!DOCTYPE html> <html> <head> <title>getElementsByTagName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <form name="form1" action="test.html" method="post"> <input type="text" name="halo" value="我是Halo1!!!" id="halo1"> <input type="text" name="halo" value="我是Halo2!!!" id="halo2"> <input type="text" name="halo" value="我是Halo3!!!" id="halo3"> <input type="text" name="halo" value="我是Halo4!!!" id="halo4"> <input type="button" name="ok" value="OK"> </form> <select name="sport" id="sport"> <option value="篮球">乔丹</option> <option value="足球" selected="selected">梅西</option> <option value="乒乓球">刘国梁</option> <option value="台球">丁俊晖</option> </select> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /*** *1、获取所有input元素的值 *2、输出所有input元素的值,不包括按钮,并且点击文本框,获取相应的值。 *3、输出所有下拉选 id=“edu” 的value值 *4、输出所有下拉选框的内容 *5、选择下拉列表框的内容,并且弹出所选择的内容 *6、针对每一个下拉列表框的内容,弹出所选中的内容 ***/ //1. /******************************************************************/ /* //1.获取所有input元素的值 var inputElements = document.getElementsByTagName("input"); //遍历inputElements数组元素的每一个对象 for(var i=0;i < inputElements.length;i++){ alert(inputElements.item(i).value); } */ //2. /******************************************************************/ //输出所有input元素的值,不包括按钮,并且点击文本框,获取相应的值。 //1、获取input元素的对象数组 var inputElements = document.getElementsByTagName("input"); //2、遍历数组 /* for(var i=0;i<inputElements.length;i++){ if(inputElements[i].type != "button"){ alert(inputElements[i].value); inputElements[i].onclick = function(){ alert(this.value); } } } */ //3. /******************************************************************/ //输出所有下拉选 id=“edu” 的value值 //eduElement.childNodes获取的是所有子节点及子子节点。 /* //1、获取id为edu的对象 var eduElement = document.getElementById("edu"); //2、获取id为edu的对象的子节点 var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].value); } */ //4. /******************************************************************/ //输出所有下拉选框的内容 /* var optionElements = document.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].value); } */ //5. /******************************************************************/ //选择下拉列表框的内容,并且弹出所选择的内容 //1.获取所有的select元素的对象 var selectElements = document.getElementsByTagName("select"); //2.遍历所有的select对象,并且赋值onchange方法 for(var i=0; i<selectElements.length;i++){ selectElements[i].onchange = function(){ //this代表选中的option对象 alert(this.value); } } //6. /******************************************************************/ //针对每一个下拉列表框的内容,弹出所选中的内容 var selectElement1 = document.getElementById("sport"); var selectElement2 = document.getElementById("edu"); selectElement1.onchange = function(){ alert(this.value); } selectElement2.onchange = function(){ alert(this.value); } </script> </html> hasChildNodes() 说明 1、该方法用来判断一个元素是否有子节点。 2、返回值为true或者false。 3、文本节点和属性节点不可能再包含子节点,所以对于这两类节点使用 hasChildNodes()方法返回值永远为false。 4、如果hasChildNodes()返回值为false,则childNodes,firstChild,lastChild将为空数组或者空字符串。 例子 <!DOCTYPE html> <html> <head> <title>hasChildNodes.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <form name="form1" action="test.html" method="post"> <input type="text" name="halo" value="我是Halo1!!!" id="halo1"> <input type="text" name="halo" value="我是Halo2!!!" id="halo2"> <input type="text" name="halo" value="我是Halo3!!!" id="halo3"> <input type="text" name="halo" value="我是Halo4!!!" id="halo4"> <input type="button" name="ok" value="OK"> </form> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分两种情况输出hasChildNodes()的值 * 1、有子节点 * 2、没有子节点 */ //输出有子节点的值 var eduElement = document.getElementById("edu"); //因为有子节点,所以返回值为true alert(eduElement.hasChildNodes()); //输出没有子节点的值 var halo1Element = document.getElementById("halo1"); alert(halo1Element.hasChildNodes()); </script> </html> nodeName属性 说明 1、文档中的每一个节点都有这个属性。 2、为给定节点的名称。 3、如果节点是元素节点,nodeName返回元素的名称;如果给定节点为属性节点,nodeName返回属性的名称;如果给定节点为文本节点,nodeName返回为#text的字符串; 例子 <!DOCTYPE html> <html> <head> <title>nodeName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> <option value="专科">专科学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeName * */ //1.获得edu对象 var eduElement = document.getElementById("edu"); //2.获得edu对象的nodeName alert(eduElement.nodeName); //这一步获得的是<select name="edu" id="edu">的name属性的值 //var nameElement = eduElement.name; //通过eduElement.getAttributeNode()可以获取属性的对象 var nameElement = eduElement.getAttributeNode("name"); alert(nameElement.nodeName); var idElement = eduElement.getAttributeNode("id"); alert(idElement.nodeName); var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ alert(optionElements[i].nodeName); var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeName); } </script> </html> nodeType属性 说明 1、该节点表明节点类型,返回值为一个整数 2、常用的节点类型有三种: (1)、 元素节点类型 值为1 (2)、属性节点类型 值为2 (3)、文本节点类型 值为3 例子 <!DOCTYPE html> <html> <head> <title>nodeName.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeType *输出option元素的子节点文本元素的元素类型 */ //1.分别输出edu元素节点元素及属性name,id的nodeType var eduElement = document.getElementById("edu"); //alert(eduElement.nodeType); var nameElement = eduElement.getAttributeNode("name"); //alert(nameElement.nodeType); var idElement = eduElement.getAttributeNode("id"); //alert(idElement.nodeType); var optionElements = eduElement.getElementsByTagName("option"); for(var i=0;i<optionElements.length;i++){ //alert(optionElements[i].nodeType); var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeType); var textElement = optionElements[i].firstChild; alert(textElement.nodeType); } </script> </html> nodeType属性 说明 1、返回给定节点的当前值(字符串)。 2、如果给定节点是属性节点,返回值是这个属性的值;如果给定节点是文本节点,返回值是这个文本节点的内容;如果给定节点是元素节点,返回值是null。 3、nodeValue是一个读写属性。 例子 <!DOCTYPE html> <html> <head> <title>nodeValue.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <select name="edu" id="edu"> <option value="专科">专科学位</option> <option value="本科">本科学位</option> <option value="硕士">硕士学位</option> <option value="博士">博士学位</option> </select> </body> <script type="text/javascript"> /* *分别输出edu元素节点元素及属性name,id的nodeValue *输出option元素的子节点文本元素的元素类型 */ //1、获得edu的元素节点 var eduElement = document.getElementById("edu"); //2、获得eduElement的nodeValue的值 alert(eduElement.nodeValue); //获得edu属性name的元素节点值 var nameElement = eduElement.getAttributeNode("name"); alert(nameElement.nodeValue); //获得edu属性id的元素节点值 var idElement = eduElement.getAttributeNode("id"); alert(nameElement.nodeValue); //输出option元素的子节点文本元素的元素类型 var optionElements = eduElement.getElementsByTagName("option"); for(var i = 0; i < optionElements.length; i++){ var valueElement = optionElements[i].getAttributeNode("value"); alert(valueElement.nodeValue); var textElement = optionElements[i].firstChild; alert(textElement.nodeValue); } </script> </html> replaceChild() 说明 1、把一个给定父元素里的一个子节点替换为另外一个子节点; 2、var reference = element.replaceChild(newChild,oldChild); 3、返回值指向已经被替换掉的那个子节点的引用; 例子 <!DOCTYPE html> <html> <head> <title>replaceChild.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的城市:<br> <ul> <li id="wh" value="wuhan">武汉</li> <li id="km" value="kunming">昆明</li> <li id="sz" value="shenzhen">深圳</li> </ul> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value="daye">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /* *点击北京节点,将被给力节点替换 */ window.onload = function(){ //1、得到北京节点 var whElement = document.getElementById("wh"); //2、注册onclick事件 whElement.onclick = function(){ //3、找到wh节点的父节点 var ulElement = whElement.parentNode; //4、获得gl节点 var dyElement = document.getElementById("dy"); //5、替换 ulElement.replaceChild(dyElement,whElement); } } </script> </html> getAttribute() 说明 1、返回一个给定元素的给定属性的节点的值 2、var attributeValue = element.getAttribute(attributeName) 3、给定属性的名字必须以字符串的形式传递给该方法 4、给定属性的值将以字符串的形式返回 5、通过属性获取属性节点getAttributeNode(属性的名称) --返回属性节点 例子 <!DOCTYPE html> <html> <head> <title>getAttribute.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value="daye">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 获取<li id="six" value="sixsixsix">666</li>的属性id和value的值 **/ var sixElement = document.getElementById("six"); //第一种方法: alert(sixElement.getAttributeNode("id").nodeValue); alert(sixElement.getAttributeNode("value").nodeValue); //第二种方法: alert(sixElement.getAttribute("id")); alert(sixElement.getAttribute("value")); </script> </html> setAttribute() 说明 1、将给定元素添加一个新的属性或改变它现有属性的值; 2、element.setAttribute(attributeName,attributeValue); 3、属性的名字和值必须以字符串的形式传递; 4、如果这个属性已经存在,那么值将被attributeValue取代; 5、如果这个属性不存在,那么先创建它,再给他赋值; 例子 <!DOCTYPE html> <html> <head> <title>setAttribute.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value=daye"">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 给<li id="ly" value="laoye">老爷</li>增加一个name属性,并赋值,然后输出 **/ var lyElement = document.getElementById("ly"); lyElement.setAttribute("name", "halo"); alert(lyElement.getAttribute("name")); </script> </html> createElement() 说明 1、按照给定的标签名创建一个新的元素节点,方法的参数为被创建的元素的名称; 2、var reference = document.createElement(elementName); 3、方法的返回值指向新建节点的引用,返回值是一个元素节点,所以nodeType 为1; 4、新建的节点不会自动添加到文档里,只是存在于document里一个游离的对象; 例子 <!DOCTYPE html> <html> <head> <title>createElement.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> 您喜欢的词语:<br> <ul> <li id="six" value="sixsixsix">666</li> <li id="dy" value=daye"">大爷</li> <li id="ly" value="laoye">老爷</li> </ul> </body> <script type="text/javascript"> /** ** 为ul增加一个新的元素<li id="cs" value="cs">计算机</li> ** **/ //1.创建<li></li> var liElement = document.createElement("li"); //2.创建文本节点 传说 var textElement = document.createTextNode("计算机"); //3.<li id="cs" value="cs">计算机</li>的形成 liElement.appendChild(textElement); liElement.setAttribute("id", "cs"); liElement.setAttribute("value", "cs"); //4.获得ul对象 var ulElement = document.getElementsByTagName("ul")[0]; ulElement.appendChild(liElement); </script> </html> innerHTML属性 说明 用来读写某个元素中的HTML内容 例子 <!DOCTYPE html> <html> <head> <title>innerHTML.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> <div id="mydiv"><h1 id="h">halo是我的简称!!</h1></div> </body> <script type="text/javascript"> /** *读取div中的html内容 **/ var divElement = document.getElementById("mydiv"); var h1Element = document.getElementById("h") alert(divElement.textContent); alert(h1Element.textContent); </script> </html> window.onload 说明 1、在页面上所有的数据加载完以后触发该方法; 2、这样做的好处是,有时候一些JS函数要用到页面上的一些数据,但是此时有些数据还没有加载进来。这个时候触发函数,就会报一些异常。所以用window.onload方法可以确保数据安全落地; 例子 <!DOCTYPE html> <html> <head> <title>window_load.html</title> <meta name="keywords" content="keyword1,keyword2,keyword3"> <meta name="description" content="this is my page"> <meta http-equiv="content-type" content="text/html; charset=UTF-8"> </head> <body> this is my HTML page.<br> </body> <script type="text/javascript"> /** *把页面中的所有的数据加载完以后触发该方法 **/ window.onload = function(){ alert("ssssss"); } </script> </html>

优秀的个人博客,低调大师

swift:入门知识之简单值

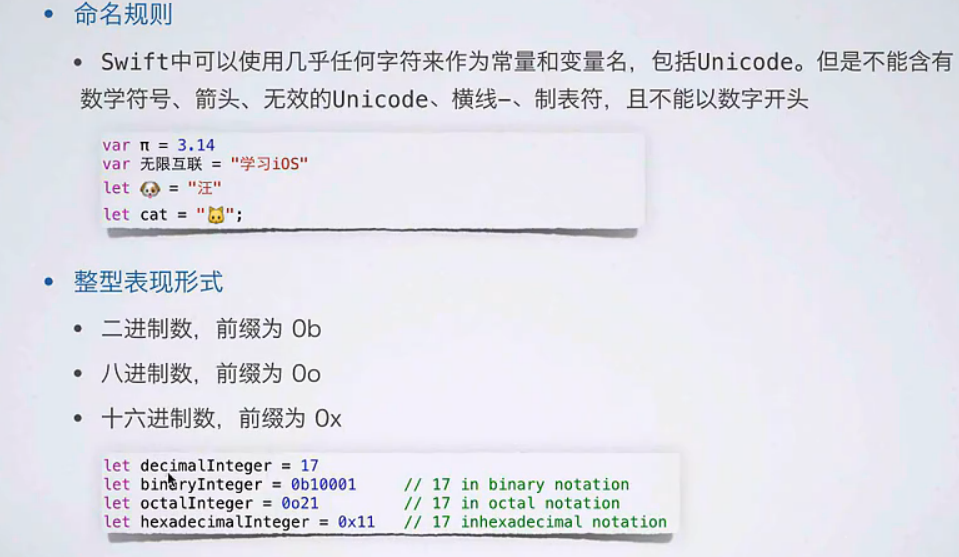
1、swift中用let关键字类定义常量,用var关键字来定义变量。 2、swift语句的结尾不需要再带逗号,系统在运行程序时自动会帮你添加上 3、一个变量或常量必须与赋值时拥有相同的类型。 4、如果初始化值没有提供足够的信息(或没有初始化值),可以在变量名后写类型,并用冒号分隔。 5、如果第一次赋初值变量的类型不确定,它可以根据再一次赋值时来确定当前变量的数据类型。 命名规范: 常用数据类型: 类型别名: 新类型元组 : 字符和字符串: 具体举例如下: 用var定义隐式变量,开始赋初值不能确定类型,等第二次赋值后,类型即可确定,此时再赋值类型需要一样 //定义变量用var //不用加类型 //语句后面不用加分号 var str = "Hello, playground" println(str) //"Hello,palyground" var myVariable = 40 myVariable = 55 myVariable = 56.7 //myVariable = "hello world" //error,类型不匹配 用let定义常量,赋初值后,不允许再赋值 //定义常量用let let myConstant = 40 //myConstant = 55 //error,常量不可再赋值 显示的定义变量或常量的类型,变量或常量的后面跟上": 类型" //显示声明变量或常量的类型 var num:Int = 30 let num2:Double = 30.5 其他类型转化为字符串类型,采用String(...)的方式强制转换为字符串 //其他类型转换为字符串 let label = "The width is " let width = 94 let widthLabel = label + String(width) //"The width is 94" 字符串可以直接用"+"号连接成一个新的字符串 //字符串的连接直接用加号var str = "hello" var str2 = "good morning" println(str+" "+str2) //"hello good morning" 在字符串中用" \(...) "这种方式可以用来格式化字符串 //格式化字符串var num = 2.0 let str3 = "good morning \(num)" //"good mornig 2.0" 字符串其他运算: 定义数组,用[ ]括号,通过索引获取数组中的值 //定义数组,用[] var arr = [1,2,3,4] arr[1] = 6 println("\(arr)") //"6" 数组其他运算方式: 添加元素 数组元素个数和容量 遍历元素: 删除元素: 设置数组多个元素: 定义一个字典,也用[ ]括号,没有显示指定字典类型时,键和值类型要保持一致,通过键key获取对应的值。如果没有找到,就会将其新添加进字典中 //定义一个字典,也用[],键和值类型需要保持一致 var dic = ["name":"Tom","age":"20"] dic["age"] = "22" println("\(dic)") //["name":"Tom","age":"22"]dic["sex"]= "M"println("\(dic)") //["name":"Tom","age":"22","sex":"M"] 字典其他运算方式: 遍历字典: 删除元素: 定义未知类型的空数组或空字典 //创建空数组 var arr3 = [] //创建空字典 var dic3 = [:] 定义指定类型的空数组或空字典 //创建空的字符串数组 var emptyArray = [String]() emptyArray = ["Tom"]//创建空的泛型字典 var emptyDictionary = Dictionary<String,Float>() emptyDictionary = ["tom":20,"jobs":23] 创建元组,可以同时存放任意类型的数据 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4902736.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

swift:入门知识之泛型

在尖括号里写一个名字来创建一个泛型函数或者类型 例如<T>、<Type> 可以创建泛型类、枚举和结构体 在类型后使用where来指定一个需求列表。例如,要限定实现一个协议的类型,需要限定两个类型要相同,或者限定一个类必须有一个特定的父类 先给一个具体举例如下: //泛型函数 func repeat<ItemType>(item:ItemType,times:Int)->[ItemType]{ var results:[ItemType] = [ItemType]() for i in 0..<times{ results.append(item) } return results } //第一个参数可以接收任意类型的数据 repeat("Tom", 4) //字符串 repeat(10, 5) //整数 repeat((1,2,3,4), 3) //元组 显示结果: swift泛型具体介绍: http://www.cocoachina.com/newbie/basic/2014/0612/8790.html 泛型代码可以让你写出根据自我需求定义、适用于任何类型的,灵活且可重用的函数和类型。它可以让你避免重复的代码,用一种清晰和抽象的方式来表达代码的意图。 泛型是 Swift 强大特征中的其中一个,许多 Swift 标准库是通过泛型代码构建出来的。事实上,泛型的使用贯穿了整本语言手册,只是你没有发现而已。例如,Swift 的数组和字典类型都是泛型集。你可以创建一个Int数组,也可创建一个String数组,或者甚至于可以是任何其他 Swift 的类型数据数组。同样的,你也可以创建存储任何指定类型的字典(dictionary),而且这些类型可以是没有限制的。 泛型所解决的问题 这里是一个标准的,非泛型函数swapTwoInts,用来交换两个Int值: funcswapTwoInts(inouta:Int,inoutb:Int) lettemporaryA=a a=b b=temporaryA } 这个函数使用写入读出(in-out)参数来交换a和b的值,请参考写入读出参数。 swapTwoInts函数可以交换b的原始值到a,也可以交换a的原始值到b,你可以调用这个函数交换两个Int变量值: varsomeInt=3 varanotherInt=107 swapTwoInts(&someInt,&anotherInt) println("someIntisnow\(someInt),andanotherIntisnow\(anotherInt)") //输出"someIntisnow107,andanotherIntisnow3" swapTwoInts函数是非常有用的,但是它只能交换Int值,如果你想要交换两个String或者Double,就不得不写更多的函数,如 swapTwoStrings和swapTwoDoublesfunctions,如同如下所示: funcswapTwoStrings(inouta:String,inoutb:String){ lettemporaryA=a a=b b=temporaryA } funcswapTwoDoubles(inouta:Double,inoutb:Double){ lettemporaryA=a a=b b=temporaryA } 你可能注意到 swapTwoInts、 swapTwoStrings和swapTwoDoubles函数功能都是相同的,唯一不同之处就在于传入的变量类型不同,分别是Int、String和Double。 但实际应用中通常需要一个用处更强大并且尽可能的考虑到更多的灵活性单个函数,可以用来交换两个任何类型值,很幸运的是,泛型代码帮你解决了这种问题。(一个这种泛型函数后面已经定义好了。) 注意: 在所有三个函数中,a和b的类型是一样的。如果a和b不是相同的类型,那它们俩就不能互换值。Swift 是类型安全的语言,所以它不允许一个String类型的变量和一个Double类型的变量互相交换值。如果一定要做,Swift 将报编译错误。 泛型函数 泛型函数可以工作于任何类型,这里是一个上面swapTwoInts函数的泛型版本,用于交换两个值: funcswapTwoValues<T>(inouta:T,inoutb:T){ lettemporaryA=a a=b b=temporaryA } swapTwoValues函数主体和swapTwoInts函数是一样的,它只在第一行稍微有那么一点点不同于swapTwoInts,如下所示: funcswapTwoInts(inouta:Int,inoutb:Int) funcswapTwoValues<T>(inouta:T,inoutb:T) 这个函数的泛型版本使用了占位类型名字(通常此情况下用字母T来表示)来代替实际类型名(如In、String或Doubl)。占位类型名没有提示T必须是什么类型,但是它提示了a和b必须是同一类型T,而不管T表示什么类型。只有swapTwoValues函数在每次调用时所传入的实际类型才能决定T所代表的类型。 另外一个不同之处在于这个泛型函数名后面跟着的展位类型名字(T)是用尖括号括起来的()。这个尖括号告诉 Swift 那个T是swapTwoValues函数所定义的一个类型。因为T是一个占位命名类型,Swift 不会去查找命名为T的实际类型。 swapTwoValues函数除了要求传入的两个任何类型值是同一类型外,也可以作为swapTwoInts函数被调用。每次swapTwoValues被调用,T所代表的类型值都会传给函数。 在下面的两个例子中,T分别代表Int和String: varsomeInt=3 varanotherInt=107 swapTwoValues(&someInt,&anotherInt) //someIntisnow107,andanotherIntisnow3 varsomeString="hello" varanotherString="world" swapTwoValues(&someString,&anotherString) //someStringisnow"world",andanotherStringisnow"hello" 注意:上面定义的函数swapTwoValues是受swap函数启发而实现的。swap函数存在于 Swift 标准库,并可以在其它类中任意使用。如果你在自己代码中需要类似swapTwoValues函数的功能,你可以使用已存在的交换函数swap函数。 类型参数 在上面的swapTwoValues例子中,占位类型T是一种类型参数的示例。类型参数指定并命名为一个占位类型,并且紧随在函数名后面,使用一对尖括号括起来(如)。 一旦一个类型参数被指定,那么其可以被使用来定义一个函数的参数类型(如swapTwoValues函数中的参数a和b),或作为一个函数返回类型,或用作函数主体中的注释类型。在这种情况下,被类型参数所代表的占位类型不管函数任何时候被调用,都会被实际类型所替换(在上面swapTwoValues例子中,当函数第一次被调用时,T被Int替换,第二次调用时,被String替换。)。 你可支持多个类型参数,命名在尖括号中,用逗号分开。 命名类型参数 在简单的情况下,泛型函数或泛型类型需要指定一个占位类型(如上面的swapTwoValues泛型函数,或一个存储单一类型的泛型集,如数组),通常用一单个字母T来命名类型参数。不过,你可以使用任何有效的标识符来作为类型参数名。 如果你使用多个参数定义更复杂的泛型函数或泛型类型,那么使用更多的描述类型参数是非常有用的。例如,Swift 字典(Dictionary)类型有两个类型参数,一个是键,另外一个是值。如果你自己写字典,你或许会定义这两个类型参数为KeyType和ValueType,用来记住它们在你的泛型代码中的作用。 注意:请始终使用大写字母开头的驼峰式命名法(例如T和KeyType)来给类型参数命名,以表明它们是类型的占位符,而非类型值。 泛型类型 通常在泛型函数中,Swift 允许你定义你自己的泛型类型。这些自定义类、结构体和枚举作用于任何类型,如同Array和Dictionary的用法。 这部分向你展示如何写一个泛型集类型--Stack(栈)。一个栈是一系列值域的集合,和Array(数组)类似,但其是一个比 Swift 的Array类型更多限制的集合。一个数组可以允许其里面任何位置的插入/删除操作,而栈,只允许在集合的末端添加新的项(如同push一个新值进栈)。同样的一个栈也只能从末端移除项(如同pop一个值出栈)。 注意:栈的概念已被UINavigationController类使用来模拟试图控制器的导航结构。你通过调用UINavigationController的pushViewController:animated:方法来为导航栈添加(add)新的试图控制器;而通过popViewControllerAnimated:的方法来从导航栈中移除(pop)某个试图控制器。每当你需要一个严格的后进先出方式来管理集合,堆栈都是最实用的模型。 下图展示了一个栈的压栈(push)/出栈(pop)的行为: 1、现在有三个值在栈中; 2、第四个值“pushed”到栈的顶部; 3、现在有四个值在栈中,最近的那个在顶部; 4、栈中最顶部的那个项被移除,或称之为“popped”; 5、移除掉一个值后,现在栈又重新只有三个值。 这里展示了如何写一个非泛型版本的栈,Int值型的栈: structIntStack{ varitems= [Int]() mutatingfuncpush(item:Int){ items.append(item) } mutatingfuncpop()->Int{ returnitems.removeLast() } } 这个结构体在栈中使用一个Array性质的items存储值。Stack提供两个方法:push和pop,从栈中压进一个值和移除一个值。这些方法标记为可变的,因为他们需要修改(或转换)结构体的items数组。 上面所展现的IntStack类型只能用于Int值,不过,其对于定义一个泛型Stack类(可以处理任何类型值的栈)是非常有用的。 这里是一个相同代码的泛型版本: structStack<T>{ varitems= [T]() mutatingfuncpush(item:T){ items.append(item) } mutatingfuncpop()->T{ returnitems.removeLast() } } 注意到Stack的泛型版本基本上和非泛型版本相同,但是泛型版本的占位类型参数为T代替了实际Int类型。这种类型参数包含在一对尖括号里(<T>),紧随在结构体名字后面。 T定义了一个名为“某种类型T”的节点提供给后来用。这种将来类型可以在结构体的定义里任何地方表示为“T”。在这种情况下,T在如下三个地方被用作节点: - 创建一个名为items的属性,使用空的T类型值数组对其进行初始化; - 指定一个包含一个参数名为item的push方法,该参数必须是T类型; - 指定一个pop方法的返回值,该返回值将是一个T类型值。 当创建一个新单例并初始化时, 通过用一对紧随在类型名后的尖括号里写出实际指定栈用到类型,创建一个Stack实例,同创建Array和Dictionary一样: varstackOfStrings=Stack<String>() stackOfStrings.push("uno") stackOfStrings.push("dos") stackOfStrings.push("tres") stackOfStrings.push("cuatro") //现在栈已经有4个string了 下图将展示stackOfStrings如何push这四个值进栈的过程: 从栈中pop并移除值"cuatro": letfromTheTop=stackOfStrings.pop() //fromTheTopisequalto"cuatro",andthestacknowcontains3strings 下图展示了如何从栈中pop一个值的过程: 由于Stack是泛型类型,所以在 Swift 中其可以用来创建任何有效类型的栈,这种方式如同Array和Dictionary。 类型约束 swapTwoValues函数和Stack类型可以作用于任何类型,不过,有的时候对使用在泛型函数和泛型类型上的类型强制约束为某种特定类型是非常有用的。类型约束指定了一个必须继承自指定类的类型参数,或者遵循一个特定的协议或协议构成。 例如,Swift 的Dictionary类型对作用于其键的类型做了些限制。在字典的描述中,字典的键类型必须是可哈希,也就是说,必须有一种方法可以使其是唯一的表示。Dictionary之所以需要其键是可哈希是为了以便于其检查其是否包含某个特定键的值。如无此需求,Dictionary即不会告诉是否插入或者替换了某个特定键的值,也不能查找到已经存储在字典里面的给定键值。 这个需求强制加上一个类型约束作用于Dictionary的键上,当然其键类型必须遵循Hashable协议(Swift 标准库中定义的一个特定协议)。所有的 Swift 基本类型(如String,Int, Double和 Bool)默认都是可哈希。 当你创建自定义泛型类型时,你可以定义你自己的类型约束,当然,这些约束要支持泛型编程的强力特征中的多数。抽象概念如可哈希具有的类型特征是根据他们概念特征来界定的,而不是他们的直接类型特征。 类型约束语法 你可以写一个在一个类型参数名后面的类型约束,通过冒号分割,来作为类型参数链的一部分。这种作用于泛型函数的类型约束的基础语法如下所示(和泛型类型的语法相同): funcsomeFunction<T:SomeClass,U:SomeProtocol>(someT:T,someU:U){ //functionbodygoeshere } 上面这个假定函数有两个类型参数。第一个类型参数T,有一个需要T必须是SomeClass子类的类型约束;第二个类型参数U,有一个需要U必须遵循SomeProtocol协议的类型约束。 类型约束行为 这里有个名为findStringIndex的非泛型函数,该函数功能是去查找包含一给定String值的数组。若查找到匹配的字符串,findStringIndex函数返回该字符串在数组中的索引值(Int),反之则返回nil: funcfindStringIndex(array: [String],valueToFind:String)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } findStringIndex函数可以作用于查找一字符串数组中的某个字符串: letstrings=["cat","dog","llama","parakeet","terrapin"] ifletfoundIndex=findStringIndex(strings,"llama"){ println("Theindexofllamais\(foundIndex)") } //输出"Theindexofllamais2" 如果只是针对字符串而言查找在数组中的某个值的索引,用处不是很大,不过,你可以写出相同功能的泛型函数findIndex,用某个类型T值替换掉提到的字符串。 这里展示如何写一个你或许期望的findStringIndex的泛型版本findIndex。请注意这个函数仍然返回Int,是不是有点迷惑呢,而不是泛型类型?那是因为函数返回的是一个可选的索引数,而不是从数组中得到的一个可选值。需要提醒的是,这个函数不会编译,原因在例子后面会说明: funcfindIndex<T>(array: [T],valueToFind:T)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } 上面所写的函数不会编译。这个问题的位置在等式的检查上,“if value == valueToFind”。不是所有的 Swift 中的类型都可以用等式符(==)进行比较。例如,如果你创建一个你自己的类或结构体来表示一个复杂的数据模型,那么 Swift 没法猜到对于这个类或结构体而言“等于”的意思。正因如此,这部分代码不能可能保证工作于每个可能的类型T,当你试图编译这部分代码时估计会出现相应的错误。 不过,所有的这些并不会让我们无从下手。Swift 标准库中定义了一个Equatable协议,该协议要求任何遵循的类型实现等式符(==)和不等符(!=)对任何两个该类型进行比较。所有的 Swift 标准类型自动支持Equatable协议。 任何Equatable类型都可以安全的使用在findIndex函数中,因为其保证支持等式操作。为了说明这个事实,当你定义一个函数时,你可以写一个Equatable类型约束作为类型参数定义的一部分: funcfindIndex<T:Equatable>(array: [T],valueToFind:T)->Int?{ for(index,value)inenumerate(array){ ifvalue==valueToFind{ returnindex } } returnnil } findIndex中这个单个类型参数写做:T: Equatable,也就意味着“任何T类型都遵循Equatable协议”。 findIndex函数现在则可以成功的编译过,并且作用于任何遵循Equatable的类型,如Double或String: letdoubleIndex=findIndex([3.14159,0.1,0.25],9.3) //doubleIndexisanoptionalIntwithnovalue,because9.3isnotinthearray letstringIndex=findIndex(["Mike","Malcolm","Andrea"],"Andrea") //stringIndexisanoptionalIntcontainingavalueof2 关联类型 当定义一个协议时,有的时候声明一个或多个关联类型作为协议定义的一部分是非常有用的。一个关联类型给定作用于协议部分的类型一个节点名(或别名)。作用于关联类型上实际类型是不需要指定的,直到该协议接受。关联类型被指定为typealias关键字。 关联类型行为 这里是一个Container协议的例子,定义了一个ItemType关联类型: protocolContainer{ typealiasItemType mutatingfuncappend(item:ItemType) varcount:Int{get} subscript(i:Int)->ItemType{get} } Container协议定义了三个任何容器必须支持的兼容要求: 必须可能通过append方法添加一个新item到容器里; 必须可能通过使用count属性获取容器里items的数量,并返回一个Int值; 必须可能通过容器的Int索引值下标可以检索到每一个item。 这个协议没有指定容器里item是如何存储的或何种类型是允许的。这个协议只指定三个任何遵循Container类型所必须支持的功能点。一个遵循的类型也可以提供其他额外的功能,只要满足这三个条件。 任何遵循Container协议的类型必须指定存储在其里面的值类型,必须保证只有正确类型的items可以加进容器里,必须明确可以通过其下标返回item类型。 为了定义这三个条件,Container协议需要一个方法指定容器里的元素将会保留,而不需要知道特定容器的类型。Container协议需要指定任何通过append方法添加到容器里的值和容器里元素是相同类型,并且通过容器下标返回的容器元素类型的值的类型是相同类型。 为了达到此目的,Container协议声明了一个ItemType的关联类型,写作typealias ItemType。The protocol does not define what ItemType is an alias for—that information is left for any conforming type to provide(这个协议不会定义ItemType是遵循类型所提供的何种信息的别名)。尽管如此,ItemType别名支持一种方法识别在一个容器里的items类型,以及定义一种使用在append方法和下标中的类型,以便保证任何期望的Container的行为是强制性的。 这里是一个早前IntStack类型的非泛型版本,适用于遵循Container协议: structIntStack:Container{ //originalIntStackimplementation varitems= [Int]() mutatingfuncpush(item:Int){ items.append(item) } mutatingfuncpop()->Int{ returnitems.removeLast() } //conformancetotheContainerprotocol typealiasItemType=Int mutatingfuncappend(item:Int){ self.push(item) } varcount:Int{ returnitems.count } subscript(i:Int)->Int{ returnitems[i] } } IntStack类型实现了Container协议的所有三个要求,在IntStack类型的每个包含部分的功能都满足这些要求。 此外,IntStack指定了Container的实现,适用的ItemType被用作Int类型。对于这个Container协议实现而言,定义 typealias ItemType = Int,将抽象的ItemType类型转换为具体的Int类型。 感谢Swift类型参考,你不用在IntStack定义部分声明一个具体的Int的ItemType。由于IntStack遵循Container协议的所有要求,只要通过简单的查找append方法的item参数类型和下标返回的类型,Swift就可以推断出合适的ItemType来使用。确实,如果上面的代码中你删除了 typealias ItemType = Int这一行,一切仍旧可以工作,因为它清楚的知道ItemType使用的是何种类型。 你也可以生成遵循Container协议的泛型Stack类型: structStack<T>:Container{ //originalStack<T>implementation varitems= [T]() mutatingfuncpush(item:T){ items.append(item) } mutatingfuncpop()->T{ returnitems.removeLast() } //conformancetotheContainerprotocol mutatingfuncappend(item:T){ self.push(item) } varcount:Int{ returnitems.count } subscript(i:Int)->T{ returnitems[i] } } 这个时候,占位类型参数T被用作append方法的item参数和下标的返回类型。Swift 因此可以推断出被用作这个特定容器的ItemType的T的合适类型。 扩展一个存在的类型为一指定关联类型 在使用扩展来添加协议兼容性中有描述扩展一个存在的类型添加遵循一个协议。这个类型包含一个关联类型的协议。 Swift的Array已经提供append方法,一个count属性和通过下标来查找一个自己的元素。这三个功能都达到Container协议的要求。也就意味着你可以扩展Array去遵循Container协议,只要通过简单声明Array适用于该协议而已。如何实践这样一个空扩展,在使用扩展来声明协议的采纳中有描述这样一个实现一个空扩展的行为: extensionArray:Container{} 如同上面的泛型Stack类型一样,Array的append方法和下标保证Swift可以推断出ItemType所使用的适用的类型。定义了这个扩展后,你可以将任何Array当作Container来使用。 Where 语句 类型约束中描述的类型约束确保你定义关于类型参数的需求和一泛型函数或类型有关联。 对于关联类型的定义需求也是非常有用的。你可以通过这样去定义where语句作为一个类型参数队列的一部分。一个where语句使你能够要求一个关联类型遵循一个特定的协议,以及(或)那个特定的类型参数和关联类型可以是相同的。你可写一个where语句,通过紧随放置where关键字在类型参数队列后面,其后跟着一个或者多个针对关联类型的约束,以及(或)一个或多个类型和关联类型的等于关系。 下面的列子定义了一个名为allItemsMatch的泛型函数,用来检查是否两个Container单例包含具有相同顺序的相同元素。如果匹配到所有的元素,那么返回一个为true的Boolean值,反之,则相反。 这两个容器可以被检查出是否是相同类型的容器(虽然它们可以是),但他们确实拥有相同类型的元素。这个需求通过一个类型约束和where语句结合来表示: funcallItemsMatch< C1:Container,C2:Container whereC1.ItemType==C2.ItemType,C1.ItemType:Equatable> (someContainer:C1,anotherContainer:C2)->Bool{ //checkthatbothcontainerscontainthesamenumberofitems ifsomeContainer.count!=anotherContainer.count{ returnfalse } //checkeachpairofitemstoseeiftheyareequivalent foriin0..someContainer.count{ ifsomeContainer[i]!=anotherContainer[i]{ returnfalse } } //allitemsmatch,soreturntrue returntrue } 这个函数用了两个参数:someContainer和anotherContainer。someContainer参数是类型C1,anotherContainer参数是类型C2。C1和C2是容器的两个占位类型参数,决定了这个函数何时被调用。 这个函数的类型参数列紧随在两个类型参数需求的后面: C1必须遵循Container协议 (写作 C1: Container)。 C2必须遵循Container协议 (写作 C2: Container)。 C1的ItemType同样是C2的ItemType(写作 C1.ItemType == C2.ItemType)。 C1的ItemType必须遵循Equatable协议 (写作 C1.ItemType: Equatable)。 第三个和第四个要求被定义为一个where语句的一部分,写在关键字where后面,作为函数类型参数链的一部分。 这些要求意思是: someContainer是一个C1类型的容器。 anotherContainer是一个C2类型的容器。 someContainer和anotherContainer包含相同的元素类型。 someContainer中的元素可以通过不等于操作(!=)来检查它们是否彼此不同。 第三个和第四个要求结合起来的意思是anotherContainer中的元素也可以通过 != 操作来检查,因为他们在someContainer中元素确实是相同的类型。 这些要求能够使allItemsMatch函数比较两个容器,即便他们是不同的容器类型。 allItemsMatch首先检查两个容器是否拥有同样数目的items,如果他们的元素数目不同,没有办法进行匹配,函数就会false。 检查完之后,函数通过for-in循环和半闭区间操作(..)来迭代someContainer中的所有元素。对于每个元素,函数检查是否someContainer中的元素不等于对应的anotherContainer中的元素,如果这两个元素不等,则这两个容器不匹配,返回false。 如果循环体结束后未发现没有任何的不匹配,那表明两个容器匹配,函数返回true。 这里演示了allItemsMatch函数运算的过程: varstackOfStrings=Stack<String>() stackOfStrings.push("uno") stackOfStrings.push("dos") stackOfStrings.push("tres") vararrayOfStrings=["uno","dos","tres"] ifallItemsMatch(stackOfStrings,arrayOfStrings){ println("Allitemsmatch.") }else{ println("Notallitemsmatch.") } //输出"Allitemsmatch." 上面的例子创建一个Stack单例来存储String,然后压了三个字符串进栈。这个例子也创建了一个Array单例,并初始化包含三个同栈里一样的原始字符串。即便栈和数组否是不同的类型,但他们都遵循Container协议,而且他们都包含同样的类型值。你因此可以调用allItemsMatch函数,用这两个容器作为它的参数。在上面的例子中,allItemsMatch函数正确的显示了所有的这两个容器的items匹配。 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4905273.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

swift:入门知识之类和对象

1、swift中使用class创建一个类。一个类的声明则是在类里作为常量或变量声明的,除了是在类的上下文中。在方法和函数中也是这么写的。 2、swift中使用init(...)作为初始化构造函数 3、swift中使用构造函数初始化成员变量时,格式为 : self.name = name.构造器的声明跟函数一样,除了会创建类的实例。每一个属性都需要赋值,无论在声明里还是在构造器里。 4、swift中使用deinit来创建一个析构函数,由系统自动调用来撤销对象,进行内存的清理工作 5、swift中子类继承父类时,一冒号:隔开。在继承标准根类时无需声明,所以你可以忽略超类 6、swift中子类重写父类的方法时,必须使用关键词override重载超类中的实现,如果没有这个关键词,编译器会报错 7、swift中可以设置get和set方法,例如如下所示: var perimeter: Double { //getter方法 get{ return slideLength } //setter方法 set{ slideLength = newValue/2 } } 具体举例如下: 定义一个没有构造函数的类Shape //声明一个没有构造函数的类 class Shape{ //成员变量,边数 var numberOfSides = 0 //成员方法 func simpleDescripton()->String{ return "A shape with \(numberOfSides) sides." } } //创建对象 var shape = Shape() //{numberOfSides 0} //设置成员变量 shape.numberOfSides = 4 //调用成员方法 shape.simpleDescripton() //"A shape with 4 sides" 定义一个子类NameShape继承上面的父类Shape,子类带一个init构造函数和一个deinit析构函数 //声明带构造函数的类,继承父类Shape class NameShape : Shape{ //形状的名字 var name:String //初始化方法 init(name:String){ self.name = name } //虚构方法,不可以显示调用,系统会在程序执行结束后自动调用,清理内存 deinit{ println("deinit") } //成员方法,重写父类的方法必须要加上关键字 override override func simpleDescripton()->String{ return "A shape with name:\(name) have \(numberOfSides) sides." } } //创建对象,参数名不可以省略 var nameshape:NameShape = NameShape(name:"rect") //{{numberOfSides 0} name"rect"} //设置成员变量 nameshape.numberOfSides = 4 //{{numberOfSides 4} name "rect"} //调用成员方法 nameshape.simpleDescripton() //"A shape with name:rect have 4 sides" 定义一个正方形类Square继承上面的父类NameShape,其实它也继承了根父类Shape,Square继承它父类所有公有的属性和方法,在初始化时,子类可以借助父类的初始化方法给它们共有的属性赋初值 //继承父类NameShape class Square: NameShape { //边长 var slideLength:Double = 0.0 //子类自己的初始化方法 init(slideLength:Double,name:String) { self.slideLength = slideLength //调用父类的初始化方法 super.init(name: name) //直接用从父类继承的边数属性 numberOfSides = 4 } //设置对象的set和get方法 var perimeter: Double { //getter方法 get{ return slideLength } //setter方法 set{ slideLength = newValue/2 } } //定义求面积的方法 func area() -> Double{ return slideLength*slideLength } override func simpleDescripton() -> String { return "A shape with name:\(name) have \(numberOfSides) sides.its area is \(area())" } } //创建对象时的参数名不可以省略 var square:Square = Square(slideLength:2,name:"正方形") square.perimeter = 6 square.simpleDescripton() //"A shape with name:正方形 have 4 sides .its area is 9.0" square.slideLength //3 可以给参数的参数名再设置一个名字,函数内部使用参数的原始名,调用时使用设置参数名的名称,即外部名,前一章函数部分已经介绍过 class Counter{ var count:Int = 0 //给第二个参数times再设置一个名称numberOfTimes,不过函数内部使用的还是times func incrementBy(amount: Int, numberOfTimes times: Int){ count += amount * times } } var counter = Counter() //创建一个对象//调用函数时,用的第二个参数的名称为numberOfTimes counter.incrementBy(2, numberOfTimes: 7) //14 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4903057.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux 小知识翻译 - 「架构」(arch)

这次,聊聊「架构」这个术语。 在PC相关的文档中,是不是经常看到「x86架构」这个短句。但是对于这句话,是不是总感到有种似懂非懂的感觉。 架构的英语是「architecture」。这里面有「建筑」,「建筑风格」,「构造」的意思。实际上架构这个词在很多领域中都有「构造」的意思。 其实,即使在电脑的世界里,「架构」也有被用在多种场合。软件设计中会使用「架构」这个术语,硬件中也会使用「架构」这个术语。 使用时会涉及到多个方面,很难用一句话来概括「架构」的意思,但基本含有之前提到的「构造」,「设计风格」的意思。 那么,「x86架构」指的又是什么呢?「x86」是被称为电脑的头脑的CPU的一种。 所以,说「x86架构」的时候,就是指以 x86 CPU为核心的各种硬件的组合。 总之,只有CPU的话电脑是无法运行的,根据CPU的不同,硬件(使用什么样主板好呢?使用什么样的内存好呢?等等)的构成也会变化。 把和CPU相关的硬件的全体被称为「架构」,这样来考虑可能比较好。 (硬件)架构这个术语产生的理由是因为软件会「根据硬件架构的不同而改变」。即,同样的软件,可能在某些架构上能运行,其他架构上则不能运行或者运行的不好。 为了防止这种事情,有必要掌握使用软件的电脑的架构是什么样的。 标签: linux 本文转自wang_yb博客园博客,原文链接:http://www.cnblogs.com/wang_yb/p/3796348.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

android,java知识点总结

monkey List ,HashMap ,set ,HashTable ,eventBus ,LitPal ,OkHttp ,Glide ,热修复,线程安全,线程池,6.0以及5.0权限管理,7.0分屏画中画;材料设计语言,蓝牙,wifi,ViewDrapHelper,动画,排序,RandomAccess,Rxjava,注解,设计模式。类设计,项目结构设计。功能设计。泛型数据结构。SqlLiteOpenHelper。内存泄漏。adb命令等等 1、使用aapt进行apk信息的查看 aapt dump dadging 跟上apk路径 (必须要注意要配置aapt 环境变量) 2、特殊字符在string.xml中需要进行转义 `一般需要注意的就是< 、> 、@,?等等可以使用"<( ̄︶ ̄)>" 类似这样进行包装;也可以是使用 ,使用比如颜文字` <!--颜文字 --> <string-array name="emoji_array"> <item>⊙▽⊙</item> <item> ( ؕؔʘ̥̥̥̥ ه ؔؕʘ̥̥̥̥ )? </item> <item>( •̅_•̅ ) </item> <item><MSGCONTENT><![CDATA["<( ̄︶ ̄)>" ]]></MSGCONTENT></item> <item>(๑ ̄ ̫  ̄๑) </item> <item>눈_눈 </item> <item>ᕙ(⇀‸↼‵‵)ᕗ</item> <item> ( ・᷄ ᵌ・᷅ ) </item> <item>(৹ᵒ̴̶̷᷄﹏ᵒ̴̶̷᷅৹) </item> <item>( ˉ ⌓ ˉ ๑) </item> <item> o(〃\'▽\'〃)o </item> <item>₍₍ (̨̡ ‾᷄ᗣ‾᷅ )̧̢ ₎₎ </item> <item>( ¬_¬) </item> <item>( ゚皿゚) </item> <item>(▭-▭) </item> <item>π_π </item> <item>(¬ω¬) </item> <item>(。•ˇ‸ˇ•。)</item> <item>(。・ω・。)ノ</item> <item>ू(ʚ̴̶̷́ .̠ ʚ̴̶̷̥̀ ू)</item> <item>ლ(●ↀωↀ●)ლ</item> <item>(ノ ̄д ̄)ノ</item> <item>⸂⸂⸜(രᴗര๑)⸝⸃⸃</item> <item>-_-||</item> <item>ɿ(。・ɜ・)ɾ</item> <item>p(´⌒`。q)</item> <item>⊙ω⊙</item> <item>ꉂ ೭(˵¯̴͒ꇴ¯̴͒˵)౨”</item> <item>(ღ˘⌣˘ღ)</item> <item>→_→ </item> <item>〜( ̄△ ̄〜)</item> <item>←_←</item> <item>؏؏ᖗ乛◡乛ᖘ؏؏</item> <item>\@_@</item> <item>(^3^)</item> <item>≥﹏≤</item> <item>^ω^</item> <item>^_^</item> <item>\^O^/</item> <item>T_T</item> <item>◑▂◐</item> <item>-_-#</item> </string-array> 3、android EditText 在获取到焦点的时候就会弹出软键盘,然后是不会执行onClick方法的,因为第一次点击如果是没有获取到焦点的话首先会获取焦点,然后下一次点击才会执行onCLick,如果需要首先执行onCLick的话,那么就要在布局中设置 android:clickable="true" android:focusableInTouchMode=“false" 然后点击的时候会执行onClick,然后在里边可以设置 mEditText.setFocusable(true); mEditText.setFocusableInTouchMode(true); mEditText.requestFocus(); mEditText.requestFocusFromTouch(); 然后就可以获取到焦点,然后在做软键盘的弹出 4、EditText 添加onScrollListener 只在5.0以上(不包括5.0)有这个方法,必须要保证最小编译版本在23 5、关于List源码学习: List 是一个接口,它继承了Collection接口,Collection继承了Iterable接口, Iterable里边定义了Iterator,foreach,spliterator这么三个方法Collection继承了以后在里边添加了add ,remove,clear,hashCode,equals,spliterator,retainAll,addAll,removeAll,toArray,containsAll,contains等方法List在继承了以后添加了get,set,indexOf,lastIndexOf,listIterator,subList,replaceAll,sort这几个方法。 我们在使用List的时候都是使用它的实现类ArrayList,LinkedList,Vector。 ArrayList的实现: 在实现了List接口以后我们会重写里边所有的方法,然后实现对应的功能,ArrayList还继承了AbstracList这个抽象类,这个类继承自AbstractCollection,然后实现了List接口(抽象类的主要作用就是实现共有部分功能) 但是大部分功能都是在ArrayList中进行的实现。ArrayList提供了三个构造方法 1、默认的无参构造方法,默认长度为10 public ArrayList() { super(); this.elementData = EMPTY_ELEMENTDATA; } 2、指定集合长度 public ArrayList(int initialCapacity) { super(); if (initialCapacity < 0) throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); this.elementData = new Object[initialCapacity]; } 3、以集合为参数 public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); size = elementData.length; // c.toArray might (incorrectly) not return Object[](see 6260652) if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } 其中的elementData是一个object类型的数组,用来存放集合中的元素。集合默认长度为10,如果要添加的元素超过了这个长度就会进行扩容,调用ensureCapacity,ensureExplicitCapacity,ensureExplicitCapacity,grow() private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // minCapacity is usually close to size, so this is a win: elementData = Arrays.copyOf(elementData, newCapacity); } 最后是通过Arrays的copyOf方法复制一个新的长度为newCapacity的数组,新的长度就等于老的长度除以2 + 老的长度,然后在进行下边的判断计算最终的长度。 所以从这些流程可以看到ArrayList在数据频繁添加的过程中会有频繁的扩容操作,因为会有数组的copy过程,如果数据量很大的时候会影响性能,最后是能确定他的最终大小,在初始化的时候直接申请。而且ArrayList是基于数组来进行数据元素的存储,所以在插入的过程中都会有元素的移动,插入速度相当慢。查询 6 、adb monkey 首先确保android的adb命令是ok的。然后就是monkey命令的参数说明。adb shell 进入手机命令行然后就可以执行 monkey 看到 monkey的参数说明 shell@PD1624:/ $ monkey usage: monkey [-p ALLOWED_PACKAGE [-p ALLOWED_PACKAGE] ...] [-c MAIN_CATEGORY [-c MAIN_CATEGORY] ...] [--ignore-crashes] [--ignore-timeouts] [--ignore-security-exceptions]//忽略安全检查 [--monitor-native-crashes] [--ignore-native-crashes] //忽略native 异常 [--kill-process-after-error]//发生错误时杀掉进程 [--hprof] //生成hprof文件 [--pct-touch PERCENT] [--pct-motion PERCENT]//该种类型事件的百分比 [--pct-trackball PERCENT]//轨迹球的事件百分比 [--pct-syskeys PERCENT]//系统事件百分比 [--pct-nav PERCENT] [--pct-majornav PERCENT] [--pct-appswitch PERCENT] [--pct-flip PERCENT] [--pct-anyevent PERCENT] [--pct-pinchzoom PERCENT] [--pct-permission PERCENT] [--pkg-blacklist-file PACKAGE_BLACKLIST_FILE]//黑名单 [--pkg-whitelist-file PACKAGE_WHITELIST_FILE]//白名单 [--wait-dbg] [--dbg-no-events] [--setup scriptfile] [-f scriptfile [-f scriptfile] ...] [--port port] [-s SEED] //设置随机种子数,如果俩次seed值相同,那么对于同一事件那么执行的结果完全相同 [-v [-v] ...] 作用:命令行上的每一个-v都将增加反馈信息的详细级别。 Level0(默认-v),除了启动、测试完成和最终结果外只提供较少的信息。 Level1(-v -v),提供了较为详细的测试信息,如逐个发送到Activity的事件信息。 Level2(-v -v -v),提供了更多的设置信息,如测试中选中或未选中的Activity信息。 [--throttle MILLISEC] [--randomize-throttle]//事件的延迟时间(这个时间设置了以后不是特别准备,如果需要确定要跑多久的monkey的话需要计算执行一次时间所花费的时间,然后用时间除以一个事件的时长算出要执行的次数) [--profile-wait MILLISEC] [--device-sleep-time MILLISEC]//设备睡眠事件 [--randomize-script] //随机脚本 [--script-log]//脚本log [--bugreport]//bug报告 [--periodic-bugreport]//定期bug报告 [--permission-target-system] COUNT //数量 >> 使用这个命令输出monkey日志到目标地址的文件中(这个不是monkey命令,是命令统一的输出方式) 从上边可以发现一个monkey命令的完整写法 简单的命令: monkey -v -p com.android.bluetooth 200-v log级别 -p 后边跟包名 200 就是要执行事件的次数 这就是一个简单的monkey测试 monkey -v -p com.guoyi.qinghua --pct-majornav 20 --monitor-native-crashes --ignore-security-exceptions --ignore-crashes --ignore-timeouts --kill-process-after-error -s 220 --throttle 300 500000 >> ../monkey.txt 因为monkey在测试过程中事件的延迟时间(这个时间设置了以后不是特别准确,如果需要确定要跑多久的monkey的话需要计算执行一次时间所花费的时间,然后用时间除以一个事件的时长算出要执行的次数)如果--throttle 1000 ,那么计算次数的方式 count= (时长 单位毫秒)/(一次事件的时间) monkey -v -v -v -p com.xxxx.xxx --throttle 1000 count 7、关于进入手机设置界面 可以通过抓包来获取当前ActivityManager来获取,当前跳转的activity的信息。下边是adb 命令adb logcat | grep ActivityManager 进入系统设置的所有界面都可以通过Intent 只要设置不同的Settings就可以 Intent appIntent = new Intent(); appIntent = new Intent(Settings.ACTION_SETTINGS); context.startActivity(appIntent); 只要替换Settings的值就可以,如果要进入其中一个应用的详情设置了Settings以后的话还需要传递包名 appIntent.setData(Uri.parse("package:" + context.getPackageName())); 但是android系统没有专门的权限管理。如果要进入权限管理必须要对不同系统进行区别,然后根据不同的定制系统来进行处理跳转。//vivo权限管理界面 appIntent.setClassName("com.iqoo.secure", "com.iqoo.secure.safeguard.PurviewTabActivity"); 然后可以通过adb 命令来启动一个页面 db shell am start -n com.android.settings/com.letv.leui.settings.LeUIMainSettings 8、关于EventBus源码学习 EventBus 的学习首先从 EventBus这个类开始。 这个类主要是用来进行EventBus的初始化,注册反注册,发送事件或者移除事件,是整个工具所暴露的可以进行操作的一个工作接口。 EventBus在初始化上边有俩种方式: (1)、通过getDefault() (2)、通过new EventBus() 但是实际创建方式都是通过Builder(建造者模式来进行创建)跟所有的建造者模式一样,都是通过一个私有的构造方法以EventBusBuilder对象为参数来进行对象的创建。 然后调用register来进行注册。在调用register这个方法的时候会传递一个要注册的对象的。然后会通过反射来获取这个对象中的所有的方法。然后会通过方法来找到其中订阅了EventBus的事件的方法。然后通过subscribe这个方法,把这些方法添加到订阅列表中。 public void register(Object subscriber) { Class<?> subscriberClass = subscriber.getClass(); List<SubscriberMethod> subscriberMethods = subscriberMethodFinder.findSubscriberMethods(subscriberClass); synchronized (this) { for (SubscriberMethod subscriberMethod : subscriberMethods) { subscribe(subscriber, subscriberMethod); } } } 反注册的流程与一般的订阅者都是一样的,把订阅的方法都从订阅队列进行删除。 剩下的就是事件的发送: 因为整个EventBus的架构就是观察者模式。 所以事件发送其实就是通过EventBus对象对所有订阅了这个事件的订阅者进行通知,然后在他订阅的方法里边就可以进行处理。 public void post(Object event) { PostingThreadState postingState = currentPostingThreadState.get(); List<Object> eventQueue = postingState.eventQueue; eventQueue.add(event); if (!postingState.isPosting) { postingState.isMainThread = Looper.getMainLooper() == Looper.myLooper(); postingState.isPosting = true; if (postingState.canceled) { throw new EventBusException("Internal error. Abort state was not reset"); } try { while (!eventQueue.isEmpty()) { postSingleEvent(eventQueue.remove(0), postingState); } } finally { postingState.isPosting = false; postingState.isMainThread = false; } } } 然后postSingleEvent ->postSingleEventForEventType->postToSubscription 然后执行真正的事件发送。 private void postToSubscription(Subscription subscription, Object event, boolean isMainThread) { switch (subscription.subscriberMethod.threadMode) { case POSTING: invokeSubscriber(subscription, event); break; case MAIN: if (isMainThread) { invokeSubscriber(subscription, event); } else { mainThreadPoster.enqueue(subscription, event); } break; case BACKGROUND: if (isMainThread) { backgroundPoster.enqueue(subscription, event); } else { invokeSubscriber(subscription, event); } break; case ASYNC: asyncPoster.enqueue(subscription, event); break; default: throw new IllegalStateException("Unknown thread mode: " + subscription.subscriberMethod.threadMode); } } 说是发送,其实是通过反射来调用被订阅的方法。(只要我们能拿到被订阅的方法所在的类的对象,就可以执行他里边的方法)也就是通过EventBus中的invokeSubscriber方法 void invokeSubscriber(PendingPost pendingPost) { Object event = pendingPost.event; Subscription subscription = pendingPost.subscription; PendingPost.releasePendingPost(pendingPost); if (subscription.active) { invokeSubscriber(subscription, event); } } void invokeSubscriber(Subscription subscription, Object event) { try { subscription.subscriberMethod.method.invoke(subscription.subscriber, event); } catch (InvocationTargetException e) { handleSubscriberException(subscription, event, e.getCause()); } catch (IllegalAccessException e) { throw new IllegalStateException("Unexpected exception", e); } } 还有些要注意的类,就是HandlerPoster,这个类主要是维护了一个队列,用来管理要发送的事件。他的内在实现其实是通过Handler来进行的。handler就不需要多说了。AsyncPoster 异步Poster,通过实现Runnable,通过ExectorService 进行线程管理。BackgroundPoster后台Poster,通过实现Runnable进行实现,通过ExectorService 进行线程管理。它使用的是Executors.newCachedThreadPool创建的缓存线程池。具体什么事缓存线程池可以看相关的文章。 private final static ExecutorService DEFAULT_EXECUTOR_SERVICE = Executors.newCachedThreadPool(); 总结: **EventBus的整体架构是通过 观察者模式来进行事件的订阅,然后在订阅的事件发生了改变以后通知所有的订阅者。在这个过程中使用到了反射来进行。在订阅的时候通过反射获取到当前对象所定于的方法,在有改变的通过反射执行被订阅的方法,然后就可以处理自己的逻辑。 在发送事件的时候(post)我们会判断当前事件是在什么线程中执行。然后做相应的处理。对与事件处理主要使用了Handler(初始化的时候默认是主线程Handler),使用线程池进行事件的管理。里边用到了多线程的并发处理:使用ThreadLocal ,CopyOrWriteArrayList;synchronized。ThreadLocal 会为每一个线程创建一个副本对象,CopyOrWirteArrayList是通过copy一份数据,然后在Write的时候通过创建一个新的对象,然后对新的对象进行write,然后把新对象赋值给旧对象来保证线程安全。读取的时候通过使用旧的对象来进行,因为读取是不需要关注线程安全问题。synchronized同步锁,只有持有这个方法的所的对象才能进入这个方法,其他的都要等待。** 9、关于RecycleView的使用 使用RecyvleView的方式很简单,跟使用ListView,GridView类似,只是RecycleView可以实现比这俩个控件更多的功能。只要通过LayoutManager进行设置。 RecycleView没有onItemClickListener,需要自己实现。RecycleView 如果有错位的问题,那么肯定也是跟ListView一样因为复用引起的,其实修改原理都类似。个人觉得只要把复用的View里边的参数都还原成最初的状态(如果view成为最原始的状态,那么只要数据没有问题,就不会有错位的事了),然后通过tag来进行判断,然后在更新View即可。 RecycleView的adapter里边强制使用VIewHolder。为了减少重复创建对象的消耗(主要是会影响性能)。 RecycleView 滚动条的设置使用的是View的通用滚动条设置。 android:scrollbars=“horizontal" //设置滚动条的方向 android:scrollbarAlwaysDrawHorizontalTrack=“true" //设置总是绘制横向滚动条 android:scrollbarThumbHorizontal=“@drawable/scrollbar_line”//横向滚动条 android:scrollbarTrackHorizontal=“@drawable/scrollbar_line_track”//横向滚动条的轨道 android:paddingBottom="20dp" android:scrollbarStyle=“outsideInset" //设置显示的位置 android:fadeScrollbars=“false" //是否一直显示 如果要设置不一样粗细的滚动条与轨道,可以通过使用不同粗细的进度图片来实现,也可以通过使用shape来自定义滚动条与轨道,自定义的时候滚动条的高度要比轨道的高,这样横向滚动条与轨道就会不一样粗细。 10、fresco是一个很强大的图片加载库,不同的功能都有相对应的库模块来处理。 11、android中点击电源键关闭屏幕的话。 如果现在屏幕是竖屏没有任何影响,如果是横屏,会销毁activity,然后在启动这个Activity 。会导致activity数据的丢失。如果只是数据可以通过onSaveInstance进行保存,但是如果正在进行通话或者长连接的功能,会导致功能中断。解决方式: 1、使屏幕常亮 2、设置activity的 android:configChanges=“orientation|keyboardHidden|screenSize" 12、jni 编译 : (1)首先项目的sdk地址 创建native方法,然后点击studio的make project生成class文件 (2)然后切换到项目package目录下 (例如 com.xxx.xxx.xx) 调用 javaH -d ../jni “包名 + 类名” 然后会在jni文件夹下生成.h头文件。然后创建c或c++文件,进行代码的编写,可以直接复制头文件到c或c++文件中。提供的头文件里边的参数需要自定义名称。是一个空的实现。(3)配置app.gradle文件 ndk { moduleName"jnilib" ldLibs "log", "z", "m" abiFilters "armeabi", "armeabi-v7a", "x86" } 如果不知道studio支持的ndk可编译版本可以在gradle.properties添加android.useDeprecatedNdk=true//可使用过时版本 (如果使用studio编译以后运行出现dlopen failed: cannot locate symbol "__aeabi_memcpy" referenced by “/data/app/com.example.chenpengfei.uninstallreceiver-2/lib/arm/libjnilib.so”,那么是因为sdk版本的问题,23及以下,或者更新studio到最新版本) 13、LinkedList源码学习: 关于LinkedList 类的功能来说,也是一个集合容器类,实现了List接口,但是他内部的数据结构跟ArrayList不一样,使用的是链表。而实现链表主要是通过Node这个类。 他继承了AbstractSequentialList,而这个类其实是继承了AbstractList。他与ArrayList不一样的就是他实现了Deque接口。 因为它是基于Node实现的列表,那么需要关注的就是Node这个类 private static class Node<E> { E item; Node<E> next; Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } 这个类会保存它上一个节点node,跟下一个节点node。 如果是有俩个节点那么a 节点的next指向b节点 ,pre也指向b,b的pre指向a,next也指向a,这样就形成了一个闭环。实现了双向链表。 如果是三个的话 a 节点的next 指向b ,pre指向c,b 节点的next 指向c,pre指向a,而c节点的next指向a,pre指向b。这样也是一个闭环。 所以LinkedList存储数据的时候特别快。直接把节点的指向改变了就可以了。但是存储的时候也分几种情况:如果是直接添加的话不管是添加到首部还是尾部都直接修改节点指向,但是如果是指定下标来进行添加的话,会折半查找到下边的node节点,然后在该节点处修改节点指向。速度会慢点。但是查询的时候就需要类似上边的折半以后进行查找,然后返回该节点。速度就会比ArrayList慢很多。毕竟人家是实现了RendemAsscess接口,而且内部结构是array,查询没的比啊。 14、Vector源码学习 通过学习ArrayList 与LinkedList以后在学习Vector发现没有太多要注意的地方。因为Vector是跟ArrayList基本上完全相同的,只是在某些地方有点区别。Vector是线程安全的,在很多方法上都加了线程锁,synchronize,实现同步。内部结构完全就是ArrayList的结构,只是在容量扩展的时候这是Vecctor的容量扩展 private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + ((capacityIncrement > 0) ? capacityIncrement : oldCapacity); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); elementData = Arrays.copyOf(elementData, newCapacity); } 这是ArrayList的容量扩展 private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // minCapacity is usually close to size, so this is a win: elementData = Arrays.copyOf(elementData, newCapacity); } 可以发现在进行容量扩展的时候 newCapacity的值在取值的时候有点区别ArrayList是直接扩展为原来容量的3/2,但是Vector因为有 一个容量扩充的参数capacityIncrement,如果不为0,那么每次扩展是在原来的基础上增加capacityIncrement的长度,否则就是原来的2倍。 因为跟ArrayList很相似,学习的过程中发现比较一下这几个实现了List接口的类更有用: ArrayList、Vecotr、LinkedList的区别(源码角度): 区别: 1、 ArrayList、Vector使用的是数组的数据结构来进行数据的存储,实现了RandomAccess接口提供快速随机访问。 而LinkedList是通过链表这样的数据接口来存储数据,他实现了Deque接口,在随机访问方面性能很差,因为需要遍历这个链表中的节点(虽然是折半以后的遍历,但是一样很慢) 2、 容量扩展对于LinkedList来说是没有任何关系的,因为它不需要。但是对于ArrayList于Vector来说这是很重要的点。因为他们的初始容量都是10,除非你指定了他的容量。但是在把数据进行添加的过程中,他们会检查容量是否足够存放数据,如果不够就要进行容量的扩展。容量的扩展是通过创建一个新的容量的数组,然后指向上一个数组对象,创建的方式是调用一个系统的arrayCopy方法。数据量很大的话对与性能有很大影响,使用的时候根据需要可以指定初始容量。这就是他们之间的又一个不同点,插入效率,很明显LinkedList很快,但是Vector与ArrayList很慢 Android 虚拟现实开发 开发者中心地址:https://vr.google.com/daydream/developers/ 按需要下载自己需要的sdk已经开发工具 15、HashMap源码学习 HashMap是一个存储键值对的容器类,通过学习他的源码来熟悉他的实现。首先说下HashMap 1.8之前,最基本的实现是通过维护一个Entry[]的数组已经单链表来实现的数据存储。 就是当我们在创建一个HashMap以后,通过调用put方法,会进行很多判断,最后把我们要存放的数据添加到Entry[]数组中。 public V put(K key, V value) { if (key == null) return putForNullKey(value); // 得到key的哈希码 int hash = hash(key); // 通过哈希码计算出bucketIndex int i = indexFor(hash, table.length); // 取出bucketIndex位置上的元素,并循环单链表,判断key是否已存在 for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; // 哈希码相同并且对象相同时 if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { // 新值替换旧值,并返回旧值 V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } // key不存在时,加入新元素 modCount++; addEntry(hash, key, value, i); return null; } 但是在1.8以后,为了实现快速查找,添加了红黑树。里边维护的数组变为了Node[]数组,一个实现Map.Entry接口的类。这应该是1.8改动最大的地方。 1 public V put(K key, V value) { 2 // 对key的hashCode()做hash 3 return putVal(hash(key), key, value, false, true); 4 } 5 6 final V putVal(int hash, K key, V value, boolean onlyIfAbsent, 7 boolean evict) { 8 Node<K,V>[] tab; Node<K,V> p; int n, i; 9 // 步骤①:tab为空则创建 10 if ((tab = table) == null || (n = tab.length) == 0) 11 n = (tab = resize()).length; 12 // 步骤②:计算index,并对null做处理 13 if ((p = tab[i = (n - 1) & hash]) == null) 14 tab[i] = newNode(hash, key, value, null); 15 else { 16 Node<K,V> e; K k; 17 // 步骤③:节点key存在,直接覆盖value 18 if (p.hash == hash && 19 ((k = p.key) == key || (key != null && key.equals(k)))) 20 e = p; 21 // 步骤④:判断该链为红黑树 22 else if (p instanceof TreeNode) 23 e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); 24 // 步骤⑤:该链为链表 25 else { 26 for (int binCount = 0; ; ++binCount) { 27 if ((e = p.next) == null) { 28 p.next = newNode(hash, key,value,null); //链表长度大于8转换为红黑树进行处理 29 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st 30 treeifyBin(tab, hash); 31 break; 32 } // key已经存在直接覆盖value 33 if (e.hash == hash && 34 ((k = e.key) == key || (key != null && key.equals(k)))) break; 36 p = e; 37 } 38 } 39 40 if (e != null) { // existing mapping for key 41 V oldValue = e.value; 42 if (!onlyIfAbsent || oldValue == null) 43 e.value = value; 44 afterNodeAccess(e); 45 return oldValue; 46 } 47 } 48 ++modCount; 49 // 步骤⑥:超过最大容量 就扩容 50 if (++size > threshold) 51 resize(); 52 afterNodeInsertion(evict); 53 return null; 54 } 跟所有的容器类一样,这个类里边也定义size, modcout,loadFactor(负载因子),threshold(判断是否需要扩展的界限 他的值等于初始容量乘以 负载因子),默认的初始容量是 1<< 4 , Hash主要是通过散列表来进行存储,通过计算key的hash值,然后计算要存放的下标,然后放到数组中对应的位置。如果计算出来的hash相同,那么比较key是否相等,如果相等,那么久覆盖旧值,返回旧值,如果不相同,那么创建Node对象,然后与该位置中的Node链表进行连接,使Node链表的最新的节点是新创建的Node对象。 HashMap的扩容是扩容为 原来的2倍。 因为HashMap是通过散列表来进行存储,所以会有空间的浪费,也就是用空间换取时间。查找的时候通过计算key的hash值,然后计算在数组中的下标,可以快速的进行查找。HashMap中使用链表主要是为了解决碰撞问题,也就是会有相同的Hash值的问题。 16、HashSet源码: HashSet用来存放单一数据,不在是键值对,而且存储到其中的数据没有顺序,但是他可以保证数据不会重复(前提是你要重新hashCode 以及equals方法)。因为HashSet的底层实现是通过HashMap来进行实现的。通过他的构造方法可以看到: public HashSet(int initialCapacity) { map = new HashMap<>(initialCapacity); } public HashSet(int initialCapacity, float loadFactor) { map = new HashMap<>(initialCapacity, loadFactor); } public HashSet(Collection<? extends E> c) { map = new HashMap<>(Math.max((int) (c.size()/.75f) + 1, 16)); addAll(c); } public HashSet() { map = new HashMap<>(); } 如果对HashMap源码了解的话很简单就可以看懂。 HashSet提供了add方法进行数据的添加,也提供了容器类基本的功能。比如删除,是否包含,是否为空等等。使用HashSet的时候遍历数据是通过HashMap的KeySet这个类进行的。 final class KeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { HashMap.this.clear(); } public final Iterator<K> iterator() { return new KeyIterator(); } public final boolean contains(Object o) { return containsKey(o); } public final boolean remove(Object key) { return removeNode(hash(key), key, null, false, true) != null; } public final Spliterator<K> spliterator() { return new KeySpliterator<>(HashMap.this, 0, -1, 0, 0); } public final void forEach(Consumer<? super K> action) { Node<K,V>[] tab; if (action == null) throw new NullPointerException(); if (size > 0 && (tab = table) != null) { int mc = modCount; for (int i = 0; i < tab.length; ++i) { for (Node<K,V> e = tab[i]; e != null; e = e.next) action.accept(e.key); } if (modCount != mc) throw new ConcurrentModificationException(); } } } 从这个可以看出,我们可以是用ForEach,或者迭代器。 HashSet实现数据不重复就是重写了HashCode以及Equals方法:是在他所继承的AbstractSet这个类中书写的: 使用HashSet的时候要注意他不是线程安全的,需要重新要存放数据的HashCode 与Equals方法。HashSet没有办法实现快速存取,如果需要如果需要获取到某一个位置的数据可以先调用 toArray方法转换为数组,然后进行查找.返回的数据顺序与插入的顺序相反。 HashMap的keySet的效率比entrySet效率低,因为keySet是通过迭代key来进行迭代,entrySet通过迭代Node对象来进行,不需要通过key进行value的查找,所以速度更快。 17、Popwindow源码学习: 关于popWindow的源码其中最主要的是show 以及dismiss的原理;做过悬浮窗开发的人肯定知道,如果我们要创建一个悬浮在当前Activity或者这个android系统上边的话,需要使用到的一个类肯定是WindowManager,通过WindowManager的addView的方法添加到界面上去,如果只是添加到当前Activity的话 18、Toast源码学习 也是通过WindowManager来进行实现的。toast主要是通过TN这个类来进行最终的显示以及隐藏,如果要自己来控制显示以及隐藏可以通过反射来获取Toast中的mTN对象,然后通过这个对象用反射来调用show以及dismiss。Toast中TN源码: private static class TN extends ITransientNotification.Stub { final Runnable mShow = new Runnable() { @Override public void run() { handleShow(); } }; final Runnable mHide = new Runnable() { @Override public void run() { handleHide(); // Don't do this in handleHide() because it is also invoked by handleShow() mNextView = null; } }; private final WindowManager.LayoutParams mParams = new WindowManager.LayoutParams(); final Handler mHandler = new Handler(); int mGravity; int mX, mY; float mHorizontalMargin; float mVerticalMargin; View mView; View mNextView; WindowManager mWM; TN() { // XXX This should be changed to use a Dialog, with a Theme.Toast // defined that sets up the layout params appropriately. final WindowManager.LayoutParams params = mParams; params.height = WindowManager.LayoutParams.WRAP_CONTENT; params.width = WindowManager.LayoutParams.WRAP_CONTENT; params.format = PixelFormat.TRANSLUCENT; params.windowAnimations = com.android.internal.R.style.Animation_Toast; params.type = WindowManager.LayoutParams.TYPE_TOAST; params.setTitle("Toast"); params.flags = WindowManager.LayoutParams.FLAG_KEEP_SCREEN_ON | WindowManager.LayoutParams.FLAG_NOT_FOCUSABLE | WindowManager.LayoutParams.FLAG_NOT_TOUCHABLE; } /** * schedule handleShow into the right thread */ @Override public void show() { if (localLOGV) Log.v(TAG, "SHOW: " + this); mHandler.post(mShow); } /** * schedule handleHide into the right thread */ @Override public void hide() { if (localLOGV) Log.v(TAG, "HIDE: " + this); mHandler.post(mHide); } public void handleShow() { if (localLOGV) Log.v(TAG, "HANDLE SHOW: " + this + " mView=" + mView + " mNextView=" + mNextView); if (mView != mNextView) { // remove the old view if necessary handleHide(); mView = mNextView; Context context = mView.getContext().getApplicationContext(); String packageName = mView.getContext().getOpPackageName(); if (context == null) { context = mView.getContext(); } mWM = (WindowManager)context.getSystemService(Context.WINDOW_SERVICE); // We can resolve the Gravity here by using the Locale for getting // the layout direction final Configuration config = mView.getContext().getResources().getConfiguration(); final int gravity = Gravity.getAbsoluteGravity(mGravity, config.getLayoutDirection()); mParams.gravity = gravity; if ((gravity & Gravity.HORIZONTAL_GRAVITY_MASK) == Gravity.FILL_HORIZONTAL) { mParams.horizontalWeight = 1.0f; } if ((gravity & Gravity.VERTICAL_GRAVITY_MASK) == Gravity.FILL_VERTICAL) { mParams.verticalWeight = 1.0f; } mParams.x = mX; mParams.y = mY; mParams.verticalMargin = mVerticalMargin; mParams.horizontalMargin = mHorizontalMargin; mParams.packageName = packageName; if (mView.getParent() != null) { if (localLOGV) Log.v(TAG, "REMOVE! " + mView + " in " + this); mWM.removeView(mView); } if (localLOGV) Log.v(TAG, "ADD! " + mView + " in " + this); mWM.addView(mView, mParams); trySendAccessibilityEvent(); } } private void trySendAccessibilityEvent() { AccessibilityManager accessibilityManager = AccessibilityManager.getInstance(mView.getContext()); if (!accessibilityManager.isEnabled()) { return; } // treat toasts as notifications since they are used to // announce a transient piece of information to the user AccessibilityEvent event = AccessibilityEvent.obtain( AccessibilityEvent.TYPE_NOTIFICATION_STATE_CHANGED); event.setClassName(getClass().getName()); event.setPackageName(mView.getContext().getPackageName()); mView.dispatchPopulateAccessibilityEvent(event); accessibilityManager.sendAccessibilityEvent(event); } public void handleHide() { if (localLOGV) Log.v(TAG, "HANDLE HIDE: " + this + " mView=" + mView); if (mView != null) { // note: checking parent() just to make sure the view has // been added... i have seen cases where we get here when // the view isn't yet added, so let's try not to crash. if (mView.getParent() != null) { if (localLOGV) Log.v(TAG, "REMOVE! " + mView + " in " + this); mWM.removeView(mView); } mView = null; } } } 19、反射学习 关于java的反射:首先反射就是在程序运行的过程中可以动态的修改其状态以及行为的一种能力。现在我们使用反射大部分是通过修改某一个类的其中一个对象的引用或者对其值的修改,达到修改对象的行为。如果要对类中的方法或者实现进行修改就需要进行字节码注入操作,不在反射的学习中。 关于反射主要是通过Class这个类以及java.lang.reflect这个包下边Method,Field等等的来实现的。 20、android切换到桌面 Intent mHomeIntent; mHomeIntent = new Intent(Intent.ACTION_MAIN, null); mHomeIntent.addCategory(Intent.CATEGORY_HOME); mHomeIntent.addFlags(Intent.FLAG_ACTIVITY_NEW_TASK | Intent.FLAG_ACTIVITY_RESET_TASK_IF_NEEDED) startActivity(mHomeIntent); 21、关于String ,StringBuffer,StringBuilder的比较 String 类是一个final类型的类,它是不能被修改的,也就是说 String s = “aaaaaa” s = s + “bbbbb” 因为String 是不能被修改的,所以上边的在执行的时候是重新创建一个String 对象,然后 赋值给s 。所以如果在使用的时候是对String 对象来进行操作,是十分的耗时的,但是如果是直接对字符串进行操作,那么速度很快,都是jvm来进行操作的。 StringBuilder、StringBuffer是可变字符串对象,我们所有对字符串的操作都在这个对象上边,如果是对字符串对象进行操作的话,速度上要比String快上很多很多。 他们俩个都是继承了AbstractStringBuilder这个抽象类,在这个类中实现了大部分的功能,比如getValue,setLength,append ,reverse,等等,这个类还实现了CharSequence接口, 所以StringBuffer与StringBuilder都是在AbstractStringBuilder的基础上又进行了扩展,他们都实现了相同的三个接口java.io.Serializable, Appendable, CharSequence。 而他们俩个的区别就在于线程安全: StringBuffer:线程安全 ,是因为它里边很多方法都是上锁的,通过synchronized来进行修饰的,所以在多线程中操作时是不会引起对象的因多线程操作而发生的数据不一致问题。StringBuilder:非线程安全,与StringBuffer正好相反,所有的方法都么有加锁。但是如果在非多线程操作中,速度比StringBuffer要快。 22、6.0多进程无法安装总是提示安装失败。应用之间交互也需要设置关联启动 23、 5.0以后获取正在运行的程序只能获取到当前应用。而后台正在运行的服务以及应用都只能通过获取服务然后通过service或者process来进行判断。因为6.0以后应用如果设置多进程是无法安装的。获取方式: /** * 方法描述:判断某一Service或者应用是否正在运行 * * @param context 上下文 * @param serviceName Service的全路径: 包名 + service的类名 (如果是判断应用是否安装直接传递包名) * @return true 表示正在运行,false 表示没有运行 */ public static boolean isServiceRunning(Context context, String serviceName) { ActivityManager am = (ActivityManager) context.getSystemService(Context.ACTIVITY_SERVICE); List<ActivityManager.RunningServiceInfo> runningServiceInfos = am.getRunningServices(200); if (runningServiceInfos.size() <= 0) { return false; } for (ActivityManager.RunningServiceInfo serviceInfo : runningServiceInfos) { Log.e("TAG", serviceInfo.service.getClassName()); if (serviceInfo.process.equals(serviceName)) { return true; } } return false; } 24、android aidl进程间通信要注意的点; 现在在做一个sdk用来让讯飞可以与我们公司的应用进行开发。因为是要在进程间通信,所以肯定会使用Aidl来进行。但是要注意的几点就是:(1)进程间通信的话最好是不要把提供服务的service设置为独立的进程,要保证跟应用在同一个进程(2)还有就是进程间通信必 25、查看当前应用cpu内、存使用情况 adb shelltop -m 15 -s cpu //查询当前cpu占用前十的应用 dumpsys meminfo //查看手机上所有的内存信息dumpsys battery//查看电量信息dumpsys meminfo “要查看的应用的包名” //查询某一个应用的包名 top -d 1 | grep com.guoyi.qinghua //查询某一个应用的cpu使用情况 26、关于android 的应用程序cpu占用率问题 1、图片加载(图片加载使用好第三方框架,尽量不要使用Bitmap.create的方法) android动画对于cpu的消耗还是很大的,如果是可以通过自定实现的动画使用自定义动画,如过是复杂动画,能用ObjectAnimator实现就不要用ValueAnimator来进行实。不要使用动画来更新自定义的进度条或者是会根据时间间隔变化的View。可以用Timer或者Handler来替换。可以减小图片的大小。2、线程 (线程确保执行完成,或者可以手动控制)3、布局加载(布局尽量减少布局层数)4、网络(在进程网络访问的时候要先判断网状态)5、定位(降低定位的时间间隔)6、直播软件的编解码(在使用七牛播放器的时候,设置硬解码cpu的占有率比软解码低一半,如果cpu占用太高切换硬解码是一个好的选择) 27、android logo 尺寸 DENSITY SIZE LOCATION RATIO SCREEN MARGINXXXHDPI 192×192 drawable-xxxhdpi 4 640 DPI 12 to 16 pixelsXXHDPI 144×144 drawable-xxhdpi 3 480 DPI 8 to 12 pixelsXHDPI 96×96 drawable-xhdpi 2 320 DPI 6 to 8 pixelsHDPI 72×72 drawable-hdpi 1.5 240 DPI 4 to 6 pixelsMDPI 48×48 drawable-mdpi 1 160 DPI 3 to 4 pixelsMDPI 48×48 drawable (Cupcake) 1 160 DPI 3 to 4 pixelsLDPI 36×36 drawable-ldpi 0.75 120 DPI 2 to 3 pixelsNA 512×512 Google Play NA NA As required 28、ython环境配置以后在使用中出现的问题 python代码需要在开头插入 #!/usr/bin/python用来生名python支持,然后通过import可以导入需要的类。如果出现 -bash: ./**.py: /usr/bin/python^M: bad interpreter: No such file or directory那么应该是不同系统编码格式引起的:在windows系统中编辑的.sh .py文件可能有不可见字符,所以在linux系统下执行会报以上异常信息。一般是因为windows行结尾和linux行结尾标识不同造成的。 解决: 1)在windows下转换: 利用一些编辑器如UltraEdit或EditPlus等工具先将脚本编码转换,再放到Linux中执行。转换方式如下(UltraEdit):File-->Conversions-->DOS->UNIX即可。 2)linux下直接替换: sed -i 's/^M//g' filename (注意^M 在linux 下写法 按^M 是回车换行符,输入方法是按住CTRL+v,松开v,按m) 3)也可在Linux中转换: 首先要确保文件有可执行权限 #sh>chmod a+x filename 然后修改文件格式 #sh>vi filename 利用如下命令查看文件格式 :set ff 或 :set fileformat 可以看到如下信息 fileformat=dos 或 fileformat=unix 利用如下命令修改文件格式 :set ff=unix 或 :set fileformat=unix :wq (存盘退出) 或者使用:wq! 进行保存 最后再执行文件 #sh>./filename 如果配置了全局的python环境变量的话可以直接使用xxxx.py来执行py文件,或者要通过./xxxx.py 29、Bitmap.createBitmap中参数的理解 x的值不能小于0,width 不能小于0;x+width 的值不能小于0,也不能大于原bitmap的宽度,y的值与height与上边规则相同,而通过这个方法创建的btimap是通过x与y来控制要截取的bitmap的起始位置,最后的width与height用来确定从x与y的位置截取开始到什么时候结束。 30、如果.9图片不正规可能导致android studio编译出现多线程问题 31、studio中svn的使用 studio中使用svn可以更新指定文件,也可以提交指定文件。svn指定版本更新会把指定版本以下的代码都更新下来,不会更新指定版本以上的代码svn 中revert 复原代码,只能复原没有提交的文件,如果提交时没有办法复原 32、RecycleView 的scrollToPosition方法,如果剩下的item个数不够一屏幕的话无法滚动。 但是可以使用 scrollBy(int x, int y) 滚动屏幕的宽度的距离就可以。 33、内存泄漏的理解,如何防止内存泄漏(以及内存泄漏会引起的问题) 关于内存泄漏其实最难的是定位问题出现。一个良好的代码习惯,能避免掉很多内存泄漏,但是也不能规避过所有的。以前都是在内存泄漏以后使用工具进行内存分析,找到内存泄漏的地方,然后进行修改,现在发现一个内存泄漏检测比较简单的一个工具leakcanary,可以去gitHub上直接查看源码,然后简单集成下就可以了。内存泄漏:内存泄漏就是一个对象被别的对象引用,导致他应该被释放回收的时候,没有办法释放,对内存的持续占用,会导致android应用在给别的功能分配内存的时候,可能没有办法分配给这个功能那么多的内存,然后gc开始查找可以释放的内存,但是因为内存泄漏了(也就是那么没有办法释放的对象都是强引用),gc查找以后也不能释放出足够这个功能所需要占用的内存的时候,那么就会出现内存泄漏。内存泄漏的解决办法:可以加大android系统给应用分配的内存上限,但是这个是治标不治本,最主要还是要修改内存泄漏的根本原因。一般发生内存泄漏的地方有(1)匿名内部类的使用(因为匿名内部类一般都会持有当前对象的引用,那么在内部类对象没有释放的时候,那么他所持有的引用也不会消失,就会导致内存泄漏)如果可以在Application中添加的回调监听,一定不要放在activity中,因为那样的话,在回调没有回调的时候,引用也会一直持有;(2)在开发中发现 集合类很容易引起内存泄漏,一般尽量不要把集合类创建为static类型,否则的话他里边的对象都不会得到释放,除非是从集合中移除。可以参考的文章:http://blog.csdn.net/u012808234/article/details/74942491 34、屏幕适配是android一直以来都很坚挺的问题呢, 因为android的开源性,各个厂商的定制,等等,导致android手机的分辨率是千奇百怪,但是我们适配一般也只适配主流的分辨率,不是所有。那么在适配的过程中如何用最小的成本来适配最多屏幕,就是我们开发需要考虑的问题。android 中推荐使用match_parent,warp_parent, xxxdl ,xxxsp,主要就是为了适配。 dp(dip或者叫dpi) 代表的是单位英寸内的像素点个数,他是跟像素无关,跟屏幕密度有关的。android中屏幕密度越大也就是单位英寸内的像素点越多。屏幕显示的更清晰。密度的计算方式:1920x1080 5英寸手机(对角线的长度,也就是手机左上角跟右下角的长度)√(1920^2+1080^2)=2202.9071 2202.9/5=468.7021(ppi)≈469ppi如果在480px 跟240px上 如果密度相同,那么1dp所占的大小也是相等的。这就是跟像素无关160ppi 1dp 1px 320ppi 1dp 2px480ppi 1dp 3px密度因子以160为基础,也就是160 密度因子是1,密度因子= 密度/160 dp转px px = dp ️密度因子 知道了这个,但是如果只是简单的设置dp还是不能够适配大多数屏幕:适配方式: 1、布局适配,根据不同分辨率创建不同的布局 优点是简单明了,只要根据不同的屏幕创建不同的布局即可,但是会导致的问题就是,布局文件的增多,如果里边对于图片的使用很多的话,那么会导致app打包以后的大小变的很大,要适配大部分屏幕,工作量比较大 2、布局的时候通过比例来进行适配,比如一个按钮占屏幕的几分之几 优点就是一套布局可以适配所有的屏幕,但是不是所有的布局都能用比例来适配 3、使用一套布局,然后创建不同分辨率的dimens.xml (创建不同分辨率的values比如values_480x1280) 4、一些动画或者效果,客户端如果可以实现的话,而且不是特别难的话,最好是自定义,动态的适配分辨率 5、在代码中动态修改控件的宽度等等参数 35、开发工程中编程语言的学习以及开发工具: 36 、多项目依赖同一个module,实现module的统一管理 现在做android的基本上都在用studio进行开发,如果开发一个项目还好,但是如果是多个项目,而且他们还有同样在使用的Module,那么就要维护很多套不同项目的,但是缺相同的Moudle,所以使用多项目依赖同样的Moudule可以很有效的减小代码的维护成本,减小开发时间。 方式: 首先创建一个项目,该项目包含所有公有的Module 打开要添加公有Module的项目,通过强制引用添加所需要的Module打开项目的setting.gradle如下配置:include ':app', ':framework' include ':cuslibrary' ,’:qhlibrary' //添加项目所要包含的Moduleproject(':cuslibrary').projectDir = new File(‘../AllModule/cuslibrary') //导入该路径下的Moudleproject(':qhlibrary').projectDir = new File(‘../AllModule/qhlibrary’) //导入该路径下的Moudle 然后在该项目的app文件夹的根目录下边的build.gradle中添加Module的依赖 compile project(':cuslibrary') compile project(‘:qhlibrary') 保证不会有相同的文件或者类库的引用,然后运行ok 37、在使用svn的时候如果add 了一个不进行版本管理的文件会出现 E200009的错误 解决方式:svn st | grep ^? | awk '{print $2}' | xargs svn add
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册