首页 文章 精选 留言 我的

精选列表

搜索[天玑9500],共10000篇文章
优秀的个人博客,低调大师

一天 Star 破万的开源项目「GitHub 热点速览」

虽然现在市面上的 AI 编程助手已经"琳琅满目",但顶流就是顶流!OpenAI 新开源的轻量级编程助手 Codex,发布不到 24 小时 Star 数就轻松破万!姗姗来迟的 OpenAI,不禁让人感叹:藏着掖着的,早干嘛去了~ 说回上周的热门开源项目,首先是基于 AI 的浏览器自动化框架 Stagehand,从官方发布的评估报告来看,其准确率相当不错,并且还支持与代码结合使用,难怪能够后来居上,占领一席之地。接着是用 Next.js 打造现代化的文档网站的框架 Fumadocs,它不仅颜值高,还用的都是最时髦的前端技术,快速构建技术与美感并存的文档网站。而微软则选择另辟蹊径,推出了一款针对本地或边缘设备上运行大模型推理的推理框架,为 AI 推理提供了更多场景。 除此之外,还有一些让人眼前一亮的小工具。比如将 GitHub 通知集成到系统菜单栏的 Gitify,方便开发者随时掌握开源项目动态。以及深入比较 Python 对象的库 DeepDiff,功能强大且细致入微。 本文目录 热门开源项目 1.1 OpenAI 开源的轻量级编程助手:Codex 1.2 用 Next.js 打造现代化的文档网站:Fumadocs 1.3 用自然语言构建 UI 的新方式:OpenUI 1.4 基于 AI 的浏览器自动化框架:Stagehand 1.5 微软开源的 1-bit 大模型推理框架:BitNet HelloGitHub 热评 2.1 深入比较 Python 对象的库:DeepDiff 2.2 将 GitHub 通知带入你的系统菜单栏:Gitify 结尾 1. 热门开源项目 1.1 OpenAI 开源的轻量级编程助手:Codex 主语言:TypeScript ,Star:18k ,周增长:18k 这是一个 OpenAI 开源的命令行智能编码助手,旨在通过自然语言交互提升开发效率。它依赖 OpenAI 的 API 服务,仅需配置 OpenAI API Key 即可零门槛上手,支持代码生成、文件操作、版本控制和多模态(截图输入)等功能,适用于个人开发者、团队协作以及 CI/CD 流程。 GitHub 地址→github.com/openai/codex 1.2 用 Next.js 打造现代化的文档网站:Fumadocs 主语言:TypeScript ,Star:5.3k ,周增长:1.5k 该项目是基于 Next.js 构建的文档网站框架,专为快速创建现代化、高颜值、功能丰富的文档网站而设计。它完全采用 ESM 格式,紧跟前端技术潮流,支持内容集合(content-collections)、MDX、Contentlayer、TailwindCSS 等技术,适用于项目文档、API 文档、开发指南等多种文档需求。 GitHub 地址→github.com/fuma-nama/fumadocs 1.3 用自然语言构建 UI 的新方式:OpenUI 主语言:TypeScript、Python ,Star:20k 该项目可以帮助用户通过简单的文字描述生成和修改 UI 界面,支持 OpenAI、Groq 和 Gemini 多种大语言模型。它提供实时渲染预览功能,并可根据需求将界面导出为 React、Svelte、Web Components 等多种代码。 GitHub 地址→github.com/wandb/openui 1.4 基于 AI 的浏览器自动化框架:Stagehand 主语言:TypeScript ,Star:10.9k ,周增长:700 这是一款适用于生产环境的 AI 浏览器自动化框架,可通过自然语言简化浏览器自动化任务。它底层是 Playwright,所以可无缝集成到 Playwright 项目中,支持通过自然语言调用 OpenAI、Anthropic 等主流大模型的 Computer Use 能力,并与代码逻辑灵活结合。Stagehand 官方还提供了在不同模型下的准确性、成本和速度等方面的测评结果。 GitHub 地址→github.com/browserbase/stagehand 1.5 微软开源的 1-bit 大模型推理框架:BitNet 主语言:C++、Python ,Star:15k ,周增长:2k 该项目是微软专为 CPU 本地推理和极致压缩(低比特)大模型设计的推理框架。它支持对 1-bit/1.58-bit 量化模型进行高效、低能耗的推理,兼容 BitNet、Llama3-8B-1.58、Falcon3 等模型,适用于在本地或边缘设备上运行大模型推理任务,无需 GPU。 GitHub 地址→github.com/microsoft/BitNet 2. HelloGitHub 热评 在此章节中,我们将为大家介绍本周 HelloGitHub 网站上的热门开源项目,我们不仅希望您能从中收获开源神器和编程知识,更渴望"听"到您的声音。欢迎您与我们分享使用这些开源项目的亲身体验和评价,用最真实反馈为开源项目的作者注入动力。 我这个不称职的 HelloGitHub 站长,终于开工啦!网站更新如下: 支持通过项目名访问详情 提交项目页面新增状态查看,以及「催审」功能 优化「我的主页 -> 项目」样式 另外,欢迎各位开源项目作者来 HelloGitHub「认领」项目!通过认领,不仅能够积累用户口碑,还可以获得更多的曝光机会,并及时收到来自 HelloGitHub 社区用户的使用反馈和建议。 2.1 深入比较 Python 对象的库:DeepDiff 主语言:Python 这是一个用于深度比较、搜索和操作 Python 对象数据的 Python 库。它提供了多种模块,支持处理字典、可迭代对象、字符串等 Python 对象的差异,以及内容搜索、哈希生成和增量更新等功能。 项目详情→hellogithub.com/repository/seperman/deepdiff 2.2 将 GitHub 通知带入你的系统菜单栏:Gitify 主语言:TypeScript 这是一款开源免费的 GitHub 通知管理工具,可以将 GitHub 通知集成到用户的菜单栏,支持 Windows、Linux 和 macOS 平台。 项目详情→hellogithub.com/repository/gitify-app/gitify 3. 结尾 以上就是本期「GitHub 热点速览」的全部内容,希望这些开源项目能激发你的兴趣,找到你下一个想去尝试的工具!如果你也发现了好玩、有趣的 GitHub 开源项目想要分享,欢迎来 HelloGitHub 与我们交流心得、讨论使用体验。 往期回顾 7 个最近很火的开源项目 AI 智能体引爆开源社区

优秀的个人博客,低调大师

带你十天轻松搞定 Go 微服务系列(八、服务监控)

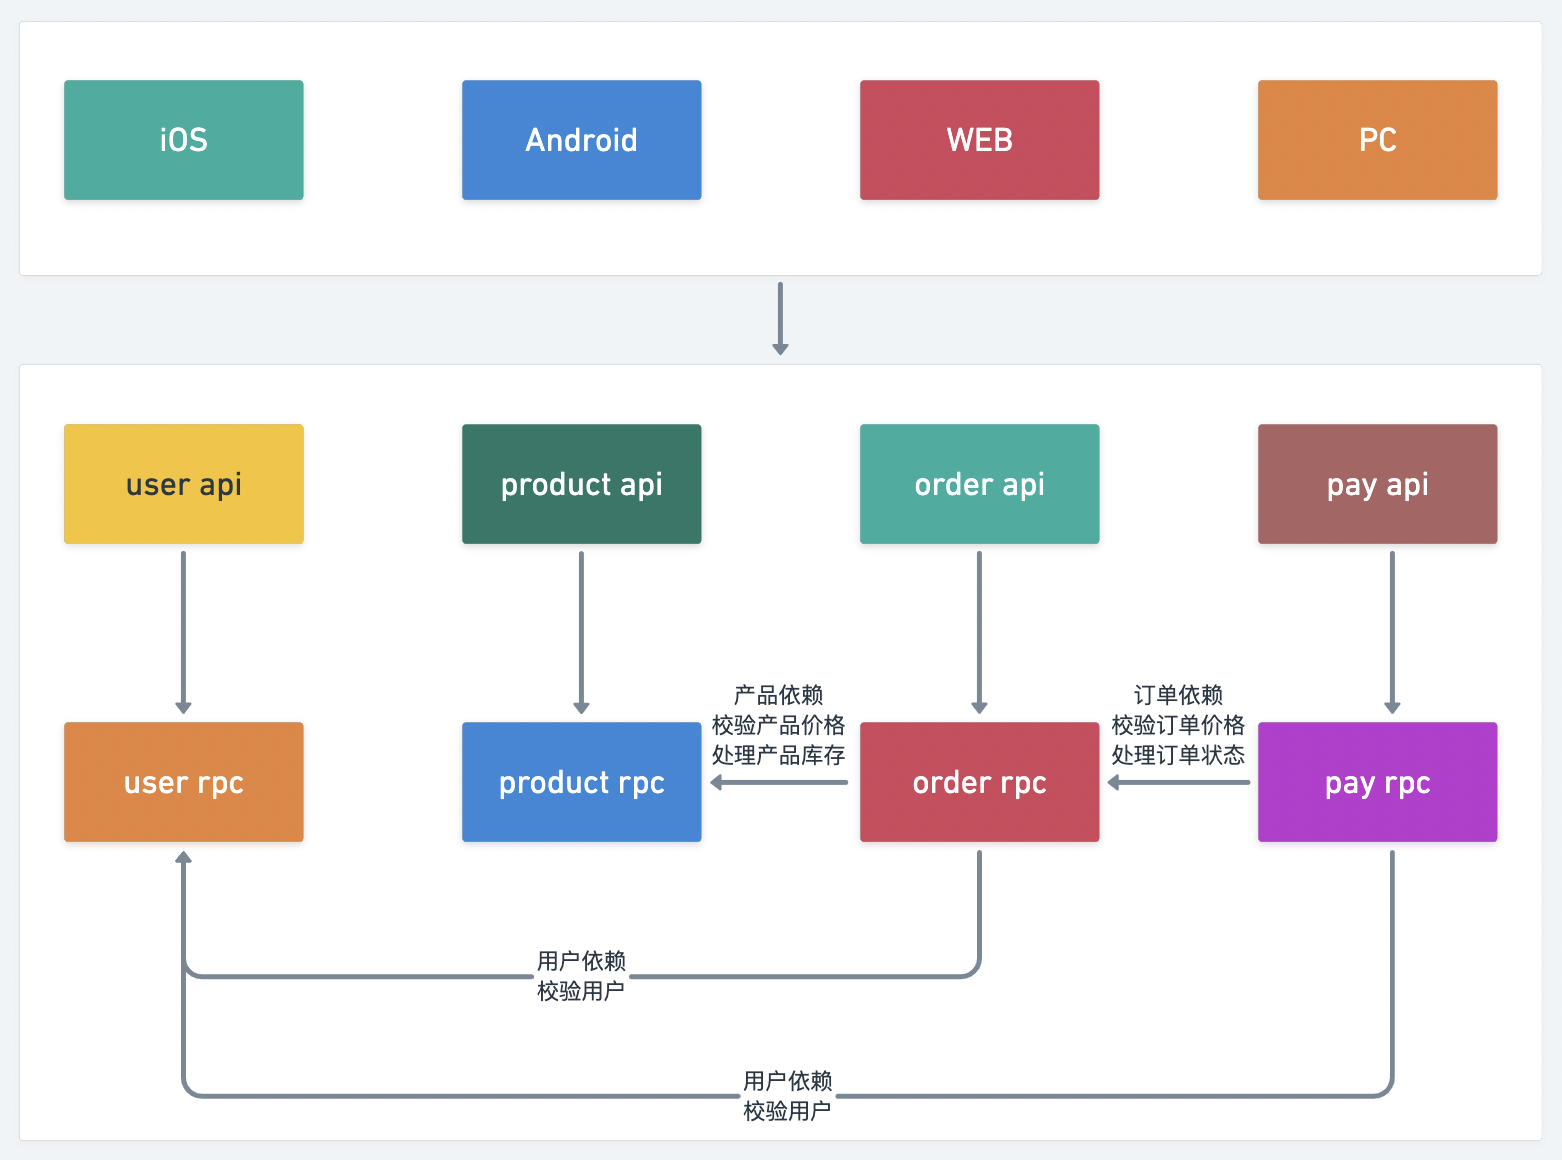
序言 我们通过一个系列文章跟大家详细展示一个 go-zero 微服务示例,整个系列分十篇文章,目录结构如下: 环境搭建 服务拆分 用户服务 产品服务 订单服务 支付服务 RPC 服务 Auth 验证 服务监控(本文) 链路追踪 分布式事务 期望通过本系列带你在本机利用 Docker 环境利用 go-zero 快速开发一个商城系统,让你快速上手微服务。 完整示例代码:https://github.com/nivin-studio/go-zero-mall 首先,我们来看一下整体的服务拆分图: 8.1 Prometheus 介绍 Prometheus 是一款基于时序数据库的开源监控告警系统,基本原理是通过 HTTP 协议周期性抓取被监控服务的状态,任意服务只要提供对应的 HTTP 接口就可以接入监控。不需要任何 SDK 或者其他的集成过程,输出被监控服务信息的 HTTP 接口被叫做 exporter 。目前互联网公司常用的服务大部分都有 exporter 可以直接使用,比如 Varnish、Haproxy、Nginx、MySQL、Linux 系统信息(包括磁盘、内存、CPU、网络等等)。Promethus 有以下特点: 支持多维数据模型(由度量名和键值对组成的时间序列数据) 支持 PromQL 查询语言,可以完成非常复杂的查询和分析,对图表展示和告警非常有意义 不依赖分布式存储,单点服务器也可以使用 支持 HTTP 协议主动拉取方式采集时间序列数据 支持 PushGateway 推送时间序列数据 支持服务发现和静态配置两种方式获取监控目标 支持接入 Grafana 8.2 go-zero 使用 Prometheus 监控服务 go-zero 框架中集成了基于 Prometheus 的服务指标监控,go-zero 目前在 http 的中间件和 rpc 的拦截器中添加了对请求指标的监控。 主要从 请求耗时 和 请求错误 两个维度,请求耗时采用了 Histogram 指标类型定义了多个 Buckets 方便进行分位统计,请求错误采用了 Counter 类型,并在 http metric 中添加了 path 标签,rpc metric 中添加了 method 标签以便进行细分监控。 接下来我们分别为前面几章实现的服务添加 Prometheus 监控,首先我们先回顾下 第二章 服务拆分,为了模拟服务的分布式部署,我们是在一个容器里启动了所有的服务,并为其分配了不同的端口号。下面我们再为这些服务分配一个 Prometheus 采集指标数据的端口号。 服务 api 服务端口号 rpc 服务端口号 api 指标采集端口号 rpc 指标采集端口号 user 8000 9000 9080 9090 product 8001 9001 9081 9091 order 8002 9002 9082 9092 pay 8003 9003 9083 9093 8.2.1 添加 user api 服务 Prometheus 配置 $ vim mall/service/user/api/etc/user.yaml Name: User Host: 0.0.0.0 Port: 8000 ... Prometheus: Host: 0.0.0.0 Port: 9080 Path: /metrics 8.2.2 添加 user rpc 服务 Prometheus 配置 $ vim mall/service/user/rpc/etc/user.yaml Name: user.rpc ListenOn: 0.0.0.0:9000 ... Prometheus: Host: 0.0.0.0 Port: 9090 Path: /metrics 8.2.3 添加 product api 服务 Prometheus 配置 $ vim mall/service/product/api/etc/product.yaml Name: Product Host: 0.0.0.0 Port: 8001 ... Prometheus: Host: 0.0.0.0 Port: 9081 Path: /metrics 8.2.4 添加 product rpc 服务 Prometheus 配置 $ vim mall/service/product/rpc/etc/product.yaml Name: product.rpc ListenOn: 0.0.0.0:9001 ... Prometheus: Host: 0.0.0.0 Port: 9091 Path: /metrics 8.2.5 添加 order api 服务 Prometheus 配置 $ vim mall/service/order/api/etc/order.yaml Name: Order Host: 0.0.0.0 Port: 8002 ... Prometheus: Host: 0.0.0.0 Port: 9082 Path: /metrics 8.2.6 添加 order rpc 服务 Prometheus 配置 $ vim mall/service/order/rpc/etc/order.yaml Name: order.rpc ListenOn: 0.0.0.0:9002 ... Prometheus: Host: 0.0.0.0 Port: 9092 Path: /metrics 8.2.7 添加 pay api 服务 Prometheus 配置 $ vim mall/service/pay/api/etc/pay.yaml Name: Pay Host: 0.0.0.0 Port: 8003 ... Prometheus: Host: 0.0.0.0 Port: 9083 Path: /metrics 8.2.8 添加 pay rpc 服务 Prometheus 配置 $ vim mall/service/pay/rpc/etc/pay.yaml Name: pay.rpc ListenOn: 0.0.0.0:9003 ... Prometheus: Host: 0.0.0.0 Port: 9093 Path: /metrics 提示:配置修改后,需要重启服务才会生效。 8.2.9 修改 Prometheus 配置 在 第一章 环境搭建 中我们集成了 Prometheus 服务,在prometheus 目录下有个 prometheus.yml 的配置文件,我们现在需要修改这个配置文件。 # my global config global: scrape_interval: 15s # Set the scrape interval to every 15 seconds. Default is every 1 minute. evaluation_interval: 15s # Evaluate rules every 15 seconds. The default is every 1 minute. # scrape_timeout is set to the global default (10s). # Alertmanager configuration alerting: alertmanagers: - static_configs: - targets: # - alertmanager:9093 # Load rules once and periodically evaluate them according to the global 'evaluation_interval'. rule_files: # - "first_rules.yml" # - "second_rules.yml" # A scrape configuration containing exactly one endpoint to scrape: # Here it's Prometheus itself. scrape_configs: # The job name is added as a label `job=<job_name>` to any timeseries scraped from this config. - job_name: "prometheus" # metrics_path defaults to '/metrics' # scheme defaults to 'http'. static_configs: - targets: ["localhost:9090"] # 我们自己的商城项目配置 - job_name: 'mall' static_configs: # 目标的采集地址 - targets: ['golang:9080'] labels: # 自定义标签 app: 'user-api' env: 'test' - targets: ['golang:9090'] labels: app: 'user-rpc' env: 'test' - targets: ['golang:9081'] labels: app: 'product-api' env: 'test' - targets: ['golang:9091'] labels: app: 'product-rpc' env: 'test' - targets: ['golang:9082'] labels: app: 'order-api' env: 'test' - targets: ['golang:9092'] labels: app: 'order-rpc' env: 'test' - targets: ['golang:9083'] labels: app: 'pay-api' env: 'test' - targets: ['golang:9093'] labels: app: 'pay-rpc' env: 'test' 提示:配置文件修改好后,需要重启 Prometheus 服务容器才能生效。 8.2.10 访问 Prometheus 可视化界面 在 第一章 环境搭建 中我们集成了Prometheus服务,并为其端口号9090 做了宿主机端口 3000 的映射关系,所以在浏览器中输入 http://127.0.0.1:3000/ 访问 Prometheus 界面。 选择 Status -> Targets 菜单,即可看到我们配置的采集目标的状态和自定义的标签。 我们多次访问 api 服务的接口后,选择 Graph 菜单,在查询输入框中输入 {path="api接口地址"} 或者 {method="rpc接口方法"} 指令,即可查看监控指标。 8.3 使用 Grafana 可视化 Prometheus 指标数据 8.3.1 添加 Prometheus 数据源 在 第一章 环境搭建 中我们集成了Grafana服务,并为其端口号3000 做了宿主机端口 4000 的映射关系,所以在浏览器中输入 http://127.0.0.1:4000/ 访问 Grafana 界面。点击左侧边栏 Configuration -> Data Source -> Add data source 进行数据源添加。 然后选择 Prometheus 数据源 填写 HTTP 配置中 URL 地址(我这里的 IP地址 是 Prometheus 所在容器的 IP地址),然后点击 Save & test 按,上方会提示 Data source is working,说明我们数据源添加成功且正常工作。 8.3.2 添加 Variables 用于服务筛选 点击左侧边栏 Dashboard 选择右上角 Dashboard settings 按钮,在 Settings 页面选择 Variables -> Add variable 添加变量,方便针对不同的标签进行过滤筛选。 分别添加 api_app API服务名称,rpc_app RPC服务名称变量,用于不同服务的筛选。变量数据源选择 Prometheus 数据源,使用正则表达式提取出对应的 app 标签。 8.3.3 添加 api 接口 qps 仪表盘 回到 Dashboard 页面选择右上角 Add panel 按钮,然后再选择 Add an empty panel 添加一个空的面板。 面板编辑页,修改面板标题为 API接口QPS,在 Metrics 中输入 sum(rate(http_server_requests_duration_ms_count{app="$api_app"}[5m])) by (path) 以 path 维度统计 api 接口的 qps 8.3.4 添加 rpc 接口 qps 仪表盘 再新建一个面板,修改面板标题为 RPC接口QPS,在 Metrics 中输入 sum(rate(rpc_server_requests_duration_ms_count{app="$rpc_app"}[5m])) by (method) 以 method 维度统计 rpc 接口的 qps 8.3.5 添加 api 接口状态码仪表盘 再新建一个面板,修改面板标题为 API接口状态码,在 Metrics 中输入 sum(rate(http_server_requests_code_total{app="$api_app"}[5m])) by (code) 以 code 维度统计 api 接口的状态码 8.3.6 添加 rpc 接口状态码仪表盘 再新建一个面板,修改面板标题为 RPC接口状态码,在 Metrics 中输入 sum(rate(rpc_server_requests_code_total{app="$rpc_app"}[5m])) by (code) 以 code 维度统计 rpc 接口的状态码 8.3.7 保存仪表盘 调整下面板位置,选择右上角 Save dashboard 按钮保存仪表盘。 项目地址 https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。 </job_name>

优秀的个人博客,低调大师

就因为把int改成Integer,第2天被辞了

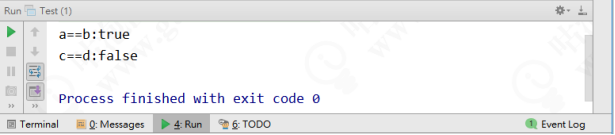
本文节选自《设计模式就该这样学》之享元模式(Flyweight Pattern) 1 故事背景 一个程序员就因为改了生产环境上的一个方法参数,把int型改成了Integer类型,因为涉及到钱,结果上线之后公司损失惨重,程序员被辞退了。信不信继续往下看。先来看一段代码: public static void main(String[] args) { Integer a = Integer.valueOf(100); Integer b = 100; Integer c = Integer.valueOf(129); Integer d = 129; System.out.println("a==b:" + (a==b)); System.out.println("c==d:" + (c==d)); } 大家猜它的运行结果是什么?在运行完程序后,我们才发现有些不对,得到了一个意想不到的运行结果,如下图所示。 看到这个运行结果,有人就一定会问,为什么是这样?之所以得到这样的结果,是因为Integer用到的享元模式。来看Integer的源码, public final class Integer extends Number implements Comparable<Integer> { ... public static Integer valueOf(int i) { if (i >= IntegerCache.low && i <= IntegerCache.high) return IntegerCache.cache[i + (-IntegerCache.low)]; return new Integer(i); } ... } 再继续进入到IntegerCache的源码来看low和high的值: private static class IntegerCache { // 最小值 static final int low = -128; // 最大值,支持自定义 static final int high; // 缓存数组 static final Integer cache[]; static { // 最大值可以通过属性配置来改变 int h = 127; String integerCacheHighPropValue = sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high"); // 如果设置了对应的属性,则使用该值 if (integerCacheHighPropValue != null) { try { int i = parseInt(integerCacheHighPropValue); i = Math.max(i, 127); // 最大数组大小为Integer.MAX_VALUE h = Math.min(i, Integer.MAX_VALUE - (-low) -1); } catch( NumberFormatException nfe) { // If the property cannot be parsed into an int, ignore it. } } high = h; cache = new Integer[(high - low) + 1]; int j = low; // 将low-high范围内的值全部实例化并存入数组中当缓存使用 for(int k = 0; k < cache.length; k++) cache[k] = new Integer(j++); // range [-128, 127] must be interned (JLS7 5.1.7) assert IntegerCache.high >= 127; } private IntegerCache() {} } 由上可知,Integer源码中的valueOf()方法做了一个条件判断,如果目标值在-128 - 127,则直接从缓存中取值,否则新建对象。其实,Integer第一次使用的时候就会初始化缓存,其中范围最小值为-128,最大值默认是127。接着会把low至high中所有的数据初始化存入数据中,默认就是将-128 - 127总共256个数循环实例化存入cache数组中。准确的说应该是将这256个对象在内存中的地址存进数组中。这里又有人会问了,那为什么默认是-128 - 127,怎么不是-200 - 200或者是其他值呢?那JDK为何要这样做呢? 在Java API 中是这样解释的: Returns an Integer instance representing the specified int value. If a new Integer instance is not required, this method should generally be used in preference to the constructor Integer(int), as this method is likely to yield significantly better space and time performance by caching frequently requested values. This method will always cache values in the range -128 to 127, inclusive, and may cache other values outside of this range 大致意思是: 128~127的数据在int范围内是使用最频繁的,为了减少频繁创建对象带来的内存消耗,这里其实是用到了享元模式,以提高空间和时间性能。 JDK增加了这一默认的范围并不是不可变,我们在使用前可以通过设置-Djava.lang.Integer.IntegerCache.high=xxx或者设置-XX:AutoBoxCacheMax=xxx来修改缓存范围,如下图: 后来,我又找到一个比较靠谱的解释: 实际上,在Java 5中首次引入此功能时,范围固定为-127到+127。 后来在Java 6中,范围的最大值映射到java.lang.Integer.IntegerCache.high,VM参数允许我们设置高位数。 根据我们的应用用例,它可以灵活地调整性能。 应该从-127到127选择这个数字范围的原因应该是什么。这被认为是广泛使用的整数范围。 在程序中首次使用Integer必须花费额外的时间来缓存实例。 Java Language Specification 的原文解释如下: Ideally, boxing a given primitive value p, would always yield an identical reference. In practice, this may not be feasible using existing implementation techniques. The rules above are a pragmatic compromise. The final clause above requires that certain common values always be boxed into indistinguishable objects. The implementation may cache these, lazily or eagerly. For other values, this formulation disallows any assumptions about the identity of the boxed values on the programmer's part. This would allow (but not require) sharing of some or all of these references. This ensures that in most common cases, the behavior will be the desired one, without imposing an undue performance penalty, especially on small devices. Less memory-limited implementations might, for example, cache all char and short values, as well as int and long values in the range of -32K to +32K. 2 关于Integer和int的比较 由于Integer变量实际上是对一个Integer对象的引用,所以两个通过new生成的Integer变量永远是不相等的(因为new生成的是两个对象,其内存地址不同)。 Integer i = new Integer(100); Integer j = new Integer(100); System.out.print(i == j); //false Integer变量和int变量比较时,只要两个变量的值是向等的,则结果为true(因为包装类Integer和基本数据类型int比较时,java会自动拆包装为int,然后进行比较,实际上就变为两个int变量的比较) Integer i = new Integer(100); int j = 100; System.out.print(i == j); //true 非new生成的Integer变量和new Integer()生成的变量比较时,结果为false。(因为 ①当变量值在-128 - 127之间时,非new生成的Integer变量指向的是java常量池中的对象,而new Integer()生成的变量指向堆中新建的对象,两者在内存中的地址不同;②当变量值在-128 - 127之间时,非new生成Integer变量时,java API中最终会按照new Integer(i)进行处理(参考下面第4条),最终两个Interger的地址同样是不相同的) Integer i = new Integer(100); Integer j = 100; System.out.print(i == j); //false 对于两个非new生成的Integer对象,进行比较时,如果两个变量的值在区间-128到127之间,则比较结果为true,如果两个变量的值不在此区间,则比较结果为false 3 扩展知识 在JDK中,这样的应用不止int,以下包装类型也都应用了享元模式,对数值做了缓存,只是缓存的范围不一样,具体如下表所示: 基本类型 大小 最小值 最大值 包装器类型 缓存范围 是否支持自定义 boolean - - - Bloolean - - char 6bit Unicode 0 Unic ode 2(16)-1 Character 0~127 否 byte 8bit -128 +127 Byte -128~127 否 short 16bit -2(15) 2(15)-1 Short -128~127 否 int 32bit -2(31) 2(31)-1 Integer -128~127 支持 long 64bit -2(63) 2(63)-1 Long -128~127 否 float 32bit IEEE754 IEEE754 Float - double 64bit IEEE754 IEEE754 Double - void - - - Void - - 大家觉得这个锅背得值不值? 4 使用享元模式实现数据库连接池 再举个例子,我们经常使用的数据库连接池,因为使用Connection对象时主要性能消耗在建立连接和关闭连接的时候,为了提高Connection对象在调用时的性能,将Connection对象在调用前创建好并缓存起来,在用的时候直接从缓存中取值,用完后再放回去,达到资源重复利用的目的,代码如下。 public class ConnectionPool { private Vector<Connection> pool; private String url = "jdbc:mysql://localhost:3306/test"; private String username = "root"; private String password = "root"; private String driverClassName = "com.mysql.jdbc.Driver"; private int poolSize = 100; public ConnectionPool() { pool = new Vector<Connection>(poolSize); try{ Class.forName(driverClassName); for (int i = 0; i < poolSize; i++) { Connection conn = DriverManager.getConnection(url,username,password); pool.add(conn); } }catch (Exception e){ e.printStackTrace(); } } public synchronized Connection getConnection(){ if(pool.size() > 0){ Connection conn = pool.get(0); pool.remove(conn); return conn; } return null; } public synchronized void release(Connection conn){ pool.add(conn); } } 这样的连接池,普遍应用于开源框架,可以有效提升底层的运行性能。 【推荐】Tom弹架构:收藏本文,相当于收藏一本“设计模式”的书 本文为“Tom弹架构”原创,转载请注明出处。技术在于分享,我分享我快乐! 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。关注微信公众号『 Tom弹架构 』可获取更多技术干货!

优秀的个人博客,低调大师

在医院五天,我把「链路追踪」整明白了

这是我的第68篇原创文章 作者 | 悟空聊架构 来源 |悟空聊架构(ID:PassJava666) 转载请联系授权(微信ID:PassJava) 封面图是 凌晨 3点半起来更文的锁屏桌面。 前言 从上周六 7 号到今天的 11 号,我都在医院,小孩因普通肺炎已经住院了,我白天和晚上的时间需要照顾娃,只能在娃睡觉的时候肝文了。对了,医院没有宽带和 WiFi,我用的手机开的热点~ 本篇主要内容 这篇主要是理论 + 实践相结合。实践部分涉及到如何把链路追踪组件 Sleuth + Zipkin 加到我的 Spring Cloud 《佳必过》开源项目上。 本篇知识点: 链路追踪基本原理 如何在项目中轻松加入链路追踪中间件 如何使用链路追踪排查问题 一、为什么要用链路追踪? 1.1 因:拆分服务单元 微服务架构其实是一个分布式的架构,按照业务划分成了多个服务单元。 由于服务单元的数量是很多的,有可能几千个,而且业务也会更复杂,如果出现了错误和异常,很难去定位。 1.2 因:逻辑复杂 比如一个请求需要调用多个服务才能完成整个业务闭环,而内部服务的代码逻辑和业务逻辑比较复杂,假如某个服务出现了问题,是难以快速确定那个服务出问题的。 1.3 果:快速定位 而如果我们加上了分布式链路追踪,去跟踪一个请求有哪些服务参与其中,参与的顺序是怎样的,这样我们就知道了每个请求的详细经过,即使出了问题也能快速定位。 二、链路追踪的核心 链路追踪组件有 Twitter 的可视化链路追踪组件 Zipkin、Google 的 Dapper、阿里的 Eagleeye 等,而 Sleuth 是 Spring Cloud 的组件。Spring Cloud Sleuth 借鉴了 Dapper 的术语。 本文主要讲解 Sleuth + Zipkin 结合使用来更好地实现链路追踪。 为什么能够进行整条链路的追踪?其实就是一个 Trace ID 将 一连串的 Span 信息连起来了。根据 Span 记录的信息再进行整合就可以获取整条链路的信息。下面是链路追踪的核心概念: 2.1 Span(跨度) 大白话:远程调用和 Span 一对一。 基本的工作单元,每次发送一个远程调用服务就会产生一个 Span。 Span 是一个 64 位的唯一 ID。 通过计算 Span 的开始和结束时间,就可以统计每个服务调用所花费的时间。 2.2 Trace(跟踪) 大白话:一个 Trace 对应多个 Span,一对多。 它由一系列 Span 组成,树状结构。 64 位唯一 ID。 每次客户端访问微服务系统的 API 接口,可能中间会调用多个微服务,每次调用都会产生一个新的 Span,而多个 Span 组成了 Trace 2.3 Annotation(注解) 链路追踪系统定义了一些核心注解,用来定义一个请求的开始和结束,注意是微服务之间的请求,而不是浏览器或手机等设备。注解包括: cs - Client Sent:客户端发送一个请求,描述了这个请求调用的 Span 的开始时间。注意:这里的客户端指的是微服务的调用者,不是我们理解的浏览器或手机等客户端。 sr - Server Received:服务端获得请求并准备开始处理它,如果将其 sr 减去 cs 时间戳,即可得到网络传输时间。 ss - Server Sent:服务端发送响应,会记录请求处理完成的时间, ss 时间戳减去 sr 时间戳,即可得到服务器请求的时间。 cr - Client Received:客户端接收响应,Span 的结束时间,如果 cr 的时间戳减去 cs 时间戳,即可得到一次微服务调用所消耗的时间,也就是一个 Span 的消耗的总时间。 2.4 链路追踪原理 假定三个微服务调用的链路如下图所示:Service 1 调用 Service 2,Service 2 调用 Service 3 和 Service 4。 微服务调用链路图 那么链路追踪会在每个服务调用的时候加上 Trace ID 和 Span ID。如下图所示: 链路追踪原理图 大白话解释: 大家注意上面的颜色,相同颜色的代表是同一个 Span ID,说明是链路追踪中的一个节点。 第一步:客户端调用 Service 1,生成一个 Request,Trace ID 和 Span ID 为空,那个时候请求还没有到 Service 1。 第二步:请求到达 Service 1,记录了 Trace ID = X,Span ID 等于 A。 第三步:Service 1 发送请求给 Service 2,Span ID 等于 B,被称作 Client Sent,即客户端发送一个请求。 第四步:请求到达 Service 2,Span ID 等于 B,Trace ID 不会改变,被称作 Server Received,即服务端获得请求并准备开始处理它。 第五步:Service 2 开始处理这个请求,处理完之后,Trace ID 不变,Span ID = C。 第六步:Service 2 开始发送这个请求给 Service 3,Trace ID 不变,Span ID = D,被称作 Client Sent,即客户端发送一个请求。 第七步:Service 3 接收到这个请求,Span ID = D,被称作 Server Received。 第八步:Service 3 开始处理这个请求,处理完之后,Span ID = E。 第九步:Service 3 开始发送响应给 Service 2,Span ID = D,被称作 Server Sent,即服务端发送响应。 第十步:Service 3 收到 Service 2 的响应,Span ID = D,被称作 Client Received,即客户端接收响应。 第十一步:Service 2 开始返回 响应给 Service 1,Span ID = B,和第三步的 Span ID 相同,被称作 Client Received,即客户端接收响应。 第十二步:Service 1 处理完响应,Span ID = A,和第二步的 Span ID 相同。 第十三步:Service 1 开始向客户端返回响应,Span ID = A、 Service 3 向 Service 4 发送请求和 Service 3 类似,对应的 Span ID 是 F 和 G。可以参照上面前面的第六步到第十步。 把以上的相同颜色的步骤简化为下面的链路追踪图: 链路追踪父子节点图 第一个节点:Span ID = A,Parent ID = null, Service 1 接收到请求。 第二个节点:Span ID = B,Parent ID= A, Service 1 发送请求到 Service 2 返回响应给 Service 1 的过程。 第三个节点:Span ID = C,Parent ID= B, Service 2 的 中间处理过程。 第四个节点:Span ID = D,Parent ID= C, Service 2 发送请求到 Service 3 返回响应给 Service 2 的过程。 第五个节点:Span ID = E,Parent ID= D, Service 3 的中间处理过程。 第六个节点:Span ID = F,Parent ID= C, Service 3 发送请求到 Service 4 返回响应给 Service 3 的过程。 第七个节点:Span ID = G,Parent ID= F,Service 4 的中间处理过程。 通过 Parent ID 即可找到父节点,整个链路就可以进行跟踪追溯了。 三、Spring Cloud 整合 Sleuth 大家可以参照我的 GitHub 开源项目 PassJava(佳必过)。 3.1 引入 Spring Cloud 依赖 在 passjava-common 中引入 Spring Cloud 依赖 因为我们使用的链路追踪组件 Sleuth 是 Spring Cloud 的组件,所以我们需要引入 Spring Cloud 依赖。 <dependencyManagement><dependencies><!--SpringCloud依赖--><dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-dependencies</artifactId><version>Hoxton.SR3</version><type>pom</type><scope>import</scope></dependency></dependencies></dependencyManagement> 3.2 引入Sleuth依赖 引入链路追踪组件 Sleuth 非常简单,在 pom.xml 文件中引入 Sleuth 依赖即可。 在 passjava-common 中引入 Sleuth 依赖: <!--链路追踪组件--><dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-sleuth</artifactId></dependency> 3.3 通过日志观察链路追踪 我们先不整合 zipkin 链路追踪可视化组件,而是通过日志的方式来查看链路追踪信息。 文件路径:\PassJava-Platform\passjava-question\src\main\resources\application.properties添加配置:logging.level.org.springframework.cloud.openfeign=debuglogging.level.org.springframework.cloud.sleuth=debug 3.4 启动微服务 启动以下微服务: passjava-gateway 服务(网关) passjava-question 服务(题目中心微服务) renren 服务(Admin 后台管理服务) 启动成功后如下图所示: 启动微服务 3.5 测试跟踪请求 打开 Admin 后台,访问题目中心->题目配置页面,可以看到发送了下面的请求: http://localhost:8060/api/question/v1/admin/question/list?t=1605170539929&page=1&limit=10&key= 佳必过项目的后台界面 打开控制台,可以看到打印出了追踪日志。 链路追踪日志 说明: 当没有配置 Sleuth 链路追踪的时候,INFO 信息里面是 [passjava-question,,,],后面跟着三个空字符串。 当配置了 Sleuth 链路追踪的时候,追踪到的信息是 [passjava-question,504a5360ca906016,e55ff064b3941956,false] ,第一个是 Trace ID,第二个是 Span ID。 四、Zipkin 链路追踪原理 上面我们通过简单的引入 Sleuth 组件,就可以获取到调用链路,但只能通过控制台的输出信息来看,不太方便。 Zipkin 油然而生,一个图形化的工具。Zipkin 是 Twitter 开源的分布式跟踪系统,主要用来用来收集系统的时序数据,进而可以跟踪系统的调用问题。 而且引入了 Zipkin 组件后,就不需要引入 Sleuth 组件了,因为 Zipkin 组件已经帮我们引入了。 Zipkin 的官网:https://zipkin.io 4.1 Zipkin 基础架构 Zipkin 基础架构 Zipkin 包含四大组件: Collection(收集器组件),主要负责收集外部系统跟踪信息。 Storage(存储组件),主要负责将收集到的跟踪信息进行存储,默认存放在内存中,支持存储到 MySQL 和 ElasticSearch。 API(查询组件),提供接口查询跟踪信息,给 UI 组件用的。 UI (可视化 Web UI 组件),可以基于服务、时间、注解来可视化查看跟踪信息。注意:Web UI 不需要身份验证。 4.2 Zipkin 跟踪流程 Zipkin 跟踪流程 流程解释: 第一步:用户代码发起 HTTP Get 请求,请求路径:/foo。 第二步:请求到到跟踪工具后,请求被拦截,会被记录两项信息:标签和时间戳。以及HTTP Headers 里面会增加跟踪头信息。 第三步:将封装好的请求传给 HTTP 客户端,请求中包含 X-B3-TraceID 和 X-B3-SpanId 请求头信息。 第四步:由HTTP 客户端发送请求。 第五步:Http 客户端返回响应 200 OK 后,跟踪工具记录耗时时间。 第六步:跟踪工具发送 200 OK 给用户端。 第七步:异步报告 Span 信息给 Zipkin 收集器。 五、整合 Zipkin 可视化组件 5.1 启动虚拟机并连接 vagrantup 启动虚拟机 接着就可以用 Xshell 工具连接虚拟机了。下面是在命令行里面执行相关操作。 5.2 docker 安装 zipkin 服务 使用以下命令开始拉取 zipkin 镜像并启动 zipkin 容器。 dockerrun-d-p9411:9411openzipkin/zipkin 命令执行完后,会执行下载操作和启动操作。 docker 安装 zipkin 服务 使用 docker ps 命令可以看到 zipkin 容器已经启动成功了。如下图所示: zipkin 容器启动成功 在浏览器窗口打开 zipkin UI 访问服务地址:http://192.168.56.10:9411/zipkin。 5.3 引入 Zipkin 依赖 在公共模块引入 zipkin 依赖 <!--链路追踪组件Zipkin--><dependency><groupId>org.springframework.cloud</groupId><artifactId>spring-cloud-starter-zipkin</artifactId></dependency> 因为 zipkin 包里面已经引入了 sleuth 组件,所以可以把之前引入的 sleuth 组件删掉。 5.4 添加 Zipkin 配置 在需要追踪的微服务模块下添加 zipkin 配置。 # zipkin 的服务器地址spring.zipkin.base-url=http://192.168.56.10:9411/# 关闭服务发现,否则 Spring Cloud 会把 zipkin 的 URL 当作服务名称。spring.zipkin.discovery-client-enabled=false# 设置使用 http 的方式传输数据,也可以用 RabbitMQ 或 Kafka。spring.zipkin.sender.type=web# 设置采样率为 100 %,默认为 0.1(10%)spring.sleuth.sampler.probability=1 5.5 测试 Zipkin 是否工作 这里我在 passjava-member 微服务中写了一个 API: passjava-member 服务的 API:getMemberStudyTimeListTest, 访问路径为/studytime/list/test/{id}。 passjava-member 服务远程调用 passjava-study 服务。 对应的 API:getMemberStudyTimeListTest。 我用 postman 工具测试 passjava-member 服务的 API: 测试 Passjava-member 服务的 API 打开 Zipkin 工具,搜索 passjava-member 的链路追踪日志,可以看到有一条记录,相关说明如下图所示: zipkin 示例 从图中可以看到 passjava-member 微服务调用了 passjava-study 微服务,如图中左半部分所示。 而且 passjava-study 微服务详细的调用时间都记录得非常清楚,如图中右半部分所示。 时间计算: 请求传输时间:Server Start - Client Start = 2.577s-2.339s = 0.238s 服务端处理时间:Server Finish - Server Start = 2.863s - 2.577s = 0.286s 请求总耗时:Client Finish - Client Start = 2.861s - 2.339s = 0.522s Passjava-member 服务总耗时:3.156 s Passjava-study 服务总耗时:0.521s 由此可以看出 passjava-member 服务 花费了很长时间,性能很差。 另外还可以用图表的方式查看跟踪信息,这里不做展开了。 图表的方式查看 六、Zipkin 数据持久化 6.1 Zipkin 支持的数据库 Zipkin 存储数据默认是放在内存中的,如果 Zipkin 重启,那么监控数据也会丢失。如果是生成环境,数据丢失会带来很大问题,所以需要将 Zipkin 的监控数据持久化。而 Zipkin 支持将数据存储到以下数据库: 内存(默认,不建议使用) MySQL(数据量大的话, 查询较为缓慢,不建议使用) Elasticsearch(建议使用) Cassandra(国内使用 Cassandra 的公司较少,相关文档也不多) 6.2 使用 Elasticsearch 作为储存介质 通过 docker 的方式配置 elasticsearch 作为 zipkin 数据的存储介质。 dockerrun--envSTORAGE_TYPE=elasticsearch--envES_HOSTS=192.168.56.10:9200openzipkin/zipkin-dependencies ES 作为存储介质的配置参数: ES 作为存储介质的配置参数 七、总结 本篇讲解了链路追踪的核心原理,以及 Sleuth + Zipkin 的组件的原理,以及将这两款组件加到了我的开源项目《佳必过》里面了。 开源项目地址:https://github.com/Jackson0714/PassJava-Platform 写在最后 这周真的身心俱疲,娃也是受罪,出院后,娃吃饭也不像以前那么积极了,看到医生那种衣服就怕,连看到照片打印机都怕了。生怕是要给他打针、吃药、做雾化的。还未结婚生娃的朋友们抓紧时间学习吧,加油少年~ 我是悟空,努力变强,变身超级赛亚人!手写了一套 Spring Cloud 进阶教程和 PMP 刷题小程序。关注我免费订阅~ - END - 建了学习交流群,可以扫码加我,备注[加群] 一起进阶! 个人二维码 本文分享自微信公众号 - 悟空聊架构(PassJava666)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

同事线上埋的这个坑,我整整找了3天3夜

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 对于线上系统调优,它本身是个技术活,不仅需要很强的技术实战能力,很强的问题定位,问题识别,问题排查能力,还需要很丰富的调优能力。 本篇文章从实战角度,从问题识别,问题定位,问题分析,提出解决方案,实施解决方案,监控调优后的解决方案和调优后的观察等角度来与大家一起交流分享本次线上高并发调优整个闭环过程。 一、项目简要情况概述 该项目为基于SSM架构的商城类单体架构项目,其中有一个秒杀重磅模块,如下为当前线上环境的简要架构部署图,大致描述一下:(1)项目为SSM架构(2)服务器类别:1台负载均衡服务器(F5),3台运用程序服务器,1台计时器服务器,1台redis服务器,1台图片服服务器和1台基于Pass架构的Mysql主从服务器(微软云)(3)调用逻辑:下图为简要调用逻辑 二、何为单体架构项目 从架构发展角度,软件项目经历了如下阶段的发展:1.单体架构:可理解为传统的前后端未分离的架构2.垂直架构:可理解为前后端分离架构3.SOA架构:可理解为按服务类别,业务流量,服务间依赖关系等服务化的架构,如以前的单体架构ERP项目,划分为订单服务,采购服务,物料服务和销售服务等4.微服务:可理解为一个个小型的项目,如之前的ERP大型项目,划分为订单服务(订单项目),采购服务(采购项目),物料服务(物料项目)和销售服务(销售项目),以及服务之间调用 三、本SSM项目引发的线上问题 1.当秒杀的时候,cpu暴增该系统每天秒杀分为三个时间端:10点,13点和20点,如下为秒杀的简要页面 2.单台运用服务器cpu 3.单台运用服务器请求数 4.rdis连接数(info clients) 这个未保存截图,记得是600左右connected_clients:600 5.mysql请求截图 四、排查过程及分析 (一)排查思路根据服务部署和项目架构,从如下几个方面排查:(1)运用服务器:排查内存,cpu,请求数等;(2)文件图片服务器:排查内存,cpu,请求数等;(3)计时器服务器:排查内存,cpu,请求数等;(4)redis服务器:排查内存,cpu,连接数等;(5)db服务器:排查内存,cpu,连接数等; (二)排查过程在秒杀后30分钟内,1.运用程序服务器cpu暴增,内存暴增,造成cpu和内存暴增的根本原因是请求数过高,单台运用服务器达到3000多; (三)造成本次系统异常主要因素分析 (1)在秒杀时,请求量过高,导致运用服务器负载过高;(2)redis连接池满,获取不到连接,connot get a connection from thread pool(3)jdbc连接池满,获取不到连接和超时(4)存在大对象代码,如向list集合中不停添加对象,不能及时回收对象导致内存增加,频繁发生Full GC(5)tomcat并发参数,jvm优化参数,jedis配置参数,jdbc配置参数不合理(6)未对请求量进行削峰和限流(7)资源连接未及时释放,如redis连接,jdbc连接未及时释放 五、最终解决方案 1.增加运用服务,做流量削峰和分流由于该项目未增加MQ,因此只能采用硬负载,增加服务器水平扩展方式来实现流量削峰和流量分流 2.优化jvm参数,如下为本次优化后的参数JAVA_OPTS="-server -Xmx9g -Xms9g -Xmn3g -Xss500k -XX:+DisableExplicitGC -XX:MetaspaceSize=2048m -XX:MaxMetaspaceSize=2048m -XX:+UseConcMarkSweepGC -XX:+CMSParallelRemarkEnabled -XX:LargePageSizeInBytes=128m -XX:+UseFastAccessorMethods -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=70 -Dfile.encoding=UTF8 -Duser.timezone=GMT+08"关于这个jvm参数的优化,jvm理论是怎样的,官方建议是怎样的,实战是怎样的,将在下篇文章中分析。 3.优化tomcat并发相关参数主要是两方面:(1)修改bio协议为nio2 (2)根据服务器配置,业务场景,业务流量等合理设置相关参数,尽量达到最优 关于tomcat相关参数优化,在接下来的文章中分析。 4.redis 和jdbc参数优化由于涉及到安全性问题,这里不列出 5.代码优化(1)优化掉大对象(2)优化未及时释放的对象和连接资源6.解决000多个线程请求无效资源问题在conf/context.xml增大缓存 cachingAllowed = "true" cacheMaxSize = "102400" /> 六、最终优化结果 经过几天观察,系统平稳1.基本监控 七、总结 1.本篇文章从实战角度,从问题识别,问题定位,问题分析,提出解决方案,实施解决方案,监控调优后的解决方案和调优后的观察等角度来与大家一起交流分享本次线上高并发调优整个闭环过程,当然,由于篇幅的限制,有些细节和优化手段未在本篇文章中提及; 2.虽然解决了该问题,但是从长远来看,该单体项目任然存在很大的问题和隐患,下面随便举几个:(1)前后端紧耦合,未分离(2)由于该系统秒杀业务属于非持续性并发,即局部性并发,当前并未做局部并发架构的调整(3)由于该系统秒杀业务与该项目紧紧耦合在一起,未进行隔离,未独立成单独模块,未单独部署,从而存在因秒杀业务造成整个系统瘫痪的风险;(4)未做流量削峰和流量限流,如加mq等软手段;(5)redis为做高可用集群 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-31本文作者:Alan_beijing 本文来自:“互联网架构师”,了解相关信息可以关注“互联网架构师”

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册