首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4312篇文章
优秀的个人博客,低调大师

从 0 到上线:我用微信小程序云开发做了个"批改作业"工具(4 云函数 + 4 集合踩坑实录)#WorkBuddy#

# 从 0 到上线:我用微信小程序云开发做了个"批改作业"工具(4 云函数 + 4 集合踩坑实录) > 一句话说清这个项目:**学生拍照上传作业 → AI 自动批改 → 错题自动归档 → 家长/老师看统计**,全程后端零服务器、零成本,全部跑在微信小程序云开发上。 ## 目录 - 一、为什么要做这个工具 - 二、整体架构设计 - 三、数据库集合设计(4 个) - 四、云函数实现(4 个) - 五、踩坑记录(重点,含解决方案) - 六、上线部署流程 - 七、总结与数据 --- ## 一、为什么要做这个工具 核心痛点很直接:**老师批改作业太费时,学生订正后错题又容易散落各处、无法追溯。** 我希望用一个小程序把这些环节串起来: 1. 学生拍照上传作业图片; 1. 后端调用 AI 完成批改,返回分数 + 逐题对错; 1. 错题自动写入错题本(按知识点归类); 1. 老师/家长随时看提交统计。 选微信小程序云开发的原因只有两个:**不用买服务器、不用配域名和 HTTPS**,写完直接部署上线。 --- ## 二、整体架构设计 整个项目由 **4 个云函数 + 4 个数据库集合**构成,职责划分如下: |云函数|职责| | --- | --- | |login|静默登录,拿 openid,初始化用户| |gradeAI|核心:接收作业图片,调用 AI 批改,返回分数与逐题结果| |notify|批改完成后给用户推订阅消息| |stats|聚合提交数、平均分、错题分布,返回给前端图表| |数据库集合|存什么| | --- | --- | |users|用户资料(openid、昵称、角色:学生/老师/家长)| |assignments|作业任务(题目、截止时间、发布人)| |submissions|提交记录(图片、AI 批改结果、分数)| |mistakes|错题本(按用户 + 知识点归档)| 数据流一句话概括: 这套结构的好处是**职责单一**:每个云函数只干一件事,改起来互不影响,也方便单独调超时和权限。 --- ## 三、数据库集合设计(4 个) 以 `submissions`(提交记录)为例,字段设计如下: `mistakes`(错题本)的关键设计是**冗余存储知识点标签**,方便后面 `stats` 直接按标签聚合: > 设计原则:**读多写少的场景下,宁可冗余字段,也不要频繁跨集合 join。** 小程序端查错题本一次 `get` 就够了。 --- ## 四、云函数实现(4 个) ### 4.1 `login` —— 静默登录 ### 4.2 `gradeAI` —— 核心批改(重点) 这里是整个项目最容易踩坑的地方,先说结论:**AI 调用一定要放到云函数里做,且要处理超时**。 ### 4.3 `notify` —— 订阅消息 批改完成后推一条「批改已完成」的订阅消息,核心是**提前让用户授权**,否则 `subscribeMessage.send` 会静默失败。 ### 4.4 `stats` —— 数据统计 --- ## 五、踩坑记录(重点,含解决方案) > 这一节是我全程最值钱的部分——下面 6 个坑,每一个都踩过、都耗了我至少半小时。 ### 坑 1:本地调试报「找不到云函数」 **现象**:开发者工具里右键云函数「上传并部署」成功后,本地运行还是报 function not found。 **原因**:`project.config.json` 里 `cloudfunctionRoot` 没指向正确的函数目录,或者上传的是别的目录。 **解决**: 确认函数目录名和「云开发控制台」里显示的名字**完全一致**。 ### 坑 2:数据库权限默认「仅创建者可读写」,别人读不到 **现象**:学生 A 提交后,老师端查不到数据。 **原因**:集合默认权限是「仅创建者可读写」,跨用户读取直接返回空。 **解决**:在云开发控制台 → 数据库 → 对应集合 → 权限设置,改成**自定义安全规则**,例如提交记录允许同一条记录被指定角色读取: ### 坑 3:AI 批改接口超时 **现象**:批改图片稍微大一点就报错,前端一直转圈。 **原因**:云函数默认超时时间只有 **3 秒**,AI 批改通常要 5~15 秒。 **解决**:在云开发控制台把 `gradeAI` 函数的超时时间调到 **20 秒**(可在 `config.json` 里配 `"timeout": 20`)。 ### 坑 4:多个云环境,环境 ID 写错 **现象**:代码明明对,数据却总写到另一个环境去了。 **原因**:开发环境 / 生产环境 ID 混淆,`wx.cloud.init({ env: 'xxx' })` 传了错的 env。 **解决**:云函数里统一用 `cloud.DYNAMIC_CURRENT_ENV`(当前环境),小程序端用 `wx.cloud.init({ env: '真实环境ID' })`,并在 `.env` 或常量里集中管理,别散落硬编码。 ### 坑 5:图片不压缩,上传又慢又费流量 **现象**:手机原图 3~5 MB,上传慢、AI 识别也慢。 **解决**:上传前用 `wx.compressImage` 压缩到 1 MB 以内,再 `wx.cloud.uploadFile`。质量和速度兼得。 ### 坑 6:订阅消息静默失败,一条都发不出去 **现象**:代码没报错,但用户就是收不到通知。 **原因**:`subscribeMessage.send` 前用户没有授权订阅,或者模板字段类型对不上。 **解决**:提交流程里先 `wx.requestSubscribeMessage` 让用户点同意;模板字段类型要严格按模板(`thing` / `number` / `date` 等)填,不能混。 --- ## 六、上线部署流程 1. 微信开发者工具 → 右上角「上传」,填版本号和备注; 1. 去 [mp.weixin.qq.com](https://mp.weixin.qq.com/) 小程序后台 → 版本管理 → 把刚上传的版本设为「体验版」; 1. 邀请几个真实用户(老师/学生/家长)扫码体验,走一遍完整流程; 1. 确认无误后点「提交审核」,等审核通过再「发布」。 --- ## 七、总结与数据 这个小程序从想法到上线,全程我一个人完成,后端**零服务器成本**,只靠微信云开发就撑起了完整闭环: - **4 个云函数**:登录、AI 批改、通知、统计,职责清晰; - **4 个集合**:用户、作业、提交、错题,读写分离; - 最核心的体会有两句:**一是 AI 调用放云函数、超时务必调大;二是数据库权限别用默认值。** 如果你也在做类似的小工具,强烈建议从「先跑通一个最小闭环(上传 → 批改 → 入库)」开始,再逐步加通知和统计,能少走很多弯路。

优秀的个人博客,低调大师

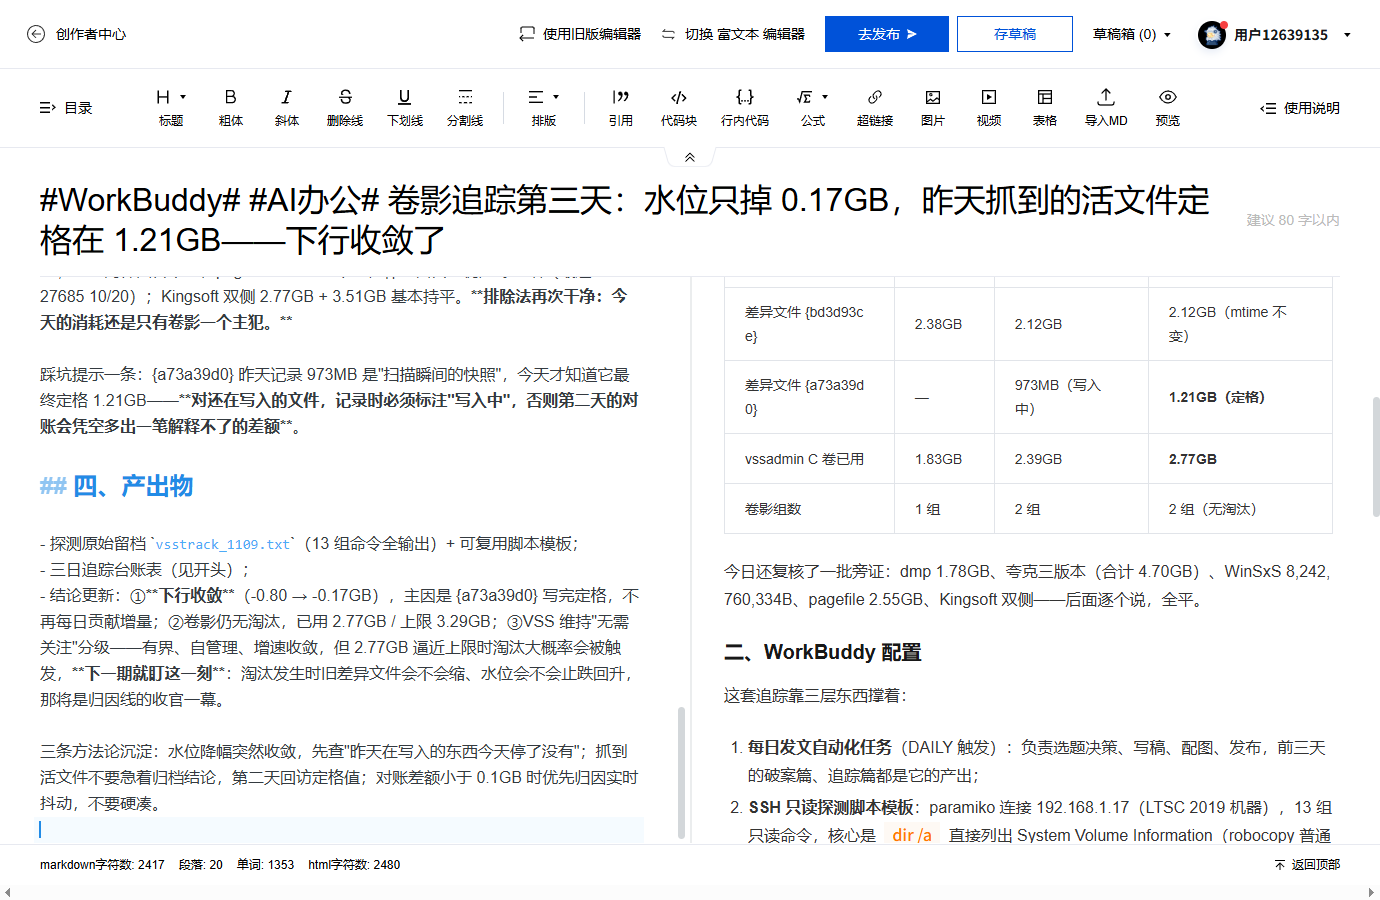
#WorkBuddy# #AI办公# 卷影追踪第三天:水位只掉 0.17GB,昨天抓到的活文件定格在 1.21GB——下行收敛了

本文是「C 盘消耗归因」系列的第六篇,也是卷影追踪的第三日。前情:11/07 破案(-1.63GB 的真凶是 System Volume Information 里的卷影差异区),11/08 第二日复扫(水位再掉 0.80GB,与卷影增量 0.71GB 对上,vssadmin 显示 3.29GB 上限封顶)。今天回答上一期留下的悬念:淘汰发生了吗?水位止跌了吗?

优秀的个人博客,低调大师

WorkBuddy 复盘:后台明明发成功 6 篇,本地台账一行都没有——根因是把记账挂在了命令行开关上

日期:2026-10-24。这是一个典型的「事实已发生、账本却不知道」案例,记下来给所有做自动化流水线的人提个醒。 ## 现象 头条自动发布通道跑了十几天后做回读对账,发现一个怪现象:后台(头条号文章管理页)明明有 10-17、10-18、10-20、10-22 共 6 篇文章带真实展现和阅读数据,但本地发布台账里「最近发布」停在 10-20,`已发布/头条已发/` 目录里也没有这 6 篇的归档。更糟的是,下游的断流检测读台账后,把一条实际活着的线误判成了「断流 🔴」,触发了错误的告警处置。 ## 根因:一行 if 排查 `tt_publish.py`,真凶就一行: ``` if "--auto" in sys.argv or PUBLISH_ONLY: record_ledger(title) # 记台账 archive_draft(f) # 稿件移入已发布 ``` 「记台账 + 归档」这两个**后置动作**被整段包在了 `--auto` 这个命令行开关的判断里。意思是:只有走全自动路径发布才会留痕;而手动补发、`--fill` + `--publish-only` 这类分步路径,页面确认发布成功后直接结束——**发布这个客观事实发生了,但记账代码从来没被调用**。 这违反一条很朴素的分工原则:**事实记录不应该依赖「通过哪条路径做成这件事」**。发布成功是一个客观结果,记账/归档是它的影子,影子的触发条件应该是「结果出现」,而不是「走路 A 还是走路 B」。 ## 修法 把记账解耦出开关: ``` if published_ok: # 只看结果,不看路径 try: record_ledger(title) archive_draft(f) except Exception as e: log(f"ledger failed but published: {e}") # 归档失败不影响「已发布」这个事实 ``` 注意两点:一是即使记账代码本身出错,也不能倒过来说「发布失败」——事实与记账分层,记账挂了记记账的错;二是所有包在 `if :` 里的后置动作都值得问一句:**不带这个开关跑的时候,这一步该不该做?** ## 连带的两个坑(同一批排查时挖出来的) **坑 1:后台发布日期被当噪音跳过。** 补账时需要每篇的真实发布时间。后台列表页的结构是「标题 → 日期行(形如 `10-12 09:22`)→ 已发布 → 展现/阅读」,而解析脚本的噪音过滤正则把孤立的短日期行一并过滤掉了。结果就是:数据明明在页面文本里,解析器却拿不到,只能靠猜——而猜日期等于编数据。修法是给日期行加一个「向上 N 行内贴着『已发布』状态」的定位规则,抓不到就返回空串,绝不猜。 **坑 2:「最近发布」用文件行序取值。** 看板的 `load_toutiao()` 每读一行台账就覆盖一次「最近发布」变量,等于取的是**文件最后一行**。历史补账是往中间插行的,行序不等于时间序,于是 10-23 的新记录被 10-22 的旧记录盖住,页面上「最近发布」和「今天已发 ✔」两张卡自相矛盾。修法是抽一个 `pick_latest()`,按日期字段取最大值,而不是按读取顺序。 ## 三条可以带走的结论 1. **事实与记账分层**:成功判定、事实落盘、账本更新是三件事,后两件不许挂在入口开关上。 1. **凡是要猜的日期,宁可留空**:原始文本里找不到就写「读不到」,不要用推定值填账。 1. **单值汇总别依赖文件行序**:补记、追加、乱序写入都会让它指向错行,按字段取最大值才稳。 这次 6 篇的漏账已用后台真值补齐,不是推定值。下游误判的告警也随台账修复自动纠正。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册