首页 文章 精选 留言 我的

精选列表

搜索[harness],共1481篇文章
优秀的个人博客,低调大师

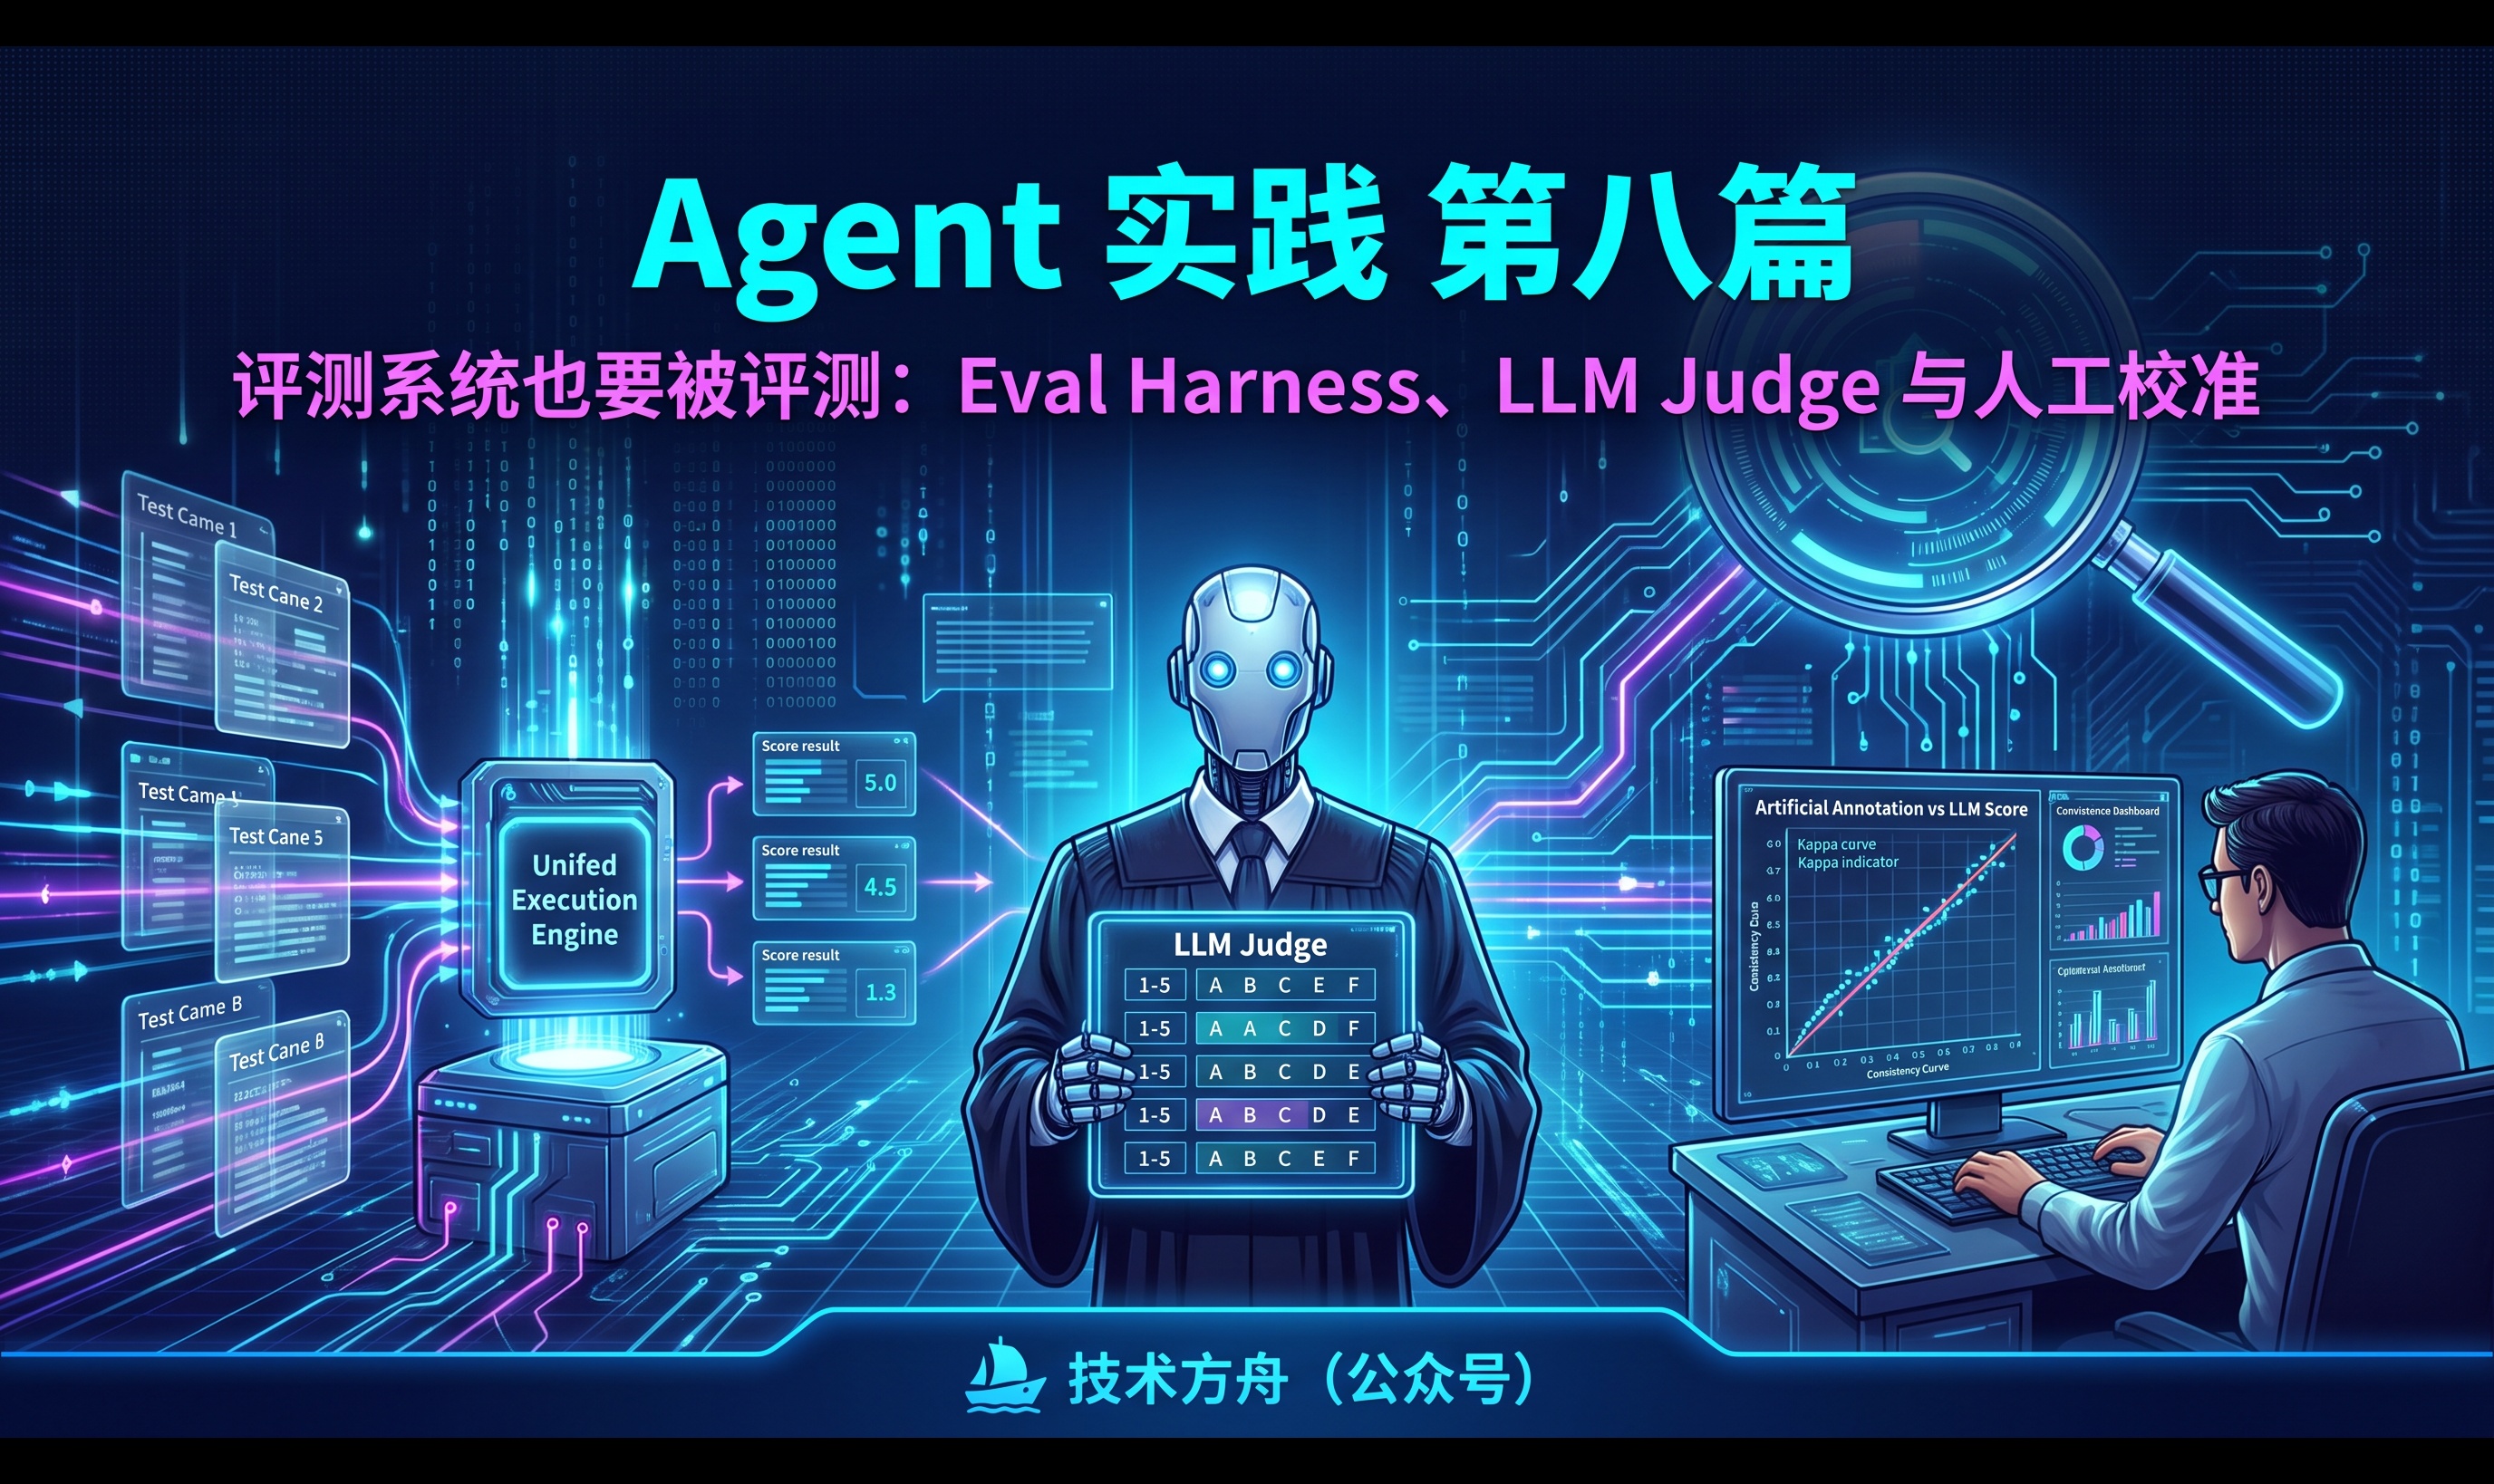
Agent 实践 第八篇 | 评测系统也要被评测:Eval Harness、LLM Judge 与人工校准

某三甲医院的一次版本评审会上,出院随访 Agent 的离线通过率提高了,随访护士却反映新版本更容易漏掉应当升级的患者。开发者没有伪造数字:报告确实来自自动运行。追查后发现,旧版本的试验大多安排在夜间语音外呼批次执行,转写噪声更多;新版本使用了更新的骨科随访模板与预警规则版本;评审提示也从“核对预警规则触发后是否创建升级”改成了“评价随访对话是否得体、解释是否清楚”。三个不同的问题被压成一个总分,最后被解释为同一系统的能力提升。

优秀的个人博客,低调大师

基于Harness工程和渐进式探索的源代码逆向工程- Skills 技能设计和实践

**大家好,我是人月聊IT。**今天继续聊AI辅助下的源代码逆向工程设计和实现。注意该技能包和实践只针对Java微服务项目进行了细化定制,暂时没有考虑其他开发框架和开发语言的个性化需求。 > 接手一个百万行存量项目时,最昂贵的动作不是"读代码",而是"重复读代码"。本文介绍一套以渐进式探索为核心的逆向工程技能(Skill)实践:先把大型代码库逆向成"可导航元模型",再让后续的每个需求、每个 Bug 都在这张地图上做定点打击,而不是一次次全库重扫。 ![](https://developer.qcloudimg.com/http-save/yehe-8165035/dedb019fbed324f742b3c1cf5c3e8abb.png) ## **一、大型存量代码库的"理解困局"** 每个经历过存量项目交接的工程师都熟悉这样的场景:新需求来了,先在代码库里漫无目的地搜索关键词,顺着调用链跳了十几个文件,终于找到改动点;三个月后同一个需求再来一次,发现又要从头走一遍——因为上一次理解的结论只存在会话里,没有沉淀下来。 这个问题不是"记忆力不好"造成的,而是由大型代码库的三个客观性质决定的。 **第一,上下文是预算,不是垃圾桶。** 一个会话能承载的有效上下文有限。百万行代码如果全部塞进上下文,不仅成本不可接受,有效信息密度也会被稀释——真正重要的边界、入口、状态变更点,淹没在大量无关实现细节里。 **第二,一次性理解无法沉淀。** 传统做法是一次性通读、输出一份"项目总结报告"。报告写得再好,也无法回答三个月后的新问题:这个接口有哪些调用方?这张表被哪些服务写入?这个状态机在哪里迁移?因为报告是"面向作者当时的关注点"的,不是"面向未来所有任务"的。 **第三,记忆必然漂移。** 代码库在持续演化,而人类(以及依赖静态报告的人)的记忆却停在过去。三个月前正确的结论,今天可能已经失效——文件被重命名、函数被重构、表结构被变更。用过期索引去定位问题,比没有索引更危险。 **第四,重复扫描有复利成本。** 更隐蔽的问题是团队层面的:十个人各自理解过一遍项目,就有十份互不相通的私人地图;每次新人入职、每次项目交接,同样的全库扫描重来一遍。理解成本随团队规模与人员流动呈复利式增长——这是存量项目"越老越难改"的深层原因之一。 这三条(其实四条)合在一起,指向一个结论:**对大型存量项目的理解,不能靠"读",要靠"工程"**。我们需要一套方法,把"理解项目"从一个一次性的动作,变成一个可持续维护的知识工程——这就是本文要讲的"渐进式探索"技能实践的核心出发点。 ## **二、核心思想:从"总结报告"到"可导航元模型"** 传统逆向的产物是"摘要":一份几十页的架构说明,读起来很有收获,用起来无从下手。本文介绍的技能把产物定义为**元模型(Meta-Model)**——一个对项目本身进行建模的模型,它区别于摘要的四个特性是: - **可导航**:每个结论都挂在层级结构里,从总入口逐层下钻,而不是平铺直叙; - **可钻取**:每个节点都携带源码索引(path / symbol / config / table / grep keywords),从结论能一步跳回代码; - **可更新**:它不是一次会话的产物,而是随代码演化持续维护的对象; - **可验证**:每条结论都标注证据级别,任何一条都可以被重新验证或宣告失效。 元模型回答的不是"这个项目是什么",而是"下一次任务需要什么"——需求变更落在哪个模块、Bug 最常出现在哪个区域、改动一张表会波及哪些流程。 实现这一目标的方法是**渐进式探索(Progressive Exploration)**,它由三个原则支撑: **原则一:先地图,后细节。** 永远先建立项目地形图(技术栈、入口、模块划分、数据流入口),再决定从哪里向下钻取。不看完整地图就深入细节,等于在陌生的城市里跟着直觉走小路。 **原则二:先索引,后展开。** 每一轮输出都以"索引"为骨架——一行摘要、一个链接、一组检索关键词。索引足够小、足够稳定,可以被反复读取;而细节知识被"延迟装载",只在任务真正需要时才展开。 **原则三:先稳定,后可变。** 建模顺序严格按稳定性排序:系统边界 → 模块边界 → 领域对象 → 数据模型 → 关键流程 → 可变实现细节。稳定的层是地基,可变细节是墙皮;反过来做,等于先研究墙皮再研究地基。 需要强调一点:这套方法论之所以被称为"技能(Skill)",是因为它不只是几条方法论口号,而是以 Skill 形态被封装为一套可执行资产——触发说明(什么场景调用)、分阶段工作流、每个阶段的提示词包、产物目录与节点模板、一致性校验清单。**方法论决定了"往哪个方向走",Skill 封装决定了"每次执行不重样、不跑偏"。** 任何人加载同一个 Skill,面对同一个仓库,产出的元模型结构一致、术语一致、质量线一致——这正是把个人经验变成团队资产的载体。 贯穿这三个原则的,是**证据分级**:每一条结论都必须标注为"已确认事实、高概率推断、待验证假设"三者之一。这一点在后面单独展开。 ## **三、逆向工程的九个阶段** 整套技能把逆向过程划分为九个阶段,每个阶段有明确的输入、操作与**完成标准**: |阶段|名称|一句话| | --- | --- | --- | |0|架构类型识别|判断单体 / 模块化单体 / monorepo / 微服务| |1|项目地形扫描|技术栈、构建、入口、配置、测试目录| |2|模块地图|稳定模块、职责、上下游依赖| |3|功能清单逆向|用户功能 → 前后端入口 → 源码 → 表| |4|领域对象抽取|实体、状态机、跨模块共享语义| |5|数据库模型逆向|表、键、字段语义、实体映射| |6|关键流程还原|请求/业务/落库/异步/定时五条链路| |7|高风险变更区|结构证据 + git 证据 + 技术债聚合| |8|总入口索引|meta-index + 二级索引 + 进度检查点| |9|一致性校验|引用完整性、孤立对象、主链路、低置信度| **阶段 0:架构类型识别。** 先回答"这是什么类型的系统",判断依据必须来自目录结构、构建文件、启动入口数量、部署清单、服务调用配置等客观证据,且至少两条独立证据交叉,证据不足的判断必须标记为"假设"。这一步决定了后续所有阶段的建模维度:单体项目只需要模块级元模型,微服务必须同时维护服务级与模块级两个层级。 **阶段 1:项目地形扫描。** 这是"先地图"的落地动作。只看根目录、构建文件、入口文件、配置目录、文档与测试目录,回答五个问题:技术栈是什么、入口在哪里、模块怎么划分、数据和控制流从哪里进入、服务边界在哪里。产出"前 10 个继续深挖的位置"——注意,是"位置",不是"结论"。地形扫描的纪律是:**不读业务细节**。 **阶段 2:模块地图。** 把系统拆成稳定模块,为每个模块记录职责、输入输出、上下游依赖、关键入口、典型变更点。完成标准是"所有顶层代码目录都有归属,模块间依赖没有未知留白"。 **阶段 3:功能清单逆向。** 这是整个元模型里需求价值最高的部分,因为需求总是以"某个功能"的形式被提出。按用户可感知功能拆分,每个功能记录:所属模块、前端落点(路由/页面/按钮)、后端 Controller、核心 Service、关键表、外部依赖、grep 关键词。前端追踪有专门的方法(见第七节)。 **阶段 4:领域对象抽取。** 提炼实体、值对象、状态机、枚举、DTO、聚合,重点回答哪些对象是业务语义核心、哪些跨模块共享、状态如何迁移。 **阶段 5:数据库模型逆向。** 当项目存在 DDL、Entity、Mapper 或显式 SQL 时,必须显式做数据库建模:主表、关系表、主键/唯一键、字段语义、代码实体到库表的四层映射(DDL → Entity → Mapper → Service),以及登录、权限、租户、菜单等核心域的表间关系。 **阶段 6:关键流程还原。** 优先还原五条链路:用户请求链路、核心业务处理链路、数据落库链路、异步消息链路、定时任务链路。每条链路必须回答:从哪里进入、经过哪些模块、关键判定点、状态在哪变化、数据在哪落库、可以从哪里插入需求变更。 **阶段 7:高风险变更区。** 识别需求高变区、高频 Bug 区、公共底座区、强耦合区、边界复杂区。与直觉相反,这个阶段**一半的证据来自 git 历史而不是代码结构**(见第七节)。 **阶段 8:总入口索引。** 把前面所有阶段收敛为一份小而稳定的 `meta-index.md`,并更新进度检查点 `PROGRESS.md`。这是整个元模型对外的唯一入口。 **阶段 9:一致性校验。** 收尾校验各产物之间的引用完整性,防止"能看但不好用"的孤立模型(见第八节)。 ## **四、阶段之间的关系:依赖、层级与闭环** 九个阶段不是简单的线性流水线,它们之间存在三种关系。 **递进依赖。** 前一阶段的产物是后一阶段的输入:没有地形扫描,模块划分就是猜;没有模块地图,功能归属就无处安放;没有数据库模型,流程还原就看不见"数据在哪落库"。这种依赖要求阶段严格按序执行,尤其是不允许"越级下钻"——直接跳到某个 Controller 的实现细节里,是整个流程最容易犯的错。 **稳定层优先。** 从建模对象的角度看,九个阶段恰好构成一个从稳定到可变的层级序列: ``` ┌─────────────────────────────────────────────┐ │ 系统边界(阶段0:架构类型、服务边界) │ ← 最稳定 ├─────────────────────────────────────────────┤ │ 模块边界(阶段1、2:地形、模块、依赖) │ ├─────────────────────────────────────────────┤ │ 领域对象(阶段4:实体、状态机、共享语义) │ ├─────────────────────────────────────────────┤ │ 数据模型(阶段5:表、键、字段语义、映射) │ ├─────────────────────────────────────────────┤ │ 关键流程(阶段3、6:功能、链路、变更点) │ ├─────────────────────────────────────────────┤ │ 可变实现细节(阶段7:热区、技术债) │ ← 最可变 └─────────────────────────────────────────────┘ ``` 越靠上的层越稳定,越值得投入精力精确建模;越靠下的层越易变,建模时要保留"随时回源验证"的能力。把有限的探索预算花在稳定层上,是元模型长期有效的根本原因——**稳定层建得越扎实,后续维护成本越低。** 对于微服务架构,这套层级还需要叠加一个**双层级**约束:服务级与模块级。服务级元模型回答"系统怎么部署、怎么协作"——服务拓扑、接口契约、事件拓扑、配置矩阵、数据归属;模块级元模型回答"代码怎么组织、逻辑在哪"——模块地图、领域对象、流程。一次跨服务的需求变更,要先用服务级地图定位边界(走哪个 API、发哪个事件、改哪张表),再钻进服务内部用模块级地图定位实现。两层之间的对应关系(哪个服务承载哪个模块、哪张表由哪个服务主写)是微服务元模型里最容易被忽略、却最常被问起的部分。 **校验闭环。** 阶段 9 不是可选的收尾仪式,而是整个流程的闭环:它回检阶段 0-8 的所有产物,发现引用断裂、孤立对象、主链路缺失,然后驱动修复并重跑,直到 0 ERROR。同时,证据升级(推断 → 事实)贯穿全程,是另一条看不见的反馈回路。整个流程可以用下图概括: ``` 阶段0 ─► 阶段1 ─► 阶段2 ─┬─► 阶段3 功能清单 ─┐ 架构识别 地形扫描 模块地图 ├─► 阶段4 领域对象 │ ├─► 阶段5 数据库模型 │ └─► 阶段6 流程还原 ─┘ │ ▼ 阶段8 总入口索引 + PROGRESS(断点续跑 ← 跨会话循环) ▲ │ 阶段9 一致性校验 ────┘ 回检阶段0-8,修复后重跑 ``` ## **五、渐进式探索的六个落地机制** 三个原则是思想,落地需要机制。这套技能把渐进式探索操作化为六个具体机制。 **机制一:入口索引(meta-index.md)。** 借鉴了 MEMORY.md 的设计:总入口文件必须小、稳定、可持续维护,每个条目一行、一个链接、一句摘要,详细知识分散到独立文档。后续任何任务的第一步都是读 meta-index.md,命中相关节点,再展开局部上下文: ``` - [模块地图](./module-index.md) - 系统模块、职责、依赖、热区 - [功能清单](./functional-inventory.md) - 功能、入口、源码、库表映射 - [关键流程](./flow-index.md) - 请求入口、调度链路、状态变更点 - [变更热区](./change-hotspots.md) - 高频 Bug 区、需求高变区、脆弱边界 ``` **机制二:深度三档与停止规则。** 渐进探索最怕两件事:小型项目过度逆向、大型项目刹不住车。为此定义三档深度:浅扫档(快速摸底,核心代码读取 ≤150 个文件)、标准档(一般需求,≤500 文件)、深挖档(大改造或长期维护,无硬上限、允许跨会话)。**达到档位上限即停止下钻**,把未覆盖项写入进度检查点,而不是无限扩展阅读。上下文是预算——预算要有额度,额度用完要记账,而不是超支。 **机制三:阶段完成标准(exit criteria)。** 每个阶段都有可勾选的完成标准。例如阶段 2 的完成标准是"所有顶层代码目录归属到模块、每模块具备职责/依赖/入口/索引四件套、模块间依赖无未知留白"。完成标准解决了两个问题:什么时候可以进入下一阶段(避免浅尝辄止),什么时候必须停手(避免过度建模)。 **机制四:进度检查点(PROGRESS.md)。** 深挖档必然跨多个会话。PROGRESS.md 记录目标档位、已完成阶段(日期+覆盖范围+遗留项)、待验证清单、下轮建议。新会话的第一步是读 PROGRESS.md + meta-index.md,从遗留项继续,而不是从头重扫——这是"一次性理解无法沉淀"的解法:**知识不沉淀在会话里,沉淀在文件里。** **机制五:最小上下文原则。** 处理具体需求或 Bug 时,先映射到元模型节点,只展开与任务直接相关的最小文件集合,任何扩展阅读都要有明确收益。这是"面向变更"的设计:元模型的价值恰恰在于,它让"最小上下文"成为一个可执行的检索动作,而不是一次碰运气的搜索。 **机制六:增量重扫。** 代码在演化,元模型必须跟上。增量更新的方法很朴素:用 `git diff --name-only ` 确定变更目录,只重扫变更区并更新对应文档。持续维护的元模型,维护成本远低于重建成本——前提是每次变更都落盘。 ## **六、证据分层:对抗记忆漂移** 元模型最大的敌人是"看起来正确":文件还在但逻辑已变、函数还在但行为已改。对抗手段是**证据分级 + 强制标注**。 每条结论必须标记为三级之一: - **事实**:已由代码、配置、测试、文档直接确认,可 grep 到; - **推断**:代码迹象强,但未完全闭环; - **假设**:需要继续读取或运行验证。 三级之间不是静态标签,而是一套生命周期。**升级配方**规定了升级的必要条件:推断升事实必须满足任一——测试命中(存在断言该行为的测试)、多路径交叉(如 Entity 字段、Mapper SQL、Service 写路径三处一致)、配置或文档佐证、运行验证。**升不上去就留在原级别,不要为了"好看"而升级。** 这句话是这个协议里最重要的一句话:证据级别是给未来的自己和同事看的信用记录,虚报信用只会让整个元模型失去信任。 **失效协议**解决"记忆漂移":元模型里的任何标识符都不是永真。定期(或每次基于元模型给修改建议前)用 grep 批量回源验证索引里的 path、symbol、表名是否仍存在: ``` # 批量回源:一次 grep 验证一批索引条目 grep -r "OrderService" src/main/java --include="*.java" -l grep -r "INSERT INTO t_order" src/main/resources --include="*.xml" -l ``` 验证失败的对象标记"已失效(日期):原因",移入文档的"历史/已变更"小节,并在进度检查点记录。**基于元模型给出的任何修改建议,落地前必须回源确认。** 这条规则把"防漂移"从口号变成了可执行的纪律。 在文档层面,证据协议落地为两个强制字段:`结论级别`(事实/推断/假设)与 `最后核验`(日期 + 依据,如"2026-08-13,测试 OrderFlowTest 命中")。每个节点模板都内置这两个字段,意味着**标注证据不是可选的注释,而是产物的固定组成部分**——未来的读者(包括未来的 AI)拿到任何一条结论,都能判断它值多少信任、上一次被验证是什么时候。 ## **七、三个高信号证据源** 在常规的代码阅读之外,这套技能刻意引入三个"高信号证据源"——它们单位投入的信息产出远高于逐行读代码。 **git 历史:时间维度的热区。** 代码结构回答"现在是什么",git 历史回答"哪里一直在变"。热区分析一半的证据来自这里: ``` # 需求高变区:最近 90 天提交最密集的目录 git log --oneline --since=90d -- modules/order | wc -l # 高频 Bug 区:bug 修复提交集中的目录 git log --oneline --grep='fix|bug' -- modules/payment # 强耦合证据:跨目录同时提交(同一次提交改动多个模块) git log --name-only --oneline -n 200 | grep -A1 'modules/' ``` 注意 git 证据的边界:高活跃可能意味着活跃开发而非高风险,所以它必须与结构证据合并使用,两者冲突时要说明冲突而不是忽略。 **契约与事件:跨服务语义的档案。** 微服务项目里,跨服务共享语义(DTO、状态枚举、事件体、幂等键)是最高价值的领域对象,但它们分散在各服务各自的代码库里。方法是在接口契约索引中单独建模:每个 REST 接口、Feign 调用、MQ 事件,记录契约定义位置、调用方、消费方、兼容性风险。这类对象往往有序列化测试与契约测试,是"推断升事实"的现成配方——一个事件体有对应的消费者测试断言其字段,就能交叉确认它是事实而非猜测。 **测试代码:行为契约的存档。** 测试是行为契约的最高信号——入口参数、边界条件、期望输出都在测试里写死了。有测试覆盖的关键流程,用测试还原期望行为,比读十遍实现更准确;有测试的功能可以直接升级为"事实";回归建议直接引用相关测试文件。代价是几乎为零,因为测试代码本来就在仓库里。 **前端追踪:四层映射。** 需求总是从"某个页面、某个按钮"开始描述,所以功能清单的入口必须从前端建立。方法是一条六步链路:识别前端技术栈(决定路由是配置式还是约定式)→ 收集路由清单 → 提取菜单与权限码 → 在请求层(axios/fetch 封装、api 目录)一次性收敛全部 URL 清单 → 与后端 Controller 的 @RequestMapping 做交集匹配 → 把页面 → API →Controller → Service → 表 的映射落盘。关键技巧是**在请求层收敛 URL 而不是逐页阅读**:一个 api 目录往往只有几十个文件,却覆盖了成百上千个页面的后端交互。 ## **八、一致性校验:让元模型"能用"** 元模型文档写完之后,最危险的状态是"每条都写了,互相不对账"。功能清单里引用的表在数据库模型里找不到、流程的入口在模块地图里没有归属、微服务的契约挂在不存在服务上——这种孤立模型"能看但不好用",甚至会误导后续任务。 阶段 9 一致性校验是收尾的质检工序,检查清单包括: 1. **引用完整性**:功能清单的表是否在数据库模型中,功能与流程的归属是否在模块地图中; 1. **孤立对象**:未被任何功能/流程引用的核心表、未映射的实体、无调用方的接口; 1. **主链路覆盖**:每个核心场景是否至少关联一个功能、一个接口、一张表; 1. **数据归属**(微服务):核心表是否被多个服务同时声明为主写; 1. **重复语义**:名称不同但描述近似的对象,提示可能重复建模; 1. **索引完备**:核心对象是否携带 path/symbol/grep,支持后续最小化补读; 1. **过度建模**:大量边缘对象但主链路未闭环,提示收敛粒度; 1. **低置信度**:置信度低的推断/假设汇总为人工复核清单。 输出按 ERROR / WARNING / INFO 分级,每条带对象名、问题类型、修复建议,最后给出覆盖度摘要:已识别多少个业务场景、功能点、接口、核心表、服务,以及哪些域的覆盖明显不足。覆盖度摘要的价值在于把"我不知道自己不知道什么"显式化——它列出的是逆向工作的盲区,后续任何依赖元模型的任务都能据此判断结论的边界。修复后重跑直到 0 ERROR。这一步保证了元模型从"写完了"到"能用"的跨越——**校验的不是完整性,是可用性。** ## **九、最小实践示例** 用一个虚构的订单系统快速演示整套流程的骨架(细节省略,只展示产物形状)。 **阶段 0-1 之后**,地形扫描的产物: ``` # 项目总览 - 架构类型:模块化单体(事实:单一 war 包,多 maven 模块,无注册中心) - 技术栈:Spring Boot 2.7 + MyBatis + MySQL + RabbitMQ - 主要入口:OrderApplication(HTTP)、OrderConsumer(MQ)、JobLauncher(XXL-Job) - 模块候选:order-core / order-api / order-infra / common ``` **阶段 2 之后**,模块地图的节点: ``` ## 模块:order-core - 结论级别:事实(多路径交叉:Entity + Mapper + Service 三处一致) - 职责:订单主流程领域逻辑 - 输入:OrderCreateCommand(来自 order-api) - 输出:OrderCreatedEvent(发布到 MQ) - 下游:order-infra(持久化)、payment-api(外部调用) - 关键入口:OrderService#createOrder - 索引:path=order-core/.../service/OrderService.java symbol=createOrder table=t_order grep=createOrder ``` **阶段 7 之后**,热区节点: ``` ## 热区:订单状态机 - 热区类型:高频 Bug / 边界复杂 - 结构证据:状态迁移集中在 OrderService,分支达 12 处 - git 证据:近 90 天 47 次提交,其中 fix/bug 相关 18 次 - 修改前必读:OrderService#transition、OrderStateEnum - 回归建议:OrderFlowTest(覆盖全部合法迁移与 6 个非法迁移) ``` **跨会话续跑**时,进度检查点的一行: ``` - [x] 阶段 5 数据库模型(2026-08-13,覆盖 t_order/t_order_item/t_payment, 遗留:t_coupon 无实体映射,进待验证清单) ``` **阶段 9 校验**的输出形态: ``` [ERROR] 功能 FUNC-12 引用的表 t_coupon 未在 database-model.md 中定义 [WARNING] 表 t_refund_log 未被任何功能/流程引用,可能为孤立表 [INFO] 对象 API-08 为低置信度推断,建议人工复核 ``` 整个过程走下来,最终沉淀的是十几个相互勾稽的 markdown 文档——它们合在一起,就是这张订单系统持续可用的"知识地图"。 ## **十、结语** 把大型代码库逆向成元模型,本质上是一次认知范式的转换:**从"读懂项目"转向"把项目建成可导航、可验证、可持续维护的知识资产"。** 渐进式探索是这场转换的方法论——先地图后细节、先索引后展开、先稳定后可变,配合证据分级对抗记忆漂移,配合进度检查点实现跨会话续跑,配合一致性校验保证产物可用。 这套技能最想传达的一个观点是:**理解代码库不应该是一次性的事件,而应该是一项持续投资的基础设施。** 第一次逆向投入的每一分钟,都会在后续的每一次需求变更、每一个 Bug 定位、每一次新人上手中被成倍地回收。当团队里的任何一个人都能从 meta-index.md 出发,在五分钟内定位到改动点、影响面与回归面时,这个团队就真正拥有了对存量系统的"制度性理解"——而这份理解,比任何一份过期的架构报告都更长久。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码