首页 文章 精选 留言 我的

精选列表

搜索[运维监控],共10000篇文章
优秀的个人博客,低调大师

运维自动化之Saltstack使用详解

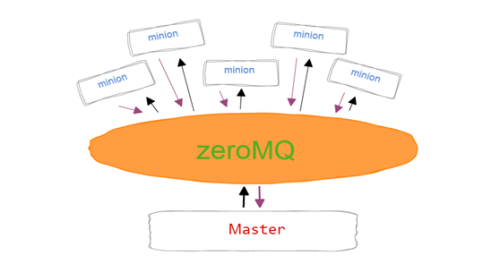
概要 saltstack是基于Python开发的C/S架构的一款批量管理工具,底层采用动态的连接总线(ZeroMQ消息队列pub/sub方式通信),使用ssl证书签发的方式进行认证管理,使其可以用于编配, 远程执行, 配置管理等等。部署轻松,在几分钟内可运行起来,扩展性好,很容易管理上万台服务器,速度够快,服务器之间秒级通讯。号称世界上最快的消息队列ZeroMQ使得saltstack非常快速的管理大量服务器,采用RSA Key方式确认身份,传输采用AES加密,安全性也非常有保障。 Saltstack使用Python开发,是一个非常简单易用和轻量级的管理工具。由Master和Minion构成,通过ZeroMQ进行通信。 SaltStack基于Python语言实现,结合轻量级消息队列(ZeroMQ)与Python第三方模块(Pyzmq、PyCrypto、Pyjinjia2、python-msgpack和PyYAML等)构建。有如下特性: (1)、部署简单、方便; (2)、支持大部分UNIX/Linux及Windows环境; (3)、主从集中化管理; (4)、配置简单、功能强大、扩展性强; (5)、主控端(master)和被控端(minion)基于证书认证,安全可靠; (6)、支持API及自定义模块,可通过Python轻松扩展。 Saltstack的master端监听4505与4506端口,4505为salt的消息发布系统,4506为salt客户端与服务端通信的端口;salt客户端程序不监听端口,客户端启动后,会主动连接master端注册,然后一直保持该TCP连接,master通过这条TCP连接对客户端控制,如果连接断开,master对客户端就无能为力了。当然,客户端若检查到断开后会定期的一直连接master端的。 核心功能 1、使命令发送到远程系统是并行的而不是串行的 2、使用安全加密的协议 3、使用最小最快的网络载荷 4、提供简单的编程接口 架构 saltstack是基于C/S服务模式,在该架构中,服务器端叫做Master,客户端叫做Minion。传统的C/S模式我们这样理解,客户端发送请求给服务器端,服务器端接受到来自客户端的请求并处理完成后再返回客户端。 在saltstack架构中,不仅有传统的C/S服务模式,而且有消息队列中的发布与订阅(pub/sub)服务模式。目前我们一般用其C/S架构做批量管理。 1)Master:控制中心,salt命令运行和资源状态管理 2)Minion:需要管理的客户端机器,会主动去连接Mater端,并从Master端得到资源状态 3)信息,同步资源管理信息 4)States:配置管理的指令集 5)Modules:在命令行中和配置文件中使用的指令模块,可以在命令行中运行 6)Grains:minion端的变量,静态的 7)Pillar:minion端的变量,动态的比较私密的变量,可以通过配置文件实现同步minions定义 8)highstate:为minion端下发永久添加状态,从sls配置文件读取.即同步状态配置 9)salt_schedule:会自动保持客户端配置 Saltstack安装 安装方式有四种,下面通过一个案例简单介绍在CentOS6.8上进行SaltStack部署。 (1)yum方式安装(采用saltstack源)推荐这种方式,简单粗暴。注意没有配置saltstack源的,请先配置saltstack源。 Version 7: rpm --importhttps://repo.saltstack.com/yum/redhat/7/x86_64/latest/SALTSTACK-GPG-KEY.pub Version 6: rpm --import https://repo.saltstack.com/yum/redhat/6/x86_64/latest/SALTSTACK-GPG-KEY.pub Save the following file to/etc/yum.repos.d/saltstack.repo: Version 7 and 6: [saltstack-repo] name=SaltStackrepoforRHEL/CentOS$releasever baseurl=https://repo.saltstack.com/yum/redhat/$releasever/$basearch/latest enabled=1 gpgcheck=1 gpgkey=https://repo.saltstack.com/yum/redhat/$releasever/$basearch/latest/SALTSTACK-GPG-KEY.pub 安装好saltstack源后,用yum命令来检查是否添加到源列表。 yumrepolistMaster端安装: yum -y install salt-master Minon端安装: yum -y install salt-minion 配置并启动Saltstack Salt的配置非常简单。默认的master配置就可以在大多数情况下运行。仅仅需要更改的是minion,在minion配置文件中设置master的地址。 The configuration fileswill be installed to/etc/saltand are named after the respective components,/etc/salt/master, and/etc/salt/minion. MASTER配置 默认Salt master监听所有网卡接口(0.0.0.0)的4505和4506端口. 如果需要指定监听IP, 通过/etc/salt/master配置文件中的"interface"指令进行如下修改: -#interface:0.0.0.0 +interface:10.0.0.1#此处是server端监听的地址。 auto_accept:True#此处是自动接受客户端发送过来的key,如果服务器很多的话,需要开启该功能。 MINION配置 尽管Salt Minion有许多配置选项,但配置Minion还是非常简单的. 默认的配置Minion会尝试连接DNS名为"salt"的master,如果minion解析到的地址正确,就无需再做配置. 如果DNS名为"salt"并不能解析到本地正确的Master地址,需要通过如下方法修改/etc/salt/minion配置文件中的"master"指令: -#master:salt +master:10.0.0.1#这里改成你的master服务器地址 id:web01#建议这里修改成主机名,便于master端分辨 #在配置文件末尾加入下面内容,每隔5分钟自动同步master配置,效果等同于在客户端执行salt-callstate.highstate或在server端执行salt'*'state.highstate schedule: highstate: function:state.highstate minutes:5 更新完配置后,需要重启Salt minion以使配置生效. 运行Saltstack 1.前台启动master(如果要以daemon方式启动,请指定-d参数<salt-master-d>): salt-master 2.前台启动minion(如果要以daemon方式启动,请指定-d参数<salt-minion-d>): salt-minion 运行有问题? 排除Salt故障最简单的方法是在前台运行master和minion,同时把loglevel设为``debug`` salt-master--log-level=debug 以普通(非root)用户运行: 想要使用其他用户身份运行Salt,参见:conf_master:`user`参数在master配置文件中。 Additionally, ownership, and permissions need to be set suchthat the desired user can read from and write to the following directories (andtheir subdirectories, where applicable): /etc/salt /var/cache/salt /var/log/salt /var/run/salt 更多关于如何使用非特权用户运行salt的信息可以在这里找到。 salt-key证书管理: master端证书存放路径:/etc/salt/pki/master/minions 注意:如果细心的话,你会发现小写字母针对的单一对象,大写都是针对全体。比如 -l显示单一key,-L显示所有key;-a 接受指定key,而-A 就是接受所有key。 saltstack认证原理: 1)、minion在第一次启动时,会在/etc/salt/pki/minion/(该路径在/etc/salt/minion里面设置)下自动生成minion.pem(private key)和 minion.pub(public key),然后将 minion.pub发送给master。 2)、master在接收到minion的publickey后,通过salt-key命令accept minion public key,这样在master的/etc/salt/pki/master/minions下的将会存放以minion id命名的 public key,然后master就能对minion发送指令了。 salt-key-L#查询所有接收到的证书 salt-key-a<证书名>#接收单个证书 salt-key-A#接受所有证书 salt-key-d<证书名>#删除单个证书 salt-key-D#删除所有证书 Salt在Master和Minion之间的通讯采用AES加密. 这就确保了发送给minions的命令不会被篡改, Master和Minion之间的通讯认证通过信任的已接受的key进行管理. 在发送给Minion之前,需要确保minion的key已经被Master所接受. 运行``salt-key``命令将列出Salt Master已知的所有keys. [root@master~]#salt-key-L UnacceptedKeys: alpha bravo charlie delta AcceptedKeys: [root@master~]#salt-key–A-y [root@master~]#salt-key-L UnacceptedKeys: AcceptedKeys: alpha bravo charlie delta 发送test.ping指令 [root@moban~]#salt'*'test.ping moban2: True moban1: True 限于篇幅太长,请大家移步这里进行下载查看,谢谢! 下载地址:http://down.51cto.com/data/2306388 本文转自 linuxzkq 51CTO博客,原文链接:http://blog.51cto.com/linuxzkq/1925299

优秀的个人博客,低调大师

Python自动化运维之异常处理

1、异常异常就是非正常状态,在Python中使用异常对象来表示异常。若程序在编译或运行过程中发生错误,程序的执行过程就会发生改变,抛出异常对象,程序流进入异常处理。如果异常对象没有被处理或捕捉,程序就会执行回溯(Traceback)来终止程序。2、异常类型通用异常类型表 异常 描述 BaseException 所有异常的基类 SystemExit 解释器请求退出 KeyboardInterrupt 用户中断执行(通常是输入^C) Exception 常规错误的基类 StopIteration 迭代器没有更多的值 GeneratorExit 生成器(generator)发生异常来通知退出 StandardError 所有的内建标准异常的基类 ArithmeticError 所有数值计算错误的基类 FloatingPointError 浮点计算错误 OverflowError 数值运算超出最大限制 ZeroDivisionError 除(或取模)零 (所有数据类型) AssertionError 断言语句失败 AttributeError 对象没有这个属性 EOFError 没有内建输入,到达EOF 标记 EnvironmentError 操作系统错误的基类 IOError 输入/输出操作失败 OSError 操作系统错误 WindowsError 系统调用失败 ImportError 导入模块/对象失败 LookupError 无效数据查询的基类 IndexError 序列中没有此索引(index) KeyError 映射中没有这个键 MemoryError 内存溢出错误(对于Python 解释器不是致命的) NameError 未声明/初始化对象 (没有属性) UnboundLocalError 访问未初始化的本地变量 ReferenceError 弱引用(Weak reference)试图访问已经垃圾回收了的对象 RuntimeError 一般的运行时错误 NotImplementedError 尚未实现的方法 SyntaxError Python 语法错误 IndentationError 缩进错误 TabError Tab 和空格混用 SystemError 一般的解释器系统错误 TypeError 对类型无效的操作 ValueError 传入无效的参数 UnicodeError Unicode 相关的错误 UnicodeDecodeError Unicode 解码时的错误 UnicodeEncodeError Unicode 编码时错误 UnicodeTranslateError Unicode 转换时错误 Warning 警告的基类 DeprecationWarning 关于被弃用的特征的警告 FutureWarning 关于构造将来语义会有改变的警告 OverflowWarning 旧的关于自动提升为长整型(long)的警告 PendingDeprecationWarning 关于特性将会被废弃的警告 RuntimeWarning 可疑的运行时行为(runtime behavior)的警告 SyntaxWarning 可疑的语法的警告 UserWarning 用户代码生成的警告 Exception类:是通用异常基类下列异常类均继承于Exception类,python解析器会自动将通用异常类型名称放在内建命名空间中,所以当使用通用异常类型时,不需要import exceptions模块。3、异常处理3.1 触发异常raiseraise关键字:手动抛出一个通用的异常类型(Exception),类似Java中的throw语句。raise关键字后跟异常的名称,异常名称能够标识出异常类的对象。执行raise语句时,python会创建指定异常类的对象,还能够指定对异常对象进行初始化的参数,参数也可以为由若干参数组成的元组。 注意:一旦执行raise语句,程序就会被终止。 格式:raise [exceptionType[,argument][,traceback]] deftestRaise(number): ifnumber<1: raiseValueError('Invalidvalue')#或者raiseValueError,'Invalidvalue' testRaise(0) traceback:这个参数用于追踪异常对象,一般很少使用。 这样就可以触发一个异常,并且接收异常信息。3.2 传递异常当你捕获到异常之后又希望再次的触发异常只需要使用不带任何参数的raise关键字。 importos try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists' ifnotos.path.exists('notExistsFile.txt'): raise except: print('processexception' 异常会在捕获之后再次触发同一个异常。3.3 assert语句触发异常assert语句根据后面的表达式的真假来控制程序流。若为True,则往下执行。若为False,则中断程序并调用默认的异常处理器,同时输出指定的提示信息。 格式:assertexpression,'information' 例如: deftestAssert(x): assertx<1,'Invalidvalue' testAssert(1) print('Validvalue' 执行结果: AssertionError:Invaildvalue 3.4 捕获异常try..except..else注意:except子句的数量没有限制,但使用多个except子句捕获异常时,如果异常类之间具有继承关系,则子类应该写在前面,否则父类将会直接截获子类异常。放在后面的子类异常也就不会执行。 格式: try: 可能触发异常的语句块 except[exceptionType]: 捕获可能触发的异常[可以指定处理的异常类型] except[exceptionType][,date]: 捕获异常并获取附加数据 except: 没有指定异常类型,捕获任意异常 else: 没有触发异常时,执行的语句块 4、try的工作原理执行一个try语句时,python解析器会在当前程序流的上下文中作标记,当出现异常后,程序流能够根据上下文的标记回到标记位,从而避免终止程序。 1. 如果try语句执行时发生异常,程序流跳回标记位,并向下匹配执行第一个与该异常匹配的except子句,异常处理完后,程序流就通过整个try语句(除非在处理异常时又引发新的异常)。 2. 如果没有找到与异常匹配的except子句(也可以不指定异常类型或指定同样异常类型Exception,来捕获所有异常),异常被递交到上层的try(若有try嵌套时),甚至会逐层向上提交异常给程序(逐层上升直到能找到匹配的except子句。实在没有找到时,将结束程序,并打印缺省的错误信息)。 3. 如果在try子句执行时没有发生异常,python将执行else语句后的语句(可选),然后控制流通过整个try语句。 try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists')#执行 except: print('processexception')#不执行 else: print('Readingthefile')#不执行 执行结果: In[157]:%runtestError.py FilenotExists 嵌套try: try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists')#执行 except: print('processexception')#不执行 else: print('Readingthefile')#执行 执行结果: In[159]:%runtestError.py FilenotExists Readingthefile 5、捕捉多个异常方法一:指定一个通用异常,可以捕获多个不同的包含在Exception类中的异常类。 try: 语句块 exceptException: 语句块 方法二:在一个except子句后将多个异常作为元组元素列出。 try: 语句块 except(IOError,ValueError): 语句块 方法三:except子句后不带任何异常名称,捕获所有异常 try: 语句块 except: 语句块 6、try..finally语句无论try语句块中是否触发异常,都会执行finally子句中的语句块,因此一般用于关闭文件或关闭因系统错误而无法正常释放的资源。比如文件关闭,释放锁,把数据库连接返还给连接池等。 importos defwrite_test(fileName,content_iterable): try: pwd=open(fileName,'w') forkey,valueincontent_iterable.items(): pwd.write(key+'\t'+value+'\n')#传入String类型参数同时加入换行符 finally: pwd.close() if__name__=='__main__': fileName='/usr/local/src/pyScript/fileOperation.txt' dic={'name':'Jmilk','age':'23','city':'BJ'} ifos.path.exists(fileName): write_test(fileName,dic) else:print('Filenotexist!') 注意:try..finally与try..except 是可以同时使用的。 In[3]:try: ...:raise ...:exceptException: ...:print('error') ...:raise ...:finally: ...:print('success') ...: error success --------------------------------------------------------------------------- TypeErrorTraceback(mostrecentcalllast) <ipython-input-3-530db52949e7>in<module>() 1try: ---->2raise 3exceptException: 4print('error' 5raise TypeError:exceptionsmustbeold-styleclassesorderivedfromBaseException,notNoneType NOTE:try…finally 的意义在于,就是我们在 try 代码块中执行了 return 语句,但是仍然会继续执行在 finally 中的代码块,所以我们一般用作处理资源的释放。7、自定义异常通过(直接或简介)继承Exception类来创建一个自定义异常类,自定义的异常类只能通过raise关键字来手动触发。 classtestError(Exception):#直接集成Exception类 def__init__(self,arg): self.args=arg try: raisetestError('Justtest') excepttestError,info: printinfo.args 执行结果: In[52]:%runtest.py ('J','u','s','t','','t','e','s','t') with..as触发异常自动关闭资源在使用类文件的流对象时,都需要单独的调用close()来关闭资源。with..as语句能够实现在with语句块执行完后,自动的关闭文件。如果with语句块中触发异常,会调用默认的异常处理器处理,而且文件仍然能够正常关闭。 importos deftestWith(fileName): try: withopen(fileName,'r+')aspwd: pwd.readlines() print2/0 exceptException: print('Fileclosed:',pwd.closed#判断文件是否关闭 if__name__=='__main__': ifos.path.exists('/usr/local/src/pyScript/fileOperation.txt'): testWith('/usr/local/src/pyScript/fileOperation.txt') print('continue') 执行结果: In[17]:%runtest.py Fileclosed:True#没有callclose()函数,文件仍然自动关闭。 continue 7、as获取异常信息每个异常都会有一定的描述信息,可以通过as关键字来获取。但是这种异常信息并不适合一般用户阅读,所以会使用自定义的异常信息。但是仍然会将原有的异常信息保留起来,用于后期的异常分析。 try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() except(IOError,ValueError)asinfo:#或者except(IOError,ValueError),info: printinfo except: print('processexception') else: print('Readingthefile') 执行结果: In[164]:%runtestError.py [Errno2]Nosuchfileordirectory:'notExistsFile.txt' 异常参数也可以使用异常参数作为输出的异常信息参数,来获取异常信息。并且异常参数中包含有异常信息、错误数字、错误位置等属性。 try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() except(IOError,ValueError),info: printdir(info) printinfo.args except: print('processexception') else: print('Readingthefile') 执行结果: In[44]:%runtest.py ['__class__','__delattr__','__dict__', '__doc__','__format__','__getattribute__','__getitem__', '__getslice__','__hash__','__init__','__new__','__reduce__', '__reduce_ex__','__repr__','__setattr__','__setstate__', '__sizeof__','__str__','__subclasshook__','__unicode__','args', 'errno','filename','message','strerror'] (2,'Nosuchfileordirectory') Readingthefile 8、traceback追踪异常使用traceback追踪异常的时候,需要import traceback模块。traceback模块可以有效的帮助查看异常的详细信息。 注意:若希望获取异常的详细信息,却又不会终止程序的执行,可以在except子句中使用 tarceback.print_exc()函数。 tarceback.print_exc(): print_exc(limit=None,file=None) Shorthandfor‘print_exception(sys.exc_type,sys.exc_value,sys.exc_traceback,limit,file)’. (Infact,itusessys.exc_info()toretrievethesameinformationinathread-safeway.) 输出sys.exc_type, sys.exc_value, sys.exc_traceback, limit, file等异常信息,实际上是以线程安全的方式去使用sys.exc_info()函数来获取相同的信息。 importtraceback try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOErrorasinfo: print('FilenotExists') print(info) traceback.print_exc() print('continue') except: print('processexception') else: print('Readingthefile') 执行结果: In[38]:%runtest.py FilenotExists [Errno2]Nosuchfileordirectory:'notExistsFile.txt' Traceback(mostrecentcalllast): File"/usr/local/src/pyScript/test.py",line5,in<module> openFile=open('notExistsFile.txt','r') IOError:[Errno2]Nosuchfileordirectory:'notExistsFile.txt' continue 异常信息的重定向:如果希望将异常的信息保存在一个指定的文件中,以供后期分析。可以使用下面的方法: importtraceback try: withopen('notExistsFile.txt','r')asopenFile: fileContent=openFile.readlines() exceptIOError: withopen('errorLog','w+')aserrorInfo: traceback.print_exc(file=errorInfo) print('continue') except: print('processexception') else: print('Readingthefile') 执行结果: In[61]:%runtest.py continue In[62]:caterrorLog Traceback(mostrecentcalllast): File"/usr/local/src/pyScript/test.py",line5,in<module> withopen('notExistsFile.txt','r')asopenFile: IOError:[Errno2]Nosuchfileordirectory:'notExistsFile.txt' sys.exc_info()获取异常信息traceback.print_exc()函数实际上是call sys.exc_info() importsys try: a=b b=c except: info=sys.exc_info() print(info[0],":",info[1]) 执行结果: In[65]:%runtest.py <type'exceptions.NameError'>:name'b'isnotdefined 异常处理用于处理程序错误之外,还有许多应用的地方。如关闭资源、平台兼容、模块导入等。

优秀的个人博客,低调大师

Python自动化运维之高级函数

一、协程1.1协程的概念协程,又称微线程,纤程。英文名Coroutine。一句话说明什么是线程:协程是一种用户态的轻量级线程。(其实并没有说明白~)那么这么来理解协程比较容易: 线程是系统级别的,它们是由操作系统调度;协程是程序级别的,由程序员根据需要自己调度。我们把一个线程中的一个个函数叫做子程序,那么子程序在执行过程中可以中断去执行别的子程序;别的子程序也可以中断回来继续执行之前的子程序,这就是协程。也就是说同一线程下的一段代码执行着执行着就可以中断,然后跳去执行另一段代码,当再次回来执行代码块的时候,接着从之前中断的地方开始执行。比较专业的理解是: 协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈。因此:协程能保留上一次调用时的状态(即所有局部状态的一个特定组合),每次过程重入时,就相当于进入上一次调用的状态,换种说法:进入上一次离开时所处逻辑流的位置。1.2 协程的优缺点协程的优点: (1)无需线程上下文切换的开销,协程避免了无意义的调度,由此可以提高性能(但也因此,程序员必须自己承担调度的责任,同时,协程也失去了标准线程使用多CPU的能力) (2)无需原子操作锁定及同步的开销 (3)方便切换控制流,简化编程模型 (4)高并发+高扩展性+低成本:一个CPU支持上万的协程都不是问题。所以很适合用于高并发处理。协程的缺点: (1)无法利用多核资源:协程的本质是个单线程,它不能同时将 单个CPU 的多个核用上,协程需要和进程配合才能运行在多CPU上.当然我们日常所编写的绝大部分应用都没有这个必要,除非是cpu密集型应用。 (2)进行阻塞(Blocking)操作(如IO时)会阻塞掉整个程序2、Python中如何实现协程2.1 yield实现协程 前文所述“子程序(函数)在执行过程中可以中断去执行别的子程序;别的子程序也可以中断回来继续执行之前的子程序”,那么很容易想到Python的yield,显然yield是可以实现这种切换的。 defeater(name): print("%seatfood"%name) whileTrue: food=yield print("done") g=eater("gangdan") print(g) 执行结果: <generatorobjecteaterat0x0000000002140FC0> 由执行结果可以证明g现在就是生成器函数 2.2 协程函数赋值过程用的是yield的表达式形式,要先运行next(),让函数初始化并停在yield,然后再send() ,send会在触发下一次代码的执行时,给yield赋值next()和send() 都是让函数在上次暂停的位置继续运行, defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) #获取生成器 builder=creater('tom') #现在是运行函数,让函数初始化 next(builder) print(builder.send('包子')) print(builder.send('骨头')) print(builder.send('菜汤')) 执行结果: tomstarttoeatfood tomget包子,tostarteat ['包子'] tomget骨头,tostarteat ['包子','骨头'] tomget菜汤,tostarteat ['包子','骨头','菜汤'] 需要注意的是每次都需要先运行next()函数,让程序停留在yield位置。如果有多个这样的函数都需要执行next()函数,让程序停留在yield位置。为了防止忘记初始化next操作,需要用到装饰器来解决此问题 definit(func): defwrapper(*args,**kwargs): builder=func(*args,**kwargs) next(builder)#这个地方是关键可以使用builder.send("None"),第一次必须传入None。 returnbuilder returnwrapper @init defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) #获取生成器 builder=creater("tom") #现在是直接运行函数,无须再函数初始化 print(builder.send('包子')) print(builder.send('骨头')) print(builder.send('菜汤')) 执行结果: tomstarttoeatfood tomget包子,tostarteat ['包子'] tomget骨头,tostarteat ['包子','骨头'] tomget菜汤,tostarteat ['包子','骨头','菜汤'] 2.3协程函数简单应用 请给Tom投喂食物 definit(func): defwrapper(*args,**kwargs): builder=func(*args,**kwargs) next(builder) returnbuilder returnwrapper @init defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) deffood(): builder=creater("Tom") whileTrue: food=input("请给Tom投喂食物:").strip() iffood=="q": print("投喂结束") return0 else: builder.send(food) if__name__=='__main__': food() 执行结果: Tomstarttoeatfood 请给Tom投喂食物:骨头 Tomget骨头,tostarteat 请给Tom投喂食物:菜汤 Tomget菜汤,tostarteat 请给Tom投喂食物:q 投喂结束 2.4 协程函数的应用实现linux中"grep -rl error <目录>"命令,过滤一个文件下的子文件、字文件夹的内容中的相应的内容的功能程序首先了解一个OS模块中的walk方法,能够把参数中的路径下的文件夹打开并返回一个元组 >>>importos#导入模块 >>>os.walk(r"E:\Python\script")#使用r是让字符串中的符号没有特殊意义,针对的是转义 <generatorobjectwalkat0x00000000035D3F10> >>>g=os.walk(r"E:\Python\script") >>>next(g) ('E:\\Python\\script',['.idea','函数'],[]) 返回的是一个元组,第一个元素是文件的路径,第二个是文件夹,第三个是该路径下的文件这里需要用到一个写程序的思想:面向过程编程二、面向过程编程面向过程:核心是过程二字,过程及即解决问题的步骤,基于面向过程设计程序就是一条工业流水线,是一种机械式的思维方式。流水线式的编程思想,在设计程序时,需要把整个流程设计出来优点:1:体系结构更加清晰2:简化程序的复杂度缺点:可扩展性极其的差,所以说面向过程的应用场景是:不需要经常变化的软件,如:linux内核,httpd,git等软件下面就根据面向过程的思想完成协程函数应用中的功能目录结构: test ├──aa │├──bb1 ││└──file2.txt │└──bb2 │└──file3.txt └─file1.txt 文件内容: file1.txt:error123 file2.txt:123 file3.txt:123error 程序流程 第一阶段:找到所有文件的绝对路径 第二阶段:打开文件 第三阶段:循环读取每一行 第四阶段:过滤“error” 第五阶段:打印该行属于的文件名第一阶段:找到所有文件的绝对路径g是一个生成器,就能够用next()执行,每次next就是运行一次,这里的运行结果是依次打开文件的路径 >>>importos >>>g=os.walk(r"E:\Python\script\函数\test") >>>next(g) ('E:\\Python\\script\\函数\\test',['aa'],[]) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa',['bb1','bb2'],['file1.txt']) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa\\bb1',[],['file2.txt']) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa\\bb2',[],['file3.txt']) >>>next(g) Traceback(mostrecentcalllast): File"<input>",line1,in<module> StopIteration 我们在打开文件的时候需要找到文件的绝对路径,现在可以通过字符串拼接的方法把第一部分和第三部分进行拼接用循环打开: importos dir_g=os.walk(r"E:\Python\script\函数\test") fordir_pathindir_g: print(dir_path) 结果: ('E:\\Python\\script\\函数\\test',['aa'],[]) ('E:\\Python\\script\\函数\\test\\aa',['bb1','bb2'],['file1.txt']) ('E:\\Python\\script\\函数\\test\\aa\\bb1',[],['file2.txt']) ('E:\\Python\\script\\函数\\test\\aa\\bb2',[],['file3.txt']) 将查询出来的文件和路径进行拼接,拼接成绝对路径 importos dir_g=os.walk(r"E:\Python\script\函数\test") fordir_pathindir_g: forfileindir_path[2]: file="%s\\%s"%(dir_path[0],file) print(file) 执行结果: E:\Python\script\函数\test\aa\file1.txt E:\Python\script\函数\test\aa\bb1\file2.txt E:\Python\script\函数\test\aa\bb2\file3.txt 用函数实现: importos defsearch(): whileTrue: dir_name=yield dir_g=os.walk(dir_name) fordir_pathindir_g: forfileindir_path[2]: file="%s\\%s"%(dir_path[0],file) print(file) g=search() next(g) g.send(r"E:\Python\script\函数\test") 为了把结果返回给下一流程 @init#初始化生成器 defsearch(target): whileTrue: dir_name=yield dir_g=os.walk(dir_name) forpardir,_,filesindir_g: forfileinfiles: abspath=r"%s\%s"%(pardir,file) target.send(abspath) 第二阶段:打开文件 @init defopener(target): whileTrue: abspath=yield withopen(abspath,'rb')asf: target.send((abspath,f)) 第三阶段:循环读出每一行内容 @init defcat(target): whileTrue: abspath,f=yield#(abspath,f) forlineinf: res=target.send((abspath,line)) ifres:break 第四阶段:过滤 @init defgrep(pattern,target): tag=False whileTrue: abspath,line=yieldtag tag=False ifpatterninline: target.send(abspath) tag=True 第五阶段:打印该行属于的文件名 @init defprinter(): whileTrue: abspath=yield print(abspath) g=search(opener(cat(grep('error'.encode('utf-8'),printer())))) g.send(r'E:\Python\script\函数\test') 执行结果: E:\Python\script\函数\test\aa\file1.txt E:\Python\script\函数\test\aa\bb2\file3.txt

优秀的个人博客,低调大师

Linux轻量级自动运维工具-Ansible浅析

Ansible是什么? ansible架构图 ansible特性 模块化:调用特定的模块,完成特定的任务; 基于Python语言研发,由Paramiko, PyYAML和Jinja2三个核心库实现; 部署简单:agentless; 支持自定义模块,使用任意编程语言; 强大的playbook机制; 幂等性; 安装及程序环境: 程序: ansible ansible-playbook ansible-doc 配置文件: /etc/ansible/ansible.cfg 主机清单: /etc/ansible/hosts 插件目录: /usr/share/ansible_plugins/ 安装ansible 安装依赖包 ansible命令的使用: Usage: ansible <host-pattern> [options] 常用选项: -m MOD_NAME -a MOD_ARGS 配置Host Inventory: /etc/ansible/hosts [group_id] HOST_PATTERN1 HOST_PATTERN2 示例:首先对此文件进行备份操作,以防后面需要用到默认配置文件 进入到/etc/ansible/hosts文件,此处绿色光标以下的内容是没有用的,都是示例,可以删除掉,然后添加我们下面实验操作用到的主机。 添加一组websrvs服务器,以用于下面的测试 测试主机连通性 这里报错是因为实验用的主机交换其他两台主机的公钥/私钥的原因导致的 实验SSH免密码登陆设置 生成私钥和公钥ssh-keygen -t rsa -P '' 复制公钥文件问authorized_keys 把公钥传送到其他主机 在68的主机上面可以看见公钥已经传送过来了,并且确认文件的权限是否正确 重复以上操作把公钥发送给69的主机 然后重新执行ansible的ping模块命令查看该两台主机的连通性 可以发现此时已经成功,那么下面就开始介绍ansilbe的其他模块 最后记得利用ansible同步一下所有主机的时间,以免某主机的时间有错误,后面看日志起来会造成混乱 ansible模块: 获取模块列表:ansible-doc -l 获取指定模块的使用帮助:ansible-doc -s MOD_NAME 常用模块: ping模块:探测目标主机是否存活; 示例:测试所有的主机的连通性 command模块:在远程主机执行命令; 示例1:让所有主机同步时间 此处没有给出指定的-m command命令,是因为ansible的模块默认就是command 示例2:让每一台主机都执行uname -r命令 示例3:在主机上面都创建一个用户 查看两台主机是否已经创建该用户 查看用户信息: 帮这两个用户改密码,此处需要注意的是,虽然用下面的命令看似执行成功,但是当我们验证的时候,就会发现密码错误了,这是因为ansible的command模块并不支持管道等输出,所以下面介绍另外一个ansible的模块shell shell模块:在远程主机上调用shell解释器运行命令,支持shell的各种功能,例如管道等 注意:command和shell模块的核心参数直接为命令本身;而其它模块的参数通常为“key=value”格式; 示例:批量修改其他主机的特定用户的密码 此时可以发现已经可以登陆成功 copy模块:复制文件到远程主机 用法: (1) 复制文件 -a "src= dest= " (2) 给定内容生成文件 -a "content= dest= " 其它参数:mode, owner, group, ... 示例:复制文件到其他主机 此处创建一个测试文件 复制文件到其他主机 下面红色的报错信息是,如果要传送文件,该主机的指定目录需要存在,如果不存在,就是提示错误 创建对应的目录 重新传送文件,已经没有错误提示,但是此处也可以看见,如果文件已经存在,则原文件会被覆盖掉,并且此处也没有任何提示覆盖文件的信息,所以操作的时候就需要注意了,以免覆盖掉重要的文件 验证文件 file模块:设置文件的属性 用法: (1) 创建目录: -a "path= state=directory" (2) 创建链接文件: -a "path= src= state=link" (3) 删除文件: -a "path= state=absent“ 示例:修改文件的权限和属主 验证文件 示例:创建文件的软连接 验证文件 设置文件的状态为absent(即删除文件) 验证 fetch模块:从远程主机拿文件 示例:从10.1.156.69主机拿一个文件 当抓去一堆文件的时候,也会创建对应的ip地址的目录,以区分文件 cron模块:管理计划任务条目 用法: -a "" minute= hour= day= month= weekday= job= name= user= state={present|absent} 示例:创建一个同步时间的计划任务,每5分钟同步一下服务器的时间 验证任务 示例:删除计划任务 验证 hostname模块:管理主机名 用法: name= 示例:修改主机名 yum模块:使用yum命令完成程序包管理 用法: -a "" (1) name= state={present|latest} (2) name= state=absent 示例:安装指定包 此实验,首先,确定主机的yum源是可用的,否则实验会失败 安装samba包 验证 删除samba安装包 已经没有安装的字眼了 service模块:服务管理 用法: -a "" name= state= started stopped restarted enabled= runlevel= 示例:开启主机的httpd服务 首先我们确认httpd服务是关闭的 开启httpd服务,并且设置为开机启动 验证,80端口已经开启 group模块:增加或删除组 用法: -a "" name= state= system= gid= 示例:添加一个组 验证 删除组 验证 user模块:用户管理 使用格式: name= : 创建的用户名 state= : present新增,absent删除 force= : 删除用户的时候删除家目录 system= : 创建系统用户 uid= : 指定UID shell= : 指定shell home= : 指定用户家目录 示例:增加一个系统用户 验证 删除用户 setup模块:收集主机里面的各种信息 示例:收集所有主机的信息 YAML:一种数据序列化工具的语言格式 YAML is a data serialization format designed for human readability and interaction with scripting languages. 数据结构: key:value - item1 - item2 - item3 例如{name:jerry, age:21} PlayBook 核心元素: Tasks:任务,由模块定义的操作的列表; Variables:变量 Templates:模板,即使用了模板语法的文本文件; Handlers:由特定条件触发的Tasks; Roles:角色; playbook的基础组件: Hosts:运行指定任务的目标主机; remote_user:在远程主机以哪个用户身份执行; sudo_user:非管理员需要拥有sudo权限; tasks:任务列表 模块,模块参数: 格式: (1) action: module arguments (2) module: arguments 运行playbook,使用ansible-playbook命令 (1) 检测语法 ansible-playbook --syntax-check /path/to/playbook.yaml (2) 测试运行 ansible-playbook -C /path/to/playbook.yaml --list-hosts -list-tasks --list-tags (3) 运行 ansible-playbook /path/to/playbook.yaml -t TAGS, --tags=TAGS --skip-tags=SKIP_TAGS --start-at-task=START_AT 示例1:定义一个playbook任务来新增用户和组 定义一个yaml的模板 查查语法有没有错误,没有提示即表示语法应该没有问题。 测试运行看看,-C表示仅测试跑一边,但是不会实际操作 也可以单独测试某些特定的选项 查看仅影响的主机 查看运行哪些任务 查看哪个任务打标了,这里并没有任何任务打标记,后面再演示 以上没有错误,开始正式运行该任务 验证 示例2:定义一个playbook任务来修改文件端口 此步骤里面有安装httpd的安装包,其实此处有点多余,因为测试的两台主机均已经安装该服务,此处添加上去是为了演示效果,因为当生产环境中,假如存在一台服务器没有该安装包,那么次处就能帮我们安装上去,不然的话,漏了这一步,到后面查原因也挺麻烦的 检查语法问题 先从一台主机上面把httpd.conf文件拷问来编辑 修改httpd.conf文件 比如修改端口为8080,其他都为默认配置 首先备份好各自主机里面的配置文件,以防后面出错 检查备份是否成功 测试运行web.yml,看看有没有问题,没有问题的话就正常运行 执行改文件 验证服务器端口打开没有,可以看见8080端口已经打开,实验成功。 Handlers的使用:由特定条件触发的Tasks; 格式: tasks: - name: TASK_NAME module: arguments notify: HANDLER_NAME handlers: - name: HANDLER_NAME module: arguments 示例:参照上面的例子继续修改apache的端口 修改端口号为8090 修改原来的web.yml脚本实现操作 检测语法 测试运行,可以看出,当复制文件过去的时候,会触发到restart httpd service的handlers任务,所以任务就重启了,而不是启动 正式运行 验证结果,8090端口已经打开,实验成功 tags:给指定的任务定义一个调用标识; 使用格式: - name: NAME module: arguments tags: TAG_ID 示例:执行特定的tags 修改文件的端口为8088 在此前的配置文件上面插入一个标签instconf 检查语法 此处可以查看到该yml脚本有一个标签,影响着websrvs组 测试运行 正式运行一下,指定以instconf的标签运行,所以此处不会显示器其他多余的信息,包括安装httpd包和启动httpd服务 验证该结果 此处也可以对同一个文件标记多个标签同时执行 测试运行,因为此处已经安装了httpd包和文件已经复制过去,所以都是绿色,此处就演示到这里,其他步骤可以参考上面的操作 Variables:变量 类型: 内建: (1) facts 自定义: (1) 命令行传递; -e VAR=VALUE (2) 在hosts Inventory中为每个主机定义专用变量值; (a) 向不同的主机传递不同的变量 ; IP/HOSTNAME variable_name=value (b) 向组内的所有主机传递相同的变量 ; [groupname:vars] variable_name=value (3) 在playbook中定义 vars: - var_name: value - var_name: value (4) Inventory还可以使用参数: 用于定义ansible远程连接目标主机时使用的属性,而非传递给playbook的变量; ansible_ssh_host ansible_ssh_port ansible_ssh_user ansible_ssh_pass ansible_sudo_pass ... (5) 在角色调用时传递 roles: - { role: ROLE_NAME, var: value, ...} 变量调用: ` var_name ` 示例1:利用命令行传递变量来安装不同的包 此处` pkgname `表示为一个变量 检查一下语法,居然报错了,什么情况?仔细看了即便发现是漏了空格 加上空格 再次检查,还是还是有报错的情况,各位不要慌,因为这只是因为还没有给变量赋值才会报的错,所以此处报错是很正常 给变量赋值再跑一遍,此时就不会报错 修改一下变量,发现也是正常的,此处68因为已经安装过vsftpd所以就不会执行,所以并不会changed 示例2:在playbook中定义变量 测试,也没有问题的 思考?假如同时利用-e的参数传递一个变量的参数的话会怎么样? 测试结果如下,是-e传递的变量参数的优先级更高,这样的话能避免传递参数的时候,因为文本里面定义的优先级更高而出错? 示例3:在hosts Inventory中为每个主机定义专用变量值 删除掉文档里面原有的变量 测试,没有问题 示例4:在hosts Inventory中为每个主机定义专用变量值的第二种方法 测试,也是可以的 Templates:模板,文本文件,内部嵌套有模板语言脚本(使用Jinja2模板语言编写) Jinja2 is a template engine written in pure Python. It provides a Django inspired non-XML syntax but supports inline expressions and an optional sandboxed environment. 语法: 字面量: 字符串:使用单引号或双引号; 数字:整数、浮点数; 列表:[item1, item2, ...] 元组:(item1, item2, ...) 字典:{key1:value1, key2:value2, ...} 布尔型:true/false 算术运算: +, -, *, /, //, %, ** 比较操作: ==, !=, >, <, >=, <= 逻辑运算:and, or, not 执行模板文件中的脚本,并生成结果数据流,需要使用template模块; template: -a " " src= dest= mode= onwer= group= 注意:此模板不能在命令行使用,而只能用于playbook; 示例:利用templates模板来设置nginx的定义cpu的数量 首先利用ansible命令获取当前系统系统的cpu数量 首先备份一下默认的文件 首先在下面的主机传送一个配置文件过来 编辑该文件,修改此处为上面利用ansible的setup模块获取的名称 重命名该文件为Jinja2格式后缀的文件 新建一个playbook文件,为了演示,建立一个ngxsrvs组,虽然看上去都一样。。。 建立playbook文档 此处为了演示效果,此处把原来的nginx包卸载掉 确认安装包卸载掉,并且服务没在线 检查playbook的文件有没语法错误 测试运行,此处报错是因为找不到nginx的服务,所以应该是没有问题的 正式运行,没有问题 查看一下端口是否已经打开 重点检查一下cpu的变量是否有改变,这里可以看到,跟我们ansible_processor_vcpus的值是一样,这样符合我们预期,此处就展示完毕 条件测试:when语句:在tasks中使用,Jinja2的语法格式; 示例:利用Ansible条件测试在CentOS_6和CentOS_7的启动服务 这边首先增加一台ip为10.1.156.70的CentOS7的主机 然后我们利用setup模块的命令 在7的上面可以找到该行 在6的上面可以找到该行 根据以上的信息,我们就可以创建一个基于条件判断的playbook文件test.yml 为了演示效果,实验前把CentOS6的nginx先卸载掉,此处70的报错只是因为ssh缺少那边没有提供公钥文件,此处就不再演示 检查playbook语法有没有问题 测试运行,没有报错,可以看出当执行service nginx start命令时候,只有CentOS6的主机执行了命令,不过开始那里提示有skipping信息是为什么?CentOS7开始也提示有skipping信息?但是后面确实是执行成功了,下面正式运行该playbook看看效果。 正式运行,似乎没有报什么错误 看看服务是否已经开启,此处可见80端口已经开发,应该是没有问题的,此处就不浏览主页做测试了 循环:迭代,需要重复执行的任务; 对迭代项的引用,固定变量名为"item”,使用with_item属性给定要迭代的元素; 元素:列表 字符串 字典 基于字符串列表给出元素示例: 示例:基于列表的方式安装多个安装包 检查语法 测试运行,没有报错(这里就以69和70两台不同的版本的CentOS来做测试) 正式运行,69的机器报错了,看了一下原因,是下载php-mbstring的时候出错了,此处原因应该是虚拟挂载CentOS6.8的cd1导致的,挂载cd2应该就解决此问题,不过部分安装包应该是在cd1里面,所以小伙伴们最好找一个安全包都全的yum仓库 重新配置好yum仓库,并且把先前安装的先卸载掉,以配置实验 此处可以看出来,由于69主机刚报错了一个,所以所有的包都没有安装,7上面倒是都已经安装过了 重新运行脚本,没有报错了 验证,发现已经安装上了,此处就不再看其他安装包的安装情况了,应该没有大问题 基于字典列表给元素示例: 示例:创建指定的用户并属于指定的组 检查语法 测试运行,没有提示有任何变化? 正式运行,可以看见创建了对应的用户和组 验证,符合我们预期 角色:roles 以特定的层级目录结构进行组织的tasks、variables、handlers、templates、files等; role_name/ files/:存储由copy或script等模块调用的文件; tasks/:此目录中至少应该有一个名为main.yml的文件,用于定义各task;其它的文件需要由main.yml进行“包含”调用; handlers/:此目录中至少应该有一个名为main.yml的文件,用于定义各handler;其它的文件需要由main.yml进行“包含”调用; vars/:此目录中至少应该有一个名为main.yml的文件,用于定义各variable;其它的文件需要由main.yml进行“包含”调用; templates/:存储由template模块调用的模板文本; meta/:此目录中至少应该有一个名为main.yml的文件,定义当前角色的特殊设定及其依赖关系;其它的文件需要由main.yml进行“包含”调用; default/:此目录中至少应该有一个名为main.yml的文件,用于设定默认变量; 在playbook中调用角色的方法: - hosts: HOSTS remote_user: USERNAME roles: - ROLE1 - ROLE2 - { role: ROLE3, VARIABLE: VALUE, ...} - { role: ROLE4, when: CONDITION } 示例:创建对应的服务目录下面的模版 首先创建对应的目录 确认一下目录是否正确 首先准备一个安装包,放到nginx/file/目录下面 新建一个nginx的task模板 大家可以发现此处的模板跟之前的不一样,比如说,开头没有了定义主机、用户、和task等,此处的task会自行查找/etc/ansible/roles/nginx/task/main.yml的任务(此处文件本身也是在task目录下面)。再比如说,该处指定的copy命令的src=FILENAME也是相对路径,其绝对路径为/etc/ansible/roles/nginx/file/FILENAME。又比如说定义了notify但是这里并没有handlers,是因为此处定义了的notify的名字会自行去查看该目录下面即/etc/ansible/roles/nginx/handlers/main.yml里面的handlers。还有template那里,大家有没发现也是用的相对路径,此处绝对路径为在/etc/ansible/roles/nginx/template/nginx.conf.j2。所以大家清楚了吗? 接着是定义/etc/ansible/roles/nginx/handlers/main.yml 此处的文件就是用来承上面的notify里面为什么没有定义的handlers的原因,因为已经定义在../handlers/main.yml里面了。 复制nginx.conf文件到templates目录下面为nginx.conf.j2 编辑里面定义的cpu数量,之前是2,所以此处我们也可以利用算数表达式来控制cpu的数量,比如此处-1,到时候看到的cpu数量应该是为1。 再复制/etc/nginx/conf.d/default.conf到nginx/templates/default.conf.j2 然后编辑此文件 编辑原来的端口号为一个变量值ngxport 此时需要重新编辑task/main.yml文件 主要添加一下内容 此时我们就可以定义变量文件了 比如说定义ngxport的变量为8888 此时所有的元素暂时都足够了,meta和default的文件夹在此处暂时用不上,然后我们在/etc/ansible/目录下面创建一个nginx.yml的文件 注意此处的roles里面的nginx要在/etc/ansible.cfg文件里面有对应的设定 编辑查看ansible.cfg文件 可以看见系统默认的roles路径也是在此处,所以我们去掉#号来启用它 修改成如下 以上都准备好了以后,检查一下nginx.yml语法,暂时并没有报错 然后测试运行,可以看见此处报错了,看了一下报错的原因,是因为找不到/tmp/nginx安装包,因为只是测试运行,并没有传送安装包到目标主机上面,所以此处报错是正常的可以不予理会。 下面正式运行该脚本,此处报错了,原因看了一下,nginx安装包是el7版本的,在centos6上面并不能安装。以及handlers出问题了。 此处修改一下tasks/main.yml,以下红色内容为修改部分,意思就是,CentOS7系统从远程复制的安装包安装,CentOS6则直接从yum仓库源安装,6和7的nginx的配置文件应该是一样的,暂时先这么操作实验看看结果,并且先把CentOS7系统的nginx安装包删除掉,以重新演示效果。notify处的语法错误,此处补上。 修改完以上的内容,重新测试运行 可以看出来此处还是有报错内容, 第一个报错内容为找不到安装包,此处是正常的,因为安装包还是传过去(上一次运行的时候传送过去的安装包我已经删掉了,所以此处需要重传) 第二个报错内容为找不到nginx服务,此处也是正常的,因为nginx安装包还没有安装 正常重新运行一下nginx.yml脚本看看,发现已经没有报错的地方了 验证结果,发现8888端口已经打开 cpu数量的设置也跟我们之前配置的是一样的,实验到此结束 示例2:根据以上内容,修改端口号 当我们写好模板以后,需要修改端口号,也是非常容易的,而且我们也可以通过在nginx.yml上面通过roles传递变量 例如像以下这样子操作 测试运行一下看看有没有错误,可以看见在复制配置文件和重启服务那里有了变化,这符合我们预期 正式运行一下看看,能正常运行 验证端口号是否修改成功,看到8080端口,表示操作没有问题 以上是运行成功了,但是细心的同学会发现,这样所有程序都跑一遍也麻烦,所以我们可以用之前了解到的标签来执行特定的操作即可,也可以直接传递相应的变量。 直接传递参数测试运行,好像没有问题 正式运行 查看端口号是否正确,此处可以看见是我们定义的8099端口,测试成功 示例:实现httpd不同主机不同的端口号 首先先把定义的端口号先屏蔽掉 编辑/etc/ansible/hosts文件 定义对应的端口号,然后测试 然后记得把nginx.yml文件里面也改回来 这里直接运行就不先做测试了,不过一般同学们还是做好测试工作比较好,本人比较懒O.O 验证端口号,也符合我们预期 示例:在同一个yml配置文件里面运行两个服务模板程序 这里以memcached为例,首先复制memcached的配置文件到对应的templates目录下来为.j2的文件 memcached服务是依靠设置内存参数来定义的,所以我们得首先用ansible来确认系统的内存变量参数值是什么,并且通过以下图可以看见两个系统参数都是一致的。 编辑memcached.j2文件 定义变量参数 改成 开始定义memcached的任务文件 定义handlers文件 把memcached定义在ngnix.yml文件一同运行 测试运行,只是安装包还没有安装,提示的错误都问题不大,是正常的 正式运行 验证服务是否开启,且是否设置好预期可用内存 可以看见11211端口已经打开 查看可用内存,原来的数值是970~980多,这里200多,符合除以4的预期效果 示例:根据不同的系统安装mysql包 首先定义一个tasks的模板 定义一个yaml调用角色脚本 设置hosts文件添加dbsrvs组 测试语法 测试运行调用角色脚本db.yml,应该没有大问题 正式运行,没有报任何错误 验证服务是否已经开启 可以看见mysql和mariadb服务均已经开启 写在最后,关于ansible的能最多控制几台主机此处是在配置文件里面定义的,默认是5台主机,如果把主机的控制的主机调大,估计也要相对应性能的主机当ansible服务器 至此,本博文已经完结,下面总结几个小点: 1、ansible的playbook.yml文件要求的格式比较严格,有时候少了几个空格,或者空格位置不妥当的时候,系统均默认此格式为错误,所以需要小心 2、有时候输入错了ansibile不能识别的错误,用- - syntax-check或者–check测试文件的时候并不会提示有任何提示,需要实际运行才能会报错。 3、有一次写playbook.yml文件的时候,检查过是没有问题,但是测试一直出问题,后来把所有重写一遍就好,也可能是哪里错了自己没看见。

优秀的个人博客,低调大师

运维人员的解放----Docker快速部署 推荐

Docker是一个用了一种新颖方式实现的超轻量虚拟机,在实现的原理和应用上还是和VM有巨大差别,专业的叫法是应用容器(Application Container)。(我个人还是喜欢称虚拟机) Docker应用容器相对于 VM 有以下几个优点: 启动速度快,容器通常在一秒内可以启动,而 VM 通常要更久 资源利用率高,一台普通PC 可以跑上千个容器,你跑上千个 VM 试试 性能开销小, VM 通常需要额外的 CPU 和内存来完成 OS 的功能,这一部分占据了额外的资源 因为VM 的 Hypervisor 需要实现对硬件的虚拟化,并且还要搭载自己的操作系统,自然在启动速度和资源利用率以及性能上有比较大的开销。 个人体会较深的两处优点: 1、 快速部署,传统的部署模式是:安装(包管理工具或者源码包编译)->配置->运行;Docker的部署模式是:复制->运行。 2、 可以保证线上与测试环境一致,计划以后上线就直接复制测试使用的docker容器) 什么是docker? http://oilbeater.com/docker/2014/06/29/what-is-docker.html 为什么你应该关注docker? http://oilbeater.com/docker/2014/06/13/why-you-should-care-about-docker.html 1、docker安装 debian7安装docker 参考地址:http://www.webmaster.me/server/installing-docker-on-debian-wheezy-in-60-seconds.html echo deb http://get.docker.io/ubuntu docker main | sudo tee/etc/apt/sources.list.d/docker.list sudo apt-key adv --keyserver keyserver.ubuntu.com --recv-keys 36A1D7869245C8950F966E92D8576A8BA88D21E9 sudo apt-get update sudo apt-get install -y lxc-docker #四行命令,Docker就安装好了。下面创建一个ubuntu虚拟系统: docker pull ubuntu #此处是从官网拉取名为ubuntu的image,也可手动在https://index.docker.io上搜索想要的镜像。 docker run -i -t ubuntu /bin/bash #创建一个容器,-t是临时终端。 ubuntu12.04、windows、macOS安装docker 参考docker中文文档http://www.widuu.com/docker/ 2、docker使用过程实践 2.1 在测试机启动容器,安装ssh docker run -i -t ubuntu /bin/bash #此方式运行的容器,退出后容器就会关闭。 apt-get install openssh-server #安装ssh #需要修改/etc/sshd/sshd_config文件中内容 PermitRootLogin yes UsePAM no 2.2 启动ssh,容器以后台方式运行 docker run -d -p 50001:22 <镜像id> /usr/sbin/sshd-D #容器id可通过 docker ps -a查看,最上面的为最新的。 2.3 通过ssh连接到容器安装软件 ssh root@127.0.0.1-p 50001 #连上后想装什么就装什么,可使用exit退出容器,但后台还会运行。 2.4 服务安装完成后,停止容器。 docker stop <容器id> #停止运行的容器 2.5 把容器提交生成最新的镜像 docker commit <容器id> debian02#把这个容器提交生成新的debian02镜像(该镜像是原始镜像与容器的整合) 2.6 打包镜像 docker save debian02 >/root/debian02.tar #debian02镜像打包 2.7 在另外的机器上导入镜像 docker load < debian02.tar #导入镜像 docker images #查看存在的镜像 2.8 启动容器 docker run -h="redis-test" --name redis-test -d -p 51000:22 -p51001:3306 -p 51003:6379 -p 51004:6381-p 51005:80 -p 51006:8000 -p 51007:8888debian02 /etc/rc.local #此处是我测试机器启动命令,指定主机名与端口映射。 #启动后,后面又装了程序,开机自启动命令可放在/etc/rc.local文件中。 docker容器迁移简单方便,可以任意的拷贝部署,以后再也不怕新部署环境了,一堆依赖装的想死有木有。 3、关于docker容器的端口映射 由于docker容器的IP地址每次启动都会变,所以不适用于手动添加端口映射(难道每次重启都来查看容器的IP么?),所以需要每次启动容器时由docker程序自动添加NAT规则,前期尽可能的把需要映射的端口在创建容器时配置好,如下: docker run -h="activemq" --name activemq -d -p 51000:22 -p 51001:3306-p 51003:6379 -p 51004:6381 -p 51005:80-p 51006:8000 -p 51007:8888 debian/base/etc/rc.local #此处我把mysql,redis,nginx,ssh都进行了映射。 后续对于docker容器的管理,记住容器的名称,如上述名称是activemq,则使用docker stop,start来控制容器进程。 dockerstop activemq docker start activemq 当然,也可以不让docker每次启动容器修改容器的IP地址,参考如下: docker网络配置:http://www.open-open.com/lib/view/open1404896485747.html 4、关于docker容器的多程序开机自动运行 docker容器每次启动时,开机自启动的命令都要在启动容器前指定。如 docker run -I -t debian /bin/bash命令,只会运行/bin/bash程序,其它的程序都不会运行,对于要跑多个程序的容器特别纠结。 多程序开机自动运行方法: 可把前面所说的启动命令换成dockerrun -I -t debian /etc/rc.local,在容器中把所有需要开机自的启动命令放在/etc/rc.local中,就可以达到多程序开机自启动了。 后台运行则是:docker run -d -p 50001:22 debian /etc/rc.local。注意:run命令是创建一个新的容器,如果要启动一个曾经运行过的容器,则用命令docker ps -a中找对应的容器ID,然后使用docker start <容器ID>即可。 5、关于docker容器和镜像的关系 无论容器里做什么操作,写文件,删文件。该容器的基本镜像都不会有任何改变。 这是因为Docker从父镜像建立增量镜像,只存储每个容器的更改。因此,如果你有一个300MB的父镜像,如果你在容器中安装了50MB的额外应用或服务,你的容器只有50MB,父镜像还是300MB。 但是可以使用Dockfile或commit命令来,把增量镜像和父镜像一起生成一个新的镜像。 commit使用: docker commit <容器id> <新镜像名称> Dockfile使用: root@yangrong:/data# cat Dockerfile FROMubuntu/testa #这是基础镜像 CMD["/root/start.sh"] #这是启动命令 root@yangrong:/data# docker build -t <新镜像名> ./ 关于Dockfile更多参数参考地址: http://www.tuicool.com/articles/FRvAbe http://www.colorscode.net/2014/01/04/howto-build-image-with-automatic-startup-ssh-service-from-dockerfile/ 6、docker参数详解 docker useage of docker -D 默认false 允许调试模式(debugmode) -H 默认是unix:///var/run/docker.sock tcp://[host[:port]]来绑定 或者unix://[/path/to/socket]来使用(二进制文件的时候),当主机ip host=[0.0.0.0],(端口)port=[4243] 或者 path=[/var/run/docker.sock]是缺省值,做为默认值来使用 -api-enable-cors 默认flase 允许CORS header远程api -b 默认是空,附加在已存在的网桥上,如果是用'none'参数,就禁用了容器的网络 -bip 默认是空,使用提供的CIDR(ClasslessInter-Domain Routing-无类型域间选路)标记地址动态创建网桥(dcoker0),和-b参数冲突 -d 默认false 允许进程模式(daemonmode) -dns 默认是空,使docker使用指定的DNS服务器 -g 默认是"/var/lib/docker":作为docker使用的根路径 -icc 默认true,允许inter-container来通信 -ip 默认"0.0.0.0":绑定容器端口的默认Ip地址 -iptables 默认true 禁用docker添加iptables规则 -mtu 默认1500 : 设置容器网络传输的最大单元(mtu) -p 默认是/var/run/docker.pid进程pid使用的文件路径 -r 默认是true 重启之前运行的容器 -s 默认是空 ,这个是docker运行是使用一个指定的存储驱动器 -v 默认false 打印版本信息和退出 7、docker run命令详解 Usage: docker run [OPTIONS] IMAGE[:TAG] [COMMAND] [ARG...] Run a command in a new container -a=map[]: 附加标准输入、输出或者错误输出 -c=0: 共享CPU格式(相对重要) -cidfile="": 将容器的ID标识写入文件 -d=false: 分离模式,在后台运行容器,并且打印出容器ID -e=[]:设置环境变量 -h="": 容器的主机名称 -i=false: 保持输入流开放即使没有附加输入流 -privileged=false: 给容器扩展的权限 -m="": 内存限制 (格式:<number><optional unit>, unit单位 = b, k, m or g) -n=true: 允许镜像使用网络 -p=[]: 匹配镜像内的网络端口号 -rm=false:当容器退出时自动删除容器 (不能跟 -d一起使用) -t=false: 分配一个伪造的终端输入 -u="": 用户名或者ID -dns=[]: 自定义容器的DNS服务器 -v=[]: 创建一个挂载绑定:[host-dir]:[container-dir]:[rw|ro].如果容器目录丢失,docker会创建一个新的卷 -volumes-from="": 挂载容器所有的卷 -entrypoint="": 覆盖镜像设置默认的入口点 -w="": 工作目录内的容器 -lxc-conf=[]: 添加自定义-lxc-conf="lxc.cgroup.cpuset.cpus = 0,1" -sig-proxy=true: 代理接收所有进程信号(even in non-tty mode) -expose=[]: 让你主机没有开放的端口 -link="": 连接到另一个容器(name:alias) -name="": 分配容器的名称,如果没有指定就会随机生成一个 -P=false: Publish all exposed ports to thehost interfaces 公布所有显示的端口主机接口 8、docker常用命令总结 docker pull <镜像名:tag> #从官网拉取镜像 docker search <镜像名> #搜索在线可用镜像名 8.1查询容器、镜像、日志 docker top <container> #显示容器内运行的进程 docker images #查询所有的镜像,默认是最近创建的排在最上。 docker ps#查看正在运行的容器 docker ps -l #查看最后退出的容器的ID docker ps -a #查看所有的容器,包括退出的。 docker logs {容器ID|容器名称} #查询某个容器的所有操作记录。 docker logs -f {容器ID|容器名称} #实时查看容易的操作记录。 8.2删除容器与镜像 docker rm$(docker ps -a -q) #删除所有容器 docker rm <容器名or ID> #删除单个容器 docker rmi <ID> #删除单个镜像 docker rmi$(docker images | grep none | awk '{print $3}' | sort -r)#删除所有镜像 8.3启动停止容器 docker stop <容器名or ID> #停止某个容器 docker start <容器名or ID> #启动某个容器 docker kill <容器名or ID> #杀掉某个容器 8.4容器迁器 docker export <CONTAINER ID> > /home/export.tar #导出 cat /home/export.tar | sudo docker import - busybox-1-export:latest # 导入export.tar文件 docker save debian> /home/save.tar #将debian容器打包 docker load< /home/save.tar #在另一台服务器上加载打包文件 save和export的对比参考地址: http://www.fanli7.net/a/bianchengyuyan/C__/20140423/452256.html 8.5运行一个新容器 #运行一个新容器,同时为它命名、端口映射。以debian02镜像为例 docker run -h="redis-test" --name redis-test -d -p 51000:22 -p51001:3306 -p 51003:6379 -p 51004:6381-p 51005:80 -p 51006:8000 -p 51007:8888debian02 /etc/rc.local #从container中拷贝文件,当container已经关闭后,在里面的文件还可以拷贝出来。 sudo docker cp 7bb0e258aefe:/etc/debian_version . #把容器中的/etc/debian_version拷贝到当前目录下。 8.6 docker Dockfile镜像制作 root@yangrong:/data# cat Dockerfile FROM ubuntu/testa #这是基础镜像 CMD ["/root/start.sh"]#这是启动命令 root@yangrong:/data# docker build -t <新镜像名> ./ #生成新的镜像 Dockfile更多参数参考: http://www.tuicool.com/articles/FRvAbe http://www.colorscode.net/2014/01/04/howto-build-image-with-automatic-startup-ssh-service-from-dockerfile/ <完> 如果要把docker应用到生产环境,就要好好的规划一下,可参考下面文章: docker容器端口IP规划及端口动态扩容 http://yangrong.blog.51cto.com/6945369/1582184

优秀的个人博客,低调大师

“不是不需要运维工程师,是人人皆是运维”|对话阿里云MVP蒋烁淼(上)

【三位阿里云MVP(驻云CEO、首席架构师、大数据总监)《MVP时间》首次同台授课,“湖畔第一大脑” 蒋烁淼领头线上精讲,内容涉及企业IT架构、混合云存储、大数据方案等实战内容,从技术实战到解决方案,难题痛点一次解透。听课链接直戳:第一节:云时代企业IT智能诊断实践与探索第二节:企业IT架构云化转型挑战与应对第三节:混合云场景下存储实践精讲第四节:云管理服务技术要点和实践精讲第五节:混合云大数据实践精讲】 阿里云MVP、驻云科技CEO蒋烁淼4月11日做客《MVP时间》,为大家分析在云时代对于企业IT智能诊断的实践与探索。本篇为上期,下期文档直戳 1、 云时代的大背景屈指算来,云计算已经进入了第二个十年。随着下一代技术如数字业务、物联网和人工智能的实现,云计算已然是业务和IT的关键组成部分。云技术正在从一个市场颠覆者演变为传统和下

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册