首页 文章 精选 留言 我的

精选列表

搜索[磐石100],共10000篇文章
优秀的个人博客,低调大师

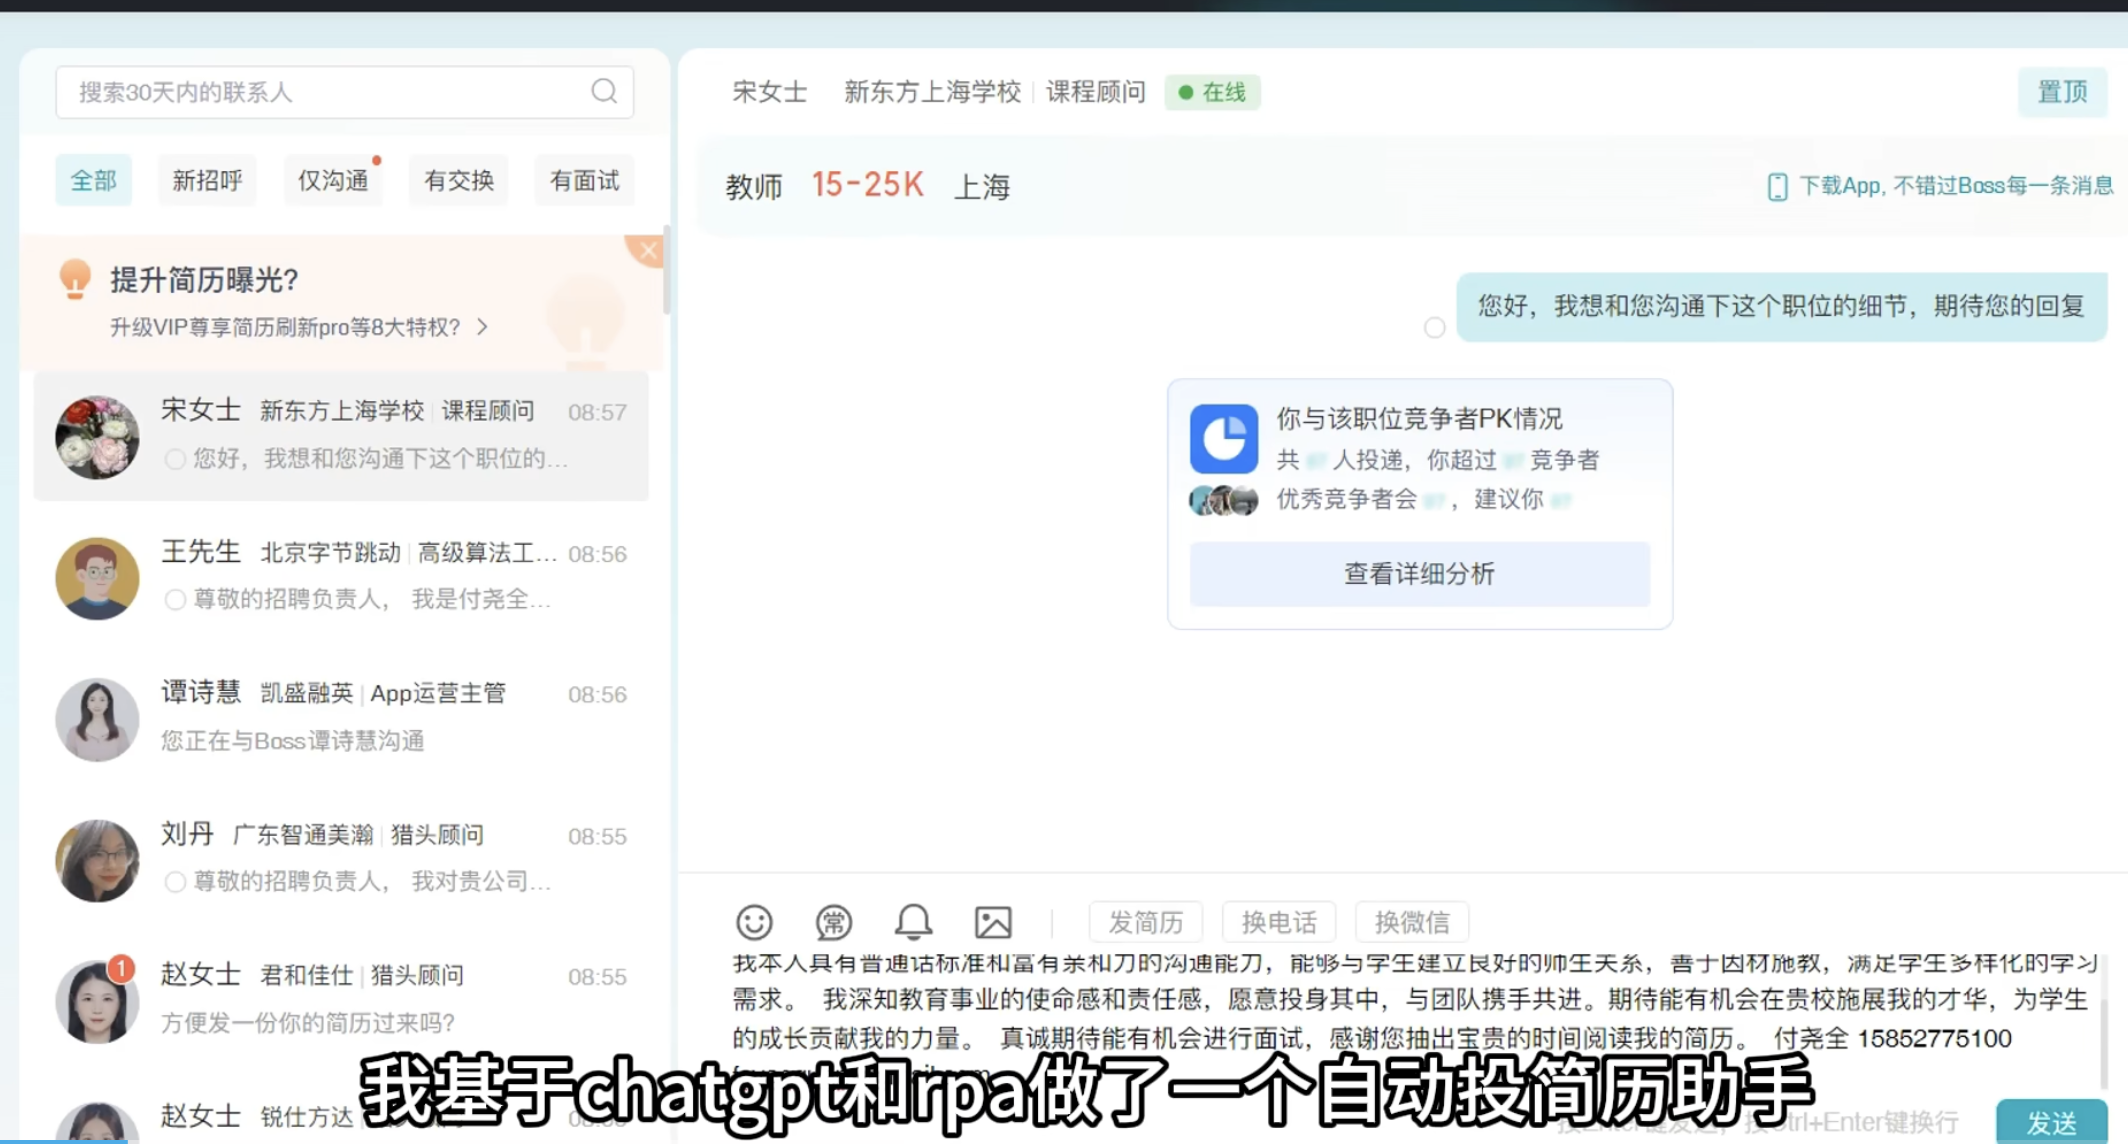
程序员用 AI 自动投简历,极速刷满每天上限 100

介绍一个用 AI 自动投递简历的开源项目,作者表示这个项目结合了 ChatGPT 与 RPA 技术,实现一键自动寻找工作、根据自己的简历和工作描述生成求职信、发送给 HR 的全流程自动操作。 主要流程: 读取招聘平台的招聘信息 结合招聘信息的职位要求和自身简历,写一封求职信并发送给 HR 自动优化投递时的自我介绍 生成真挚的求职信发送给 HR 源代码地址:https://github.com/Frrrrrrrrank/auto_job__find__chatgpt__rpa

优秀的个人博客,低调大师

Python爬虫入门教程 36-100 酷安网全站应用爬虫 scrapy

爬前叨叨 2018年就要结束了,还有4天,就要开始写2019年的教程了,没啥感动的,一年就这么过去了,今天要爬取一个网站叫做酷安,是一个应用商店,大家可以尝试从手机APP爬取,不过爬取APP的博客,我打算在50篇博客之后在写,所以现在就放一放啦~~~ 酷安网站打开首页之后是一个广告页面,点击头部的应用即可 页面分析 分页地址找到,这样就可以构建全部页面信息 我们想要保存的数据找到,用来后续的数据分析 上述信息都是我们需要的信息,接下来,只需要爬取即可,本篇文章使用的还是scrapy,所有的代码都会在文章中出现,阅读全文之后,你就拥有完整的代码啦 import scrapy from apps.items import AppsItem # 导入item类 import re # 导入正则表达式类 class AppsSpider(scr

优秀的个人博客,低调大师

Python爬虫入门教程 35-100 知乎网全站用户爬虫 scrapy

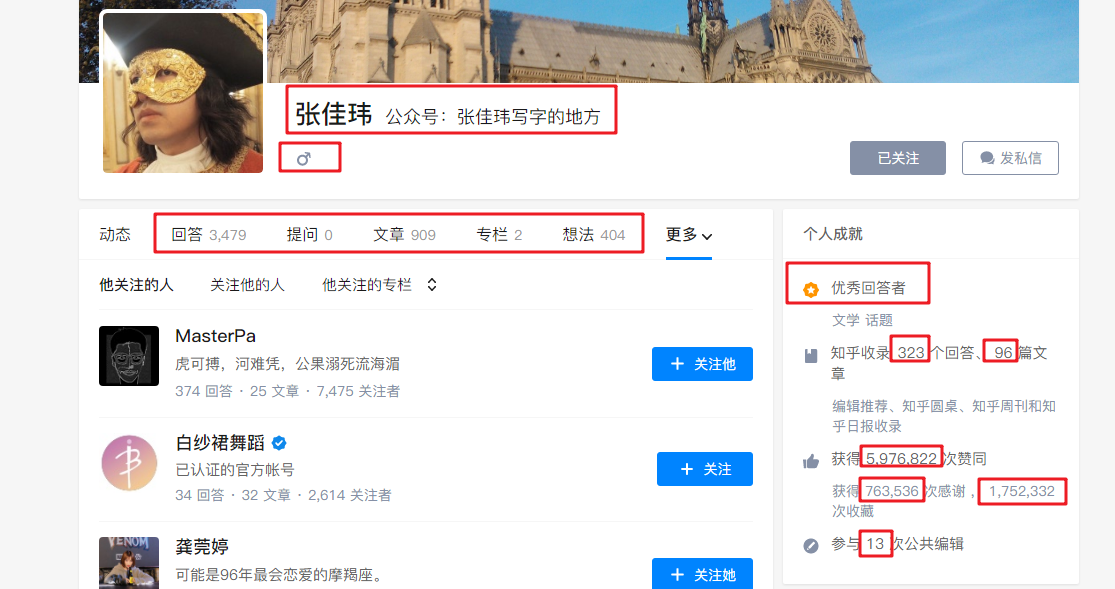
爬前叨叨 全站爬虫有时候做起来其实比较容易,因为规则相对容易建立起来,只需要做好反爬就可以了,今天咱们爬取知乎。继续使用scrapy当然对于这个小需求来说,使用scrapy确实用了牛刀,不过毕竟本博客这个系列到这个阶段需要不断使用scrapy进行过度,so,我写了一会就写完了。 你第一步找一个爬取种子,算作爬虫入口 https://www.zhihu.com/people/zhang-jia-wei/following 我们需要的信息如下,所有的框图都是我们需要的信息。 获取用户关注名单 通过如下代码获取网页返回数据,会发现数据是由HTML+JSON拼接而成,增加了很多解析成本 class ZhihuSpider(scrapy.Spider): name = 'Zhihu' allowed_domains = ['www.zhi

优秀的个人博客,低调大师

Python爬虫入门教程 28-100 虎嗅网文章数据抓取 pyspider

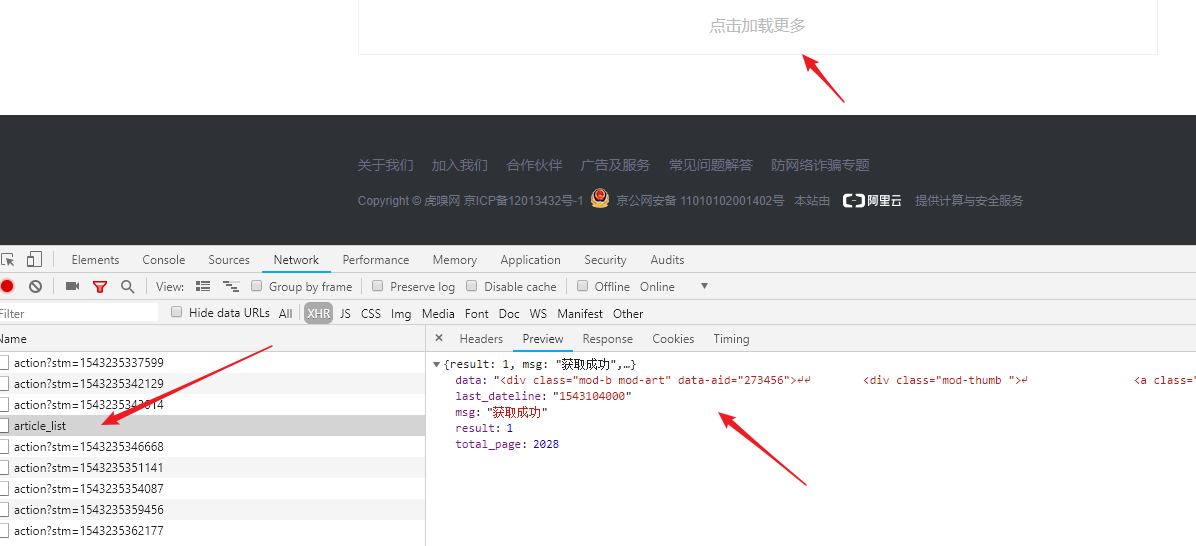
1. 虎嗅网文章数据----写在前面 今天继续使用pyspider爬取数据,很不幸,虎嗅资讯网被我选中了,网址为 https://www.huxiu.com/ 爬的就是它的资讯频道,本文章仅供学习交流使用,切勿用作其他用途。 常规操作,分析待爬取的页面 拖拽页面到最底部,会发现一个加载更多按钮,点击之后,抓取一下请求,得到如下地址 2. 虎嗅网文章数据----分析请求 查阅该请求的方式和地址,包括参数,如下图所示 得到以下信息 页面请求地址为:https://www.huxiu.com/v2_action/article_list 请求方式:POST 请求参数比较重要的是一个叫做page的参数 我们只需要按照上面的内容,把pyspider代码部分编写完毕即可。on_start 函数内部编写循环事件,注意到有个数字2025这个数字,是我从刚才那个请求中

优秀的个人博客,低调大师

Python爬虫入门教程 24-100 微医挂号网医生数据抓取

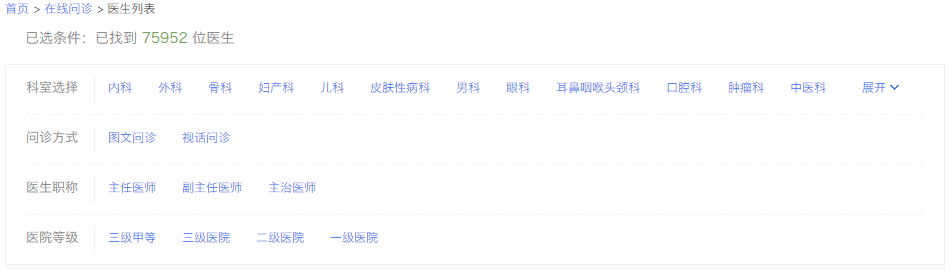
1. 微医挂号网医生数据写在前面 今天要抓取的一个网站叫做微医网站,地址为 https://www.guahao.com ,我们将通过python3爬虫抓取这个网址,然后数据存储到CSV里面,为后面的一些分析类的教程做准备。本篇文章主要使用的库为pyppeteer 和 pyquery 首先找到 医生列表页 https://www.guahao.com/expert/all/全国/all/不限/p5 这个页面显示有 75952 条数据 ,实际测试中,翻页到第38页,数据就加载不出来了,目测后台程序猿没有把数据返回,不过为了学习,我们忍了。 2. 微医挂号网医生数据页面URL https://www.guahao.com/expert/all/全国/all/不限/p1 https://www.guahao.com/expert/all/

优秀的个人博客,低调大师

Python爬虫入门教程 23-100 石家庄链家租房数据抓取

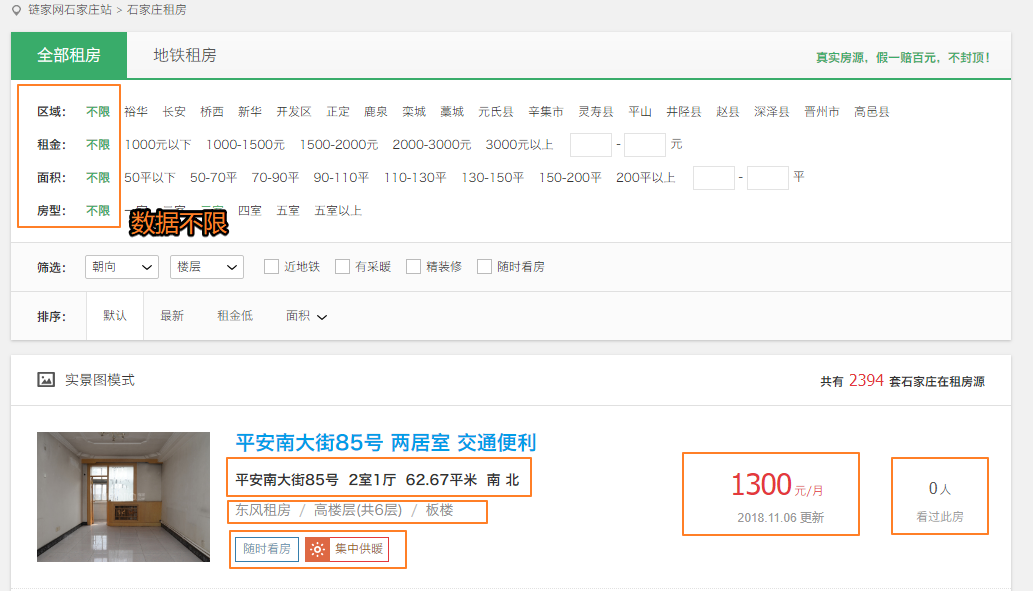
1. 石家庄链家租房数据-写在前面 作为一个活跃在京津冀地区的开发者,要闲着没事就看看石家庄这个国际化大都市的一些数据,这篇博客爬取了链家网的租房信息,爬取到的数据在后面的博客中可以作为一些数据分析的素材。我们需要爬取的网址为:https://sjz.lianjia.com/zufang/ 2. 石家庄链家租房数据-分析网址 首先确定一下,哪些数据是我们需要的 可以看到,黄色框就是我们需要的数据。 接下来,确定一下翻页规律 https://sjz.lianjia.com/zufang/pg1/ https://sjz.lianjia.com/zufang/pg2/ https://sjz.lianjia.com/zufang/pg3/ https://sjz.lianjia.com/zufang/pg4/ https://sjz.lianji

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册