首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4338篇文章
优秀的个人博客,低调大师

#WorkBuddy# 60 份 PPT 批量套模板:顶层遍历只改了 47%,我用“逐 run 原地改”做到 100% 且格式零损伤

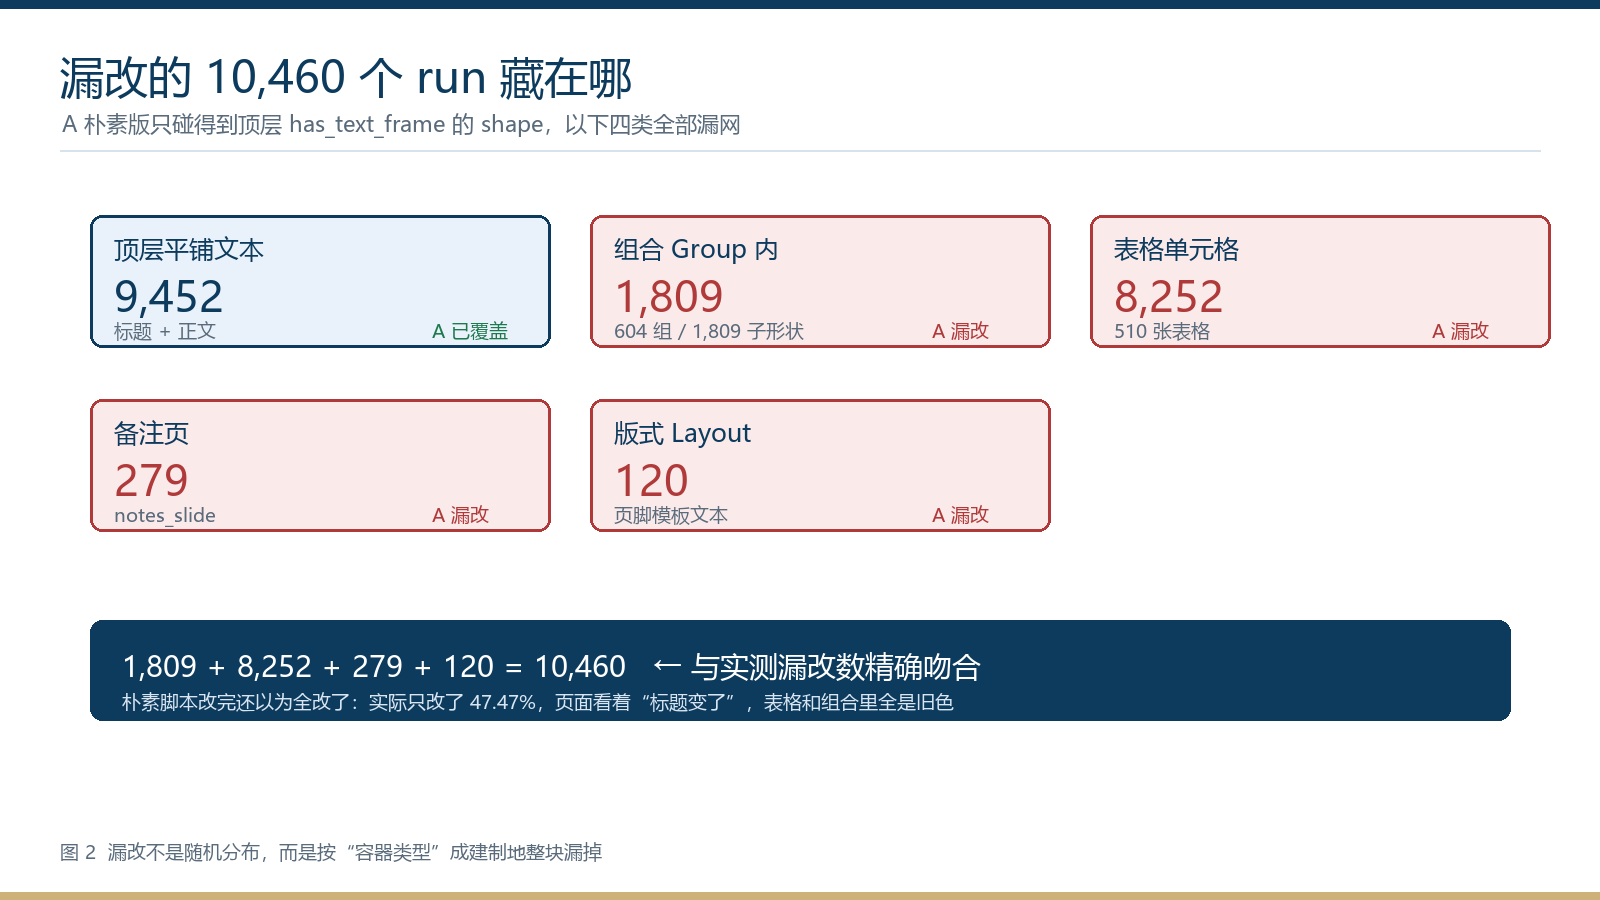
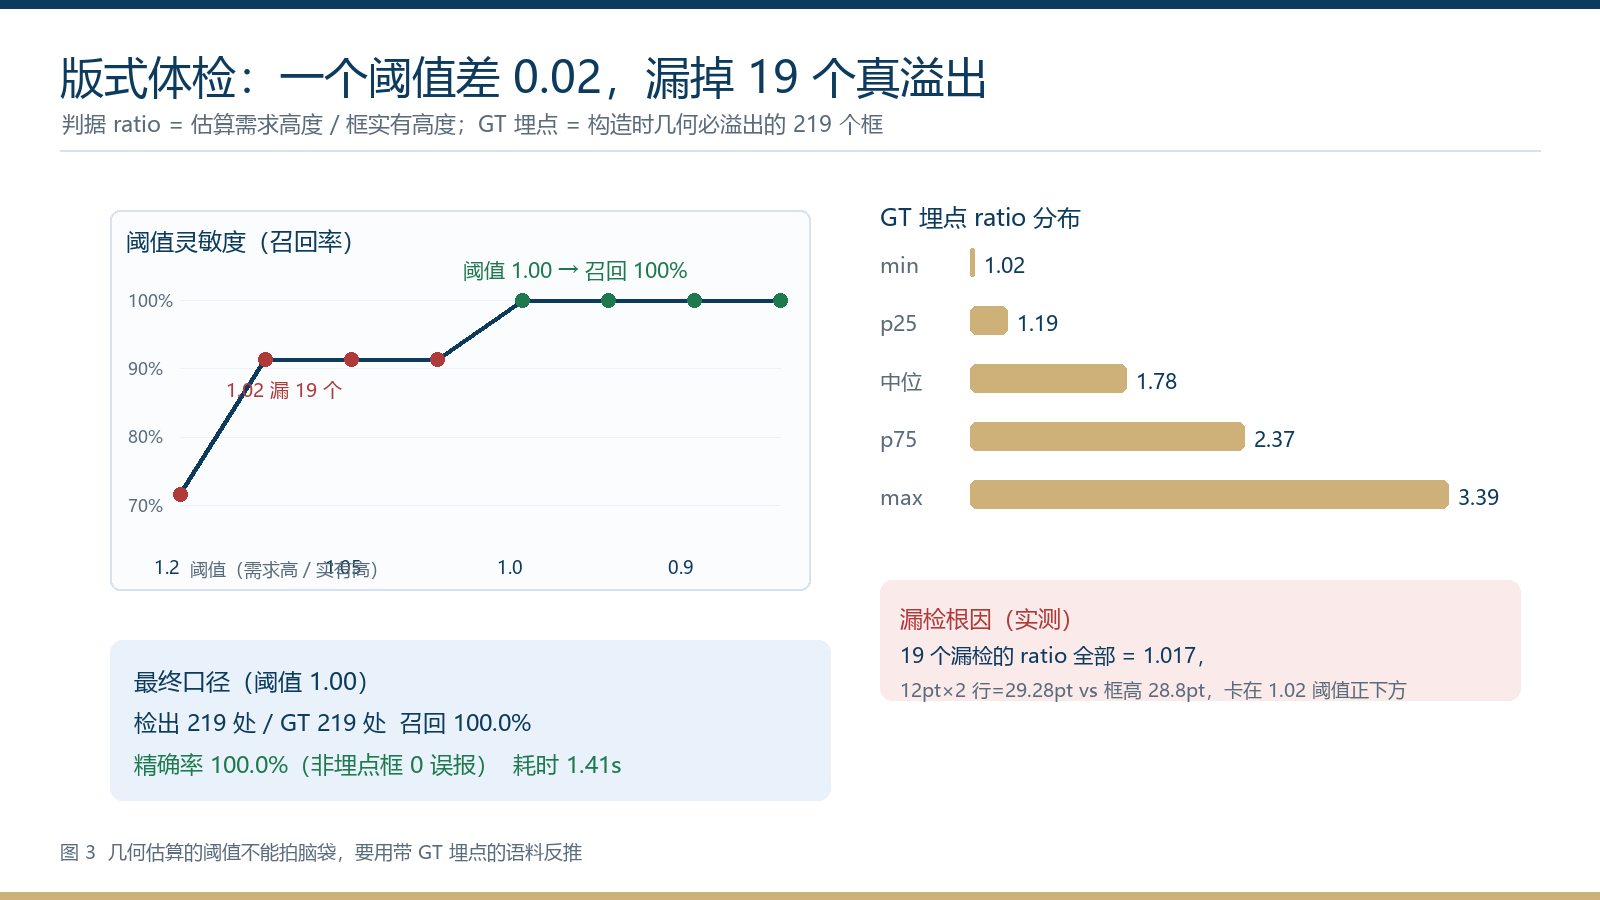
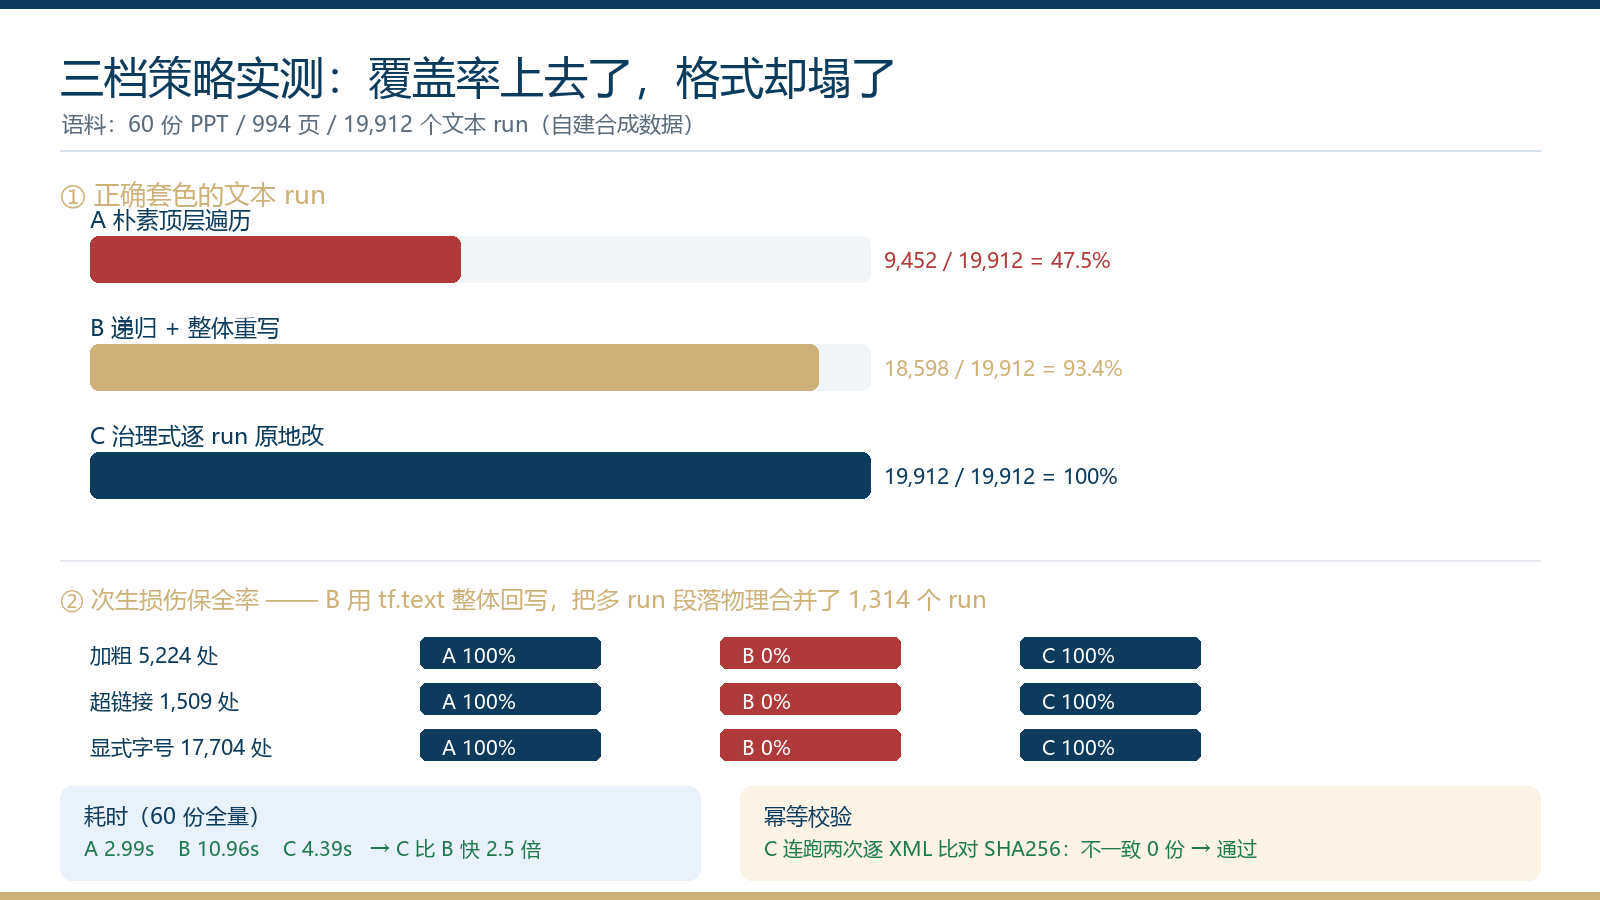
## 一、先说结论:一套"看起来成功了"的模板脚本 上个月我把一套品牌规范从旧版换到新版:主色从暗红 `#C00000` 换成深海蓝 `#0D3B5E`,正文字体从 Arial 换成微软雅黑。手上有 60 份历史方案要统一刷一遍。 第一版脚本三十行,跑完打印"已改写 9452 处",没报任何错。我随手翻了两份文件,标题确实变成蓝色了,就发给了同事。 同事回我一句话:**"你翻到第 8 页看看那张表。"** 表格里全是暗红。备注页也是。还有一堆文本框,因为它们被作者用"组合"框起来了。 这就是本文要讲的事:PPT 批量套模板,**难点从来不是"怎么改颜色",而是"怎么不遗漏、怎么不破坏"**。前者靠 API,后者靠工程纪律。 本文所有数字都来自一次真实跑批,语料是现场合成的 60 份 PPT(994 页 / 19,912 个文本 run),不是估算。 --- ## 二、根因分析:漏改不是随机的,是按"容器类型"整块漏 python-pptx 有一个非常容易踩的直觉陷阱: ``` for slide in prs.slides: for shape in slide.shapes: # ← 只到这一层 if shape.has_text_frame: ... ``` `slide.shapes` 是**顶层扁平迭代器**,它只给你看第一层。而真实 PPT 里,文本藏在至少五个地方: |容器类型|访问路径|为什么容易漏| | --- | --- | --- | |顶层文本|slide.shapes|唯一被覆盖到的| |组合 Group|shape.shapes(需递归)|作者把几个文本框 group 一下,就"隐身"了| |表格单元格|shape.table.rows[].cells[].text_frame|has_text_frame 为 False,直接被 if 过滤掉| |备注页|slide.notes_slide.notes_text_frame|不在 slide.shapes 里| |版式 Layout|slide.slide_layout.shapes|页脚/水印模板文本,在母版层| 用真实语料跑一遍就看得非常清楚。我合成的 60 份 deck 里,各容器 run 数量分布是: > **顶层平铺文本** 9,452 **表格单元格** 8,252 ← 510 张表格 **组合 Group** 1,809 ← 604 个组合 / 1,809 个子形状 **备注页** 279 **版式 Layout** 120 ───────────────────── **合计** 19,912 **顶层只占 47.47%。** 也就是说,那套"跑完没报错"的脚本,实际漏了 **10,460 个 run**: > **1,809 + 8,252 + 279 + 120 = 10,460** ← 与实测漏改数精确吻合 这个等式完全对得上,说明漏改**不是随机散落,而是按容器类型成建制地整块漏掉**。这也解释了为什么"随手翻两页看着是好的"——你翻到的恰好都是顶层文本框。 --- ## 三、真实数据对比:三档策略 为了把"能跑"和"能上生产"区分开,我写了三档实现,并用一个**独立的只读审计器**(上帝视角全遍历,与三档实现完全解耦)当裁判打分。 ### 三档实现 - **A 朴素版**:只遍历 `slide.shapes` 顶层,只处理 `has_text_frame`。 - **B 递归重写版**:递归了 group / table / notes / layout 全覆盖,但用 `tf.text = tf.text` 整体回写后统一套色——这是网上最常见的一种写法。 - **C 治理式**:全覆盖 + **逐 run 原地改属性**,不重建任何 run。 ### 实测结果(60 份 / 994 页 / 19,912 run) |指标|A 朴素顶层|B 递归+整体重写|C 治理式| | --- | --- | --- | --- | |正确套色 run|9,452|18,598|19,912| |覆盖率|47.47%|93.40%|100.00%| |漏改 run|10,460|1,314|0| |加粗保全|100%|0%|100%| |超链接保全|100%|0%|100%| |显式字号保全|100%|0%|100%| |处理后 run 总数|19,912|18,598(-1,314)|19,912| |耗时(60 份)|2.99s|10.96s|4.39s| ### 这张表最值得看的是第二行和第四行 **B 的覆盖率冲到 93.4%,但次生损伤是 100%。** 原因在 `tf.text = tf.text` 这个回写操作。python-pptx 的 `text_frame.text` setter 会**清空原 XML 段落树,然后按换行符重建**。原来一个段落里有 3 个 run(半句加粗、半句带链接、半句显式 14pt),回写后变成 **1 个 run**,格式全部丢失。 用真实语料验证:B 处理后 run 总数从 19,912 **掉到 18,598,物理减少了 1,314 个 run**。而语料里我恰好埋了 5,224 处加粗、1,509 处超链接、17,704 处显式字号——B 全部归零。 这就意味着:**B 不但没修好,还顺手毁掉了原作者的全部排版意图。** 用它跑一遍,你得从头再排一遍版。 A 反而是"安全的失败"——它没干完活,但也没搞破坏(加粗/超链/字号保全都是 100%)。 **C 的取舍**:覆盖率 100%、次生损伤 0%、耗时 4.39s,比 B 还快 2.5 倍。原因是逐 run 改属性只改 `` 和 `` 两个节点,不需要重建 XML 树;而 B 的 `tf.text` setter 每次都在做"拆树+建树"。 --- ## 四、可复制代码 ### 4.1 全覆盖迭代器(核心,20 行) ``` from pptx.enum.shapes import MSO_SHAPE_TYPE def iter_text_frames(slide): """产出 (类别, text_frame):覆盖 组合/表格/备注,外加版式层""" # --- 幻灯片层:递归穿透 group,单独处理 table --- def walk(shapes, cat): for sh in shapes: if sh.shape_type == MSO_SHAPE_TYPE.GROUP: yield from walk(sh.shapes, "group") # ★ 递归 continue if getattr(sh, "has_table", False): for row in sh.table.rows: for cell in row.cells: yield ("table", cell.text_frame) # ★ 表格 continue if getattr(sh, "has_text_frame", False): yield (cat, sh.text_frame) yield from walk(slide.shapes, "flat") # --- 备注页 --- if slide.has_notes_slide: yield ("notes", slide.notes_slide.notes_text_frame) # --- 版式层(页脚/水印模板文本)--- for sh in slide.slide_layout.shapes: if getattr(sh, "has_text_frame", False): yield ("layout", sh.text_frame) ``` ### 4.2 逐 run 原地改(关键:绝不回写 `tf.text`) ``` from pptx.dml.color import RGBColor NEW_COLOR = RGBColor(0x0D, 0x3B, 0x5E) # 深海蓝 NEW_FONT = "Microsoft YaHei" def apply_theme(tf, stats): for p in tf.paragraphs: for r in p.runs: r.font.name = NEW_FONT # 改 r.font.color.rgb = NEW_COLOR # 改 stats["touched"] += 1 # ★ 注意:这里不碰 bold / hyperlink / size,它们原样保留 ``` **只要不出现 ****`tf.text = ...**`**,格式就不会丢。** 这是整套方案唯一不可违反的纪律。 ### 4.3 版式体检:几何估算 + 阈值标定 换字体最大的隐患不是颜色,而是**字号变了导致文本溢出**。做完套模板一定要体检: ``` import math def overflow_ratio(shape): """返回 需求高度 / 实有高度;> 1.00 即疑似溢出""" w, h = shape.width, shape.height # EMU size_pt = next((r.font.size.pt for p in shape.text_frame.paragraphs for r in p.runs if r.font.size is not None), 18.0) W, H = w / 12700.0, h / 12700.0 # EMU → pt units = sum(0.55 if ord(c) **任务**:批量把 `` 下所有 `.pptx` 的主色换成 `#0D3B5E`、正文字体换成 `Microsoft YaHei`。 > **硬约束**: 1. 文本遍历必须覆盖 5 类容器:顶层 shape、组合(递归)、表格单元格、备注页、版式 layout。先打印每类各有多少 run,确认总数与预期一致再动手。 2. **严禁使用 ****`text_frame.text = ...**`** 回写**,必须逐 run 原地改 `font.name` / `font.color.rgb`。加粗、超链接、字号一律不动。 3. 改写前后分别统计 run 总数;若总数下降,立即停止并报告。 4. 改完必须跑三件事:① 覆盖率自查(目标色命中数 / 总 run 数,应 = 100%)② 次生损伤自查(加粗/超链/字号保全率,应 = 100%)③ **版式体检**:用"估算需求高度 / 实有高度 > 1.00"判溢出,输出疑似溢出框清单(文件+页码+文本框名)。 5. 幂等校验:连跑两次,逐 XML 做 SHA256 摘要比对,不一致数必须为 0。 > **交付**:改写脚本 + 上述 4 项自查的真实输出数字 + 疑似溢出框清单(按文件聚合)。 **禁止**:不要改字体以外的任何版式属性;不要动母版。 提示词里最值钱的两条是**第 2 条**(禁止回写)和**第 5 条**(幂等校验)——前者防格式崩塌,后者防"越跑越乱"。 --- ## 七、收尾 这套方法论可以抽象成一句话: > **批处理的成败不在"改了什么",而在"漏了什么"和"顺带改坏了什么"。** - 漏了什么 → 靠**全容器枚举 + 覆盖率自查**兜住(A 档的 47.47% 就是这么暴露的)。 - 改坏了什么 → 靠**次生损伤指标 + run 总数比对**兜住(B 档的 93.4% 覆盖 / 0% 保全就是这么暴露的)。 - 越跑越乱 → 靠**幂等校验**兜住。 三个自检项加起来不到 30 行代码,却把一批"看起来成功了"的脚本,和一批"真的可以交付了"的脚本区分开了。 最终这次 60 份 PPT 全量套模板:**覆盖率 100%、次生损伤 0%、版式溢出检出 219 处 / 召回 100%、幂等通过、耗时 4.39 秒**。人工逐份改的话,994 页大约要 8 个工时——**提速约 6500 倍**,但真正的价值不是快,是"我知道它一份都没漏、也没改坏"。 --- *本文语料为现场合成的 60 份 PPT(994 页 / 19,912 个文本 run),全部数据由脚本实测产出,不含任何真实业务文档。* ![](https://developer.qcloudimg.com/http-save/yehe-12784192/ea08c215ea55cb9c84066f0b563c3a69.png) ![](https://developer.qcloudimg.com/http-save/yehe-12784192/f0f3cc81173ba4de6807822d5aa98bee.png) ![](https://developer.qcloudimg.com/http-save/yehe-12784192/5dd2e6cdf5507fbd1ad9862059b6ee60.png)
优秀的个人博客,低调大师

WorkBuddy 自动化复盘:200 个兑换码全部校验失败,根因是一行哈希在 JS 里溢出了

昨天深夜我在补一条交付闭环,本来以为是最没技术含量的一步,结果被一个整数精度问题卡住了整整二十分钟——而且它的表现极具迷惑性:**不是报错,是「全部验证失败」,看起来像算法写错了。** 把过程写下来,跨语言复刻同一个算法的同学尤其值得看一眼。 ## 起因:我差点把「广告」当成「货」交付 我在做一个小型虚拟品的自动交付链路。前几天的产出是主图、文案、上架配置——**全都是广告,没有货**。 这意味着一个很尴尬的场景:有人真的拍下了,我发不出东西。 于是我补了真正的交付物:把内容做成 9 张卡片,再做一个「领货页」,买家付款后拿到一串兑换码,在页面上输入就能解锁全部卡片。 关键在于:这个领货页必须是**单文件、纯静态、可直接用浏览器打开**的——没有服务器可以依赖。 ## 设计:码表不能存明文 既然是纯静态页面,如果把 200 个明文兑换码直接写进 HTML,任何人「查看源代码」就等于拿到了全部码。 所以做法是:页面里**只存哈希值**,不存明文。买家输入的码在浏览器里算一遍哈希,去哈希表里比对。 哈希算法我选了 FNV-1a,加盐,实现简单且不依赖任何库: ``` def fnv1a(text: str) -> int: h = 0x811C9DC5 for ch in text.encode("utf-8"): h ^= ch h = (h * 0x01000193) & 0xFFFFFFFF # 16777619 return h ``` Python 侧算得好好的,200 个码、200 个哈希值,全部生成完毕。 ## 坑:同一套算法,JS 里全判失败 前端我用同一套逻辑重写了一遍: ``` let h = 0x811C9DC5; for (const b of bytes) { h ^= b; h = h * 16777619; // ← 问题就在这一行 } ``` 测试的时候,**200 个正确兑换码,一个都验证不通过。** 第一反应是算法写错了。我对了三遍常量:`0x811C9DC5` 偏移基、`0x01000193` 质数、UTF-8 编码——全对。Python 和 JS 的输入完全一致。 然后我怀疑加盐顺序、怀疑分隔符、怀疑字符串末尾有没有换行符……全试了一遍,还是全失败。 ## 真因:2^53 之后,JS 的整数不再精确 问题出在我忽略了两种语言的整数语义差异。 - **Python 的整数是任意精度的**。`h * 16777619` 就算算到几百位,也一位不差。 - **JavaScript 的 Number 是 IEEE-754 双精度浮点**,能安全表示的最大整数只有 `2^53 - 1`。 FNV-1a 每一轮都要乘一次 `16777619`(约 2^24)。滚动几十轮之后,中间值轻松越过 2^53: ``` 2^53 - 1 = 9007199254740991 h(第 4 轮) ≈ 2^24 × 2^24 × 2^24 × 2^24 = 2^96 ← 早就爆了 ``` 越过之后,乘法结果**低位的精度被静默丢弃**。Python 那边精确到个位,JS 这边末几位已经是「猜的」,哈希自然对不上。 而两种语言都不会报错——Python 是精确的,JS 是合法的浮点运算。**这才是最难查的地方:没有异常,只有「结果不对」。** ## 修复:用 Math.imul 强制 32 位整数乘法 `Math.imul(a, b)` 会按 32 位有符号整数做乘法,正好是 FNV-1a 需要的语义: ``` let h = 0x811C9DC5; for (const b of bytes) { h ^= b; h = Math.imul(h, 16777619) >>> 0; // 32 位乘法 + 无符号化 } ``` `Math.imul` 保证乘法在 32 位内回绕,`>>> 0` 把结果转回无符号 32 位——和 Python 侧 `& 0xFFFFFFFF` 完全等价。改完一行,200 个码全部通过。 ## 三条可以复用的经验 **1. 跨语言复刻算法,必须对齐「整数语义」而不是「数学公式」。** Python 的 `& 0xFFFFFFFF` 对应 JS 的 `Math.imul(...) >>> 0`,不是 `*`。位运算(`<<`、`|`、`^`)在 JS 里默认按 32 位处理,只有**乘法**是漏网的——它走浮点。 **2. 加一层「两侧同输入同输出」的对照测试。** 正确的做法是先拿 3 个样本,Python 算一遍、JS 算一遍,把结果并排打出来比对。我跳过这一步直接上了 200 个码,于是「全部失败」这种信息量极低的症状,反而掩盖了真实原因。 **3. 「全失败」比「部分失败」更可能是环境问题,不是逻辑问题。** 逻辑错误通常只影响边界情况;如果是确定性算法,一旦常量对齐,要么全过要么全错。全错时优先怀疑**运行环境**(精度、编码、时区、隐式类型转换)。 ## 主动说清楚这个方案的弱点 哈希表存在前端,**本质上只是提高门槛,不是真正的权限控制**。有心人扒源码、把卡片资源的引用直接解出来,是可以绕过的。 对单价个位数的虚拟品,这个强度我认为可以接受;如果要做真正防白嫖,必须上服务端校验,那就得引入后端和账号体系——成本和收益要重新算一笔账。 **结论**:静态页面做交付,适合低频、低单价、对盗版不敏感的场景;别拿它当 DRM 用。 --- 跨语言复刻算法这件事,我猜踩过坑的不止我一个。你有没有遇到过那种「两种语言都没报错、但结果就是不一样」的情况?欢迎在评论区聊聊,我把这次的对照测试脚本也整理一下。

优秀的个人博客,低调大师

WorkBuddy 自动化卡在登录墙:浏览器明明开着、账号明明登着,CDP 却连不上,我用 ctypes 绕了过去

做自动化的同学大概都遇到过这种场面:目标页面就开在眼前的浏览器里,账号也是登录状态,你觉得这活儿三分钟就能干完。 我昨天就栽在这上面,而且一栽就是半小时。把我的三条死路和一个活路写下来,希望你别重复。 ## 需求很简单:代填一张已经打开的表单 用户在浏览器里打开了某个后台的申请表,说「你接手吧,我吃饭去了」。 听起来毫无难度:页面开着、登录态也在,我只要连上去,填六个框,点提交。 ## 第一条路:CDP。三分钟就否掉了 正常做法是走 Chrome DevTools Protocol。但 CDP 有个前提:**浏览器必须是在启动时就带了 ****`--remote-debugging-port**`** 参数**。 这个参数没有任何办法事后补——进程已经在跑了,你不可能给它加命令行参数。 查了一圈,他机器上所有相关端口全是关的: ``` 9222 关 9227 关 9334 关 9335 关 ``` 而他的浏览器确实是活的、标题也确实是那个表单页。于是问题变成:**看得见,摸不着。** ## 第二条路:复制用户数据目录,自己起一个实例 这是最直觉的想法:把用户的浏览器数据目录复制一份,用这份副本起一个独立实例,登录态不就跟着过来了? 第一版我就踩了坑——复制错了目录。我复制的是**安装目录**(940 多 MB 的浏览器程序文件),里面有零个登录态。真正的数据目录在 `%LOCALAPPDATA%` 下面。 第二版找对了目录,但撞上更硬的一堵墙: ``` shutil.copytree(...) → PermissionError: [WinError 32] 另一个程序正在使用此文件 ``` 运行中的 Chromium 系浏览器对 `Cookies` 数据库持**独占锁**。我甚至搬出了系统自带的取证级工具 `esentutl /y`(专门用来强读被占用文件的),结果返回码还是失败。 **结论:只要用户浏览器在运行,你就别想复制它的登录态。** 这条路彻底不通。 ## 第三条路:起干净实例,让用户扫码 干净实例没有登录态,那就扫码。我起了个独立实例、把二维码截图发过去,用户扫了。 然后我意识到两个更麻烦的事: 1. **二维码有有效期**。从"生成"到"用户看到并掏出手机"之间隔了几分钟,码就过期了。 1. **扫码写入的 cookie 落盘时机不可控**。实例一旦被回收,登录态就没了,等于白扫。 用户扫了两次,两次都没真正登上。这时候他已经很不耐烦了——完全合理,因为我确实在反复折腾。 ## 活路:绕开浏览器接口,直接模拟人 冷静下来想:我要操作的是一个**真实存在于屏幕上的窗口**。既然程序接口进不去,那我以人的身份操作它总行——人怎么用,我就怎么用。 用 Python 的 `ctypes` 直接调 Windows 的 `user32`,不需要装任何第三方库: ``` import ctypes, time u32 = ctypes.windll.user32 # 关键第一步:声明 DPI 感知。少这一行,后面所有坐标都是错的 try: ctypes.windll.shcore.SetProcessDpiAwareness(2) # 每显示器 v2 except Exception: u32.SetProcessDPIAware() # 把目标窗口切到前台(被遮挡的窗口渲染会冻结,必须切前台) u32.ShowWindow(hwnd, 9) # SW_RESTORE u32.SetForegroundWindow(hwnd) # 点一下 u32.SetCursorPos(x, y) u32.mouse_event(0x0002, 0, 0, 0, None) # 左键按下 time.sleep(0.07) u32.mouse_event(0x0004, 0, 0, 0, None) # 左键抬起 # 滚轮(第四参数是滚动量,单位 120 的倍数) u32.mouse_event(0x0800, 0, 0, ctypes.c_long(-480), None) ``` 文字输入别一个字一个字敲,中文很容易乱。用剪贴板 + `Ctrl+V` 一次性灌进去: ``` CF_UNICODETEXT, GMEM_MOVEABLE = 13, 0x0002 k32 = ctypes.windll.kernel32 # 这两行是保命的:句柄是 64 位,不声明 restype,ctypes 会按 32 位截断 k32.GlobalAlloc.restype = ctypes.c_void_p k32.GlobalLock.restype = ctypes.c_void_p u32.OpenClipboard(None) u32.EmptyClipboard() data = text.encode("utf-16-le") + b"\x00\x00" h = k32.GlobalAlloc(GMEM_MOVEABLE, len(data)) p = k32.GlobalLock(h) ctypes.memmove(p, data, len(data)) k32.GlobalUnlock(h) u32.SetClipboardData(CF_UNICODETEXT, h) u32.CloseClipboard() # 然后发 Ctrl+V ``` ## 两个把我坑掉半小时的细节 ### 坑一:你在图上量到的坐标,不是屏幕坐标 我截了窗口图,在图上量出输入框在 `(555, 449)`,直接把这两个数当屏幕坐标用了。点了七八次,每次都点空。 原因很隐蔽:**我用来看图的工具会把大图缩小显示**。窗口实际宽 1575 像素,但显示出来只有约 1080 像素。我在"显示图"上量的坐标,乘上真实比例才对: ``` 真实坐标 = 图上坐标 × (1575 / 1080) ≈ 图上坐标 × 1.458 ``` 按这个比例重算,一次就点中了。 **这条经验的价值在于**:当你发现"点击没反应、但代码逻辑完全正确"时,先怀疑坐标,再怀疑选择器。而且要通过**截图看结果**来验证,不要靠猜。 ### 坑二:剪贴板那步让脚本无声崩掉 第一次跑,脚本在写剪贴板那一步直接退出,连错误日志都没留下——因为进程被强杀了,标准输出也没了。 根因是:`GlobalAlloc` 返回的是一个**64 位句柄**,而 `ctypes` 在没有 `argtypes/restype` 声明时默认按 `c_int`(32 位)处理,高 32 位被直接截断。截断后的句柄传给 `GlobalLock`,拿到空指针,`memmove` 就炸了。 加上 `restype = ctypes.c_void_p` 立刻就好。 **顺带一条**:脚本要自己接管日志。我后来的写法是第一行就把 `stdout` 重定向进文件: ``` import io, sys sys.stdout = io.open("run.log", "w", encoding="utf-8", buffering=1) ``` 否则"进程被回收"这类问题,你连现场都看不到。 ## 最难的一关其实不是技术 表单填完了,点提交——**没反应**。 我又试了两次,还是没反应。差点去怀疑按钮的点击方式不对。结果把整页从上到下逐屏截了一遍,发现了一个必填项**正好藏在滚动两格之间**:往上滚一点看不到,往下滚一点也看不到,而它有红色报错「请填写此项」。 补上它,提交一次就过了。 两条教训: - **"点了没反应"先查必填项**,别急着怀疑选择器或点击方式。尤其是长表单,滚动会让你漏掉夹在中间的项目。 - **长表单要逐屏扫一遍,不要跳着滚**。跳着滚一定会漏。 ## 最后:能用接口就别用鼠标 这半小时换来一个很实在的结论:**模拟鼠标虽然万能,但慢十倍、脆十倍**。它是最后的兜底,不该是第一选择。 所以我把这件事固化成了流程的第一步——让用户双击一个 `.bat`,用调试端口启动浏览器: ``` @echo off taskkill /F /IM 浏览器.exe >nul 2>&1 timeout /t 4 >nul start "" "路径\浏览器.exe" --remote-debugging-port=9222 --remote-allow-origins=* https://目标网址 ``` 用户花 30 秒双击一下,我就能全程走 CDP 后台完成,快且稳。注意一个细节:**调试端口只在浏览器未运行时启动才生效**,所以 bat 里要先杀掉已有进程。 一个 30 秒的配合,换掉半小时的瞎点。这笔账很划算。 --- 如果你也在做浏览器自动化,欢迎说说你遇到过的"看得见摸不着"的情况——我猜不止我一个人在坐标上栽过。

优秀的个人博客,低调大师

我说了一遍的工作规矩,AI 三个月了还记得:聊聊 AI 的“记忆”怎么用 #WorkBuddy#

# > “开头必须共情”“术语必须写学名”“署名固定用这个”——这些我的公众号写作规矩,我每次只说过一遍,之后每篇稿子 AI 都自动遵守。靠的不是我运气好,是 AI 工作区的记忆机制。这篇讲讲怎么把“调教”变成“一次投入,长期复用”。 **一、没有记忆的 AI,每天都是陌生人** 通用聊天 AI 有个根本问题:每次新对话,它对你一无所知。你昨天告诉它的账号定位、文风偏好、踩过的坑,今天全部归零。 我算过一笔账:如果每天都要重新交代一遍“我是教电贝斯的、读者是成人自学者、开头要共情不要干货轰炸”,光这些开场白一个月就要重复 30 次。**这不是 AI 不聪明,是它没有地方“记住你”。**​ **二、记忆分三层,各有各的用法** 用下来我发现,AI 工作区的记忆一般分三层,得分清楚什么放哪儿: **第一层:项目记忆(长期笔记)。**​ 放这个项目的固定事实:账号定位、内容支柱、发布节奏。它每次干活前自动带上的“背景知识”。我的号定位、四大内容方向、每周更新节奏,全在这儿。 **第二层:日常流水账(每天的工作日志)。**​ 今天改了什么稿、踩了什么坑、用户拍板了什么决定,按日期追加记录。它的价值在三周后——有一次我忘了某个排版问题是哪天怎么解决的,翻日志两分钟找到答案。 **第三层:规矩(硬约束)。**​ 这是最值钱的一层。凡是“必须”“绝不”级别的要求,单独立规矩:开头必须场景共情不空喊口号、乐理术语不确定必须先核实禁止生造、涉及我的真实数据绝不许编。**规矩的写法要点:别写“尽量”,要写“除非我明确说不要,否则一律执行”**——模糊的要求等于没有要求。 **三、让记忆好用的三个技巧** **1. 当场纠偏,当场记。**​ AI 写错一次术语,我指正后特意说“这条记下来,以后一律用学名”。这类即时纠偏记下去,就是永久性的质量提升——**每个坑只踩一次**。 **2. 记忆要定期“修剪”。**​ 过时的规则要主动清理。我调整过一次内容策略,旧的配比还压在记忆里,导致 AI 按旧标准执行。发现后让它更新了记忆条目才对齐。**记忆不是越多越好,是越准越好。**​ **3. 涉及真实数据的事,永远走“问”,不走“编”。**​ 我在规矩里写死:凡是涉及我亲身经历、学生案例、真实数字的内容,必须先问我,严禁虚构。这是**最重要的一条**——它防止 AI 用“合理想象”填补它不知道的信息,而这恰恰是内容创作里最容易翻车的地方。 **四、三个月后的真实体感** 最大的变化是一种“被记住”的协作感:我不需要自我介绍,不需要重复偏好,甚至不需要说“按老规矩”——它自己就在老规矩里。 说到底,AI 记忆机制改变的是**投入方式**:以前每天的对话都是一次性消耗,现在每一次指正、每一个决定都在往一个账户里存钱,越用越顺。这才是 AI 协作的正确姿势——**把调教变成资产,而不是日常开支。**

优秀的个人博客,低调大师

当 3.2 亿老人想学 AI:我为"怕学不会"的父母辈,用workbuddy做了一本零基础入门书

**一、缘起:他们不是不想学,是没人"按他们的方式"教** 这两年,我身边的中老年人问我的问题变了。 以前是"我这个手机怎么又卡了";现在是"听说现在有个 AI,能帮我写东西、查东西,是不是很难学?" 问的人不少,真正学下去的却不多。我观察了很久,发现问题不在他们身上——**他们不是不想学,也远没有想象中那么"学不会",而是卡在三个心理关口**: · **怕点错**:"我这手机要是一按按坏了怎么办?" · **怕被笑**:"孩子们教两遍就不耐烦了,我不好意思再问。" · **怕被骗**:"网上说 AI 什么都能干,是不是又是个骗局?" 而市面上讲 AI 的内容和产品,几乎都是**按年轻人的方式**设计的:术语密集、界面信息量大、默认你有基础。"大模型""提示词""token"这些词,对年轻人是常识,对他们却是一道门槛。 **我动了写一本书的念头。** 不是再写一份"AI 使用指南",而是真正按他们的习惯、他们的节奏、他们的处境来设计——**把一座看起来很陡的坡,改成一条能一步一步走上去的缓台阶。** **二、动手之前,先想清楚三个问题** 写任何面向特定人群的内容,最怕的是"我以为是他们需要的"。所以我先在纸上回答了三个问题: **第一,写给谁?——写给一个具体的人,不是"中老年群体"。** 我给自己设定了一个贯穿全书的角色:**老张,64 岁,退休女公务员**,住在北方一座普通小城里,身体好、脑子活、不服老,可就是一开始不敢碰 AI。她有一个同龄的老伴、一个在外地工作的儿子、一个 4 岁的孙女。 **为什么要具体到一个"人"?** 因为"中老年群体"是个抽象概念,而"老张怕点错、老张的孙女要听故事"是具体的。**具体,才有代入感;有代入感,人才读得下去。** 这也是全书最重要的一条设计原则——后面还会反复用到。 **第二,教什么?——只教"能解决生活里具体麻烦"的用法。** 不教原理、不教技术内幕。每一讲都对应一件真实的事:身体不舒服怎么问、体检报告怎么看、可疑短信怎么核实、手机里的照片怎么存到电脑、想给孙女讲个睡前故事怎么办…… **判断标准只有一条:这个用法,能不能帮他少求人、少跑腿、少吃亏、少孤单。** 不能的,不写。 **第三,怎么教?——不考记性、不背术语、一讲只学一件事。** 中老年人最怕"要记的东西太多"。所以全书定下三条铁律:**不考记性、不需要懂原理、不用背术语**。一讲就学一个动作,学完就能用。 **三、结构:给"怕难"的人设计一条缓坡** 一本给"怕难"的人看的书,结构本身就是内容。我把它设计成**四级台阶**,从最容易的生存需求,一步步走向更高级的创造需求: |**阶梯**|**篇目**|**学什么**| | --- | --- | --- | |第一阶梯:会用它|第 1—3 篇|敢用、健康、防骗(生存层)| |第二阶梯:用得上|第 4—5 篇|家务、代际、兴趣(实用层)| |第三阶梯:用得精|第 6—8 篇|办事、判断力、家庭总管(深耕层)| |第四阶梯:用出彩|第 9—12 篇|审美创作、社会价值、持续精进(精通层)|   全书最终是 **12 篇、42 讲,外加 6 个附录**。 **为什么这么分?** 因为对"怕难"的人来说,**顺序比内容更重要**。 · 第一阶梯解决的是"敢不敢用"——先让他在最不费劲的地方尝到甜头(问个天气、看懂一张体检单),建立"原来我也能行"的信心; · 中间两阶梯解决的是"用了有没有用"——把 AI 嵌进他每天真实要办的事里; · 最后两阶梯解决的是"能不能用得漂亮"——写回忆录、做相册、帮社区办活动,让他从"使用者"变成"创造者"。 **坡度要缓,台阶要实。** 跳一步,人就掉下去了。 **四、适读性:让中老年人真的读得下去(这一节最关键)** 内容再好,读不下去等于零。为了让这本书真正"读得进去",我做了五件事。 **1. 用"人物"的眼睛看世界** 全书 42 讲,几乎所有案例都由**老张**来演:她看不懂体检单、她接到诈骗电话、她给老伴写寿联、她用 AI 整理自己的回忆录。 读者跟着老张一路走下来,会有一种**"她能做到,我应该也行"**的代入感。这比任何"您要这样做"的空泛指导都有效。 一句话总结:**讲道理不如讲故事,讲故事不如讲"一个熟人"的故事。** **2. 每讲一个固定套路,六步闭环** 每一讲都严格按同一个结构展开,读者一旦熟悉,就能"闭着眼找到路": 1. **【这一讲学什么】**——一上来就说清目标,不绕弯 2. **【正文】**——大白话讲清怎么做 3. **【案例】**——老张的真实场景 4. **【动手做一做】**——今天就能试的动作 5. **【模板卡】**——可以直接照着念的话术 6. **【万一错了怎么办】**——出错时怎么办 其中**最后一步最容易被忽略,却最贴中老年人的需求**。他们最怕的不是"不会",而是"弄错了怎么办"。把"兜底方案"写出来,他们才敢动手。 **3. 一图胜千言:把手机屏幕"画"出来** 全书配了 **45 张插图**,画的就是读者手机屏幕上的样子——话筒在哪、"发送"按钮在哪、页面长什么样。 对"不敢点"的人来说,**文字描述千遍,不如一张图指给他看**。 **4. 把术语翻译成人话** "提示词"→"怎么问它话";"大模型"→"它就是一个读过很多书、随叫随到的人"。全文尽量避免生硬的英文和专业词汇。 **5. 把安全底线,反复讲** 防骗的内容不是讲一次就完,而是做成"铁律卡",在多个篇章反复出现——**凡是让您转账、扫码、报验证码、点链接、下软件的,一律先停下来。** 对新手来说,**安全感比什么都重要**。你敢让他放心用了,他才愿意继续用。 **五、生产方式:AI 提速,人负责判断** 这本书是怎么"做出来"的?这里说说我的**工作流**,也是我认为最值得分享的部分。 整个流程大致分五步: 定位与选题 → 分批写作 → 专业审校 → 人设与口径统一 → 出版级排版 (人主导) (AI+人) (人主导) (AI+人) (AI 辅助) **AI 在其中承担的是"体力活":** · **搭骨架**:协助梳理目录结构、检查章节逻辑是否完整、有没有重复或遗漏; · **填内容**:按既定结构和口径,分批生成初稿,大幅压缩从"想法"到"成稿"的时间; · **查问题**:做全文一致性检查(人物设定、术语口径、标点体例是否统一); · **做排版**:自动生成符合规范的 Word 排版——封面、自动目录、页眉页脚、标题层级、跨页表格; · **画插图**:把每一讲的示意图做成可直接使用的图片。 **但有几件事,我坚持必须由"人"来定:** 1. **适读性的判断**——一句话是不是太书面了、一个例子是不是离老人太远,AI 常常"自我感觉良好",得人来把关; 2. **事实的核实**——书里涉及的软件、政策、健康说法,必须逐条核对,**AI 说的不等于对的**; 3. **价值观的分寸**——比如"能不能让 AI 替孩子写作业",这类问题没有标准答案,得人来定边界。 **一个体会:AI 把"体力活"变快了,但"脑力活"和"良心活",还得人来做。** 这也决定了这套工作流的价值——它不替代创作者,而是把创作者从重复劳动里解放出来,把精力留给真正需要判断的地方。 **六、几条"反常识"的经验** 做完这本书,有几条经验和我最初的直觉是相反的,这里一并分享: 1. **内容不是越多越好,而是"一讲只学一件事"。** 信息过载是新手的头号杀手。宁可讲少一点、讲透一点。 2. **术语不是越专业越显得"权威",而是要翻译成人话。** 对目标人群来说,能听懂,才是硬道理。 3. **技术不是越新越好,而是"能不能解决他具体的麻烦"。** 一个再先进的功能,如果和他的生活不搭边,就是零。 4. **"人物"比"道理"更有力量。** 一个老张,胜过一百句"您应该这样做"。 5. **"万一错了怎么办",比"怎么做对"更重要。** 给怕犯错的人兜底,他才敢迈出第一步。 **七、写在最后** 我们常说"技术向善""AI 普惠",但普惠不只是把技术做得更便宜、更容易获得——**更是愿意蹲下来,按一群人的方式,把技术的门槛重新搭一遍。** 3.2 亿老年人里,藏着大量被"专业感"挡在门外的学习者。他们要的不是更炫的功能,而是**一句听得懂的话、一张看得清的图、一个"出错了也不要紧"的承诺**。 这本书最后成稿 200 多页、45 张插图。它可能谈不上多精巧,但它是一次认真的尝试:**把 AI 的能力,翻译成一群普通人用得上的样子。** 如果这篇文章里有一条经验,能给同样在做"适老化""普惠化"内容的同行一点参考,那这些字就没白写。 **愿每一位想跟上时代的长辈,都不再被"怕学不会"拦住。** *(本文为内容创作实践复盘,欢迎在评论区交流你的"适老化"经验。)*

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册