首页 文章 精选 留言 我的

精选列表

搜索[springcloud],共1351篇文章
优秀的个人博客,低调大师

java B2B2C Springcloud电子商务平台源码------Hystrix的缓存使用

一介绍 在高并发的场景之下,Hystrix中提供了请求缓存的功能,可以方便地开启和使用请求缓存来优化系统,达到减轻高并发时请求线程的消耗、降低请求响应时间的效果。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 二开启请求缓存功能 在实现HystrixCommand或HystrixObservableCommand时,通过重载getCacheKey()方法来开启请求缓存。 例如: public class CommandUsingRequestCache extends HystrixCommand<Boolean> { private final int value; protected CommandUsingRequestCache(int value) { super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.value = value; } @Override protected Boolean run() { return value == 0 || value % 2 == 0; } //通过getCacheKey方法中返回的请求缓存key值,就能让该请求命令具备缓存功能。此时当不同的外部请求 //处理逻辑调用了同一个依赖服务时,Hystrix会根据getCacheKey方法返回的值区分是否是重复请求, //如果它们的cachekey相同时候,那么该依赖服务值会在第一个请求达到时被真实的调用一次,另外一个 //请求则直接从请求缓存中返回结果,所以开启缓存有以下好处: //减少重复请求数,降低依赖服务的并发度 //在同一用户请求的上下文中,相同依赖服务的返回数据始终保持一致。 //请求缓存在run()和construct()执行之前生效,所以可以有效减少不必要的线程开销。 @Override protected String getCacheKey() { return String.valueOf(value); } } 三清理失效缓存功能 使用请求缓存时,如果只是读操作,那么不需要考虑缓存内容是否正确的问题,但是如果请求命令中还有更新数据的操作,那么缓存中的数据就需要我们在进行写操作时进行及时处理,以防止读操作的请求命令获取到失效的数据。 在Hystrix中,可以通过HystrixRequestCache.clear()方法来进行缓存的清理。 例如: //当我们对GetterCommand命令实现了请求缓存之后,那么势必需要为SetterCommand命令实现清理缓存,以保证 //prefixStoredOnRemoteDataStore被更新之后,Hystrix请求缓存中相同的缓存的结果被移除,这样下一次根据id //获取prefixStoredOnRemoteDataStore时,不会从缓存去获取数据 public class CommandUsingRequestCacheInvalidation { /* represents a remote data store */ private static volatile String prefixStoredOnRemoteDataStore = "ValueBeforeSet_"; //根据id获取数据 public static class GetterCommand extends HystrixCommand<String> { private static final HystrixCommandKey GETTER_KEY = HystrixCommandKey.Factory.asKey("GetterCommand"); private final int id; public GetterCommand(int id) { super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("GetSetGet")) .andCommandKey(GETTER_KEY)); this.id = id; } @Override protected String run() { return prefixStoredOnRemoteDataStore + id; } @Override protected String getCacheKey() { return String.valueOf(id); } //该方法从默认的Hystrix并发策略中根据GETTER_KEY获取命令的请求缓存对象HystrixRequestCache的实例 //然后再调用该请求缓存对象的clear方法,对Key为id值的缓存内容进行清理。 public static void flushCache(int id) { HystrixRequestCache.getInstance(GETTER_KEY, HystrixConcurrencyStrategyDefault.getInstance()).clear(String.valueOf(id)); } } //用于更新prefixStoredOnRemoteDataStore的值 public static class SetterCommand extends HystrixCommand<Void> { private final int id; private final String prefix; public SetterCommand(int id, String prefix) { super(HystrixCommandGroupKey.Factory.asKey("GetSetGet")); this.id = id; this.prefix = prefix; } @Override protected Void run() { // persist the value against the datastore prefixStoredOnRemoteDataStore = prefix; //在调用了写prefixStoredOnRemoteDataStore之后,增加了对GetterCommand //中静态方法flushCache的调用,以实现对时效缓存的清理工作。 GetterCommand.flushCache(id); // no return value return null; } } } 代码结构如下:资料和源码来源
优秀的个人博客,低调大师

java B2B2C 源码 多级分销Springcloud多租户电子商城系统-KAFKA介绍

Kafka是一个分布式的、可分区的、可复制的消息系统。 它提供了普通消息系统的功能,但具有自己独特的设计。这个独特的设计是什么样的呢? 首先让我们看几个基本的消息系统术语: Kafka将消息以topic为单位进行归纳。 将向Kafka topic发布消息的程序成为producers. 将预订topics并消费消息的程序成为consumer. Kafka以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个broker. producers通过网络将消息发送到Kafka集群,集群向消费者提供消息,如下图所示: 客户端和服务端通过TCP协议通信。Kafka提供了Java客户端,并且对多种语言都提供了支持。 Topics 和Logs 先来看一下Kafka提供的一个抽象概念:topic. 一个topic是对一组消息的归纳。对每个topic,Kafka 对它的日志进行了分区,如下图所示: 每个分区都由一系列有序的、不可变的消息组成,这些消息被连续的追加到分区中。分区中的每个消息都有一个连续的序列号叫做offset,用来在分区中唯一的标识这个消息。 在一个可配置的时间段内,Kafka集群保留所有发布的消息,不管这些消息有没有被消费。比如,如果消息的保存策略被设置为2天,那么在一个消 息被发布的两天时间内,它都是可以被消费的。之后它将被丢弃以释放空间。Kafka的性能是和数据量无关的常量级的,所以保留太多的数据并不是问题。 实际上每个consumer唯一需要维护的数据是消息在日志中的位置,也就是offset.这个offset有consumer来维护:一般情 况下随着consumer不断的读取消息,这offset的值不断增加,但其实consumer可以以任意的顺序读取消息,比如它可以将offset设置 成为一个旧的值来重读之前的消息。 以上特点的结合,使Kafka consumers非常的轻量级:它们可以在不对集群和其他consumer造成影响的情况下读取消息。你可以使用命令行来"tail"消息而不会对其他正在消费消息的consumer造成影响。 将日志分区可以达到以下目的:首先这使得每个日志的数量不会太大,可以在单个服务上保存。另外每个分区可以单独发布和消费,为并发操作topic提供了一种可能。 分布式 每个分区在Kafka集群的若干服务中都有副本,这样这些持有副本的服务可以共同处理数据和请求,副本数量是可以配置的。副本使Kafka具备了容错能力。 每个分区都由一个服务器作为“leader”,零或若干服务器作为“followers”,leader负责处理消息的读和 写,followers则去复制leader.如果leader down了,followers中的一台则会自动成为leader。集群中的每个服务都会同时扮演两个角色:作为它所持有的一部分分区的leader,同 时作为其他分区的followers,这样集群就会据有较好的负载均衡。 Producers Producer将消息发布到它指定的topic中,并负责决定发布到哪个分区。通常简单的由负载均衡机制随机选择分区,但也可以通过特定的分区函数选择分区。使用的更多的是第二种。 consumer 发布消息通常有两种模式:队列模式和发布-订阅模式。队列模式中,consumers可以同时从服务端读取消息,每个消息只被其中一个consumer读到;发布-订阅模式中消息被广播到所有的consumer中。 Consumers可以加入一个consumer 组,共同竞争一个topic,topic中的消息将被分发到组中的一个成员中。同一组中的consumer可以在不同的程序中,也可以在不同的机器上。如果所有的consumer都在一个组中,这就成为了传统的队列模式,在各consumer中实现负载均衡。 如果所有的consumer都不在不同的组中,这就成为了发布-订阅模式,所有的消息都被分发到所有的consumer中。 更常见的是,每个topic都有若干数量的consumer组,每个组都是一个逻辑上的“订阅者”,为了容错和更好的稳定性,每个组由若干consumer组成。这其实就是一个发布-订阅模式,只不过订阅者是个组而不是单个consumer。 由两个机器组成的集群拥有4个分区 (P0-P3) 2个consumer组. A组有两个consumerB组有4个 相比传统的消息系统,Kafka可以很好的保证有序性。 传统的队列在服务器上保存有序的消息,如果多个consumers同时从这个服务器消费消息,服务器就会以消息存储的顺序向consumer分 发消息。虽然服务器按顺序发布消息,但是消息是被异步的分发到各consumer上,所以当消息到达时可能已经失去了原来的顺序,这意味着并发消费将导致 顺序错乱。为了避免故障,这样的消息系统通常使用“专用consumer”的概念,其实就是只允许一个消费者消费消息,当然这就意味着失去了并发性。 在这方面Kafka做的更好,通过分区的概念,Kafka可以在多个consumer组并发的情况下提供较好的有序性和负载均衡。将每个分区分 只分发给一个consumer组,这样一个分区就只被这个组的一个consumer消费,就可以顺序的消费这个分区的消息。因为有多个分区,依然可以在多 个consumer组之间进行负载均衡。注意consumer组的数量不能多于分区的数量,也就是有多少分区就允许多少并发消费。 Kafka只能保证一个分区之内消息的有序性,在不同的分区之间是不可以的,这已经可以满足大部分应用的需求。如果需要topic中所有消息的有序性,那就只能让这个topic只有一个分区,当然也就只有一个consumer组消费它。

优秀的个人博客,低调大师

java B2B2C Springcloud多租户电子商城系统-断路器聚合监控

一、Hystrix Turbine简介 看单个的Hystrix Dashboard的数据并没有什么多大的价值,要想看这个系统的Hystrix Dashboard数据就需要用到Hystrix Turbine。Hystrix Turbine将每个服务Hystrix Dashboard数据进行了整合。Hystrix Turbine的使用非常简单,只需要引入相应的依赖和加上注解和配置就可以了。 二、准备工作 本文使用的工程为上一篇文章的工程,在此基础上进行改造。因为我们需要多个服务的Dashboard,所以需要再建一个服务,取名为service-lucy,它的基本配置同service-hi,具体见源码,在这里就不详细说明。 三、创建service-turbine 引入相应的依赖: <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix-dashboard</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-turbine</artifactId> </dependency> </dependencies> 在其入口类ServiceTurbineApplication加上注解@EnableTurbine,开启turbine,@EnableTurbine注解包含了@EnableDiscoveryClient注解,即开启了注册服务。 @SpringBootApplication @EnableEurekaClient @EnableDiscoveryClient @RestController @EnableHystrix @EnableHystrixDashboard @EnableCircuitBreaker @EnableTurbine public class ServiceTurbineApplication { /** * http://localhost:8764/turbine.stream */ public static void main(String[] args) { SpringApplication.run( ServiceTurbineApplication.class, args ); } } 配置文件application.yml: spring: application.name: service-turbine server: port: 8769 security.basic.enabled: false turbine: aggregator: clusterConfig: default # 指定聚合哪些集群,多个使用","分割,默认为default。可使用http://.../turbine.stream?cluster={clusterConfig之一}访问 appConfig: service-hi,service-la ### 配置Eureka中的serviceId列表,表明监控哪些服务 clusterNameExpression: new String("default") # 1. clusterNameExpression指定集群名称,默认表达式appName;此时:turbine.aggregator.clusterConfig需要配置想要监控的应用名称 # 2. 当clusterNameExpression: default时,turbine.aggregator.clusterConfig可以不写,因为默认就是default # 3. 当clusterNameExpression: metadata['cluster']时,假设想要监控的应用配置了eureka.instance.metadata-map.cluster: ABC,则需要配置,同时turbine.aggregator.clusterConfig: ABC eureka: client: serviceUrl: defaultZone: http://localhost:8761/eureka/ Turbine演示 依次开启server、service-hi、service-la、service-turbine工程。 打开浏览器输入:http://localhost:8769/turbine.stream, 依次请求: http://localhost:8762/hi?name=whhttp://localhost:8763/hi?name=wh 打开:http://localhost:8763/hystrix,输入监控流http://localhost:8769/turbine.stream,点击monitor stream,可以看到这个页面聚合了2个service的hystrix dashbord数据。 java B2B2C springmvc mybatis电子商务平台源码

优秀的个人博客,低调大师

Nacos 计划发布v0.2版本,进一步融合Dubbo和SpringCloud生态

在近期的Aliware Open Source 成都站的活动上,阿里巴巴高级工程师邢学超(于怀)分享了Nacos v0.2的规划和进度,并对Nacos v0.3的控制台进行了预览。Nacos v0.2将进一步融入Duboo和Spring Cloud生态,帮助开发者更好的在微服务场景下使用服务发现和动态配置管理。 嘉宾介绍:邢学超(于怀),Nacos开源项目主要推动者,负责阿里巴巴内部 configserver、skywalker和taokeeper产品的架构和研发,爱好代码、篮球、吉他和摇滚,还记得超哥给盲人小朋友写的那首超温暖的歌么?-传送门:《给你们的歌》 一、Nacos开源介绍 Nacos是一个更易于帮助构建云原生应用的动态服务发现、配置和服务管理平台,脱胎于承载整个阿里巴巴集团的软负载产品,并于今年7月对外开源。开源以来,获得

优秀的个人博客,低调大师

springCloud(6):Eureka的自我保护模式、多网卡下的IP选择、Eureka的健康检查

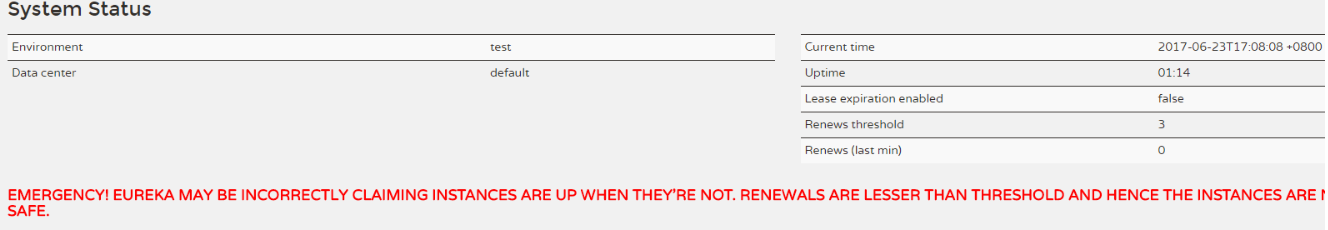
一、Eureka的自我保护模式 进入自我保护模式最直观的体现就是Eureka Server首页的警告,如下图: 默认情况下,如果Eureka Server在一定时间内没有接收到某个微服务实例的心跳,Eureka Server将会注销该实例(默认90秒)。但是当网络分区故障发生时,微服务与Eureka Server之间无法正常通信,这就可能变得非常危险了----因为微服务本身是健康的,此时本不应该注销这个微服务。 Eureka Server通过“自我保护模式”来解决这个问题----当Eureka Server节点在短时间内丢失过多客户端时(可能发生了网络分区故障),那么这个节点就会进入自我保护模式。一旦进入该模式,Eureka Server就会保护服务注册表中的信息,不再删除服务注册表中的数据(也就是不会注销任何微服务)。当网络故障恢复后,该Eureka Server节点会自动退出自我保护模式。 自我保护模式是一种对网络异常的安全保护措施。使用自我保护模式,而已让Eureka集群更加的健壮、稳定。 在Spring Cloud中,可以使用eureka.server.enable-self-preservation=false来禁用自我保护模式,当然也可以使用显示指定IP地址来解决: 1 eureka.instance.instance-id:${spring.cloud.client.ipAddress}:${server.port} 二、多网卡环境下的IP选择 2.1、简介 指定IP在某些场景下很有用,如某台服务器有eth0、eth1和eth2三块网卡,但是eth1可以被其它的服务器访问;如果Eureka Client将eth0或者eth2注册到Eureka Server上,其它微服务就无法通过这个IP调用该微服务的接口。 Spring Cloud提供了按需选择IP的能力,从而避免以上的问题。 2.2、操作 方案1、忽略指定名称的网卡 1 2 3 4 #忽略eth0,支持正则表达式 spring.cloud.inetutils.ignored-interfaces[0]=eth0 #注册时使用ip而不是主机名 eureka.instance.prefer-ip-address=true 方案2、只使用站点本地地址 1 2 3 4 #只使用站点本地地址 spring.cloud.inetutils. use -only-site- local -interfaces=true #注册时使用ip而不是主机名 eureka.instance.prefer-ip-address=true 方案3、手动指定IP地址 1 2 3 4 #手动指定IP地址 spring.cloud.inetutils. default -ip-address=127.0.0.1 #注册时使用ip而不是主机名 eureka.instance.prefer-ip-address=true 三、Eureka的健康检查 先看下图: 说明:在Status栏显示着UP,表示应用程序状态正常。其它取值DOWN、OUT_OF_SERVICE、UNKNOWN等,只有UP的微服务会被请求。 由于Eureka Server与Eureka Client之间使用心跳机制来确定Eureka Client的状态,默认情况下,服务器端与客户端的心跳保持正常,应用程序就会始终保持“UP”状态,所以微服务的UP并不能完全反应应用程序的状态。 Spring Boot Actuator提供了/health端点,该端点可展示应用程序的健康信息,只有将该端点中的健康状态传播到Eureka Server就可以了,实现这点很简单,只需为微服务配置如下内容: 1 2 #开启健康检查(需要spring-boot-starter-actuator依赖) eureka.client.healthcheck.enabled=true 如果需要更细粒度健康检查,可实现com.netflix.appinfo.HealthCheckHandler接口 本文转自我爱大金子博客51CTO博客,原文链接http://blog.51cto.com/1754966750/1941655如需转载请自行联系原作者 我爱大金子

优秀的个人博客,低调大师

springcloud微服务三:Eureka服务治理之注册服务提供者及服务的发现和消费

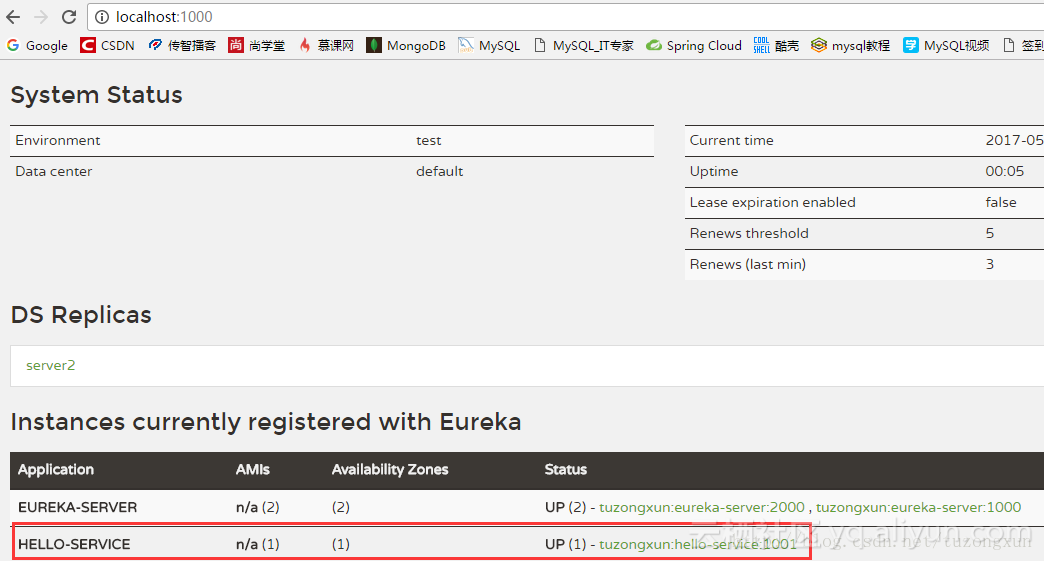
当服务注册中心成功建立以后,就需要有服务的注册和消费,否则这个服务注册中心就没有了存在的意义,而实际上,一个简单的服务注册也是非常简单的,仅仅需要实现四部曲就好。 首先,还是建立一个基本的spring boot的项目,创建的时候选择web,然后在pom.xml文件中加入Eureka的依赖,和服务注册中心的maven配置一样,这里就不再罗列代码。 第二步,就是修改application.properties文件,指定端口和服务名称以及注册中心的地址: server.port=1001 spring.application.name=hello-service eureka.client.serviceUrl.defaultZone=http://server1:1000/eureka/,http://server2:2000/eureka/ 因为上一步中实现了注册中心的集群模式,因此这里可以指定两个,如果有更多的服务注册中心,还可以指定更多,中间以逗号分隔。 第三步,使用注解开启自动装配,使服务能够向注册中心注册、向注册中心服务租约(实际上就是定时器持续发送心跳告诉服务注册中心自己还活着)、取消租约、查询服务列表等,这个注解是@EnableDiscoveryClient,添加以后的代码如下: @EnableDiscoveryClient @SpringBootApplication public class EurekaService1Application { public static void main(String[] args) { SpringApplication.run(EurekaService1Application.class, args); } } 第四步,我们说要进行服务注册,当上边一切准备工作做好以后,自然需要有服务才能注册,而这个服务就是一个看起来很普通的controller类,如图: @RestController public class HelloController { @Autowired private DiscoveryClient client; @RequestMapping(value="/hello",method=RequestMethod.GET) public String sayHello(){ ServiceInstance instance=client.getLocalServiceInstance(); return "hello "+instance.getHost()+","+instance.getPort()+","+instance.getServiceId(); } } 这里的DiscoveryClient可以获取注册到服务注册中心的服务的相关信息,并不是必须注入的,这里完全可以写成如下所示的代码: @RestController public class HelloController { @RequestMapping(value="/hello",method=RequestMethod.GET) public String sayHello(){ return "hello"; } } 当然了,因为只是了解服务注册的过程,所以这里仅仅这么简单,实际的业务逻辑自然不会是这样。 那么通过上边四步,一个能够注册到服务注册中心提供服务的服务就完成了,启动这个服务就会被注册到服务注册中心,我们可以通过服务注册中心的页面来查看: 成功的创建了一个服务并注册到注册中心,同样的,为了高可用,我们可以再建一个具有同样功能的服务,而这个过程就更加的简单,只需要更改一下端口号,也就是server.port,然后重新启动就可以,启动后会看到上边的页面如下(当然了,这里也是为了测试方便,实际情况也应该是在两台机器上运行的两套代码才对): 这里我们会看到已经有了两个同应用名的服务,端口分别是1001和2001。 而在上述页面中还需要注意的是那一段醒目的红色提示,它的意思就是说开启了自我保护机制,也就是说当服务失效后,有可能注册中心还会保留一段时间该服务的信息,这样就可能导致服务消费方获取服务列表的时候依然能够获取到这个服务,但是实际上向该服务发送请求的时候又无法成功请求,那么学习的过程中可以使用以下配置关闭自我保护机制,然后如果再访问注册中心的页面便不会再出现这个提示,也不会出现那种服务失效后还保留在注册中心的情况。 #设置是否开启自我保护机制,默认是true eureka.server.enable-self-preservation=false 服务注册好以后,下边就是服务的发现和消费,通常有ribbon和feign两种方式,而feign实际上也是以ribbon为基础的,这两种后边都还需要具体详细的学习,所以这里只简单的演示一下消费的过程,不做太详细的解释。ribbon可以实现负载均衡,这里使用最简单的模板实现。 首先还是建立一个基础spring boot项目,然后pom.xml中加入eureka和ribbon的依赖以及eureka的版本信息: <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-ribbon</artifactId> </dependency> <dependencyManagement> <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-dependencies</artifactId> <version>Brixton.RELEASE</version> <type>pom</type> <scope>import</scope> </dependency> </dependencies> </dependencyManagement> 然后application.properties文件内容如下: server.port=3001 spring.application.name=rabbit-client eureka.client.serviceUrl.defaultZone=http://server1:1000/eureka/,http://server2:2000/eureka/ 再然后就是创建项目时生成的类中加入@EnableDiscoveryClient参数开启自动装配,以及注入服务消费模板并开启负载均衡: @Bean @LoadBalanced RestTemplate restTemplate(){ return new RestTemplate(); } 之后的这个步骤实际不是必要的,只是为了能够更直观的在页面中看到结果,所以加入一个controller类,输出服务的一些基本信息: @RestController public class ConsumerController { @Autowired RestTemplate restTemplate; @RequestMapping(value="/hello",method=RequestMethod.GET) public String hello(){ return restTemplate.getForEntity("http://HELLO-SERVICE/hello", String.class).getBody(); } } 那么当我们启动这个消费端以后,页面访问localhost:3001/hello就可以看到如下页面:

优秀的个人博客,低调大师

java B2B2C Springcloud电子商务平台源码-eureka集群整合config配置中心

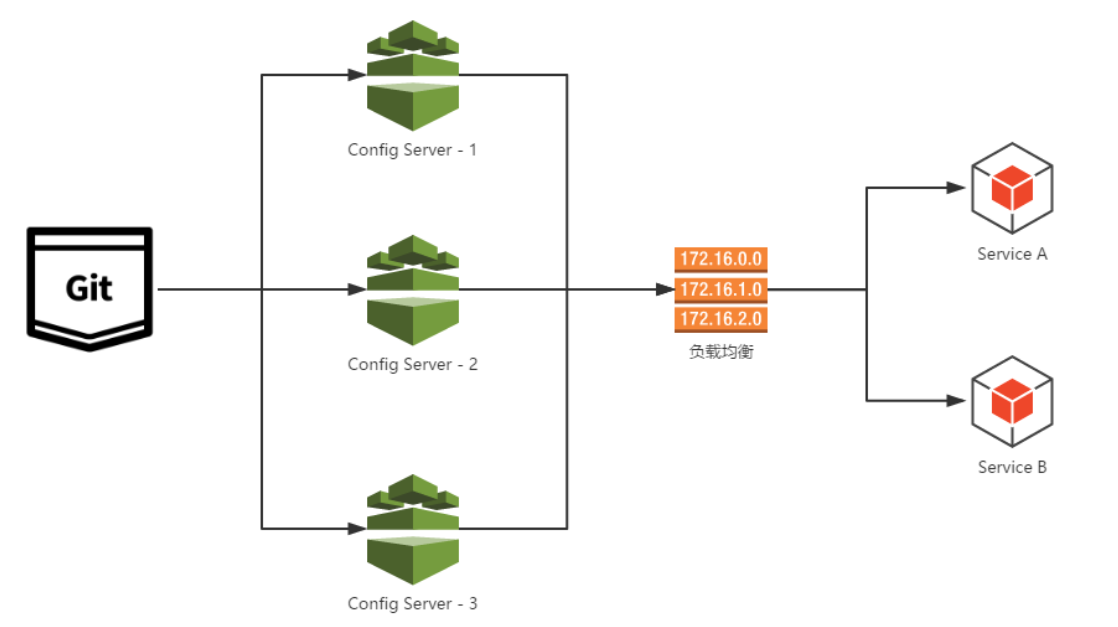
eureka集群-整合config配置中心 加入依赖 <dependencies> <!-- 监控 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> <!-- 安全验证 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-security</artifactId> </dependency> <!-- Netflix --> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-config-server</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> </dependencies> application.yml server: port: 8881 spring: application: name: tms-config cloud: config: server: git: uri: 仓库地址 searchPaths: 目录 username: 用户名 password: 密码 label: master eureka: instance: prefer-ip-address: true lease-renewal-interval-in-seconds: 30 lease-expiration-duration-in-seconds: 90 metadata-map: name: tms-config-metadata-map-name client: serviceUrl: defaultZone: http://admin:admin@192.168.1.109:8761/eureka/, http://admin:admin@192.168.1.109:8762/eureka/ # 抓取服务列表时间间隔 registry-fetch-interval-seconds: 30 endpoints: sensitive: false shutdown: enabled: true sensitive: true security: user: name: admin password: admin role: SUPERUSER management: context-path: /tms-config security: roles: SUPERUSER #角色 # 日志 logging: file: logs/logger.log level: com.netflix: DEBUG org.springframework.web: DEBUG org.springframework.security: INFO 启动项 @SpringBootApplication @EnableConfigServer @EnableEurekaClient public class TmsConfigApplication { public static void main(String[] args) { SpringApplication.run(TmsConfigApplication.class, args); } } 调用者配置 ,注意这里要用此配置文件名 bootstrap.yml spring: application: name: tms-client cloud: config: label: master profile: dev username: admin password: admin discovery: enabled: true service-id: tms-config eureka: client: serviceUrl: defaultZone: http://admin:admin@192.168.1.109:8761/eureka/, http://admin:admin@192.168.1.109:8762/eureka/ 读取配置文件内容 @RestController public class TestController { @Value("${apuserName}") private String apuserName; @GetMapping(value = "/hello") public String hello() { return apuserName; } } //需要JAVA Spring Cloud大型企业分布式微服务云构建的B2B2C电子商务平台源码 一零三八七七四六二六 java B2B2C 仿淘宝电子商城系统

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册