首页 文章 精选 留言 我的

精选列表

搜索[Emacs化],共10000篇文章
优秀的个人博客,低调大师

(五)Java工程化--Jenkins

Jenkins简介 Jenkins 是一种用Java语言实现的持续集成工具,Jenkins是一个平台, 在此基础上实现下面两个目的. CI 持续集成(Continous Integration) CD 持续交付(Continous Delivery) 安装 下载地址: https://jenkins.io/ 文件名为jenkins.war 启动命令:java -jar jenkins.war --httpPort=8099 访问http://localhost:8099 第一次访问会有guide,按guide配置好用户/插件等 插件安装:建议安装推荐的插件, 如不安装插件有的配置项出不来;系统管理-->插件管理-->可选插件 可以查找和安装插件 配置 (进入“系统管理”菜单) 全局工具配置 点击 系统管理-->全局工具配置 在此目录下配置JDK和MAVEN环境,以及git; (不安装git相关插件看不到配置项) JDK和Maven是配置home路径, git需要配置git.exe文件的全路径 创建任务 Jenkins的学习主要是要自己动手, 本文不再截图凑篇幅, 实践中遇到相应问题可以从管网查找资料,该下载插件的下插件,该在流程中作相应配置的做配置. 在我从上家公司离职之前的几个月, 公司的运维正在做CI方面的工作, 其间也是根据实际情况慢慢摸索, 一方面是要满足各种不同语言,项目,场景的CI, 另一方面也证实Jenkins的强大适应性,丰富的插件几乎能满足各种需求.

优秀的个人博客,低调大师

Python数据持久化-小测验

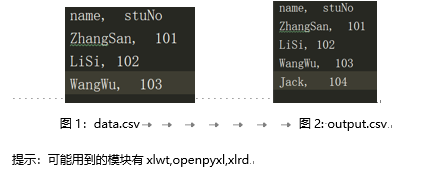
2018年7月13日考试 1.Python读写csv文件 现有如下图1所示的data.csv文件数据,请使用python读取该csv文件数据,并添加一条记录后输出如图2所示的output.csv文件(10分) 题1.png 这一题需要用到的csv文件 data.csv下载链接: https://pan.baidu.com/s/1JCUCU4vXBQNwOx2xhAjDqA 密码: pbpx 第1题 import csv def printCsv(csvName): with open(csvName) as csvFile: reader = csv.reader(csvFile) for i in reader: print(i) if __name__ == "__main__": inCsv = "data.csv" outCsv = "output.csv" with open(inCsv) as csvFile: reader = csv.reader(csvFile) data = list(reader) print("原csv文件data.csv的数据内容:") printCsv(inCsv) data.append(['Jack','104']) with open(outCsv,'w',\ newline='') as csvFile: writer = csv.writer(csvFile) writer.writerows(data) print("新产生的csv文件output.csv的数据内容:") printCsv(outCsv) 上面一段代码的运行结果如下: 原csv文件data.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] 新产生的csv文件output.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] ['Jack', '104'] 2.Python读写excel文件 如下所示的Excel表格数据,请编写python代码筛选出Points大于5的数据,并按Points进行排序后输出如图2所示的Excel文件结果 题2.png 这一题需要用到的excel文件 rank.xlsx下载链接: https://pan.baidu.com/s/1reS7yjxUjU1iqZc0rCjljA 密码: uymy import xlrd import xlwt if __name__ == "__main__": excel = xlrd.open_workbook("rank.xlsx") sheet = excel.sheet_by_index(0) #获取字段列表赋值给field_list,第2个字段大于5的数据列表赋值给data_list field_list = sheet.row_values(0) data_list = [] for i in range(1,sheet.nrows): if int(sheet.row_values(i)[2]) > 5: data_list.append(sheet.row_values(i)) #利用sorted内置函数排序 data_list = sorted(data_list,key=lambda x:x[2],reverse=True) #将获得的信息存入新表,命名为output.xlsx excel_w = xlwt.Workbook() sheet_w = excel_w.add_sheet("sheet1") for i in range(len(field_list)): sheet_w.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet_w.write(i+1,j,data_list[i][j]) excel_w.save("output.xls") 3.mysql数据库的sql语句 (1) 使用sql创建出如下图所示的数据表,数据库名为movies,表名为movieRank,表中包含MovieName、boxOffice、percent、days、totalBoxOffice五个字段,字段的信息如下图所示: 题3-1.png 创建语句.png (2)使用sql语句向movieRank表中添加若干条数据(材料中已提供movieData.txt) insert into movierank values("21克拉", 1031.92, 15.18, 2, 2827.06); insert into movierank values("狂暴巨兽", 2928.28, 43.07, 9, 57089.20); insert into movierank values("起跑线", 161.03, 2.37, 18, 19873.43); insert into movierank values("头号玩家", 1054.87, 15.52, 23, 127306.41); insert into movierank values("红海行动", 45.49, 0.67, 65, 364107.74); 插入数据的结果如下图所示: 插入结果图示.png (3)使用sql语句查询movieRank表中的数据并按照totalBoxOffice字段进行排序 select * from movierank order by totalboxoffice; (4)使用sql语句计算出字段totalBoxOffice字段的总和 select sum(totalboxoffice) from movierank; 4.Python操作mysql数据库 此题接第3题题干,在第三题的基础上完成以下需求: (1)编写python代码连接mysql数据库,并向movieRank表中新添加两条数据(已提供second.txt) import pymysql def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": conn = getConn("movies") cursor = conn.cursor() insert_sql = 'insert into movierank values'\ '("犬之岛", 617.35, 9.08, 2, 1309.09),'\ '("湮灭", 135.34, 1.99, 9 , 5556.77)' cursor.execute(insert_sql) conn.commit() conn.close() (2)编写python代码,查询出所有的电影数据,并输出到一个Excel表movieRank.xlsx中,如下图所示 题4-2.png import pymysql import xlwt def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": #从mysql数据库中取出数据赋值给data_list,其数据类型为元组 conn = getConn("movies") cursor = conn.cursor() select_sql = "select * from movierank " cursor.execute(select_sql) data_list = cursor.fetchall() field_list = [k[0] for k in cursor.description] #把data_list中的数据存入新的excel中,并命名为movieRank.xls excel = xlwt.Workbook() sheet = excel.add_sheet("sheet1") for i in range(len(field_list)): sheet.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet.write(i+1,j,data_list[i][j]) excel.save("movieRank.xls") 5.Python操作MongoDB数据库 (1)编写python代码连接MongoDB数据库,并新建一个building库,在building库下新建一个rooms表 from pymongo import MongoClient if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.create_collection("rooms") (2)编写python代码读取rooms.csv文件的中的数据,并将数据插入到rooms表中,添加到rooms表中的数据结构如下图所示 image.png 这一题需要用到的csv文件rooms.csv下载链接: https://pan.baidu.com/s/10fyct-J3a0txtS-EZaaxAQ 密码: je33 from pymongo import MongoClient import csv if __name__ == "__main__": with open("rooms.csv") as csvFile: reader = list(csv.reader(csvFile)) field_list = reader[0] data_list = reader[1:] conn = MongoClient("localhost") db = conn.building rooms = db.rooms insert_list = [] for data in data_list: insert_list.append( {key:value for key,value in zip(field_list,data)}) rooms.insert_many(insert_list) 使用csv.DictReader方法 from pymongo import MongoClient import csv if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.rooms with open("rooms.csv") as csvFile: reader = csv.DictReader(csvFile) for row in reader: rooms.insert_one(dict(row))

优秀的个人博客,低调大师

Python数据持久化-mysql篇

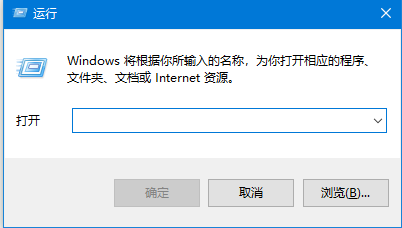
1.下载pymysql模块 pymysql模块对python3的支持比较好 安装命令:pip install pymysql 2.新建一个数据库 会用可视化工具hedisql或者navicat创建数据库则跳过此步 打开cmd或者PoweShell 打开方式是windows+R组合键 具体操作为:在按住windows键的情况,再按R键 windows键在键盘左下方,下方第一行从左往右数第二个有windows图标的键就是windows键 呼唤出窗口如下图所示: 图片.png-7kB 在 运行窗口中输入powershell 图片.png-6.9kB 点击上图中的确定后,如下图所示。 图片.png-4kB 在PowerShell中输入命令并运行: mysql -u root -p 图片.png-4.6kB 输入root用户对应的密码后,运行如下图所示: 图片.png-11.6kB 在mysql中输入命令并运行: create database pydb 图片.png-9.5kB 出现上图所示,则成功创建数据库。 3.编辑py文件 3.1插入数据 import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("drop table if exists test") cursor.execute("create table test(id int,name varchar(20))") cursor.execute('insert into test values(1,"小明")') cursor.execute('insert into test values(2,"小红")') cursor.execute('insert into test values(3,"小王")') conn.commit() conn.close() 3.2查询数据 cursor.fetchall()函数示例: import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchall() for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') (3, '小王') cursor.fetchmany()函数示例: import pymysql if __name__ == "__main__": args = dict( host='localhost', user='root', passwd='...your password', db='pydb', charset='utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchmany(2) for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') 小结 关键是mysql的sql语句要熟练,python连接mysql数据库后对相应的数据库利用cursor.execute()方法进行操作。 完成操作后要提交,即conn.commit();关闭连接,即conn.close()

优秀的个人博客,低调大师

jenkins docker springcloud 自动化

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80632522 由于公司要做微服务所以我对jenkins docker springcloud如何集成起来做自动部署做了一些研究,这里写出来也算是结自己一个总结,同时也希望能帮助到其他人。 我这里环境如下: Contos7 64 jdk-8u144-linux-x64.tar.gz jenkins.war 2.78 docker gitlab maven git 因为jenkins是java 编写的所以需要安装jdk安装步骤很简单这大概也就是一步: 进入jdk的目录 cd /usr/local 我这里是/usr/local这个目录 查看目录下文件 ls -il 解压jdktar zxvf jdk-8u144-linux-x64.tar.gz 配置jdk 编辑profile 文件加入jdk 环境变量 vim /etc/profile export JAVA_HOME=/usr/local/jdk1.8.0_144export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jarexport PATH=$PATH:$JAVA_HOME/bin 使用source命令使配置生效 source/etc/profile 这时我们来执行 java -version 出现下面这个就说明配置成功了。 接下来我们就可以安装jenkins了首选需要下载jenkins 下载地址 http://updates.jenkins-ci.org/download/war/ 下载后将jenkins.war上传到 /usr/local 到jenkins.war 目录下 执行 java -jar jenkins.war 或者是 java -jar httpPort=8080(这里可以指定怎么想指定的端口) jenkins.war jenkins 默认是8080 因为liunx 系统没有开放8080端口所以要开放8080端口firewall-cmd --add-port=8080/tcp --permanent 重新加载防火墙配置 firewall-cmd --reload 这时在浏览器访问 http://ip:8080 就可以看到 这是jenkins为我们自动生成的一个密钥 这个密钥可以在控制台找到 当然也可以去 这个目录下找到/root/.jenkins/secrets/initialAdminPassword这里我们到控制台去找 将这个密钥复制到文本框 点击Continue 就可以看到这个页面 这里这们选择推荐(install suggested plugins)这时可以看到已经在安装插件 安装完成后需要创建一个管理员账户 填写完成后点击 Save and finish 当进入下面这个页面后jenkins就算是安装完成了 docker 的安装我这里是安官网的安装这里就不做请说明。请参考官网 https://docs.docker.com/engine/installation/linux/docker-ce/centos/#install-using-the-repository maven 安装 首先要下载一上maven 的安装文件 使用wget下载 wget http://mirror.bit.edu.cn/apache/maven/maven-3/3.5.0/binaries/apache-maven-3.5.0-bin.tar.gz 下载完成后解压 maven :tar zxvf apache-maven-3.5.0-bin.tar.gz 配置MAVEN_HONE 环境变量 编辑 vim /etc/profile 加入下面这两句 export MAVEN_HOME=/usr/local/apache-maven-3.5.0export PATH=$PATH:$MAVEN_HOME/bin 配置生效 source /etc/profile 执行mvn -version 看到如果图说明配置成功 配置阿里云的maven repository 进入 maven conf目录下 cd /usr/local/apache-maven-3.5.0/conf 编辑settings.xml加入阿里云的maven仓库 vimsettings.xml <mirror> <id>nexus-aliyun</id> <mirrorOf>*</mirrorOf> <name>Nexus aliyun</name> <url>http://maven.aliyun.com/nexus/content/groups/public</url> </mirror> 安装git yum install -y git 安装完成执行 git --version 接下来进入主题来构建我们的第一个项目 1.在jenkins中创建一个新任务 2.构建一个自由风格的软件项目 3.配置项目构建信息 1)配置git 2)配置git web hook 安装 gitlab hook plugin 系统管理 -> 插件管理 -> 可选插件 -> 搜索 gitlab hook plugin -> 选中安装 首先说明我这里用的是私有的gitlab 如果你的机器可以公网访问那么你可以使用github 或 码云 。搭建私有gitlab请看 http://www.imooc.com/article/17128?block_id=tuijian_wz 进入点击generate生成一个token 复制 http://192.168.189.139:8080/project/microservice-discovery 进入 gitlab Settings -> Integrations -> 添加url和 token 3)配置构建环境 maven构建 增加构建步骤 -> invoker top-level-Maven targets 构建命令 clean package shell 脚本 增加构建步骤 -> Execute shell 构建前我们需要设置一下docker 的regitry通过不安全的http访问 地址以及阿里云加速器 vim /usr/lib/systemd/system/docker.service 加入如下 --registry-mirror=https://aj2rgad5.mirror.aliyuncs.com --insecure-registry 192.168.189.133:5000 完成已上步骤我们点构建就可以构建我们的项目了 从下图中可以看到已经开始在构建 构建完成后我们访问http://192.168.189.139:8761就可以看到springcloud eureak的管理页了 构建脚本如下: #!/bin/bash REGISTRY_URL=192.168.189.133:5000 WORK_DIR=/root/work_build PROJECT_NAME=microservice-provider PROJECT_VERSION=0.0.1 if [ ! -e ${WORK_DIR}/${PROJECT_NAME} ] && [ ! -d ${WORK_DIR}/${PROJECT_NAME} ]; then mkdir -p ${WORK_DIR}/${PROJECT_NAME} echo "Create Dir: ${WORK_DIR}/${PROJECT_NAME}" fi if [ -e ${WORK_DIR}/${PROJECT_NAME}/Dockerfile ]; then rm -rf ${WORK_DIR}/${PROJECT_NAME}/Dockerfile echo "Remove File: ${WORK_DIR}/${PROJECT_NAME}/Dockerfile" fi cp ./Dockerfile ${WORK_DIR}/${PROJECT_NAME}/ cp ./target/*.jar ${WORK_DIR}/${PROJECT_NAME}/ cd ${WORK_DIR}/${PROJECT_NAME}/ docker build -t ${REGISTRY_URL}/microservice/${PROJECT_NAME}:${PROJECT_VERSION} . docker push ${REGISTRY_URL}/microservice/${PROJECT_NAME}:${PROJECT_VERSION} if docker ps -a | grep ${PROJECT_NAME}; then docker rm -f ${PROJECT_NAME} echo "Remove Docker Container: ${PROJECT_NAME}" fi docker run -d -p 8761:8761 --name ${PROJECT_NAME} ${REGISTRY_URL}/microservice/${PROJECT_NAME}:${PROJECT_VERSION}

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册