Python爬虫入门教程 3-100 美空网数据爬取
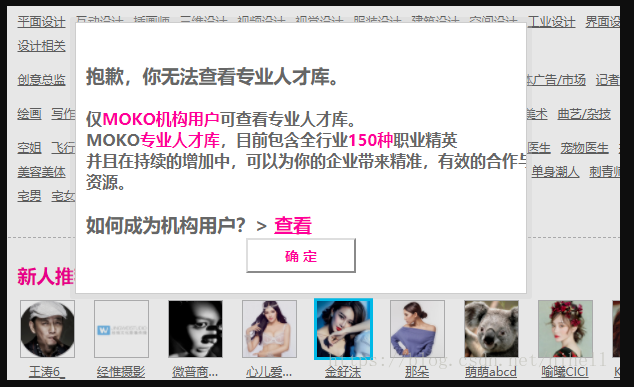
1.美空网数据-简介 从今天开始,我们尝试用2篇博客的内容量,搞定一个网站叫做“美空网”网址为:http://www.moko.cc/, 这个网站我分析了一下,我们要爬取的图片在 下面这个网址 http://www.moko.cc/post/1302075.html 然后在去分析一下,我需要找到一个图片列表页面是最好的,作为一个勤劳的爬虫coder,我找到了这个页面 http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/list.html 列表页面被我找到了,貌似没有分页,这就简单多了,但是刚想要爬,就翻车了,我发现一个严重的问题。 http://www.moko.cc/post/==da39db43246047c79dcaef44c201492d==/list.html 我要做的是一个自动化的爬虫,但是我发现,出问题了,上面那个黄色背景的位置是啥? ID,昵称,个性首页,这个必须要搞定。 我接下来随机的找了一些图片列表页,试图找到规律到底是啥? http://www.moko.cc/post/978c74a0375f4edca114e87b0a45a0b5/list.html http://www.moko.cc/post/jundayi/list.html http://www.moko.cc/post/slavik/list.html ...... 没什么问题,发现规律了 http://www.moko.cc/post/==个性昵称(中文昵称是一个加密的串)==/list.html 这就有点意思了,我要是能找到尽量多的昵称,不就能拼接出来我想要得所有地址了吗 开干!!! 手段,全站乱点,找入口,找切入点,找是否有API .... .... 结果没找着 下面的一些备选方案 趴这个页面,发现只有 20页 http://www.moko.cc/channels/post/23/1.html 每页48个模特,20页。那么也才960人啊,完全覆盖不到尽可能多的用户。 接着又找到 http://www.moko.cc/catalog/index.html 这个页面 确认了一下眼神,以为发现问题了,结果 哎呀,还么有权限,谁有权限,可以跟我交流一下,一时激动,差点去下载他们的APP,然后进行抓包去。 上面两条路,都不好弄,接下来继续找路子。 无意中,我看到了一丝曙光 关注名单,点进去 哈哈哈,OK了,这不就是,我要找到的东西吗? 不多说了,爬虫走起,测试一下他是否有反扒机制。 我找到了一个关注的人比较多的页面,1500多个人 http://www.moko.cc/subscribe/chenhaoalex/1.html 然后又是一波分析操作 2.美空网数据- 爬虫数据存储 确定了爬虫的目标,接下来,我做了两件事情,看一下,是否对你也有帮助 确定数据存储在哪里?最后我选择了MongoDB 用正则表达式去分析网页数据 对此,我们需要安装一下MongoDB,安装的办法肯定是官网教程啦! https://docs.mongodb.com/master/tutorial/install-mongodb-on-red-hat/ 如果官方文档没有帮助你安装成功。 那么我推荐下面这篇博客 https://www.cnblogs.com/hackyo/p/7967170.html 安装MongoDB出现如下结果 恭喜你安装成功了。 接下来,你要学习的是 关于mongodb用户权限的管理 http://www.cnblogs.com/shiyiwen/p/5552750.html mongodb索引的创建 https://blog.csdn.net/salmonellavaccine/article/details/53907535 别问为啥我不重新写一遍,懒呗~~~ 况且这些资料太多了,互联网大把大把的。 一些我经常用的mongdb的命令 链接 mongo --port <端口号> 选择数据库 use admin 展示当前数据库 db 当前数据库授权 db.auth("用户名","密码") 查看数据库 show dbs 查看数据库中的列名 show collections 创建列 db.createCollection("列名") 创建索引 db.col.ensureIndex({"列名字":1},{"unique":true}) 展示所有索引 db.col.getIndexes() 删除索引 db.col.dropIndex("索引名字") 查找数据 db.列名.find() 查询数据总条数 db.列名.find().count() 上面基本是我最常用的了,我们下面实际操作一把。 用Python链接MongoDB 使用 pip3 安装pymongo库 使用pymongo模块连接mongoDB数据库 一些准备工作 创建dm数据库 链接上mongodb 在终端使用命令 mongo --port 21111 [linuxboy@localhost ~]$ mongo --port 21111 MongoDB shell version v3.6.5 connecting to: mongodb://127.0.0.1:21111/ MongoDB server version: 3.6.5 > 配置用户权限:接着上面输入命令 show dbs 查看权限 权限不足 创建管理用户 db.createUser({user: "userAdmin",pwd: "123456", roles: [ { role: "userAdminAnyDatabase", db: "admin" } ] } ) 授权用户 db.auth("userAdmin","123456") 查看权限 > db.auth("userAdmin","123456") 1 > show dbs admin 0.000GB config 0.000GB local 0.000GB moko 0.013GB test 0.000GB > 接下来创建 dm数据库<在这之前还需要创建一个读写用户> > use dm switched to db dm > db dm > db.createUser({user: "dba",pwd: "dba", roles: [ { role: "readWrite", db: "dm" } ] } ) Successfully added user: { "user" : "dba", "roles" : [ { "role" : "readWrite", "db" : "dm" } ] } > 重新授权 db.auth("dba","dba") 创建一列数据 > db.createCollection("demo") { "ok" : 1 } > db.collections dm.collections > show collections demo > Python实现插入操作 import pymongo as pm #确保你已经安装过pymongo了 # 获取连接 client = pm.MongoClient('localhost', 21111) # 端口号是数值型 # 连接目标数据库 db = client.dm # 数据库用户验证 db.authenticate("dba", "dba") post = { "id": "111111", "level": "MVP", "real":1, "profile": '111', 'thumb':'2222', 'nikename':'222', 'follows':20 } db.col.insert_one(post) # 插入单个文档 # 打印集合第1条记录 print (db.col.find_one()) 编译执行 [linuxboy@bogon moocspider]$ python3 mongo.py {'_id': ObjectId('5b15033cc3666e1e28ae5582'), 'id': '111111', 'level': 'MVP', 'real': 1, 'profile': '111', 'thumb': '2222', 'nikename': '222', 'follows': 20} [linuxboy@bogon moocspider]$ 好了,我们到现在为止,实现了mongodb的插入问题。 3.美空网数据-用Python 爬取关注对象 首先,我需要创造一个不断抓取链接的类 这个类做的事情,就是分析 http://www.moko.cc/subscribe/chenhaoalex/1.html 这个页面,总共有多少页,然后生成链接 抓取页面中的总页数为77 正则表达式如下 onfocus=\"this\.blur\(\)\">(\d*?)< 在这里,由所有的分页都一样,所以,我匹配了全部的页码,然后计算了数组中的最大值 #获取页码数组 pages = re.findall(r'onfocus=\"this\.blur\(\)\">(\d*?)<',content,re.S) #获取总页数 page_size = 1 if pages: #如果数组不为空 page_size = int(max(pages)) #获取最大页数 接下来就是我们要搞定的生产者编码阶段了,我们需要打造一个不断获取连接的爬虫 简单的说就是 我们需要一个爬虫,不断的去爬取 http://www.moko.cc/subscribe/chenhaoalex/1.html 这个页面中所有的用户,并且还要爬取到总页数。 比如查看上述页面中,我们要获取的关键点如下 通过这个页面,我们要得到,这样子的一个数组,注意下面数组中有个位置【我用爬虫爬到的】这个就是关键的地方了 all_urls = [ "http://www.moko.cc/subscribe/chenhaoalex/1.html", "http://www.moko.cc/subscribe/chenhaoalex/2.html", "http://www.moko.cc/subscribe/chenhaoalex/3.html", "http://www.moko.cc/subscribe/chenhaoalex/4.html", ...... "http://www.moko.cc/subscribe/dde760d5dd6a4413aacb91d1b1d76721/1.html" "http://www.moko.cc/subscribe/3cc82db2231a4449aaa97ed8016b917a/1.html" "http://www.moko.cc/subscribe/d45c1e3069c24152abdc41c1fb342b8f/1.html" "http://www.moko.cc/subscribe/【我用爬虫爬到的】/1.html" ] 引入必备模块 # -*- coding: UTF-8 -*- import requests #网络请求模块 import random #随机模块 import re #正则表达式模块 import time #时间模块 import threading #线程模块 import pymongo as pm #mongodb模块 接下来,我们需要准备一个通用函数模拟UserAgent做一个简单的反爬处理 class Config(): def getHeaders(self): user_agent_list = [ \ "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/22.0.1207.1 Safari/537.1" \ "Mozilla/5.0 (X11; CrOS i686 2268.111.0) AppleWebKit/536.11 (KHTML, like Gecko) Chrome/20.0.1132.57 Safari/536.11", \ "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1092.0 Safari/536.6", \ "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1090.0 Safari/536.6", \ "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/19.77.34.5 Safari/537.1", \ "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.9 Safari/536.5", \ "Mozilla/5.0 (Windows NT 6.0) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.36 Safari/536.5", \ "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \ "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \ "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_8_0) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \ "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.0 Safari/536.3", \ "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24", \ "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24" ] UserAgent=random.choice(user_agent_list) headers = {'User-Agent': UserAgent} return headers 编写生产者的类和核心代码,Producer继承threading.Thread #生产者 class Producer(threading.Thread): def run(self): print("线程启动...") headers = Config().getHeaders() if __name__ == "__main__": p = Producer() p.start() 测试运行,一下,看是否可以启动 [linuxboy@bogon moocspider]$ python3 demo.py 线程启动... {'User-Agent': 'Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24'} [linuxboy@bogon moocspider]$ 如果上面的代码没有问题,接下来就是我们爬虫代码部分了,为了方便多线程之间的调用,我们还是创建一个共享变量在N个线程之间调用 # -*- coding: UTF-8 -*- import requests import random import re import time import threading import pymongo as pm # 获取连接 client = pm.MongoClient('localhost', 21111) # 端口号是数值型 # 连接目标数据库 db = client.moko # 数据库用户验证 db.authenticate("moko", "moko") urls = ["http://www.moko.cc/subscribe/chenhaoalex/1.html"] index = 0 #索引 g_lock = threading.Lock() #初始化一个锁 #生产者 class Producer(threading.Thread): def run(self): print("线程启动...") headers = Config().getHeaders() print(headers) global urls global index while True: g_lock.acquire() if len(urls)==0: g_lock.release() continue page_url = urls.pop() g_lock.release() #使用完成之后及时把锁给释放,方便其他线程使用 response = "" try: response = requests.get(page_url,headers=headers,timeout=5) except Exception as http: print("生产者异常") print(http) continue content = response.text rc = re.compile(r'<a class=\"imgBorder\" href=\"\/(.*?)\" hidefocus=\"true\">') follows = rc.findall(content) print(follows) fo_url = [] threading_links_2 = [] for u in follows: this_url = "http://www.moko.cc/subscribe/%s/1.html" % u g_lock.acquire() index += 1 g_lock.release() fo_url.append({"index":index,"link":this_url}) threading_links_2.append(this_url) g_lock.acquire() urls += threading_links_2 g_lock.release() print(fo_url) try: db.text.insert_many(fo_url,ordered=False ) except: continue if __name__ == "__main__": p = Producer() p.start() 上面代码除了基本操作以外,我做了一些细小的处理 现在说明如下 fo_url.append({"index":index,"link":this_url}) 这部分代码,是为了消费者使用时候,方便进行查找并且删除操作而特意改造的,增加了一个字段index作为标识 第二个部分,插入数据的时候,我进行了批量的操作使用的是insert_many函数,并且关键的地方,我增加了一个ordered=False的操作,这个地方大家可以自行研究一下,我的目的是去掉重复数据,默认情况下insert_many函数如果碰到数据重复,并且在mongodb中创建了索引==创建索引的办法,大家自行翻阅文章上面==,那么是无法插入的,但是这样子会插入一部分,只把重复的地方略过,非常方便。 关于pymongo的使用,大家可以参考官网手册 这个是 pymongo的官方教程 http://api.mongodb.com/python/current/api/pymongo/collection.html?highlight=insert_many#pymongo.collection.Collection.insert_many MongoDB的手册大家也可以参考 https://docs.mongodb.com/manual/reference/method/db.collection.insertMany/ db.text.insert_many(fo_url,ordered=False ) 我们链接上MongoDB数据库,查询一下我们刚刚插入的数据 > show collections col links text > db.text moko.text > db.text.find() { "_id" : ObjectId("5b1789e0c3666e642364a70b"), "index" : 1, "link" : "http://www.moko.cc/subscribe/dde760d5dd6a4413aacb91d1b1d76721/1.html" } { "_id" : ObjectId("5b1789e0c3666e642364a70c"), "index" : 2, "link" : "http://www.moko.cc/subscribe/3cc82db2231a4449aaa97ed8016b917a/1.html" } ....... { "_id" : ObjectId("5b1789e0c3666e642364a71e"), "index" : 20, "link" : "http://www.moko.cc/subscribe/8c1e4c738e654aad85903572f9090adb/1.html" } Type "it" for more 其实上面代码,有一个非常严重的BUG,就是当我们实际操作的时候,发现,我们每次获取到的都是我们使用this_url = "http://www.moko.cc/subscribe/%s/1.html" % u 进行拼接的结果。 也就是说,我们获取到的永远都是第1页。这个按照我们之前设计的就不符合逻辑了, 我们还要获取到分页的内容,那么这个地方需要做一个简单的判断,就是下面的逻辑了。 ==如果完整代码,大家不知道如何观看,可以直接翻阅到文章底部,有对应的github链接== #如果是第一页,那么需要判断一下 #print(page_url) is_home =re.search(r'(\d*?)\.html',page_url).group(1) if is_home == str(1): pages = re.findall(r'onfocus=\"this\.blur\(\)\">(\d*?)<',content,re.S) #获取总页数 page_size = 1 if pages: page_size = int(max(pages)) #获取最大页数 if page_size > 1: #如果最大页数大于1,那么获取所有的页面 url_arr = [] threading_links_1 = [] for page in range(2,page_size+1): url = re.sub(r'(\d*?)\.html',str(page)+".html",page_url) threading_links_1.append(url) g_lock.acquire() index += 1 g_lock.release() url_arr.append({ "index":index, "link": url}) g_lock.acquire() urls += threading_links_1 # URL数据添加 g_lock.release() try: db.text.insert_many(url_arr,ordered=False ) except Exception as e: print("数据库输入异常") print (e) continue else: pass else: pass 截止到现在为止,其实你已经实现了链接的生产者了 。 我们在MongoDB中生成了一堆链接,接下来就是使用阶段了。 使用起来也是非常简单。 我先给大家看一个比较复杂的正则表达式爬虫写的好不好,正则表达式站很重要的比例哦~ divEditOperate_(?P<ID>\d*)[\"] .*>[\s\S]*?<p class=\"state\">.*?(?P<级别>\w*P).*</span></span>(?P<是否认证><br/>)?.*?</p>[\s\S]*?<div class=\"info clearfix\">[\s\S]*?<a class=\"imgBorder\" href=\"\/(?P<主页>.*?)\" hidefocus=\"true\">[\s\S]*?<img .*?src=\"(?P<头像>.*?)\".*?alt=\".*?\" title=\"(?P<昵称>.*?)\" />[\s\S]*?<p class=\"font12 lesserColor\">(?P<地点>.*?) .*?<span class=\"font12 mainColor\">(?P<粉丝数目>\d*?)</span> 上面这个正则表达式,就是我为 http://www.moko.cc/subscribe/chenhaoalex/1.html 这个页面专门准备的。 这样子,我就可以直接获取到我想要的所有数据了。 消费者的代码如下 get_index = 0 #消费者类 class Consumer(threading.Thread): def run(self): headers = Config().getHeaders() global get_index while True: g_lock.acquire() get_index += 1 g_lock.release() #从刚才数据存储的列里面获取一条数据,这里用到find_one_and_delete方法 #get_index 需要声明成全局的变量 link = db.links.find_one_and_delete({"index":get_index}) page_url = "" if link: page_url = link["link"] print(page_url+">>>网页分析中...") else: continue response = "" try: response = requests.get(page_url,headers=headers,timeout=5) except Exception as http: print("消费者有异常") print(http) continue content = response.text rc = re.compile(r'divEditOperate_(?P<ID>\d*)[\"] .*>[\s\S]*?<p class=\"state\">.*?(?P<级别>\w*P).*</span></span>(?P<是否认证><br/>)?.*?</p>[\s\S]*?<div class=\"info clearfix\">[\s\S]*?<a class=\"imgBorder\" href=\"\/(?P<主页>.*?)\" hidefocus=\"true\">[\s\S]*?<img .*?src=\"(?P<头像>.*?)\".*?alt=\".*?\" title=\"(?P<昵称>.*?)\" />[\s\S]*?<p class=\"font12 lesserColor\">(?P<地点>.*?) .*?<span class=\"font12 mainColor\">(?P<粉丝数目>\d*?)</span>') user_info = rc.findall(content) print(">>>>>>>>>>>>>>>>>>>>") users = [] for user in user_info: post = { "id": user[0], "level": user[1], "real":user[2], "profile": user[3], 'thumb':user[4], 'nikename':user[5], 'address':user[6], 'follows':user[7] } users.append(post) print(users) try: db.mkusers.insert_many(users,ordered=False ) except Exception as e: print("数据库输入异常") print (e) continue time.sleep(1) print("<<<<<<<<<<<<<<<<<<<<") 当你使用python3 demo.py 编译demo之后,屏幕滚动如下结果,那么你成功了。 接下来就可以去数据库查阅数据去了。 [linuxboy@bogon moocspider]$ python3 demo.py 线程启动... {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3'} http://www.moko.cc/subscribe/chenhaoalex/2.html>>>网页分析中... ['dde760d5dd6a4413aacb91d1b1d76721', '3cc82db2231a4449aaa97ed8016b917a', 'a1835464ad874eec92ccbb31841a7590', 'c9ba6a47a246494398d4e26c1e0b7e54', '902fe175e668417788a4fb5d4de7ab99', 'dcb8f11265594f17b821a6d90caf96a7', '7ea0a96621eb4ed99c9c642936559c94', 'd45c1e3069c24152abdc41c1fb342b8f', 'chenyiqiu', '798522844', 'MEERILLES', 'ddfd9e1f7dca4cffb2430caebd2494f8', 'd19cbd37c87e400e9da42e159560649b', 'ac07e7fbfde14922bb1d0246b9e4374d', '05abc72ac7bb4f738f73028fed17ac23', 'hanzhuoer', 'e12e15aaee654b8aa9f528215bc3294c', '3b6d8dc6fd814789bd484f393b5c9fa8', '83256b93a2f94f449ab75c730cb80a7b', '8c1e4c738e654aad85903572f9090adb'] [{'index': 77, 'link': 'http://www.moko.cc/subscribe/dde760d5dd6a4413aacb91d1b1d76721/1.html'}, {'index': 78, 'link': 'http://www.moko.cc/subscribe/3cc82db2231a4449aaa97ed8016b917a/1.html'}, {'index': 79, 'link': 'http://www.moko.cc/subscribe/a1835464ad874eec92ccbb31841a7590/1.html'}, {'index': 80, 'link': 'http://www.moko.cc/subscribe/c9ba6a47a246494398d4e26c1e0b7e54/1.html'}, {] >>>>>>>>>>>>>>>>>>>> [{'id': '3533155', 'level': 'MP', 'real': '', 'profile': 'b1a7e76455cc4ca4b81ed800ab68b308', 'thumb': 'http://img.mb.moko.cc/2018-02-17/d7db42d4-7f34-46d2-a760-c88eb90d6e0d.jpg', 'nikename': '模特九九', 'address': '大连', 'follows': '10'}, {'id': '3189865', 'level': 'VIP', 'real': '', 'profile': 'cfdf1482a9034f65a60bc6a1cf8d6a02', 'thumb': 'http://img.mb.moko.cc/2016-09-30/98c1ddd3-f9a8-4a15-a106-5d664fa7b558.jpg', 'nikename': '何应77', 'address': '杭州', 'follows': '219'}, {'id': '14886', 'level': 'VIP', 'real': '<br/>', 'profile': 'cndp', 'thumb': 'http://img2.moko.cc/users/0/49/14886/logo/img2_des_x3_10100286.jpg', 'nikename': '多拍PGirl', 'address': '北京', 'follows': '2331'}, {'id': '3539257', 'level': 'MP', 'real': '<br/>', 'profile': '605c8fb2824049aa841f21858a7fd142', 'thumb': 'http://img.mb.moko.cc/2018-02': 记得处理数据的时候去掉重复值 >show collections col links mkusers text > db.mkusers.find() { "_id" : ObjectId("5b17931ec3666e6eff3953bc"), "id" : "3533155", "level" : "MP", "real" : "", "profile" : "b1a7e76455cc4ca4b81ed800ab68b308", "thumb" : "http://img.mb.moko.cc/2018-02-17/d7db42d4-7f34-46d2-a760-c88eb90d6e0d.jpg", "nikename" : "模特九九", "address" : "大连", "follows" : "10" } { "_id" : ObjectId("5b17931ec3666e6eff3953bd"), "id" : "3189865", "level" : "VIP", "real" : "", "profile" : "cfdf1482a9034f65a60bc6a1cf8d6a02", "thumb" : "http://img.mb.moko.cc/2016-09-30/98c1ddd3-f9a8-4a15-a106-5d664fa7b558.jpg", "nikename" : "何应77", "address" : "杭州", "follows" : "219" } { "_id" : ObjectId("5b17931ec3666e6eff3953be"), "id" : "14886", "level" : "VIP", "real" : "<br/>", "profile" : "cndp", "thumb" : "http://img2.moko.cc/users/0/49/14886/logo/img2_des_x3_10100286.jpg", "nikename" : "多拍PGirl", "address" : "北京", "follows" : "2331" } { "_ 最后一步,如果你想要把效率提高,修改线程就好了 if __name__ == "__main__": for i in range(5): p = Producer() p.start() for i in range(7): c = Consumer() c.start() 经过3个小时的爬取,我获取了70000多美空的用户ID,原则上,你可以获取到所有的被关注者的,不过这些数据对我们测试来说,已经足够使用。