首页 文章 精选 留言 我的

精选列表

搜索[天工3.1],共7277篇文章
优秀的个人博客,低调大师

JS 网页全自动翻译 v3.1 发布,解决动态数据渲染漏翻译问题

两行 js 实现 html 全自动翻译。 无需改动页面、无语言配置文件、无 API Key、对 SEO 友好! 升级说明 增加 translate.request.listener ,解决某些框架动态加载数据页面渲染时,有时导致漏翻译的问题 增加 translate.language.translateLanguagesRange 设置只对指定语种进行翻译 增加 translate.selectLanguageTag.refreshRender(); 重新绘制 select 语种下拉选择; 大幅优化 translate.language.recognition 对批量文本语种识别的精确度; 增加 translate.selectLanguageTag.documentId 的自定义设置; 增加对元素整体翻译对特殊字符 \ { } ^ 的适配 增加一级缓存自定义重写方式的相关文档说明 修复翻译时的图片翻译,如果图片设置的是相对路径会导致图片翻译不生效的问题 优化 msg.js 引入有http变为 https 优化 input 的 placeholder 翻译问题 优化日语字符的识别 重新优化 translate.language.getLocal() 的识别精度; 优化 translate.language.recognition 的计算方式,提高精确度 优化繁体中文的识别,全面覆盖本地语种是繁体中文的网页适配 TCDN 修复忽略 class name 失效的问题 TCDN 优化对大部分HTTPS协议源站的支持 TCDN 增加 html源文件文本替换 能力,可自定义对源站html源码进行文本替换。 TCDN 增加源站 sitemap.xml 的自定义设置 TCDN 增加生成的目标翻译站的 sitemap.xml 自动生成 在线体验 http://res.zvo.cn/translate/demo.html 快速使用 在你的网页最末尾,</html>之前,加入以下代码,会在页面的最底部出现选择语言的标签: <script src="https://cdn.staticfile.net/translate.js/3.1.7/translate.js"></script> <script> translate.language.setLocal('chinese_simplified'); //设置本地语种(当前网页的语种)。如果不设置,默认就是 'chinese_simplified' 简体中文。 可填写如 'english'、'chinese_simplified' 等,具体参见文档下方关于此的说明。 translate.service.use('client.edge'); //设置机器翻译服务通道,直接客户端本身,不依赖服务端 。相关说明参考 http://translate.zvo.cn/43086.html translate.execute(); //进行翻译 </script> 开源适配 如果您有开源项目,比如文档、cms、UI 框架、后台管理框架、等等,需要采用此进行多语言切换,欢迎喊我,无偿提供全程接入讨论及遇到的问题跟随优化,希望我们的开源项目能互相产生作用一起越来越好。

优秀的个人博客,低调大师

告别手动调度,海豚调度器 3.1.x 集群部署让你轻松管理多机!

转载自第一片心意 1 前言 由于海豚调度器官网的集群部署文档写的较乱,安装过程中需要跳转到很多地方进行操作,所以自己总结了一篇可以直接跟着从头到尾进行操作的文档,以方便后续的部署、升级、新增节点、减少节点的相关操作。 2. 提前准备 2.1. 基础组件 JDK:下载JDK (1.8+),安装并配置 JAVA_HOME 环境变量,并将其下的 bin 目录追加到 PATH 环境变量中。如果你的环境中已存在,可以跳过这步。 二进制包:在下载页面下载 DolphinScheduler 二进制包 数据库:PostgreSQL (8.2.15+) 或者 MySQL (5.7+),两者任选其一即可,如 MySQL 则需要 JDBC Driver 8 版本,可以从中央仓库下载。 注册中心:ZooKeeper (3.4.6+),下载地址。 进程树分析 macOS安装pstree Fedora/Red/Hat/CentOS/Ubuntu/Debian安装psmisc。 注意: DolphinScheduler 本身不依赖 Hadoop、Hive、Spark 等,但如果你运行的任务需要依赖他们,就需要有对应的环境支持。 3. 上传 上传二进制包,并且解压到某个目录,具体目录位置,自己定即可。 要注意目录名称,最好在后面加一些字符,要做到安装目录和二进制包解压目录不同名,以进行区分。 tar -xvf apache-dolphinscheduler-3.1.7-bin.tar.gz mv apache-dolphinscheduler-3.1.7-bin dolphinscheduler-3.1.7-origin 后面的 -origin 表示这是原始的二进制包解压文件,后续有配置改动时,可以修改改目录下的文件,然后重新执行安装脚本。 4. 用户 4.1. 配置用户免密及权限 创建部署用户,并且一定要配置 sudo 免密。以创建 dolphinscheduler 用户为例: # 创建用户需使用 root 登录 useradd dolphinscheduler # 添加密码 echo "dolphinscheduler" | passwd --stdin dolphinscheduler # 配置 sudo 免密 sed -i '$adolphinscheduler ALL=(ALL) NOPASSWD: ALL' /etc/sudoers sed -i 's/Defaults requirett/#Defaults requirett/g' /etc/sudoers # 修改目录权限,使得部署用户对二进制包解压后的 apache-dolphinscheduler-*-bin 目录有操作权限 chown -R dolphinscheduler:dolphinscheduler apache-dolphinscheduler-*-bin 注意: 因为任务执行服务是以 sudo -u {linux-user} 切换不同 linux 用户的方式来实现多租户运行作业,所以部署用户需要有 sudo 权限,而且是免密的。初学习者不理解的话,完全可以暂时忽略这一点。 如果发现 /etc/sudoers 文件中有 “Defaults requirett” 这行,也请注释掉。 4.2. 配置机器SSH免密登陆 由于安装的时候需要向不同机器发送资源,所以要求各台机器间能实现SSH免密登陆。配置免密登陆的步骤如下: su dolphinscheduler ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys # 一定要执行下面这个命令,否则免密登录会失败 chmod 600 ~/.ssh/authorized_keys 注意: 配置完成后,可以通过运行命令 ssh localhost 判断是否成功,如果不需要输入密码就能 ssh登陆,则证明成功。 5. 启动zookeeper 启动集群中的 zookeeper 即可。 6. 修改配置 下面所有的操作,均在 dolphinscheduler 用户下执行。 完成基础环境的准备后,需要根据你的机器环境修改配置文件。配置文件可以在目录 bin/env 中找到,他们分别是 install_env.sh 和 dolphinscheduler_env.sh。 6.1. install_env.sh install_env.sh 文件配置将 DolphinScheduler 安装到哪些机器 ,以及每台机器安装哪些服务。可以在路径 bin/env/ 中找到此文件,之后按照下面的说明修改对应的配置即可。 # --------------------------------------------------------- # INSTALL MACHINE # --------------------------------------------------------- # A comma separated list of machine hostname or IP would be installed DolphinScheduler, # including master, worker, api, alert. If you want to deploy in pseudo-distributed # mode, just write a pseudo-distributed hostname # Example for hostnames: ips="ds1,ds2,ds3,ds4,ds5", Example for IPs: ips="192.168.8.1,192.168.8.2,192.168.8.3,192.168.8.4,192.168.8.5" # 配置海豚调度器要安装到那些机器上 ips=${ips:-"ds01,ds02,ds03,hadoop02,hadoop03,hadoop04,hadoop05,hadoop06,hadoop07,hadoop08"} # Port of SSH protocol, default value is 22. For now we only support same port in all `ips` machine # modify it if you use different ssh port sshPort=${sshPort:-"22"} # A comma separated list of machine hostname or IP would be installed Master server, it # must be a subset of configuration `ips`. # Example for hostnames: masters="ds1,ds2", Example for IPs: masters="192.168.8.1,192.168.8.2" # 配置 master 角色要安装到哪些机器上 masters=${masters:-"ds01,ds02,ds03,hadoop04,hadoop05,hadoop06,hadoop07,hadoop08"} # A comma separated list of machine <hostname>:<workerGroup> or <IP>:<workerGroup>.All hostname or IP must be a # subset of configuration `ips`, And workerGroup have default value as `default`, but we recommend you declare behind the hosts # Example for hostnames: workers="ds1:default,ds2:default,ds3:default", Example for IPs: workers="192.168.8.1:default,192.168.8.2:default,192.168.8.3:default" # 配置 worker 角色要安装到哪些机器上,默认都放到 default 的 worker 分组内,其他分组,可以通过海豚调度器界面进行单独配置 workers=${workers:-"ds01:default,ds02:default,ds03:default,hadoop02:default,hadoop03:default,hadoop04:default,hadoop05:default,hadoop06:default,hadoop07:default,hadoop08:default"} # A comma separated list of machine hostname or IP would be installed Alert server, it # must be a subset of configuration `ips`. # Example for hostname: alertServer="ds3", Example for IP: alertServer="192.168.8.3" # 配置 alert 角色安装到哪个机器上,配置一台机器即可 alertServer=${alertServer:-"hadoop03"} # A comma separated list of machine hostname or IP would be installed API server, it # must be a subset of configuration `ips`. # Example for hostname: apiServers="ds1", Example for IP: apiServers="192.168.8.1" # 配置 api 角色安装到哪个机器上,配置一台机器即可 apiServers=${apiServers:-"hadoop04"} # The directory to install DolphinScheduler for all machine we config above. It will automatically be created by `install.sh` script if not exists. # Do not set this configuration same as the current path (pwd). Do not add quotes to it if you using related path. # 配置安装路径,将会在所有海豚集群的机器上安装服务,一定要和上面解压的二进制包目录区分开,最好带上版本号,以方便后续的升级操作。 installPath=${installPath:-"/opt/dolphinscheduler-3.1.5"} # The user to deploy DolphinScheduler for all machine we config above. For now user must create by yourself before running `install.sh` # script. The user needs to have sudo privileges and permissions to operate hdfs. If hdfs is enabled than the root directory needs # to be created by this user # 部署使用的用户,用上面自己新建的用户即可 deployUser=${deployUser:-"dolphinscheduler"} # The root of zookeeper, for now DolphinScheduler default registry server is zookeeper. # 配置注册到 zookeeper znode 名称,如果配置了多个海豚集群,则需要配置不同的名称 zkRoot=${zkRoot:-"/dolphinscheduler"} 6.2. dolphinscheduler_env.sh 可以在路径 bin/env/ 中找到此文件,该文件用来配置用到的一些环境,按照下面的说明修改对应配置即可: # JDK 路径,一定要修改 export JAVA_HOME=${JAVA_HOME:-/usr/java/jdk1.8.0_202} # 数据库类型,支持 mysql、postgresql export DATABASE=${DATABASE:-mysql} export SPRING_PROFILES_ACTIVE=${DATABASE} # 连接 url,主要修改下面的 hostname,最后配置的是东八区 export SPRING_DATASOURCE_URL="jdbc:mysql://hostname:3306/dolphinscheduler?useUnicode=true&characterEncoding=UTF-8&useSSL=false&serverTimezone=Asia/Shanghai" export SPRING_DATASOURCE_USERNAME=dolphinscheduler # 如果密码比较复杂,则需要前后使用英文单引号括起来 export SPRING_DATASOURCE_PASSWORD='xxxxxxxxxxxxx' export SPRING_CACHE_TYPE=${SPRING_CACHE_TYPE:-none} # 配置各角色 JVM 启动时使用的时区,默认为 -UTC,如果想要完全支持东八区,则设置为 -GMT+8 export SPRING_JACKSON_TIME_ZONE=${SPRING_JACKSON_TIME_ZONE:-GMT+8} export MASTER_FETCH_COMMAND_NUM=${MASTER_FETCH_COMMAND_NUM:-10} export REGISTRY_TYPE=${REGISTRY_TYPE:-zookeeper} # 配置使用的 zookeeper 地址 export REGISTRY_ZOOKEEPER_CONNECT_STRING=${REGISTRY_ZOOKEEPER_CONNECT_STRING:-hadoop01:2181,hadoop02:2181,hadoop03:2181} # 配置使用到的一些环境变量,按照自己的需要进行配置即可,所有需要的组件,都自己安装 export HADOOP_HOME=${HADOOP_HOME:-/opt/cloudera/parcels/CDH/lib/hadoop} export HADOOP_CONF_DIR=${HADOOP_CONF_DIR:-/etc/hadoop/conf} export SPARK_HOME1=${SPARK_HOME1:-/opt/soft/spark1} export SPARK_HOME2=${SPARK_HOME2:-/opt/spark-3.3.2} export PYTHON_HOME=${PYTHON_HOME:-/opt/python-3.9.16} export HIVE_HOME=${HIVE_HOME:-/opt/cloudera/parcels/CDH/lib/hive} export FLINK_HOME=${FLINK_HOME:-/opt/flink-1.15.3} export DATAX_HOME=${DATAX_HOME:-/opt/datax} export SEATUNNEL_HOME=${SEATUNNEL_HOME:-/opt/seatunnel-2.1.3} export CHUNJUN_HOME=${CHUNJUN_HOME:-/opt/soft/chunjun} export PATH=$HADOOP_HOME/bin:$SPARK_HOME1/bin:$SPARK_HOME2/bin:$PYTHON_HOME/bin:$JAVA_HOME/bin:$HIVE_HOME/bin:$FLINK_HOME/bin:$DATAX_HOME/bin:$SEATUNNEL_HOME/bin:$CHUNJUN_HOME/bin:$PATH 6.3. common.properties 从自己的 hadoop 集群上下载 hdfs-site.xml 和 core-site.xml 文件,然后放到 api-server/conf/ 和 worker-server/conf/ 目录下。如果是自己搭建的 apache 的原生集群,则从各个组件的 conf 目录下找,如果是 CDH ,则可以通过 CDH 界面直接下载。 修改 api-server/conf/ 和 worker-server/conf/ 目录下的这个文件,该文件主要用来配置资源上传相关参数,比如将海豚的资源上传到 hdfs 等,按照下面的说明修改即可: # 本地路径,主要用来存放任务运行时的临时文件,要保证用户对该文件具有读写权限,一般保持默认即可,如果后续任务运行报错说是对该目录下的文件没有操作权限,直接将该目录权限修改为 777 即可 data.basedir.path=/tmp/dolphinscheduler # resource view suffixs #resource.view.suffixs=txt,log,sh,bat,conf,cfg,py,java,sql,xml,hql,properties,json,yml,yaml,ini,js # 保存资源的地方,可用值为: HDFS, S3, OSS, NONE resource.storage.type=HDFS # 资源上传的基本路径,必须以 /dolphinscheduler 开头,要保证用户对该目录有读写权限 resource.storage.upload.base.path=/dolphinscheduler # The AWS access key. if resource.storage.type=S3 or use EMR-Task, This configuration is required resource.aws.access.key.id=minioadmin # The AWS secret access key. if resource.storage.type=S3 or use EMR-Task, This configuration is required resource.aws.secret.access.key=minioadmin # The AWS Region to use. if resource.storage.type=S3 or use EMR-Task, This configuration is required resource.aws.region=cn-north-1 # The name of the bucket. You need to create them by yourself. Otherwise, the system cannot start. All buckets in Amazon S3 share a single namespace; ensure the bucket is given a unique name. resource.aws.s3.bucket.name=dolphinscheduler # You need to set this parameter when private cloud s3. If S3 uses public cloud, you only need to set resource.aws.region or set to the endpoint of a public cloud such as S3.cn-north-1.amazonaws.com.cn resource.aws.s3.endpoint=http://localhost:9000 # alibaba cloud access key id, required if you set resource.storage.type=OSS resource.alibaba.cloud.access.key.id=<your-access-key-id> # alibaba cloud access key secret, required if you set resource.storage.type=OSS resource.alibaba.cloud.access.key.secret=<your-access-key-secret> # alibaba cloud region, required if you set resource.storage.type=OSS resource.alibaba.cloud.region=cn-hangzhou # oss bucket name, required if you set resource.storage.type=OSS resource.alibaba.cloud.oss.bucket.name=dolphinscheduler # oss bucket endpoint, required if you set resource.storage.type=OSS resource.alibaba.cloud.oss.endpoint=https://oss-cn-hangzhou.aliyuncs.com # if resource.storage.type=HDFS, the user must have the permission to create directories under the HDFS root path resource.hdfs.root.user=hdfs # if resource.storage.type=S3, the value like: s3a://dolphinscheduler; if resource.storage.type=HDFS and namenode HA is enabled, you need to copy core-site.xml and hdfs-site.xml to conf dir # resource.hdfs.fs.defaultFS=hdfs://bigdata:8020 # whether to startup kerberos hadoop.security.authentication.startup.state=false # java.security.krb5.conf path java.security.krb5.conf.path=/opt/krb5.conf # login user from keytab username login.user.keytab.username=hdfs-mycluster@ESZ.COM # login user from keytab path login.user.keytab.path=/opt/hdfs.headless.keytab # kerberos expire time, the unit is hour kerberos.expire.time=2 # resourcemanager port, the default value is 8088 if not specified resource.manager.httpaddress.port=8088 # if resourcemanager HA is enabled, please set the HA IPs; if resourcemanager is single, keep this value empty yarn.resourcemanager.ha.rm.ids=hadoop02,hadoop03 # if resourcemanager HA is enabled or not use resourcemanager, please keep the default value; If resourcemanager is single, you only need to replace ds1 to actual resourcemanager hostname yarn.application.status.address=http://ds1:%s/ws/v1/cluster/apps/%s # job history status url when application number threshold is reached(default 10000, maybe it was set to 1000) yarn.job.history.status.address=http://hadoop02:19888/ws/v1/history/mapreduce/jobs/%s # datasource encryption enable datasource.encryption.enable=false # datasource encryption salt datasource.encryption.salt=!@#$%^&* # data quality option data-quality.jar.name=dolphinscheduler-data-quality-dev-SNAPSHOT.jar #data-quality.error.output.path=/tmp/data-quality-error-data # Network IP gets priority, default inner outer # Whether hive SQL is executed in the same session support.hive.oneSession=false # use sudo or not, if set true, executing user is tenant user and deploy user needs sudo permissions; if set false, executing user is the deploy user and doesn't need sudo permissions sudo.enable=true setTaskDirToTenant.enable=false # network interface preferred like eth0, default: empty #dolphin.scheduler.network.interface.preferred= # network IP gets priority, default: inner outer #dolphin.scheduler.network.priority.strategy=default # system env path #dolphinscheduler.env.path=dolphinscheduler_env.sh # development state development.state=false # rpc port alert.rpc.port=50052 # set path of conda.sh conda.path=/opt/anaconda3/etc/profile.d/conda.sh # Task resource limit state task.resource.limit.state=false # mlflow task plugin preset repository ml.mlflow.preset_repository=https://github.com/apache/dolphinscheduler-mlflow # mlflow task plugin preset repository version ml.mlflow.preset_repository_version="main" 6.4. application.yaml 需要修改所有角色下 /conf/application.yaml 文件,包括:master-server/conf/application.yaml、worker-server/conf/application.yaml、api-server/conf/application.yaml、alert-server/conf/application.yaml,主要修改的是时区设置,具体修改如下: spring: banner: charset: UTF-8 jackson: # 将时区设置为东八区,只修改这一个地方即可 time-zone: GMT+8 date-format: "yyyy-MM-dd HH:mm:ss" 6.5. service.57a50399.js和service.57a50399.js.gz 这两个文件在 api-server/ui/assets/ 和 ui/assets/ 目录下。 分别切换到这两个目录下,然后分别找到这两个文件,之后通过 vim 命令打开,然后搜索 15e3,找到之后,将其改为 15e5。这修改的是页面响应的超时时间,默认值 15e3 表示 15 秒,我们将其改为 1500 秒,在上传大文件时,不会因为页面超时而报错。 7. 初始化数据库 驱动配置 将 mysql 驱动(8.x)拷贝到海豚调度器每个角色的 lib 目录下,包括:api-server/libs、alert-server/libs、master-server/libs、worker-server/libs、tools/libs。 数据库用户 使用 root 用户登录 mysql,然后执行以下 sql,mysql5 和 mysql8 都支持: create database `dolphinscheduler` character set utf8mb4 collate utf8mb4_general_ci; create user 'dolphinscheduler'@'%' IDENTIFIED WITH mysql_native_password by 'your_password'; grant ALL PRIVILEGES ON dolphinscheduler.* to 'dolphinscheduler'@'%'; flush privileges; 执行数据库升级脚本: bash tools/bin/upgrade-schema.sh 8. 安装 bash ./bin/install.sh 执行该脚本,会将本地的所有文件通过 scp 远程传输给上面配置文件中配置的所有机器,然后停止对应机器上的角色,之后再启动所有机器上的角色。 第一次安装之后,就已经启动了所有的角色,无需再次单独启动任何角色,如果有哪些角色没启动的话,可以去对应的机器上查看对应的日志,看具体是什么问题导致的。 9. 启停服务 # 一键停止集群所有服务 bash ./bin/stop-all.sh # 一键开启集群所有服务 bash ./bin/start-all.sh # 启停 Master bash ./bin/dolphinscheduler-daemon.sh stop master-server bash ./bin/dolphinscheduler-daemon.sh start master-server # 启停 Worker bash ./bin/dolphinscheduler-daemon.sh start worker-server bash ./bin/dolphinscheduler-daemon.sh stop worker-server # 启停 Api bash ./bin/dolphinscheduler-daemon.sh start api-server bash ./bin/dolphinscheduler-daemon.sh stop api-server # 启停 Alert bash ./bin/dolphinscheduler-daemon.sh start alert-server bash ./bin/dolphinscheduler-daemon.sh stop alert-server 一定要注意,必须使用安装海豚调度器的用户执行这些脚本,否则会有一些权限之类的问题。 每个服务在路径 <service>/conf/dolphinscheduler_env.sh 中都有 dolphinscheduler_env.sh 文件,为微服务需求提供便利。这意味着你可以在对应服务中配置 <service>/conf/dolphinscheduler_env.sh,然后通过<service>/bin/start.sh 命令基于不同的环境变量来启动各个服务。但如果使用命令 /bin/dolphinscheduler-daemon.sh start <service> 启动服务器,它将会使用文件 bin/env/dolphinscheduler_env.sh 覆盖 <service>/conf/dolphinscheduler_env.sh ,然后启动服务,这么做是为了减少用户修改配置的成本。 10. 扩容 10.1. 标准方式 参考上面的步骤,进行如下操作: 新节点 安装配置好 JDK。 新建海豚用户(Linux 用户),然后配置免密登录、权限等。 之前安装海豚调度器时解压二进制安装包的机器上。 登录安装海豚的用户。 切换到之前安装海豚调度器时解压二进制安装包,修改配置文件:bin/env/install_env.sh,在该配置文件中,修改需要在新节点上部署的角色。 执行 /bin/install.sh 文件进行安装,该脚本会按照 bin/env/install_env.sh 文件中的配置,将整个目录重新 scp 到所有的机器,之后停止所有机器上的角色,然后再启动所有角色。 该方式的缺点:如果海豚调度器上有很多分钟级别的任务,或者是 flink、spark 之类的实时任务,由于该操作会停止所有的角色,然后启动,这期间会花费一定的时间,在这期间,这些任务可能会由于整个集群的重启,从而异常停止,或者是无法被正常调度起来。但海豚调度器自己实现了自动容错和灾备等功能,所以可以这么操作,最后观察下所有任务执行是否正常。 10.2. 简单方式 参考上面的步骤,进行如下操作: 新节点 安装配置好 JDK。 新建海豚用户(Linux 用户),然后配置免密登录、权限等。 之前安装海豚调度器时解压二进制安装包的机器上。 登录安装海豚的用户。 将之前修改完配置的整个目录直接压缩,然后传输到新节点上。 新节点 在新节点上解压文件,然后将其重命名到之前配置文件 bin/env/install_env.sh 中配置的安装目录下。 登录安装海豚的用户。 需要在新节点部署哪些角色,就启动哪些角色,具体脚本位置:/bin/dolphinscheduler-daemon.sh,启动命令为: ./dolphinscheduler-daemon.sh start master-server ./dolphinscheduler-daemon.sh start worker-server 登录到海豚调度器界面,然后“监控中心”中观察,对应角色在新节点是否启动。 11.缩容 在需要下线的机器上,通过 /bin/dolphinscheduler-daemon.sh 脚本停止机器上所有的角色,停止命令为: ./dolphinscheduler-daemon.sh stop worker-server 登录到海豚调度器界面,然后“监控中心”中观察,刚才机器上停止的角色是否已经消失。 在之前安装海豚调度器时解压二进制安装包的机器上 登录安装海豚的用户。 修改配置文件:bin/env/install_env.sh,在该配置文件中,删除下线角色对应的机器。 12. 升级 按照上面的步骤,一步一步操作即可,对于已经有过的操作,无需二次操作。下面是一些具体的操作步骤: 上传新版二进制包。 解压,解压到和旧版安装目录不同的目录,或者是重命名也可以。 修改配置文件,比较简单的方式是,将上面步骤中涉及到的所有配置文件,从之前安装的目录下拷贝到新版本目录下,替换即可。 将其他节点上部署的一些组件,全部打包,然后解压放到新节点对应的位置。具体需要拷贝哪些组件,可以查看 dolphinscheduler_env.sh 文件中的配置。 配置驱动,参考《初始化数据库》中的步骤。 停止之前的集群。 备份整个数据库。 执行数据库升级脚本,参考《初始化数据库》中的步骤。 执行安装脚本,参考《安装》。 升级完成,登录界面,查看“监控中心”,看所有角色是否都成功启动。 文件转载,请标明出处。欢迎大家一起讨论技术,写的不对的地方还请大家一起讨论。 原文链接:https://blog.csdn.net/u012443641/article/details/131419391 本文由 白鲸开源科技 提供发布支持!

优秀的个人博客,低调大师

Proxy-Go 控制面板 v3.1 发布,更新 SDK 到最新版!

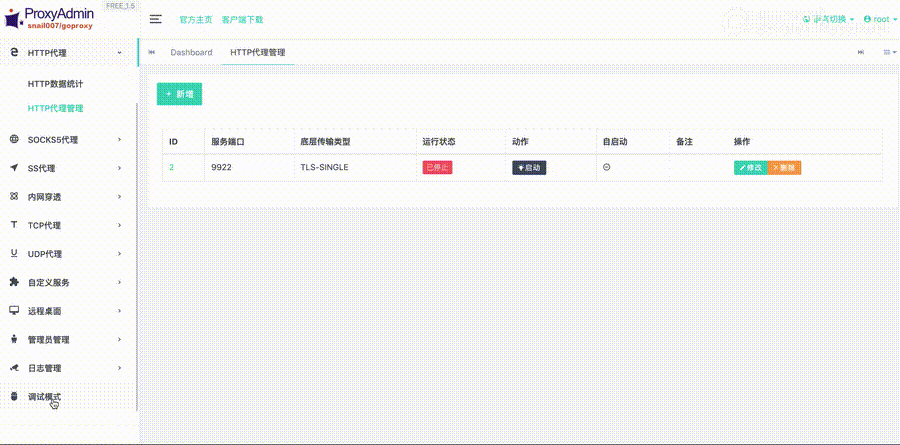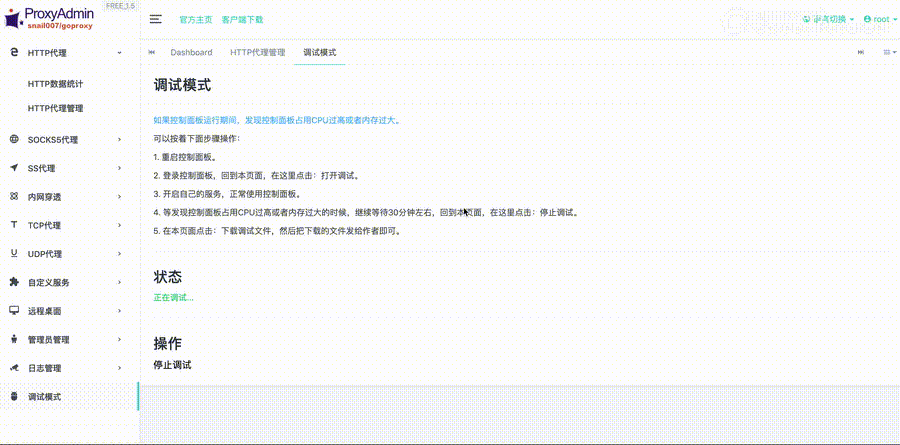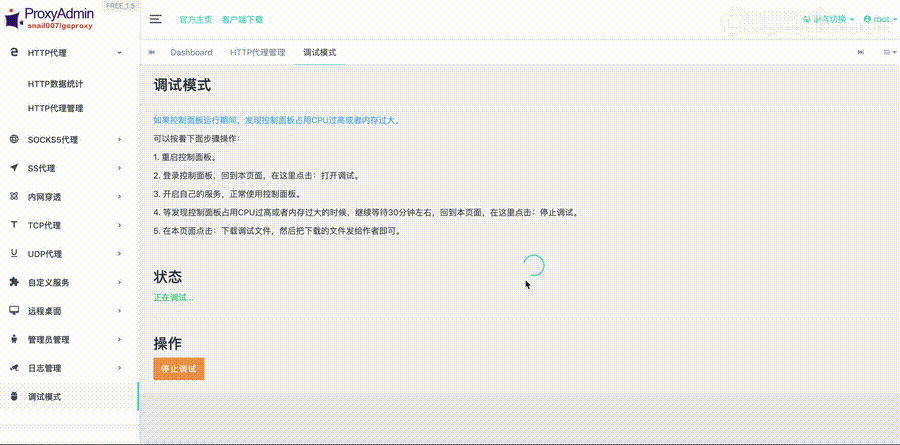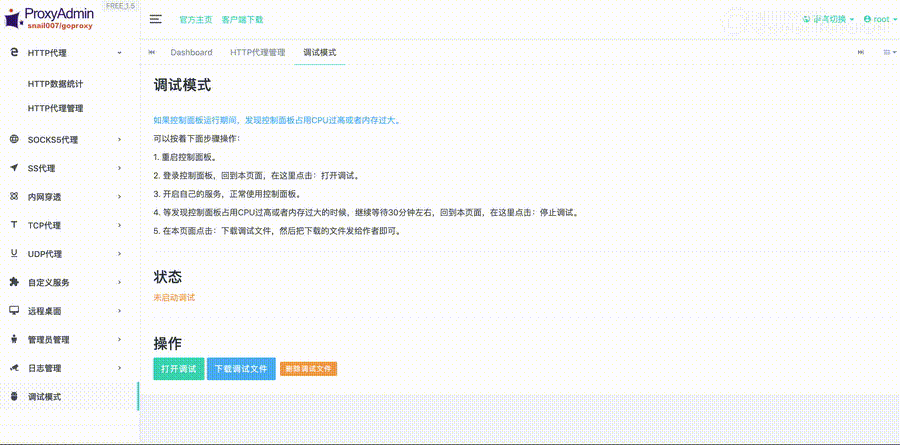
Proxy-Go 控制面板 ProxyAdmin是强大的代理服务工具snail007/goproxy的控制面板,运行了它,一秒让你的服务器变为强大的代理服务器,友好的交互界面,小白也能轻松上手,让你用起来得心应手,心情舒畅。 更新内容: 1.更新到最新版sdk。 更新: v3.0及以后版本,执行:proxy-admin update,即可完成快速更新到最新版。 功能预览 展现客户端参数 实时日志 参数文件管理 调试模式 下载地址: Gitee Github

优秀的个人博客,低调大师

mysql8+mybatis-plus3.1自动生成带lombok和swagger和增删改查接口

mybatis-dsc-generator 还在为写swagger而烦恼吗?还在为忘记写注释而烦恼吗?还在为写简单的api接口而烦恼吗?mybatis-dsc-generator完美集成lombok,swagger的代码生成工具,让你不再为繁琐的注释和简单的接口实现而烦恼:entity集成,格式校验,swagger; dao自动加@ mapper,service自动注释和依赖; 控制器实现单表的增副改查,并实现swaggers的api文档。 源码地址 GitHub:https://github.com/flying-cattle/mybatis-dsc-generator 码云:https://gitee.com/flying-cattle/mybatis-dsc-generator MAVEN地址 2.1.0版本是未集成Mybatis-plus版本——源码分支master <dependency> <groupId>com.github.flying-cattle</groupId> <artifactId>mybatis-dsc-generator</artifactId> <version>2.1.0.RELEASE</version> </dependency> 3.0.0版本是集成了Mybatis-plus版本——源码分支mybatisPlus <dependency> <groupId>com.github.flying-cattle</groupId> <artifactId>mybatis-dsc-generator</artifactId> <version>3.0.0.RELEASE</version> </dependency> 数据表结构样式 CREATE TABLE `user` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'ID', `login_name` varchar(40) DEFAULT NULL COMMENT '登录名', `password` varchar(100) NOT NULL COMMENT '秘密', `nickname` varchar(50) NOT NULL COMMENT '昵称', `type` int(10) unsigned DEFAULT NULL COMMENT '类型', `state` int(10) unsigned NOT NULL DEFAULT '1' COMMENT '状态:-1失败,0等待,1成功', `note` varchar(255) DEFAULT NULL COMMENT '备注', `create_time` timestamp NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` timestamp NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', `update_uid` bigint(20) DEFAULT '0' COMMENT '修改人用户ID', `login_ip` varchar(50) DEFAULT NULL COMMENT '登录IP地址', `login_addr` varchar(100) DEFAULT NULL COMMENT '登录地址', PRIMARY KEY (`id`), UNIQUE KEY `login_name` (`login_name`) ) ENGINE=InnoDB AUTO_INCREMENT=13 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; 要求必须有表注释,要求必须有主键为id,所有字段必须有注释(便于生成java注释swagger等)。 生成的实体类 生成方法参考源码中的:https://gitee.com/flying-cattle/mybatis-dsc-generator/blob/master/src/main/java/com/github/mybatis/fl/test/TestMain.java 执行结果 实体类 /** * @filename:Order 2018年7月5日 * @project deal-center V1.0 * Copyright(c) 2018 BianP Co. Ltd. * All right reserved. */ import com.baomidou.mybatisplus.annotation.IdType; import com.baomidou.mybatisplus.annotation.TableId; import com.baomidou.mybatisplus.extension.activerecord.Model; import com.fasterxml.jackson.annotation.JsonFormat; import io.swagger.annotations.ApiModelProperty; import lombok.Data; import lombok.EqualsAndHashCode; import lombok.experimental.Accessors; import java.util.Date; import org.springframework.format.annotation.DateTimeFormat; import java.io.Serializable; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户实体类</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *---------------------------------------------------------------* * 2019年4月9日 BianPeng V1.0 initialize */ @Data @EqualsAndHashCode(callSuper = false) @Accessors(chain = true) @Data @EqualsAndHashCode(callSuper = false) @Accessors(chain = true) public class User extends Model<User> { private static final long serialVersionUID = 1L; @TableId(value = "id", type = IdType.AUTO) @ApiModelProperty(name = "id" , value = "用户ID") private Long id; @ApiModelProperty(name = "loginName" , value = "登录账户") private String loginName; @ApiModelProperty(name = "password" , value = "登录密码") private String password; @ApiModelProperty(name = "nickname" , value = "用户昵称") private String nickname; @ApiModelProperty(name = "type" , value = "用户类型") private Integer type; @ApiModelProperty(name = "state" , value = "用户状态") private Integer state; @ApiModelProperty(name = "note" , value = "备注") private String note; @DateTimeFormat(pattern = "yyyy-MM-dd HH:mm:ss") @JsonFormat(pattern="yyyy-MM-dd HH:mm:ss",timezone = "GMT+8") @ApiModelProperty(name = "createTime" , value = "用户创建时间") private Date createTime; @DateTimeFormat(pattern = "yyyy-MM-dd HH:mm:ss") @JsonFormat(pattern="yyyy-MM-dd HH:mm:ss",timezone = "GMT+8") @ApiModelProperty(name = "updateTime" , value = "修改时间") private Date updateTime; @ApiModelProperty(name = "updateUid" , value = "修改人用户ID") private Long updateUid; @ApiModelProperty(name = "loginIp" , value = "登录IP") private String loginIp; @ApiModelProperty(name = "loginIp" , value = "登录地址") private String loginAddr; @Override protected Serializable pkVal() { return this.id; } } DAO import com.baomidou.mybatisplus.core.mapper.BaseMapper; import org.apache.ibatis.annotations.Mapper; import com.xin.usercenter.entity.User; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户数据访问层</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *---------------------------------------------------------------* * 2019年4月9日 BianPeng V1.0 initialize */ @Mapper public interface UserDao extends BaseMapper<User> { } 生成的XML <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.xin.usercenter.dao.UserDao"> <resultMap id="BaseResultMap" type="com.xin.usercenter.entity.User"> <id column="id" property="id" /> <id column="login_name" property="loginName" /> <id column="password" property="password" /> <id column="nickname" property="nickname" /> <id column="type" property="type" /> <id column="state" property="state" /> <id column="note" property="note" /> <id column="create_time" property="createTime" /> <id column="update_time" property="updateTime" /> <id column="update_uid" property="updateUid" /> <id column="login_ip" property="loginIp" /> <id column="login_addr" property="loginAddr" /> </resultMap> <sql id="Base_Column_List"> id, login_name, password, nickname, type, state, note, create_time, update_time, update_uid, login_ip, login_addr </sql> </mapper> 生成的SERVICE import com.xin.usercenter.entity.User; import com.baomidou.mybatisplus.extension.service.IService; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户服务层</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *------------------------------------------------------------* * 2019年4月9日 BianPeng V1.0 initialize */ public interface UserService extends IService<User> { } 生成的SERVICE_IMPL import com.xin.usercenter.entity.User; import com.xin.usercenter.dao.UserDao; import com.xin.usercenter.service.UserService; import org.springframework.stereotype.Service; import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户服务实现层</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *------------------------------------------------------------* * 2019年4月9日 BianPeng V1.0 initialize */ @Service public class UserServiceImpl extends ServiceImpl<UserDao, User> implements UserService { } 生成的CONTROLLER import com.item.util.JsonResult; import com.xin.usercenter.entity.User; import com.xin.usercenter.service.UserService; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.PathVariable; import org.springframework.web.bind.annotation.PostMapping; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import com.baomidou.mybatisplus.core.conditions.query.QueryWrapper; import com.baomidou.mybatisplus.core.metadata.IPage; import com.baomidou.mybatisplus.extension.plugins.pagination.Page; import io.swagger.annotations.Api; import io.swagger.annotations.ApiImplicitParam; import io.swagger.annotations.ApiImplicitParams; import io.swagger.annotations.ApiOperation; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.factory.annotation.Autowired; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户API接口层</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *---------------------------------------------------------------* * 2019年4月9日 BianPeng V1.0 initialize */ @Api(description = "用户",value="用户" ) @RestController @RequestMapping("/user") public class UserController { Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired public UserService userServiceImpl; /** * @explain 查询用户对象 <swagger GET请求> * @param 对象参数:id * @return user * @author BianPeng * @time 2019年4月9日 */ @GetMapping("/getUserById/{id}") @ApiOperation(value = "获取用户信息", notes = "获取用户信息[user],作者:BianPeng") @ApiImplicitParam(paramType="path", name = "id", value = "用户id", required = true, dataType = "Long") public JsonResult<User> getUserById(@PathVariable("id")Long id){ JsonResult<User> result=new JsonResult<User>(); try { User user=userServiceImpl.getById(id); if (user!=null) { result.setType("success"); result.setMessage("成功"); result.setData(user); } else { logger.error("获取用户失败ID:"+id); result.setType("fail"); result.setMessage("你获取的用户不存在"); } } catch (Exception e) { logger.error("获取用户执行异常:"+e.getMessage()); result=new JsonResult<User>(e); } return result; } /** * @explain 添加或者更新用户对象 * @param 对象参数:user * @return int * @author BianPeng * @time 2019年4月9日 */ @PostMapping("/insertSelective") @ApiOperation(value = "添加用户", notes = "添加用户[user],作者:BianPeng") public JsonResult<User> insertSelective(User user){ JsonResult<User> result=new JsonResult<User>(); try { boolean rg=userServiceImpl.saveOrUpdate(user); if (rg) { result.setType("success"); result.setMessage("成功"); result.setData(user); } else { logger.error("添加用户执行失败:"+user.toString()); result.setType("fail"); result.setMessage("执行失败,请稍后重试"); } } catch (Exception e) { logger.error("添加用户执行异常:"+e.getMessage()); result=new JsonResult<User>(e); } return result; } /** * @explain 删除用户对象 * @param 对象参数:id * @return int * @author BianPeng * @time 2019年4月9日 */ @PostMapping("/deleteByPrimaryKey") @ApiOperation(value = "删除用户", notes = "删除用户,作者:BianPeng") @ApiImplicitParam(paramType="query", name = "id", value = "用户id", required = true, dataType = "Long") public JsonResult<Object> deleteByPrimaryKey(Long id){ JsonResult<Object> result=new JsonResult<Object>(); try { boolean reg=userServiceImpl.removeById(id); if (reg) { result.setType("success"); result.setMessage("成功"); result.setData(id); } else { logger.error("删除用户失败ID:"+id); result.setType("fail"); result.setMessage("执行错误,请稍后重试"); } } catch (Exception e) { logger.error("删除用户执行异常:"+e.getMessage()); result=new JsonResult<Object>(e); } return result; } /** * @explain 分页条件查询用户 * @param 对象参数:AppPage<User> * @return PageInfo<User> * @author BianPeng * @time 2019年4月9日 */ @GetMapping("/getUserPages") @ApiOperation(value = "分页查询", notes = "分页查询返回对象[IPage<User>],作者:边鹏") @ApiImplicitParams({ @ApiImplicitParam(paramType="query", name = "pageNum", value = "当前页", required = true, dataType = "int"), @ApiImplicitParam(paramType="query", name = "pageSize", value = "页行数", required = true, dataType = "int") }) public JsonResult<Object> getUserPages(Integer pageNum,Integer pageSize){ JsonResult<Object> result=new JsonResult<Object>(); Page<User> page=new Page<User>(pageNum,pageSize); QueryWrapper<User> queryWrapper =new QueryWrapper<User>(); //分页数据 try { //List<User> list=userServiceImpl.list(queryWrapper); IPage<User> pageInfo=userServiceImpl.page(page, queryWrapper); result.setType("success"); result.setMessage("成功"); result.setData(pageInfo); } catch (Exception e) { logger.error("分页查询用户执行异常:"+e.getMessage()); result=new JsonResult<Object>(e); } return result; } } 生成完毕,控制器中的JsonResult import java.io.Serializable; import java.net.ConnectException; import java.sql.SQLException; import org.slf4j.Logger; import org.slf4j.LoggerFactory; /** * Copyright: Copyright (c) 2019 * * <p>说明: 用户服务层</P> * @version: V1.0 * @author: BianPeng * * Modification History: * Date Author Version Description *---------------------------------------------------------* * 2019/4/9 flying-cattle V1.0 initialize */ public class JsonResult<T> implements Serializable{ Logger logger = LoggerFactory.getLogger(this.getClass()); private static final long serialVersionUID = 1071681926787951549L; /** * <p>返回状态</p> */ private Boolean isTrue=true; /** *<p> 状态码</p> */ private String code; /** * <p>业务码</p> */ private String type; /** *<p> 状态说明</p> */ private String message; /** * <p>返回数据</p> */ private T data; public Boolean getTrue() { return isTrue; } public void setTrue(Boolean aTrue) { isTrue = aTrue; } public String getCode() { return code; } public void setCode(String code) { this.code = code; } public String getMessage() { return message; } public void setMessage(String message) { this.message = message; } public T getData() { return data; } public void setData(T data) { this.data = data; } public String getType() { return type; } public void setType(String type) { this.type = type; } /** * <p>返回成功</p> * @param type 业务码 * @param message 错误说明 * @param data 数据 */ public JsonResult(String type, String message, T data) { this.isTrue=true; this.code ="0000"; this.type=type; this.message = message; this.data=data; } public JsonResult() { this.isTrue=true; this.code ="0000"; } public JsonResult(Throwable throwable) { logger.error(throwable+"tt"); this.isTrue=false; if(throwable instanceof NullPointerException){ this.code= "1001"; this.message="空指针:"+throwable; }else if(throwable instanceof ClassCastException ){ this.code= "1002"; this.message="类型强制转换异常:"+throwable; }else if(throwable instanceof ConnectException){ this.code= "1003"; this.message="链接失败:"+throwable; }else if(throwable instanceof IllegalArgumentException ){ this.code= "1004"; this.message="传递非法参数异常:"+throwable; }else if(throwable instanceof NumberFormatException){ this.code= "1005"; this.message="数字格式异常:"+throwable; }else if(throwable instanceof IndexOutOfBoundsException){ this.code= "1006"; this.message="下标越界异常:"+throwable; }else if(throwable instanceof SecurityException){ this.code= "1007"; this.message="安全异常:"+throwable; }else if(throwable instanceof SQLException){ this.code= "1008"; this.message="数据库异常:"+throwable; }else if(throwable instanceof ArithmeticException){ this.code= "1009"; this.message="算术运算异常:"+throwable; }else if(throwable instanceof RuntimeException){ this.code= "1010"; this.message="运行时异常:"+throwable; }else if(throwable instanceof Exception){ logger.error("未知异常:"+throwable); this.code= "9999"; this.message="未知异常"+throwable; } } } 如果你生成的分页的方法不能分页:根据官方提升,记得在启动类中加入 @Bean public PaginationInterceptor paginationInterceptor() { return new PaginationInterceptor(); }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册