首页 文章 精选 留言 我的

精选列表

搜索[Python环境],共10000篇文章
优秀的个人博客,低调大师

Python量化交易开源框架:AmazingQuant

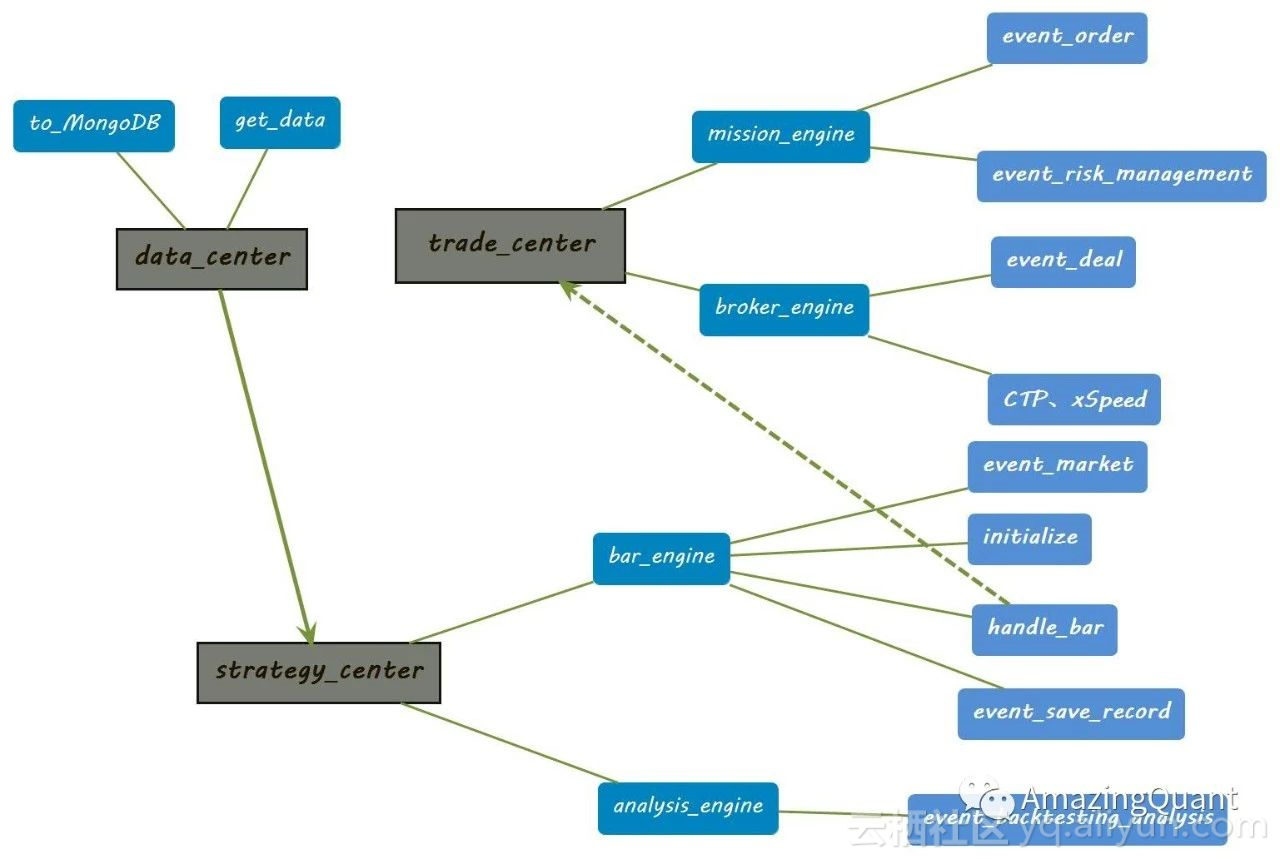
1.简介开源地址: https://github.com/zhanggao2013/AmazingQuant AmazingQuant是一款基于event-driven的量化回测交易开源框架,下图是总体框架架构。 data_centerto_mongoDB 存放行情、财务等各种数据到MongoDB的存储模块get_data 策略中从数据库中取数据的接口模块trade_centermossion_engine 包含下单任务(event_order)和风控(event_risk_management)两部分的engine,分别完成下单前的检查和风控broker_engine 分为回测时的simulate的broker(主要是event_deal)撮合成交和连接实盘交易CTP、xSpeed等接口两部分strategy_cente

优秀的个人博客,低调大师

Python函数式编程map()、reduce()

一、map() 格式:map(func, *iterables) map函数接受两个参数,第一个是要执行的函数,第二个是可迭代对象,可迭代对象可以传入多个参数。 map()函数是将func作用于iterables中的每一个元素,并用一个列表给出返回值。如果func为None,作用同zip()。 传入一个可迭对象 def func(x): return x*x lists = [1, 2, 3, 4] l = list(map(func, lists)) print(l) 结果:[1, 4, 9, 16] 传入两个可迭对象 def func(x, y): return x+y lists = [1, 2, 3, 4] lists2 = [1, 2, 3, 4] l = list(map(func, lists, lists2)) print(l) 结果:[2, 4, 6, 8] 二、reduce() 格式:reduce(function, sequence, initial=None) reduce函数接受三个参数,第一个是要执行的函数,第二个是序列,第三个是默认值。第一个函数必须有两个参数。 reduce函数即为化简,它是这样一个过程:每次迭代,将上一次的迭代结果(第一次时为init的元素,如没有init则为seq的第一个元素)与下一个元素一同执行一个二元的func函数。在reduce函数中,init是可选的,如果使用,则作为第一次迭代的第一个元素使用。 例子: 不传入默认值 from functools import reduce lists = ['a', 'b', 'c', 'd'] r = reduce(lambda x, y: x+y, lists) print(r) 结果:abcd 传入默认值 from functools import reduce lists = ['a', 'b', 'c', 'd'] r = reduce(lambda x, y: x+y, lists, '你好') print(r) 结果:你好abcd

优秀的个人博客,低调大师

Python数据分析实例操作

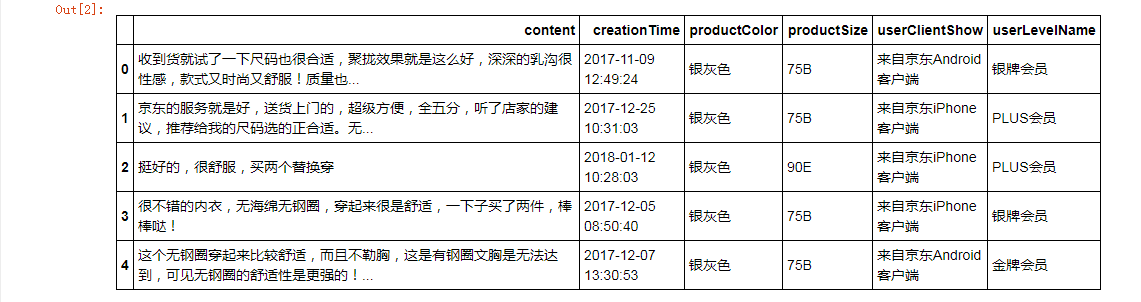
import pandas as pd #导入pandas import matplotlib.pyplot as plt #导入matplotlib from pylab import * mpl.rcParams['font.sans-serif'] = ['SimHei'] mpl.rcParams['axes.unicode_minus'] = False %matplotlib inline 数据读取与索引 bra = pd.read_csv('data/bra.csv') bra.head() 选取列 bra.content bra[['creationTime','productColor']].head() 选择行 bra[1:6] 选择行和列 bra.ix[[2,3],[1,3]] #使用ix bra.ix[1:5,['productColor']] bra.iloc[[2,3],[1,3]] #使用iloc bra.loc[1:5,['content','creationTime','productSize']] #使用loc bra.loc[1:5,'content':'userClientShow'] 数据预处理 缺失值 bra.describe() #查看数据的分布情况,可返回变量和观测的数量、缺失值和唯一值的数目、平均值、分位数等相关信息 bra['userClientShow'].unique() #userClientShow列有几种选项 bra['userClientShow'].isnull().sum() #初始缺失值数量 bra['userClientShow'].fillna('不详',inplace=True) #缺失值替换为“不详” bra['userClientShow'].isnull().sum() #赋值后的缺失值数量 新增列 bra.dtypes #查看属性 bra['creationTime'] = pd.to_datetime(bra['creationTime']) #更新类型 bra.dtypes bra['hour'] = [i.hour for i in bra['creationTime']] #新建hour列 bra 字符串操作 bra.productSize.unique() #查看productSize的唯一值 cup = bra.productSize.str.findall('[a-zA-Z]+').str[0] #新增列cup cup2 = cup.str.replace('M','B') cup3 = cup2.str.replace('L','C') cup4 = cup3.str.replace('XC','D') bra['cup'] = cup4 bra.head() bra['cup'].unique() #查看cup唯一值 数据转换 bra.productColor.unique() #查看productColor唯一值 def getColor(s): if '黑' in s: return '黑色' elif '肤' in s: return '肤色' elif '蓝' in s: return '蓝色' elif '红' in s: return '红色' elif '紫' in s: return '紫色' elif '白' in s: return '白色' elif '粉' in s: return '粉色' elif '灰' in s: return '灰色' elif '绿' in s: return '绿色' elif '青' in s: return '青色' else: return s bra['color'] = bra['productColor'].map(getColor) #从productColor列查询,赋值到定义的函数getColor,最终新增列color bra bra.color.unique() #查询color的唯一值 数据可视化 x = [1991,1992,1993,1994,1995,1996,1997] y = [23,56,38,29,34,56,92] plt.plot(x,y) #调用函数plot plt.figure(figsize=(8,6),dpi=80) #调用函数firgure plt.plot(x,y) hour = bra.groupby('hour')['hour'].count() #hour列排序 hour plt.xlim(0,25) #横轴0~25 plt.plot(hour,linestyle='solid',color='royalblue',marker='8') #颜色深蓝 cup_style = bra.groupby('cup')['cup'].count() #cup列唯一值得数量 cup_style plt.figure(figsize=(8,6),dpi=80) labels = list(cup_style.index) plt.xlabel('cup') #x轴为cup plt.ylabel('count') #y轴为count数量 plt.bar(range(len(labels)),cup_style,color='royalblue',alpha=0.7) #alpha为透明度 plt.xticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='y',alpha=0.6) plt.legend(['user-count']) for x,y in zip(range(len(labels)),cup_style): plt.text(x,y,y,ha='center',va='bottom') color_style = bra.groupby('color')['color'].count() #color列唯一值得数量 color_style plt.figure(figsize=(8,6),dpi=80) plt.subplot(facecolor='gainsboro',alpha=0.2) colors = ['brown','orange','gray','white','pink','purple','red','green','wheat','blue','gold','springgreen','black'] #颜色种类 labels = list(color_style.index) plt.xlabel('count') #x轴为count数量 plt.ylabel('color') #y轴为color plt.title('Color Distribution') #定义标题 plt.barh(range(len(labels)),color_style,color=colors,alpha=1) plt.yticks(range(len(labels)),labels,fontsize=12) plt.grid(color='#95a5a6',linestyle='--',linewidth=1,axis='x',alpha=0.4) bra.head(30) 知识在于点滴积累
优秀的个人博客,低调大师

python多进程与协程

1、进程的概念 什么是进程—>CPU在同一时刻只能处理一个任务,只是因为cpu执行速度很快。 cpu在各个任务之间来回的进行切换。 进程的概念:正在进行的一个过程或者说一个任务,而负责执行任务的则是CPU,进程本身是 一个抽象的概念,即进程就是一个过程、一个任务。 CPU描述的是一个程序的执行过程. 进程之间是如何做到并发的:CPU在各个任务之间来回的进行切换,并在切换的过程当中保存当前 进程的执行状态(保存蛋糕的执行过程)。 进程与程序的区别:程序相当于菜谱,而进程相当于做菜的整个过程。 需要强调的是:同一个程序执行两次(双击),那也是两个进程,比如打开暴风影音,虽然都是同一个软件,但是一个可以播放a,一个可以播放b. 核的概念:https://zhidao.baidu.com/question/541410131.html 处理器,就是说有几个处理器。。。也就说一个CPU里面会有几个处理器,这样就可以同时处理几个要求了。。。 2、并行与并发的区别 无论是并行还是并发,在用户看来都是同时运行的,不管是进程还是线程,都只是一个任务而已, 真正干活的是CPU,CPU来做这些任务,而一个cpu(单核)同一时刻只能执行一个任务。 并行:多个任务同时运行,只有具备多个cpu才能实现并行,含有几个cpu,也就意味着在同一时刻可以执行几个任务。 并发:是伪并行,即看起来是同时运行的,实际上是单个CPU在多道程序之间来回的进行切换。 3、同步与异步的概念 同步就是指一个进程在执行某个请求的时候,若该请求需要一段时间才能返回信息,那么这个进程将会一直等待下去,直到收到返回信息才继续执行下去。 异步是指进程不需要一直等下去,而是继续执行下面的操作,不管其他进程的状态。当有消息返回时系统会通知进行处理,这样可以提高执行的效率。 打电话的过程就是同步通信,发短信时就是异步通信。 4、进程创建的方式 用户创建出来的所有进程都是由操作系统负责的,因此无论是哪一种创建进程的方式,实际上都是调用操作系统的接口创建的,进程的切换都是由操作系统控制的。 无论哪一种创建进程的方式,新进程的创建都是由一个已经存在的进程执行了一个用于创建进程的系统调用而创建的。 5、父进程和子进程之间的关系 子进程创建后,父进程和子进程有各自不同的地址空间,多道技术要求物理层面实现进程之间内存的 隔离,任何一个进程在其地址空间的修改都不会影响到另外一个进程。 注意:子进程和父进程之间是可以有只读的共享的内存区域的。 进程与进程之间数据(资源)是隔离的,两个进程之间可以基于管道这种方式进行通信。在Unix当中,是含有进程层次的概念的,但是在windows当中,是没有进程层次的概念的,所有的进程都是地位相同的。 在Linux当中,每启动一个命令,都会启动一个进程。 6、线程的概念 一个进程里面至少有一个控制线程,进程的概念只是一种抽象的概念,真正在CPU上面调度的是进程 里面的线程,就好比真正在地铁这个进程里面工作的实际上是地铁里面的线程,北京地铁里面至少要有 一个线程,线程是真正干活的,线程用的是进程里面包含的一堆资源,线程仅仅是一个调度单位,不包含资源。 7、 什么时候需要开启多个线程? 什么时候需要开启多个线程:一个进程里面的多个线程共享这个进程里面的资源,因此如果多个任务共享同一块资源的时候,需要开启多个线程。 多线程指的是,在一个进程中开启多个线程,简单的说:如果多个任务共用同一个资源空间,那么必须在一个进程内开启多个线程。 8、一个进程里面需要包含多个线程? 一个进程这个任务里面可能对应多个分任务,如果一个进程里面只开启一个线程的话,多个分任务之间实际上是串行的执行效果,即一个程序里面只含有一条执行路径。 9、多线程和多进程的关系 对于计算密集型应用,应该使用多进程;对于IO密集型应用,应该使用多线程。 线程的创建比进程的创建开销小的多。 ''' about what ''' import multiprocessing import time def func(arg): pname = multiprocessing.current_process().name pid = multiprocessing.current_process().pid print("当前进程ID=%d,name=%s" % (pid, pname)) for i in range(5): print(arg) time.sleep(1) if __name__ == "__main__": pname = multiprocessing.current_process().name pid = multiprocessing.current_process().pid print("当前进程ID=%d,name=%s" % (pid, pname)) p = multiprocessing.Process(target=func, args=("hello",)) # p = multiprocessing.Process(target=func,name="劳资的队伍",args=("hello",)) p.daemon = True # 设为【守护进程】(随主进程的结束而结束) p.start() while True: print("子进程是否活着?", p.is_alive()) time.sleep(1) print("main over") 协程 协程,又称微线程,纤程。英文名Coroutine。 协程是啥 ?? 首先我们得知道协程是啥?协程其实可以认为是比线程更小的执行单元。为啥说他是一个执行单元,因为他自带CPU上下文。这样只要在合适的时机,我们可以把一个协程切换到另一个协程,只要这个过程中保存或恢复 CPU上下文那么程序还是可以运行的。 通俗的理解:在一个线程中的某个函数,可以在任何地方保存当前函数的一些临时变量等信息,然后切换到另外一个函数中执行,注意不是通过调用函数的方式做到的,并且切换的次数以及什么时候再切换到原来的函数都由开发者自己确定。 协程和线程差异 最大的优势就是协程极高的执行效率,因为子程序切换不是线程切换,而是由程序自身控制,因此,没有线程切换的开销线程切换从系统层面远不止保存和恢复 CPU上下文这么简单。操作系统为了程序运行的高效性每个线程都有自己缓存Cache等等数据,操作系统还会帮你做这些数据的恢复操作。所以线程的切换非常耗性能。但是协程的切换只是单纯的操作CPU的上下文,所以一秒钟切换个上百万次系统都抗的住。 第二大优势就是不需要多线程的锁机制,因为只有一个线程,也不存在同时写变量冲突。 2、使用协程 1.使用greenlet + switch实现协程调度 ''' 使用greenlet + switch实现协程调度 ''' from greenlet import greenlet import time def func1(): print("开门走进卫生间") time.sleep(3) gr2.switch() # 把CPU执行权交给gr2 print("飞流直下三千尺") time.sleep(3) gr2.switch() pass def func2(): print("一看拖把放旁边") time.sleep(3) gr1.switch() print("疑是银河落九天") pass if __name__ == '__main__': gr1 = greenlet(func1) gr2 = greenlet(func2) gr1.switch() # 把CPU执行权先给gr1 pass 2.使用gevent + sleep自动将CPU执行权分配给当前未睡眠的协程 ''' 使用gevent + sleep自动将CPU执行权分配给当前未睡眠的协程 ''' import gevent def func1(): gevent.sleep(1) print("大梦谁先觉") gevent.sleep(13) print("1:over") pass def func2(): gevent.sleep(3) print("平生我自知") gevent.sleep(9) print("2:over") pass def func3(): gevent.sleep(5) print("草堂春睡足") gevent.sleep(5) print("3:over") pass def func4(): gevent.sleep(7) print("窗外日迟迟") gevent.sleep(1) print("4:over") def simpleGevent(): gr1 = gevent.spawn(func1) gr2 = gevent.spawn(func2) gr3 = gevent.spawn(func3) gr4 = gevent.spawn(func4) gevent.joinall([ gr1, gr2, gr3, gr4 ]) if __name__ == '__main__': # simpleGevent() pass 3.通过monkey调度 ''' 使用gevent + monkey.patch_all()自动调度网络IO协程 ''' import gevent import requests import time from gevent import monkey def getPageText(url, order=0): print("No%d:%s请求开始..." % (order, url)) resp = requests.get(url) # 发起网络请求,返回需要时间——阻塞IO html = resp.text print("No%d:%s成功返回:长度为%d" % (order, url, len(html))) # 将【标准库-阻塞IO实现】替换为【gevent-非阻塞IO实现】 monkey.patch_all() if __name__ == '__main__': start = time.time() time.clock() gevent.joinall([ gevent.spawn(getPageText, "http://www.sina.com", order=1), gevent.spawn(getPageText, "http://www.qq.com", order=2), gevent.spawn(getPageText, "http://www.baidu.com", order=3), gevent.spawn(getPageText, "http://www.163.com", order=4), gevent.spawn(getPageText, "http://www.4399.com", order=5), gevent.spawn(getPageText, "http://www.sohu.com", order=6), gevent.spawn(getPageText, "http://www.youku.com", order=7), gevent.spawn(getPageText, "http://www.iqiyi.com", order=8), ]) end = time.time() print("over,耗时%d秒" % (end - start)) print(time.clock()) pass

优秀的个人博客,低调大师

python 预测目标(y)的转换

标签二值化 >>> from sklearn import preprocessing >>> lb = preprocessing.LabelBinarizer() >>> lb.fit([1, 2, 6, 4, 2]) LabelBinarizer(neg_label=0, pos_label=1, sparse_output=False) >>> lb.classes_ array([1, 2, 4, 6]) >>> lb.transform([1, 6]) array([[1, 0, 0, 0], [0, 0, 0, 1]]) 对于多类别是实例,可以使用:class:MultiLabelBinarizer: >>> lb = preprocessing.MultiLabelBinarizer() >>> lb.fit_transform([(1, 2), (3,)]) array([[1, 1, 0], [0, 0, 1]]) >>> lb.classes_ array([1, 2, 3]) 标签编码 LabelEncoder是一个可以用来将标签规范化的工具类,它可以将标签的编码值范围限定在[0,n_classes-1]。这在编写高效的Cython程序时是非常有用的,:class:LabelEncoder可以如下使用: >>>> from sklearn import preprocessing >>> le = preprocessing.LabelEncoder() >>> le.fit([1, 2, 2, 6]) LabelEncoder() >>> le.classes_ array([1, 2, 6]) >>> le.transform([1, 1, 2, 6]) array([0, 0, 1, 2]) >>> le.inverse_transform([0, 0, 1, 2]) array([1, 1, 2, 6]) 当然,它也可以用于非数值型标签的编码转换成数值标签(只要它们是可哈希并且可比较的): >>> le.fit(["paris", "paris", "tokyo", "amsterdam"]) LabelEncoder() >>> list(le.classes_) ['amsterdam', 'paris', 'tokyo'] >>> le.transform(["tokyo", "tokyo", "paris"]) array([2, 2, 1]) >>> list(le.inverse_transform([2, 2, 1])) ['tokyo', 'tokyo', 'paris']</pre>

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码