首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

HBuilder学习与使用

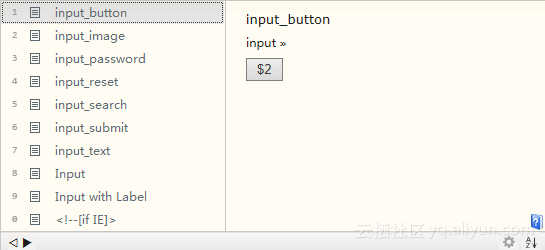
设计理念及常用功能 设计理念 HBuilder追求无鼠标的极速操作,有很多的快捷设定,包括语法库/语法结构模型/AST语法分析引擎 HBuilder主要用于开发html/js/css,同时配合HTML的后端脚本语言如php/jsp也可以适用,还有前端的预编译语言如less及markdown都可以良好的编辑 常用功能 代码块:一个代码块少敲20下键盘 代码块是常用的代码组合,比如在js中输入$,回车,则可以自动输入document.getElementById(id);在HTML中输入i,回车,可以得到input button标签查看/编辑代码块可以在工具-自定义代码块中,选择相应的代码块进行查看和编辑;也可以在激活代码块的代码助手中,点击详细信息右下角的修改图标进行修改和查看 代码块激活字符原则1:连续单词的首字母;比如:dg激活document.getElementById(""),vari激活var i=0,dn激活display: none 代码块激活字符原则2:整段HTML一般使用tag的名称;比如script/style,通常,敲最多4个字母即可匹配到需要的代码块,不需要完整录入,如sc回车/st回车,即可完成script/style标签的输入 代码块激活字符原则3:同一个tag有多个代码块输出,则在最后加后缀,比如meta输出,但metau则输出,metag同理 代码块激活字符原则4:如果原始语法超过4个字符,针对常用语法,则第一个单词的激活符使用缩写;比如input button,缩写为inbutton,同理intext是输入框 代码块激活字符原则5:js的关键字代码块,是在关键字最后加一个重复字母;比如if直接敲会提示if关键字,但iff回车,则出现if代码块;类似的有forr/withh等;由于funtion字母较长,为加快输入速度,取fun缩写,比如funn,输出function代码块,而funa和func,分别输出匿名函数和闭包 全时提示 HBuilder不仅提示全面的语法,非语法的各种候选输入也都能提示;包括图片/链接/颜色/字体/脚本/样式/URI/ID/class/自定义JS对象/方法;举例:在img src=后激活代码助手,可看到本工程所有图片列表:输入<sc可以看到本工程所有js列表,在js的document.getElementById(id)中提示本工程已经定义的ID列表,在css的color:后可以列出本工程所有使用过的颜色。 Emmet支持 HBuilder内嵌了emmet(即zencoding)插件;输入div#id1,按下tab,可以自动生成<div id="id1"></div>Emmet的详细语法请查阅其官方网站emmet.io 框架语法支持 HBuilder内嵌了jquery/bootstrap/angular/mui等常用框架的语法提示库,并且这些框架语法一样可以享受到HBuilder的全时提示机制,提示图片/颜色/id/class...;如果要使用框架语法,需要在工具菜单/项目的右键菜单中,点击引入框架语法提示的子项,为该项目选择框架语法提示;提示效果如下: JSDoc+ HBuilder扩展了jsdoc,并改良用途用于酷酷的语法提示,让动态的js有了静态的感觉;具体参考:http://ask.dcloud.net.cn/article/129 边看边改 想一边写代码一边看效果,按下Ctrl P进入边看边改视图,左边保存右边立即刷新,调试的玩法还有很多,参考http://ask.dcloud.net.cn/article/483 最全语法库和浏览器兼容数据 HBuilder的语法库包括W3C的HTML/JAVASCRIPT/CSS的正式标准和推荐标准...,ECMAScript中浏览器支持的部分,还有各大浏览器的扩展语法,webkit/moz/ms,均实时更新到各浏览器的最新版本;信息栏中的浏览器品牌图标,全亮表示无障碍支持该语法,全灰表示不支持,而半亮则表示该浏览器部分支持该语法;半亮时会下图标下方显示出来详细的支持情况,比如video标签,从IE9才开始支持 手机App开发 HTML5一大用途就是App开发,HBuilder良好的支持手机App开发;包括新建移动App项目/run in device真机调试/本地及云端打包;HBuilder开发的HTML5+ App,比普通的web App功能更强,性能更高 less/sass的支持和预编译器 HBuilder支持less/sass文档 1.着色:正常使用 2.代码提示:只能提示其中的css部分,less/sass仅支持对已编写的代码的单词提示 3.编译:对less/sass文件右键点击编译即可正常编译 HBuilder还支持预编译器配置,在菜单工具-预编译器配置里,可以自己选配less/sass甚至coffeescript等文件的预编译器,保存即可触发 Less文件配置说明,其他文件可参照操作 1.npm全局安装less:npm install less -g 2.hbuilder菜单"工具"->"选项"->"预编译器",修改.less中的命令路径和命令参数,也可以直接使用"智能完成" 3.如果"智能完成"失败,请在"命令触发地址"中填写less全局安装后的命令文件lessc.cmd(windows)或less(mac)文件的路径,命令参数请参照截图填写,也可自行修改保存路径 HTML模板组使用指南 模板组指讲html文件及其使用的文件(如js/css/字体/图片等)整体作为模板的功能 如何新建模板组 点击菜单-文件-HTML文件,点击“自定义模板组”如下图将常用的若干文件压缩为zip保存到该目录,新建HTML文件时,模板组列表会多出以该zip文件的文件名命名的模板组;如下图以该模板组新建HTML文件,HBuilder会自动生成zip里的文件(含内容) 如何扩展语法提示、自定义语法 HBuilder默认只提示标准的HTML5语法,很多框架有自己的HTML/JS语法,也希望在开发中被提示;HBuilder提供如下扩展方案 JS部分 基于sdocml的框架语法库 对工程点右键,引入框架语法,可以看到已经做了的一些常用框架语法库,包括jquery/zepto/mui;其他框架语法,大家可参考这些语法库的sdocml文件格式,来自己做,做好后提交到 https://github.com/dcloudio/WebFrameworkGrammar 以共享给更多开发者 jsdoc HBuilder兼容jsdoc规范,如果开发者的jsdoc写的完善,一样可以被HBuilder的代码助手良好的提示出来;jsdoc的好处是分发容易,跟着js文件一起分发;坏处是造成js文件体积变大,影响性能;常见的做法是提供2个js文件给开发者,比如ext-dev.js和ext-min.js;dev包括jsdoc而min是压缩版 另外注意js文件的体积,比如ext-dev.js的官方文件高达6M,这样的文件HBuilder解析起来还是有压力的 js代码块 我们也可以通过代码块的方式来扩展js提示,点菜单工具-扩展代码块-js,可以看到详细说明和教程;代码块并不是简单的xml配置,而是可以使用ruby编程的,功能很强大 HTML部分 HTML部分目前只能通过代码块扩展,代码块的扩展包括标签和属性2部分,在工具-扩展代码块-HTML里有说明 HBuilder中文输入法免干扰功能说明 HBuilder7.1起支持中文符号自动替换为英文符合;中文符号免干扰指在编写html/js/css代码时,如果处于中文输入法状态,自动将必要的符号如:;。等转为: ; .等 如下图: 1.在HTML区域输入《 2.在js区域输入。3.在css 输入 》如不需要此功能,请在工具-选项-HBuilder-编辑器的对应html/js/css/json编辑器类型中调整 HBuilder如何分栏/分窗格/并列标签 HBuilder编辑器分栏功能可以实现左右分栏和上下分栏以及组合分栏 1.左右分栏实现:鼠标点着编辑器选项卡往最右边拖动,拖到右滚动条附近,光标变化,然后松开,即可实现左右分栏 2.上下分栏实现:鼠标点着编辑器选项卡往最下边拖动,拖到下滚动条附近,光标变化,然后松开,即可实现上下分栏 3.组合分栏实现:组合分栏就是即有的文件向下拖动,有的文件向右拖动 真机运行、手机运行、真机联调常见问题 请首先保证iTunes或Android手机助手(如360手机助手)可以正常连接手机,如果仍有问题请查阅以下问题是否与自己遇到的情况相同 出现问题手机分析清楚问题在哪个环节,从在HBuilder菜单里点真机运行,要经历几个步骤: 1.手机硬件通过usb线连接到HBuilder所在电脑,此时可能因为usb口/数据线/手机硬件等多种问题造成连接失败 2.HBuilder通过adb或itunes服务检测手机,此时可能因为手机渠道/usb连接设置/adb设置或abd冲突/itunes设置造成检测不到 3.HBuilder安装调试基座到手机,此时可能因为手机禁止usb安装/Android手机没有sd卡/iOS手机没有信任证书而安装失败 4.HBuilder将ide中的代码同步到手机上并启动调试基座,这一步一般不会出问题 下面把各种常见FAQ列出,大家可按图索骥。 Q:HBuilder检测不到手机 A:真机只能运行移动App项目,所以首先必须新建好移动App项目,并选中移动App项目或将焦点放在将要运行的移动App项目的文件编辑器上;HBuilder的项目前面都是有图标的,W表示web项目,A表示App项目 如果点击手机运行,HBuilder无法找到手机,尝试以下解决方案: Android设备: 1)确认手机已通过数据线连接电脑 2)如果是Windows系统,确认已安装Android手机驱动;装驱动比较好的方式是使用各种手机助手,比如360/腾讯的各种手机助手,如果有问题,尝试升级助手的版本 3)确认手机设置中USB调试模式已开启;这个设置一般在OS设置里的开发者选项里,有的手机在插上数据线后在push通知栏里也可以设置,注意不能设置为u盘模式或充电模式,必须是usb调试或usb数据访问模式 4)如手机屏幕弹出需信任本计算机的询问,请同意该授权,并且最好是把始终同意该设备调试的checkbox勾上 5)Windows系统中,如果在启动HBuilder后才安装驱动连接上手机,可能需要重启HBuilder 6)Windows系统中,如果手机助手正常连接,HBuilder无法检测到手机,可能是这个手机助手独占了Google的ADB服务通道,请关闭所有手机助手及进程里各种*adb.exe;(ADB是Google提供的Android手机与PC端通信的服务) 7)如果是Android5.0系统,不要使用访客模式,这种模式下无法成功运行 8)Windows系统中,使用管理员权限运行HBuilder 9)Windows系统下,如果以上方案均无法解决,可能是其他软件带的adb与HBuilder冲突,点击检查冲突 10)如果其他软件能检测到手机,但HBuilder无法检测到,将HBuilder安装目录下的tools/adbs目录(MAC下为HBuilder.app/Contents/tools/adbs目录)下的文件备份,然后将tools/adbs/1.0.31目录下的文件拷贝到tools/adbs目录下,重启HBuilder(注:特别是魅族) 11)关闭右侧的WebView调试模式,重启HBuilder重试 12)Mac系统下,HBuilder无法检测到Android手机: ①关于本机(指Mac系统的关于本机,非手机)-->系统报告->usb->你所连接的device-->厂商ID或者供应商ID(Vendor ID) ②在终端执行如下命令:echo xxxxxx >> ~/.android/adb_usb.ini (“xxxxxx”为厂商ID或者供应商ID(Vendor ID),有些系统下echo命令并不能正确写入文件,可在~/.android/目录下修改或新建adb_usb.ini添加xxxxxx) ③重启HBuilder ④如重启HBuilder仍然不行,请使用命令行(终端.app),cd到HBuilder.app/Contents/tools/adbs目录下运行./adb kill-server重试 ⑤重启电脑重试 iOS设备: 1)确认手机已通过数据线连接电脑 2)如果是Windows系统,确认已安装iTunes,若未安装点击下载iTunes注意iTunes12.1起更改了接口,会造成无法连接: ①HBuilder菜单:工具-插件安装,打开插件安装界面,选择iOS连接插件并安装,安装完并重启HBuilder,尝试是否解决 ②安装最新版本的ITools,重启HBuilder 3)确认iTunes能正常连接手机 4)如手机屏幕弹出需信任本计算机的询问,请同意该授权 5)如果是第一次安装完itunes,建议重新启动HBuilder 6)如果以上方案都无法解决,有可能是因为本地库与iTunes带的库冲突了,一般是iTunes库目录(32位系统目录为:C:Program FilesCommon FilesAppleApple Application Support,64位系统目录为:C:Program Files (x86)Common FilesAppleApple Application Support)下的dll文件和系统库目录(32位系统目录为:C:WINDOWSsystem32,64位系统目录为:C:WindowsSysWOW64)下的dll重名,可将iTunes库目录下的同名dll文件拷贝到系统库目录下,或者将系统目录下的同名dll文件重命名或删除,然后再重启HBuilder或者重试真机运行 7)有可能是iTunes安装时依赖库丢失,尝试重装iTunes解决问题 8)iTunes12.1及以上版本无法找到设备: ①.HBuilder菜单:工具-插件安装,打开插件安装界面,选择iOS连接插件并安装,安装完并重启HBuilder,尝试是否解决 ②.安装最新版本的ITools,重启HBuilder 9)iOS模拟器如果无法识别: ①Xcode必须安装在应用程序(Application)中②首先用确认Xcode(版本必须是6.0及以上版本)已安装并能正常启动模拟器 ③其次将Xcode的应用名称(可能是Xcode-XXX/Xcode.XXX等)改为Xcode ④如果仍然无法检测到,则打开Xcode,然后打开Xcode的 Preferences --> Locations,设置该界面中的Command Line Tools 项,选择正确的Xcode版本即可 排查问题有些方式虽然土,但没办法也要用: 1.换数据线/换usb口;数据线有时电压不足或接触不良.尝试重新插拔数据线或直接插入电脑USB口.使用普通的USB HUB很容易出现供电不足 2.重启HBuilder/重启手机/甚至重启电脑 Q:能检测到手机,但点HBuilder的真机运行,无法安装调试基座 1.部分Android rom如小米有usb安装apk的权限,可能是关闭状态,此时需要在手机管家等设置里寻找usb安装apk的权限,将其打开 2.部分Android手机在usb安装apk时,会在手机界面上弹框,如果不能及时点弹框,会因为超时而安装失败,请注意手机屏幕的显示;当HBuilder控制台提示“安装HBuilder基座App失败,请使用手机助手手动安装xxxandroid_base.apk。”时,基本都属于这种情况 如果不是这个原因,就是无法通过HBuilder真机运行的adb安装调试基座,那也只能借助三方工具把HBuilder所在目录里的调试基座android_base.apk手动copy到手机上进行安装了 Q:检查adb冲突(windows系统) Android的ADB服务已经被大量软件使用,除了各种手机助手自带adb,其他如搜狗输入法/暴风影音/酷狗音乐/阿里旺旺等众多软件都自带adb,有些工具的adb服务版本低且独占手机通道,就会导致HBuilder无法连接手机 一般情况下,用户可以在软件的设置里取消该软件对手机的监控;还可以使用如下方式检测当前是哪个进程在占用Android手机通道 1)打开系统dos窗口:开始-运行(快捷键:win+r),输入cmd并回车 2)确认adb的启动进程: 寻找端口是5037的tcp连接,在dos中输入:netstat -ano | findstr 5037在输出结果中找到类似下面的一行: TCP 127.0.0.1:5037 0.0.0.0:0 LISTENING 5816 如果内容为空,可能是没有程序在占用adb端口;或者使用 netstat -ano | findstr 5037>d:/1.txt 输出到文件中查找 根据查询结果确认端口为5037的连接被那个进程占用,结果中显示的“5816”表示占用adb端口的进程PID;根据进程的PID可以找到具体进程,在命令行中输入:tasklist | findstr 5816,在输出结果中找到类似下面的一行: adb.exe 5816 Console 0 4,440 K adb.exe(名称一般不是adb.exe,以adb.exe举例)为启动的adb进程;或者手工在任务管理器中定位这个进程,打开任务管理器后,进入进程选项卡,如果列表里有PID,直接找;如果列表里没有PID,点菜单查看-选择列,勾上PID 3)解决冲突: 一般发生冲突是,任务管理器的进程里会出现多个adb.exe,或kadb.exe、tadb.exe。。。 在任务管理器中找到adb.exe相关进程,在任务管理中右键该进程,打开文件位置,查看该进程是什么软件启动的 如果adb.exe不是HBuilder安装目录下的文件,一般可以用以下方案解决冲突: 1.有些软件这种进程是可以设置成不自动启动的,各个软件设置不一样,设置完成后关闭软件就自动退出了 2.在任务管理器中结束该进程 3.有些软件该进程结束后又会被自动启动,所以得将adb.exe文件重命名一下 Q:iPhone真机联调报安装失败 return code= A:确保HBuilder为最新版 iOS5目前确实在运行时会报错,其他iOS版本偶发也会报错,此时需要这样处理: 在HBuilder安装目录的/plugins/com.pandora.tools.android_1.0.0.xxxx/base目录下(其中xxxx代表最新日期),手动安装iPhone_base.ipa;安装方式推荐itools,没有itools使用itunes也可以;安装完毕后会在手机上有一个HBuilder的应用,以后再点真机运行,就可以把项目部署到手机上,然后手动点击HBuilder应用,就能看到项目的结果 Q:Android手机真机运行提示应用安装成功,但是其实手机上并没有HBuilder应用 A: 1.确认USB调试模式是否打开,如果未打开,请打开USB调试模式重新运行真机调试 2.如果HBuilder已经检测到手机,可能存在与手机助手冲突的情况,请关闭所有的手机助手重新运行真机调试 3.利用手机助手手动安装HBuilder安装目录下的 pluginscom.pandora.tools.android_1.0.0.xxx(最新版本号)baseandroid_base.apk到手机上,然后重新运行真机调试 Q:Android真机联调报文件操作Permission denied A:请尝试以下方法解决:1.拔出数据线 2.重新打开USB调试模式 3.重新插上数据线,此时手机上可能需要授权确认,点击确认 4.重新运行真机调试看看是否还有问题 5.重启手机,再重新运行真机调试,看看问题是否解决 6.如果还有问题,重新启动HBuilder,重复1-4步骤,再重新运行真机调试,看看问题是否解决 7.如果问题仍然没有解决,则重新安装手机驱动: 1)我的电脑---右键--属性--硬件---设备管理器--删除USB驱动 2)打开手机助手重新安装驱动 此时手机上可能需要授权确认,点击确认,然后再重新运行真机调试 8.如果以上方案均无法解决,则有可能是手机root的时候把sdcard目录的权限搞错了,导致无法真机运行,此时可以恢复出厂设置,或者重新root,或者刷机解决此问题 Q:Android真机联调报:open '/dev/hwlog_switch' fail -1, 13. Permission denied A:请尝试以下方法解决: 1.拔插数据线重试 2.重新打开USB调试模式重试 3.重启手机重试 4.重新启动HBuilder重试 5.如果以上方案均无法解决,则有可能是手机root的时候把sdcard目录的权限搞错了,导致无法真机运行,此时可以恢复出厂设置,或者重新root,或者刷机解决此问题 Q:真机联调图标和启动图片如何更改 A:真机联调不是打包,资源都是DCloud预先打包好的,只有自己重新打包,才能更改图标,启动图片,这是原生应用的规范;如果是为了在手机浏览器上使用的WEB应用,还是应该使用手机浏览器来访问,HBuilder内置的web服务器地址配成192.168等内网地址,手机wifi连入,即可访问 更改HBuilder内置的web服务器地址请点击菜单工具-选项,展开左边的HBuilder-web服务器-内建服务器,在右边更改地址,需要重启HBuilder才生效 Q:为什么Android手机没有SDCard就不能真机调试 A:Android没有root的手机只有SDCard才有权限,不过此SDCard并不是非得外插一张实体sd卡,是手机里一个叫SDCard的根目录;如果是使用Android模拟器,在模拟器里可以配置SDCard是否存在及大小 Q:控制台显示手机应用已启动,但手机屏幕上没有出现 A:Android手机第一次安装基座应用时,手机端大多有各种杀毒软件要检测一会才会放行,需要等一会 Q:运行后手机端一直在启动画面停留,不停转圈不能进入 A:这个是应用的js代码的问题,启动画面的关闭是可配置的 Q:为什么我电脑没有插iphone,但HBuilder检测到iOS设备 A:iTunes支持wifi同步,如果iOS设备启动了wifi同步,电脑端的iTunes就可以检测到,进而HBuilder也可以检测到 Q:真机运行成功启动,但手机端软件启动后显示的不是正在运行的项目 A: 1.这种情况是adb连接手机成功,但copy项目文件到手机上失败了,首先尝试重新运行真机调试 2.Android设备可能存在与手机助手冲突的情况,点击检查冲突 3.确认手机上HBuilder应用安装位置,如果手机上有外置SDCard,不要把HBuilder基座App安装在外置SDCard上,如果是安装在外置SDCard上,卸载外置SDCard上的HBuilder基座App,并在设置中将应用的默认安装位置不要设置为外置的SDCard上,或者将应用转移至手机内存或内置SDCard上,并重新运行真机调试. Q:真机运行启动后显示HBuilder真机运行(log)界面 A: 1.重新运行真机调试尝试解决问题 2.Android设备可能存在与手机助手冲突的情况,请关闭所有的手机助手重新运行真机调试 3.如果步骤2无法解决,请更换别的手机助手,重新运行真机调试尝试解决问题 4.确认手机上HBuilder应用安装位置,如果手机上有外置sdcard,不要把HBuilder基座App安装在外置sdcard上,如果是安装在外置sdcard上,卸载外置sdcard上的HBuilder基座App,并在设置中将应用的默认安装位置不要设置为外置的sdcard上,或者将应用转移至手机内存或内置sdcard上,并重新运行真机调试 外部工具使用指南 外部工具指将一些外部程序/命令配置为HBuilder可通过菜单直接操作的命令 如何添加外部工具 运行-外部工具-外部工具配置如下图选择程序菜单,点击“新建启动配置”如下图A处为外部的exe(请输入exe的全路径)或命令行命令;B处为执行此命令所处的目录;C处为执行命令需要的变量 点击变量按钮,可使用HBuilder内置的变量,如下图以上图为例,project_name变量指的是资源所在的项目;配置完毕后点击应用即可保存此外部工具,如下图上图配置的外部工具,点击运行的效果相当于在CMD命令行下,切换到E盘根目录,运行点击运行,E盘根目录生成1.txt/2.txt/3.txt如下图 如何为外部工具添加快捷键 依次点击工具-选项-常规-快捷键,在过滤文本中输入外部工具,回车如下图绑定自己喜欢的快捷键即可 给SVN/GIT等绑定操作快捷键 1.切换到你想用快捷键的视图(如开发视图/边改边看视图) 2.点击视图,定制透视图3.选择命令选项卡4.选择SVN或Git 5.设置成功后会在帮助菜单前生成SVN、Git等菜单 6.在工具-选项-快捷键中为SVN、Git等操作绑定快捷键即可 速度慢/响应卡顿/CPU高/占用内存高怎么办 HBuilder功能比文本编辑器更多,资源消耗也更多,但HBuilder可保证主流配置电脑流畅使用;我们先说下HBuilder比文本编辑器慢的几个原因: 1.HBuilder毕竟是IDE,功能比文本编辑器多,执行也自然会相对慢 2.HBuilder还自带了可调试控制台的浏览器,ide+浏览器都在这里,内存占用肯定也少不了 3.插件有问题导致卡:HBuilder的三方eclipse插件,如aptana的php/ftp插件 4.HBuilder遇到某些情况的bug造成卡:目前这种情况已经比较少见了 然后讨论下让HBuilder更快的技巧,或使用中避免不卡的注意事项 1.如果有固态硬盘,把HBuilder和工程代码都放到SSD固态盘上;现在的电脑配置,cpu和内存都不是问题,往往的瓶颈是硬盘上 2.同时打开的项目不要太多,把不用的项目点右键关闭,这样HBuilder就不扫描这些项目了,后台资源会释放不少 3.编辑大文档时慎用自动语法验证器,语法验证过程较易引发卡顿,可以在工具-选项-HBuilder-语法验证器设置里关闭,或选择手动验证语法 4.编辑大文档时,最好关闭大纲的实时同步功能;大文档的大纲结构会很多,每次移动光标实时计算大纲的位置会有点慢。可以在需要定位时再点一下同步。大纲实时同步在大纲视图的右上角的下拉菜单里 清理无用的js框架和素材库,Js框架文件都比较大且结构复杂,素材库文件可能很多,扫描这些文件比较费时,不用的文件就移出项目;如果不在意这些文件的扫描提示,也可以把文件移除扫描清单,这样就会更流畅;对不用的文件或目录点右键-构建-移除构建目录 6.windows search index和dropxbox等工具也会监控磁盘,当项目文件目录被他们监控时,磁盘IO会比较高,在新建项目时会卡 7.刚导入一个大工程时,或语法库升级时,会触发索引构建,此时cpu会比较高,并行做其他操作就会卡顿,但构建完毕后会恢复正常 8.不用边看边改时,不要最小化那个浏览器,直接关掉它(ctrl+shift+p);不然你改其他页面时,那个浏览器始终在运行,万一临时写的js有死循环,那HBuilder就挂掉了;而且HBuilder是相当于同时开了ide和浏览器,浏览器也是吃资源的,可能总体内存看着占了不少,但比较某些工具+浏览器合起来占的内存,其实也不多 9.有些杀毒软件在监控HBuilder的exe和dll等文件,导致HBuilder卡顿,此时请把HBuilder的目录设成杀毒软件的白名单,禁止杀毒软件扫描 简单说下IDE和文本编辑器的区别: IDE有AST语法树,是专用于某种语言的优化开发工具,它能认识这种语言;而文本编辑器是通用的,没有为特定的语言做优化,语法提示也乱;比如var a = document.getElementById("a1");,在a后敲点出它的方法属性时,HBuilder要扫描a到底是什么,超链接?canvas?输入框?然后才会给予用户最准确的提示;这种计算都需要在按下键盘的很短时间内完成,文本编辑器没有这些功能,它不管什么都提示一样的内容,所以提示速度更快;而在所有的语言的AST构建中,js这种动态语言是最复杂的;一个function,可能根据参数不同返回多种类型,这样的function后面再点时,HBuilder都会分析function里的代码以确定返回类型 AST不止用于语法提示,转到定义/重构变量都离不开它,这些功能也是文本编辑器缺失的;所以在HBuilder里alt+左键转到定义非常好用,而文本编辑器就做不到了
优秀的个人博客,低调大师

Java内存模型学习

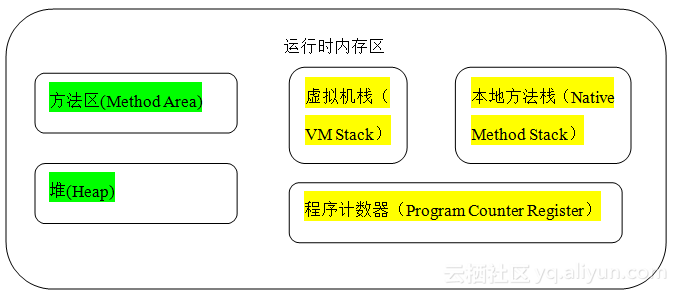
1,内存模型 左侧绿色区域为共享内存区,右侧黄色区域为线程私有内存区①方法区:存放被虚拟机加载的类信息,常量,静态变量,即时编译器编译后的代码,方法区有一个运行时常量池存放编译器生成的字面量和符号引用。②堆:虚拟机启动时创建,Java虚拟机管理内存中最大的一块,用于存放对象实例(注意:因为堆是垃圾收集器管理的主要区域,因此也叫GC堆)③程序计数器:记录当前线程执行的字节码行号指示器,控制分支,循环,跳转,异常,线程恢复等基础功能④虚拟机栈:虚拟机私有,线程创建时创建,代表java方法执行的内存模型。每个方法执行都会创建一个栈帧来存储方法的变量,操作数栈,动态链接方法,返回值,返回地址等信息。每个方法从调用到结束就对应于虚拟机栈中入栈和出栈的过程。⑤本地方法栈:与虚拟机用到的Native方法相关。 2,内存执行模型java程序的运行实体是线程,每个线程都会有一个工作内存(即栈空间)由线程私有,而内存模型归档所有的变量都存储在所有线程共享的堆内存,所以线程对变量的操作要:①从堆内存中拷贝变量的副本到本线程的工作内存中②在本线程的工作内存中操作变量副本③操作完成后将变量写会回主内存注意:如果方法中有一个局部变量是基本数据类型(如int, long, boolean, byte, short, char, float, double)则该变量直接存储在线程私有的栈内存中,如果本地变量是引用类型,则该引用存储在栈内存中,引用指向的实例存放在堆内存中。 3,CPU与内存的交互模型 读写速度CPU寄存器>CPU缓存>RAM 4,java线程与内核线程内核线程是操作系统内核支持的线程,由操作系统内核完成线程管理,对于应用程序而言,一般不会直接调用内核线程,而是使用一种轻量级的进程(即通称意义上的线程),每个轻量级的进程都会映射到一个内核线程上,然后由操作系统将内核线程分发给各个处理器处理。一个轻量级进程(线程)会映射到一个内核线程 5,线程安全问题1)多个线程同时操作堆内存中的数据(线程间共享)时,可能引发线程安全问题,原因是:每个线程都会拷贝一份数据副本到线程私有内存区,如果线程A,B同一时间段内读取数据,修改,并回写,可能发生①A回写前,B就复制副本;②A回写后,B才复制副本等不确定问题。2)程序运算的时候并不是所有操作在操作系统层都是原子性的,例如程序执行c = a+b,在指令层面可能会有:①load a to register1②load b to register2③add register1 register2 to register3④load register3 to c。这样的情况如果在多线程同时处理c变量的时候就有可能出现线程安全问题。另外:编译器语句重排;执行并行重排;内存系统重排等。3)线程A修改了共享变量a的值,还未回写到共享存储区之前线程B是不知道修改后的值的,但在单线程下,修改后的值都是可见的,这叫可见性4)java程序中,在本线程内所有的操作都视为有序的,这叫有序性;多线程环境下,一个线程中观察另外一个线程,所有操作都是无序的(由于指令重排/主内存和工作内存的延迟同步现象) 6,如何解决上面的原子性,可见性,有序性①synchronized或ReentrantLock保证操作的原子性(volatile不能保证原子性)②synchronized或volatile关键字保证可见性③volatile保证有序性,因为它禁止重排优化④happens-before原则 7,volatile的作用①保证被volatile修饰的共享变量对所有的线程都是可见的,即:某个线程修改后的新值总是被其他线程立即得到②禁止指令重排③volatile不能保证原子性,例如下面的程序可能会有线程安全问题:public class VolatileVisibility{public volatile static int I = 0;public static void increase(){ i++;//改操作不是原子性的,所以任然可能会有线程安全问题 }}修改方法是在increase方法上用synchronized修饰,属性定义上可去掉volatile修饰。volatile保证可见性的方式:当修改一个volatile变量时,会强制将工作内存中改变后的值刷新到主内存;读取volatile变量时,会先将本线程工作内存中的值置为无效,重新从主内存里读取新副本。④典型单例模式中禁止重排例子Public class DoubleCheckLock {private static DoubleCheckLock instance;private DoubleCheckLock (){};public DoubleCheckLock getInstance(){ if(null == instance){ synchronized (DoubleCheckLock.class){ if(null == instance){ instance = new DoubleCheckLock(); }}}return instance;}}上面的程序有线程安全问题:当线程B读取到instance不为空的时候,其他线程初始化的动作可能还没有完成,因为new DoubleCheckLock();大致可以分为如下3步:①memory = allocate();//分配内存空间②instance(memory);//初始化内存区域③instance=memory;//将初始化好的内存区域赋值给instance上面三步中的②③可能会出现重排,即先赋值,再初始化。因此此时应该在私有变量instance上用volatile修饰:public volatile static DoubleCheckLock instance;

优秀的个人博客,低调大师

CUDA学习(九十四)

数据迁移和一致性:统一内存通过将数据迁移到正在访问的设备(即将数据移动到主机内存(如果CPU正在访问它,并将数据移动到设备内存,如果GPU将访问它),来尝试优化内存性能)。 数据迁移是统一内存的基础,但对于程序而言是透明的。 系统会尝试将数据放置在最有效访问的位置,而不会违反一致性。数据的物理位置对于程序是不可见的,并且可以随时更改,但访问数据的虚拟地址将保持任何处理器的有效性和连贯性,而不管本地是什么。 请注意,保持一致性是主要要求,在性能之前; 在主机操作系统的限制下,系统被允许无法访问或移动数据,以保持处理器之间的全局一致性。计算能力低于6.x的GPU架构不支持托管数据向GPU按需细粒度移动。无论何时启动GPU内核,通常都必须将所有托管内存传输到GPU内存,以避免内存访问出现故障。通过计算能力6.x,引入了新的GPU页面错误机制,可提供更加无缝的统一内存功能。结合系统范围的虚拟地址空间,页面错误提供了几个好处。首先,页面错误意味着CUDA系统软件在每次内核启动之前不需要将所有托管的内存分配同步到GPU。如果在GPU上运行的内核访问不在其内存中的页面,则它会发生故障,从而允许页面按需自动迁移到GPU内存。或者,页面可能映射到GPU地址空间,以便通过PCIe或NVLink互连进行访问(访问映射有时可能比迁移快)。请注意,统一内存是系统范围内的:GPU(和CPU)可能会在CPU内存或系统中其他GPU的内存上发生故障并迁移内存页面。GPU内存Oversubscription:计算能力低于6.x的设备无法分配比GPU内存的物理大小更多的托管内存。计算能力6.x的设备扩展寻址模式以支持49位虚拟寻址。 这足以覆盖现代CPU的48位虚拟地址空间以及GPU自己的内存。 大型虚拟地址空间和页面错误功能使应用程序能够访问整个系统虚拟内存,而不受任何一个处理器的物理内存大小的限制。 这意味着应用程序可以超额订阅内存系统:换句话说,它们可以分配,访问和共享比系统总物理容量更大的阵列,从而可以对超大型数据集进行非核心处理。 只要有足够的系统内存可用于分配,cudaMallocManaged就不会耗尽内存多GPU支持:对于计算能力低于6.x的设备,托管内存分配的行为与使用cudaMalloc()分配的非托管内存的行为相同:当前活动设备是物理分配的归属,所有其他GPU都接收对等映射到内存。 这意味着系统中的其他GPU将通过PCIe总线以更低的带宽访问内存。 请注意,如果系统中的GPU之间不支持对等映射,则托管内存页将放置在CPU系统内存(“零拷贝”内存)中,并且所有GPU都会遇到PCIe带宽限制。 有关详细信息,请参阅6.x之前的架构下的带有多GPU程序的托管内存。具有计算能力6.x的设备的系统上的托管分配对所有GPU均可见,并可按需迁移到任何处理器。

优秀的个人博客,低调大师

CUDA学习(九十二)

统一的存储器编程:统一内存简介:Unified Memory是CUDA编程模型的一个组件,首次在CUDA 6.0中引入,该模型定义了一个托管内存空间,其中所有处理器都可以看到具有公共地址空间的单个一致内存映像。(处理器是指具有专用MMU的任何独立执行单元。 这包括任何类型和架构的CPU和GPU。)底层系统管理CUDA程序中的数据访问和位置,而不需要显式的内存拷贝调用。 这有利于两种主要方式的GPU编程: GPU编程通过统一系统中所有GPU和CPU的内存空间并通过为CUDA程序员提供更紧密和更直接的语言集成而得到简化。 通过将数据透明地迁移到使用它的处理器,可以最大限度地提高数据访问速度。 简而言之,统一内存不需要通过cudaMemcpy *()例程进行显式数据移动,而且不会因将所有数据放入零拷贝内存而导致性能损失。 数据移动当然仍然会发生,所以程序的运行时间通常不会减少; 统一内存改为可以编写更简单,更易维护的代码。Unified Memory提供了一个“单指针到数据”模型,它在概念上类似于CUDA的零拷贝内存。 两者之间的一个关键区别在于,使用零拷贝分配时,内存的物理位置被固定在CPU系统内存中,使得程序可能对其进行快速访问或缓慢访问,具体取决于访问的位置。 另一方面,统一内存将内存和执行空间分开,以便所有数据访问都很快。统一内存这个术语描述了一个系统,它提供内存管理服务给各种各样的程序,从定位运行时API到使用虚拟ISA(PTX)的程序。 该系统的一部分定义了选择统一内存服务的托管内存空间。托管内存可与设备特定的分配互操作并互换,例如使用cudaMalloc()例程创建的分配。 所有在设备内存上有效的CUDA操作在托管内存上也是有效的; 主要区别在于程序的主机部分也能够引用和访问内存。系统要求:统一内存有两个基本要求: SM体系结构3.0或更高版本的GPU(开普勒架构或更新) 一个64位主机应用程序和非嵌入式操作系统(Linux,Windows,MacOS) SM体系结构6.x或更高版本(Pascal或更新版本)的GPU可提供额外的统一内存功能,如本文档中概述的按需页面迁移和GPU内存超额认购。 请注意,目前这些功能仅在Linux操作系统上受支持。 运行在Windows上的应用程序(无论是TCC还是WDDM模式)还是macOS,都将使用基本统一内存模型,与6.x之前的体系结构一样,即使它们在计算能力为6.x或更高的硬件上运行。

优秀的个人博客,低调大师

深度学习必备包

安装 Tensorflow Keras Opencv # For a specific version: !pip install tensorflow-gpu==1.5.0rc0 # To determine which version you're using: !pip show tensorflow-gpu # For the current version: !pip install --upgrade tensorflow-gpu # For the latest nightly build: !pip install tf-nightly-gpu !pip install -U tensorflow-gpu !pip install -U keras !pip install opencv-contrib-python --upgrade Keras: The Python Deep Learning library OpenCV An open-source software library for Machine Intelligence Install 7zip reader libarchive !pip install -U libarchive Install GraphViz & PyDot !pip install -U pydot graphviz Install xgboost !pip install -U xgboost import tensorflow as tf tf.keras # Keras 为 TensorFlow 提供了 API 探寻有趣之事!

优秀的个人博客,低调大师

python的HTMLParser学习

先来大致看看HTMLParser的源代码吧: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 260 261 262 263 264 265 266 267 268 269 270 271 272 273 274 275 276 277 278 279 280 281 282 283 284 285 286 287 288 289 290 291 292 293 294 295 296 297 298 299 300 301 302 303 304 305 306 307 308 309 310 311 312 313 314 315 316 317 318 319 320 321 322 323 324 325 326 327 328 329 330 331 332 333 334 335 336 337 338 339 340 341 342 343 344 345 346 347 348 349 350 351 352 353 354 355 356 357 358 359 360 361 362 363 364 365 366 367 368 369 370 371 372 373 374 375 376 377 378 379 380 381 382 383 384 385 386 387 388 389 390 """A parser for HTML and XHTML.""" # This file is based on sgmllib.py, but the API is slightly different. # XXX There should be a way to distinguish between PCDATA (parsed # character data -- the normal case), RCDATA (replaceable character # data -- only char and entity references and end tags are special) # and CDATA (character data -- only end tags are special). import markupbase import re # Regular expressions used for parsing interesting_normal = re. compile ( '[&<]' ) interesting_cdata = re. compile (r '<(/|\Z)' ) incomplete = re. compile ( '&[a-zA-Z#]' ) entityref = re. compile ( '&([a-zA-Z][-.a-zA-Z0-9]*)[^a-zA-Z0-9]' ) charref = re. compile ( '&#(?:[0-9]+|[xX][0-9a-fA-F]+)[^0-9a-fA-F]' ) starttagopen = re. compile ( '<[a-zA-Z]' ) piclose = re. compile ( '>' ) commentclose = re. compile (r '--\s*>' ) tagfind = re. compile ( '[a-zA-Z][-.a-zA-Z0-9:_]*' ) attrfind = re. compile ( r '\s*([a-zA-Z_][-.:a-zA-Z_0-9]*)(\s*=\s*' r '(\'[^\']*\'|"[^"]*"|[-a-zA-Z0-9./,:;+*%?!&$\(\)_#=~@]*))?' ) locatestarttagend = re. compile (r """ <[a-zA-Z][-.a-zA-Z0-9:_]* # tag name (?:\s+ # whitespace before attribute name (?:[a-zA-Z_][-.:a-zA-Z0-9_]* # attribute name (?:\s*=\s* # value indicator (?:'[^']*' # LITA-enclosed value |\"[^\"]*\" # LIT-enclosed value |[^'\">\s]+ # bare value ) )? ) )* \s* # trailing whitespace """ , re.VERBOSE) endendtag = re. compile ( '>' ) endtagfind = re. compile ( '</\s*([a-zA-Z][-.a-zA-Z0-9:_]*)\s*>' ) class HTMLParseError(Exception): """Exception raised for all parse errors.""" def __init__( self , msg, position = ( None , None )): assert msg self .msg = msg self .lineno = position[ 0 ] self .offset = position[ 1 ] def __str__( self ): result = self .msg if self .lineno is not None : result = result + ", at line %d" % self .lineno if self .offset is not None : result = result + ", column %d" % ( self .offset + 1 ) return result class HTMLParser(markupbase.ParserBase): """Find tags and other markup and call handler functions. Usage: p = HTMLParser() p.feed(data) ... p.close() Start tags are handled by calling self.handle_starttag() or self.handle_startendtag(); end tags by self.handle_endtag(). The data between tags is passed from the parser to the derived class by calling self.handle_data() with the data as argument (the data may be split up in arbitrary chunks). Entity references are passed by calling self.handle_entityref() with the entity reference as the argument. Numeric character references are passed to self.handle_charref() with the string containing the reference as the argument. """ CDATA_CONTENT_ELEMENTS = ( "script" , "style" ) def __init__( self ): """Initialize and reset this instance.""" self .reset() def reset( self ): """Reset this instance. Loses all unprocessed data.""" self .rawdata = '' self .lasttag = '???' self .interesting = interesting_normal markupbase.ParserBase.reset( self ) def feed( self , data): """Feed data to the parser. Call this as often as you want, with as little or as much text as you want (may include '\n'). """ self .rawdata = self .rawdata + data self .goahead( 0 ) def close( self ): """Handle any buffered data.""" self .goahead( 1 ) def error( self , message): raise HTMLParseError(message, self .getpos()) __starttag_text = None def get_starttag_text( self ): """Return full source of start tag: '<...>'.""" return self .__starttag_text def set_cdata_mode( self ): self .interesting = interesting_cdata def clear_cdata_mode( self ): self .interesting = interesting_normal # Internal -- handle data as far as reasonable. May leave state # and data to be processed by a subsequent call. If 'end' is # true, force handling all data as if followed by EOF marker. def goahead( self , end): rawdata = self .rawdata i = 0 n = len (rawdata) while i < n: match = self .interesting.search(rawdata, i) # < or & if match: j = match.start() else : j = n if i < j: self .handle_data(rawdata[i:j]) i = self .updatepos(i, j) if i = = n: break startswith = rawdata.startswith if startswith( '<' , i): if starttagopen.match(rawdata, i): # < + letter k = self .parse_starttag(i) elif startswith( "</" , i): k = self .parse_endtag(i) elif startswith( "<!--" , i): k = self .parse_comment(i) elif startswith( "<?" , i): k = self .parse_pi(i) elif startswith( "<!" , i): k = self .parse_declaration(i) elif (i + 1 ) < n: self .handle_data( "<" ) k = i + 1 else : break if k < 0 : if end: self .error( "EOF in middle of construct" ) break i = self .updatepos(i, k) elif startswith( "&#" , i): match = charref.match(rawdata, i) if match: name = match.group()[ 2 : - 1 ] self .handle_charref(name) k = match.end() if not startswith( ';' , k - 1 ): k = k - 1 i = self .updatepos(i, k) continue else : if ";" in rawdata[i:]: #bail by consuming &# self .handle_data(rawdata[ 0 : 2 ]) i = self .updatepos(i, 2 ) break elif startswith( '&' , i): match = entityref.match(rawdata, i) if match: name = match.group( 1 ) self .handle_entityref(name) k = match.end() if not startswith( ';' , k - 1 ): k = k - 1 i = self .updatepos(i, k) continue match = incomplete.match(rawdata, i) if match: # match.group() will contain at least 2 chars if end and match.group() = = rawdata[i:]: self .error( "EOF in middle of entity or char ref" ) # incomplete break elif (i + 1 ) < n: # not the end of the buffer, and can't be confused # with some other construct self .handle_data( "&" ) i = self .updatepos(i, i + 1 ) else : break else : assert 0 , "interesting.search() lied" # end while if end and i < n: self .handle_data(rawdata[i:n]) i = self .updatepos(i, n) self .rawdata = rawdata[i:] # Internal -- parse processing instr, return end or -1 if not terminated def parse_pi( self , i): rawdata = self .rawdata assert rawdata[i:i + 2 ] = = '<?' , 'unexpected call to parse_pi()' match = piclose.search(rawdata, i + 2 ) # > if not match: return - 1 j = match.start() self .handle_pi(rawdata[i + 2 : j]) j = match.end() return j # Internal -- handle starttag, return end or -1 if not terminated def parse_starttag( self , i): self .__starttag_text = None endpos = self .check_for_whole_start_tag(i) if endpos < 0 : return endpos rawdata = self .rawdata self .__starttag_text = rawdata[i:endpos] # Now parse the data between i+1 and j into a tag and attrs attrs = [] match = tagfind.match(rawdata, i + 1 ) assert match, 'unexpected call to parse_starttag()' k = match.end() self .lasttag = tag = rawdata[i + 1 :k].lower() while k < endpos: m = attrfind.match(rawdata, k) if not m: break attrname, rest, attrvalue = m.group( 1 , 2 , 3 ) if not rest: attrvalue = None elif attrvalue[: 1 ] = = '\'' = = attrvalue[ - 1 :] or \ attrvalue[: 1 ] = = '"' = = attrvalue[ - 1 :]: attrvalue = attrvalue[ 1 : - 1 ] attrvalue = self .unescape(attrvalue) attrs.append((attrname.lower(), attrvalue)) k = m.end() end = rawdata[k:endpos].strip() if end not in ( ">" , "/>" ): lineno, offset = self .getpos() if "\n" in self .__starttag_text: lineno = lineno + self .__starttag_text.count( "\n" ) offset = len ( self .__starttag_text) \ - self .__starttag_text.rfind( "\n" ) else : offset = offset + len ( self .__starttag_text) self .error( "junk characters in start tag: %r" % (rawdata[k:endpos][: 20 ],)) if end.endswith( '/>' ): # XHTML-style empty tag: <span attr="value" /> self .handle_startendtag(tag, attrs) else : self .handle_starttag(tag, attrs) if tag in self .CDATA_CONTENT_ELEMENTS: self .set_cdata_mode() return endpos # Internal -- check to see if we have a complete starttag; return end # or -1 if incomplete. def check_for_whole_start_tag( self , i): rawdata = self .rawdata m = locatestarttagend.match(rawdata, i) if m: j = m.end() next = rawdata[j:j + 1 ] if next = = ">" : return j + 1 if next = = "/" : if rawdata.startswith( "/>" , j): return j + 2 if rawdata.startswith( "/" , j): # buffer boundary return - 1 # else bogus input self .updatepos(i, j + 1 ) self .error( "malformed empty start tag" ) if next = = "": # end of input return - 1 if next in ( "abcdefghijklmnopqrstuvwxyz=/" "ABCDEFGHIJKLMNOPQRSTUVWXYZ" ): # end of input in or before attribute value, or we have the # '/' from a '/>' ending return - 1 self .updatepos(i, j) self .error( "malformed start tag" ) raise AssertionError( "we should not get here!" ) # Internal -- parse endtag, return end or -1 if incomplete def parse_endtag( self , i): rawdata = self .rawdata assert rawdata[i:i + 2 ] = = "</" , "unexpected call to parse_endtag" match = endendtag.search(rawdata, i + 1 ) # > if not match: return - 1 j = match.end() match = endtagfind.match(rawdata, i) # </ + tag + > if not match: self .error( "bad end tag: %r" % (rawdata[i:j],)) tag = match.group( 1 ) self .handle_endtag(tag.lower()) self .clear_cdata_mode() return j # Overridable -- finish processing of start+end tag: <tag.../> def handle_startendtag( self , tag, attrs): self .handle_starttag(tag, attrs) self .handle_endtag(tag) # Overridable -- handle start tag def handle_starttag( self , tag, attrs): pass # Overridable -- handle end tag def handle_endtag( self , tag): pass # Overridable -- handle character reference def handle_charref( self , name): pass # Overridable -- handle entity reference def handle_entityref( self , name): pass # Overridable -- handle data def handle_data( self , data): pass # Overridable -- handle comment def handle_comment( self , data): pass # Overridable -- handle declaration def handle_decl( self , decl): pass # Overridable -- handle processing instruction def handle_pi( self , data): pass def unknown_decl( self , data): self .error( "unknown declaration: %r" % (data,)) # Internal -- helper to remove special character quoting entitydefs = None def unescape( self , s): if '&' not in s: return s def replaceEntities(s): s = s.groups()[ 0 ] if s[ 0 ] = = "#" : s = s[ 1 :] if s[ 0 ] in [ 'x' , 'X' ]: c = int (s[ 1 :], 16 ) else : c = int (s) return unichr (c) else : # Cannot use name2codepoint directly, because HTMLParser supports apos, # which is not part of HTML 4 import htmlentitydefs if HTMLParser.entitydefs is None : entitydefs = HTMLParser.entitydefs = { 'apos' :u "'" } for k, v in htmlentitydefs.name2codepoint.iteritems(): entitydefs[k] = unichr (v) try : return self .entitydefs[s] except KeyError: return '&' + s + ';' return re.sub(r "&(#?[xX]?(?:[0-9a-fA-F]+|\w{1,8}));" , replaceEntities, s) 大家可以看到,其实内部的很多的方法都是没有实现的,所以需要我们继承这个类,自己去实现一些方法。关于HTMLParser的方法,大家可以参考官方文档: http://docs.python.org/library/htmlparser.html#HTMLParser.HTMLParser(英文,笔者没有多少时间去翻译这些) 另外,给一个例子大家对照着看看,我相信这么简单的例子,大家都能看懂的。 假设我们要处理的文件在d盘根目录下,名字为hello.html,文件的内容为: <! DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd"> < html xmlns="http://www.w3.org/1999/xhtml"> < head > < meta http-equiv="Content-Type" content="text/html; charset=utf-8"/> < title >Rollen Holt - cnblogs</ title > < meta name="keywords" content="Rollen Holt,rollenholt" /> < link type="text/css" rel="stylesheet" href="http://www.cnblogs.com/css/common.css"/> < link id="MainCss" type="text/css" rel="stylesheet" href="http://www.cnblogs.com/Skins/kubrick/style.css"/> < link type="text/css" rel="stylesheet" href="http://www.cnblogs.com/css/common2.css"/> < link type="text/css" rel="stylesheet" href="http://common.cnblogs.com/css/shCore.css"/> < link type="text/css" rel="stylesheet" href="http://common.cnblogs.com/css/shThemeDefault.css"/> < link title="RSS" type="application/rss+xml" rel="alternate" href="http://www.cnblogs.com/rollenholt/rss"/> < link title="RSD" type="application/rsd+xml" rel="EditURI" href="http://www.cnblogs.com/rollenholt/rsd.xml"/> < link type="application/wlwmanifest+xml" rel="wlwmanifest" href="http://www.cnblogs.com/rollenholt/wlwmanifest.xml"/> < script src="http://common.cnblogs.com/script/jquery.js" type="text/javascript"></ script > < script src="/script/common.js" type="text/javascript"></ script > < script src="http://common.cnblogs.com/script/jquery.json-2.2.min.js" type="text/javascript"></ script > < script type="text/javascript" src="http://common.cnblogs.com/script/shCore.js"></ script > < script type="text/javascript" src="http://common.cnblogs.com/script/shLanguage.js"></ script > </ head > < body > < a name="top"></ a > < form method="post" action="" id="Form1"> < div class="aspNetHidden"> < input type="hidden" name="__VIEWSTATE" id="__VIEWSTATE" value="" /> </ div > </ form > </ body > </ html > 我们的python代码为: #coding=utf-8 from HTMLParser import HTMLParser class MyParser(HTMLParser): """一个简单的HTMLparser的例子""" def handle_decl( self , decl): """处理头文档""" HTMLParser.handle_decl( self , decl) print decl def handle_starttag( self , tag, attrs): """处理起始标签""" HTMLParser.handle_starttag( self , tag, attrs) if not HTMLParser.get_starttag_text( self ).endswith( "/>" ): print "<" ,tag, ">" def handle_data( self , data): """处理文本元素""" HTMLParser.handle_data( self , data) print data, def handle_endtag( self , tag): """处理结束标签""" HTMLParser.handle_endtag( self , tag) if not HTMLParser.get_starttag_text( self ).endswith( "/>" ): print "</" ,tag, ">" def handle_startendtag( self , tag, attrs): """处理自闭标签""" HTMLParser.handle_startendtag( self , tag, attrs) print HTMLParser.get_starttag_text( self ) def handle_comment( self , data): """处理注释""" HTMLParser.handle_comment( self , data) print data def close( self ): HTMLParser.close( self ) print "parser over" demo = MyParser() demo.feed( open ( "d:\\hello.html" ).read()) demo.close() 输出的结果为: DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd" < html > < head > <meta http-equiv="Content-Type" content="text/html; charset=utf-8"/> < title > Rollen Holt - cnblogs </ title > <meta name="keywords" content="Rollen Holt,rollenholt" /> <link type="text/css" rel="stylesheet" href="http://www.cnblogs.com/css/common.css"/> <link id="MainCss" type="text/css" rel="stylesheet" href="http://www.cnblogs.com/Skins/kubrick/style.css"/> <link type="text/css" rel="stylesheet" href="http://www.cnblogs.com/css/common2.css"/> <link type="text/css" rel="stylesheet" href="http://common.cnblogs.com/css/shCore.css"/> <link type="text/css" rel="stylesheet" href="http://common.cnblogs.com/css/shThemeDefault.css"/> <link title="RSS" type="application/rss+xml" rel="alternate" href="http://www.cnblogs.com/rollenholt/rss"/> <link title="RSD" type="application/rsd+xml" rel="EditURI" href="http://www.cnblogs.com/rollenholt/rsd.xml"/> <link type="application/wlwmanifest+xml" rel="wlwmanifest" href="http://www.cnblogs.com/rollenholt/wlwmanifest.xml"/> < script > </ script > < script > </ script > < script > </ script > < script > </ script > < script > </ script > </ head > < body > < a > </ a > < form > < div > <input type="hidden" name="__VIEWSTATE" id="__VIEWSTATE" value="" /> parser over ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/archive/2011/12/01/2271058.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

算法学习--数组

一个数组存放了2n+1个整数,其中有n个数出现了2次,1个数出现了1次,找出出现1次的数是多少? //方法一:借助辅助数组(长度为n+1,元素为一结构体(包含数值和 //个数两个成员))进行计数,但是时间复杂度为O(n*n),空间复杂度为O(n+1) //本来是想把Val定义为结构体的,但由于结构体是值类型,不是引用类型, //添加到List结合中的元素的属性值不能被修改,把List中的一个元素赋给另一个Val,修改Val中的value和num, //List中对应的Val相关的属性值是不会改变的,因为他们是内存中的两个不同单元 //总之:谁叫我C学得不好,用的是C#呢,不然就用C实现了。 public class Val {public int value;//值 public int num;//出现的次数 }public int FindA(int[] A, int n) { List<Val> list = new List<Val>(); Val val ; int j=0;for (int i = 0; i < n ; i++) {while (j < n) {bool isExist = false;for(int k=0;k<list.Count;k++) { if (list[k].value == A[j]) { isExist = true; list[k].num = 2;break; } }if (!isExist) { val = new Val(); val.value = A[j]; val.num = 1; list.Add(val); } j++; } }int result = -1;foreach (Val v in list) {if (v.num == 1) { result = v.value;break; } }return result; }//方法二:借助一个长度为n/2+1的数组B,如果A中的元素不在B中,就存入B中,//如果在B中,存在的那个元素后面所有的元素向前移一个单位,相当于去掉这个在B中存在的元素,//这一进一出的,出现偶数次的都去掉了,只剩下出现奇数次的元素。 public int FindI(int[] A, int n) {int[] B = new int[n / 2 + 1];int k = 0;for (int i = 0; i < n; i++) {bool isExist = false;for (int j = 0; j <= k; j++) {if (A[i] == B[j]) { isExist = true;for (int f = j; f < k - 1; f++) { B[f] = B[f + 1]; } k--;break; } }if (!isExist) { B[k] = A[i]; k++; } }return B[0]; }//方法三:排序。相等的数当然就在一起,单独的那个数就是那个只出现一次的了,哈哈... public int FindS(int[] A, int n) {for (int i = 0; i < n - 1; i++) {for (int j = i + 1; j < n; j++) {if (A[i] > A[j]) {int temp = A[j]; A[j] = A[i]; A[i] = temp; } } }int result = -1;for (int i = 0; i < n; i = i + 2) {if (A[i] != A[i + 1]) { result = A[i];break; } }return result; }//方法四:异或运算(博客园这位帅哥牛) //异或运算 0与任何数异或等于任何数,相等的两个数异或等于0,//也就是两个数对应的二进制位进行异或运算;0^0=0 , 1^0=1 , 0^1=1 , 1^1=0//出现偶数次都完蛋了,就剩下出现奇数次的了 public int FindSpecial(int[] A, int n) {int res = 0;for (int i = 0; i < n; i++) { res = res ^ A[i]; }return res; } 本文转自啊汉博客园博客,原文链接:http://www.cnblogs.com/hlxs/archive/2010/11/16/2087989.html

优秀的个人博客,低调大师

Android开发学习清单

目录: 第1章 Android应用与开发环境 1.1 Android的发展和历史 1.1.1 Android的发展和简介 1.1.2 Android平台架构及特性 1.2 搭建Android开发环境 1.2.1下载和安装Android SDK 1.2.2 安装Eclipse和ADT插件 1.3 Android常用开发工具的用法 1.3.1创建、删除和浏览AVD 1.3.2 使用Android模拟器(Emulator) 1.3.3使用DDMS进行调试android调试输出 1.3.4 Android Debug Bridge(ADB)的用法 1.3.5 使用DX编译Android应用 1.3.6 使用Android Asset Packaging Tool(AAPT)打包资源 1.3.7 使用mksdcard管理虚拟SD卡 1.4 开始第一个Android应用 1.4.1 使用Eclipse开发第一个Android应用 1.4.2 通过ADT运行Android应用 1.5Android应用结构分析 1.5.1 创建一个Android应用 1.5.2 自动生成的R.java 1.5.3 res目录说明 1.5.4 Android应用的清单文件:AndroidManifest.xml 1.5.5应用程序权限说明 1.6 Android应用的基本组件介绍 1.6.1 Activity和View 1.6.2Android中Services简析 1.6.3 BroadcastReceiver 1.6.4 ContentProvider 1.6.5 Intent和IntentFilter 1.7 本章小结 第2章 Android应用的界面编程2.1 界面编程与视图(View)组件 2.1.1 视图组件与容器组件 2.1.2 使用XML布局文件控制UI界面 2.1.3 在代码中控制UI界面 2.1.4 使用XML布局文件和Java代码混合控制UI界面 2.1.5 开发自定义View 2.2 布局管理器 2.2.1线性布局 2.2.2表格布局 2.2.3 帧布局 2.2.4相对布局 2.2.5绝对布局 2.2.6 框架布局 2.2.7layout_weight详解 2.2.8Android中include标签的使用 2.2.9Android LayoutInflater详解2.3 基本界面组件 2.3.1文本框(TextView)与编辑框(EditText)的功能和用法 2.3.1.1TextView显示html文件中的图片 2.3.2按钮(Button)与图片按钮(ImageButton)组件的功能和用法 2.3.3 使用9Patch图片作为按钮背景 2.3.4单选按钮(RadioButton)和复选框(CheckBox)介绍与应用 2.3.5状态开关按钮ToggleButton的功能与用法 2.3.6 时钟(AnalogClock和DigitalClock)的功能与功法 2.3.7图像视图(ImageView)的功能和用法 2.4 高级界面组件 2.4.1自动完成文本框AutoCompleteTextView的功能和用法 2.4.2Spinner的功能和用法 2.4.3日期、时间选择DatePicker、TimePicker的功能和用法 2.4.4进度条ProgressBar的功能和用法 2.4.5拖动条SeekBar的功能和用法 2.4.6 星级评分条(RatingBar) 的功能和用法 2.4.7选项卡TabHost的功能和用法 2.4.8 滚动视图(ScrollView) 的功能和用法 2.4.9列表视图(ListView和ListActivity) 2.4.9.1Android中动态更新ListView(转) 2.4.10 可展开的列表组件(ExpandableListView) 2.4.11网格视图(GridView)和图像切换器(ImageSwitcher)功能和用法 2.4.12画廊视图Gallery的功能和用法 2.5 对话框 2.5.1 使用AlertDialog创建简单对话框 2.5.2 使用AlertDialog创建列表对话框 2.5.3 使用AlertDialog创建自定义对话框 2.5.4 使用PopupWindow 2.5.5 使用DatePickerDialog、TimePickerDialog 2.5.6 使用ProgressDialog创建进度对话框 2.6 消息提示 2.6.1 使用Toast显示提示信息框 2.6.2Notification的功能与用法 2.7 菜单 2.7.1 选项菜单和子菜单(SubMenu) 2.7.2 使用监听器来监听菜单事件 2.7.3 创建复选菜单项和单选菜单项 2.7.4 设置与菜单项关联的Activity 2.7.5 上下文菜单 2.8 本章小结 第3章 事件处理 3.1 Android的事件处理 3.2 基于监听的事件处理 3.2.1 事件监听的处理模型 3.2.2 事件和事件监听器 3.2.3 内部类作为事件监听器类 3.2.4 外部类作为事件监听器类 3.2.5 Activity本身作为事件监听器 3.2.6 匿名内部类作为事件监听器类 3.2.7 直接绑定到标签 3.3 基于回调的事件处理 3.3.1 回调机制与监听机制 3.3.2 基于回调的事件传播 3.3.3 重写onTouchEvent方法响应触摸屏事件 3.4 响应的系统设置的事件 3.4.1 Configuration类简介 3.4.2 重写onConfigurationChanged响应系统设置更改 3.5 Handler消息传递机制 3.5.1 Handler类简介 3.5.2Handler使用案例 3.6 本章小结 第4章 深入理解Activity4.1 建立、配置和使用Activity 4.1.1 建立Activity 4.1.2 配置Activity 4.1.3 启动、关闭Activity 4.1.4使用Bundle在Activity之间交换数据 4.1.5启动其他Activity并返回结果 activity结束之后刷新之前的activity的内容 4.2 Activity的回调机制 4.3 Activity的生命周期 4.3.1 Activity的生命周期演示 4.3.2 Activity与Servlet的相似性与区别 4.4 本章小结 第5章 使用Intent和IntentFilter进行通信5.1 Intent对象详解 5.1.1使用Intent启动系统组件5.2 Intent的属性及intent-filter配置 5.2.1 Component属性 5.2.2 Action、Category属性与intent-filter配置 5.2.3 指定Action、Category调用系统Activity 5.2.4 Data、Type属性与intent-filter配置 5.2.5 Extra属性5.3 使用Intent创建Tab页面 5.4 本章小结 第6章 Android应用的资源6.1 资源的类型及存储方式 6.1.1 资源的类型以及存储方式 6.1.2 使用资源6.2使用字符串、颜色、尺寸资源 6.2.1 颜色值的定义 6.2.2定义字符串、颜色、尺寸资源文件android 中resources管理 6.2.3Android中自定义属性(attrs.xml,TypedArray的使用) 6.2.4Android中关于dip和px以及转换的总结 6.3 数组(Array)资源6.4 使用(Drawable)资源 6.4.1 图片资源 6.4.2 StateListDrawable资源 6.4.3 LayerDrawable资源 6.4.4 ShapeDrawable资源 6.4.5 ClipDrawable资源 6.4.6 AnimationDrawable资源6.5 使用原始XML资源 6.5.1 定义原始XML资源 6.5.2 使用原始XML文件 6.6 使用布局(Layout)资源6.7 使用菜单(Menu)资源 6.7.1 定义菜单资源 6.7.2 使用菜单资源6.8 样式(Style)和主题(Theme)资源 6.8.1样式资源 6.8.2主题资源6.9 属性(Attribute)资源6.10 使用原始资源6.11 国际化和资源自适应 6.11.1 Java国际化的思路 6.11.2 Java支持的语言和国家 6.11.3 完成程序国际化 6.11.4 为Android应用提供国际化资源 6.11.5 国际化Android应用 6.12 本章小结 第7章 图形与图像处理7.1 使用简单图片 7.1.1 使用Drawable对象 7.1.2 Bitmap和BitmapFactory7.2 绘图 7.2.1 Android绘图基础:Canvas、Paint等 7.2.2 Path类 7.2.3 绘制游戏动画7.3 图形特效处理 7.3.1 使用Matrix控制变换 7.3.2 使用drawBitmapMesh扭曲图像 7.3.3 使用Shader填充图形7.4 逐帧(Frame)动画 7.4.1 AnimationDrawable与逐帧动画7.5 补间(Tween)动画 7.5.1 Tween动画与Interpolator 7.5.2 位置、大小、旋转度、透明度改变的补间动画 7.5.3 自定义补间动画7.6 使用SurfaceView实现动画 7.6.1 SurfaceView的绘图机制 7.7 本章小结 第8章 Android的数据存储和IO8.1 使用SharedPreferences 8.1.1 SharedPreferences与Editor简介 8.1.2 SharedPreferences的存储位置和格式 8.1.3 读、写其他应用Shared Preferences8.2 File存储 8.2.1 openFileOutput和open FileInput 8.2.2读写SD卡上的文件8.3SQLite数据库 8.3.1 简介SQLiteDatabase 8.3.2 创建数据库和表 8.3.3 使用SQL语句操作SQLite数据库 8.3.4 使用sqlite3工具 8.3.5 使用特定方法操作SQLite数据库 8.3.6 事务 8.3.7 SQLiteOpenHelper类8.4 手势(Gesture) 8.4.1 手势检测 8.4.2 增加手势 8.4.3 识别用户的手势8.5 自动朗读(TTS) 8.6 本章小结 第9章 使用ContentProvider实现数据共享 9.1 数据共享标准:ContentProvider简介 9.1.1 ContentProvider简介 9.1.2 Uri简介 9.1.3 使用ContentResolver操作数据 9.2 操作系统的ContentProvider 9.2.1 使用ContentProvider管理联系人 9.2.2 使用ContentProvider管理多媒体内容 9.3 实现ContentProvider 9.3.1 创建ContentProvider的步骤 9.4 监听ContentProvider的数据改变 9.4.1 ContentObserver简介 9.5 本章小结 第10章 Service与BroadcastReceiver10.1 Service简介 10.1.1 创建、配置Service 10.1.2 启动和停止Service 10.1.3绑定本地Service并与之通信 10.1.4 Service的生命周期10.2 跨进程调用Service(AIDL服务) 10.2.1 AIDL服务简介 10.2.2 创建AIDL文件 10.2.3 将接口暴露给客户端 10.2.4 客户端访问AIDLService 10.2.5Android中Services之异步IntentService 10.3 电话管理器(TelephonyManager)Android监听来电和去电 10.4 短信管理器(SmsManager) 10.5 音频管理器(AudioManager) 10.5.1 AudioManager简介10.6 振动器(Vibrator) 10.6.1 Vibrator简介 10.6.2 使用Vibrator控制手机振动10.7 手机闹钟服务(AlarmManager) 10.7.1 AlarmManager简介 10.7.2 设置闹钟10.8 接收广播消息 10.8.1BroadcastReceiver简介 10.8.2 发送广播 10.8.3 有序广播10.9 接收系统广播消息 10.10在Android中实现service动态更新UI界面 第11章 多媒体应用开发 11.1 音频和视频的播放 11.1.1 使用MediaPlayer播放音频 11.1.2 使用SoundPool播放音效 11.1.3 使用VideoView播放视频 11.1.4 使用MediaPlayer和SurfaceView播放视频 11.2 使用MediaRecorder录制音频 11.3 控制摄像头拍照 11.3.1 通过Camera进行拍照 11.3.2 录制视频短片 11.4 本章小结 第12章 OpenGL与3D应用开发 12.1 3D图像与3D开发的基本知识 12.2 OpenGL和OpenGL ES简介 12.3 绘制2D图形 12.3.1 在Android应用中使用OpenGL ES 12.3.2 绘制平面上的多边形 12.3.3 旋转 12.4 绘制3D图形 12.4.1 构建3D图形 12.4.2 应用纹理贴图 12.5 本章小结 第13章 Android的网络应用13.1 基于TCP协议的网络通信 13.1.1 TCP协议基础 13.1.2 使用ServerSocket创建TCP服务器端 13.1.3 使用Socket进行通信 13.1.4 加入多线程 13.1.5Android的UI设计与后台线程交互 13.1.6使用AsyncTask异步更新UI界面及原理分析 13.1.7实例演示Android异步加载图片 13.1.8AsyncTask和Handler对比(转) 13.2 使用URL访问网络资源 13.2.1 使用URL读取网络资源 13.2.2 使用URLConnection提交请求13.3 使用HTTP访问网络 13.3.1 使用HttpURLConnection 13.3.2 使用Apache HttpClient13.4 使用WebView视图显示网页 13.4.1 使用WebView浏览网页 13.4.2 使用WebView加载HTML代码 13.5 使用Web Service进行网络编程13.5.1 Web Service简介 13.5.2 Web Service平台概述 13.5.3使用Android应用调用Web Service 常见问题及解决方法: Eclipse JAVA文件注释乱码 Android SDK Manager无法更新的解决 android 项目中出现红色感叹号的解决方法 Eclipse快捷键大全(转载) 设置Android程序图标 eclipse中关联文件设置方法 Android在对Sdcard进行文件的读写操作的时候报错FileNotFoundException No resource identifier found for attribute 'showAsAction' in package 'android' Android SlidingMenu 仿网易新闻客户端布局 没有R.java问题找不到getActionBar()方法 Android 2.x中使用actionbar - Actionbarsherlock Android 2.x中使用actionbar - Actionbarsherlock (2) android布局文件中android:icon="?attr/menuIconCamera"找不到对应图标路径 Cannot override the final method from SherlockFragmentActivity 移植SlidingMenu Android library,和安装example出现的问题解决 android防止内存溢出浅析 Android系统目录介绍 ImageView的scaletype属性 Android中TextView setText int 报错 本文转自欢醉博客园博客,原文链接http://www.cnblogs.com/zhangs1986/p/3608882.html如需转载请自行联系原作者 欢醉

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册