首页 文章 精选 留言 我的

精选列表

搜索[mapreduce],共3589篇文章
优秀的个人博客,低调大师

在 Oracle 数据库中实现 MapReduce

在程序员开发并行程序时,Map-Reduce模式正变得流行起来。这些map-reduce程序通常来并行处理大量数据。本文来演示如何在Oracle数据库上,通过使用Parallel Pipelined Table函数及并行操作,来实现Map-Reduce程序。(译者注:table()是oracle中一个函数,可以把定义为Pipelined的function的返回结果进行SQL查询) 原理: Pipelined Table函数是在Oracle 9i引入的,作为能在数据流中嵌入过程逻辑代码方法。从逻辑上说,一个Table函数是可以出现在from子句中,该函数就像数据表一样的返回多行数据。Table函数同样也可以接收多行数据做为输入参数。大多数情况下,Pipelined Table函数可以嵌入到一个数据流中,它让数据“流”进SQL语句中,从而避免增加一个物理层(直译:具体化的中介)。再次说明,Pipelined Table函数是可以并行处理的。 为了并行Table函数,开发人员必须指定指定一个键对输入数据进行重定位。 在多个发行版中,Pipelined Table函数已经被用户使用,并成为Oracle可扩展基础功能的一个核心部分。无论是外部用户,还是Oracle的开发部门,Table函数成为一个有效的、简单的扩充数据库核心功能的方法。 类似Table函数的功能已经在Oracle内使用,并且是Oracle Spatial 和Oracle Warehouse Builder许多特色功能的实现方式。Oracle Spatial(空间数据处理系统)使用它涉及spatial joins 和许多 spatial data的数据挖掘的操作。Oracle Warehouse Builder让让用户使用Table 函数对数据流进行并行处理的逻辑,比如Match-Merge 算法和其它逐行计算的算法。 手把手的例子 所有的例子都在omr.sql文件中。 为了说明并行的使用方法以及用Pipelined Table函数在Oracle数据库内写一个Map-Reduce算法, 我们实现一个最经典的map-reduce例子--单词计数。单词计数是实现返回一组文档中所有不重复单词出现的个数的程序,也可以说是查询单词出现频率功能。 示例代码是用PL/SQL实现,但如前所说,Oracle允许你选择其它语言来实现这个过程逻辑。 文章转载自 开源中国社区 [http://www.oschina.net]

优秀的个人博客,低调大师

《Flume日志收集与MapReduce模式》一导读

Preface 前 言 Hadoop是个非常优秀的开源工具,可以将海量的非结构化数据转换为易于管理的内容,从而更好地洞察客户需求。它很便宜(几乎是免费的),只要数据中心有空间和电源,它就能够水平扩展,并且可以处理传统数据仓库难以解决的问题。需要注意的是,你得将数据填入Hadoop集群中,否则你所得到的只不过是昂贵的热量产生器而已。你很快就会发现,一旦对Hadoop的使用经过 “试验性”阶段后,你就需要工具来自动化地将数据填充到集群中。过去,你需要自己找到该问题的解决方案,但现在则不必如此!Flume一开始是Cloudera的项目,当时它们的集成工程师需要一次又一次地为客户编写工具来实现数据的自动化导入。时至今日,Flume已经成为Apache软件基金会的项目,并且处于活跃开发状态中,很多用户已经将其用于产品环境多年。本书将会通过F

优秀的个人博客,低调大师

MapReduce实现手机上网日志分析(排序)

一、背景 1.1 流程 实现排序,分组拍上一篇通过Partitioner实现了。 实现接口,自动产生接口方法,写属性,产生getter和setter,序列化和反序列化属性,写比较方法,重写toString,为了方便复制写够着方法,不过重写够着方法map里需要不停地new,发现LongWritable有set方法,text也有,可以用,产生默认够着方法。 public void set(String account,double income,double expense,double surplus) { this.account = account; this.income = income; this.expense = expense; this.surplus = income-expense; } 1.2 数据集 为了和上一篇保在知识上持递进,数据及换了,名字没变。 下面是输出结果,其实mr也会自动排序,不过string按字典序排序了。 二、理论知识 字符串拼接,记得以前自己写过,现在拿出来看看,http://www.cnblogs.com/hxsyl/archive/2012/10/18/2729112.html 简单总结扩展如下:String是final的,不能改变也不能继承,因此在每次对 String 类型进行改变的时候其实都等同于生成了一个新的 String 对象,然后将指针指向新的 String 对象,所以经常改变内容的字符串最好不要用 String ,因为每次生成对象都会对系统性能产生影响,特别当内存中无引用对象多了以后, JVM 的 GC 就会开始工作,那速度是一定会相当慢的。 如果for循环1w次,这句 string += "hello";的过程相当于将原有的string变量指向的对象内容取出与"hello"作字符串相加操作再存进另一个新的String对象当中,再让string变量指向新生成的对象。反编译出的字节码文件可以很清楚地看出,每次循环会new出一个StringBuilder对象,然后进行append操作,最后通过toString方法返回String对象。也就是说这个循环执行完毕new出了10000个对象,试想一下,如果这些对象没有被回收,内存浪费不说,有可能重复使用赵成系统卡死。从上面还可以看出:string+="hello"的操作事实上会自动被JVM优化成: StringBuilder str = new StringBuilder(string); str.append("hello"); str.toString(); 如果直接for循环里StringBuilder 的话会只是new一次。效率高。 而StringBuffer是线程安全的,多了synchronized关键字,也就是在多线程下会顺序读取换冲刺。 参考了这个http://blog.csdn.net/loveyaozu/article/details/47037957 三、实体类 收入相同的话按消费从低到高,否则收入从高到低。 package cn.app.hadoop.mr.sort; import java.io.DataInput; import java.io.DataOutput; import java.io.IOException; import java.math.BigDecimal; import org.apache.hadoop.io.WritableComparable; import org.apache.jasper.tagplugins.jstl.core.Out; //Writable是序列化接口 //泛型是InfoBean,就像比较学生信息一样,成绩,性别等 ,封装在了一个bean里 //不过发现WritableComparable 有了序列化和反序列化 public class InfoBean implements WritableComparable<InfoBean>{ private String account; //金钱类都需要BigDecimal,double顺势精度,不过不知道下边序列化咋写类型,所以先用double,估计writeUTF可以 private double income; private double expense; private double surplus; public String getAccount() { return account; } public void setAccount(String account) { this.account = account; } public double getIncome() { return income; } public void setIncome(double income) { this.income = income; } public double getExpense() { return expense; } public void setExpense(double expense) { this.expense = expense; } public double getSurplus() { return surplus; } public void setSurplus(double surplus) { this.surplus = surplus; } public void readFields(DataInput in) throws IOException { // TODO Auto-generated method stub this.account = in.readUTF(); this.income = in.readDouble(); this.expense = in.readDouble(); this.surplus = in.readDouble(); } public void write(DataOutput out) throws IOException { // TODO Auto-generated method stub out.writeUTF(account); out.writeDouble(income); out.writeDouble(expense); out.writeDouble(surplus); } public void set(String account,double income,double expense) { this.account = account; this.income = income; this.expense = expense; this.surplus = income - expense; } public InfoBean() { super(); // TODO Auto-generated constructor stub } @Override public String toString() { return "InfoBean [income=" + income + ", expense=" + expense + ", surplus=" + surplus + "]"; } public int compareTo(InfoBean o) { // TODO Auto-generated method stub if(this.income == o.getIncome()) { return this.expense>o.getExpense()?1:-1; }else { return this.income>o.getIncome()?-1:1; } } } 四、第一种实现 4.1 Mapper //第一个处理文本的话一般是LongWritable 或者object //一行一行的文本是text //输出的key的手机号 定位Text //结果是DataBean 一定要实现Writable接口 public class InfoSortMapper extends Mapper<LongWritable, Text, Text, InfoBean> { private InfoBean v = new InfoBean(); private Text k = new Text(); public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] fields = line.split("\t"); String account = fields[0]; double in = Double.parseDouble(fields[1]); double out = Double.parseDouble(fields[2]); //不用每次new 几遍不重写内存引用,也很站用资源 k.set(account); v.set(account, in, out); context.write(k, v); } 4.2 Reducer public class InfoSortReducer extends Reducer<Text, InfoBean, Text, InfoBean> { //k就是key,不需要 private InfoBean v = new InfoBean(); public void reduce(Text key, Iterable<InfoBean> value, Context context) throws IOException, InterruptedException { // process values double incomeSum = 0; double expenseSum = 0; for (InfoBean o : value) { incomeSum += o.getIncome(); expenseSum += o.getExpense(); } v.set(key.toString(), incomeSum, expenseSum); //databean会自动调用toString context.write(key,v); } } 五、第二种实现 5.1 Mapper //对 InfoBean 排序 k2就是他 public class SortMapper extends Mapper<LongWritable, Text, InfoBean, NullWritable> { private InfoBean k = new InfoBean(); public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] fields = line.split("\t"); String account = fields[0]; double in = Double.parseDouble(fields[1]); double out = Double.parseDouble(fields[2]); //不用每次new 几遍不重写内存引用,也很站用资源 k.set(account, in, out); //value必须是NullWritable.get(),NullWritable不行,提示不是变量 context.write(k, NullWritable.get()); } } 5.2 Reducer //对 InfoBean 排序 k2就是他 public class SortMapper extends Mapper<LongWritable, Text, InfoBean, NullWritable> { private InfoBean k = new InfoBean(); public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] fields = line.split("\t"); String account = fields[0]; double in = Double.parseDouble(fields[1]); double out = Double.parseDouble(fields[2]); //不用每次new 几遍不重写内存引用,也很站用资源 k.set(account, in, out); //value必须是NullWritable.get(),NullWritable不行,提示不是变量 context.write(k, NullWritable.get()); } } 六、结束语 如果k2 v2和k4 v4,也就是mapp的输出和reducer的输出类型不一致的话必须在Main里也设置Mapper的输出,上面的第二种就是。 job.setMapOutputKeyClass(InfoBean.class); job.setMapOutputValueClass(NullWritable.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(InfoBean.class); 否则java里不报错,加上log4j后看到类型不匹配。

优秀的个人博客,低调大师

MapReduce实现倒排索引(类似协同过滤)

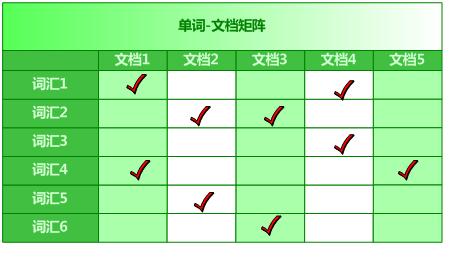
一、问题背景 倒排索引其实就是出现次数越多,那么权重越大,不过我国有凤巢....zf为啥不管,总局回应推广是不是广告有争议... eclipse里ctrl+t找接口或者抽象类的实现类,看看都有啥方法,有时候hadoop的抽象类返回的接口没有需要的方法,那么我们返回他的实现类。 吧需要的文件放入hdfs下的目录下,只要不是以下划线开头的均算。 二、理论准备 搜索引擎查询的时候就是查询这个单词文档矩阵,旺旺采用倒排索引存储,后缀树也可以。 不管理论直接看例子,这是原始的文档 下面是简单的索引,只是表征是否在文档中出现过。 下面就是文档及出现次数。 擦,咋有点想协同过滤。 三、思路分析 其实是一个全文检索的数据结构。理论上关键字出现次数越多,那么文章就越靠前。 就是wc的加强版本。wc是统计单词在文章里出现的次数,倒排是统计关键字在各个文章出现的次数。 有时候不能一下子写出来,可能需要多次mr,那么我们首先确定最终的结果形式,然后向上反推。 如果多个mr,考虑使用combiner,不过要考虑combiner是不是可插拔的,也就是combiner和业务逻辑是否和reducer一样。 怎么知道单词出现在那个文章里?从context对象里获取。既然能忘context写东西,那么也能从其中获取信息。 最终结果是 hello "a.txt->5 b.txt->3" tom "a.txt->2 b.txt->1" kitty "a.txt->1" 那么reduce的输出 context.write("hello","a.txt->5 b.txt->3"); 那么combiner阶段是 <"hello",{"a.txt->5","b.txt->3"}> 那么map的输出 context.write("hello","a.txt->5"); context.write("hello","b.txt->3"); 不过考虑到wc,map的输出应该是,路径放在value不好处理,还要廉价呢。 context.write("hello->a.txt",1); context.write("hello->a.txt",1); context.write("hello->a.txt",1); context.write("hello->a.txt",1); context.write("hello->a.txt",1); context.write("hello->b.txt",1); context.write("hello->b.txt",1); context.write("hello->b.txt",1); 那么combiner阶段根据就输出 <"hello->a.txt",1> <"hello->a.txt",1> <"hello->a.txt",1> <"hello->a.txt",1> <"hello->a.txt",1> <"hello->b.txt",1> <"hello->b.txt",1> <"hello->b.txt",1> context.write("hello","a.txt->5"); context.write("hello","b.txt->3"); 次是不同文件的相同key并没有合并,reducer合并输出皆可。 四、代码实现 4.1 Mapper public class IIMapper1 extends Mapper<LongWritable, Text, Text, Text> { private Text k = new Text(); //下面其实是int,不过也可以在接收端Integer.parseInt转了就好 private Text v = new Text(); public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] words = line.split(" "); //从context对象里找到单词属于那个文章 //context.getInputSplit();找到切片 按ctrl找 发现返回时InputSplit //不过是个抽象类 ctrl + t找他的实现类 //能把数据写入context,繁殖也能从context拿到很多信息 //从下面inputSplit调用get的时候发现没有合适的方法,那么我们找他的实现类,调用实现类的方法 //InputSplit inputSplit = context.getInputSplit(); //inputSplit.get //他的子类很多 我们处理文件就用File开头的 然后有个getPath FileSplit inputSplit = (FileSplit)context.getInputSplit(); //文件名是hdfs://hostname:port/a/1.txt //我们戒掉hdfs://hostname:port 不能戒掉a 应为这是文件夹否则不知道1.txt来自哪 其他文件家下可能也有同名文件 //也可以不接去 String path = inputSplit.getPath().toString(); for(String w:words) { k.set(w+"->"+path); v.set("1"); context.write(k, v); } } } 4.2 Combiner String[] wordAndPath = key.toString().split("->"); String word = wordAndPath[0]; String path = wordAndPath[1]; // process values int sum = 0; for (Text val : value) { sum += Integer.parseInt(val.toString()); } k.set(word); v.set(path+"->"+sum); context.write(k, v); 4.3 Reducer //不涉及多线程 用StringBuilde即可 StringBuilder sb = new StringBuilder(); // process values for (Text val : value) { sb.append(val.toString()).append("\t"); } context.write(key, new Text(sb.toString())); 四、实验分析

优秀的个人博客,低调大师

MaxCompute Studio提升UDF和MapReduce开发体验

随着 MaxCompute 2.0 的发布,我们提供了MaxCompute Studio,一套基于IntelliJ IDEA的开发插件,让用户在集成开发环境(IDE)中更方便地进行SQL及用户代码开发。MaxCompute Studio 为开发者提供了良好的开发体验,支持项目空间浏览、SQL 脚本开发,UDF开发和调试,作业执行状态展示等功能,本系列将逐一展开进行介绍。 第一弹 - 元数据浏览第二弹 - 玩转SQL编辑器第三弹 - UDF开发与调试第四弹 - 权限那些事儿 UDF全称User Defined Function,即用户自定义函数。MaxCompute提供了很多内建函数来满足用户的计算需求,同时用户还可以创建自定义函数来满足定制的计算需求。用户能扩展的UDF有三种:UDF(User Defined Scalar Funct

优秀的个人博客,低调大师

MapReduce优化----Shuffle过程剖析及性能优化

1.Map端 当Map开始产生输出时,它并不是简单的把数据写到磁盘,因为频繁的磁盘操作会导致性能严重下降。它的处理过程更复杂,数据首先是写到内存中的一个缓冲区,并做了一些预排序,以提升效率。 每个Map任务都有一个用来写入输出数据的循环内存缓冲区。这个缓冲区默认大小是100MB,可以通过io.sort.mb属性来设置具体大小。当缓冲区中的数据量达到一个特定阀值(io.sort.mb * io.sort.spill.percent,其中io.sort.spill.percent默认是0.80)时,系统将会启动一个后台线程把缓冲区中的内容spill到磁盘。在spill过程中,Map的输出将会继续写入到缓冲区,但如果缓冲区已满,Map就会被阻塞直到spill完成。spill线程在把缓冲区的数据写到磁盘前,会对它进行一个二次快速排序,首先根据数据所属的partition排序,然后每个partition中再按Key排序。输出包括一个索引文件和数据文件。 如果设定了Combiner,将在排序输出的基础上运行。Combiner就是一个Mini Reducer,它在执行Map任务的节点本身运行,先对Map的输出做一次简单Reduce,使得Map的输出更紧凑,更少的数据会被写入磁盘和传送到Reducer。 spill文件保存在由mapred.local.dir指定的目录中,Map任务结束后删除。 每当内存中的数据达到spill阀值的时候,都会产生一个新的spill文件,所以在Map任务写完它的最后一个输出记录时,可能会有多个spill文件。在Map任务完成前,所有的spill文件将会被归并排序为一个索引文件和数据文件。这是一个多路归并过程,最大归并路数由io.sort.factor控制(默认是10)。如果设定了Combiner,并且spill文件的数量至少是3(由min.num.spills.for.combine属性控制),那么Combiner将在输出文件被写入磁盘前运行以压缩数据。 对写入到磁盘的数据进行压缩,通常是一个很好的方法,因为这样做使得数据写入磁盘的速度更快,节省磁盘空间,并减少需要传送到Reducer的数据量。默认输出是不被压缩的,但可以很简单的设置mapred.compress.map.output为true启用该功能。压缩所使用的库由mapred.map.output.compression.codec来设定。 当spill文件归并完毕后,Map将删除所有的临时spill文件,并告知TaskTracker任务已完成。Reducers通过HTTP来获取对应的数据。用来传输partitions数据的工作线程数由tasktracker.http.threads控制,这个设定是针对每一个TaskTracker的,并不是单个Map,默认值为40,在运行大作业的大集群上可以增大以提升数据传输速率。 2.Reduce端 2.1 copy阶段 Map的输出文件放置在运行Map任务的TaskTracker的本地磁盘上(注意:Map输出总是写到本地磁盘,但Reduce输出不是,一般是写到HDFS),它是运行Reduce任务的TaskTracker所需要的输入数据。Reduce任务的输入数据分布在集群内的多个Map任务的输出中,Map任务可能会在不同的时间内完成,只要完成的Map任务数达到占总Map任务数一定比例(mapred.reduce.slowstart.completed.maps默认0.05),Reduce任务就开始拷贝它的输出。 Reduce任务拥有多个拷贝线程,可以并行的获取Map输出。可以通过设定mapred.reduce.parallel.copies来改变线程数,默认是5。 如果Map输出足够小,它们会被拷贝到Reduce TaskTracker的内存中(缓冲区的大小 由mapred.job.shuffle.input.buffer.percent控制,指定了用于此目的的堆内存的百分比);如果缓冲区空间不足,会被拷贝到磁盘上。当内存中的缓冲区用量达到一定比例阀值(由mapred.job.shuffle.merge.percent控制),或者达到了Map输出的阀值大小(由mapred.inmem.merge.threshold控制),缓冲区中的数据将会被归并然后spill到磁盘。 拷贝来的数据叠加在磁盘上,有一个后台线程会将它们归并为更大的排序文件,这样做节省了后期归并的时间。对于经过压缩的Map输出,系统会自动把它们解压到内存方便对其执行归并。 2.2 sort阶段 当所有的Map输出都被拷贝后,Reduce任务进入排序阶段(更恰当的说应该是归并阶段,因为排序在Map端就已经完成),这个阶段会对所有的Map输出进行归并排序,这个工作会重复多次才能完成。 假设这里有50个Map输出(可能有保存在内存中的),并且归并因子是10(由io.sort.factor控制,就像Map端的merge一样),那最终需要5次归并。每次归并会把10个文件归并为一个,最终生成5个中间文件。 注:每趟合并的文件数实际上比示例中展示的更微妙。目标是合并最小数量的文件以便满足最后一趟的合并系数。因此如果是40个文件,我们不会在四趟中,每趟合并10个文件从而得到4个文件。相反,第一趟只合并4个文件,随后三趟合并所有十个文件。在最后一趟中,4个已合并的文件和余下的6个(未合并的)文件合计10个文件。这并没有改变合并的次数,它只是一个优化措施,尽量减少写到磁盘的数据量,因为最后一趟总是直接合并到reduce。 2.3 reduce阶段 在Reduce阶段,Reduce函数会作用在排序输出的每一个key上。这个阶段的输出被直接写到输出文件系统,一般是HDFS。在HDFS中,因为TaskTracker节点也运行着一个DataNode进程,所以第一个块备份会直接写到本地磁盘。 3.配置调优 该配置调优方案主要是对以上Shuffle整个过程中涉及到的配置项按流程顺序一一呈现并给以调优建议。 1.Map端 1)io.sort.mb 用于map输出排序的内存缓冲区大小 类型:Int 默认:100mb 备注:如果能估算map输出大小,就可以合理设置该值来尽可能减少溢出写的次数,这对调优很有帮助。 2)io.sort.spill.percent map输出排序时的spill阀值(即使用比例达到该值时,将缓冲区中的内容spill到磁盘) 类型:float 默认:0.80 3)io.sort.factor 归并因子(归并时的最多合并的流数),map、reduce阶段都要用到 类型:Int 默认:10 备注:将此值增加到100是很常见的。 4)min.num.spills.for.combine 运行combiner所需的最少溢出写文件数(如果已指定combiner) 类型:Int 默认:3 5)mapred.compress.map.output map输出是否压缩 类型:Boolean 默认:false 备注:如果map输出的数据量非常大,那么在写入磁盘时压缩数据往往是个很好的主意,因为这样会让写磁盘的速度更快,节约磁盘空间,并且减少传给reducer的数据量。 6)mapred.map.output.compression.codec 用于map输出的压缩编解码器 类型:Classname 默认:org.apache.Hadoop.io.compress.DefaultCodec 备注:推荐使用LZO压缩。Intel内部测试表明,相比未压缩,使用LZO压缩的TeraSort作业,运行时间减少60%,且明显快于Zlib压缩。 7)tasktracker.http.threads 每个tasktracker的工作线程数,用于将map输出到reducer。 (注:这是集群范围的设置,不能由单个作业设置) 类型:Int 默认:40 备注:tasktracker开http服务的线程数。用于reduce拉取map输出数据,大集群可以将其设为40~50。 2.reduce端 1)mapred.reduce.slowstart.completed.maps 调用reduce之前,map必须完成的最少比例 类型:float 默认:0.05 2)mapred.reduce.parallel.copies reducer在copy阶段同时从mapper上拉取的文件数 类型:int 默认:5 3)mapred.job.shuffle.input.buffer.percent 在shuffle的复制阶段,分配给map输出的缓冲区占堆空间的百分比 类型:float 默认:0.70 4)mapred.job.shuffle.merge.percent map输出缓冲区(由mapred.job.shuffle.input.buffer.percent定义)使用比例阀值,当达到此阀值,缓冲区中的数据将会被归并然后spill到磁盘。 类型:float 默认:0.66 5)mapred.inmem.merge.threshold map输出缓冲区中文件数 类型:int 默认:1000 备注:0或小于0的数意味着没有阀值限制,溢出写将有mapred.job.shuffle.merge.percent单独控制。 6)mapred.job.reduce.input.buffer.percent 在reduce过程中,在内存中保存map输出的空间占整个堆空间的比例。 类型:float 默认:0.0 备注:reduce阶段开始时,内存中的map输出大小不能大于该值。默认情况下,在reduce任务开始之前,所有的map输出都合并到磁盘上,以便为reducer提供尽可能多的内存。然而,如果reducer需要的内存较少,则可以增加此值来最小化访问磁盘的次数,以提高reduce性能。 3.性能调优补充 相对于大批量的小文件,hadoop更合适处理少量的大文件。一个原因是FileInputFormat生成的InputSplit是一个文件或该文件的一部分。如果文件很小,并且文件数量很多,那么每次map任务只处理很少的输入数据,每次map操作都会造成额外的开销。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册