首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

python希尔排序

希尔排序介绍 希尔排序(Shell Sort)是插入排序的一种。也称缩小增量排序,是直接插入排序算法的一种更高效的改进版本,该方法的基本思想是:先将整个待排元素序列分割成若干个子序列(由相隔某个“增量”的元素组成的)分别进行直接插入排序,然后依次缩减增量再进行排序,待整个序列中的元素基本有序(增量足够小)时,再对全体元素进行一次直接插入排序。因为直接插入排序在元素基本有序的情况下(接近最好情况),效率是很高的,因此希尔排序在时间效率比直接插入排序有较大提高。 首先要明确一下增量的取法: 第一次增量的取法为: d=count/2; 第二次增量的取法为: d=(count/2)/2; 最后一直到: d=1; 看上图观测的现象为: d=3时:将40跟50比,因50大,不交换。 将20跟30比,因30大,不交换。 将80跟60比,因60小,交换。 d=2时:将40跟60比,不交换,拿60跟30比交换,此时交换后的30又比前面的40小,又要将40和30交换,如上图。 将20跟50比,不交换,继续将50跟80比,不交换。 d=1时:这时就是前面讲的插入排序了,不过此时的序列已经差不多有序了,所以给插入排序带来了很大的性能提高。 代码实例: import time,random #source = [8, 6, 4, 9, 7, 3, 2, -4, 0, -100, 99] #source = [92, 77, 8,67, 6, 84, 55, 85, 43, 67] source = [ random.randrange(10000+i) for i in range(10000)] #print(source) step = int(len(source)/2) #分组步长 t_start = time.time() while step >0: print("---step ---", step) #对分组数据进行插入排序 for index in range(0,len(source)): if index + step < len(source): current_val = source[index] #先记下来每次大循环走到的第几个元素的值 if current_val > source[index+step]: #switch source[index], source[index+step] = source[index+step], source[index] step = int(step/2) else: #把基本排序好的数据再进行一次插入排序就好了 for index in range(1, len(source)): current_val = source[index] # 先记下来每次大循环走到的第几个元素的值 position = index while position > 0 and source[ position - 1] > current_val: # 当前元素的左边的紧靠的元素比它大,要把左边的元素一个一个的往右移一位,给当前这个值插入到左边挪一个位置出来 source[position] = source[position - 1] # 把左边的一个元素往右移一位 position -= 1 # 只一次左移只能把当前元素一个位置 ,还得继续左移只到此元素放到排序好的列表的适当位置 为止 source[position] = current_val # 已经找到了左边排序好的列表里不小于current_val的元素的位置,把current_val放在这里 print(source) t_end = time.time() - t_start print("cost:",t_end)

优秀的个人博客,低调大师

python快速排序

#_*_coding:utf-8_*_ __author__ = 'Alex Li' def quick_sort(array,left,right): ''' :param array: :param left: 列表的第一个索引 :param right: 列表最后一个元素的索引 :return: ''' if left >=right: return low = left high = right key = array[low] #第一个值 while low < high:#只要左右未遇见 while low < high and array[high] > key: #找到列表右边比key大的值 为止 high -= 1 #此时直接 把key(array[low]) 跟 比它大的array[high]进行交换 array[low] = array[high] array[high] = key while low < high and array[low] <= key : #找到key左边比key大的值,这里为何是<=而不是<呢?你要思考。。。 low += 1 #array[low] = #找到了左边比k大的值 ,把array[high](此时应该刚存成了key) 跟这个比key大的array[low]进行调换 array[high] = array[low] array[low] = key quick_sort(array,left,low-1) #最后用同样的方式对分出来的左边的小组进行同上的做法 quick_sort(array,low+1, right)#用同样的方式对分出来的右边的小组进行同上的做法 if __name__ == '__main__': array = [96,14,10,9,6,99,16,5,1,3,2,4,1,13,26,18,2,45,34,23,1,7,3,22,19,2] #array = [8,4,1, 14, 6, 2, 3, 9,5, 13, 7,1, 8,10, 12] print("before sort:", array) quick_sort(array,0,len(array)-1) print("-------final -------") print(array)

优秀的个人博客,低调大师

python冒泡排序

冒泡排序(Bubble Sort),是一种计算机科学领域的较简单的排序算法。 它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。 这个算法的名字由来是因为越大的元素会经由交换慢慢“浮”到数列的顶端,故名。 data_set = [ 9,1,22,31,45,3,6,2,11 ] loop_count = 0 for j in range(len(data_set)): for i in range(len(data_set) - j- 1): # -1 是因为每次比对的都 是i 与i +1,不减1的话,最后一次对比会超出list 获取范围,-j是因为,每一次大loop就代表排序好了一个最大值,放在了列表最后面,下次loop就不用再运算已经排序好了的值 了 if data_set[i] > data_set[i+1]: #switch tmp = data_set[i] data_set[i] = data_set[i+1] data_set[i+1] = tmp loop_count +=1 print(data_set) print(data_set) print("loop times", loop_count)

优秀的个人博客,低调大师

python选择排序

选择排序(Selection sort)是一种简单直观的排序算法。它的工作原理是每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完。 选择排序是不稳定的排序方法(比如序列[5, 5, 3]第一次就将第一个[5]与[3]交换,导致第一个5挪动到第二个5后面)。 data_set = [ 9,1,22,31,45,3,6,2,11 ] smallest_num_index = 0 #初始列表最小值,默认为第一个 loop_count = 0 for j in range(len(data_set)): for i in range(j,len(data_set)): if data_set[i] < data_set[smallest_num_index]: #当前值 比之前选出来的最小值 还要小,那就把它换成最小值 smallest_num_index = i loop_count +=1 else: print("smallest num is ",data_set[smallest_num_index]) tmp = data_set[smallest_num_index] data_set[smallest_num_index] = data_set[j] data_set[j] = tmp print(data_set) print("loop times", loop_count)

优秀的个人博客,低调大师

python logistic回归

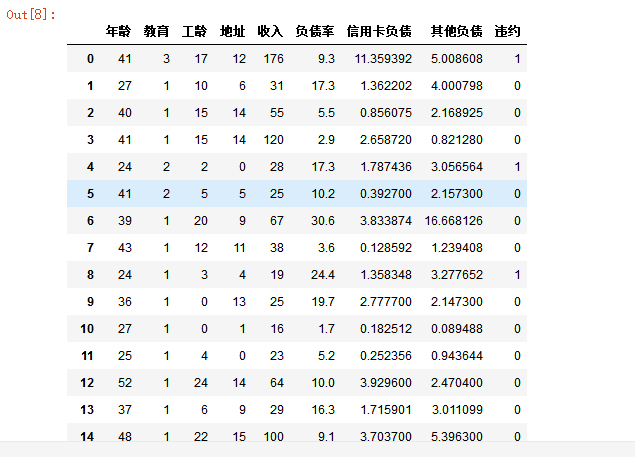
常用的分类与预测算法 回归分析 决策树 人工神经网络 贝叶斯网络 支持向量机 其中回归分析包括: 线性回归---自变量因变量线性关系,最小二乘法求解。 非线性回归--自变量因变量非线性关系,函数变换为线性关系,或非线性最小二乘方法求解。 logistic回归--因变量一般有1和0两种取值,将因变量的取值范围控制再0-1范围内,表示取值为1的概率。 岭回归--要求自变量之间具有多重共线性,是一种改进最小二乘法的方法。 主成分回归--要求自变量之间具有多重共线性,是对最小二乘法的方法的改进,可以消除自变量间的多重共线性。 一般自变量和因变量之间存在线性关系的时候,就可以用线性回归的方法,而两者之间呈现的是某种曲线特性时,就用非线性回归,当自变量之间出现多重共线时,用最小二乘估计的回归系数不准确,则主要用岭回归和主成分回归法。 此处的logistics回归属于概率性非线性回归,对于二分类问题,y只有是否两个值,1和0,在自变量x1,x2,x3作用下y取值为是的概率为p,取值为否的概率为1-p。logistics回归 p=P(y=1|X),取0概率是1-p,取1和取0的概率之比为p/1-p,成为事件的优势比odds,odds取对数得到Logistic变换Logit(p)=ln(p/1-p),再令Logit(p)=ln(p/1-p)=z ,则可以求出p=1/1+e^-z,则为Logistic函数。 logistics回归模型步骤 根据挖掘目的设置特征,并筛选特征x1,x2...xp,使用sklearn中的feature_selection库,F检验来给出特征的F值和P值,筛选出F大的,p小的值。RFE(递归特征消除)和SS(稳定性选择) 列出回归方程ln(p/1-p)=β0+β1x1+...+βpxp+e 估计回归系数 模型检验 预测控制 随机逻辑回归进行特征筛选,逻辑回归进行模型训练评估 #-*- coding: utf-8 -*- #逻辑回归 自动建模 import pandas as pd #参数初始化 filename = '../data/bankloan.xls' data = pd.read_excel(filename) x = data.iloc[:,:8].as_matrix() y = data.iloc[:,8].as_matrix() from sklearn.linear_model import LogisticRegression as LR from sklearn.linear_model import RandomizedLogisticRegression as RLR rlr = RLR() #建立随机逻辑回归模型,筛选变量 rlr.fit(x, y) #训练模型 rlr.get_support() #获取特征筛选结果,也可以通过.scores_方法获取各个特征的分数 print(u'通过随机逻辑回归模型筛选特征结束。') print(u'有效特征为:%s' % ','.join(data.columns[rlr.get_support()])) x = data[data.columns[rlr.get_support()]].as_matrix() #筛选好特征 lr = LR() #建立逻辑货柜模型 lr.fit(x, y) #用筛选后的特征数据来训练模型 print(u'逻辑回归模型训练结束。') print(u'模型的平均正确率为:%s' % lr.score(x, y)) 逻辑回归模型训练结束。 模型的平均正确率为:0.805714285714 RandomizedLogisticRegression(C=1, fit_intercept=True, memory=None, n_jobs=1, n_resampling=200, normalize=True, pre_dispatch='3*n_jobs', random_state=None, sample_fraction=0.75, scaling=0.5, selection_threshold=0.25, tol=0.001, verbose=False) 从结果来看,采用随机逻辑回归剔除变量,分别剔除了x2 x8 x1 x5。 在建立随机逻辑回归模型时, 使用了默认的阈值0.25,可以使用(selection—threshold = 0.5)设置阈值。逻辑回归本质上还是一种线性模型,因此所筛选出来的变量,说明与结果有比较强的线性相关,然而被剔除的变量不一定跟结果没关系,因为他们之间可能是非线性关系。

优秀的个人博客,低调大师

python操作gmail

import imaplib, re class pygmail( object ): def __init__( self ): self .IMAP_SERVER = 'imap.gmail.com' self .IMAP_PORT = 993 self .M = None self .response = None self .mailboxes = [] def login( self , username, password): self .M = imaplib.IMAP4_SSL( self .IMAP_SERVER, self .IMAP_PORT) rc, self .response = self .M.login(username, password) return rc def get_mailboxes( self ): rc, self .response = self .M. list () for item in self .response: self .mailboxes.append(item.split()[ - 1 ]) return rc def get_mail_count( self , folder = 'Inbox' ): rc, self .response = self .M.select(folder) return self .response[ 0 ] def get_unread_count( self , folder = 'Inbox' ): rc, self .response = self .M.status(folder, "(UNSEEN)" ) unreadCount = re.search( "UNSEEN (\d+)" , self .response[ 0 ]).group( 1 ) return unreadCount def get_imap_quota( self ): quotaStr = self .M.getquotaroot( "Inbox" )[ 1 ][ 1 ][ 0 ] r = re. compile ( '\d+' ).findall(quotaStr) if r = = []: r.append( 0 ) r.append( 0 ) return float (r[ 1 ]) / 1024 , float (r[ 0 ]) / 1024 def get_mails_from( self , uid, folder = 'Inbox' ): status, count = self .M.select(folder, readonly = 1 ) status, response = self .M.search( None , 'FROM' , uid) email_ids = [e_id for e_id in response[ 0 ].split()] return email_ids def get_mail_from_id( self , id ): status, response = self .M.fetch( id , '(body[header.fields (subject)])' ) return response def rename_mailbox( self , oldmailbox, newmailbox): rc, self .response = self .M.rename(oldmailbox, newmailbox) return rc def create_mailbox( self , mailbox): rc, self .response = self .M.create(mailbox) return rc def delete_mailbox( self , mailbox): rc, self .response = self .M.delete(mailbox) return rc def logout( self ): self .M.logout() if __name__ = = "__main__" : demo = pygmail() demo.login( "renwenchao888@gmail.com" , "qqq191430791" ) mailBoxex = demo.get_mailboxes() for i in demo.response: print i demo.logout() ============================================================================= 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/archive/2011/12/08/2280652.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册