首页 文章 精选 留言 我的

精选列表

搜索[蓝色链接],共10000篇文章
优秀的个人博客,低调大师

手把手教你如何用Python从PDF文件中导出数据(附链接)

有很多时候你会想用Python从PDF中提取数据,然后将其导出成其他格式。不幸的是,并没有多少Python包可以很好的执行这部分工作。在这篇贴子中,我们将探讨多个不同的Python包,并学习如何从PDF中提取某些图片。尽管在Python中没有一个完整的解决方案,你还是应该能够运用这里的技能开始上手。提取出想要的数据之后,我们还将研究如何将数据导出成其他格式。 让我们从如何提取文本开始学起! 使用PDFMiner提取文本 最被大家所熟知的可能是一个叫做PDFMiner的包。PDFMiner包大约从Python 2.4版本就存在了。它的主要目的是从PDF中提取文本。实际上,PDFMiner可以告诉你某文本在分页上具体的位置和字体信息。对于Python 2.4到2.7版本,你可以参考以下网站来了解PDFMiner的更多信息: GitHub – https://github.com/euske/pdfminer PyPI – https://pypi.python.org/pypi/pdfminer/ Webpage – https://euske.github.io/pdfminer/ PDFMiner是不兼容于Python 3的。幸运的是,PDFMiner家族的一个分支PDFMiner.six在Python 3上完全能胜任同样的功能。 你可以在以下网站上找到: https://github.com/pdfminer/pdfminer.six 关于PDFMiner的安装说明已经比较过时了。其实你可以用pip命令来安装它: 如果你要在Python 3上安装PDFMiner(这也许就是你现在正在做的),你需要这样安装: PDFMiner的相关文档很少。你将很大可能地需要使用Google和Stack Overflow两个查询工具来弄清楚如何在这篇贴子的涵盖内容之外有效地使用PDFMiner。 提取所有文本 有时你会想要提取PDF文件中的所有文本。PDFMiner包提供了一些不同的方法使你能够做到这一点。我们先来探讨一些编程的方法。让我们试着从一个国税局W9表单中读取所有的文本。 你可以从这里得到表单副本: https://www.irs.gov/pub/irs-pdf/fw9.pdf 保存完这个PDF文件之后,你可以参考以下代码: 当你直接使用PDFMiner包时,往往会有点繁琐。这里,我们从PDFMiner的不同模块中引入多个不同的类。由于这些类都没有文档说明,也没有实现其文档字符串属性,我将不会深入讲解它们做了什么。如果你真的好奇的话,尽管可以深入地研究它们的源代码。无论如何,我认为我们可以大致照以上代码行事。 我们做的第一件事就是创建一个资源管理器的实例。然后通过Python的输入输出(io)模块创建一个似文件对象。如果你使用的是Python 2,你应该使用StringIO模块。接下来的步骤是创建一个转换器。在这个例子里,我们选择使用TextConverter,如果你想要的话,你还可以使用HTMLConverter或XMLConverter。最后,我们创建一个PDF解释器对象,携带着我们的资源管理器和转换器对象,来提取文本。 最后一步是打开PDF文件并且循环遍历每一页。结尾部分,我们抓取所有的文本,关闭不同的信息处理器,同时打印文本到标准输出(stdout)。 按页提取文本 通常我们并不需要从一个多页文档中抓取所有的文本。你一般会想要处理文档的某些部分。那么,让我们改写代码以便它提取文本呈分页的格式。这将允许我们在检查文本时,一次一页地进行: 在这个例子中,我们创建了一个生成器函数按页生成(yield)了文本。extract_text函数按页打印出文本。此处我们可以加入一些分析逻辑来得到我们想要的分析结果。或者我们可以仅是将文本(或HTML或XML)存入不同的文件中以便分析。 你可能注意到这些文本没有按你期望的顺序排列。因此你需要思考一些方法来分析出你感兴趣的文本。 PDFMiner的好处就是你可以很方便地按文本、HTML或XML格式来“导出”PDF文件。 你也可以使用PDFMiner的命令行工具,pdf2txt.py和dumppdf.py,来为你执行导出工作。如果你不想试图自己弄明白PDFMiner。根据pdf2txt.py 的源代码,它可以被用来导出PDF成纯文本、HTML、XML或“标签”格式。 通过pdf2txt.py导出文本 伴随着PDFMiner一起的pdf2txt.py命令行工具会从一个PDF文件中提取文本并且默认将其打印至标准输出(stdout)。它不能识别文字图片,就像PDFMiner不支持光学字符识别(OCR)一样。让我们尝试用最简单的方法来使用它,那就是仅仅传递给它一个PDF文件的路径。我们会使用w9.pdf文件。打开一个终端并且定位到你存放PDF文件的位置,或修改一下命令指向待处理文件: 如果你执行这条命令,它将打印出所有的文本到标准输出(stdout)。你也可以使pdf2txt.py 将文本写入文件成文本、HTML、XML或“带标签PDF”格式。XML格式将给出关于PDF的大部分信息,因为它包含了每一个字母在文件中的位置以及字体信息。不推荐使用HTML格式,因为pdf2txt生成的标记往往会很丑。以下是教你如何生成不同格式输出的方法: 第一条命令将创建一个HTML文件,而第二条将创建一个XML文件。 最终的结果看上去有点怪,但是它并不太糟糕。XML格式的输出极其冗长,因此我不能将它完整地在这里重现,以下是一小段示例: 使用Slate提取文本 Tim McNamara觉得PDFMiner使用起来太过愚蠢和费力,因此他写了一个围绕它的包装器叫做slate,以使它更简单地从PDF中提取文本。不幸的是,它和Python 3不兼容。如果你想试用,你可能需要easy_install以便于安装distribute包,如下: 我不能使用pip 正确安装这个包。然而一旦安装了它,你将能够使用pip来安装slate: 注意最新的版本是0.5.2,而pip未必能拿到这个版本。如果拿不到,那么你可以从GitHub上直接获取slate安装: 现在我们已经准备好写一些代码来从PDF中提取文本了: 正如你能看到的,让slate分析一个PDF文件,你只需要引进slate然后创建一个它的PDF类的实例。PDF类其实是Python内置类list的一个子类,所以它仅是返回了一列/可遍历的文本页。如果PDF文件设有密码,你可以传入一个密码参数。不管怎样,一旦文件被分析,我们只要打印出每一页的文本即可。 我非常喜欢slate,它用起来更简单。不幸的是,这个包也几乎没有什么相关文档。在浏览过它的源码之后,它看起来只支持纯文本提取。 导出你的数据 现在我们得到了一些文本,我们会花费一些时间来学习如何导出数据成各种不同的格式。具体来说,我们将学习如何以如下方法导出文本: ●XML ●JSON ●CSV 让我们开始吧! 导出成XML 可扩展标记语言(XML)格式是最为人所熟知的输入输出格式之一。它被广泛运用于互联网中的许多不同的事物。正如我们已经在本贴中看到的,PDFMiner也支持XML作为它的输出之一。 话虽这么说,让我们创建我们自己的XML生成工具。如下是一个简单的例子: 这段代码将使用Python内置的XML库,minidom和ElementTree。我们也引入PDFMiner生成器代码以用于每次抓取一页文本。在这个例子中,我们用PDF的文件名创建了我们顶层的元素。然后在它的下层增加了一个页(Pages)元素。下一步是for循环,在此循环中我们从PDF中提取每一页然后保存想要的信息。此处你可以加入一个特定的分析程序,其中你可以将页分成句子或者单词,从而分析出更有趣的信息。比如,你可能只想得到有某个特定名字或日期/时间戳的句子。你可以运用Python的正则表达式来找出这类东西,或者仅是检查子字符串在句子中的存在。 对于这个例子,我们仅仅是提取了每一页的前100个字符并将其存入一个XML的子元素(SubElement)中。接下来的一段代码可以简化成仅是写出XML文件。然而,ElementTree不会做任何事来使得XML易读。它最后看上去有点像压缩的JavaScript似的一块巨型文本。所以我们在写入文件之前使用minidom 通过空格来“美化”XML,而不是将整块文本写入磁盘。最终看上去像这样: 上面是漂亮干净的XML,同时它也是易读的。锦上添花的是,你可以运用你在PyPDF2章节中所学到的知识从PDF中提取元数据(metadata),然后将其也加入到XML中。 导出成JSON JavaScript对象注释, 或者JSON, 是一种易读易写的轻量级的数据交换格式。Python包含一个json 模块于它的标准库中,从而允许你用编程方式来读写JSON。让我们运用从前一章节学到的内容来创建一个导出器脚本来输出JSON而不是XML: 这里,我们引入所需要的不同的库,包括PDFMiner模块。然后创建一个函数,以PDF文件的输入路径和JSON文件的输出路径为参数。在Python中JSON基本上就是一个字典,所以我们创建一对简单的顶层的键:Filename和Pages。Pages键对应一个空的表单。接着,我们循环遍历PDF的每一页并且提取每一页的前100个字符。然后创建一个字典变量以页号作为键100个字符作为值并将其添加到顶层的页表单中。最后,我们利用json 模块的dump 命令生成文件。 文件的内容最终看上去像这样: 又一次,我们得到了易读的输出。你也可以通过PDF的元数据(metadata)来加强这个例子,如果你乐意的话。请注意输出将会改变,它依赖于你想从每一页或文档中分析出什么样的结果。 现在让我们来快速看一下怎样导出CSV文件。 导出成CSV CSV是 **comma separated values** (逗号分隔值)的缩写。它是一种漂亮的标准格式,并且已经存在了很长时间。CSV的优点就是Microsoft Excel和 LibreOffice都能够自动地以漂亮的电子表格的方式将它们打开。你也可以在一个文本编辑器中打开CSV文件,如果你乐意看到它的原始值的话。 Python有一个内置的csv 模块,你可以用它来读写CSV文件。在这里我们将用它从我们由PDF中提取的文本来创建一个CSV。让我们看一下代码: 这个例子中,我们引入了Python的csv库。除此以外,引入的库和前一个例子相同。在函数中,我们利用CSV文件路径创建了一个CSV文件处理器。然后用文件处理器作为唯一的参数初始化了一个CSV写入器对象。接着像之前一样遍历了PDF页。这里唯一的不同就是我们将前100个字符分割成了单个的词。这将允许我们拥有一些真实的数据来加入到CSV中。如果不这样做,那么每一行将只会有一个元素在其中,那就不算一个真正的CSV文件了。最后,我们将一列单词写入CSV文件中。 这就是得到的结果: 我认为这个例子同JSON或XML的例子相比读起来难了点,但是它不算太难。现在让我们继续来看一下怎样才能将图片从PDF中提取出来。 从PDF中提取图片 不幸的是,并不存在Python包可以真正地做到从PDF中提取图片。我找到的最接近的东西是有一个叫minecart的项目宣称可以做到这一点,但是它只在Python 2.7上有效。我没法使其运行于我的PDF样本。在Ned Batchelder的博客上有一篇文章谈到了一点儿如何从PDF中提取JPG图片。代码如下: 这同样对我使用的PDF文件无效。有一些人在留言中宣称代码对他们的一些PDF文件有效,同时也有一些留言例举了修改后的代码。Stack Overflow网站上有关于这个的各种代码,其中一些这样或那样地使用了PyPDF2。但没有一个对我有效。 我的建议是使用一个类似于Poppler 的工具来提取图片。Poppler有一个工具叫做pdfimages,你可以同Python的subprocess模块一起来使用。以下是你如何在没有Python的情况下使用它: 请确保images文件夹(或你想新建的任何输出文件夹)已经被创建,因为pdfimages不会为你创建它。 让我们写一个Python脚本来执行同样的命令,请确保输出文件夹已经存在: 在这个例子中,我们引入了subprocess和os模块。如果输出路径不存在,我们会尝试创建它。然后我们运用subprocess的call函数来执行pdfimages命令。使用call函数是因为它将等到 pdfimages命令完全执行完才返回。你可以代之以Popen,但是那将基本上在后台运行命令进程。最后,我们打印出输出路径下的细节,以确定所有的图片都被提取进了其中。 还有一些网络上的其它文章引用了一个叫做Wand 的库,你也许可以试一试。它是一个ImageMagick的包装器。还有一个值得关注的是绑定了Poppler的Python叫做pypoppler,虽然我没有能够找到任何和这个包相关的提取图片的例子。 总结 这篇文章网罗了很多信息。我们学习了一些可以用来从PDF中提取文本的包,如PDFMiner或Slate。我们还学习了如何运用Python的内置库来导出文本到XML、JSON和CSV。最后,我们研究了一下从PDF中导出图片这个棘手的问题。尽管Python目前没有任何出色的库可以完成这个工作,你可以采用其它工具的变通方案,例如Poppler的pdfimage工具模块。 原文发布时间为:2018-11-29 本文作者:Mike Driscoll 本文来自云栖社区合作伙伴“数据分析”,了解相关信息可以关注“数据分析”。

优秀的个人博客,低调大师

python通过web3py链接以太坊区块链节点的几种方式

通信服务提供接口是web3如何与区块链交互的关键。接口接受JSON-RPC请求并返回响应。这通常通过将请求提交给基于HTTP或IPC套接字的服务器来完成。 如果你已经愉快地连接到你的以太坊节点,那么你可以跳过这部分内容。 选择如何连接到你的节点 大多数节点都有多种连接方式。如果你尚未确定要使用哪种节点,请转到如何选择要使用的节点? 连接节点的最常用方法是: 1.IPC(使用本地文件系统:最快,最安全) 2.Websockets(远程工作,比HTTP更快) 3.HTTP(更多节点支持它) 如果你不确定如何决定,请选择以下方式: 如果你可以选择在与节点相同的计算机上运行Web3.py,请选择IPC。 如果必须连接到其他计算机上的节点,请使用Websockets。 如果你的节点不支持Websockets,请使用HTTP。 大多数节点都有“关闭”连接选项的方法。我们建议你关闭所有未使用的连接选项。这提供了更安全的设置:它减少了恶意黑客可以试图窃取你的以太币的方式。 确定连接后,可以使用通信服务提供接口Provider指定详细信息。通信服务提供接口Provider程序是为所需类型的连接配置的Web3.py类。 看这几个: IPCProvider WebsocketProvider HTTPProvider 配置通信服务提供接口程序后,如: from web3 import Web3 my_provider = Web3.IPCProvider('/my/node/ipc/path') 然后你就可以初始化Web3实例了,如下所示: w3 = Web3(my_provider) 这样,你就已准备好开始使用Web3.py. 自动与手动通信服务提供接口 如果未指定通信服务提供接口程序,Web3对象将在几个标准位置查找以太坊节点。初始化时会发生自动检测: from web3.auto import w3 # which is equivalent to: from web3 import Web3 w3 = Web3() 有时,web3无法自动检测节点的位置。 如果你不确定使用哪种连接方法,请看上文。 如果你知道连接方法,但不知道连接所需的其他信息(如IPC文件的路径),则需要在节点的配置中查找该信息。 如果你不确定使用的是哪个节点,请参阅如何选择要使用的节点?。 要深入了解自动检测的工作原理,请接着看: 自动检测如何工作 Web3尝试按以下顺序连接到节点,使用它可以进行的第一个成功连接: 由环境变量指定的连接。 IPCProvider,它查找几个IPC文件位置。 HTTPProvider,尝试连接到http://localhost:8545。 如果没有提供者成功,你仍然可以使用不需要连接的Web3 API,例如: 类型转化(Type Conversions)。 货币单位转换(Currency Conversions)。 地址相关(Addresses)。 使用本地私钥(Local Private Keys)。 等等。 使用自动检测的示例 一些节点提供超出标准的API。有时,跨节点以不同方式提供相同的信息。如果要编写跨多个节点工作的代码,可能需要查找连接到的节点类型。 例如,以下内容检索geth和parity的客户端enode端点: from web3.auto import w3 connected = w3.isConnected() if connected and w3.version.node.startswith('Parity'): enode = w3.parity.enode elif connected and w3.version.node.startswith('Geth'): enode = w3.admin.nodeInfo['enode'] else: enode = None 通过环境变量 或者,你可以在启动脚本之前设置环境变量WEB3_PROVIDER_URI,web3将首先查找这种方式。 此环境变量的有效格式为: file:///path/to/node/rpc-json/file.ipc http://192.168.1.2:8545 https://node.ontheweb.com ws://127.0.0.1:8546 自动初始化的快捷方式 常见方法中有几个自动初始化的快捷方式。 Infura Mainnet 要轻松连接到Infura Mainnet远程节点,如果你没有https://infura.io/signup,请先注册免费的API密钥。 然后使用你的API密钥设置环境变量INFURA_API_KEY: $ export INFURA_API_KEY=YourApiKey >>> from web3.auto.infura import w3 # confirm that the connection succeeded >>> w3.isConnected() True Geth dev PoA 要使用默认值连接到geth --dev PoA(Proof-of-authority)实例: >>> from web3.auto.gethdev import w3 # confirm that the connection succeeded >>> w3.isConnected() True 内置通信服务提供接口 Web3附带以下通信服务提供接口程序,这些通信服务提供接口程序适用于连接到本地和远程JSON-RPC服务器。 HTTPProvider class web3.providers.rpc.HTTPProvider(endpoint_uri[, request_kwargs]) 此通信服务提供接口程序处理与基于HTTP或HTTPS的JSON-RPC服务器的交互。 endpoint_uri应该是RPC端点的完整URI,例如'https://localhost:8545'。对于在端口80上运行的HTTP连接后面的RPC服务器和在端口443上运行的HTTPS连接,可以从URI中省略该端口。 request_kwargs这应该是关键字参数的字典,它将被传递到http/https请求。 >>> from web3 import Web3 >>> web3 = Web3(Web3.HTTPProvider("http://127.0.0.1:8545")) 请注意,每个python进程只应创建一个HTTPProvider,因为HTTPProvider会回收底层TCP/IP网络连接,以获得更好的性能。 HTTPProvider使用python请求库来发出请求。如果你想修改请求的方式,可以使用request_kwargs来执行此操作。一个常见的用例是增加每个请求的超时。 >>> from web3 import Web3 >>> web3 = Web3(Web3.HTTPProvider("http://127.0.0.1:8545", request_kwargs={'timeout': 60})) IPCProvider web3.providers.ipc.IPCProvider(ipc_path=None, testnet=False, timeout=10) 此通信服务提供接口程序处理与基于IPC Socket的JSON-RPC服务器的交互。 ipc_path是IPC套接字的文件系统路径。:56 >>> from web3 import Web3 >>> web3 = Web3(Web3.IPCProvider("~/Library/Ethereum/geth.ipc")) 如果没有指定ipc_path,它将使用它可以从下表中找到的第一个IPC文件: On Linux and FreeBSD: ~/.ethereum/geth.ipc ~/.local/share/io.parity.ethereum/jsonrpc.ipc On Mac OS: ~/Library/Ethereum/geth.ipc ~/Library/Application Support/io.parity.ethereum/jsonrpc.ipc On Windows: \.\pipe\geth.ipc \.\pipe\jsonrpc.ipc WebsocketProvider class web3.providers.websocket.WebsocketProvider(endpoint_uri[, websocket_kwargs]) 此通信服务提供接口程序处理与基于WS或WSS的JSON-RPC服务器的交互。 endpoint_uri应该是RPC端点的完整URI,例如ws://localhost:8546。 websocket_kwargs应该是关键字参数的字典,它将被传递到ws/wss websocket连接。 >>> from web3 import Web3 >>> web3 = Web3(Web3.WebsocketProvider("ws://127.0.0.1:8546")) WebsocketProvider使用python websockets库来发出请求。如果你想修改请求的方式,可以使用websocket_kwargs来执行此操作。一个常见的用例是增加每个请求的超时。 >>> from web3 import Web3 >>> web3 = Web3(Web3.WebsocketProvider("http://127.0.0.1:8546", websocket_kwargs={'timeout': 60})) ====================================================================== 分享个交互式在线编程实战教程: python以太坊,主要是针对python工程师使用web3.py进行区块链以太坊开发的详解。 汇智网原创翻译,转载请标明出处。这里是原文

优秀的个人博客,低调大师

业界 | 阿里巴巴宣布全面进军IoT,五年要链接100亿设备

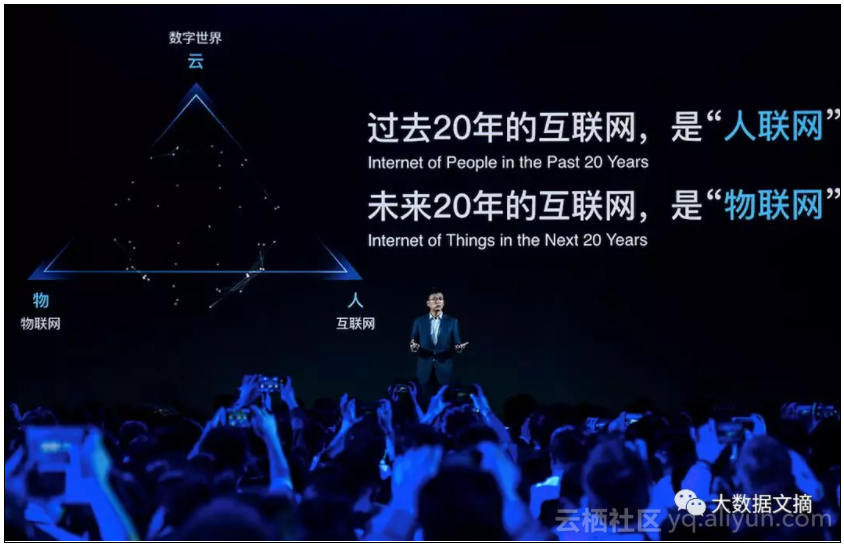
“过去20年的互联网是‘人联网’,未来20年的互联网是‘物联网’。” 3月28日,阿里巴巴集团资深副总裁、阿里云总裁胡晓明在2018云栖大会·深圳峰会上宣布:阿里巴巴将全面进军物联网领域,IoT是阿里巴巴集团继电商、金融、物流、云计算后新的主赛道。 胡晓明表示,互联网的上半场是将人类活动数字化,比如电商、社交、文化娱乐等,催生了今天蓬勃发展的互联网市场,背后是全球40亿网民。互联网的下半场是将整个物理世界数字化,道路、汽车、森林、河流、厂房……甚至一个垃圾桶都会被抽象到数字世界,连到互联网上,实现“物”“物”交流、“人”“物”交互,这会是一场更加深刻的技术变革,一场全新的生产力革命。 目前,阿里云支持2/3/4G、LoRa、NB-IoT、eMTC等95%的通信协议。胡晓明在现场表示,阿里云计划在未来5年内连接100亿台设备。 阿里云于20

优秀的个人博客,低调大师

收集的网络上大型的开源图像处理软件代码(提供下载链接)

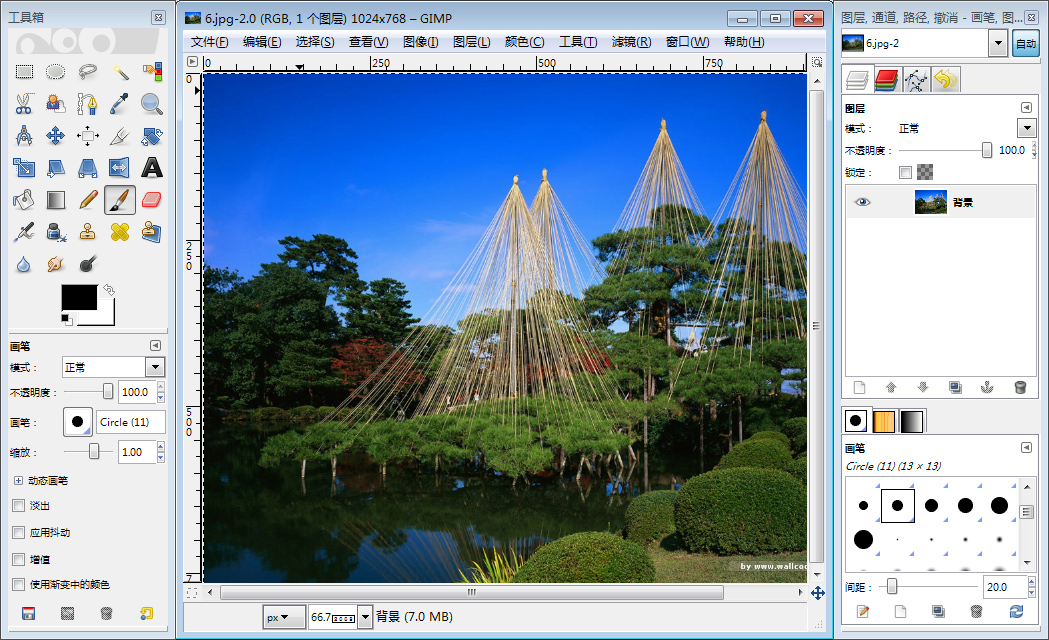
要写好一个图像处理软件,仅靠自己看书是完全不够的,要多方面学习,借鉴前人的经验,要集思广益、多面出击。如今网络发达,图像学的资料其实也到处都是。只是往往个人能力或精力有限,在短时间内无法找到那些也许藏于角落里的金子。本人研究图像至今也历时7年,在慢慢的摸索和累积中也找到了一些相关资料,共享给大家学习。 1、 最著名的开源图像软件:GIMP。 开发语言:C GIMP号称Linux下的PhotoShop,总观其工程,确实达到了PhotoShop早期版本的功能。三大利器:选区、图层、蒙板一应俱全,滤镜也非常丰富,支持插件。缺点就是界面不美观,用户体验差,执行速度在Windows下慢(Linux下不清楚)。 官方网址为:http://www.gimp.org/ 源码下载:因其源码体积过大,请大家直接到其官网下载。 对应的可执行文件可在官方网站下载。 界面预览: 2、 微软曾支持过的"开源"图像软件:Paint.NET。 开发语言:C# Paint.NET是Windows 平台上的一个图像和照片处理软件,早期定位于MSPaint的免费替代软件,支持图层、通道、无限制的历史记录、特效和许多实用工具,在3.3版本之前开源,之后由于种种原因放弃开源。其界面看起来有点像Photoshop,执行速度上也不快。 官方网站:http://www.getpaint.net/ 源码下载:http://files.cnblogs.com/Imageshop/Paint.net.rar 界面预览: 3、一个响当当的图像开源软件:ImageEditor 开发语言:JAVA 一个用JAVA开发的图像处理软件,具有图层、选区、滤镜以及其他一些工具。整体来说较上述两个软件稍次一些,但依旧强劲。提供了很多独特的滤镜算法,工具箱中的透视变形工具很给力,是用JAVA开发图像值得借鉴的好代码。算法的执行速度一般。 官方网址为:http://www.jhlabs.com/ 源码下载:http://files.cnblogs.com/Imageshop/jhlabs.rar 源码中包含对应的EXE文件,但需要机器上安装了JAVA运行环境方可正常运行。 界面预览: 4、优秀的图像操作类库: CxImage 开发语言:C++ 它可以快捷地存取、显示、转换各种图像,自带了较多图像模式转换算法,以及一些滤镜,是VC使用者最为常用的图像类库。 官方网址:http://www.codeproject.com/KB/graphics/cximage.aspx 源码下载:http://files.cnblogs.com/Imageshop/cximage.rar 界面预览: 5、国人的开源图像处理软件: Imagestone 开发语言:C++ ImageStone是一套功能强大的C++图像处理库,能读写JPG、GIF、PNG、TIFF、TGA等多种图像文件,有多达100多中预定义的特效。其算法很多是取自GIMP的代码,如果认为GIMP的代码过于复杂,可以从该软件中很轻松分解出你需要的部分。 官方网址为:http://www.codeproject.com/KB/graphics/ImageStone.aspx 源码下载:http://files.cnblogs.com/Imageshop/ImageStone.rar 界面预览: 6、基于AForge.NET的开源软件:iplab 开发语言:C# 和CxImage似乎是一个作者,包含了很多滤镜,也有一些图像识别上常用的分析方法。 官方网址为:http://www.codeproject.com/KB/GDI-plus/Image_Processing_Lab.aspx 源码下载:http://www.codeproject.com/KB/GDI-plus/Image_Processing_Lab/iplab_src.zip 界面预览: 7、一款VB值得爱好者学习的软件:iBmp 开发工具:VB6 虽然在提供的算法上没有什么太多值得说明的地方,但在图像缩放的坐标计算、偏移、图像导航器方面的代码确实值得大家学习。 官方网址为:http://www.planet-source-code.com/vb/scripts/ShowCode.asp?txtCodeId=42376&lngWId=1 源码下载:http://files.cnblogs.com/Imageshop/iBMP.rar 界面预览: 8、图像编码解码的利器:FreeImage、ImageMagick 开发语言:C FreeImage 是一款免费的、开源的、跨平台(Windows 、Linux 和Mac OS X )的,支持20 多种图像类型的(如BMP 、JPEG 、GIF 、PNG 、TIFF 等)图像处理库。其最大优点就是采用插件驱动型架构,具有快速、灵活、简单易用的特点,得到了广泛使用。 ImageMagick是一套功能强大、稳定而且免费的工具集和开发包,可以用来读、写和处理超过89种基本格式的图片文件,包括流行的TIFF、JPEG、GIF、 PNG、PDF以及PhotoCD等格式。利用ImageMagick,你可以对图片进行改变大小、旋转、锐化、减色或增加特效等操作,并将操作的结果以相同格式或其它格式保存。 9、其他的一些开源软件: (1) PhotoSprite:一个国产的用C#开发的类似PHOTOSHOP的软件(太抬举他了),用到了很多图形算法,新手可以参考。 下载地址:http://files.cnblogs.com/Imageshop/PhotoSprite.rar (2)FilterExplorer: 一个小的VC写的图像处理代码,有一些比较好的滤镜代码。 下载地址:http://files.cnblogs.com/Imageshop/FilterExplorer.rar

优秀的个人博客,低调大师

IOS 教程:自定义链接下载应用并直接安装ipa-itms-services

想不经过App Store直接下载游戏吗?下载完不知道怎么安装?需要通过第三方软件来安装?下面奥特曼超人来带你进入新版的安装教程: 搭建一个HTTPS服务,可以使用HTTPD或者Tomcat构建 使用plist文件 通过A标签调起安装 扩展-(可通过js判断是否安装,如果未安装直接安装,安装了就下载) 早上在撸Html5,有个下载页的需求,需要安卓和苹果,一般来说苹果用第三方或者AppStore的,但这次是在内部使用的App和Ipa,所以得有个方法来绕过这个,其实第三方实现的原理也是如此,来看下执行步骤。 首先,下载plist 文件模版:点我下载 外链:https://github.com/sheep0704/IOSIphoneHttps/blob/master/x5.plist 注意细节,如果自己复制模版,不要漏下下面的声明: <!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd"> 然后把plist文件放在https服务目录下,如果没有服务器的建议使用BaiduYun或者Github来进行测试,如果浏览器提示【无法连接到github.com】,请检查plist文件和服务器的拦截问题,有些马大哈也会把xml写错,可直接用浏览器访问plist地址看看。 然后通过A标签写入进行测试 <a href="itms-services:///?action=download-manifest&url=https://github.com/sheep0704/IOSIphoneHttps/blob/master/x5.plist" class="button button-stripe">苹果正版下载</a> 点击测试,发现并没有效果,苹果浏览器会提示连接不上github.com,我们拦截下请求看看,发现了 Provisional headers are shown! 原因: itms-services应该不支持自签名的SSL证书,要搞一下ssl证书来放plist文件 分享下效果图: 总结:一开始调试几次发现不行,因为用的是NGR,映射了127.0.0.1的Tomcat,所以后来替换回我们自己的服务器地址,经过测试是可行的,所以建议中间不要有转发的过程,直接用外网服务器进行测试。 || 版权声明:本文为博主杜锦阳原创文章,转载请注明出处。

优秀的个人博客,低调大师

生成式引擎优化(GEO)深度指南:当答案取代链接,品牌如何被 AI 说出口

2026 年 8 月 18 日,宾夕法尼亚大学与东北大学的研究者在 arXiv 发布了一项预注册随机对照实验:1100 名美国 Google 用户被随机分配进不同的搜索环境。结果很直白——被强制进入 AI Mode 的用户,对外站点的点击率下降 18.8 个百分点;而把 AI Overviews 完全隐藏的那组,点击率反而上升 8.8 个百分点,且用户对信任度、满意度、有用性没有任何可察觉的下降。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册