首页 文章 精选 留言 我的

精选列表

搜索[禅道API],共10000篇文章
优秀的个人博客,低调大师

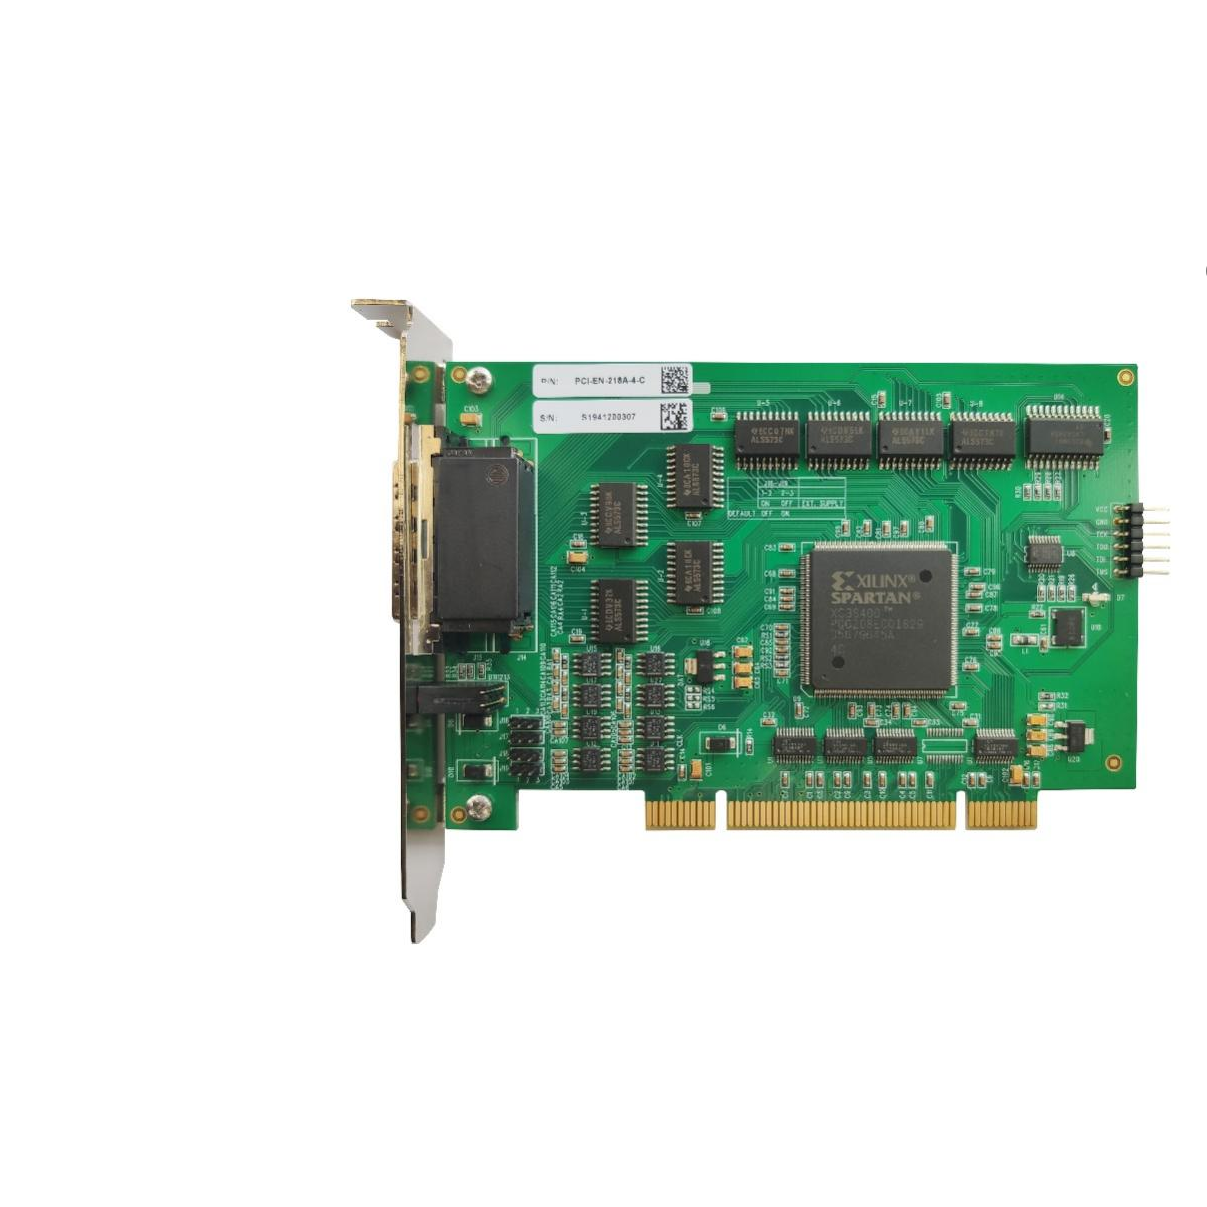
4通道正交解码计数器卡

4 通道正交解码计数器卡(4 轴编码器采集卡),是工业测控、运动仿真领域专用板卡,**4 路独立正交解码通道**,接收增量式正交编码器 A/B/Z 相信号,硬件实时解码,输出位置、方向、脉冲计数,可同时采集 4 台旋转 / 直线编码器,用于位置反馈、转速测量、定位触发、转台仿真、伺服闭环采集等场景。 ![PCI-EN-218A-4-C](https://developer.qcloudimg.com/http-save/yehe-12511585/bc0f6dd1a0f1bd10addc54946ebe8581.jpg) 原理:正交编码器输出相位相差 90° 的 A、B 两相脉冲;板卡硬件判断 A/B 相位超前关系,识别运动方向;支持 **X1/X2/X4** 倍频解码提升位置分辨率;Z 相(索引)用于机械原点锁存。 总线形态常见:PCIe / CPCI / PXI / VPX / USB;军工 / 航电多用 CPCI、VPX;工业 PC 多用 PCIe。 典型应用场景 - 伺服电机、转台、机器人 4 轴位置反馈采集 - 数控机床、AOI 光学检测、位移测量 - 航电仿真、半实物仿真(HIL),编码器信号采集仿真 - 多轴转速、角度、位移实时监测 - 运动控制闭环反馈、位置同步触发 ## 选型要点 1. **最高输入频率**:高速编码器优先选≥10MHz 型号;普通低速 5MHz 足够 1. **是否需要隔离**:工业现场强干扰环境,必须选 2500V 隔离版本 1. **总线**:台式机选 PCIe;3U 机箱、测试平台选 CPCI/PXI;军工加固选 VPX 1. **操作系统**:确认驱动支持麒麟、Ubuntu 等国产 Linux 系统 1. **触发能力**:HIL、同步采集场景,重点看硬件位置比较输出与 FIFO 深度 通用技术参数 |项目|参数| | --- | --- | |通道数量|4 路独立正交编码器通道,每通道 A/B/Z 相| |计数器位宽|32 位(有符号计数,支持正负位置)| |正交倍频模式|X1 / X2 / X4 硬件可编程选择| |编码器输入类型|差分 RS-422 / 单端 TTL/5V CMOS| |最高输入频率|基础款:5MHz;高速款可达 10~18MHz(X4 模式)| |索引功能|Z 相硬件锁存位置,捕获原点位置| |数字滤波|可编程数字滤波,滤除输入毛刺| |数字 I/O|4 路隔离 DI、4 路隔离 DO(用于位置比较输出、限位)| |隔离耐压|2500 VDC 光电隔离(I/O ↔ 系统总线)| |比较器|每通道多组 32 位硬件比较器,位置匹配硬件触发输出| |FIFO 缓存|单通道 1024 点 FIFO(不同型号略有差异)| |总线接口|PCIe Gen1 x1 / CPCI 33MHz / PXI / VPX / USB| |连接器|SCSI50、DB37、DB44 等| |开发驱动|C/C++、C#、LabVIEW、Python、MATLAB,Windows/ Linux / 麒麟系统驱动|

优秀的个人博客,低调大师

终端防护的三道防线:预防、检测与响应

终端安全常被当成"装个杀毒软件"的小事。 实际攻防发生在主机上,攻击者从进入、立足到扩散,每一步都在消耗防御者的时间窗口。 把防护按攻击生命周期拆成预防、检测、响应三层来看,比笼统谈"防病毒"更贴近真实运维。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-12625089/dfac3f0ad331b8545bb8b6e1ad4f2e33.png) ## 一、预防(pre-execution):拦在代码跑起来之前 这是最省成本的一层。 签名与信誉拦截仍是主力: 已知恶意样本的哈希、证书、信誉库能在落地瞬间挡掉大部分自动化攻击。 但它挡不住免杀和 0day,所以得补上漏洞加固——关掉不必要的高危端口、收紧服务权限、把 RDP/SSH 暴露在公网的入口收口。 最小权限原则在这里最实用: 普通账号不给本地管理员,能拦掉一大票"下载即执行"的套路。 对高价值主机可以再上应用控制(白名单),只允许签名的程序跑,把执行面直接缩小到业务必需。 补丁与配置基线是地基,很多入侵不是因为没防,而是某台机器三个月没打补丁,被已知漏洞一把捅穿。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-12625089/b57a45cdfb74cda21364c5746c70f902.png) ## 二、检测(detection):预防有漏网,得有"看"的能力 行为监控盯着进程链: 一个 Word 起来后去调 powershell、再去连陌生外网,这种父子关系异常比单看文件哈希更早暴露问题。 EDR 的遥测把进程、网络、注册表、文件操作全记下来,出事后能还原时间线。 UEBA 则给每个人、每台机建行为基线,罕见进程、非工作时间大批量读取、向同网段多台机器发起 SMB 连接(典型的横向移动迹象)这类偏离基线的动作,比规则更擅长抓"人还在、手法新"的入侵。 实践中把遥测按 MITRE ATT&CK 的战术阶段打标签,复盘时能直接看出攻击者走到了哪一步、在哪一层断了线。 EPP 与 EDR 的关系也在这层清楚: EPP 偏"拦",把已知威胁挡在门外; EDR 偏"看"与"溯",出问题能拉出完整证据链。 两者不是替代,是前后配合。 ## 三、响应(response):检测到不等于处置完 主机隔离先把受感染机器从网络拔掉,防止横向扩散,这是争取时间的硬手段。 进程查杀清掉落地载荷,文件回滚把被篡改的系统或业务文件恢复到可信版本——前提是平时有可信快照或备份。 取证留存别省: 内存镜像、日志、样本先归档,后续定责和复盘都要靠它,别一杀了之把线索也清了。 隔离单台还不够,记得拿提取出的 IoC 在全网扫一遍,确认横向扩散范围,否则清了一台、别的机器还留着后门。 响应最好落到写好的 runbook 上,谁隔离、谁取证、谁通知,步骤定死,半夜告警来了不至于手忙脚乱。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-12625089/5a4953b1530238a0e205b7f3f8c95e0c.png) ## 总结 预防靠规则、检测靠数据、响应靠流程,三层都得有。 只上拦截不建遥测,出了事两眼一抹黑; 只看不拦,告警成噪音; 能拦能看却没响应流程,处置全靠临时发挥。 按这三层去盘自己环境里缺哪块,比追一个新名词实在。 **责编:安企神小赵**

优秀的个人博客,低调大师

SEO 没死,生成式 AI 优化道阻且长

“ 3 个月 5980 ,你的品牌名上不了 DeepSeek ,你来找我,我们直接退钱! ” “一个词 5980 吗?” “对,如果你优化多个平台,会有梯度优惠,比如豆包、元宝、KIMI 。” 以上,是最近一个 GEO( Generative Engine Optimization 生成引擎优化)业务销售与朋友的聊天记录,大概情况是:朋友是做 MCN 的,需要在 DeepSeek 、豆包、元宝等国内 AI 平台上优化自己的品牌关键词(或业务关键词),然后一个自称 GEO 营销专家的销售嗅着味就过来了,其产品 PPT 营销味之冲,令人咋舌。 整理了一些关键表述,大家评估(不便直接截图,但是真人真事): 答案霸权战争开启,95% 传统 SEO 企业出局 未布局 GEO 企业搜索量暴跌 90% GEO 成本≈传统 SEO 的 1/10 ... 笔者理解在一些营销场域,确实需要拽狠词儿,但不解:一个 2023 年随 ChatGPT 大火后出现的技术方向,真的有如此大的能量?这不禁让笔者联想到 2022 年还有一篇文章提到:“随着 ChatGPT 取代谷歌搜索,传统的搜索引擎优化( SEO )正走向消亡...” 但事实上,SEO 并没死,诸如 GEO、LLMO 等优化概念,也随着这几年生成式 AI 技术的发展,与传统 SEO 形成互补、协作的态势。 闲言少叙,正片开始。 GEO、LLMO 是什么?二者有何联系? 严格来说,我们处于一个由人工智能技术,特别是生成式 AI ( Generative AI )深刻变革的时代。以大语言模型为核心的生成引擎,如 ChatGPT 、Gemini 、DeepSeek 、豆包、腾讯元宝等,正以前所未有的速度渗透到信息检索、内容创作、问题解答、决策辅助等各个环节。 而用户获取信息的行为也正发生转变:从过去习惯于在搜索引擎返回的“链接列表”中自行探索、筛选和整合信息,逐渐转向直接对 AI 提出问题,并期望获得一个经过 AI 理解、提炼、组织后的综合性、对话式答案。 以上是因,果则是:传统的 SEO 策略,虽仍有价值,但不足以完全应对这场由 AI 驱动的信息革命。2023 年 ,GEO(生成引擎优化)这一概念被提出,随之还有 LLMO(大语言模型优化)。 方便大家了解,笔者引用 @已见室 的解读,如下: 综合来看,二者不外乎解决一件事情:提升品牌及其内容在生成式 AI 回答中的可见度。但二者也有些许不同。 我们先聊 GEO 。GEO 全称 Generative Engine Optimization ,指通过优化网站内容,提升其在 AI 驱动的搜索引擎(国内如 Deepseek 、百度 AI 搜索、秘塔搜索,国外如 ChatGPT 、Perplexity 、Gemini 、Copilot 和 Google AI Overviews )中的可见度。 例如,当用户搜索与你的产品、服务或专业领域相关的内容时,GEO 能帮助你的品牌在 AI 生成结果中获得优先展示,从而实现精准触达,最终将访客转化为品牌的忠实用户,促使他们持续回访并深度互动。 故 GEO 多面向企业、品牌、内容创作者,以及营销人员。 在上海源易信息发布的《GEO 营销新增长白皮书》一文提出,企业要系统性地构建能被生成式 AI 优先采信的内容,可以遵循 DSS 原则,即:语义深度、数据支持、权威来源。 语义深度:指内容在信息丰富度、分析透彻度、逻辑严谨性、上下文关联性和满足用户深度(而非表层)需求方面的程度。 数据支持:指内容中的观点、结论或陈述是否基于可验证的事实、可靠的数据、具体的案例或明确的证据。 权威来源:指内容本身的出处(发布平台或作者)是否具有公认的专业性、权威性和良好的声誉,关乎内容的可信背书和行业地位。 而 LLMO( Large Language Model Optimization ),则聚焦于模型自身的优化,涉及模型微调、模型压缩、优化推理效率、改进上下文学习能力等,以提高模型的准确率、响应速度或多模态处理能力。 例如:通过微调,让模型在金融行业场景下,更准确地分析财报;通过剪枝,让模型在面对一些低延时场景下,提升响应速度。 故 LLMO 多面向 AI 开发者、数据科学家或工程师。 那么,GEO 与 LLMO 之间有何关联呢?在搞懂这一点前,不妨看看 LLM 是如何影响单一品牌出现的,从机制上: 预训练数据:模型在预训练期间的数据、权重。换言之,LLM 不创造内容,生成什么,取决于曾经“被投喂”过什么; 上下文检索:在 RAG(检索增强生成)系统中,上下文检索可以定位与 query 相关的内容(如:输入输出对),而非单独依赖模型训练时的旧数据; 注意力机制:模型对输入的各个部分进行加权; 外部检索:联网搜索功能。 总结一下,大家可以将 LLMO 看作是为了“精准反馈用户所需要的内容”,大模型在“输出前”的自身机制优化,而 GEO 则为了优化 AI 生成结果的先后顺序,即:针对于生成式 AI 答案的“ SEO ”。二者相互协同,最终提升品牌在生成式 AI 回答中的可见度。 GEO 与 SEO 的关联与互补 笔者明确一个观点:GEO 并非完全摒弃 SEO ,GEO 建立在 SEO 基础之上,并对其核心理念进行了延展。 无论是 GEO 还是 SEO ,其核心目的都是对输出内容的先后顺序进行优化——不外乎 SEO 优化的是网站链接的先后顺序,而 GEO 优化的是 LLM 输出内容的先后顺序。 所以,我们在 AI 搜索引擎中看到的引用链接,常常也出现在搜索引擎结果页( SERP )的前列。 左图(GEO)所引用的“某度百科”,为右图(SEO)的第二位 而搜索引擎和生成式 AI 引擎的本质都是“响应用户需求”,因此 SEO 和 GEO 都需要先明确“用户想获取什么信息”,再反向优化策略。二者的本质都是“用户需求→信息匹配→优化策略”的闭环,只是“需求载体”不同,SEO 是“搜索关键词”,GEO 是“自然语言提问”。 且为了更好理解用户需求,搜索引擎和生成式 AI 引擎都依赖 NLP (自然语言处理),因此 GEO 和 SEO 在“语言优化”层面其实是相似的。 SEO 的 NLP 应用:搜索引擎通过 NLP 解析用户关键词的语义,例如“电脑卡怎么办”与“如何解决电脑卡顿”是同义需求,因此 SEO 还需要优化内容的“语义关联性”,并非单纯的关键词查询。 GEO 的 NLP 应用:生成式引擎的核心是理解用户的自然语言提问,例如“帮我推荐附近一家靠谱的火锅店”,GEO 不但需要负责推荐的排序,还得整合输出对应品牌的相关标签,以满足“靠谱”“附近”等词的语义解决。 至于 GEO 与传统 SEO 的互补,其实可以分为两个方面: 1、产品形态的角度 目前很多 AI 搜索引擎都会同时返回“ AI 输出整理”与“传统搜索引擎结果”,即:顶部显示 AI 生成式回答,下方序列显示相关网页链接。例如,在 Google 搜索“what are the 4 ps of marketing ”,会显示如下结果: 再拓展一下,例如某音这款大家常用的短视频 APP ,也推出了“ AI 搜一搜”这类功能,搜索的答案则不会直接反馈“关联词”的短视频,而是 AI 生成的答案。 可见,在实际使用场景中,输出内容背后所对应的优化逻辑( GEO/SEO ),目前仍是并行使用的。 2、爬虫协议的角度 传统的 SEO ,是通过网络根目录下的 robot.txt 文件去抓取网络的内容、关键词,而现在的 GEO 依旧沿用了这一爬虫协议,并诞生了更契合大模型理解的 llms.txt 协议,通过提供网站的结构化 Markdown 文档,帮助 LLM 理解哪些内容重要,哪些内容不重要、可取舍,从而减少爬虫工具对网站的抓取负担。 目前,全球大概已有 5000+ 网站布局了 llms.txt ,以增强网站的机器可读。爬虫协议方面,robot.txt 、sitemap.xml 、llms.txt 呈现出并行支持的态势。 针对 GEO ,企业可以怎么做? 上文也提到,GEO 是为了让大模型更好抓取内容并理解,在“输入前”的一整套可操作的优化方案。那么“输入前”是哪个阶段呢?对于企业来说,无非是官网搭建、内容框架、分发渠道等,即:向 LLM 介绍“ who am I ”的阶段。 针对于提高企业相关内容的能见度,我们又该怎么做呢?结合上海源易信息的解决方案,笔者用大白话为大家整理如下—— 内容层优化: 1、深度挖掘核心用户需求,打造具有标签性质的内容框架。例如,品牌可以通过用户调研、搜索数据分析等,建立品牌 FAQ 板块。这样不仅可以通过品牌官网解决大部分用户需求,也可以满足 LLM 信息抓取的结构化需要,毕竟在对话式 AI 语境下,大模型的输出也是一问一答。 2、提升语义深度。品牌在搭建内容框架时,需要提供尽可能全面的信息。例如:产品背景、技术参数、专业名词解释、针对痛点、恰当类比、解决方案,以及明确导向能给用户带来的独特价值。总而言之,品牌最好要有自己独特的内容框架,别抄模板,别写一些模棱两可的话。 3、强化数据支持。说白了,言之有理,言有出处。一方面,引用可信数据,例如来自于权威机构(政府、研究机构、行业协会)的最新数据、统计报告;另一方面,多使用图表、图像等形式让数据更直观易懂。 4、建立 LLM 受益的文档结构。即 Snowflake 的“全球文档”概念,指 LLM 通过将文本分解为“块”来工作,可以通过在整个文本中添加有关文档的额外信息(如财务文本的公司名称、提交日期),LLM 更容易理解并正确解释每个独立的块,从而提高回答准确率。 技术层优化: 1、夯实 SEO 基础(面向 AI 爬虫):首先确保网站没有阻止 AI 爬虫访问的技术障碍(如 robots.txt 或 llms.txt 设置不当)。其次做好跨端适配,确保在各种设备上都能良好显示和使用。最后使用 HTTPS 加密,搜索引擎更倾向于优先展示 HTTPS 网站。 2、结构化数据( Schema Markup )深度应用:Schema 标记是一种标准化的词汇表,可添加到网站 HTML 中,帮助搜索引擎和 AI 更精准地理解页面的含义和实体关系。基于此,Schema 标记直接向 AI 提供相关内容的“元数据”,降低 AI 理解内容的难度和歧义性,也提升了内容被准确解读和采信的可能性。 3、实体优化:是指内容和网站结构中清晰地定义和关联这些核心实体,帮助 AI 准确识别并理解它们。例如,在内容中一致地使用品牌、产品、人物、logo 等的标准名称,建立内部链接将相关实体页面连接起来;在权威第三方平台(如维基百科、行业数据库、知识图谱网站)上建立和完善品牌相关的实体信息。 4、建立“防御性 GEO ”机制:GEO 策略不仅要着眼于优化正面信息,更要建立常态化的品牌 AI 声誉监测体系。主动发现并追踪 AI 回答中关于品牌的潜在负面、不实或过时信息。一旦发现问题,可以通过发布和优化更权威、全面、可信的官方信息(如声明、FAQ 、事实核查文章)来“对冲”负面内容,争取让 AI 采信正面信息源。 平台选择与分发策略: 我们得承认,即便内容质量再高,如果发布在 AI 不常访问或不信任的平台上,品牌被引用的效果也会大打折扣。 所以,企业可以优先在行业内公认的网站、知名媒体或高权重平台发表内容。其次,优先在 AI 索引的主流平台发布内容,满足 LLM 抓取习惯。最后,切忌随意更换品牌的官方表述、历史声誉等信息。(笔者还认为,在分发过程中,明确内容作者的专业背景、从业经验、相关认证等,通过关联作者信息的形式,也有利于品牌的索引曝光。) 图源:上海源易信息 目前的困难与挑战 总体来说,GEO 目前依旧是一个新兴的研究领域,自带历史局限性。例如,2022 年,GEO 刚被提出时,网上就出现了“如何确保优化后的内容准确可信”、“过度优化导致优质小众内容被淹没”的声音。 而在笔者咨询了一圈企业主之后,也得到了更多的负面声音: 除了需要支付 SEO 的费用,还要支付 GEO 的费用,徒增运营成本 如何防止竞争企业在 AI 平台上对品牌进行恶意抹黑 AI 生成内容对原创内容的引用、改编和合成,引发关于版权、知识产权归属的法律和伦理问题 那些跟模型厂商有合作,或者有关联的品牌,能否介入 LLM 的参数权重 类似还有很多,笔者就不展开了。我们不得不承认:原本在 SEO 时代下存在的,恶性竞价、优化转单等问题,依旧可能在 GEO 时代发生。除此之外,生成式 AI 内容优化还自带与 AI 深度结合下的发展挑战: 算法不透明、难以解释。目前,大模型的“黑箱”问题在短期内难以解决,但随着技术发展与市场监管的要求,生成引擎提供商可能会有限度地提高算法透明度,或提供更明确的内容指南,帮助创作者更好地进行优化; 网站的机器可读性低。在生成式 AI 深度介入内容生态后,“机器可读性” 的内涵已远超传统 SEO 中对 HTML 结构、标签规范的基础要求,而类似于 llms.txt 等标准,还未大范围推行; 数据偏见的固化与放大。生成式 AI 的优化能力高度依赖训练数据的质量,而历史数据中隐含的社会偏见(如性别刻板印象、地域认知偏差)会被模型学习并在优化过程中强化。这种偏见的 “代际传递” 难以通过简单的算法调整消除,因为它根植于数据反映的历史认知偏差。 GEO 还没有像 SEO 一样,走向体系化。SEO ,不仅有搜索引擎平台出的规范、教程以及适用范围,在业内同样有专业的从业资格认证,且诞生出了 SEO 优化师这一垂直岗位。反观 GEO ,就像笔者开篇所写,一个词优化就需要 6000 块,谁定的价?优化方案是?优化平台是?目前在很多方面仍不透明。 ...... 可见,让 AI 有效回答,并满足人类的实际需求,并不是一件简单的事情。但笔者还是认为:无论是 GEO ,还是 LLMO ,LLM 都可以拥有其自身的回答风格与范式,这也是目前绝大部分模型厂商的态度。至于商业品牌的曝光需求,不妨落在特定业务场景下的 AI Agent 中去解决,或许所生成的内容、提供的服务,更易被提问者接受。 参考资料: 1、上海源易信息《GEO 营销增长白皮书》 2、https://digitalzoo.com.hk/blog/seo%e5%b0%88%e9%a1%8c/geo-llmo-aeo-%e5%85%a8%e9%83%a8%e9%83%bd%e5%8f%aa%e6%98%afseo%e8%80%8c%e5%b7%b2/ 3、https://mister-seo.com/llmo-gaio-geo/

优秀的个人博客,低调大师

想要面试大数据工作的50道必看题

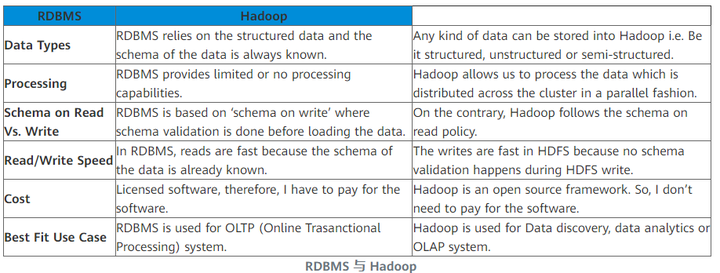
摘要:是否对面试官在 Hadoop 面试中可能会问的所有问题感到不知所措?现在是时候通过一系列涵盖 Hadoop 框架不同方面的 Hadoop 面试问题了。 本文分享自华为云社区《2021 年你必须准备的 50 大 Hadoop 面试问题》,作者:Donglian Lin 。 在本文中,我们将涵盖所有常见问题,这些问题将帮助您通过最佳解决方案在面试中胜出。但在此之前,让我告诉您对大数据和 Hadoop 专家的需求是如何持续增长的。 美国大数据 Hadoop 开发人员的平均工资为 144,000 美元- Indeed.com 印度大数据 Hadoop 开发人员的平均工资为 1600,000 卢比-Indeed.com 英国的平均年薪为 £66,250 – £66,750- itjobswatch.co.uk 我想提请您注意大数据革命。早些时候,组织只关心运营数据,不到整体数据的 20%。后来,他们意识到分析整个数据会给他们更好的业务洞察力和决策能力。那是雅虎、Facebook、谷歌等巨头开始采用 Hadoop 和大数据相关技术的时候。事实上,现在五分之一的公司正在转向大数据分析。因此,对大数据 Hadoop 工作的需求正在上升。因此,如果您想提升自己的职业生涯,Hadoop 和 Spark 正是您需要的技术。无论是新人还是有经验的人,这总是会给您一个良好的开端。 准备好这些顶级 Hadoop 面试问题,以便在新兴的大数据市场中占据优势,全球和本地企业,无论大小,都在寻找优质的大数据和 Hadoop 专家。这份 Hadoop 顶级面试问题的权威列表将带您了解有关Hadoop 集群、HDFS、 MapReduce、Pig、Hive、HBase的问题和答案 。这个博客是通往下一个 Hadoop 工作的门户。 以下是我们将要讨论的问题的大纲: 基本的 Hadoop 面试问题 Hadoop HDFS 面试问题 Hadoop MapReduce 面试题 Apache Pig 面试问题 Apache Hive 面试问题 Apache HBase 面试题 Apache Spark 面试问题 Oozie & Zookeeper 面试问题 如果您在 Hadoop 面试中遇到一些困难的问题,并且仍然对最佳答案感到困惑,请将这些问题放在下面的评论部分。我们很乐意回答他们。 1、关系型数据库和HDFS的基本区别是什么? 以下是 HDFS 和关系数据库之间的主要区别: 2. 解释“大数据”,大数据的五个 V 是什么? “大数据”是大量复杂数据集的术语,这使得使用关系数据库管理工具或传统数据处理应用程序难以处理。捕获、管理、存储、搜索、共享、传输、分析和可视化大数据很困难。大数据已成为企业的机遇。现在,他们可以成功地从数据中获取价值,并且凭借增强的业务决策能力,将比竞争对手具有明显的优势。 ♣ 提示:在此类问题中谈论 5V 将是一个好主意,无论是否专门询问! 卷:卷表示以指数速率增长的数据量,即以 PB 和 Exabytes 为单位。 速度:速度是指数据增长的速度,非常快。今天,昨天的数据被认为是旧数据。如今,社交媒体是数据增长速度的主要贡献者。 多样性:多样性是指数据类型的异质性。换句话说,收集到的数据有多种格式,如视频、音频、csv 等。因此,这些不同的格式代表了数据的多样性。 真实性:真实性是指由于数据的不一致和不完整而对可用数据存疑或不确定的数据。可用数据有时会变得混乱并且可能难以信任。大数据形式多样,质量和准确性难以控制。数量往往是数据缺乏质量和准确性的原因。 价值:获得大数据固然很好,但除非我们能将其转化为价值,否则它毫无用处。通过将其转化为价值,我的意思是,它是否增加了组织的利益?致力于大数据的组织是否实现了高 ROI(投资回报率)?除非它通过处理大数据来增加他们的利润,否则它是没有用的。 3.什么是Hadoop及其组件。 当“大数据”成为一个问题时,Apache Hadoop 演变为它的解决方案。Apache Hadoop 是一个框架,它为我们提供各种服务或工具来存储和处理大数据。它有助于分析大数据并从中做出业务决策,这是使用传统系统无法高效和有效地完成的。 ♣ 提示:现在,在讲解Hadoop的同时,还要讲解一下Hadoop的主要组成部分,即: 存储单元——HDFS(NameNode、DataNode) 处理框架——YARN(ResourceManager、NodeManager) 4. 什么是 HDFS 和 YARN? HDFS(Hadoop分布式文件系统)是Hadoop的存储单元。它负责在分布式环境中将不同类型的数据存储为块。它遵循主从拓扑。 ♣ 提示:建议对HDFS组件也进行说明即 NameNode:NameNode 是分布式环境中的主节点,它维护存储在 HDFS 中的数据块的元数据信息,如块位置、复制因子等。 DataNode:DataNode 是从节点,负责在 HDFS 中存储数据。NameNode 管理所有的 DataNode。 YARN(Yet Another Resource Negotiator)是 Hadoop 中的处理框架,它管理资源并为进程提供执行环境。 ♣ 提示:同理,就像我们在 HDFS 中所做的那样,我们也应该解释一下 YARN 的两个组件: ResourceManager:它接收处理请求,然后相应地将请求的部分传递给相应的 NodeManager,在那里进行实际处理。它根据需要为应用程序分配资源。 NodeManager:NodeManager 安装在每个DataNode 上,负责在每个DataNode 上执行任务。 5. 告诉我各种 Hadoop 守护进程及其在 Hadoop 集群中的作用。 通常通过首先解释 HDFS 守护程序,即 NameNode、DataNode 和辅助 NameNode,然后转到 YARN 守护程序,即 ResorceManager 和 NodeManager,最后解释 JobHistoryServer 来解决这个问题。 NameNode:它是主节点,负责存储所有文件和目录的元数据。它有关于块的信息,它创建一个文件,以及这些块在集群中的位置。 Datanode:它是包含实际数据的从节点。 辅助 NameNode:它会定期将更改(编辑日志)与 NameNode 中存在的 FsImage(文件系统映像)合并。它将修改后的 FsImage 存储到持久化存储中,可以在 NameNode 失败的情况下使用。 ResourceManager:它是管理资源和调度运行在 YARN 之上的应用程序的中央机构。 NodeManager:它运行在从机上,负责启动应用程序的容器(应用程序在其中执行它们的部分),监控它们的资源使用情况(CPU、内存、磁盘、网络)并将这些报告给 ResourceManager。 JobHistoryServer:它在Application Master 终止后维护有关MapReduce 作业的信息。 Hadoop HDFS 面试问题 6. 将 HDFS 与网络附加存储 (NAS) 进行比较。 本题先解释一下NAS和HDFS,然后比较它们的特点如下: 网络附加存储 (NAS) 是连接到计算机网络的文件级计算机数据存储服务器,提供对异构客户端组的数据访问。NAS 可以是提供存储和访问文件服务的硬件或软件。而 Hadoop 分布式文件系统 (HDFS) 是使用商品硬件存储数据的分布式文件系统。 在 HDFS 中,数据块分布在集群中的所有机器上。而在 NAS 中,数据存储在专用硬件上。 HDFS 旨在与 MapReduce 范式一起使用,其中将计算移至数据。NAS 不适合 MapReduce,因为数据与计算分开存储。 HDFS 使用的是具有成本效益的商品硬件,而 NAS 是包含高成本的高端存储设备。 7. 列出 Hadoop 1 和 Hadoop 2 的区别。 这是一个重要的问题,在回答这个问题时,我们必须主要关注两点,即被动 NameNode 和 YARN 架构。 在 Hadoop 1.x 中,“NameNode”是单点故障。在 Hadoop 2.x 中,我们有主动和被动的“NameNodes”。如果主动“NameNode”出现故障,则被动“NameNode”负责。因此,可以在 Hadoop 2.x 中实现高可用性。 此外,在 Hadoop 2.x 中,YARN 提供了一个中央资源管理器。使用 YARN,您现在可以在 Hadoop 中运行多个应用程序,所有应用程序都共享一个公共资源。MRV2 是一种特殊类型的分布式应用程序,它在 YARN 之上运行 MapReduce 框架。其他工具也可以通过 YARN 执行数据处理,这在 Hadoop 1.x 中是一个问题。 8. 什么是主动和被动“NameNodes”? 在 HA(高可用性)架构中,我们有两个 NameNode——主动“NameNode”和被动“NameNode”。 活动的“NameNode”是在集群中工作和运行的“NameNode”。 被动的“NameNode”是备用的“NameNode”,与主动的“NameNode”具有相似的数据。 当主动“NameNode”出现故障时,被动“NameNode”会替换集群中的主动“NameNode”。因此,集群永远不会没有“NameNode”,因此它永远不会失败。 9. 为什么在Hadoop集群中频繁删除或添加节点? Hadoop 框架最吸引人的特性之一是它对商品硬件的利用。然而,这会导致 Hadoop 集群中频繁出现“DataNode”崩溃。Hadoop 框架的另一个显着特点是随着数据量的快速增长而易于扩展。由于这两个原因,Hadoop 管理员最常见的任务之一就是在 Hadoop 集群中启用(添加)和停用(移除)“数据节点”。 10. 当两个客户端试图访问 HDFS 中的同一个文件时会发生什么? HDFS 仅支持独占写入。 当第一个客户端联系“NameNode”打开文件进行写入时,“NameNode”授予客户端创建该文件的租约。当第二个客户端尝试打开同一个文件进行写入时,“NameNode”会注意到该文件的租用已经授予另一个客户端,并拒绝第二个客户端的打开请求。 11. NameNode 如何处理 DataNode 故障? NameNode 定期从集群中的每个 DataNode 接收心跳(信号),这意味着 DataNode 运行正常。 块报告包含 DataNode 上所有块的列表。如果一个 DataNode 发送心跳消息失败,则在特定时间段后将其标记为死亡。 NameNode 使用之前创建的副本将死节点的块复制到另一个 DataNode。 12. NameNode宕机了怎么办? NameNode 恢复过程包括以下步骤来启动和运行 Hadoop 集群: 使用文件系统元数据副本(FsImage)启动一个新的 NameNode。 然后,配置 DataNode 和客户端,以便它们可以确认这个新的 NameNode,即启动。 现在,新的 NameNode 将在完成加载最后一个检查点 FsImage(用于元数据信息)并从 DataNode 接收到足够的块报告后开始为客户端提供服务。 而在大型 Hadoop 集群上,NameNode 恢复过程可能会消耗大量时间,这在日常维护的情况下成为更大的挑战。 13. 什么是检查点? 简而言之,“Checkpointing”是一个获取 FsImage 的过程,编辑日志并将它们压缩到一个新的 FsImage 中。因此,NameNode 可以直接从 FsImage 加载最终的内存状态,而不是重放编辑日志。这是一种更有效的操作,并减少了 NameNode 的启动时间。检查点由辅助 NameNode 执行。 14、HDFS如何容错? 当数据存储在 HDFS 上时,NameNode 将数据复制到多个 DataNode。默认复制因子为 3。您可以根据需要更改配置因子。如果 DataNode 出现故障,NameNode 会自动将数据从副本复制到另一个节点并使数据可用。这在 HDFS 中提供了容错能力。 15. NameNode 和 DataNode 可以是商品硬件吗? 这个问题的明智答案是,DataNodes 是像个人计算机和笔记本电脑一样的商品硬件,因为它存储数据并且需要大量使用。但是根据您的经验,您可以看出,NameNode 是主节点,它存储有关存储在 HDFS 中的所有块的元数据。它需要高内存(RAM)空间,因此NameNode需要是具有良好内存空间的高端机器。 16. 为什么我们在有大量数据集的应用程序中使用 HDFS 而不是在有很多小文件时? 与分布在多个文件中的少量数据相比,HDFS 更适合单个文件中的大量数据集。如您所知,NameNode 将有关文件系统的元数据信息存储在 RAM 中。因此,内存量会限制我的 HDFS 文件系统中的文件数量。换句话说,过多的文件会导致生成过多的元数据。而且,将这些元数据存储在 RAM 中将成为一项挑战。根据经验,文件、块或目录的元数据需要 150 个字节。 17.在HDFS中如何定义“块”?Hadoop 1 和 Hadoop 2 中的默认块大小是多少?可以改变吗? 块只是硬盘驱动器上存储数据的最小连续位置。HDFS 将每个存储为块,并将其分布在整个 Hadoop 集群中。HDFS 中的文件被分解为块大小的块,这些块作为独立的单元存储。 Hadoop 1 默认块大小:64 MB Hadoop 2 默认块大小:128 MB 是的,可以配置块。可以在 hdfs-site.xml 文件中使用 dfs.block.size 参数来设置 Hadoop 环境中块的大小。 18. 'jps' 命令有什么作用? 'jps' 命令帮助我们检查 Hadoop 守护进程是否正在运行。它显示了机器上运行的所有 Hadoop 守护进程,即 namenode、datanode、resourcemanager、nodemanager 等。 19. 你如何定义 Hadoop 中的“机架感知”? 机架感知是“NameNode”根据机架定义决定如何放置块及其副本的算法,以最大限度地减少同一机架内“DataNode”之间的网络流量。假设我们考虑复制因子 3(默认),策略是“对于每个数据块,一个机架中将存在两个副本,另一个机架中将存在第三个副本”。此规则称为“副本放置策略”。 20. Hadoop 中的“推测执行”是什么? 如果某个节点似乎执行任务的速度较慢,则主节点可以在另一个节点上冗余地执行同一任务的另一个实例。然后,首先完成的任务将被接受,另一个被杀死。这个过程称为“推测执行”。 21. 如何重启“NameNode”或Hadoop中的所有守护进程? 这个问题可以有两个答案,我们将讨论这两个答案。我们可以通过以下方法重启NameNode: 您可以使用 单独停止 NameNode。/sbin /hadoop-daemon.sh 停止 namenode命令,然后使用./sbin/hadoop-daemon.sh 启动 namenode命令。 要停止和启动所有守护进程,请使用./sbin/全部停止。sh然后使用 ./sbin/start-all.sh命令将首先停止所有守护进程,然后启动所有守护进程。 这些脚本文件位于 Hadoop 目录内的 sbin 目录中。 22. “HDFS Block”和“Input Split”有什么区别? “HDFS Block”是数据的物理划分,而“Input Split”是数据的逻辑划分。HDFS 将数据划分为块以将块存储在一起,而对于处理,MapReduce 将数据划分为输入拆分并将其分配给映射器函数。 23. 说出 Hadoop 可以运行的三种模式。 Hadoop可以运行的三种模式如下: 独立(本地)模式:如果我们不配置任何东西,这是默认模式。在这种模式下,Hadoop 的所有组件,如 NameNode、DataNode、ResourceManager 和 NodeManager,都作为一个 Java 进程运行。这使用本地文件系统。 伪分布式模式:单节点 Hadoop 部署被视为以伪分布式模式运行 Hadoop 系统。在这种模式下,所有 Hadoop 服务,包括主服务和从服务,都在单个计算节点上执行。 完全分布式模式:Hadoop 主从服务运行在不同节点上的 Hadoop 部署被称为完全分布式模式。 Hadoop MapReduce 面试题 24.什么是“MapReduce”?运行“MapReduce”程序的语法是什么? 它是一种框架/编程模型,用于使用并行编程在计算机集群上处理大型数据集。运行 MapReduce 程序的语法是hadoop_jar_file.jar /input_path /output_path。 如果你对 MapReduce 有任何疑问或想修改你的概念,你可以参考这个MapReduce 教程。 25. “MapReduce”程序的主要配置参数是什么? “MapReduce”框架中用户需要指定的主要配置参数有: 分布式文件系统中作业的输入位置 作业在分布式文件系统中的输出位置 数据输入格式 数据输出格式 包含地图功能的类 包含 reduce 函数的类 包含映射器、减速器和驱动程序类的 JAR 文件 26. 说明我们不能在mapper中进行“聚合”(加法)的原因?为什么我们需要“减速器”呢? 这个答案包括很多点,所以我们将依次进行。 我们不能在 mapper 中执行“聚合”(加法),因为在“mapper”函数中不会发生排序。排序只发生在reducer 端,没有排序聚合是无法完成的。 在“聚合”期间,我们需要所有映射器函数的输出,这些输出在映射阶段可能无法收集,因为映射器可能运行在存储数据块的不同机器上。 最后,如果我们尝试在 mapper 上聚合数据,它需要在可能运行在不同机器上的所有 mapper 函数之间进行通信。因此,它会消耗高网络带宽并可能导致网络瓶颈。 27、Hadoop中“RecordReader”的作用是什么? “InputSplit”定义了一个工作片段,但没有描述如何访问它。“RecordReader”类从其源加载数据并将其转换为适合“Mapper”任务读取的(键、值)对。“RecordReader”实例由“输入格式”定义。 28. 解释“MapReduce 框架”中的“分布式缓存”。 分布式缓存可以解释为,MapReduce 框架提供的一种工具,用于缓存应用程序所需的文件。一旦你为你的工作缓存了一个文件,Hadoop 框架就会让它在你运行 map/reduce 任务的每个数据节点上可用。然后,您可以在 Mapper 或 Reducer 作业中将缓存文件作为本地文件访问。 29、“reducers”之间是如何通信的? 这是一个棘手的问题。“MapReduce”编程模型不允许“reducer”相互通信。“减速器”是孤立运行的。 30. “MapReduce Partitioner”有什么作用? “MapReduce Partitioner”确保单个键的所有值都进入同一个“reducer”,从而允许在“reducer”上均匀分布地图输出。它通过确定哪个“reducer”负责特定键,将“mapper”输出重定向到“reducer”。 31. 你将如何编写自定义分区器? 可以按照以下步骤轻松编写 Hadoop 作业的自定义分区器: 创建一个扩展 Partitioner 类的新类 覆盖方法 – getPartition,在 MapReduce 中运行的包装器中。 使用 set Partitioner 方法将自定义分区程序添加到作业,或将自定义分区程序作为配置文件添加到作业。 32、什么是“合路器”? “Combiner”是一个执行本地“reduce”任务的迷你“reducer”。它从特定“节点”上的“映射器”接收输入,并将输出发送到“减速器”。“组合器”通过减少需要发送到“减速器”的数据量来帮助提高“MapReduce”的效率。 33. 你对“SequenceFileInputFormat”了解多少? “SequenceFileInputFormat”是用于在序列文件中读取的输入格式。它是一种特定的压缩二进制文件格式,经过优化,可将一个“MapReduce”作业的输出之间的数据传递到其他“MapReduce”作业的输入。 序列文件可以作为其他 MapReduce 任务的输出生成,并且是从一个 MapReduce 作业传递到另一个 MapReduce 作业的数据的有效中间表示。 Apache Pig 面试问题 34. Apache Pig 相对于 MapReduce 有哪些优势? Apache Pig 是一个平台,用于分析将它们表示为雅虎开发的数据流的大型数据集。它旨在提供对 MapReduce 的抽象,降低编写 MapReduce 程序的复杂性。 Pig Latin 是一种高级数据流语言,而 MapReduce 是一种低级数据处理范式。 无需在 MapReduce 中编写复杂的 Java 实现,程序员可以使用 Pig Latin 非常轻松地实现相同的实现。 Apache Pig 将代码长度减少了大约 20 倍(根据 Yahoo)。因此,这将开发周期缩短了近 16 倍。 Pig 提供了许多内置操作符来支持数据操作,如连接、过滤、排序、排序等。而在 MapReduce 中执行相同的功能是一项艰巨的任务。 在 Apache Pig 中执行 Join 操作很简单。而在 MapReduce 中很难在数据集之间执行 Join 操作,因为它需要依次执行多个 MapReduce 任务才能完成作业。 此外,pig 还提供了 MapReduce 中缺少的嵌套数据类型,例如元组、包和映射。 35. Pig Latin 中有哪些不同的数据类型? Pig Latin 可以处理原子数据类型(如 int、float、long、double 等)和复杂数据类型(如 tuple、bag 和 map)。 原子数据类型:原子或标量数据类型是所有语言中使用的基本数据类型,如字符串、整数、浮点、长、双、char[]、byte[]。 复杂数据类型:复杂数据类型有元组、映射和包。 36. 你合作过的“Pig Latin”中有哪些不同的关系运算? 不同的关系运算符是: for each order by filters group distinct join limit 37.什么是UDF? 如果某些函数在内置运算符中不可用,我们可以通过编程方式创建用户定义函数 (UDF),以使用其他语言(如 Java、Python、Ruby 等)引入这些功能,并将其嵌入到 Script 文件中。 Apache Hive 面试问题 38.“蜂巢”中的“SerDe”是什么? Apache Hive 是一个建立在 Hadoop 之上的数据仓库系统,用于分析 Facebook 开发的结构化和半结构化数据。Hive 抽象了 Hadoop MapReduce 的复杂性。 “SerDe”接口允许您指示“Hive”如何处理记录。“SerDe”是“Serializer”和“Deserializer”的组合。“Hive”使用“SerDe”(和“FileFormat”)来读取和写入表的行。 39、默认的“Hive Metastore”可以被多个用户(进程)同时使用吗? “Derby 数据库”是默认的“Hive Metastore”。多个用户(进程)不能同时访问它。它主要用于执行单元测试。 40. “Hive”存储表数据的默认位置是什么? Hive 存储表数据的默认位置在 /user/hive/warehouse 中的 HDFS 内。 Apache HBase 面试题 41.什么是Apache HBase? HBase 是一个开源、多维、分布式、可扩展和用 Java 编写的 NoSQL 数据库。HBase 运行在 HDFS(Hadoop 分布式文件系统)之上,并为 Hadoop 提供类似 BigTable (Google) 的功能。它旨在提供一种容错方式来存储大量稀疏数据集。HBase 通过在庞大的数据集上提供更快的读/写访问来实现高吞吐量和低延迟。 42. Apache HBase 有哪些组件? HBase 包含三个主要组件,即 HMaster Server、HBase RegionServer 和 Zookeeper。 Region Server:一个表可以分成几个区域。区域服务器为客户端提供一组区域。 HMaster:它协调和管理Region Server(类似于NameNode 管理HDFS 中的DataNode)。 ZooKeeper:Zookeeper 就像 HBase 分布式环境中的协调器。它有助于通过会话进行通信来维护集群内的服务器状态。 43、Region Server有哪些组成部分? 区域服务器的组件是: WAL: Write Ahead Log (WAL) 是附加到分布式环境中每个 Region Server 的文件。WAL 存储尚未持久化或提交到永久存储的新数据。 块缓存:块缓存驻留在区域服务器的顶部。它将经常读取的数据存储在内存中。 MemStore:它是写缓存。在将所有传入数据提交到磁盘或永久内存之前,它会存储所有传入数据。一个区域中的每个列族都有一个 MemStore。 HFile:HFile 存储在 HDFS 中。它将实际单元存储在磁盘上。 44.解释HBase中的“WAL”? Write Ahead Log (WAL) 是附加到分布式环境中每个 Region Server 的文件。WAL 存储尚未持久化或提交到永久存储的新数据。它用于恢复数据集失败的情况。 45. 提到“HBase”和“关系数据库”之间的区别? HBase 是一个开源、多维、分布式、可扩展和用 Java 编写的 NoSQL 数据库。HBase 运行在 HDFS 之上,并为 Hadoop 提供类似 BigTable 的功能。让我们看看 HBase 和关系数据库之间的区别。 Apache Spark 面试问题 46.什么是Apache Spark? 这个问题的答案是,Apache Spark 是一个在分布式计算环境中进行实时数据分析的框架。它执行内存计算以提高数据处理速度。 通过利用内存计算和其他优化进行大规模数据处理,它比 MapReduce 快 100 倍。 47. 你能用任何特定的 Hadoop 版本构建“Spark”吗? 是的,可以为特定的 Hadoop 版本构建“Spark”。 48. 定义 RDD。 RDD 是弹性分布数据集的首字母缩写词 - 并行运行的操作元素的容错集合。RDD 中的分区数据是不可变的和分布式的,这是 Apache Spark 的一个关键组件。 Oozie 和 ZooKeeper 面试问题 49. Apache ZooKeeper 和 Apache Oozie 是什么? Apache ZooKeeper 协调分布式环境中的各种服务。它通过执行同步、配置维护、分组和命名节省了大量时间。 Apache Oozie 是一个调度程序,它调度 Hadoop 作业并将它们作为一个逻辑工作绑定在一起。有两种 Oozie 作业: Oozie 工作流:这些是要执行的顺序操作集。您可以将其视为接力赛。每个运动员都在等待最后一名运动员完成他的部分。 Oozie Coordinator:这些是在数据可用时触发的 Oozie 作业。将此视为我们体内的反应刺激系统。以同样的方式,当我们对外部刺激做出反应时,Oozie 协调器会对数据的可用性做出反应,否则就会休息。 50. 如何在 Hadoop 中配置“Oozie”作业? “Oozie”与 Hadoop 堆栈的其余部分集成,支持多种类型的 Hadoop 作业,例如“Java MapReduce”、“Streaming MapReduce”、“Pig”、“Hive”和“Sqoop”。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

无间道!勒索软件团伙Conti攻击手册泄露

Conti是近年来最为活跃和危险的勒索软件团伙之一。该组织采用勒索软件即服务 (RaaS) 的运营模式,其中核心团队管理恶意软件和Tor站点,而招募的联盟机构则执行网络漏洞和数据加密攻击。核心团队赚取赎金的20~30%,而附属公司赚取其余部分。 上图是该团伙的培训材料,勒索软件的攻击手册也在其中 近日,安全研究人员pancak3分享了一个反水的Conti加盟机构成员发布的论坛帖子,该成员公开泄露了有关勒索软件操作的信息。该信息包括Cobalt Strike C2服务器的IP地址(下图,pancak3强烈建议立刻封锁图片中的IP地址)和一个113MB的档案,其中包含大量用于进行勒索软件攻击的工具和培训材料。 该成员还表示,他发布这些材料的原因是在一次攻击后的分赃中只获得了1,500美元,而团队的其他成员却将赚取数百万美元。一位威胁情报专家指出,此次泄露的攻击手册与Conti的活跃案例相符,基本可以确认是真实泄露。 此次泄密暴露出勒索软件团伙的组织成熟度,以及他们在针对全球公司发动攻击时使用的流程和经验。同时也暴露了勒索软件即服务操作的脆弱性,因为任何一个不满意的加盟成员都可能会导致攻击中使用的精心制作的培训信息和资源暴露。 作为勒索软件的顶级玩家,Conti勒索软件“渗透测试”团队的操作手册同时也是渗透测试操作的“圣杯”。因此这次泄露将产生积极的影响,防御端的渗透测试人员可以通过这些资料来逐步提高渗透测试技能以应对勒索软件。 【本文是51CTO专栏作者“安全牛”的原创文章,转载请通过安全牛(微信公众号id:gooann-sectv)获取授权】 戳这里,看该作者更多好文

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册