首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

优化数仓业务视图:过滤条件传递

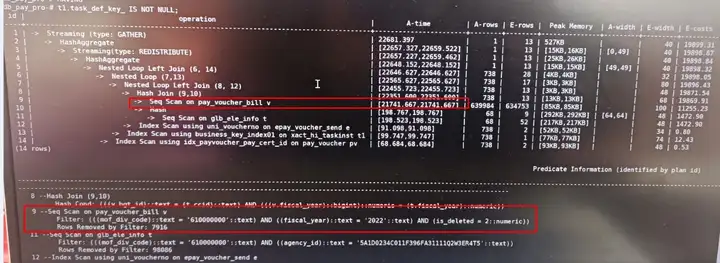
摘要:在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 本文分享自华为云社区《GaussDB(DWS)业务视图优化-过滤条件传递》,作者:卫小毛 。 在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 SQL举例 SELECT count(1) AS have_done_num, t1.task_def_key_ AS menuguid FROM vw_pay_voucher_bill t2 LEFT JOIN xact_hi_taskinst t1 ON t1.business_key_ = t2.id AND t1.proc_def_key_ = 'pay_voucher_bill' AND t1.operation_flag_ IN ('NORMAL', 'WITHDRAW') AND t1.suspension_state_ = 1 AND t1.org_code_ = t2.mof_div_code AND delete_reason_ = 'completed' AND ext1_ IS NULL WHERE t2.is_deleted = '2' AND t2.fiscal_year = '2022' AND t2.mof_div_code = 'xxxxxxxx0' AND ( agency_id = '5A1xxxxxxxxxxxxxxxxxxx4T5' ) GROUP BY t1.task_def_key_ HAVING t1.task_def_key_ IS NOT NULL; sql分析:以上SQL vw_pay_voucher_bill t2 、xact_hi_taskinst t1 视图和表进行关联查询 根据业务特性分析过滤效果较好的字段为 agency_id 优化前耗时:22s 分析执行计划: 时间主要耗时在 seq scan on pay_voucher_bill v 这一步 看到该表过滤条件仅有mof_div_code、fiscal_year、is_deleted 过滤效果差,几乎全表数据参与过程运算,执行代价高 视图及表结构分析: 视图中关联条件较为有效的过滤条件,bgt_id 字段查询时不会应用。分析视图中“v”和“t”表都存在agency_id 字段,当前t表过滤使用了agency_id字段,可以考虑视图定义中量表关联条件增加 agency_id 字段关联条件需要考虑业务需求。 同业务沟通后可进行优化 优化后耗时:0.4s 对比优化前后SQL查询结果一致 优化总结: 同业务侧研发沟通客户实际需要仅需要查询本单位 (agency_id) 下的数据,但因为SQL和视图设计时,并未将这一有效条件传递给每张表。导致数据库在针对 pay_voucher 进行数据过滤时需要将全表64万+ 数据筛选出来进行运算,仅仅这一步开销就占用了20s+。在优化后(视图中增加agency_id关联信息后,该操作可将agency_id 过滤条件传递给基表 pay_voucher),仅需从pay_voucher 表中获取738行数据进行运算,最终sql耗时降为 0.4s左右。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

解析数仓lazyagg查询重写优化规则

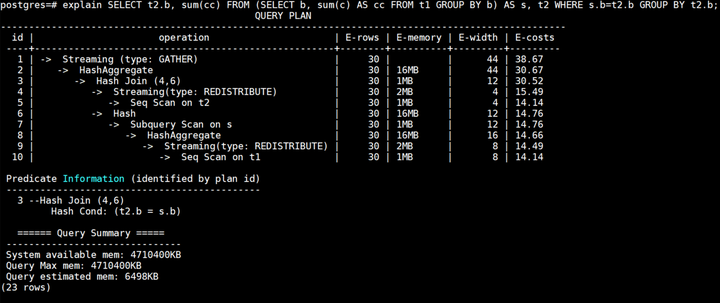
摘要:为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则。 本文分享自华为云社区《GaussDB(DWS) lazyagg查询重写优化解析【这次高斯不是数学家】》,作者: OreoreO 。 聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句eze聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句: SELECT a, count(a) FROM t1 GROUP BY a; -- 按a分组并计算分组内重复值的个数 一、Lazy Agg重写规则 数据量大的场景下,聚集运算由于数据量大导致下盘,聚集操作执行时间成为性能瓶颈,从而导致整个查询执行效率非常差。例如: SELECT t2.b, sum(cc) FROM (SELECT b, sum(c) AS cc FROM t1 GROUP BY b) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 子查询对t1.b列进行聚集,对t1.c列求和,在外部查询中,同样也存在聚集运算,对子查询的聚集求和列cc列求和。对于这类语句,当子查询的聚集运算较耗时的情况下,可以利用查询重写规则消除子查询的聚集运算,由外部查询的聚集函数统一完成聚集运算。消除子查询后可能导致子查询行数增多,但对于子查询聚集运算时t1.b列的distinct值较多的场景,子查询聚集运算后的行数较原表不会有明显缩减,不会导致外层JOIN运算量的大量增加。即语句可被重写为: SELECT t2.b, sum(cc) FROM (SELECT b, c AS cc FROM t1) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 这个改写规则称为Lazy Agg,适用于基表数据量大且distinct值较多的场景。如果重复值较少,那么消除了聚集操作会导致Join后的行数激增,Join性能较差,因此需要将Agg下推到Join之前进行,通过提前的Agg操作减少Join结果的行数,这个改写规则称为Eager Agg。 二、GaussDB(DWS) lazyagg优化 为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则,可以通过设置guc参数rewrite_rule包含’lazyagg’使用Lazy Agg查询重写优化。开启lazyagg查询重写优化后,对满足条件的场景会优化并消除子查询中的聚集操作。原计划如下所示: lazyagg重写优化后计划如下所示: 可以看到相比于原计划,lazyagg重写优化后消除掉了原计划中的聚集操作,即7号Subquery Scan算子和8号HashAggregate算子。 三、lazyagg优化规格 支持子查询为单一聚集查询或包含聚集子集合操作的查询。集合操作仅支持UNION ALL,可对部分分支子查询进行聚集运算消除。子查询需为JOIN表之一(不在TargetList、Where子句等其他位置)。 支持若外部查询的所有Agg参数列包含于其某个子查询的Agg函数列,则可对该子查询的聚集运算进行消除。 支持所有消除子查询聚集运算后结果正确的聚集函数种类。聚集函数种类结果正确性见下表: 4.场景约束 在上述场景扩展的基础上,对于可能导致结果错误的场景,不进行查询重写,包括但不限于: 不支持消除的Agg函数类型。 子查询中包含其它条件或算子,会导致重写后结果错误,例如HAVING、window agg、LIMIT、OFFSET、AP function、distinct、recursive等。 外层Agg参数列、GROUP BY列或JOIN列中包含volatile函数,如random、timeofday等。 子查询Agg函数外、外部查询Agg函数内有其他表达式或函数操作,如子查询Agg函数列为sum©+1、max©+max(d),外部查询Agg函数列为sum(cc+1)等。 外部查询的JOIN列、GROUP BY列或其它条件中包含子查询Agg函数列。 子查询在LEFT JOIN、RIGHT JOIN的inner边或FULL JOIN中,且子查询Agg函数为count,外部查询Agg函数为sum的。 四、结语 通过本文的分析,相信用户朋友已经充分了解了Lazy Agg重写优化的使用场景,以及GaussDB(DWS)的lazyagg实现方式。希望广大用户能够通过深入的了解,对GaussDB(DWS)的性能调优产生浓厚的兴趣并深度参与进来。 参考文档:GaussDB(DWS)性能调优系列实战篇四:十八般武艺之SQL改写 【这次高斯不是数学家】有奖征文火热进行中:https://bbs.huaweicloud.com/blogs/345260 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

深度剖析数仓CN增量备份技术

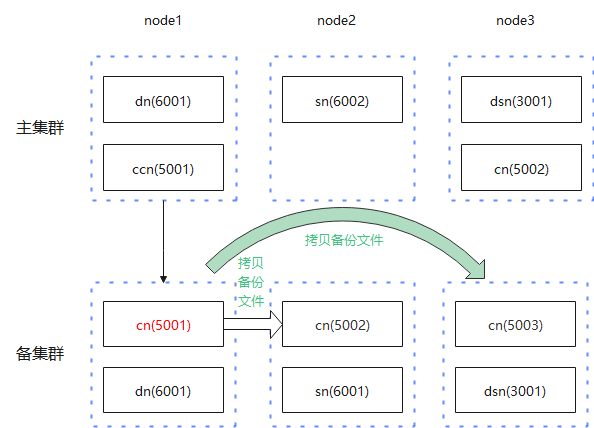
摘要:为了解决Roach的性能问题,提出了CN增量备份手段,从而达到进一步优化RPO目的。 本文分享自华为云社区《GaussDB(DWS)备份容灾之CN增量备份》,作者: zxy_db 。 1. 摘要 在数据量增大时,如果CN每次都做全量备份,则会导致每次的备份数据量很大,不仅会降低备份的性能,也从造成备份集恢复性能的降低。如果改成CN增量备份,则备份集只会备份差异数据,这样不仅会使得备份数据量变小,而且也会提升备份集恢复的性能。 2. CN备份原理 对于主备集群CN备份与恢复的过程,如下图所示: 在备份过程中,只备份主CN的数据,且只发送到备集群对应的主CN所在的节点上。 在恢复过程中,非主CN节点从主CN节点上拷贝rch文件,然后再将备份数据的rch文件恢复到实例目录。 CN备份同集群备份一样,先进行行存备份,后进行列存备份。 对于行存备份过程,首先是准备列表,然后备份文件。 准备列表主要分为3个步骤:第一步是获取CN备份类型,第二步是根据备份类型,决定LSN区间,第三步是根据LSN区间,准备备份列表(全量备份列表和增量备份列表)。 对于列存备份过程,同上述行存。 行存和列存区别在于增量备份LSN区间的取法: 行存文件来说,增量是上次startLSN到本次startLSN之间 列存文件来说,增量是上次barrierLSN到本次barrierLSN之间 3. CN备份判断逻辑 首先,CN增量需要有一个基础备份,因此,集群在做全量备份时,CN仍然做全量备份。 其次,集群在两次增量备份过程中,CN发生删除和加回后,新增的CN需要做全量备份。 对于支持异构的情况下,如果ID最小的CN发生变化,同样需要对CN做一次全量备份。 整体的备份逻辑如下图所示。 3.为了实现上述判断逻辑,通过创建标志文件backup_label.old来控制CN做全量备份还是增量备份。backup_label.old在Python侧创建。即在Python侧,调用gs_roach备份前,在最小的CN上,即要进行备份的CN上,创建backup_label.old文件。根据backup_label.old的修改时间和priorBackupKey转化的时间,判断CN做增量备份还是全量备份。流程图如下图所示。如右半部分所示,如果backup_label.old文件的修改时间比prriorBackupKey转换获得的时间大,则进行全量备份。否则,进行增量备份。 4. CN备份技术应用实测 4.1 CN删除和加回后做全量备份 初始状态,ecs-env-3038节点上的CN实例是最小CN编号,即主CN 第一步:修改XML配置文件xml,将主CN对应主机上的cooNum值从1改为0 第二步:使用gs_om工具执行删除CN操作 gs_om -t managecn -m delete -X /data1/xml/3_node_3.xml 第三步:将要加回CN对应主机上的cooNum值从0改为1 第四步:使用gs_om工具执行加回CN操作 gs_om -t managecn -m add -X /data1/xml/3_node_3.xml 删除和加回后,主CN的变化情况: 主CN由节点ecs-env-3038变为节点ecs-env-2998. 此时查看日志可以发现,由于CN发生了增删,集群做增量备份时,CN做全量备份。 4.2 备份集大小变化 第一步:拉起容灾,CN增量备份阶段停止容灾; 第二步:创建大量数据库和空表; 第三步:连续执行增量备份,增量备份中途不插入任何数据。 如下图所示,不增加数据,增量备份集大小小于全量备份集大小 5. 技术总结 本文主要从技术价值、应用场景、技术原理、技术实测展示几个维度对GaussDB(DWS) CN增量备份技术进行了剖析,可以看到增量备份是对已有全量备份恢复的一个有效的增强,可以节省宝贵的备份存储空间和cpu资源,同时达到进一步优化RPO目的,因此该技术拥有较为广阔的前景和深远的意义。 点击关注,第一时间了解华为云新鲜技术~​

优秀的个人博客,低调大师

数仓无损压缩算法:gzip算法

摘要:一种无损的压缩数据格式,是一个在类Unix上的一种文件解压缩软件。 本文分享自华为云社区《GaussDB(DWS) gzip算法简介》,作者:hw0086。 【算法原理】 gzip是一种无损压缩算法,其基础为Deflate,Deflate是LZ77与哈弗曼编码的一个组合体。它的基本原理是:对于要压缩的文件,首先使用LZ77算法的一个变种进行压缩,对得到的结果再使用哈夫曼编码(根据情况,使用静态哈弗曼编码或动态哈夫曼编码)的方法进行压缩。Deflate最初作为LZW以及其他受专利保护的数据压缩算法的替代版本而设计的,当时那些专利限制了compress以及其它一些流行的归档工具的应用。 【压缩核心Deflate】 1.LZ77算法 LZ77的核心思路是如果一个串中有两个重复的串中有两个重复的串,那么只需要知道后面的串与前面串重复的长度和后面串起始字符与前面串起始字符相对于起始位置的距离。 例如:ABCCDEFABCCDEGH 通过LZ77算法可压缩为ABCCDEF(7,6)GH,其中7表示重复串起始字符A到前面串起始字符的距离,5表示重复部分的长度(ABCCDE)。 LZ77采用滑动窗口(sliding-window compression)来实现这个算法,扫描头从串的头部开始扫描,在扫描头的前面有一个长度未N的滑动窗口。若发现扫描头处的串和窗口里的最长匹配串是相同的,则用(两个串之间的距离, 串长度)来代替后一个重复的串,同时还需要添加一个表示是真实串还是替换后的串的字节在前面以方便解压。实际过程中滑动窗口的大小固定,匹配的串也有最小长度的限制,以方便(标识+串之间距离+串长度)之和所占用的字节是固定的。 2.哈夫曼编码 哈夫曼编码是数据结构课程中一种常见的算法。哈夫曼编码使用变长编码表对源符号进行编码,变长编码表通过一种评估来源符号出现概率的方法得到,出现概率较高的字母使用较短的编码,反之出现概率低的使用较长的编码,这样使编码之后的字符串的平均长度、期望值降低,从而达到无损压缩数据的目的。通过构造Huffman Tree的方式给字符重新编码,避免一个叶子的路径是另一个叶子路径的前缀,以保证出现频率越高的字符占用的字节越少。 例如:给英文单字“F O R G E T”进行哈弗曼编码,将每个英文字母出现频率由小排到大,如下图。 每个字母与都代表一个终端节点(叶子节点),比较留个字母中每个字母出现的频率,将最小的两个字母相加合成一个新的节点。如下图。组成哈弗曼树。 将上图给定的哈弗曼树的所有左链接设为0.右链接设为1,从根节点到叶子节点一次记录每个字母的编码,所得每个字母的编码表如下图。 【文件格式】 10字节的头,包含幻数、版本号以及时间戳 可选的扩展头,如原文件名 文件体,包括DEFLATE压缩的数据 8字节的尾注,包括CRC-32校验和以及未压缩的原始数据长度 通常gzip仅用来压缩单个文件,再对多个文件的压缩归档通常会将这些文件合并成一个tar文件,再使用gzip对tar文件进行压缩,最后生成.tar.gz或者.tgz文件,即“tar压缩包”或者“tarball”。 【应用】 -c,--stdout将解压缩的内容输出到标准输出,原文件保持不变 -d,--decompress解压缩 -f,--force强制覆盖旧文件 -l,--list列出压缩包内储存的原始文件的信息(如,解压后的名字、压缩率等) -n,--no-name压缩时不保存原始文件的文件名和时间戳,解压缩时不恢复原始文件的文件名和时间戳(此时,解出来的文件,其文件名为压缩包的文件名) -N,--name压缩时保存原始文件的文件名和时间戳,解压缩时恢复原始文件的文件名和时间戳 -q,--quiet抑制所有警告信息 -r,--recursive递归 -t,--test测试压缩文件完整性 -v,--verbose冗余模式(即显示每一步的执行内容) -1、-2、...、-9压缩率依次增大,速度依次减慢,默认为-6 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

observablehq 美国 COVID-19 确诊数曲线

本线状图用于显示每天美国 COVID-19 的总计感染用户曲线。我们使用的是在线 JSON 数据,数据是通过 AWS 进行读取的。 你可以直接访问下面的链接来获得我们处理上传的数据。 https://cdn.ossez.com/dataset/json/covid19/covid19-confirmed-daily-us.json 虽然我们每天都会自动上传一些数据,但是你可能的更新数据每次都不一样。 我们主要也是希望通过这个平台来学习 D3 图表的使用。 你可以直接访问下面的链接: https://observablehq.com/@yuchenghu/untitled?collection=@yuchenghu/covid-19 对代码修改后进行编译,需要注意的是我们数据是上传到 AWS 的 JSON 数据,数据的来源是从 https://covidtracking.com/api 下载后处理的。 下载的方式是通过 Spring Batch 构建一个批量处理程序,每天定时获得最新数据后存储到本地数据库中,然后从本地数据库中导出为 JSON 数据。我也认为这种处理方式过于繁琐,其实在内存中就可以实现了,在获得原数据的 API 后,你可以直接将源数据转换为对象。 然后利用 gson 将对象转换为需要的字符串后输出成 JSON 就可以了。 如果你对 AWS API 比较了解和熟悉的话,你可以利用 AWS 的API 直接将生成的 json 数据上传到 S3 上存储。 做这个小项目的主要是为了熟悉 Spring Batch 的使用,D3 数据图表的配置,AWS API 的存储和使用。 麻雀虽小,五脏俱全,能够帮助你很好的了解微服务,云平台,数据结构等很多知识。 项目的源代码,我们已经发布到 GitHub 上了。https://github.com/ossez-com/covid-19 如果你有兴趣的话也可以参考。 https://www.cwiki.us/pages/viewpage.action?pageId=62619834

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册